大模型原理终极指南!十分钟速通,从函数到神经网络,看这篇就够了!

LLM大模型基础知识【一】 大语言模型(LLM):是指在自然语言处理(Natural Language Processing,NLP)领域中的一类大模型,通常用于处理文本数据和理解自然语言。这类大模型的主要特点是它们在大规模语料库上进行了训练,以学习自然语言的各种语法、语义和语境规则。例如:GPT系列(OpenAI)、Bard(Google)、文心一言(百度)。视觉大模型:是指在计算机视觉(Computer Vision,CV)领域中使用的大模型,通常用于图像处理和分析。 阅读详情

01

从函数到神经网络

大家都学过数学,函数这个概念并不陌生,简单理解就是一组数据通过某个规则进行转换,得到另外一组数据。并且在特定的数据集中,这个规律是恒定不变的,可以说是一个法则。好,那么回到现实世界,有哪些函数相关的例子?有的,比如一个勾股定律,当我们的形状明确是一个直角三角形时,两个直角边边长的平方加起来等于斜边长的平方,即:。这就是一个函数,通过符号化解释了现实世界的规律。

那么人们就想,是否存在一类函数,他可以解释大部分世界的规律,然后利用机器的理解和运用,实现人工智能?这就是早期人工智能的先驱流派:符号主义。

但是逐渐人们发现,世间规律太过复杂,很多事情无法用确定性的函数来表达,比如如何判断一张照片上的图片是不是一只猫,对于人类来讲就非常简单,但是对于机器来说就过于复杂了,于是联结主义出现,人们承认自己太菜了,所以放弃了寻找万物之间规律的这条路,干脆让机器自己从数据里‘统计’出近似规律——这条数据驱动的路一走就是 30 年。怎么理解呢?见下图:

f(x)=ax+b,这是一个非常简单的函数,但是如果人类一开始并不知道这个逻辑,那怎么办呢?通过上图这种方式,不断调整a和b这两个系数,逐渐让所有的点都与这条线越来越近,直到完全拟合,那么恭喜,你发现了这些数据的规律。

但是复杂的规律,人们怎么调整都找到不到一条完美的线,让所有的点都在这条线上,只能找到近似的一条线,尽量让各个点接近,比如下面这个图:

问题来了,实际上很多数据比上述情况更复杂,通过倾斜和上下移动连近似拟合都无法实现,那么这时候就需要将线性关系升级成非线性关系,比如下面这个图:

通过fx=g(ax+b),将线性函数折成了非线性函数,这里的函数g对ax+b完成了一次平方计算,即fx=(ax+b)²,那么这个将线性关系盘活的函数就称之为激活函数。

问题又来了,如果数据关系更为复杂,使用一个激活函数无法贴近真实数据情况,曲线弯的还不够灵活,怎么办呢?那就再套一个激活函数fx=g(a2(g(a1x+b1))+b2),通过这种套娃的形式可以实现极其复杂的曲线关系。

但是通过这种公式的形式表达太过复杂,于是我们抽象一下:

可以看到,从输入层经过线性变换和激活函数到隐藏层,再经过一次线性变换和激活函数到输出层,整个过程是从左到右一点点传播过去的,这个过程我们就称之为神经网络的前向传播(其实就是一层层函数计算)

随着每一层的神经元个数以及隐藏层的层数不断增加,我们可以得到一个相当复杂的神经网络(非线性函数),如下图:

从函数到神经网络基本搞清楚了,剩下的就是通过调整参数让我们离真实数据情况越来越接近,随着函数越来越复杂,猜的成本也就越来越高,那么我们有没有一些方法可以让这个猜的过程更加高效可控一点呢?有的。

02

计算神经网络的参数

好的,上一个章节我们搞懂了,神经网络其实就是一个尽量拟合真实数据的非线性函数,那么如何评估拟合的好坏呢?先回到之前的线性函数:

可以看到ab两条线,显然a要更接近真实的数据表现,如何量化呢?我们可以计算所有的数据离这条线的距离之和得到损失函数:

绝对值处理起来比较麻烦,我们对这距离进行平方,一是解决绝对值不平滑问题,二是放大误差,然后再通过计算平均值来放大数量带来的误差影响得到均方误差:

那么如何找到这个极值点,让我们损失函数的值尽量小,初中就学过通过求导为零来计算曲线的极值点。

这里是忽略了参数b,如果对两个参数进行求导,其实是求偏导数,你可以想象一个在三维空间中,以二元一次方程顶点为轴心线,通过旋转得到一个碗装的曲面,这里不详细展开。

我们通过对损失函数求导,得出线性模型,来拟合x和y的关系,就是机器学习中最基础的一种分析方法,即线性回归。

但是现实世界中的数据往往比较复杂,只能通过不断地猜测来进行拟合,我们发现在固定b参数情况下,通过不断调整w参数,可以让损失函数不断减小,即损失函数对w的偏导数,我们每次调整的力度通过一个系数去表示,即学习率。

这些偏导数所构成的向量,我们叫做梯度,通过不断调整w和b让损失函数不断减小的过程,称之为梯度下降。

很多教程会用下山来比喻,包括吴恩达的课程,其实就是不断找全局最低点的过程:

回到之前的简单神经元的案例,我们发现从输入层到隐藏层到输出层到损失函数,通过不断调整w的值,来让最终的损失L变小,通过从右向左依次求导,在计算前一层偏导数的值时,后面也会用到,所以不用重复计算而是从右向左一点点传播过来,那么这个过程我们称之为反向传播。

通过前向传播,根据输入x计算得出y,然后通过反向传播计算损失函数关于每个参数的梯度,不断往梯度的反方向变化一点,这样就构成了神经网络的一轮训练。

03

调教神经网络

上一个章节,我们的目的是让这个复杂的神经网络函数无限接近真实数据表现,即让数据拟合的很好,下图中的三个函数,哪个比较好呢?

很显然,A拟合的就不好,B感觉还不错,C貌似太完美了,假如有一些新的数据,那么C可能效果还不如B,这种在训练数据表现的很完美,但是再没见过的数据上表现得很差的情况,我们叫它过拟合。而在没见过的数据上表现的能力我们叫它泛化能力。

那如何避免过拟合呢?一方面可以通过简化模型复杂度,让我们的模型简单一点,不要学会哪些噪声,另一方面可以通过增加数据量,让训练过程可以忽略噪声。

那除了通过调整数据和函数来防止过拟合,有没有其他办法?有的,我们可以通过提前终止训练来防止,这种方式叫早停。但是这种方式比较粗糙,无法精细化控制。

所以有没有一种办法,让每次调整参数的时候,梯度下降的没有那么快呢?我们发现可以把参数本身的值加到损失函数中,当参数增大时,惩罚项会急剧增加,迫使模型优化时主动压缩那些大参数,从而抑制了参数的野蛮增长。

我们把增加的参数绝对值的和称为惩罚项,这种抑制方式称之为正则化,如果是添加绝对值叫做L1正则化,如果是平方和(放大抑制的效果)叫做L2正则化,再通过增加一个系数来调整力度,这个系数叫做正则化系数,这一系列控制参数的参数,我们称之为超参数。

另外,还有一种简单到爆炸的方式,我们可以通过在训练过程中,每次都随机丢弃一些一部分高优参数,这样让模型依赖更多的普通参数,这样来减少过渡依赖少量样本的风险,这种方式叫Dropout(丢弃)虽然听起来感觉挺不靠谱,但确实有效。

04

矩阵运算

回到我们之前讨论的神经网络,从最简单的y=x+b,通过输入层增多x,输出层增多y,我们可以得到非常复杂的神经网络,但是这个公式也太复杂了,有没有一种其他的简洁的表达形式,可以更好理解?

科学家们想到,把加减乘除变为矩阵计算,一方面让公式更直观,另一方面可以利用GPU的并行计算提升训练速度。

05

从词嵌入到RNN

通过神经网络,我们可以通过训练来让模型具备预测没有见过的数据的能力,那么如果说让我们来对一句不完整的话进行预测补充,该怎么做呢?如何设计这个神经网络呢?

先把文字转换成计算机可以识别的数字,有两种方式,第一种是对每个词语或字进行编码,用一个数字表示,比如:

这种方式有一个弊端,就是识别的范围取决于你的词表大小,并且是一维的标识,数字本身没有任何意义,也无法衡量词语之间的相关性,可以理解为就是一个映射表。

另一种方式是准备一个非常大的向量,每个词语或字代表向量的一个维度,比如这样:

这种方式叫做one-hot编码(独热编码),这种编码方式缺点也很明显,就是维度非常高,很稀疏,非常浪费计算和存储资源。

维度太低了不好,维度太高也不好,那有没有一种不高不低的方案呢?有的,这种方式叫做词嵌入(embedding),通过词嵌入得到的词向量维度不高也不低,每个位置都可以理解为一个特征,比如这样:

通过对这组数据进行点积运算或者预先相似度预算,可以发现男人和男孩的关系似乎与女人和女孩的关系有着某种联系,这种代表联系的向量如果放在多维空间中,方向可能是一致的,但是有时候通过人类语言不一定能描述出来,通过大量的数据进行训练,才能得出这种隐型特征,这样我们就发现了数据和数据之间的相关性,那么通过一组词语就可以联想出另外一组词语。

回到之前讲的神经网络,我们如何在神经网络中体现下一层数据和上一层数据之间的关联性呢?很简单,把上次层的结果以中间态的形式放到下一层中计算就可以了,具体做法如下:

将上图简化一下,这就是我们的RNN(循环神经网络):

循环神经网络通过保留中间隐藏状态不断传递,让后面的数据具备了前面数据的关联信息,通过循环传递让每个数据都具备了其他数据的关联信息,这样RNN就具备了理解词和词之间先后顺序的能力,那么预测文字就变得非常容易了。

RNN和经典的神经网络相比,就只是多了一个上一层的隐藏状态,仅此而已,是不是非常简单。

但是RNN有两个明显问题:

  1. 如果神经网络的层数很大,后面的状态数据会逐渐失真,你可以想象一下“传话游戏”,第一个人描述的非常清楚,到最后一个人讲出来却和原始含义大相径庭。
  2. 无法并行计算,因为每一层都要依赖上一层的状态,这明显是一个串行的关系,无法利用到GPU的并行计算。

那么有没有一种把所有信息尽收眼底,以一种上帝视角俯瞰全局的方案呢?有的,它就是Transformer!

06

Transformer

如果我们要预测我爱__,该怎么做呢?接下来直接进入正题:

我们先对“我爱你中国”进行词嵌入,然后分别与QKV矩阵进行词向量相乘得到三组QKV矩阵,为了计算出“我”这个向量和其他向量的关系,我们先让q1和每个矩阵的k向量进行点积运算,这样就得到了“我”向量和其他向量的相似度,然后再分别与每个矩阵的v向量相乘,就得到了a1这个向量。该向量包含了其他所有向量的相似性以及其他向量的值。

换句话讲,站在“我”这个字上,你可以看到其他所有词语的相关性以及他们的内容,这个就是注意力机制。

其中:QKV是三组通过训练得到的数据,代表大量数据中的隐藏权重。

  • Query (Q):就像你在搜索引擎里输入的关键词。
  • Key (K):就像互联网上所有网页的标题和关键词标签。
  • Value (V):就是这些网页的完整内容。

参考搜索引擎,通过你输入的Query与所有网页的Key进行匹配,计算相关度得分,将最终的网页Value汇总给你。

实际上,现实世界的数据可能不止一组QKV权重就能表达出事物所有的“特征”,那么可以通过训练多个QKV矩阵(表示多种视角的隐藏权重),重复上面的运算得到最后的结果,这种叫做多头注意力机制。

恭喜你读到这里,你已经掌握了大模型transformer的最核心的内容:

上图为大名鼎鼎的《Attention Is All You Need 》论文原图,我们把细节屏蔽,比如add&norm,代表的残差网络和归一化处理,目的是解决梯度消失,让分布更稳定而做的优化,这里不展开讲,我们把上图简化一下:

通过编码器对输入内容进行了多头注意力机制的转换,通过全连接神经网络得到K和V矩阵,然后解码器负责对输出进行多头注意力机制(注意这里是掩码了的,解码器需要推理,所以就盖住了后面的数据,让模型可以模拟真实推理)得到Q,然后和编码器送过来的KV矩阵进行多头注意力,然后经过全连接神经网络,通过线性变换投射到词表向量,然后通过softmax得到各个词的概率。然后通过当我要翻译I love china的时候,解码器只需要输出概率词表中最大的那个词,就可以一个个推理出“我 爱 中国”。

我们现在用的chat大模型都是基于transformer的解码器部分实现的,也就是不断预测下一个数据,通过这种“猜”的方案,来实现对话、写文章、写代码等众多的应用场景,方案很简单,但是却非常有用!

07

结束语

好了,到这里我们已经完全搞懂了大模型的原理啦,过去只知道一些注意力机制、模型的推理是靠猜的这些模糊的概念,通过系统性的学习和总结,我们可以更深入的理解大模型的底层到底是什么,这对以后的大模型微调、大模型工程应用都有帮助,如果看到这里忘记了前面的内容,可以再重新理一遍,理解可能会更加深刻哦,bye bye!

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
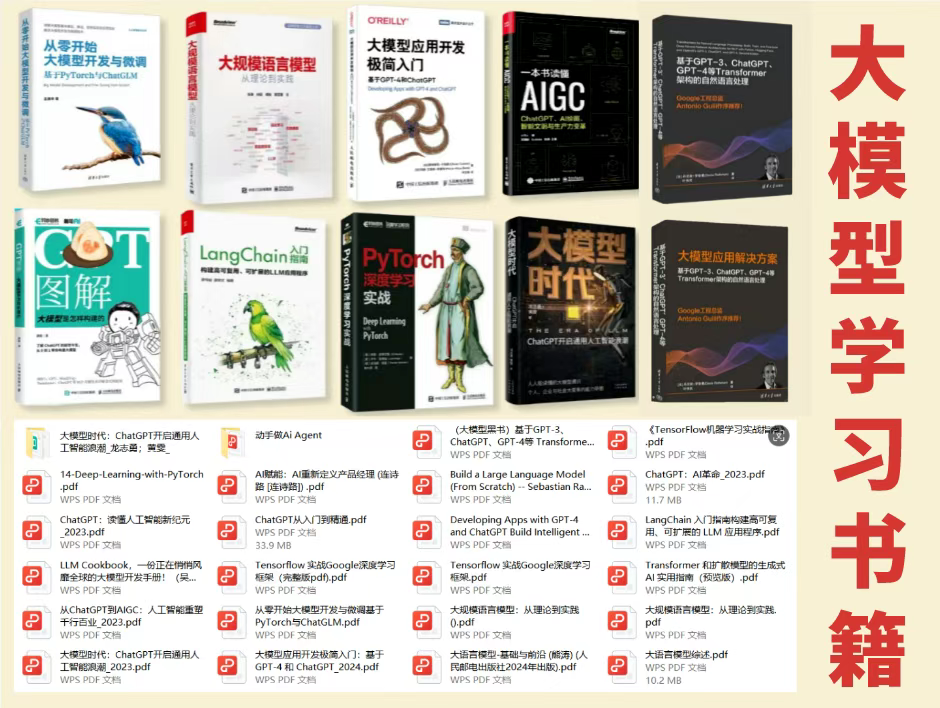
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

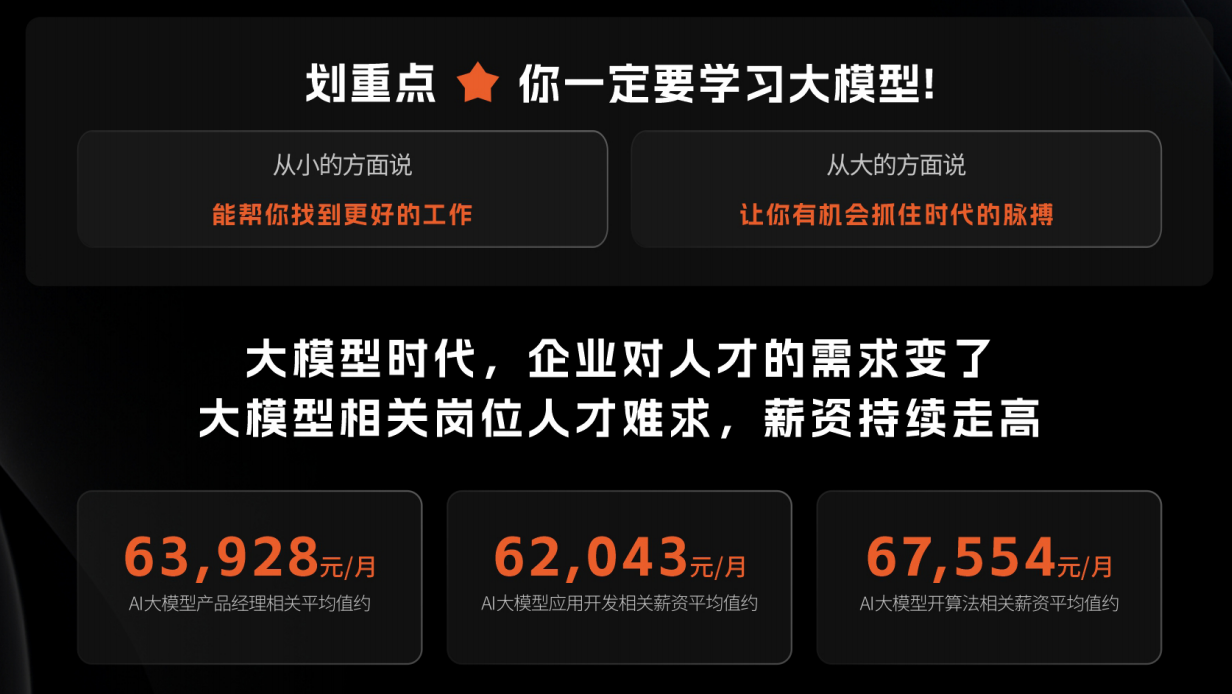
为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
在这里插入图片描述

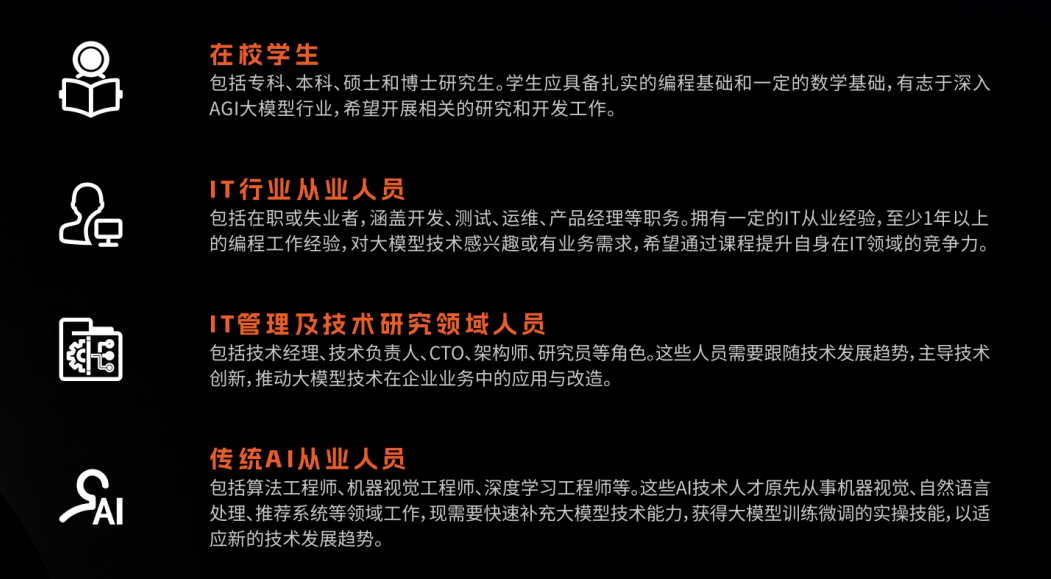
适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

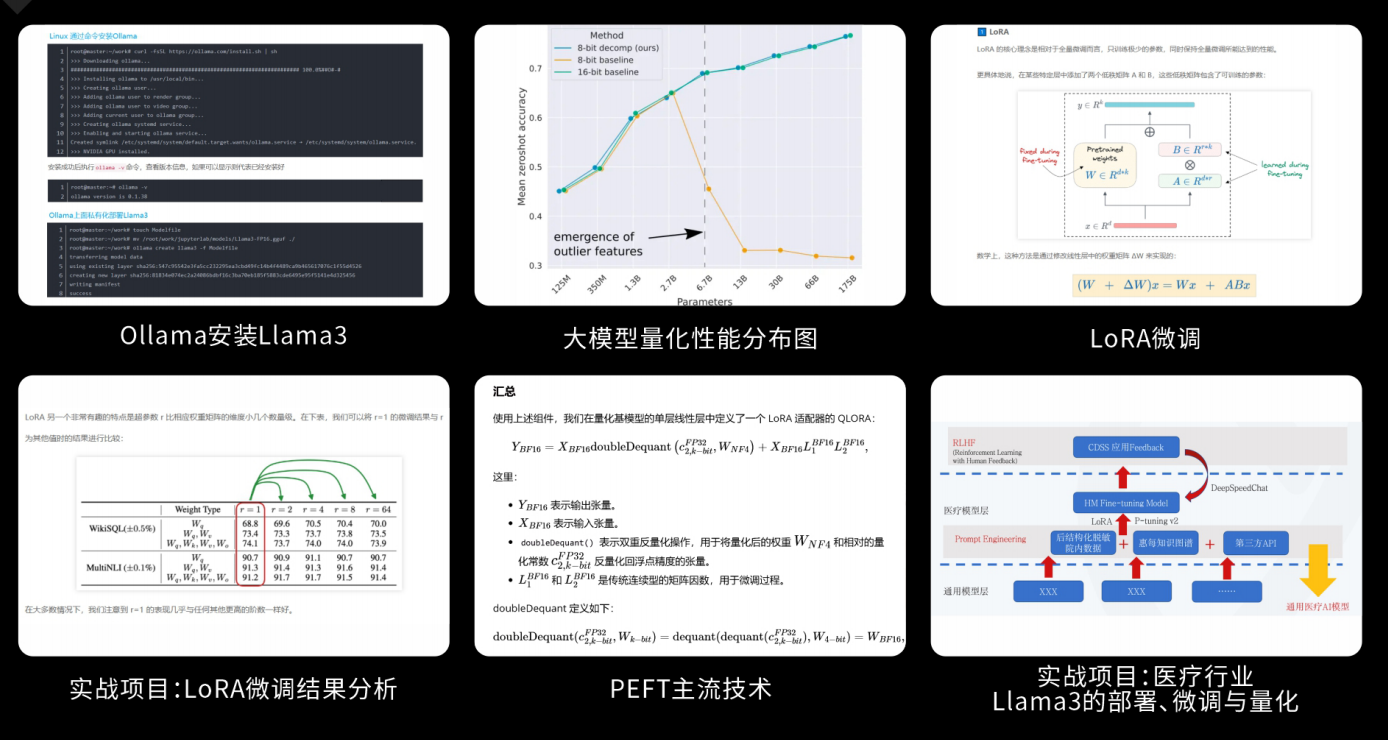
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

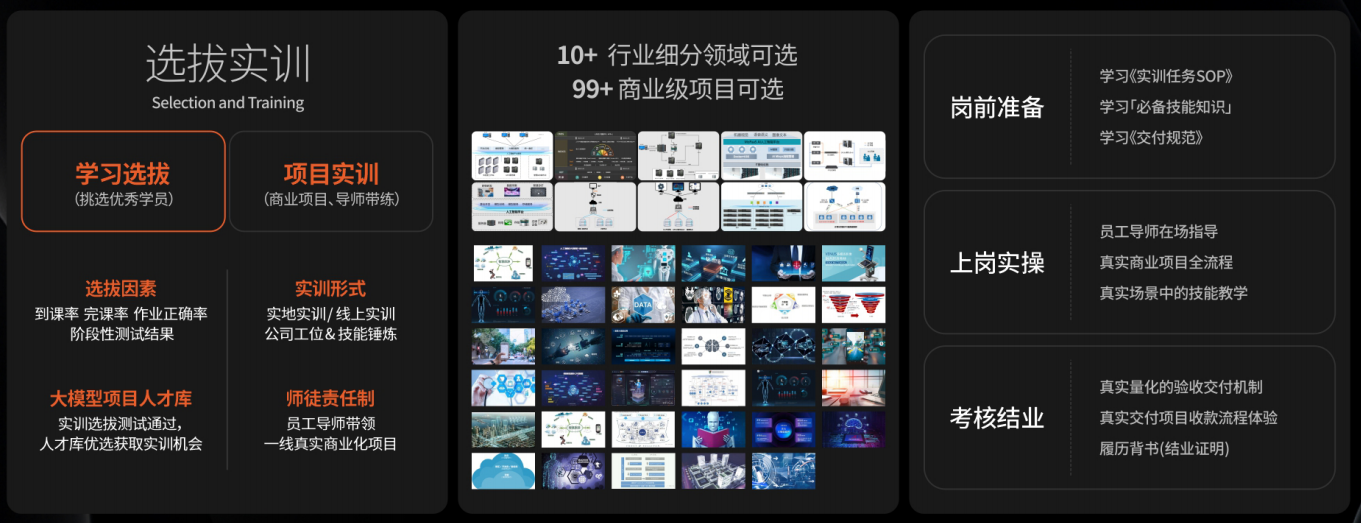
  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

大模型入门指南:基本技术原理与应用 本文探讨了大型神经网络模型的基本技术原理,包括深度神经网络、激活函数、损失函数、优化算法、正则化和模型结构等,并讨论了预训练与微调、模型压缩与加速、解释性与可解释性、隐私与安全等关键议题,旨在帮助读者更好地理解和利用大模型来解决实际问题。 阅读详情

相关推荐

大模型核心技术原理: Transformer架构详解

四是,通用语言模型,如 GLM,该模型结合了自回归和自编码两种形式的模型,举个例子,“123456”是一串输入的序列,现在把 “3”、“5”、“6” 挖空,让模型去学习,那么,挖空以后换成一个 “ mask token” 告诉模型这个地方遮掉了一些内容,现在需要去预测出来遮掉的内容。一是,自编码模型,如 BERT,简单讲就是给到一句话,然后把这句话的内容挖空,当问及挖空的内容时,就把内容填回去,这其实是典型地用来做一个自然语言理解的任务,但做生成任务是非常弱的;本文由博客一文多发平台。

马沛专栏 8240

万字长文,解读大模型技术原理(非常详细)零基础入门到精通,收藏这一篇就够了

1)突破了远距离文本依赖的学习限制,避开了递归网络的模型体系结构,并且完全依赖于注意力机制来绘制输入和输出之间的全局依赖关系。2)可高度并行进行训练,这对发挥硬件红利以及快速迭代模型非常重要。下图是论文提到的Transformer模型,对编码器和解码器使用堆叠式的自注意力和逐点式、全连接层,分别如图1的左半部分(编码器)和右半部分(解码器)所示,相关技术细节后面会重点讲到。

Python_0011的博客 9388

GraphCast气象预测模型原理解析与实操指南

图神经网络(GNN)正成为AI气象建模的核心技术,它通过在球面网格上构建不规则图结构,高效捕捉大气变量间的长程物理依赖与多尺度耦合关系。相比传统数值天气预报(NWP)依赖偏微分方程求解带来的高算力、低时效瓶颈,GNN凭借数据驱动的端到端联合预测能力,在保持物理一致性的同时实现亚秒级推理与10天高精度预报。其关键技术包括球面图建模、多变量张量输入、加权球面损失函数及Reduced Gaussian网格适配。本文聚焦GraphCast这一工业级落地模型,详解其如何将GNN原理转化为可复现的气象预测流程,覆盖数据

cunbei2644的博客 518

《大模型原理没那么难!小白也能吃透的保姆级科普》

我们将从大模型的模型架构和核心工作原理出发,用最通俗易懂的语言拆解大模型架构 —— 哪怕你是从未接触过大模型的零基础小白,也能轻松理解大模型的运转方式。无论是想掌握 Agent 开发的技术内核、精进 Prompt 设计的实践技巧,还是单纯好奇 AI 背后的奥秘,本文都将用层层剖析的方式,帮你撕掉 **「技术门槛」** 的标签,让大模型认知真正实现 **「零起点可及」**。

王不二的AI之路 1067

Neural Style Transfer实战指南:用Python零训练实现艺术风格迁移

神经风格迁移(Neural Style Transfer)是一种将内容图像与风格图像融合生成新视觉作品的技术,其核心在于利用预训练卷积神经网络(如VGG-19)分层提取语义内容与纹理统计特征,并通过Gram矩阵量化风格。该技术无需训练模型、不依赖配对数据,具备原理透明、结果可控、部署轻量等工程优势,广泛应用于设计提案生成、数字内容统一调性、美术教育可视化及创意编程教学等场景。结合Python生态工具(如neural-style-pt),开发者可在CPU环境快速完成端到端迁移,真正实现‘所见即所得’的艺术语法

weixin_34321753的博客 349

【信息科学与工程学】【数据中心】 第十九篇 MFU的优化提升方法01

MFU作为一个综合性能指标,清晰地揭示了下游任务(模型训练/推理)对上游计算资源(GPU集群)的实际利用效率。它不仅是技术能力的体现,更直接关系到企业的运营成本和AI创新的速度。追求更高的MFU,本质上是在有限的资源和无限的算力需求之间寻找最优解,是AI基础设施领域持续演进的核心动力。总而言之,数据中心CPU的MFU不仅仅是一个软件性能指标,它是计算芯片微架构、服务器硬件设计、数据中心基础设施以及软件算法协同工作效果的终极体现。

weixin_49199313的博客 1240

MoE混合专家架构:揭秘大模型2%激活率背后的动态调度原理

混合专家(MoE)是一种突破传统稠密模型瓶颈的稀疏化架构,其核心在于通过Router路由机制实现参数的按需激活,解耦模型容量与计算开销。原理上,它将庞大参数划分为多个独立Expert子网络,由轻量级Router根据输入token语义实时选择Top-k专家协同响应,显著降低单次前向传播的FLOPs与显存占用。技术价值体现在训练效率提升、推理延迟优化及线性扩展能力增强,尤其适用于高吞吐、低延迟场景如实时对话、端侧部署与多任务联合建模。本文深入剖析MoE中Router调度策略、激活率动态博弈机制与Noisy To

dielucui7698的博客 625

【产品体系】【会计领域】【成本会计】第十九篇 GPU服务器的成本会计01

从内到外依次为:界面氧化层(SiO₂,~0.5nm)、高K介电层(HfO₂或HfZrOₓ,等效氧化层厚度EOT < 0.5nm)、功函数金属层(TiN、TiAlC等多层,总厚度~2-3nm)、钨(W)或钴(Co)栅极填充金属。:服务器操作系统(如Linux发行版)、GPU驱动程序、集群管理软件(如Kubernetes)、虚拟化软件(如VMware)、AI框架(如CUDA、TensorFlow)的商用许可。随后进行绝缘层(SiO2)沉积、阻挡层(Ta/TaN)和种子层(Cu)沉积,电镀填充铜。

weixin_49199313的博客 847

GPU加速深度学习训练:从硬件原理到工程调优全解析

GPU加速并非简单提升计算速度,而是面向大规模矩阵运算的并行计算范式革新。其核心在于突破CPU在单指令流处理上的局限,依托高吞吐架构、张量核心与CUDA生态,解决神经网络训练中内存带宽瓶颈与显存容量约束等根本性问题。技术价值体现在训练吞吐量跃升、大模型收敛可行性增强及混合精度等硬件协同优化能力。典型应用场景涵盖ResNet类中等模型单卡微调、LLaMA等大语言模型分布式训练,以及Stable Diffusion等生成式AI全流程加速。本文聚焦算法工程师与AI工程实践者,深入拆解GPU如何重塑数据加载、前向传

weixin_33473110的博客 561

【信息科学与工程学】计算机科学与自动化——第二十四篇 编译器04 LLVM编译器01

训推一体方案通过整合训练与推理流程,实现资源复用、效率提升和全链路自动化。以下从。

weixin_49199313的博客 1517

戴尔笔记本装Ubuntu 20.04,别急着分区!先搞定这个BIOS设置(Intel RST避坑指南)

本文详细介绍了在戴尔笔记本上安装Ubuntu 20.04时遇到的Intel RST技术兼容性问题及解决方案。通过安全切换至AHCI模式,避免安装过程中找不到硬盘的常见问题,并提供双系统分区策略和安装后的优化建议,确保Ubuntu与Windows 10双系统稳定运行。

weixin_31315567的博客 272

机器学习与人工智能:从零搭建环境到核心算法实战

人工智能是让机器表现出智能行为的学科目标,而机器学习则是实现这一目标的核心技术路径,深度学习又是其中最具活力的分支。理解这一层级关系后,学习路线便有了清晰主线。从数据、模型、损失函数、优化到评估,机器学习本质是一条完整的数据处理流水线。文章从最基础的环境搭建讲起,涵盖Anaconda、Jupyter等工具配置与常见坑点,继而拆解线性回归、逻辑回归、决策树、SVM与神经网络等核心算法的原理与调参要点,并强调特征工程、评估指标选择及完整项目实战的重要性。无论期末复习、课程大作业还是职业认证,都能从中获得可落地的

weixin_33402252的博客 309

UReport2 报表设计器 在线表格

UReport2官网 一、UReport2报表设计器 UReport2是一个开源的可视化报表设计器,功能强大,操作简单,可以实现复杂的报表统计,有各种各样的导出和打印功能,支持导入Excel表格! 1、报表设计器 2、设计一个简单的用户列表展示 二、可编辑表格 扩展了layui的表格,支持多元化数据编辑(单选,多些、日期、下拉联动),开发简单、高效、便捷。有了它就可以轻松开发类似进销存系统的表格录入功能了,用户拿来即用! 三、主从表录......

ejinxian的专栏 2万+

混元图像3.0一句话P图技术原理与实操指南

AI图像编辑正从‘能生成’迈向‘敢交付’的关键阶段。‘一句话P图’并非简单文生图,而是融合多模态语义理解、可控生成建模与端侧推理优化的系统性突破。其核心在于将自然语言指令精准解耦为空间定位、属性保留、光照对齐等可计算任务,通过意图解析层识别用户潜台词,可控生成层固化高频操作原子模块,端侧优化层实现全平台亚秒级响应。该技术显著降低修图门槛,适用于电商运营、营销设计、人像精修等强时效性场景,让语义精准控制和端到端可用性成为AI视觉生产力的新基线。

dielucui7698的博客 505

68页|大型车企集团数字化转型汽车数字化信息系统平台规划方案

这份PPT文档提供了一个全面的汽车集团数字化转型规划方案,涵盖了项目目标、规划思路、实施关注点、解决方案建议以及合作优势等多个方面。

baidu_25525561的博客 1328

智能网联汽车云控系统核心解析:车云数据交互协议设计与实践

本文深入解析了智能网联汽车云控系统的核心——车云数据交互协议的设计与实践。文章围绕“说什么”、“怎么说”及异常处理三大核心问题,详细阐述了二进制与结构体数据类型定义、TCP/UDP双通道传输机制、通用报文格式以及典型交互流程(如GLOSA车速引导),并分享了时间同步、坐标系定义等关键实战经验与避坑指南,为构建高效、可靠、安全的车云“神经系统”提供专业指导。

alice7model的博客 121

地球Online逃生指南(上卷)

本书是一部系统探讨人类意识困境的哲学著作。全书通过七卷本的结构,依次解构人类认知牢笼、自我本质、世界实相、痛苦根源,最终指向自由、慈悲与终极实相。第一卷揭示大脑建构的认知幻象;第二卷剖析"自我"的神经机制;第三卷以系统论阐释世界空性;第四卷建立痛苦的数学模型;第五卷提出觉知训练体系;第六卷论证利他主义的科学基础;第七卷超越逻辑束缚直指存在本质。著作融合现代神经科学、量子物理、复杂性理论与东方哲学,构建了一个从认识到解脱的完整认知框架,最终指向无条件的临在与宇宙层面的觉知。

weixin_45747731的博客 836

AgentScope 实战训练营-A2UI的完整实现:从概念到部署全流程

本文详细介绍了如何在AgentScope框架中实现Google的A2UI(Agent-to-Agent UI)协议,构建一个能生成可交互UI的智能体应用。文章涵盖了从环境准备、架构设计、核心代码实现到测试部署的完整流程,包括A2UI协议解析、技能系统、客户端实现、通信机制等核心技术点,适合AI Agent和前端开发人员学习参考。

program哲学 201

Ludwig 视频问答模型全流程指南:从视频帧到文本答案的 3 段链路

视频问答(Video Question Answering,VQA)要求模型同时看懂画面并理解自然语言问题,传统做法要自己搭特征提取器、设计注意力融合,CV 和 NLP 的跨领域工作量都很重。用 Ludwig 的声明式配置可以把这条链路收敛成一份 YAML 加几条命令行:你只描述"输入是什么、怎么融合、输出是什么",数据加载、模型实例化、训练监控都由框架接管。下面直接上手,跑通从视频帧提取、模型训

gitblog_01026的博客 471

YOLOv11与3D点云检测融合技术深度解析:从2D检测到三维空间投影的完整实现

2D-3D融合目标检测技术研究 本文系统阐述了基于YOLOv11的2D-3D目标检测融合技术,重点分析了YOLOv11在融合系统中的定位优势及其架构设计。研究表明,2D图像与3D点云数据具有显著的互补特性:2D图像提供丰富语义信息,而3D点云则精确描述几何结构。 关键技术要点: YOLOv11通过GSConv平衡卷积和VoVGSCS特征融合模块,在保持实时性的同时提升了检测精度 系统采用模块化设计,包含坐标投影、点云分割、边界框拟合等核心组件 针对点云数据的非均匀分布特性,提出了多尺度特征增强和距离差异化检

本博客聚焦 YOLOv11 全流程落地,涵盖架构优化、数据集处理、训练技巧与多场景部署,兼及国产数据库、Java 开发与 AI 模型应用,内容兼顾理论与工程实践,为开发者提供系统干货,助力高效提升技术能力。 1127

RK356x U-Boot研究所(命令篇)3.12 mtd命令的用法

RK356x U-Boot研究所(命令篇)3.12 mtd命令的用法

Systemcall名屋 1686

机器学习工程师必学的5个生产级Python库

机器学习库选择本质是工程可靠性决策:scikit-learn提供标准化数据预处理与Pipeline封装,保障特征工程可复现;PyTorch通过Dataloader契约和autograd机制支撑灵活建模与GPU高效训练;Hugging Face Transformers以Trainer为核心抽象,统一处理混合精度、梯度裁剪与分布式同步;LightGBM基于直方图切分实现结构化数据的高性能训练;Weights & Biases(W&B)则重构实验管理范式,实现代码、超参、指标、artifact的全链路可追溯。这

ailiao2015的博客 407

Dify 第 7 篇 Dify 应用介绍 + 聊天助手&Agent 应用关键点说明

本文介绍了Dify应用的核心概念与使用方法。Dify是基于大模型构建的实际场景应用,提供API、WebApp和易用界面。包含5种应用类型:聊天助手、文本生成、Agent、对话流和工作流。创建方式有模板创建、空白应用和DSL文件三种。重点讲解了聊天助手和Agent应用的关键功能:聊天助手支持提示词优化、知识库引用、文件处理等;Agent应用则强调推理能力、工具调用和任务自动化。文章还详细介绍了应用的调试、发布和管理工具,为开发者提供了全面的应用构建指南。

甘蓝的专栏 1886

香薰机语音控制芯片怎么选?离线语音模组与语音SoC方案对比

语音识别芯片是智能硬件本地交互的核心,其原理在于通过前端音频采集与神经网络加速单元实现命令词实时解析。相比云端方案,离线语音识别在延迟、隐私和成本上具备显著优势,尤其适用于香薰机这类高频短时操作的小家电。MCU加算法、离线语音模组与语音SoC三条路线各有取舍,需综合评估待机功耗、麦克风信噪比、Flash余量等硬指标。应用场景中,香薰机需在风扇雾化噪声背景下保证唤醒率和低误触发率,因此芯片选型需围绕本地唤醒、低功耗监听与量产一致性展开。最终收敛到:低成本语音SoC与成熟模组是当下平衡开发效率与体验的主流选择。

weixin_34006468的博客 328

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

CANN ops-nn 的 AddRmsNormQuant 算子:Add + RmsNorm + 双路 Quantize 融合的标准化量化实现解析

AddRmsNormQuant 是 CANN 神经网络算子库 [ops-nn](https://link.gitcode.com/i/bdd9815457f72e3461bcceb29b54f13c) 中面向大模型场景的融合算子:它将 RmsNorm 之前的 Add 算子与 RmsNorm 归一化后的 Quantize 算子融合为一个算子,在一次内核计算中同时完成"两输入求和 → RMS 归一化

gitblog_00738的博客 245

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

从AI编程助手到意图驱动开发:Cursor如何重塑软件开发范式

AI编程助手正从代码补全工具演变为深度理解项目上下文的智能协作者。其核心原理在于结合大型语言模型与代码库索引技术,实现从自然语言意图到可执行代码的端到端生成。这一技术价值在于指数级提升开发效率,降低编程的心智负担与上下文切换成本。在实际应用场景中,开发者可通过对话式交互完成跨文件操作、代码重构与复杂业务逻辑实现,将工作重心从具体编码转向高层设计与架构。以Cursor为代表的意图驱动开发环境,通过深度上下文感知和项目级理解,正在推动软件开发从“如何写”向“想要什么”的范式革命,为应对航天软件等高复杂度工程挑战

weixin_33812433的博客 362

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

上一篇: 大模型技术原理,从入门到精通!用大白话解释为什么它那么聪明,看这篇就够了!
下一篇: 大模型核心技术入门到精通,啃完这篇3万字“硬核”指南,一篇就够了!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值