


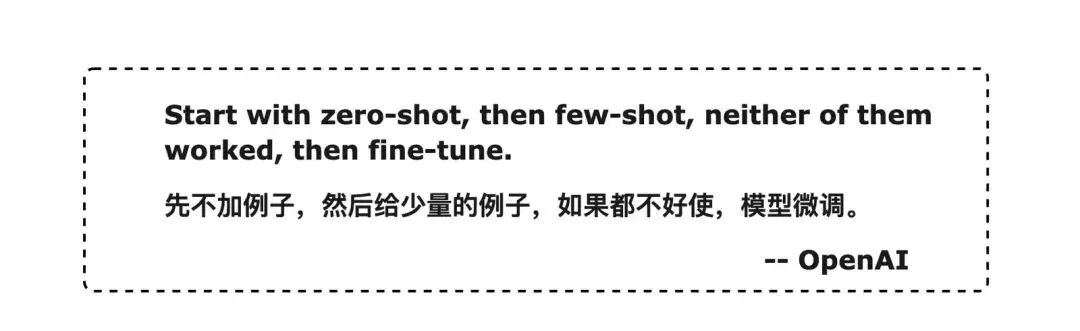
前言:模型微调虽然可以提高任务的效果,但通常来说,微调的成本远大于提示词调优,模型微调相对来说复杂性高、资源需求大而且成本高。
一、微调(Fine-tuning)基础概念
微调(Fine-tuning) 是指在预训练模型(已通过海量通用数据训练完成,具备基础语言理解 / 生成能力)的基础上,使用特定任务 / 领域的数据集(如医疗对话、法律文档分析、代码生成等)进行进一步训练,通过更新模型参数,使模型适配目标任务的过程。
1.1 核心目的
- 弥补预训练数据与目标任务的 “领域差距”(如预训练数据不含专业医疗术语,需通过微调让模型理解医学知识);
- 优化模型在特定任务上的性能(如提升情感分析的准确率、降低机器翻译的 BLEU 误差);
- 避免 “从头训练模型” 的高成本(预训练模型参数量常达百亿 / 千亿级,从头训练需极高计算资源,微调成本远低于此)。
1.2 有监督微调(SFT:Supervised Fine-tuning)
有监督微调(SFT) 指使用带标签的目标任务数据集(如 “输入:用户评价文本 → 输出:正面 / 负面标签”)对预训练模型进行训练,通过 “模型预测结果与真实标签的误差” 反向传播,更新模型参数的过程。SFT 是最常用的微调范式之一,属于 “有监督学习” 范畴,是理解其他微调方法的基础。
核心特点:依赖高质量标注数据(标签准确性直接影响微调效果);训练过程有明确 “监督信号”(真实标签),模型收敛方向更明确;是多数实际应用的 “关键一步”(如对话机器人需通过 SFT 学习 “用户提问→合理回答” 的映射关系)。
二、两大核心微调策略:全量微调(FFT)VS 参数高效微调(PEFT)
根据 “模型参数更新范围”,微调可分为全量微调和参数高效微调两大类,二者在成本、性能、适用场景上差异显著。
3.1 对比总览
| 维度 | 全量微调(FFT:Full Fine-Tuning) | 参数高效微调(PEFT:Parameter-Efficient Fine-Tuning) |
|---|---|---|
| 定义 | 对预训练模型的所有参数进行更新,无参数冻结 | 仅更新模型的一小部分参数(通常 < 1%),其余参数冻结 |
| 参数更新范围 | 100% 模型参数 | 0.1%~1% 模型参数(依方法不同略有差异) |
| 计算 / 存储成本 | 极高(需支持全量参数反向传播,千亿级模型需多卡集群) | 极低(仅更新小部分参数,单卡 GPU 即可支持) |
| 数据依赖 | 需大量标注数据(通常数万~数十万条),否则易过拟合 | 数据需求低(数千~数万条即可),抗过拟合能力更强 |
| 性能上限 | 理论性能最高(可充分适配任务) | 性能接近全量微调(多数场景下差距 < 5%),部分任务可持平 |
| 适用场景 | 数据量充足、计算资源雄厚(如大厂针对核心任务优化) | 资源有限、数据量少、多任务快速适配(如中小企业、个人开发者) |
3.2 分策略详解
(1)全量微调(FFT:Full Fine-Tuning)
- 核心逻辑
将预训练模型视为 “初始权重”,用目标任务的有监督数据重新训练所有层的参数(从输入层到输出层),让模型完全适配目标任务。
-
优势
无参数冻结,模型可充分学习任务特性,在数据量充足时能达到最优性能。
-
劣势
- 成本极高:以千亿参数模型(如 LLaMA-2-70B)为例,全量微调需数十张 A100/H100 GPU,单日训练成本可达数万元;
- 数据需求高:若标注数据不足(如仅数千条),易导致 “过拟合”(模型记住训练数据,泛化能力差);
- 存储压力大:训练过程中需保存大量中间参数(如梯度、优化器状态),对存储容量要求极高。
(2)参数高效微调(PEFT)
PEFT 是针对 FFT “高成本” 痛点提出的技术,核心是 “冻结大部分预训练参数,仅更新少量参数”,在降低成本的同时保持性能。以下是最主流的 PEFT 方法:
① LoRA(Low-Rank Adaptation:低秩适应)
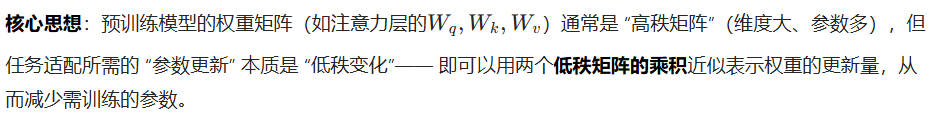
LoRA 是目前应用最广泛的 PEFT 方法,尤其适合大语言模型(LLM)的微调。
- 核心思想:
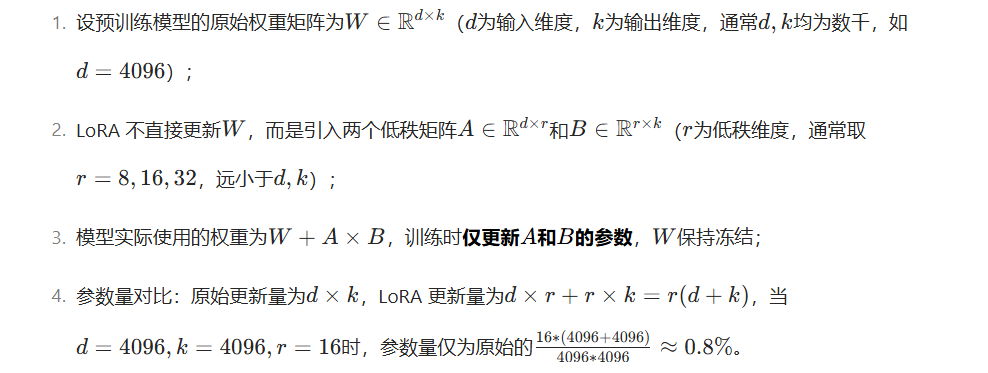
- 数学原理:
- 核心优势:
- 参数压缩比极高,计算 / 存储成本低;
- 训练稳定,不易过拟合;
- 可 “插拔式” 使用(多个任务的 LoRA 矩阵可切换,无需重新训练模型)。
② Prompt-tuning(提示微调)
Prompt-tuning 是通过 “添加可训练的虚拟提示” 适配任务,无需修改模型主体参数。
- 核心思想:在输入文本(如 “这杯咖啡很好喝”)前 / 后添加一组可训练的虚拟 Token(如 “[V1][V2][V3]”,这些 Token 无实际语义,仅用于传递任务信息),训练时仅更新这些虚拟 Token 的参数,模型主体(预训练权重)完全冻结。
- 操作方式:
- 初始化一组虚拟 Token(数量通常为 10~100,如 “[Prompt1]~[Prompt50]”);
- 将 “虚拟 Token + 原始输入文本” 作为模型输入(如 “[Prompt1]…[Prompt50] 这杯咖啡很好喝”);
- 用目标任务的标注数据训练,仅优化虚拟 Token 的嵌入向量,其余参数不变;
- 推理时,将训练好的虚拟 Token 与新输入拼接,即可得到适配任务的输出。
- 核心优势:
- 参数量极少(仅虚拟 Token 的嵌入向量,通常不足 10 万参数);
- 多任务兼容性强(不同任务可对应不同虚拟 Token 组,切换灵活);
- 适合 “小样本任务”(仅需数百~数千条标注数据)。
③ 其他常见 PEFT 方法
-
Prefix-tuning(前缀微调)
:与 Prompt-tuning 类似,但仅在输入开头添加 “可训练的前缀 Token”,且前缀 Token 会参与模型的注意力计算,更适配生成类任务(如文本摘要、对话生成)。
-
Adapter-tuning(适配器微调)
:在模型的特定层(如注意力层后、Feed-Forward 层后)插入小型 “适配器模块”(如 bottleneck 结构:降维→激活→升维),仅训练适配器模块的参数,原始模型参数冻结。
三、大模型微调方法选择总结
选择哪种微调方法,需结合数据量、计算资源、任务类型三者综合判断,具体参考如下:
| 场景条件 | 推荐微调方法 | 典型应用场景 |
|---|---|---|
| 数据量充足(>10 万条)、计算资源雄厚(多卡 A100/H100) | 全量微调(FFT) | 大厂核心业务(如电商平台情感分析、专业机器翻译) |
| 数据量中等(1 万~10 万条)、资源有限(单卡 GPU) | LoRA | 中小企业领域适配(如医疗对话、法律文档问答) |
| 数据量少(<1 万条)、多任务快速切换 | Prompt-tuning/Prefix-tuning | 小样本任务(如特定领域命名实体识别、少量标注的分类任务) |
综上,微调技术的核心是 “以最低成本实现模型的任务适配”—— 全量微调追求 “性能极致”,PEFT 追求 “性价比极致”,而 LoRA 凭借 “低成本 + 高性能” 的平衡,已成为当前大模型微调的主流选择。
四、大模型微调框架对比
在当今蓬勃发展的人工智能时代,大模型微调犹如一把神奇的钥匙,能够开启模型效果提升的大门,使其更好地适应各种特定垂直领域任务。然而,面对市场上琳琅满目的微调工具,如何从中挑选出最契合自身需求的平台,着实成为了一项颇具挑战性的难题。接下来,让我们深入对比分析 LLaMA-Factory、Unsloth、MS-Swift和MindSpeed-LLM这四个主流的微调框架,为打造你的专属行业大模型助力。
| 对比维度 | LLaMA-Factory | Unsloth | MS-Swift | MindSpeed LLM |
|---|---|---|---|---|
| 框架定位 | 开源大模型微调框架,主打模块化与多场景适配 | 开源 LLM 微调加速工具,聚焦性能与效率优化,显存优化型训练加速引擎 | 多模态大模型全栈工具链 | 昇腾硬件深度优化框架 |
| 社区生态 | GitHub 53K Star,中文社区活跃,提供 Web UI 工具 | Hugging Face 生态兼容,GitHub 12K Star,开发者论坛活跃 | 阿里ModelScope 官方框架,整合天池 / 魔搭社区资源 | 华为昇腾社区双轨支持,兼容 MindSpore/PyTorch 双后端 |
| 主要优势 | 1. 模块化设计:优化微调和推理全流程,易上手 2. 多硬件自适应:自动调整计算精度,适配不同设备 3. 量化技术:支持 4/8 位量化,降低内存占用 | 1. 高速微调:比传统方法快 2 倍及以上 2. 低内存占用:减少高达 80% 内存使用3. 主流模型兼容:适配最新热门 LLM 4.显存效率极致优化(8GB 可训 150 亿参数),训练速度提升 2.5-10 倍 | 500 + 模型支持,多模态 DPO 训练,推理吞吐量提升 20 倍 | 昇腾 910B 训练速度超 A100 2.3 倍,支持千亿参数模型分布式训练 |
| 局限 | 全参微调速度较慢,存在历史安全漏洞 | 社区较新文档不完善,依赖 Triton 内核经验 | 生态依赖性强,脱离 ModelScope 扩展性受限 | 硬件适配单一,非昇腾环境支持有限 |
| 硬件支持 | NVIDIA/AMD/Ascend GPU、Mac M 系列芯片 | 主要支持 NVIDIA GPU: NVIDIA T4/A10/A100/H100 GPU | NVIDIA GPU 为主,部分支持 Ascend NPU(算子兼容问题) | 昇腾 910B/910C NPU,支持训推共卡 |
| 模型支持 | 100 + 模型(LLaMA 3、Mixtral MoE、LLaVA 等) | Llama-3、Mistral、Phi-4 等主流模型,兼容 Hugging Face 格式 | 500 + 纯文本模型(Qwen2.5、InternLM3)、200 + 多模态模型 | LLaMA、Qwen、DeepSeek、GLM-4.5 等,新增 MindSpore 后端 |
| 训练效率 | 全参微调速度较 Unsloth 慢 30%,支持 DeepSpeed 分布式 | A100 40GB 可处理 70B 模型,GRPO 流程优化 | 多卡训练效率提升 40%(DDP+FSDP),集成 vLLM 加速 | 千亿参数模型分布式训练效率领先,GRPO 训练速度提升显著 |
| 显存优化 | 动态量化(2-8bit)+ 梯度检查点,8B 模型微调显存 10GB | 动态 4-bit 量化 + Triton 内核重写,显存占用减少 80% | PEFT 技术 + 混合精度训练,显存占用降低 70% | 算子融合 + 内存复用,70B 模型训练显存 32GB(GRPO 优化后) |
| 微调策略 | 全参微调、LoRA、QLoRA,支持 DPO、SimPO 对齐 | LoRA、QLoRA、动态量化训练,GRPO 强化学习 | LoRA+、GaLore、Q-GaLore,多模态 DPO 训练 | QLoRA、DPO、PPO,支持训推共卡模式 |
| 易用性 | 低代码 Web UI,数据标注 - 训练 - 部署一键式操作 | API 简洁,5 分钟上手,提供 Colab 一键启动脚本 | 依赖 ModelScope 数据工具,多模态任务配置模板化 | 需熟悉 Ascend-CANN 工具链,昇腾专用 SDK |
| 典型场景 | 多模态内容生成、行业大模型私有化部署(金融 / 医疗) | 资源受限环境快速迭代、学术研究原型开发 | 多模态对话系统、长文本生成(16K Token) | 昇腾集群部署的千亿参数模型训练、金融风控 / 政务合规场景 |
| 官网 / 仓库 | GitHub | GitHub | ModelScope + GitHub | 昇腾社区 + GitHub |
如何学习大模型 AI ?
我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
2025最新大模型学习路线
明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。
对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。
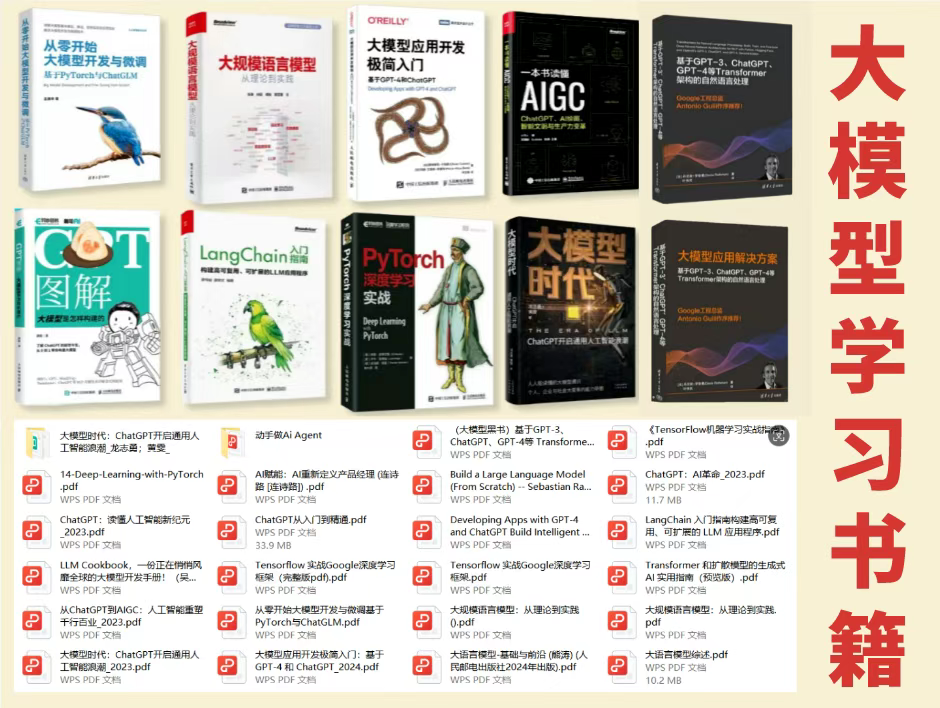
大模型经典PDF书籍
新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
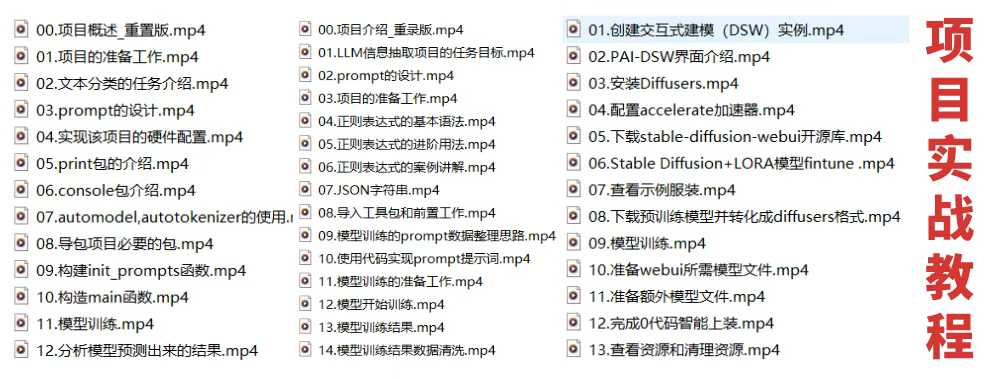
配套大模型项目实战
所有视频教程所涉及的实战项目和项目源码等
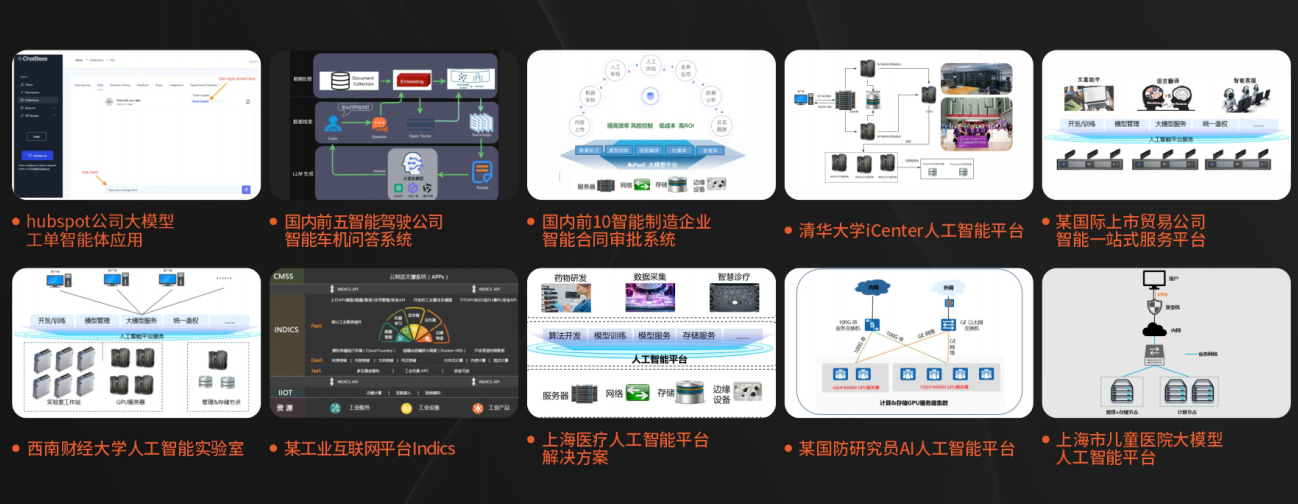
博主介绍+AI项目案例集锦
MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

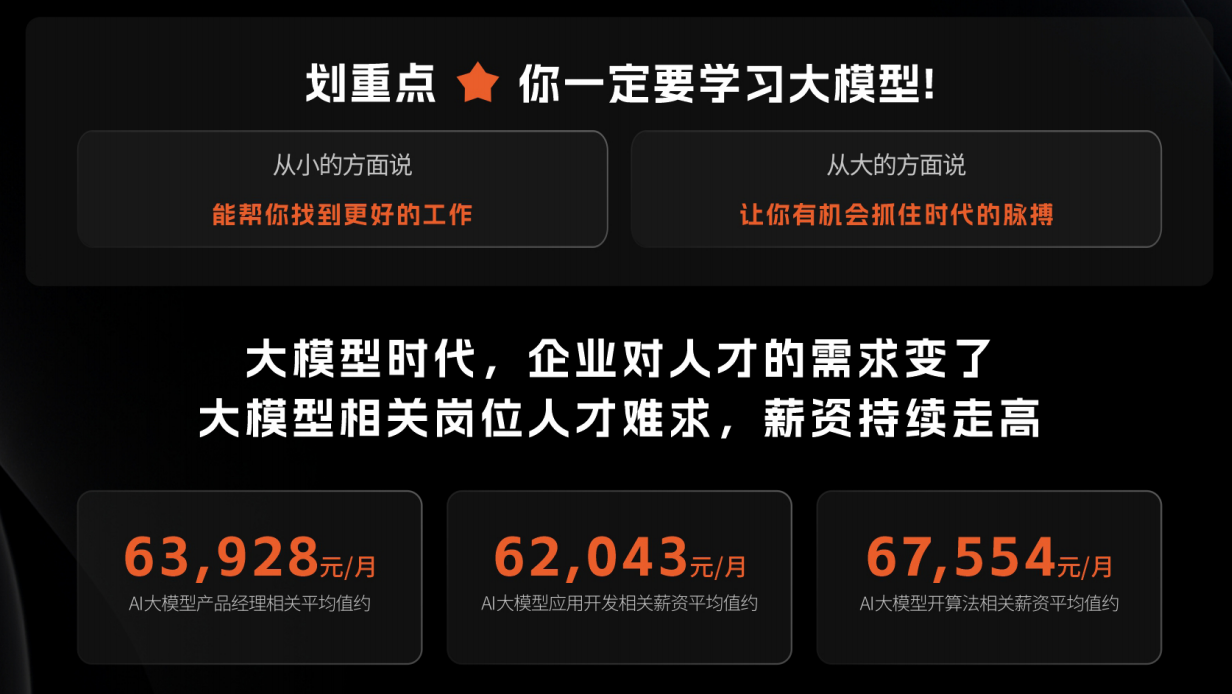
为什么要学习大模型?
2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
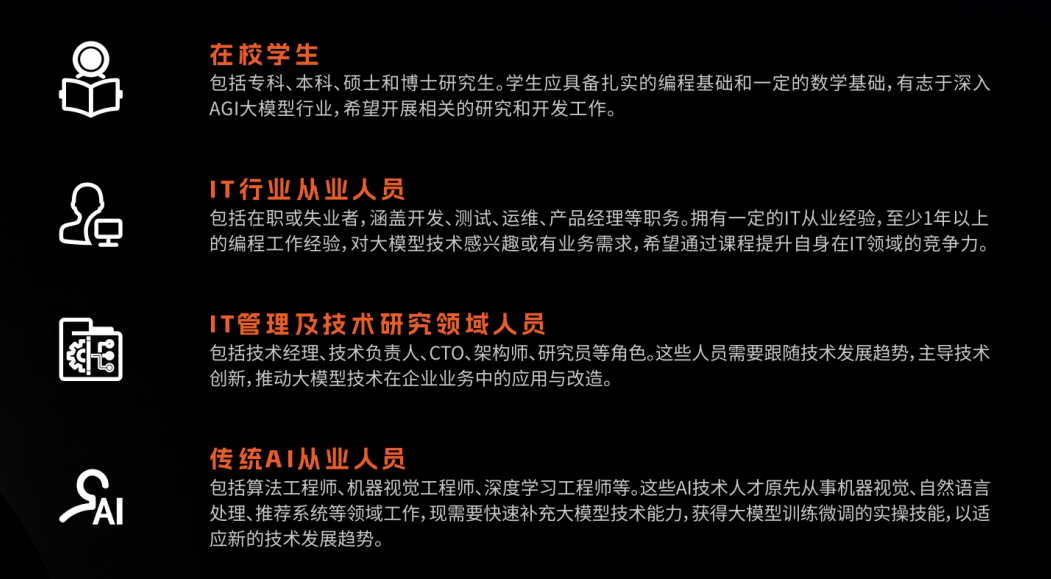
适合人群
- 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
- IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
- IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
- 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
课程精彩瞬间
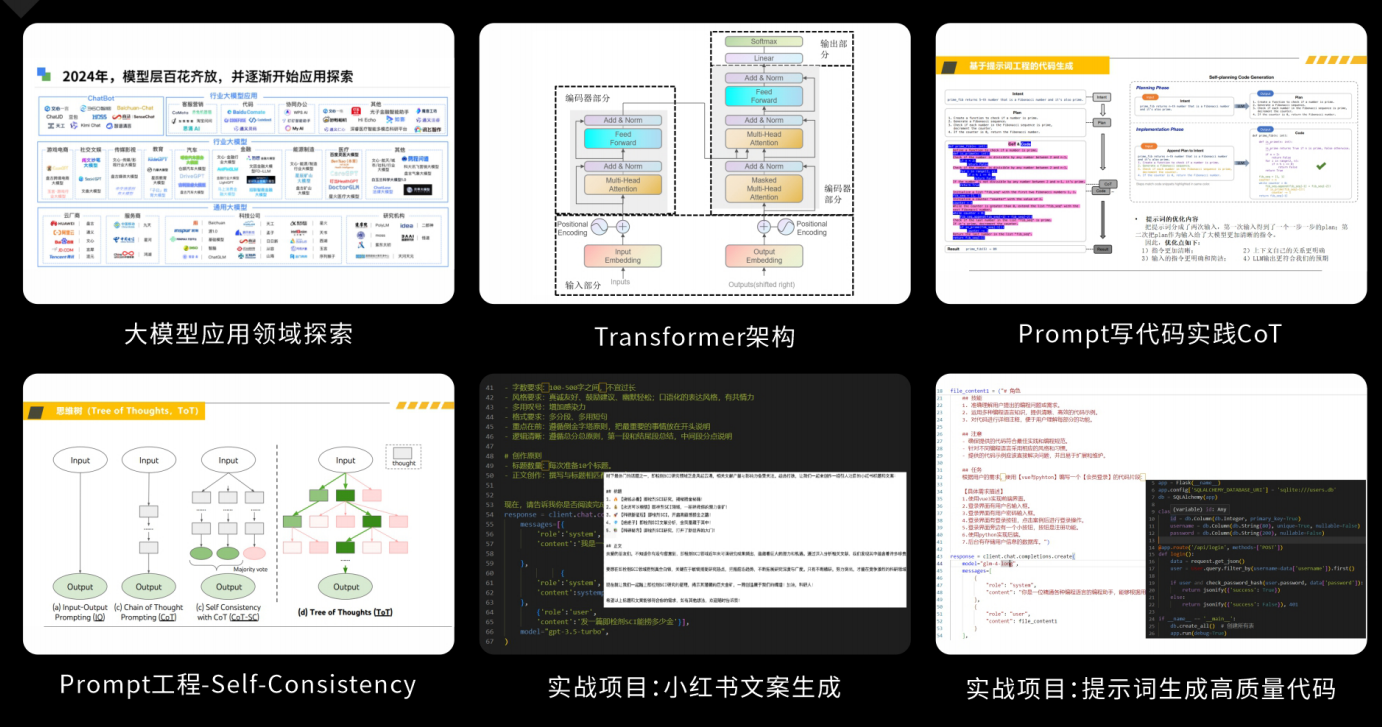
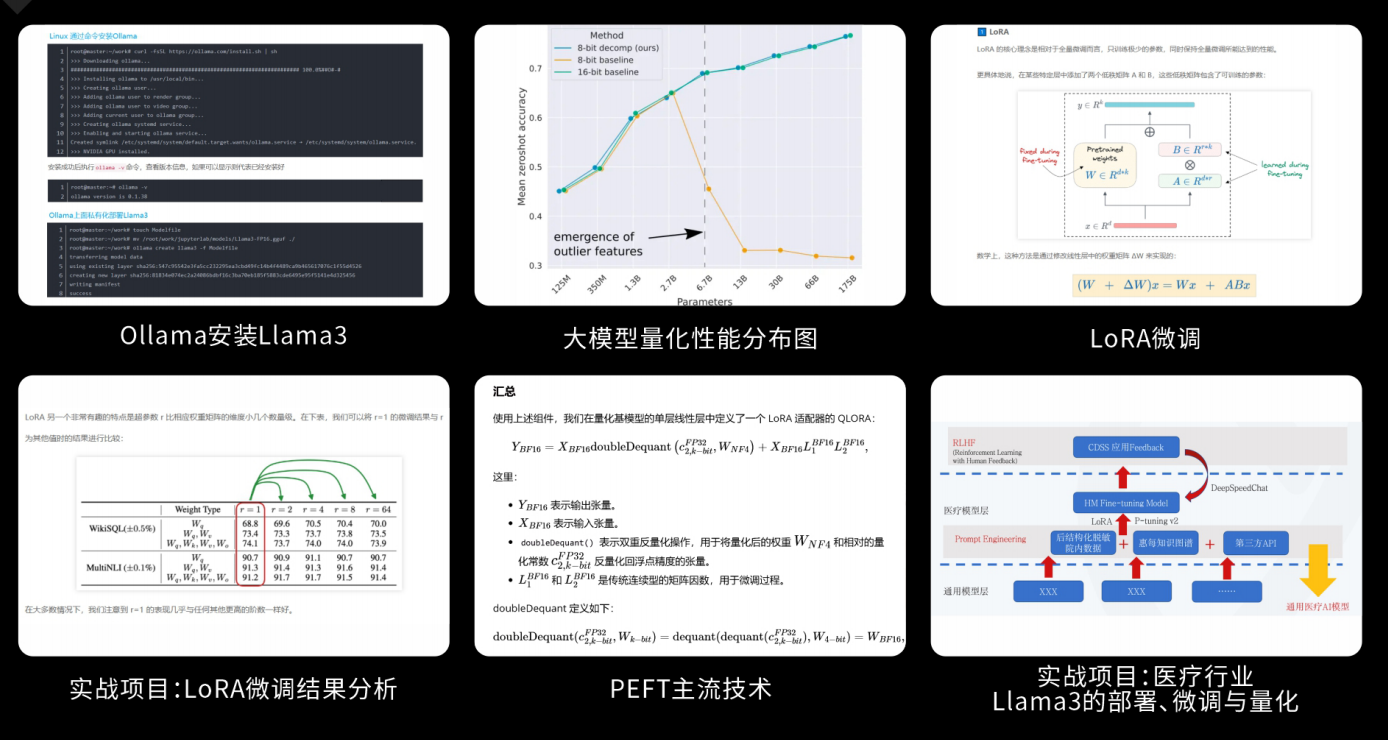
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。
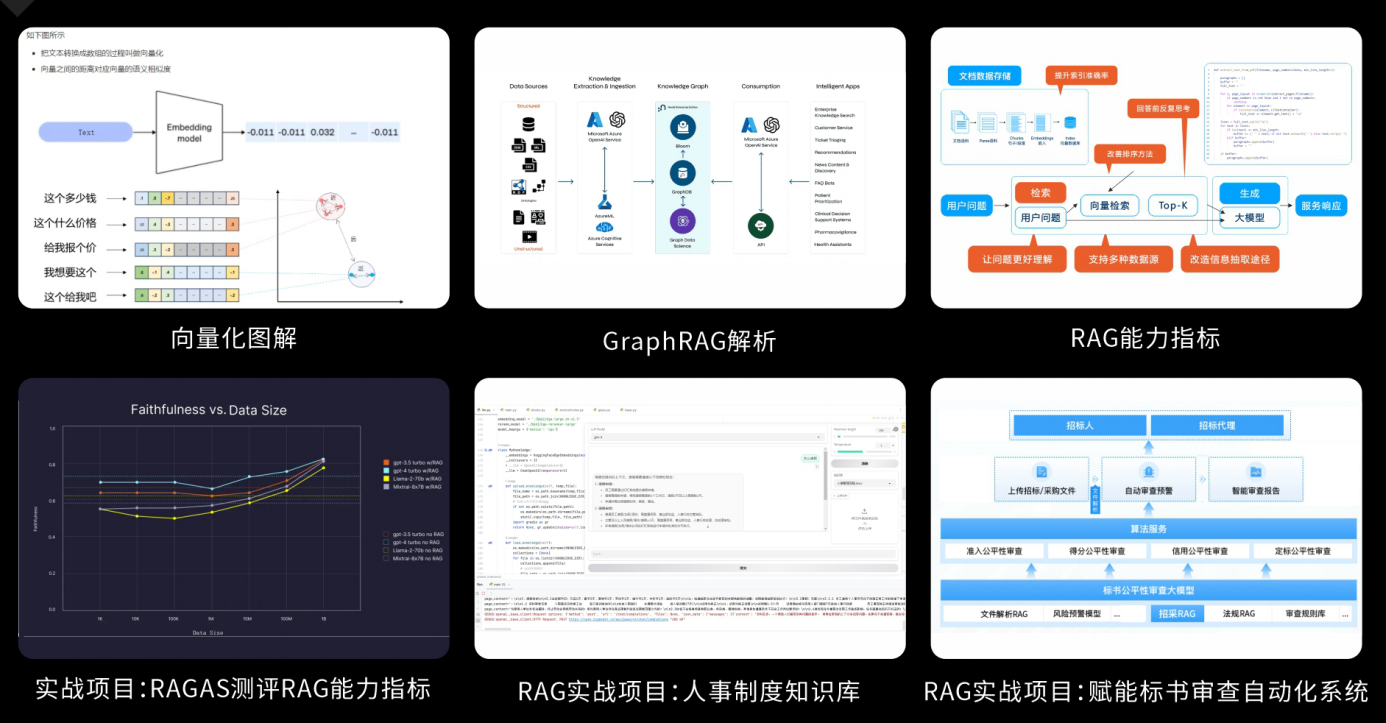
RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。
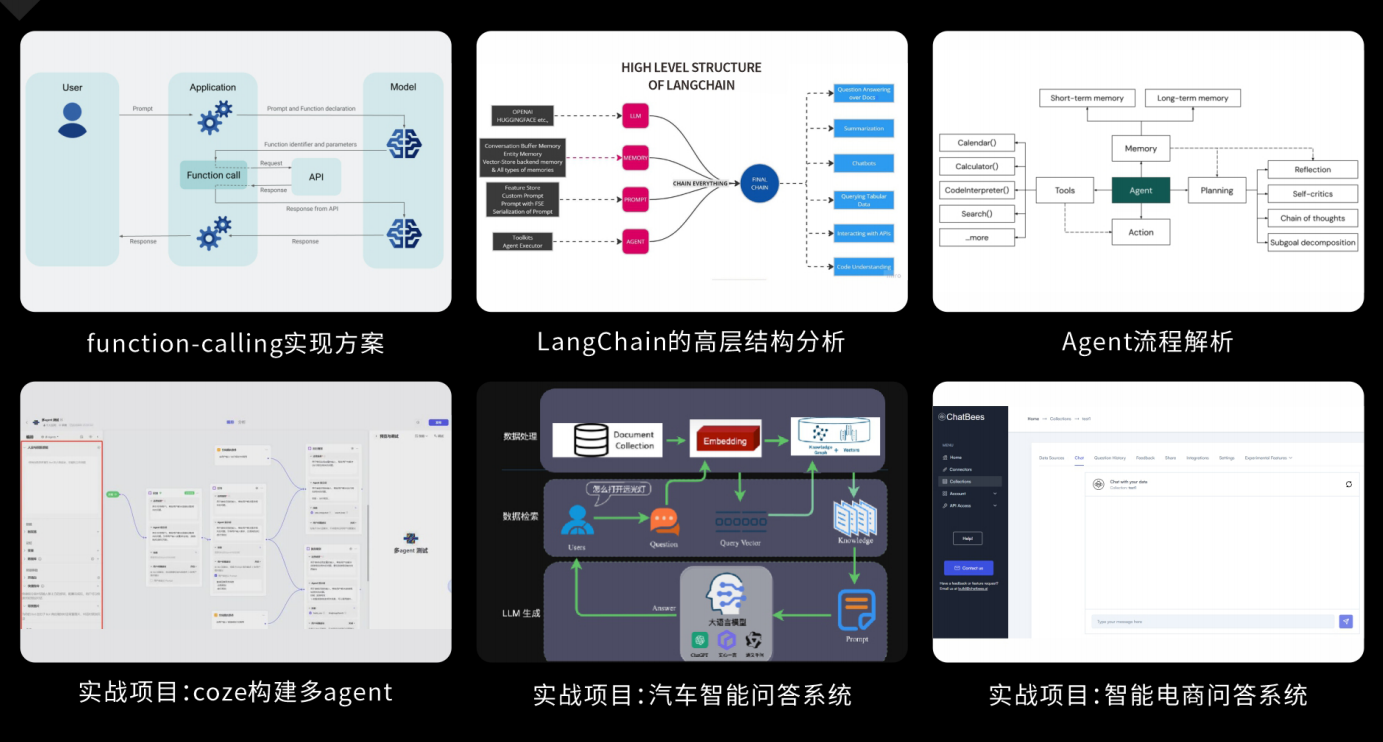
Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。
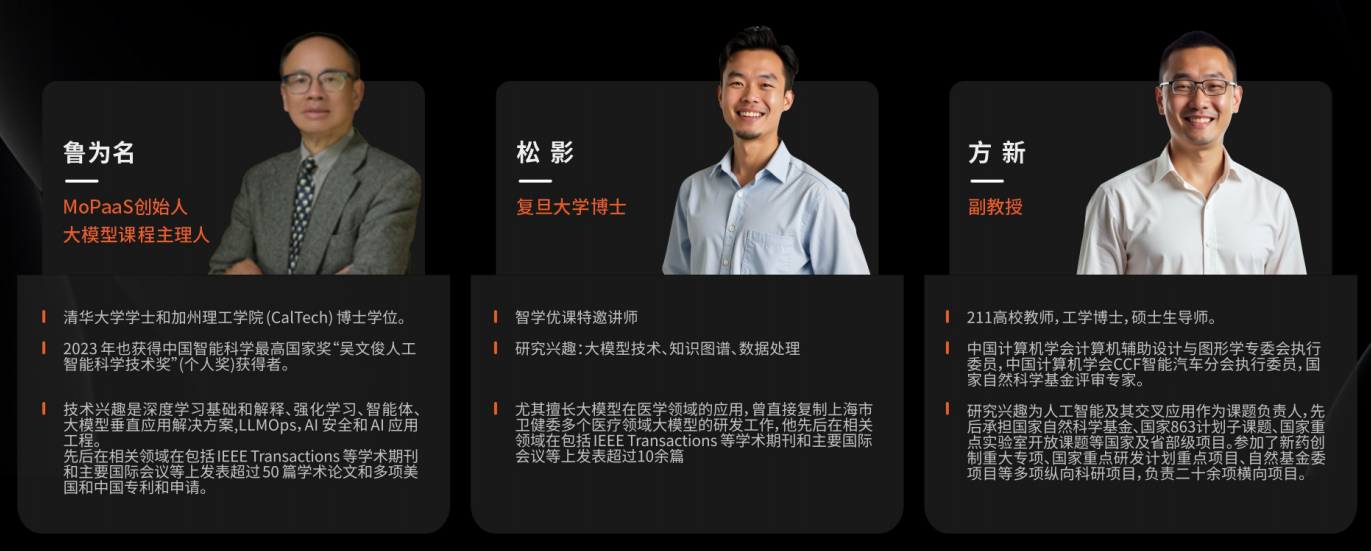
顶尖师资,深耕AI大模型前沿技术
实战专家亲授,让你少走弯路
一对一学习规划,职业生涯指导
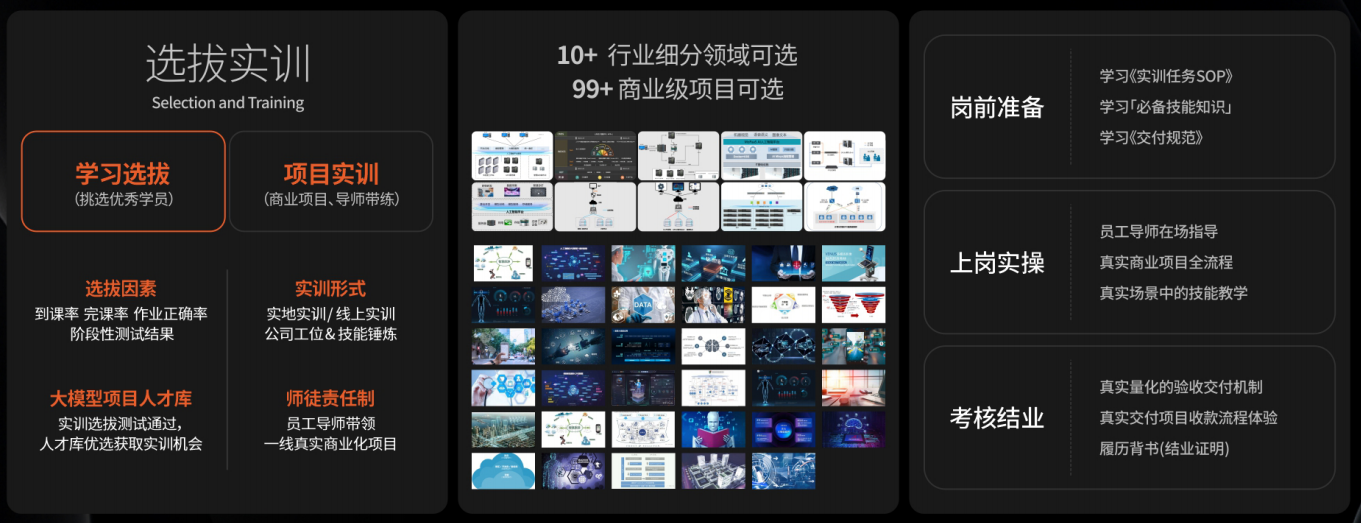
- 真实商业项目实训
- 大厂绿色直通车
人才库优秀学员参与真实商业项目实训
以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调
大厂绿色直通车,冲击行业高薪岗位
文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 6765


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


