收藏级!ACL 2025结构化知识提示全攻略:从理论到落地避坑指南

人工智能和计算机视觉领域国际学术会议submission 人工智能和计算机视觉领域国际学术会议submission参考。 阅读详情

一、引言

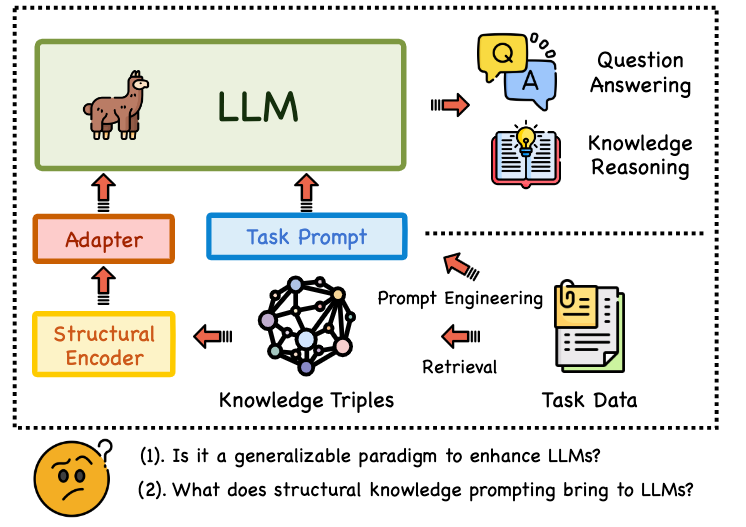
本论文关注大型语言模型(LLMs)在知识密集型任务中面临的关键挑战:事实准确性不足。虽然结构化知识提示(Structural Knowledge Prompting, SKP)通过将知识图谱(KGs)的结构化表示整合到LLMs中,显著提升了如问答和知识图谱补全等任务的性能,成为主流范式,如下图所示,已有的SKP通常用一个结构编码器+适配器的形式将从KG中提取到的结构化信息注入LLM,但现有研究大多聚焦于特定任务应用,缺乏对SKP范式本身泛化能力的系统性评估。
img

本文旨在填补这一空白,首次对SKP的泛化能力进行全面审视,围绕四个核心维度展开:知识粒度(Granularity)、跨任务与元素的可迁移性(Transferability)、可扩展性(Scalability) 以及对不同LLM的普适性(Universality)。为此,作者构建了一个全新的多粒度、多难度基准测试集 SUBARU 来支撑这项评估。

二、方法

结构化提示的工作流程

SKP的核心目标是将知识图谱(KG)的结构化信息高效注入大型语言模型,以提升其事实准确性。其工作流程分为三步:

知识抽取与编码: 给定用户查询 ,从外部知识图谱 中检索相关元素(实体 、关系 或子图)。通过预训练的结构编码器 如 TransE、R-GCN)将每个元素转化为向量嵌入。

表示空间对齐: 由于 KG 嵌入与 LLM 的文本表示空间存在异构性,需通过适配器(Adapter) 进行映射。适配器将结构嵌入转换为与 LLM 词向量维度对齐的提示 token

对于单个提示token而言,整个过程可以表示为:

论文测试了四类适配器:单层全连接(FC)、多层感知机(MLP)、混合专家(MoE)和 QFormer。

LLM 协同推理: 生成的提示 token 序列与原始查询 拼接,输入冻结的 LLM。LLM 基于联合输入生成答案:

训练时仅优化适配器参数,损失函数为标准的Next-token Prediction损失
img

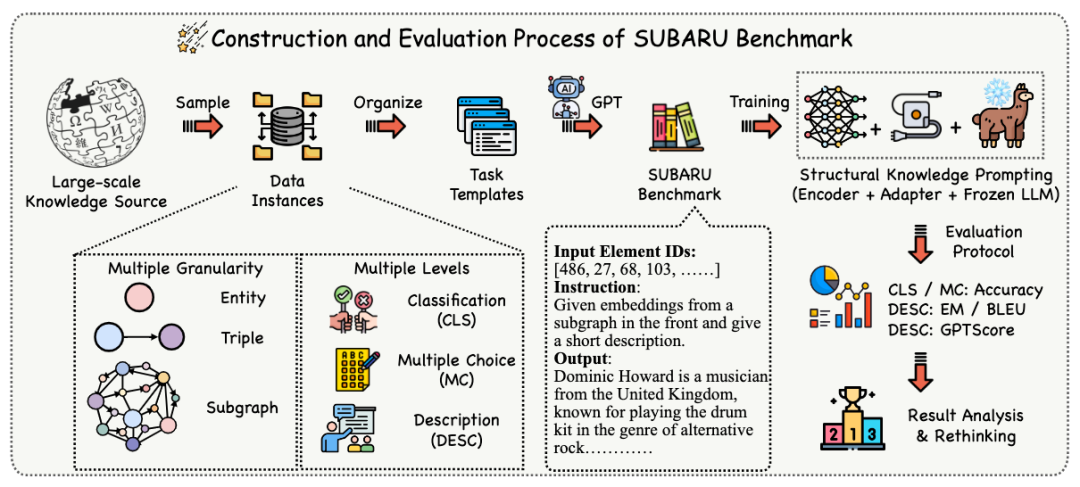
SUBARU数据集的构建逻辑

为系统性评估 SKP 的泛化能力,作者设计了 SUBARU 基准,其构建遵循两个核心原则:多粒度知识覆盖与任务难度分层。SUBARU设计了三种不同的任务粒度和三种不同的任务难度。

三种粒度:

  • 实体级(EG)
  • 三元组级(TG)
  • 子图级(SG)

三种难度:

  • 分类(CLS)
  • 选择(MC)
  • 描述(DESC)

**实例采样。**首先,我们从KG中按不同粒度采样实体/三元组/子图实例,以准备不同的任务。对于EG任务,我们采样大约2万个具有充分描述的实体,比例为8:1:1。对于TG任务,我们使用CoDeX-M三元组的拆分来构建数据集。对于SG任务,我们从EG任务中选择实体,然后随机采样它们的一跳和二跳邻域以构建子图。同时,每个任务都有特定设置。对于CLS任务,我们将一个实体ID与其真实的简短名称视为正例。对于TG和SG,我们将从现有KG中采样的每个三元组和子图视为正例。

我们进一步通过随机扰动生成负样本,保持1:1的比例。在MC任务中,我们为每个实例采样四个选择:对于EG,我们预测实体名称;对于TG和SG,我们预测缺失的实体。TG-MC中的缺失实体预测类似于传统的KGC任务,预测给定查询(h, r, ?)中的缺失尾实体。对于SG,查询提供一个子图,其中缺少一个核心实体,要求预测子图中缺失的实体。对于DESC任务,实体、三元组和子图的描述作为生成的目标。实体和三元组的描述直接来自CoDeX数据集,而子图描述是使用{GPT-3.5-turbo}生成的。

任务训练集验证集测试集
Entity CLS3212240164016
Entity MC1609620122013
Entity DESC1606120082008
Triple CLS3711682062020622
Triple MC1855841031010311
Triple DESC1855841031010311
Subgraph CLS2945439985142
Subgraph MC1472719992571
Subgraph DESC7453931939

**提示生成。**从CoDeX KG中采样后,我们通过为每个任务应用手工编写的指令提示I来创建特定任务的实例,将这些实例转换为文本格式以便进一步评估。遵循现有的范式,我们将SKP放置在输入序列的前面,向LLM提供来自KG的结构化信息。为了客观评估模型利用这些SKP的能力,我们去除了指令模板中相关元素的重要文本信息,使模型主要依靠SKP而不是文本来完成任务,以评估SKP的利用效果。

三、实验分析

作者在SUBARU上进行了广泛的实验,测试了多种结构编码器和适配器组合,主要使用Llama3-8B作为基础LLM,并扩展到其他LLM验证普适性。核心发现如下:

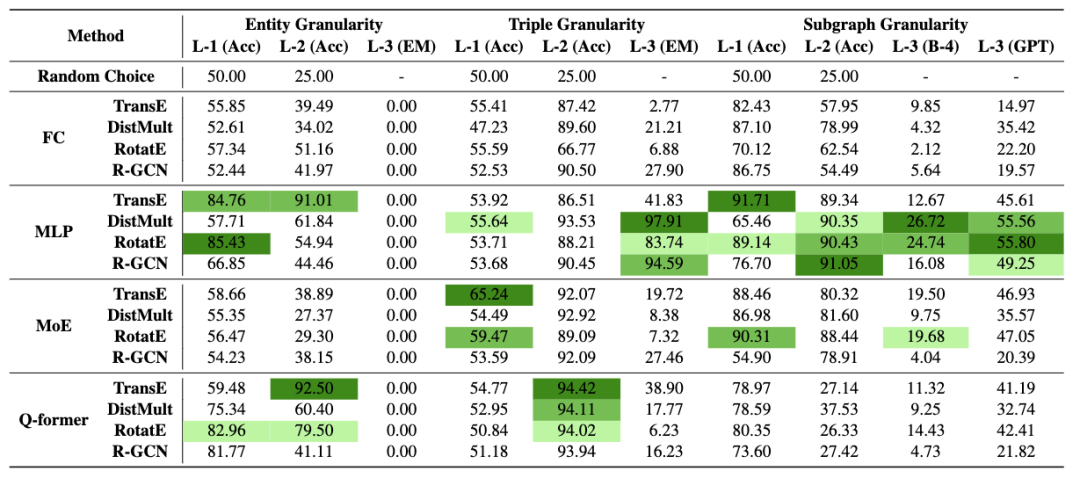
知识粒度(RQ1):实验表明,MLP适配器在绝大多数任务中表现最佳,甚至优于更复杂的QFormer或MoE。SKP在粗粒度推理(三元组级/TG和子图级/SG的多选问答/MC任务)上表现出色,说明它能有效整合子图或三元组级别的结构化信息辅助LLM决策。然而,SKP在细粒度理解上存在明显局限:它几乎完全无法完成实体级描述生成(EG-DESC)任务,表明LLM无法仅凭SKP准确识别和理解新的、未见过的实体细节。案例研究进一步证实,SKP模型生成的子图描述能捕捉大致语义关联(如职业、领域),但无法精确复现关键实体名称。
img

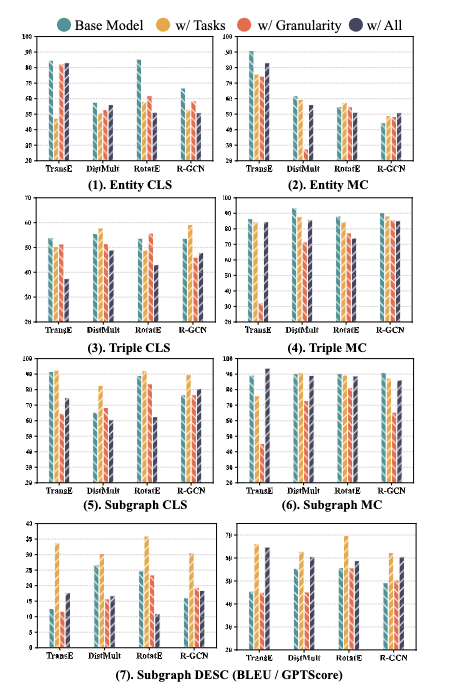
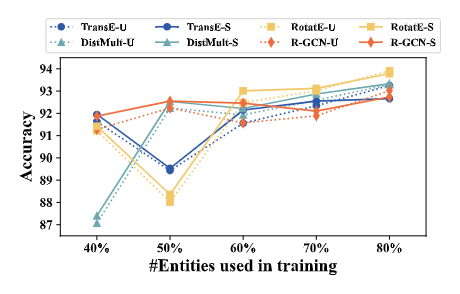
可迁移性(RQ2):评估跨任务迁移性时发现,混合训练来自不同粒度或难度的任务数据,对提升目标任务性能帮助有限,表明当前SKP架构的跨任务泛化能力不强。但在处理新元素(如新实体) 方面,三元组级任务(TG-MC)展现了令人鼓舞的结果:模型在预测涉及未见实体的三元组时,性能接近其在已知实体上的表现,且训练数据中涵盖更多实体有助于提升这种归纳能力。
img

img

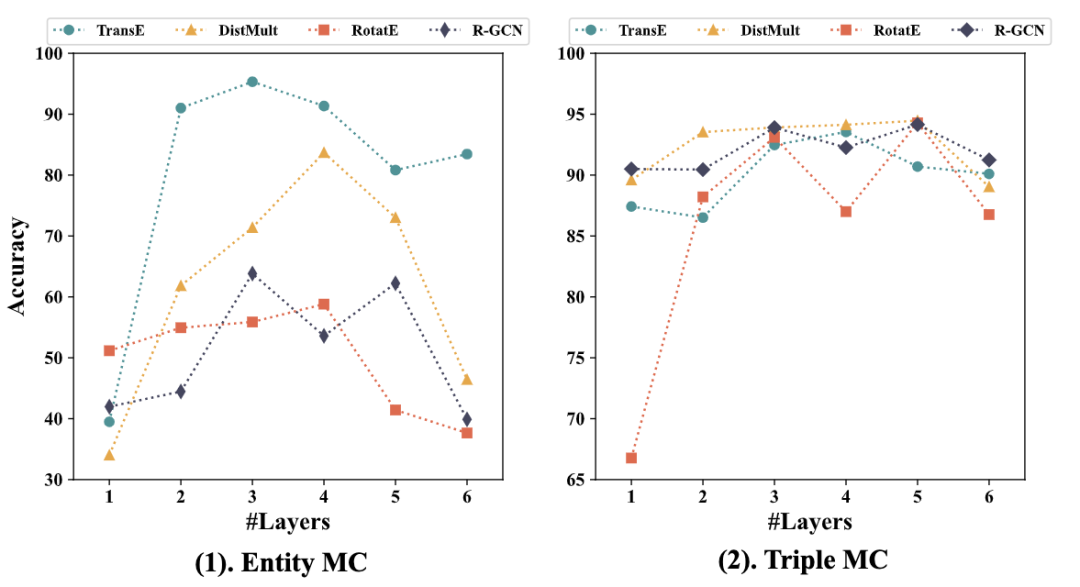
可扩展性(RQ3):研究适配器深度(MLP层数)的影响发现,性能并非随深度单调增长。3-4层的MLP通常能达到最佳效果,更深层可能导致性能下降。这表明适配器存在一个舒适区,过深的网络在当前数据规模下可能引入不必要的复杂性或训练难度。
img

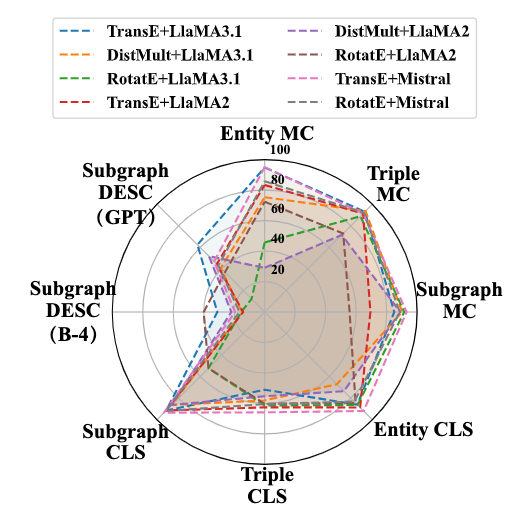
普适性(RQ4):SKP范式被证明具有较好的模型无关性。在Llama2-7B、Llama3-8B和Mistral-7B等不同架构的LLM上应用SKP,整体性能趋势保持一致,尽管不同LLM间存在微小差异。这证实了SKP作为一种增强LLM知识能力的通用方法是可行的。
img

案例分析:

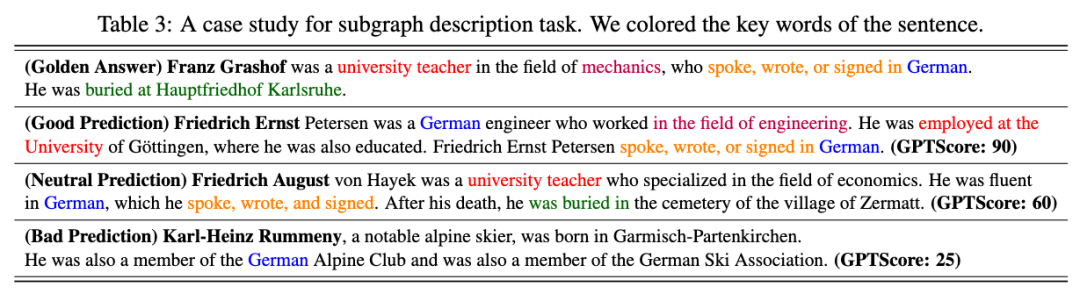
在我们在SUBARU基准测试中设计的三个难度级别中,分类(CLS) 和多选问答(MC) 任务能提供明确的答案和量化指标,便于精确比较模型性能。然而,对于子图描述生成(DESC) 任务而言,评估生成文本的质量更具主观性。因此,本节通过案例研究分析SKP模型在描述子图结构时的能力。本案例研究的目的并非比较不同SKP模型的性能差异,而是揭示其在描述中存在的共性特征。

如图5所示,我们展示了一个简单案例:提供标准答案(Golden Answer)与多个不同SKP模型的预测结果(均以人工描述形式呈现)。通过观察可得出以下两点关键结论:

  1. 所有SKP模型均无法准确识别中心实体,这突显了SKP在传递高度精确和个性化信息上的能力缺失。这也解释了为何表2中所有SKP模型均在实体级描述任务(EG DESC)中失败——该任务要求精确识别实体。
  2. SKP模型展现出对粗粒度知识的理解能力:模型能捕捉输入SKP中实体与关系的语义关联,并在生成文本中体现理解。优秀的预测结果可解码出SKP中隐含的信息(如职业、专业领域、国籍、技能等)。

综上可知,SKP能为LLMs提供粗粒度信息以大致理解子图结构,却难以处理细节信息(如具体名称、地点或专业术语)。尽管SKP擅长识别实体属性等宏观知识,但其缺乏对细粒度细节的认知能力。考虑到文本生成与深层理解是LLMs的核心能力,我们认为未来SKP的改进应聚焦于通过额外的提示token激活更精确、细粒度的信息。
img

四、结论

本研究首次对结构化知识提示(SKP)范式进行了系统性的泛化能力评估。核心结论是:当前的SKP方法(尤其是结合MLP适配器)能有效地为LLMs注入粗粒度的结构化知识,显著提升其在子图和三元组级别推理任务(如知识图谱补全、多选问答)上的表现。然而,研究也揭示了其关键局限性:无法实现细粒度的、精确的事实感知,特别是在理解和描述新实体方面能力欠缺;跨任务迁移性较弱;适配器的可扩展性也存在边界(3-4层最佳)。

这些发现对领域发展具有重要意义:它们解释了现有SKP方法在特定任务(如QA, KGC)上成功的原因(擅长粗粒度推理),同时也为未来研究指明了方向——需要设计更先进的SKP方法,以突破其细粒度理解和新元素泛化的瓶颈,从而更全面地提升LLM的事实准确性。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
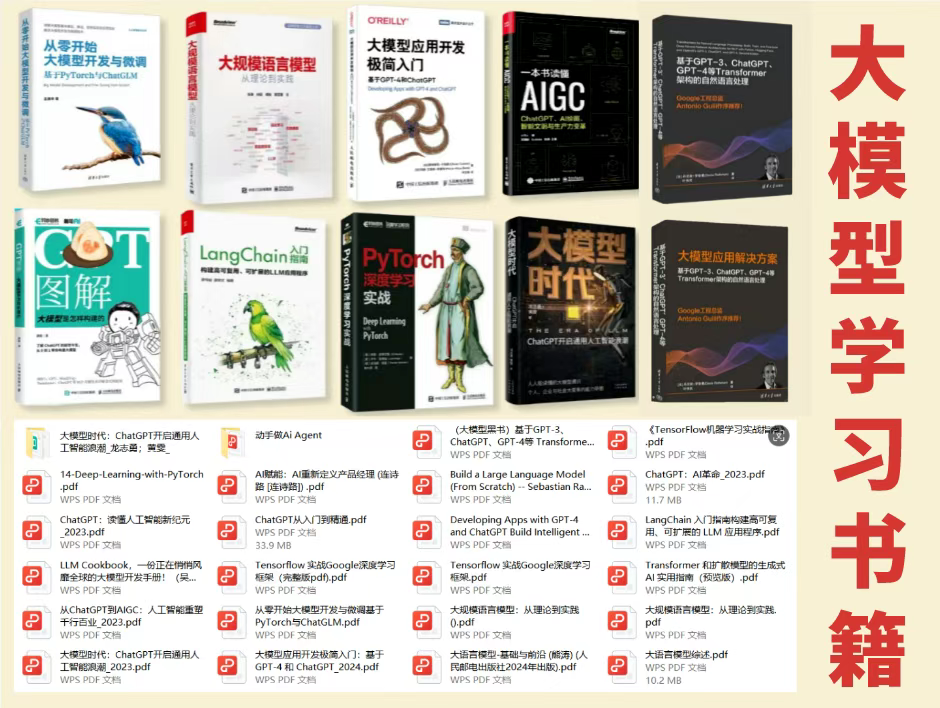
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
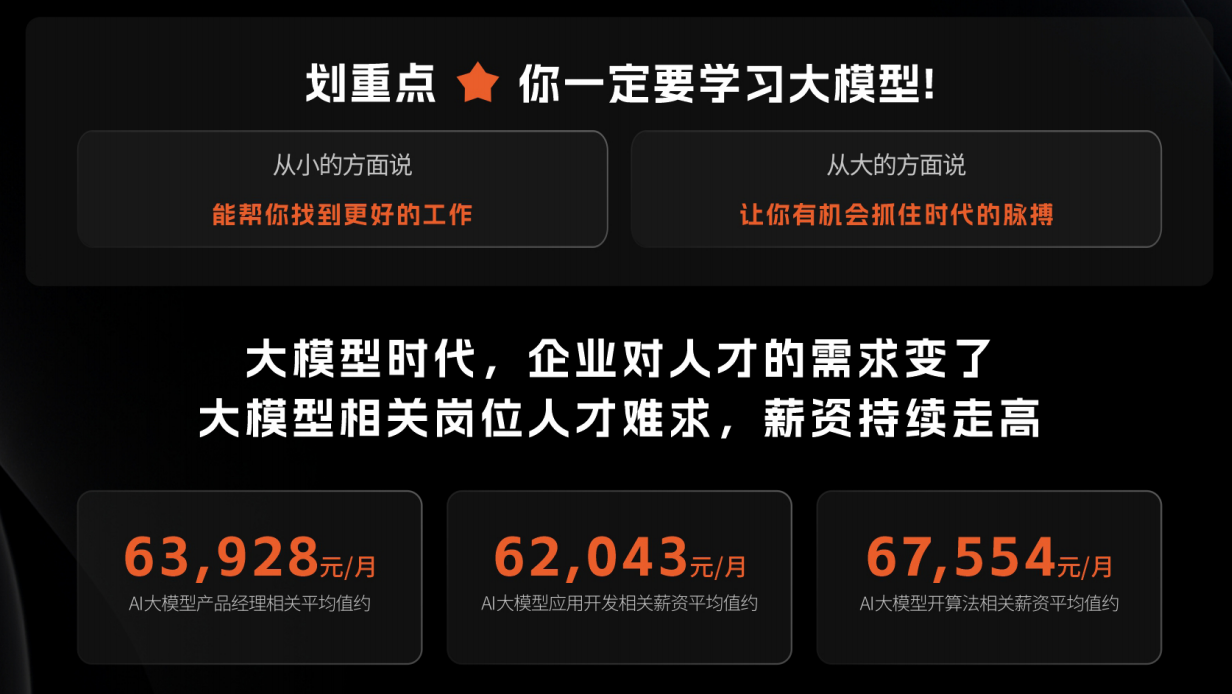
在这里插入图片描述

适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

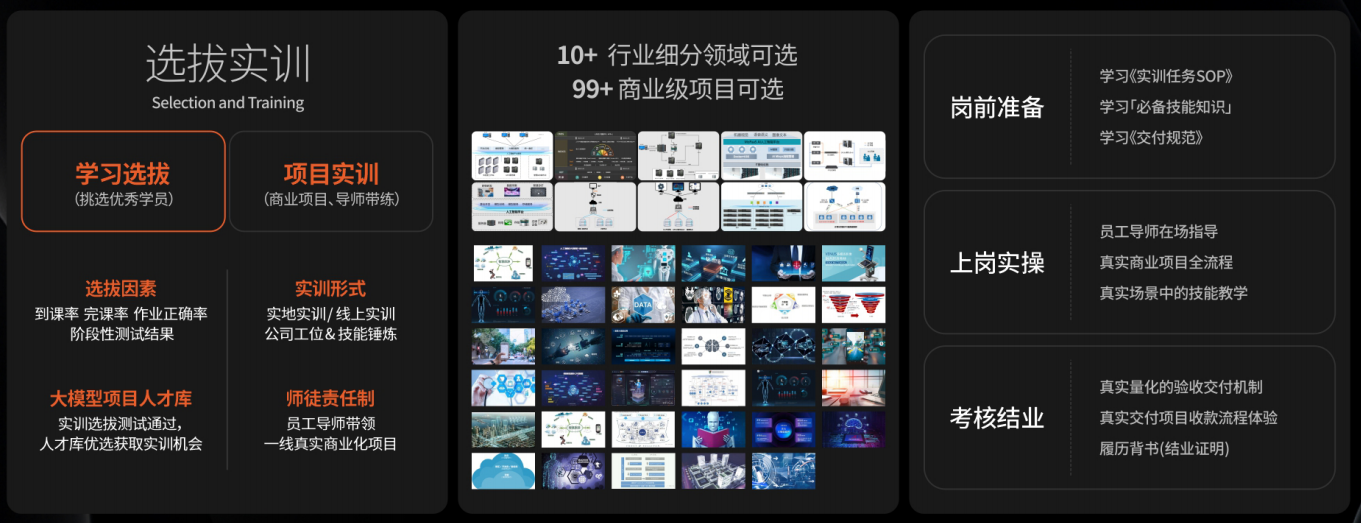
  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

自然语言处理领域CCF推荐的A类期刊 这些CCF推荐的A类期刊和会议是NLP领域内公认的高质量研究发表平台,对于从事自然语言处理研究的学者和研究人员来说,它们是展示最新研究成果、交流学术思想的重要场所。该会议由美国人工智能协会(AAAI)主办,每年举办一次,是AI领域内极具影响力的学术盛会。ICML是机器学习领域的顶级会议,自然语言处理作为机器学习的一个重要应用领域,也有很多相关的研究发表在ICML上。官方网站:http://www.informatik.uni-trier.de/~ley/db/conf/iccv/index.html。 阅读详情

相关推荐

网络安全认证全攻略:从入门到精通的职业发展路径与实战指南

网络安全认证是信息安全领域专业能力的重要凭证,其核心价值在于系统化验证从业者的知识体系与实战技能。从原理上看,认证体系通常遵循从基础理论到专项技术,再到管理与合规的递进逻辑,旨在构建完整的职业能力框架。在技术价值层面,权威认证不仅能提升个人市场竞争力,更是企业招聘与内部晋升的重要参考标准。当前,随着云安全、数据隐私保护、实战化攻防等成为行业高频搜索关键词,相关认证的热度持续攀升。这些认证紧密贴合企业上云、数据合规、主动防御等应用场景,为从业者提供了清晰的学习路径与能力证明。本文聚焦于网络安全认证的战略规划与

weixin_30298497的博客 401

ACL 2025最佳论文全解析:四大突破揭秘,引领自然语言处理未来风向标!

在2025年7月27日至8月1日于奥地利维也纳举行的第63届计算语言学协会年会(ACL 2025)大会圆满落幕,作为自然语言处理领域最具影响力的顶级会议,今年的最佳论文奖再次汇聚了业界最前沿的创新成果。四篇获奖论文不仅在理论上取得突破,更在实际应用中展现出强大的推动力,涵盖了语言理解、生成、模型优化等多个关键方向。本文将带你深入剖析这四篇重量级论文,解读它们背后的技术亮点与未来潜力,帮你全面把握自然语言处理的最新风向和发展趋势。

AI_gurubar的博客 4652

iSCSI存储配置全攻略

iSCSI存储配置指南摘要 本文详细介绍了iSCSI存储的配置方法,包括服务端(Target)和客户端(Initiator)的完整设置流程。服务端配置涵盖存储空间准备、targetcli安装、后备存储创建、Target和IQN设置、ACL访问控制、LUN映射、门户配置等关键步骤。客户端配置包括软件安装、IQN设置、服务启停、目标发现和登录等操作。通过TCP/IP网络模拟SCSI接口,iSCSI实现了远程块存储设备的访问和管理,适用于需要高性能网络存储的场景。文档提供了具体的命令示例和配置说明,帮助管理员快速

2301_81276162的博客 1092

ACL介绍

涵盖计算语言学的最新研究成果,包括自然语言处理、机器翻译、文本生成等。提交的论文需通过严格的同行评审,录用率较低,通常只接受高质量的研究工作。内容更注重实际应用、商业化成果和工业界的研究挑战。接受已完成或进行中的研究,评审会提供建设性反馈。适合学术界和工业界的研究人员展示核心研究成果。重点在于技术的实际应用和交互性,而非理论研究。适合研究人员深入探讨特定主题,并与同行交流。,聚焦工业界在自然语言处理中的应用和创新。,展示已实现的系统、工具或应用程序。,为学生提供展示研究的平台。:特定主题的深入讨论。

weixin_50882278的博客 3252

研一脑电小白日记 之 EEGLAB预处理实战指南

本文为脑电研究新手提供了一份详尽的EEGLAB预处理实战指南。从MATLAB与EEGLAB环境搭建、使用NeuracleEEGFileReader插件导入BDF格式数据开始,逐步讲解了电极定位、滤波、降采样、ICA去伪迹等核心步骤,旨在帮助初学者高效完成脑电数据预处理,为后续分析奠定坚实基础。

weixin_29230649的博客 557

蓝桥杯历年真题分类汇总(史上最全版本,一定不要错过)

天再高又怎样,踮起脚尖就更接近阳光。 满满的 题型总结​ 历年真题​ 视频讲解​ 比赛技巧 题型总结 2021 2020 2019 2018 2017 2016 2015 2014 2013 ...

m0_58367586的博客 11万+

卷上天了!ACL 2025投稿ID首次破万

2025各大顶会陆续出了DDL,有小伙伴压点提交ACL 2025的时候已经将近8500号了,照这个趋势下去加上12月的,应该能冲击12000。肝论文的各位同学们还好嘛?发过顶会的同学都知道,做科研最主要还是靠自己,一篇能被录取的论文需要正确的方向+优雅的idea+扎实的工作。以下分享一下如何单打独斗发顶会的个人建议:1.保持学术热情,多看最新的顶会paper,多观看一些学术报告,寻找合话的研究t...

Paper weekly 1061

机械臂抓取前言

机械臂相关的笔记

weixin_64037619的博客 3908

A类顶会ACL 2026投稿全攻略:时间、地点、录取率

undefined

ConferenceEye的博客 6768

Welch 方法详解:一种经典而实用的功率谱密度估计方法

在信号处理领域,谱分析是用于分析信号频率内容的强大工具。Welch方法是现代谱分析中一种广泛使用的功率谱密度估计技术,由Peter D. Welch在1967年提出。它通过对信号进行分段、加窗和平均化处理,提供了一种平滑且稳定的频谱估计方法。Welch方法通过将信号分成多个重叠的段,每段应用窗函数,然后计算每段的周期图,最后对所有周期图进行平均化,得到平滑的功率谱密度估计。welch_psd函数接收信号x、采样频率fs、每段的样本数N、重叠样本数overlap和窗函数类型window。

DuHz的博客 7053

Oracle-如何修复undo坏快

undo出现坏快,导致数据库宕机,无法启动

qqqyyy0422的博客 570

2025年人工智能领域CCF推荐A类国际会议全攻略:带你了解人工智能领域国际顶级会议全貌

2025年人工智能领域CCF推荐A类国际会议概览:本文详细介绍了7个AI领域顶级国际会议的最新信息。AAAI(录用率17.6%)、CVPR(22.1%)、ICCV(24%)、ICML(26.9%)、NeurIPS(24.52%)、ACL(20.3%)和IJCAI(19.3%)等会议投稿量持续攀升,竞争日趋激烈。各会议均采用双盲评审,注重创新性和严谨性,投稿需特别注意格式规范和匿名要求。这些会议在学术界和工业界具有高度认可度,发表论文对职业发展有显著加成。文章还提供了各会议的具体时间地点、投稿截止日期及官网链

点亮创新之光,照亮科研梦想 6526

企业信息化系统的组成模块-核心业务系统

通过标准化的数据流形成完整的业务闭环,CRM生成的销售订单驱动ERP的生产和采购,ERP将生产计划传递给MES执行,MES报工数据返回ERP进行成本核算,ERP再将交付信息同步给CRM供客户查询。生产管理确保高效交付,缩短订单周期。某贸易公司实施ERP供应链模块后,库存周转率从每年4次提升到8次,库存资金占用从2000万降到1200万,释放800万现金流,同时缺货率从15%降到5%。│ │库存 │ │ MRP │ │ ERP │ │ 云ERP/ │ │。

weiyvyy的博客 695

2025年昇腾CANN训练营第二季全攻略:从零基础到算子开发专家

昇腾CANN训练营简介 昇腾CANN训练营是华为推出的人工智能开发者培训计划,专注于昇腾AI处理器和CANN(Compute Architecture for Neural Networks)异构计算架构的技术培训。本训练营面向AI开发者、算法工程师和高校学生,提供从基础理论到实战开发的全方位培训。报名链接:点击这里报名昇腾训练营本文将全面解析2025年昇腾CANN训练营第二季的学习内容、课程体系、实践项目以及进阶路径。作为华为昇腾AI生态的重要组成部分,CANN训练营为开发者提供了系统化的算子开发能力培养

摘星编程的博客 4404

详解Pytorch求导

本文主要详解Pytorch求导,希望能对学习Pytorch的同学有所帮助。 文章目录 1. pytorch求导问题 2. pytorch三大类求导代码示例 2.1 标量求导 2.2 向量求导&矩阵求导

weixin_43178406的博客 3073

ThingsBoard教程(十九):规则节点概览介绍

在ThingsBoard的CE V2.5.6版本中,一共有这几种类型在每一种类都有包含了多个节点,每一种类型的节点都有不同的颜色表示本篇文章做一个简单的概括,后续的文章会详细讲解每一个种类的节点如何使用,每一个节点的使用。一共有10个,使用黄色表示 过滤器节点用于消息过滤和路由。一共有9个,使用绿色 属性节点用于更新传入消息的元数据。一共三个,使用蓝色 转换节点用于更改传入消息字段,如发起者、消息类型、有效负载和元数据。一共21个,使用红色标识 动作节点根据传入的消息执行各种动作。一共9个,使用黄色表示,

知无涯 1万+

2025 IDM免费使用全攻略:从原理到实践的完整指南

Internet Download Manager(IDM)作为业界领先的下载加速工具,其30天试用限制一直是用户面临的主要障碍。本文将系统解析IDM免费激活的核心技术,对比当前主流解决方案,提供从基础激活到企业级部署的完整实施指南,并深入探讨开源激活脚本的工作原理与定制方法。通过本文介绍的开源激活脚本,用户可以实现IDM的长期免费使用,同时确保系统安全性与稳定性。 ## 问题解析:IDM试用限

gitblog_00113的博客 79

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

收藏!大模型赛道全攻略:从入门认知到就业保研精准导航

这些模型通常由深度神经网络构建而成,拥有数十亿甚至数千亿个参数。大模型的设计目的是为了提高模型的表达能力和预测性能,能够处理更加复杂的任务和数据。大模型在各种领域都有广泛的应用,包括。

优快云_224022的博客 1086

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

华为HCIE要学些什么?HCIE Datacom报名流程全攻略(2025最新版)

实验考试要求在规定时间内完成一整套企业网络设计与配置,内容综合度高、时间紧迫,对实战能力要求非常高。Datacom方向,聚焦企业网络、数据中心、广域互联等关键场景,考试内容更强调设计、部署与排障能力。答:掌握从基础网络知识到高级路由、安全、虚拟化、企业网设计等全栈能力,具备网络架构、部署与排障的综合实力。作为华为认证体系中的最高级别,,如中大型企业园区网、分支互联网络、数据中心内部网络等,要求你不仅“会配置”,更要“会设计”。因此,如果你想节省时间、提高效率,建议选择专业的华为认证培训机构,比如。

SPOTO_2003的博客 2021

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

收藏!2026大模型Agent高薪赛道解析,小白/程序员入门进阶全攻略

2026年AI行业彻底迎来,相比趋于饱和的传统开发岗位,大模型AI Agent岗位凭借超高薪资、海量人才缺口,成为程序员、AI小白转行、进阶的黄金赛道。当下行业人才竞争格局早已更新,据2026年最新行业数据显示,AI Agent工程师岗位同比暴涨310%,行业人才缺口超500万,岗位供需比高达1:8,薪资溢价较传统开发岗位高出71%。目前多家一线科技企业开出招聘大模型AI Agent算法专家,资深架构师年薪更是可达100-200万,应届生、1-3年经验从业者也能轻松斩获50w+年薪总包。

youmaob的博客 425

2025大模型学习详细路线,零基础到精通,保姆级教程,我愿称之为大模型最牛学习路线!

正如前面提到过的那样,AI是一个日新月异的领域,新的发现层出不穷。到了最后这个阶段,您的目标应该是成为一名真正的专家。从零基础小白成长为大模型领域的专家是一条漫长而充满挑战的道路,但只要抱持着对AI的热情,持续不断地学习和实践,相信每位渴望转型的人都能够在这一充满活力的新领域找到自己的位置。• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

2401_84494441的博客 3691

终极指南:Pointer-Generator模型训练与部署全攻略(2025版)

训练Pointer-Generator模型时遭遇神秘NaN值导致训练中断?ROUGE评估配置反复报错?数据集准备耗费数天却无法正常加载?作为ACL 2017年的经典摘要模型,Pointer-Generator的代码库在2025年仍被广泛使用,但官方文档对复杂场景的覆盖不足,导致开发者平均浪费40小时在环境配置和bug修复上。本文将系统解决12类核心问题,提供经生产环境验证的解决方案,助你2小时内完...

gitblog_00798的博客 889

怎么备考2025下半年软考中级网络工程师:小白逆袭全攻略(零基础速通版)

“上午背协议背到怀疑人生,下午配路由配到手抽筋——新教材居然加了Wi-Fi 7和AI运维?!” 报名完就想躺到天荒地老?起来卷! 成都考区8月30日缴费截止,11月9日开考,只剩60天!作为软考中级里 "命令多如毛、协议深似海" 的科目,2025年教材偷偷加了 Wi-Fi 7配置、AI驱动网络、零信任安全架构(又要多背300页),别慌!这套 "救命式冲刺法",小白亲测有效

DD666521的博客 915

新手小白九月底备考网络工程师,一个月冲刺拿证全攻略!

朋友们,看到这篇帖子说明你做了一个明智的选择——网络工程师在软考中级科目里算是比较友好且实用的!九月底才开始准备,时间确实紧张,但我要告诉你:一个半月拿下网工证书,完全有可能!

DD666521的博客 925

保姆级教程!一文拆解操作系统智能体:MLLM如何让计算设备“像人一样思考”(全攻略),收藏这篇就够了!

创造如《钢铁侠》中虚构角色 J.A.R.V.I.S 般强大且多才多艺的 AI 助理,一直以来都是人们梦寐以求的目标。随着(多模态)大语言模型((M)LLMs)的发展,这一梦想正逐步照进现实。基于 (M)LLM 的智能体通过在操作系统(OS)所提供的环境与界面(如图形用户界面 GUI)中运行,从而在计算设备(例如计算机和移动电话)上自动执行任务,其能力已取得显著进展。本文对这一类先进的智能体进行了全面综述,我们称之为 **操作系统智能体(OS Agents)**。

m0_59163425的博客 806

2026大模型技术面试全攻略:核心模块与实战解析

Transformer架构作为现代大模型的基石,其自注意力机制和多头注意力实现是理解大模型工作原理的关键。随着模型规模突破万亿参数,分布式训练中的3D并行、ZeRO优化等技术成为工程实践的核心。在推理部署环节,动态批处理、量化压缩等优化手段能显著提升服务性能,其中vLLM框架的连续批处理技术可降低显存碎片。大模型在商业落地时还需关注伦理合规,如内容过滤系统的多级审核架构设计。掌握从PyTorch实现到DeepSpeed优化的全链路技能,是应对2026年大模型技术面试的关键,特别是在处理百万级并发的提示工程系

weixin_34277853的博客 495
上一篇: 听劝!别再手动调参了,LangChain+RAG三步搭建生产级问答系统
下一篇: 别再单打独斗!多智能体工作流全解析:从L1到L5自主等级,一篇吃透企业级落地
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值