


导语
你是否也遇到过这样的情况:RAG系统里的LLM明明很强大,Prompt也精心调校过,但最终的问答效果就是不尽如人意?答案时常上下文不全,甚至出现事实性错误。
我们排查了检索算法,优化了Embedding模型,却往往忽略了数据进入向量库之前的最关键一步:文档分块。
不恰当的分块,就像是给模型提供了一堆被打乱顺序、信息残缺的“坏数据”。模型能力再强,也无法从支离破碎的知识中推理出正确、完整的答案。可以说,分块的质量,直接决定了RAG系统性能的下限。
这篇文章,我们就来深入聊聊这个基础却至关重要的环节。本文不谈空泛的理论,而是聚焦于各类分块策略的实战代码和经验总结,希望能帮你为你的RAG系统打下最坚实的地基。
1. 分块的本质:为何与如何
分块的必要性源于两个核心限制:
•模型上下文窗口:大语言模型(LLM)无法一次性处理无限长度的文本。分块是将长文档切分为模型可以处理的、大小适中的片段。•检索信噪比:在检索时,如果一个文本块包含过多无关信息(噪声),就会稀释核心信号,导致检索器难以精确匹配用户意图。
理想的分块是在上下文完整性与信息密度之间找到最佳平衡。chunk_size和 chunk_overlap是调控这一平衡的基础参数。chunk_overlap通过在相邻块之间保留部分重复文本,确保了跨越块边界的语义连续性。
2. 分块策略详解与代码实践
2.1 基础分块策略
2.1.1 固定长度分块
这是最直接的方法,按预设的字符数进行切割。它不考虑文本的任何逻辑结构,实现简单,但容易破坏语义完整性。
•核心思想:按固定字符数 chunk_size 切分文本。•适用场景:结构性弱的纯文本,或对语义要求不高的预处理阶段。
from langchain_text_splitters importCharacterTextSplitter
sample_text =("LangChain was created by Harrison Chase in 2022. It provides a framework for developing applications ""powered by language models. The library is known for its modularity and ease of use. ""One of its key components is the TextSplitter class, which helps in document chunking.")
text_splitter =CharacterTextSplitter(    separator =" ",# 按空格分割    chunk_size=100,# 增大块大小    chunk_overlap=20,# 调整重叠比例    length_function=len,)
docs = text_splitter.create_documents([sample_text])for i, doc in enumerate(docs):print(f"--- Chunk {i+1} ---")print(doc.page_content)
2.1.2 递归字符分块
LangChain推荐的通用策略。它按预设的字符列表(如 ["\n\n", "\n", " ", ""])进行递归分割,尝试优先保留段落、句子等逻辑单元的完整性。
•核心思想:按层次化分隔符列表进行递归切分。•适用场景:绝大多数文本类型的首选通用策略。
from langchain_text_splitters importRecursiveCharacterTextSplitter
# 使用与上文相同的 sample_texttext_splitter =RecursiveCharacterTextSplitter(    chunk_size=100,    chunk_overlap=20,# 默认分隔符为 ["\n\n", "\n", " ", ""])
docs = text_splitter.create_documents([sample_text])for i, doc in enumerate(docs):print(f"--- Chunk {i+1} ---")print(doc.page_content)
**参数调优说明:**对于固定长度和递归分块,chunk_size 和 chunk_overlap 的设置至关重要:
•chunk_size: 决定了每个块的大小。块太小,可能导致上下文信息不足,模型无法充分理解;块太大,则可能引入过多噪声,降低检索的信噪比,并增加API调用成本。通常根据嵌入模型的最佳输入长度和文本特性来选择,例如 256, 512, 1024。•chunk_overlap: 决定了相邻块之间的重叠字符数。设置合理的重叠(如 chunk_size 的10%-20%)可以有效防止在块边界处切断完整的语义单元(如一个长句子),是保证语义连续性的关键。
2.1.3 基于句子的分块
以句子为最小单元进行组合,确保了最基本的语义完整性。
•核心思想:将文本分割成句子,再将句子聚合成块。•适用场景:对句子完整性要求高的场景,如法律文书、新闻报道。
import nltktry:    nltk.data.find('tokenizers/punkt')except nltk.downloader.DownloadError:    nltk.download('punkt')
from nltk.tokenize import sent_tokenize
def chunk_by_sentences(text, max_chars=500, overlap_sentences=1):    sentences = sent_tokenize(text)    chunks =[]    current_chunk =""for i, sentence in enumerate(sentences):if len(current_chunk)+ len(sentence)<= max_chars:            current_chunk +=" "+ sentenceelse:            chunks.append(current_chunk.strip())# 创建重叠            start_index = max(0, i - overlap_sentences)            current_chunk =" ".join(sentences[start_index:i+1])if current_chunk:        chunks.append(current_chunk.strip())return chunks
long_text ="This is the first sentence. This is the second sentence, which is a bit longer. Now we have a third one. The fourth sentence follows. Finally, the fifth sentence concludes this paragraph."chunks = chunk_by_sentences(long_text, max_chars=100)for i, chunk in enumerate(chunks):print(f"--- Chunk {i+1} ---")print(chunk)
注意事项:语言模型的选择许多标准库的默认配置是为英文设计的。例如,nltk.tokenize.sent_tokenize 默认使用基于英文训练的Punkt模型进行分句。如果直接用于处理中文文本,会因无法识别中文标点而导致分句失败。 处理中文时,必须采用适合中文的分割方法,例如:
•基于中文标点符号(如 。!?)的正则表达式进行切分。•使用加载了中文模型的NLP库(如 spaCy, HanLP 等)进行更准确的分句。
2.2 结构感知分块
利用文档固有的结构信息(如标题、列表、对话轮次)作为分块边界,这种方法逻辑性强,能更好地保留上下文。
2.2.1 结构化文本分块
•核心思想:根据Markdown的标题层级或HTML的标签来定义块的边界。•适用场景:格式规范的Markdown、HTML文档。
from langchain_text_splitters importMarkdownHeaderTextSplitter
markdown_document ="""# Chapter 1: The Beginning
## Section 1.1: The Old WorldThisis the story of a time long past.
## Section 1.2: A New HopeA new hero emerges.
# Chapter 2: The Journey
## Section 2.1: The Call to AdventureThe hero receives a mysterious call."""
headers_to_split_on =[("#","Header 1"),("##","Header 2"),]
markdown_splitter =MarkdownHeaderTextSplitter(headers_to_split_on=headers_to_split_on)md_header_splits = markdown_splitter.split_text(markdown_document)
for split in md_header_splits:print(f"Metadata: {split.metadata}")print(split.page_content)print("-"*20)
2.2.2 对话式分块
•核心思想:根据对话的发言人或轮次进行分块。•适用场景:客服对话、访谈记录、会议纪要。
dialogue =["Alice: Hi, I'm having trouble with my order.","Bot: I can help with that. What's your order number?","Alice: It's 12345.","Alice: I haven't received any shipping updates.","Bot: Let me check... It seems your order was shipped yesterday.","Alice: Oh, great! Thank you.",]
def chunk_dialogue(dialogue_lines, max_turns_per_chunk=3):    chunks =[]for i in range(0, len(dialogue_lines), max_turns_per_chunk):        chunk ="\n".join(dialogue_lines[i:i + max_turns_per_chunk])        chunks.append(chunk)return chunks
chunks = chunk_dialogue(dialogue)for i, chunk in enumerate(chunks):print(f"--- Chunk {i+1} ---")print(chunk)
2.3 语义与主题分块
这类方法超越了文本的物理结构,根据内容的语义含义进行切分。
2.3.1 语义分块
•核心思想:计算相邻句子/段落的向量相似度,在语义发生突变(相似度低)的位置进行切分。•适用场景:知识库、研究论文等需要高精度语义内聚的文档。
import osfrom langchain_experimental.text_splitter importSemanticChunkerfrom langchain_huggingface importHuggingFaceEmbeddings
os.environ["TOKENIZERS_PARALLELISM"]="false"embeddings =HuggingFaceEmbeddings(model_name="sentence-transformers/all-MiniLM-L6-v2")
# 创建 SemanticChunker 实例# LangChain 的 SemanticChunker 默认使用 percentile 阈值# 可以尝试不同的 breakpoint_threshold_type: "percentile", "standard_deviation", "interquartile", "gradient"text_splitter =SemanticChunker(    embeddings,    breakpoint_threshold_type="percentile",# 使用百分位作为阈值类型    breakpoint_threshold_amount=70# 设置阈值为80)print("SemanticChunker configured.")print("-"*50)
long_text =("The Wright brothers, Orville and Wilbur, were two American aviation pioneers ""generally credited with inventing, building, and flying the world's first successful motor-operated airplane. ""They made the first controlled, sustained flight of a powered, heavier-than-air aircraft on December 17, 1903. ""In the following years, they continued to develop their aircraft. ""Switching topics completely, let's talk about cooking. ""A good pizza starts with a perfect dough, which needs yeast, flour, water, and salt. ""The sauce is typically tomato-based, seasoned with herbs like oregano and basil. ""Toppings can vary from simple mozzarella to a wide range of meats and vegetables. ""Finally, let's consider the solar system. ""It is a gravitationally bound system of the Sun and the objects that orbit it. ""The largest objects are the eight planets, in order from the Sun: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune.")
docs = text_splitter.create_documents([long_text])
for i, doc in enumerate(docs):print(f"--- Chunk {i+1} ---")print(doc.page_content)print()
参数调优说明:SemanticChunker 的效果高度依赖 breakpoint_threshold_amount 这个阈值参数。
•阈值的作用:可以将其理解为一个“语义变化敏感度”的控制器。当相邻句子的语义相似度差异超过这个阈值时,就在此处进行切分。•如何调整:阈值较低:切分会非常敏感,即使微小的语义变化也可能导致分块。这会产生大量非常小且高度内聚的块。阈值较高:对语义变化的容忍度更大,只有在话题发生显著转变时才会切分,从而产生更少、更大的块。•这个值没有固定的最佳答案,需要根据您的文档内容和领域进行反复实验和调整,以达到最理想的分块效果。
2.3.2 基于主题的分块
•核心思想:利用主题模型(如LDA)或聚类算法,在文档的宏观主题发生转换时进行切分。•适用场景:长篇、多主题的报告或书籍。
import numpy as npimport refrom sklearn.feature_extraction.text importCountVectorizerfrom sklearn.decomposition importLatentDirichletAllocationimport nltkfrom nltk.corpus import stopwords
try:    stopwords.words('english')exceptLookupError:    nltk.download('stopwords')
def lda_topic_chunking(text: str, n_topics:int=3)-> list[str]:"""基于LDA主题模型的分块函数。
:param text:需要分块的原始文本。:param n_topics:期望从文本中发现的主题数量。:return:文本块列表。"""# 1. 文本预处理 和 重新定义“文档”单元# 将文本按段落分割,一个段落作为一个“文档”    paragraphs =[p.strip()for p in text.split('\n\n')if p.strip()]if len(paragraphs)<=1:return[text]# 如果只有一个段落,无需分割
# 简单的文本清洗:移除特殊字符,转为小写    cleaned_paragraphs =[re.sub(r'[^a-zA-Z\s]','', p).lower()for p in paragraphs]
# 2. 词袋模型 + 去停用词# min_df=1 因为在单文档上下文中,一个词只在一个段落出现也是有意义的    vectorizer =CountVectorizer(min_df=1, stop_words=stopwords.words('english'))    X = vectorizer.fit_transform(cleaned_paragraphs)
# 如果词汇表为空,则无法进行LDA,直接返回段落if X.shape[1]==0:return paragraphs
# 3. LDA 主题建模# n_components 是正确的参数名    lda =LatentDirichletAllocation(n_components=n_topics, random_state=42)    lda.fit(X)
# 4. 计算每个段落的主导主题    topic_dist = lda.transform(X)# np.argmax 返回每行(每个段落)最大值的索引(即主导主题的编号)    dominant_topics = np.argmax(topic_dist, axis=1)
# 5. 实现正确的分块逻辑:在主题变化时切分    chunks =[]    current_chunk_paragraphs =[]# 第一个段落的主题作为起始主题    current_topic = dominant_topics[0]
for i, paragraph in enumerate(paragraphs):if dominant_topics[i]== current_topic:# 如果主题相同,则加入当前块            current_chunk_paragraphs.append(paragraph)else:# 如果主题变化,则保存上一个块,并开始一个新块            chunks.append("\n\n".join(current_chunk_paragraphs))            current_chunk_paragraphs =[paragraph]            current_topic = dominant_topics[i]
# 添加最后一个块    chunks.append("\n\n".join(current_chunk_paragraphs))
return chunks
document ="""..............................."""
final_chunks = lda_topic_chunking(document, n_topics=3)
print(f"文档被分成了 {len(final_chunks)} 个块:")print("="*80)for i, chunk in enumerate(final_chunks):print(f"--- 块 {i+1} ---")print(chunk)print("-"*80)
**注意事项:**基于主题的分块在实践中需要谨慎使用,因为它存在一些固有挑战:
•数据依赖性强:主题模型和聚类算法通常需要足够长的文本和明确的主题区分度才能生效。对于短文本或主题交叉频繁的文档,效果可能不佳。•预处理要求高:文本清洗、停用词去除、词形还原等预处理步骤对最终的主题识别质量有巨大影响。•超参数敏感:需要预先设定主题数量(n_topics)等超参数,而这往往难以准确估计。
因此,当直接应用此类方法时,可能会发现分出的块在逻辑上不连贯,或者与实际主题边界不符。 此方法更适合作为一种探索性工具,在主题边界清晰的长文档上使用,并需要进行充分的实验验证。
2.4 高级分块策略
2.4.1 小-大分块
•核心思想:使用小块(如句子)进行高精度检索,然后将包含该小块的原始大块(如段落)作为上下文送入LLM。•适用场景:需要高检索精度和丰富生成上下文的复杂问答场景。
from langchain.embeddings importOpenAIEmbeddingsfrom langchain_text_splitters importRecursiveCharacterTextSplitterfrom langchain.retrievers importParentDocumentRetrieverfrom langchain_community.document_loaders importTextLoaderfrom langchain_chroma importChromafrom langchain.storage importInMemoryStore# from langchain_core.documents import Document # 假设 Document 已被导入
# docs = [Document(page_content="......")] # 假设这是你的文档# embeddings = OpenAIEmbeddings()# vectorstore = Chroma(embedding_function=embeddings, collection_name="split_parents")# store = InMemoryStore()
# parent_splitter = RecursiveCharacterTextSplitter(chunk_size=2000)# child_splitter = RecursiveCharacterTextSplitter(chunk_size=400)
# retriever = ParentDocumentRetriever(#     vectorstore=vectorstore,#     docstore=store,#     child_splitter=child_splitter,#     parent_splitter=parent_splitter,# )
# retriever.add_documents(docs)# sub_docs = vectorstore.similarity_search("query")# retrieved_docs = retriever.get_relevant_documents("query")# print(retrieved_docs[0].page_content)
2.4.2 代理式分块
•核心思想:利用一个LLM Agent来模拟人类的阅读理解过程,动态决定分块边界。•适用场景:实验性项目,或处理高度复杂、非结构化的文本。
import textwrapfrom langchain_openai importChatOpenAIfrom langchain.prompts importPromptTemplatefrom langchain_core.output_parsers importPydanticOutputParserfrom pydantic importBaseModel,Fieldfrom typing importList
classKnowledgeChunk(BaseModel):    chunk_title: str =Field(description="这个知识块的简洁明了的标题")    chunk_text: str =Field(description="从原文中提取并重组的、自包含的文本内容")    representative_question: str =Field(description="一个可以被这个块内容直接回答的典型问题")
classChunkList(BaseModel):    chunks:List[KnowledgeChunk]
parser =PydanticOutputParser(pydantic_object=ChunkList)
prompt_template ="""【角色】:你是一位顶尖的科学文档分析师,你的任务是将复杂的科学文本段落,分解成一组核心的、自包含的“知识块(KnowledgeChunks)”。【核心任务】:阅读用户提供的文本段落,识别其中包含的独立的核心概念。【规则】:1.**自包含性**:每个“知识块”必须是“自包含的(self-contained)”。2.**概念单一性**:每个“知识块”应该只围绕一个核心概念。3.**提取并重组**:从原文中提取与该核心概念相关的所有句子,并将它们组合成一个通顺、连贯的段落。4.**遵循格式**:严格按照下面的JSON格式指令来构建你的输出。
{format_instructions}
【待处理文本】:{paragraph_text}"""prompt =PromptTemplate(template=prompt_template,    input_variables=["paragraph_text"],    partial_variables={"format_instructions": parser.get_format_instructions()},)
# 以下 model 定义需要根据实际情况修改# model = ChatOpenAI(model="Qwen3-235B-A22B", base_url="http://10.1.18.99:8089/v1",api_key="sk-",temperature=0.0).bind(#     response_format={"type": "json_object"}# )# chain = prompt | model | parser
def agentic_chunker(paragraph_text: str)->List[KnowledgeChunk]:try:# result: ChunkList = chain.invoke({"paragraph_text": paragraph_text})# return result.chunks# 模拟返回,因为无法执行 chain.invokeprint("模拟 agentic_chunker 调用")return[]exceptExceptionas e:return[]
document ="""水循环,也称为水文循环,描述了水在地球表面、之上和之下的连续运动。这个循环至关重要,因为它确保了水对所有生命形式的可用性。循环的第一阶段是蒸发,这是水从海洋、湖泊和河流等表面转化为水蒸气并上升到大气中的过程,植物的蒸腾作用也对此有贡献。当温暖、潮湿的空气上升并冷却时,会发生第二阶段:凝结。在这个阶段,水蒸气变回微小的液态水滴,形成云。随着这些水滴碰撞并增长,它们最终变得足够重,以降水的形式落回地球,这是第三阶段,形式可以是雨、雪、雨夹雪或冰雹。最后,一旦水到达地面,它可能以多种方式移动,构成了第四个阶段:汇集。一些水会作为地表径流流入河流、湖泊和海洋。其他水则会渗入地下,成为地下水,最终也可能返回地表或海洋,从而重新开始整个循环。"""paragraphs = document.strip().split('\n\n')all_chunks =[]
for i, para in enumerate(paragraphs):print(f"--- 正在处理第 {i+1}/{len(paragraphs)} 段 ---")    chunks_from_para = agentic_chunker(para)# 调用新函数if chunks_from_para:        all_chunks.extend(chunks_from_para)print(f"成功从该段落中提取了 {len(chunks_from_para)} 个知识块。")
ifnot all_chunks:print("未能生成任何知识块。")else:for i, chunk in enumerate(all_chunks):print(f"【知识块 {i+1}】")print(f"  - 标题: {chunk.chunk_title}")print(f"  - 代表性问题: {chunk.representative_question}")print(f"  - 文本内容:")        wrapped_text = textwrap.fill(chunk.chunk_text, width=78, initial_indent='    ', subsequent_indent='    ')print(wrapped_text)print("-"*80)
3. 混合分块:平衡效率与质量
在实践中,单一策略往往难以应对所有情况。混合分块结合了多种策略的优点,是一种非常实用的技巧。
•核心思想:先用一种宏观策略(如结构化分块)进行粗粒度切分,再对过大的块使用更精细的策略(如递归或语义分块)进行二次切分。•适用场景:处理结构复杂且内容密度不均的文档。
代码示例 (结构化 + 递归混合):
from langchain_text_splitters importMarkdownHeaderTextSplitter,RecursiveCharacterTextSplitterfrom langchain_core.documents importDocument
markdown_document ="""# 第一章:公司简介
本公司成立于2017年,致力于推动人工智能技术的创新与应用。我们的使命是通过先进的AI解决方案,为各行各业赋能,创造更大的价值。我们拥有一支由顶尖科学家和工程师组成的团队,专注于深度学习、自然语言处理和计算机视觉等前沿领域。
## 1.1 发展历程
公司自创立以来,经历了快速的发展。从最初的几人团队,到如今拥有数百名员工的规模,我们始终坚持技术驱动、客户至上的原则。
# 第二章:核心技术
本章将详细介绍我们的核心技术。我们的技术框架基于先进的分布式计算理念,确保了高可用性和可扩展性。系统的核心是一个自主研发的深度学习引擎,它能够处理海量数据并进行高效的模型训练。这个引擎支持多种神经网络结构,包括卷积神经网络(CNNs)用于图像识别,以及循环神经网络(RNNs)和Transformer模型用于自然语言理解。我们特别优化了Transformer架构,提出了一种名为“注意力压缩”的新机制,该机制在保持模型性能的同时,显著减少了计算资源的需求。这一创新使得我们能够在边缘设备上部署复杂的AI模型,为物联网(IoT)应用场景提供了强大的支持。不仅如此,我们还构建了一套完整的数据处理流水线,从数据采集、清洗、标注到最终的模型评估,全程自动化,极大地提升了研发效率。这套流水线处理的数据量已达到PB级别,每日处理的请求数超过十亿次。为了保障数据安全,我们采用了端到-端加密和联邦学习等多种先进技术,确保客户数据的隐私和安全。我们相信,强大的技术实力是公司发展的基石,也是我们服务客户的信心所在。我们不断探索技术的边界,致力于将最新的科研成果转化为可靠、易用的产品和服务,帮助客户在激烈的市场竞争中保持领先地位。
## 2.1 技术原理
我们的技术原理融合了统计学、机器学习和运筹学等多个学科的知识。
# 第三章:未来展望
展望未来,我们将继续加大在人工智能领域的投入,探索通用人工智能(AGI)的可能性。
"""
# 定义混合分块函数def hybrid_chunking_optimized(    markdown_document: str,    coarse_chunk_threshold:int=400,# 定义一个粗粒度块的大小阈值    fine_chunk_size:int=100,# 定义精细切分的目标大小    fine_chunk_overlap:int=20# 定义精细切分的重叠大小)-> list[Document]:"""使用结构化+递归的混合策略,并确保元数据在二次切分中得以保留。
:param markdown_document:完整的Markdown格式文档。:param coarse_chunk_threshold:粗粒度块的长度阈值,超过则进行二次切分。:param fine_chunk_size:二次切分时,每个小块的目标长度。:param fine_chunk_overlap:二次切分时,小块间的重叠长度。:return:Document对象的列表,包含最终的所有分块。"""# 宏观的结构化分块 (按H1和H2标题)    headers_to_split_on =[("#","Header 1"),("##","Header 2")]    markdown_splitter =MarkdownHeaderTextSplitter(headers_to_split_on=headers_to_split_on)    coarse_chunks = markdown_splitter.split_text(markdown_document)
# 初始化精细分块器    fine_splitter =RecursiveCharacterTextSplitter(        chunk_size=fine_chunk_size,        chunk_overlap=fine_chunk_overlap)
# 迭代处理,对过大的块进行二次切分    final_chunks =[]for chunk in coarse_chunks:# 检查块的文本长度是否超过阈值if len(chunk.page_content)> coarse_chunk_threshold:print(f"--- 块过大 (长度: {len(chunk.page_content)}), 正在进行二次切分... ---")print(f"    原始元数据: {chunk.metadata}")
            finer_chunks = fine_splitter.split_documents([chunk])            final_chunks.extend(finer_chunks)else:            final_chunks.append(chunk)
return final_chunks
final_chunks = hybrid_chunking_optimized(markdown_document)
for i, chunk in enumerate(final_chunks):print(f"--- 最终块 {i+1} (长度: {len(chunk.page_content)}) ---")print(f"元数据: {chunk.metadata}")print("文本内容:")print(chunk.page_content)print("-"*80)
4. 如何选择最佳分块策略?
面对众多策略,合理的选择路径比逐一尝试更重要。个人建议遵循以下分层决策框架,从简单高效的基准开始,逐步引入更复杂的策略。
第一步:从基准策略开始
•默认选项:RecursiveCharacterTextSplitter 无论处理何种文本,这都是最稳妥的起点。它在通用性、简单性和效果之间取得了很好的平衡。首先使用它建立一个性能基线。
第二步:检查结构化特征
•优先选项:结构感知分块 在应用基准策略后,检查你的文档是否具有明确的结构,如Markdown标题、HTML标签、代码或对话格式。如果有,可以切换到MarkdownHeaderTextSplitter等相应的结构化分块方法。这是成本最低、收益较好的优化步骤。
第三步:当精度成为瓶颈时
•进阶选项:语义分块 或 小-大分块 如果基础策略和结构化策略的检索效果仍不理想,无法满足业务需求,说明需要更高维度的语义信息。•SemanticChunker:适用于需要块内语义高度一致的场景。•ParentDocumentRetriever (小-大分块):适用于既要保证检索精准度,又需要为LLM提供完整上下文的复杂问答场景。
第四步:应对极端复杂的文档
•高级实践:混合分块 对于那些结构复杂、内容密度不均、混合多种格式的复杂文档,单一策略难以应对。此时,混合分块是平衡成本与效果的最佳实践。例如,先用MarkdownHeaderTextSplitter进行宏观切分,再对过长的块用RecursiveCharacterTextSplitter进行二次细分。
为了方便查阅和对比,下表总结了所有讨论过的分块策略。
| 分块策略 | 核心逻辑 | 优点 | 缺点 |
|---|---|---|---|
| 固定长度分块 | 按固定字符数或token数切分 | 实现最简单,速度快 | 简单粗暴,极易破坏语义完整性 |
| 递归分块 | 按预定分隔符(段落、句子)递归切分 | 通用性强,最大程度保留文档结构 | 对无规律文档效果一般 |
| 基于句子的分块 | 以句子为最小单元,再组合成块 | 保证句子完整性,避免语义截断 | 单句上下文可能不足,需处理长句 |
| 结构化分块 | 利用文档的固有结构(如标题、对话)切分 | 块边界清晰,上下文逻辑性强 | 强依赖文档格式,不适用于混乱文本 |
| 语义分块 | 根据局部语义相似度变化切分 | 块内概念高度内聚,检索精度高 | 计算成本高,依赖高质量嵌入模型 |
| 基于主题的分块 | 利用主题模型按全局主题边界切分 | 块内信息高度相关,精准匹配主题 | 依赖主题模型效果,实现相对复杂 |
| 混合分块 | 宏观粗分(如结构)+微观细分(如递归) | 平衡效率与质量,实用性强 | 实现逻辑更复杂,需要两步处理 |
| 小-大分块 | 检索用小块,生成用大块 | 结合高精度检索和丰富上下文,效果拔群 | 管道复杂,需要管理两套索引 |
| 代理式分块 | AI代理动态分析和切分文档 | 模拟人类理解,理论上效果最优 | 实验性阶段,极度复杂,资源消耗高 |
结论:分块是实践,而非理论
文档分块,远不止是简单的文本预处理,它深刻影响着RAG系统中信息流的质量,是典型的“细节决定成败”的环节。 通过本文的梳理,我们应形成三个核心认知:
1.不存在“银弹”:没有任何一种分块策略能完美适应所有场景。将分块视为一个需要根据数据特性和业务需求不断迭代优化的工程问题。2.始于简单,终于复合:始终从RecursiveCharacterTextSplitter等简单、可靠的方法入手建立基线,再根据需要逐步引入结构化、语义化乃至混合策略,是一种高效且稳健的实践路径。3.分块即“建模”:从某种意义上说,如何分块,就是你如何理解和“建模”你的知识。一个高质量的分块,本身就是对原始数据的一种结构化和语义增强。
最终,高质量的分块是通往高质量生成结果的前提。掌握这项技能,是每一位RAG应用构建者提升系统性能的必经之路。
如何学习大模型 AI ?
我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
2025最新大模型学习路线
明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。
对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。
大模型经典PDF书籍
新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
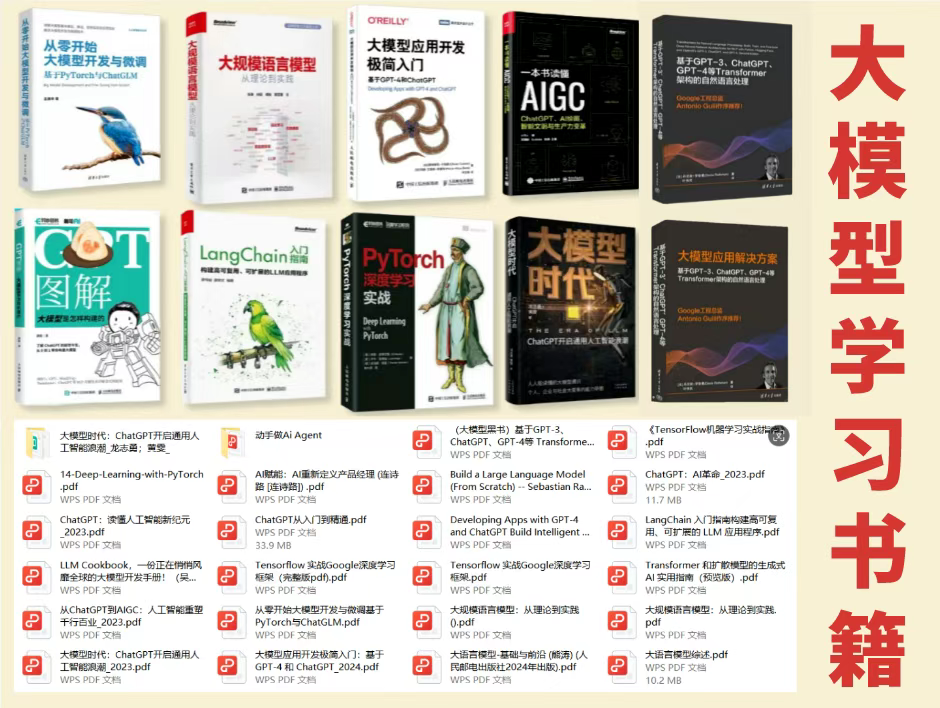
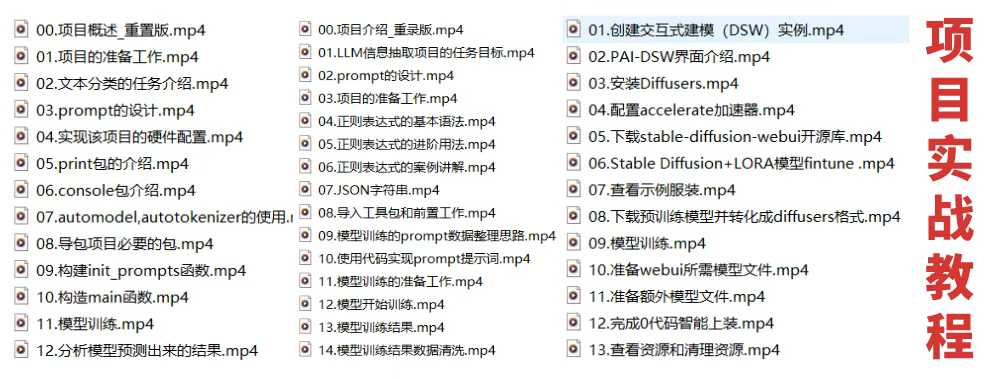
配套大模型项目实战
所有视频教程所涉及的实战项目和项目源码等
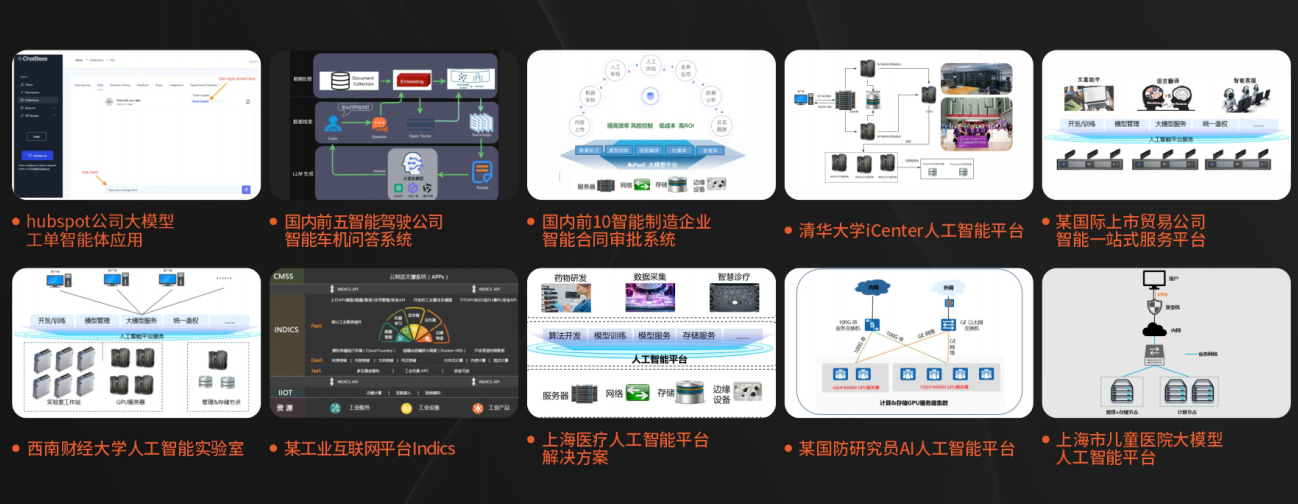
博主介绍+AI项目案例集锦
MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

为什么要学习大模型?
2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
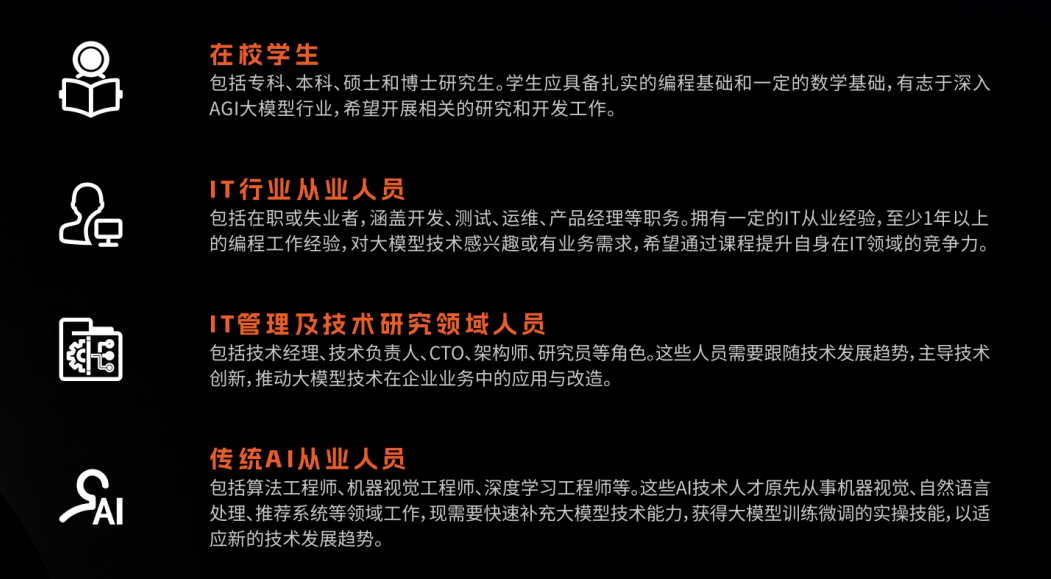
适合人群
- 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
- IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
- IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
- 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
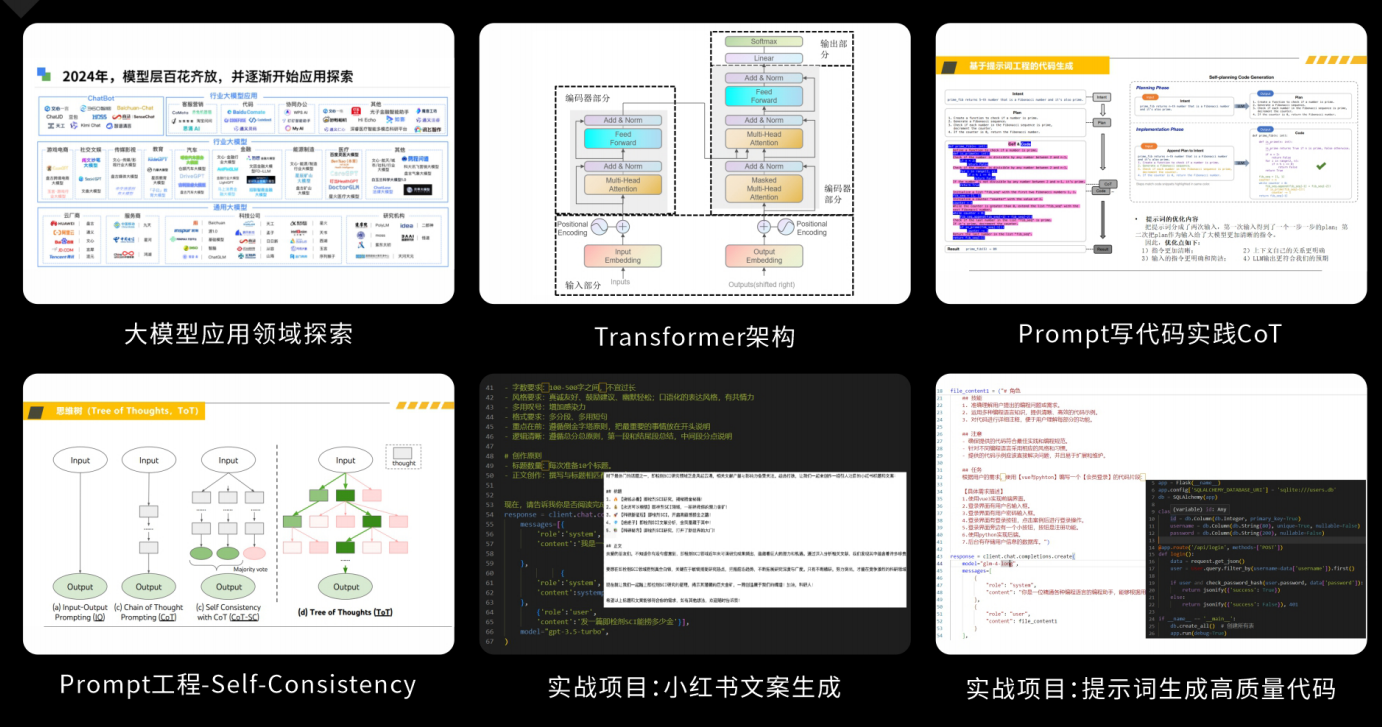
课程精彩瞬间
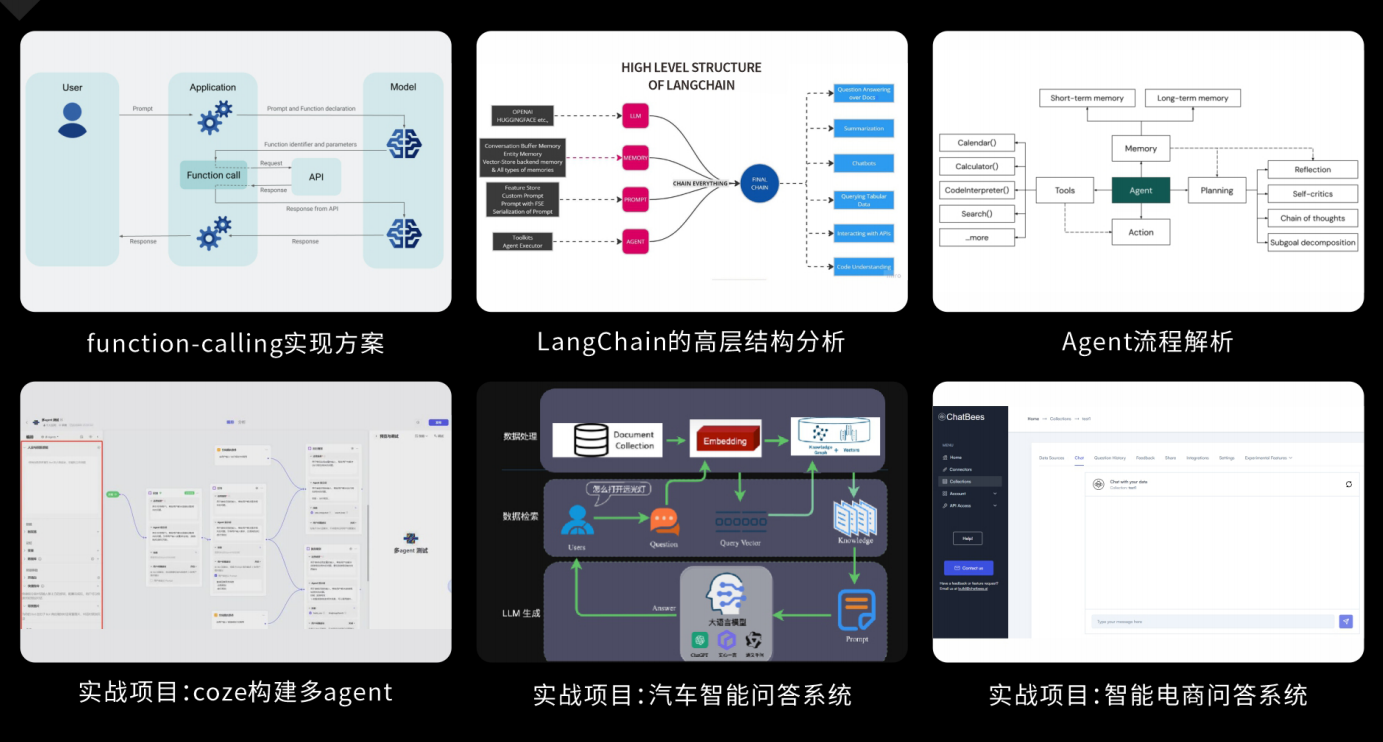
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。
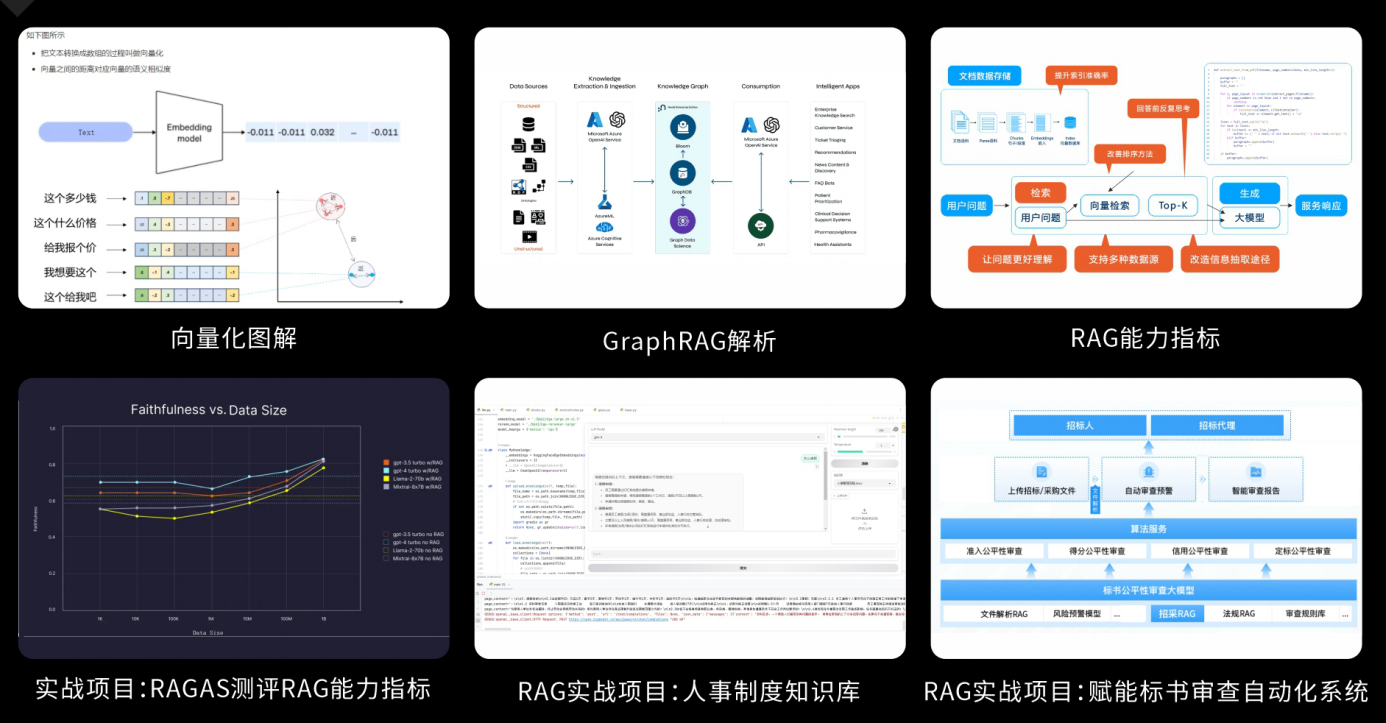
RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。
Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
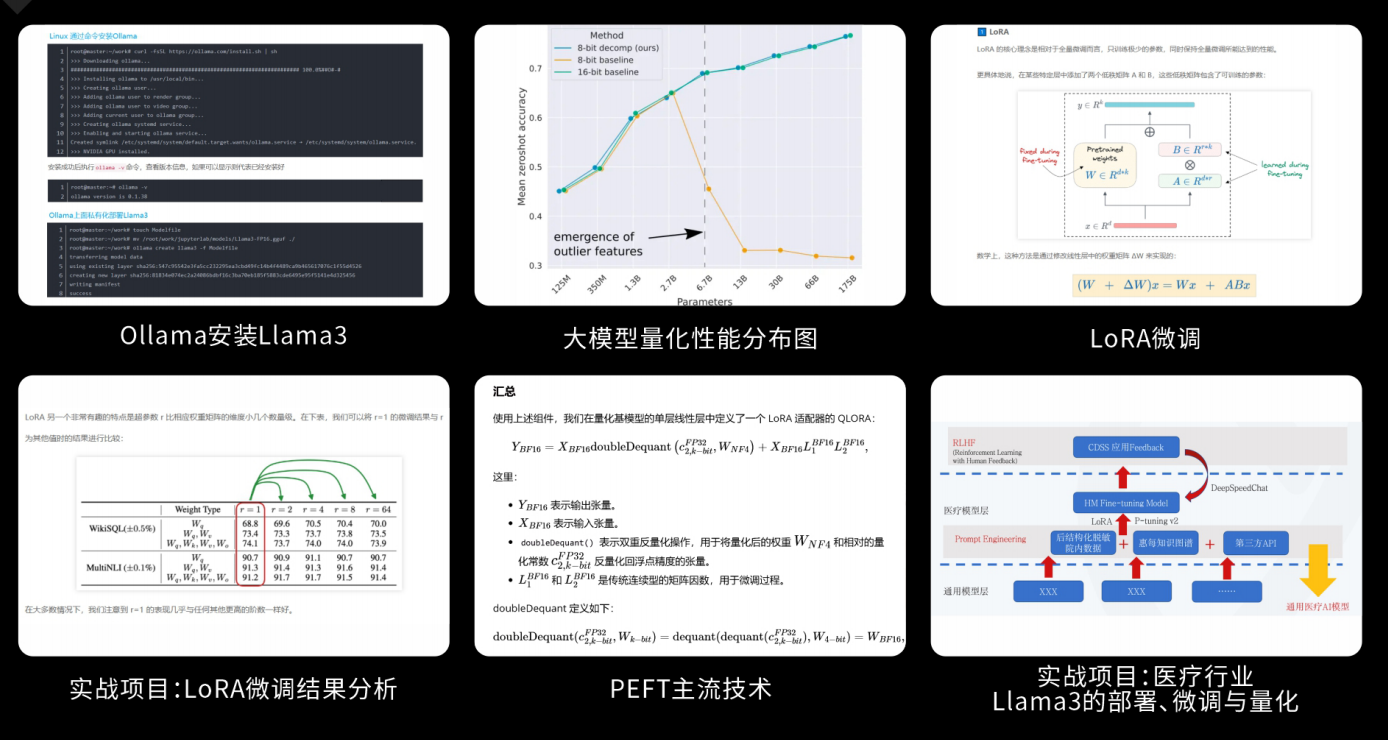
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。
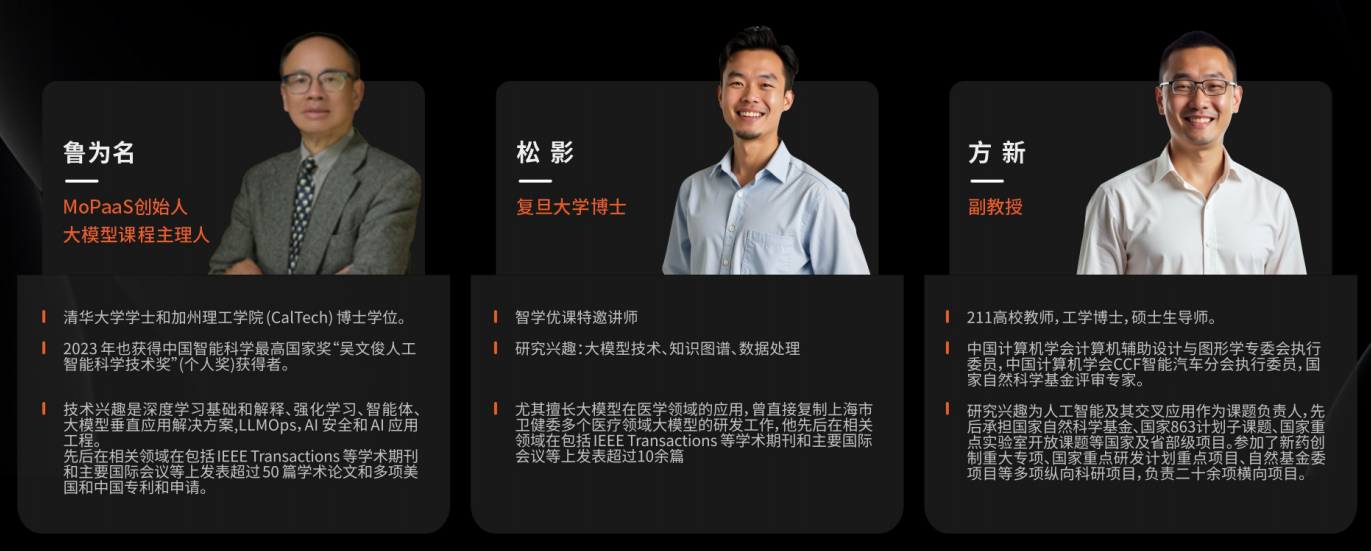
顶尖师资,深耕AI大模型前沿技术
实战专家亲授,让你少走弯路
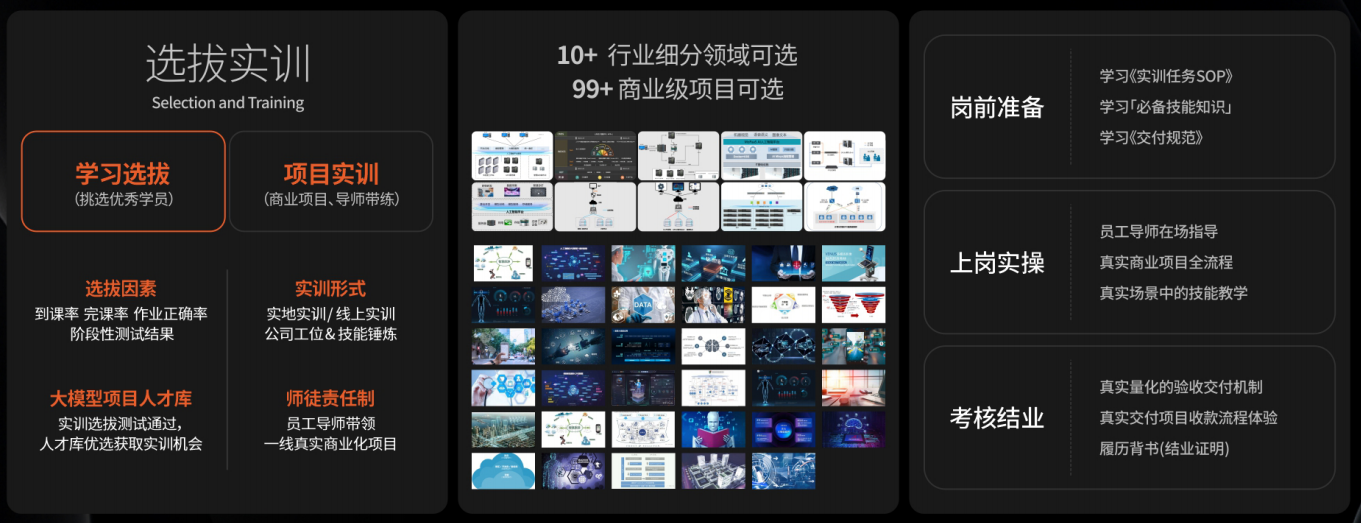
一对一学习规划,职业生涯指导
- 真实商业项目实训
- 大厂绿色直通车
人才库优秀学员参与真实商业项目实训
以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调
大厂绿色直通车,冲击行业高薪岗位
文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 180


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


