论文浅尝 | 基于关系感知锚点增强的知识图谱补全(AAAI2025)

Wikidata知识图谱介绍与数据处理 1. Wikidata简介 Wikidata(维基数据)是一个自由开放的知识库,可以同时被人和机器阅读、编辑[1]。根据官网介绍,Wikidata作为一种结构化数据的集中存储,为其他维基媒体(Wikimedia)项目[2]提供支撑,包括Wikipedia(维基百科)、Wikivoyage(维基导游)、Wiktionary(维基字典)、Wikisource(维基文库)等。 就像维基百科一样,Wikidata 支持自由协作编辑,支持多语言。与维基百科不同的是,Wikidata作为知识库,其内容都是结构化 阅读详情

img

1. 动机

利用预训练语言模型(PLM)增强具有详细文本描述的原始三元组的内在语义联系。该分支中的典型方法分别将输入查询(与实体和关系相关联的文本描述)及其候选实体映射到特征向量,然后最大化有效三元组的概率。 随着大型语言模型的快速发展,这些方法越来越受到人们的关注。根据语言模型的特性,输入查询提供的相关和具体的上下文信息越多,结果嵌入的判别性越强。在本文中,通过观察和验证,我们发现了一个被忽视的事实,即查询中头部实体的关系感知邻居可以作为更精确的链接预测的有效上下文。基于这一发现,我们提出了一种关系感知锚点增强知识图谱补全方法(RAA-KGC)。具体来说,在我们的方法中,为了提供目标实体可能是什么样子的参考,我们首先在头部实体的关系感知邻域中生成锚实体。然后,通过将查询嵌入拉向锚的邻域,对目标实体匹配进行调整,使其更具判别性。我们大量的实验结果不仅验证了RAA-KGC的有效性,而且还表明,通过集成我们的关系感知锚点增强策略,可以显著提高当前领先方法的性能,而无需进行实质性修改。

2. 贡献

  • 通过观察和实验验证,本文发现了一个以前被忽视的事实,即关系感知实体可以作为目标实体预测的有效上下文。通过这种设置,现有方法可以在不需要进行实质性修改的情况下实现显著的性能改进。
  • 本文提出了一种关系感知锚增强知识图谱补全算法(RAA-KGC),方法是用目标实体原型来补充查询。所提出的方法可以生成具有判别性和紧凑的实体嵌入。因此与比较的最先进的算法相比,实现了优越的性能。

3. 方法

(1)问题陈述

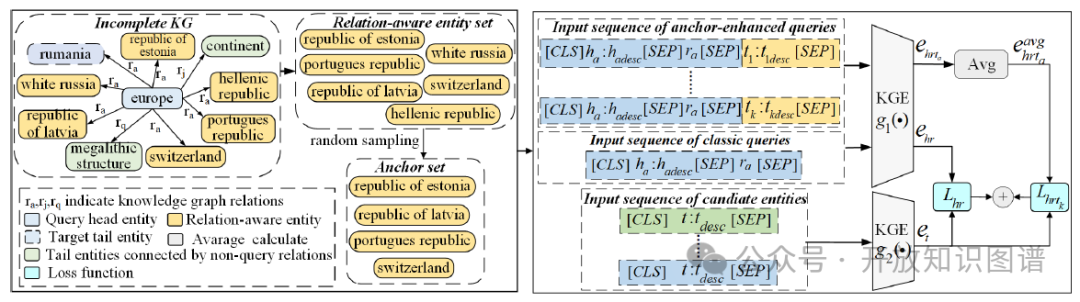
给定一个知识图谱 ,其中 和 分别是实体和关系的集合。本文专注于链接预测子任务,目标是预测缺失的头实体或尾实体。方法框架如下图所示。
img

(2)锚点生成

RAA-KGC通过利用查询头实体的关系感知邻居实体来提供目标实体的上下文信息。定义关系感知锚点生成操作如下:

其中 是从关系感知实体集 中随机采样的锚点集合。

(3)锚点增强嵌入生成

使用两个编码器 和 来生成锚点增强嵌入。锚点增强嵌入的计算公式如下:

(4)训练与推理

采用对比学习损失函数,通过最小化 和 来优化锚点增强嵌入。推理时,计算目标实体和查询的余弦相似度,并选择最高得分作为预测结果。

4. 实验

数据集

在三个常用数据集上评估RAA-KGC的性能:WN18RR、FB15k-237和Wikidata5M-Trans。

Datasettrainvalidtest
WN18RR86,83530343134
FB15k - 237272,11517,53520,466
Wikidata5M - Trans20,614,2795,1635,163

对比基线

与十二种最先进的方法进行比较,包括基于三元组和基于文本的方法。

实验结果

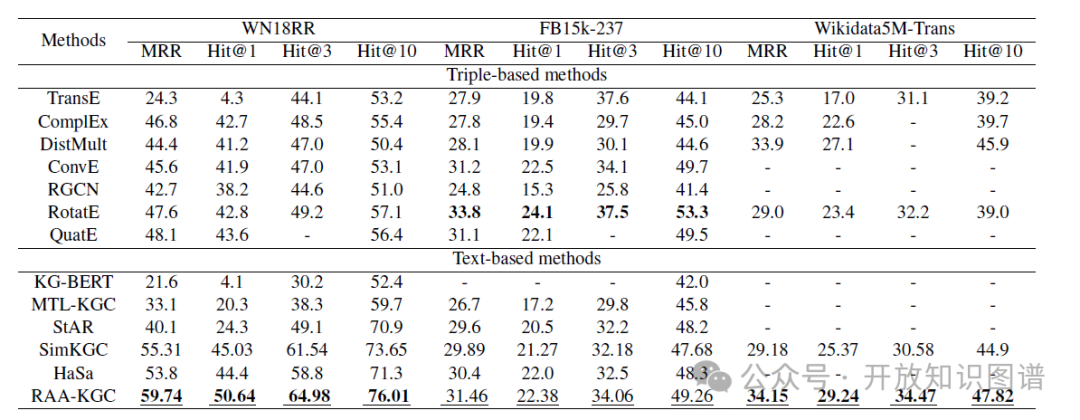
(1)总体性能比较

  • WN18RR:RAA-KGC在MRR、Hit@1、Hit@3和Hit@10上均优于SimKGC。
  • FB15k-237:RAA-KGC在某些指标上表现不如SimKGC,可能是因为该数据集的拓扑结构较密集。
  • Wikidata5M-Trans:RAA-KGC在所有指标上均表现出色。

img

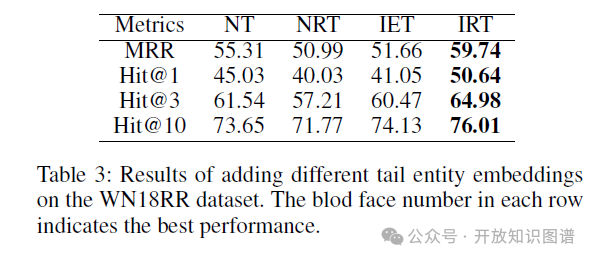
(2)锚框增强集成的重要性比较

img

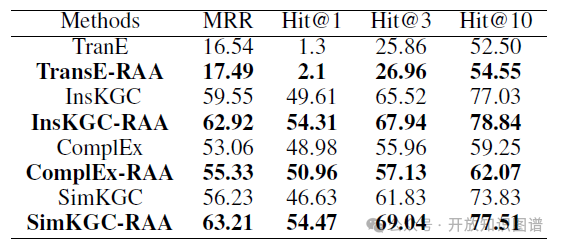
(3)兼容性分析

img

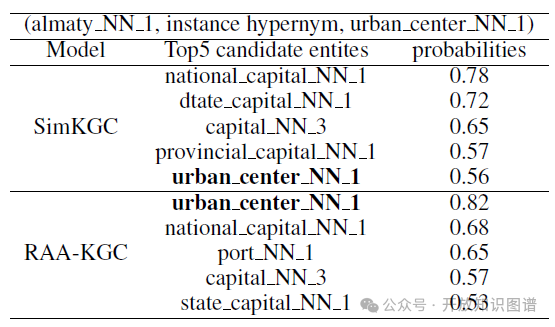
(4)实例分析

img

5. 讨论

  • 锚点增强嵌入的重要性:实验表明,锚点增强嵌入在预测过程中起到了重要作用。
  • 关系细粒度性能:RAA-KGC在大多数关系类型上优于SimKGC。
  • 样本大小的影响:随着样本大小的增加,性能有所提升,但过多的样本引入噪声限制了进一步的性能提升。
  • 兼容性:RAA框架与其他基线模型兼容,提升了它们的性能。
  • 未见实体上的性能:RAA-KGC在归纳场景下表现出色,显示出较强的泛化能力。

6. 结论

本文提出了RAA-KGC方法,通过生成目标实体的一般示例并将其嵌入拉向锚点邻域,显著提高了知识图谱补全的性能。未来的研究可以结合子图的结构和文本信息来进一步提高KGE模型的性能。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

AAAI 2025丨具身智能+多模态感知如何精准锁定目标 具身智能指通过物理载体与环境实时交互的智能系统,具备感知、决策与执行一体化能力,实现“大脑思考+身体行动”的协同。2025年首次被写入中国《政府工作报告》作为未来产业,全球人形机器人新品年超百款。中国在“天工”机器人奔跑控制、“慧思开物”通用平台等领域领先,技术加速从实验室迈向工业制造、家庭服务等场景。 阅读详情

相关推荐

AAAI 2025图像分类领域论文多维度分类总结

AAAI 2025图像分类领域研究进展速览 AAAI 2025作为人工智能顶级会议,共收到12,957篇投稿,录用率23.4%。会议聚焦图像分类技术突破,主要进展包括: 深度学习架构改进 SparX-Mamba通过生物启发的稀疏跨层连接机制提升效率,ImageNet-1K准确率达83.5% Mamba YOLO采用选择性状态空间模型,推理速度较传统Transformer提升2倍 跨模态对齐创新 DiffCLIP通过无监督掩膜扩散学习实现多模态特征统一表征 VSCNet提出动态语义定位与因果图聚合,长尾数据集

分享知识,一起学习,共同进步! 2061

【HuggingFace轻松上手】基于Wikipedia的知识增强预训练

本文介绍基于entity masking的知识增强预训练语言模型的实现,以及在几个下游任务微调的方法。本文分享核心代码实现和相关数据。

夏栀的博客 4443

wikidata-simplequestions:SimpleQuestions 数据集到维基数据的映射

简单问题维基数据 该存储库提供了映射到Wikidata的数据集的版本。 描述 数据组织在 6 个文件中: annotated_wd_data_{train, valid, test}{_full}.txt 。 每个文件每行包含一个示例,格式如下: subject [tab] property [tab] object [tab] question ,其中subject 、 property和object是维基数据项目或属性的标识符。 Rxxx属性标识符对维基数据属性Pxxx的逆属性进行编码。 例如, R19编码属性“出生地”,即P19 (“出生地”)的倒数。 请注意,并非每个翻译的三元组都必须存在于维基数据中。 从 Freebase 迁移到 Wikidata 时的部分信息丢失了。 以“_answerable”结尾的文件只包含维基数据中的三元组。 映射代码在build.ipynb文件中。

【预训练语言模型】KEPLER: A Unified Model for Knowledge Embedding and Pre-trained Language Representation

【预训练语言模型】KEPLER: A Unified Model for Knowledge Embedding and Pre-trained Language Representation 核心要点: 不引入任何参数实现知识融合; 结合知识表示学习和MLM两个loss进行训练; 构建新的benchmark:wikidata5M 简要信息: 序号 属性 值 1 模型名称 KEPLER 2 发表位置 ACL 2019 3 所属领域 自然语言处理、预训练语言模型 4 研究内容

夏栀的博客 2683

别再只看K线了!聊聊“板块联动”和“热点轮动”的跟踪方法与工具(实战派分享)

本文深入解析了如何通过板块联动和热点轮动构建高效交易系统。从三维验证框架到主流工具配置,再到持续性热点的五大特征,实战派交易员分享了识别市场主线和预判轮动方向的高阶技巧,帮助投资者摆脱单纯依赖K线的局限,提升交易决策效率。

weixin_29281941的博客 760

要配置西门子G120XA变频器实现**端子启停**和**Modbus RTU(485)频率给定

如有问题,可通过STARTER软件在线诊断Modbus通讯状态。要配置西门子G120AX变频器实现。

微:13763355074 4847

知识增强预训练语言模型|KEPLER: A Unified Model for Knowledge Embedding and Pre-trained Language Representation

1.介绍 预训练的语言表征模型(PLMs) ELMo BERT XLNet 从大规模的非结构和未标记的库中学习有效的语言表征 通常缺乏事实世界知识 -> 利用大规模知识库的实体嵌入为plm提供外部知识 他们使用了通过单独的知识嵌入(KE)算法学习的固定实体嵌入,这种算法不能很容易地与语言表示对齐,因为它们本质上是在两个不同的向量空间中。 它们需要一个实体链接器将上下文中的单词链接到相应的实体上,从而受益于实体嵌入,这使得它们存在错误传播问题。 与普通的plm相比,它们检索和使用实体嵌入的复杂机制导致

weixin_43235829的博客 2592

Camera ITS测试

一、手机端设置: 将 CtsVerifier.apk 安装到设备上, 连接上linux主机。 二、主机端设置: 基础:CTS测试运行环境 然后,主机安装python2.7,及numpy/scipy/matplotlib/opencv 栈和 python 成像库。按照下面的命令依次安装: sudo apt­-get install python-­numpy sudo apt-­g...

wangubuntu的专栏 7785

精读论文:Knowledge Graph Completion with Relation-Aware Anchor Enhancement

论文链接:[https://arxiv.org/pdf/2504.06129]代码链接:[https://github.com/DayanaYuan/RAA-KGC]发表会议: AAAI 2025。

weixin_59494599的博客 1453

面经-2023-禾赛-FPGA工程师

面经-2023-禾赛-FPGA工程师

w0shishabi的博客 2969

【SECS】初识SECS协议

项目标题的第一位和第二位告诉下面有多少字节表示项目的长度。而项目的长度是指项目标题后面的字节数,这里第一个字节就是项目标题。1个字节可以表示的最大长度是0-255,所以只要项目标题后面的字节数小于等于254,都是0x01。

weixin_48618536的博客 1643

AAAI 2025 论文精读:KG-LLaVA——用知识图谱增强医学影像解释生成

论文摘要: AAAI 2025论文《KG-LLaVA》提出了一种基于知识图谱检索增强生成(KG-RAG)的医学影像解释方法,旨在解决通用视觉语言模型(如LLaVA)在胸部X-ray病理解释任务中因缺乏专业医学知识导致的生成不严谨问题。该方法通过检索结构化医学知识图谱三元组(如“不透明影—提示—肺炎”),而非原始报告文本,增强模型生成解释的准确性与隐私安全性。实验表明,KG-LLaVA在MIMIC-NLE数据集上显著优于基线模型(AUC达83.0,CIDEr提升至62.2),验证了KG-RAG模块的普适性和有

GodGump的博客 416

基于ESP32 蓝牙游戏手柄设计

介绍使用 ESP32 并通过 BLE 通信的 设计手持游戏手柄,包含原理图与代码

DT程序员的博客 2164

AAAI-2025 时间序列(预测)31篇论文汇总

【AAAI2025时间序列预测论文精选】本届AAAI会议共收录63篇时间序列分析论文,其中预测类31篇。

SmartLab307的博客 6050

YOLO26涨点改进 | 小目标损失函数独家改进篇 | TGRS 2025 | 引入AdaFocalLoss损失函数,改进小目标检测,自适应聚焦小目标与样本分布不平衡,提升检测精度与训练稳定性

本文提出将AdaFocalLoss损失函数应用于YOLO26模型优化,有效提升小目标检测性能。AdaFocalLoss通过目标尺寸感知机制和IoU引导的动态调节,自动调整训练权重和聚焦程度,解决了样本不平衡问题。相比传统损失函数,它无需手动调参,能增强训练稳定性,在多尺度、复杂场景下表现优异。文章详细介绍了AdaFocalLoss的原理、优势及实现方法,并提供了代码集成指南。实验表明该方法能显著提升检测精度和鲁棒性,特别适用于小目标检测任务。

Ai缝合怪、助力小伙伴高效发论文 337

【原理图PCB专题】Cadence 17.4版本原理图及PCB 模块复用

在我们设计复杂板卡的时候,往往会遇到一部分电路被反复使用的情况。Cadence允许设计者一开始就将复用模块设计好,以后只要直接调用复用模块就可以直接用以设计更复杂的电路板了。这对于大规模集成设计无疑是非常好的选择,它不仅让设计者不必花费时间在相同模块反复设计上,更有利于电路的模块化设计。

一点硬件 2017

KG-LLM-Papers项目实战:构建你的第一个知识增强LLM应用

KG-LLM-Papers是一个专注于整合知识图谱(KGs)和大型语言模型(LLMs)的论文列表项目,它为开发者和研究人员提供了丰富的学术资源,帮助你快速掌握知识增强LLM应用的核心技术和最新进展。 ## 📚 为什么选择KG-LLM-Papers? 知识图谱与大型语言模型的结合是当前人工智能领域的研究热点。KG-LLM-Papers项目收录了大量相关论文,涵盖了从理论方法到实际应用的各个方面

gitblog_00166的博客 1068

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

AAAI2025第二轮分数出炉,祝大家一路绿灯accept!

AAAI 2025采用两阶段审稿流程。第一阶段,每篇论文将被分配给两名审稿人。如果一篇论文收到两份都足够负面的审稿,它将被直接拒绝,没有作者反馈的机会。其余的论文将进入第二阶段审稿。看到很多大佬也在吐槽自己得分,感觉今年有点格外惨烈啊……在两个数据集上的实验表明,NeuNet模型具有优越的分类性能,准确率分别为0.9169和0.9363,成功捕获了神经元的潜在特征表示。提出了一个统一且高效的框架NeuNet,它结合了神经元骨架的形态学信息和连接体的拓扑信息,这在以往的研究中尚未被探索。

2401_88556812的博客 6224

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

KG4Diagnosis:一种可诊断362种常见疾病的分层多智能体框架

该论文提出了KG4Diagnosis医疗诊断大模型框架,通过结合知识图谱增强技术和多智能体协作机制,为复杂医疗诊断任务提供了一种高效、精准的解决方案。

audyxiao001的博客 2168

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

KG-LLM-Papers前沿研究:2025年最新突破与未来趋势

KG-LLM-Papers是一个专注于整合知识图谱(KGs)和大型语言模型(LLMs)研究的论文列表项目,旨在探索LLM能为知识图谱做什么,以及知识图谱在LLM时代可以扮演什么角色。该项目收集了大量相关领域的前沿研究成果,为研究者和爱好者提供了全面的资源。 ## 🌟 2025年KG-LLM领域三大突破性研究 ### OntoTune:本体驱动的LLM自训练对齐 2025年2月发表的OntoT

gitblog_00845的博客 985

KG-LLM-Papers完整解析:从新手到专家的5个关键步骤

KG-LLM-Papers是一个专注于整合知识图谱(KGs)和大型语言模型(LLMs)的论文列表项目,旨在帮助研究者和爱好者系统了解这一交叉领域的最新进展。本文将通过5个关键步骤,带您从入门到精通这个项目的核心内容与应用价值。 ## 1. 快速入门:了解KG-LLM-Papers的核心价值 KG-LLM-Papers项目诞生于2023年6月,由浙江大学知识图谱实验室(ZJUKG)维护,是目前最

gitblog_00507的博客 996

跪了!AAAI 2025时间序列最强69篇论文,秒鲨现有方法!

时序数据分析作为机器学习与数据科学交叉领域的核心方向,在智能预测、模式识别和系统建模领域展现出持续生命力。当前时序分析正经历从纯数据驱动到知识嵌入的范式跃迁,这种转变将重新定义复杂系统建模的理论边界与应用场景。AAAI 2025在美国费城举行。此次会议论文投稿量达到了历史新高,主赛道收到了12957篇投稿论文,共有3032篇论文被录用,录用率达到23.4%。本文盘点了,供大家参考学习。

2501_91070801的博客 1826

【前沿 热点 顶会】AAAI 2025中与目标检测有关的论文

AAAI 2025中与目标检测有关的论文,包括3D目标检测、Radar目标检测、域适应、通用目标检测等话题。

A_Student10000的博客 6432

[AAAI 2025] 华科大认知计算与智能信息处理实验室3篇论文被国际人工智能顶级会议AAAI 2025全文录用!

CCIIP实验室23级博士生潘为燃同学(导师:魏巍)的论文 “Enhanced Sample Selection with Confidence Tracking: Identifying Correctly Labeled yet Hard-to-Learn Samples in Noisy Data”,23级研究生徐名韬同学(导师:魏巍)的论文 “Semantic Enhanced Heterogeneous Hypergraph Network for Collaborative Filtering”

xx_nm98的博客 1691
上一篇: Qwen2.5-VL技术解读和文档解析可行性验证
下一篇: RAG的技术演进
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值