我在Mac上部署了阿里开源Qwen3,这3个玩法让我上头

Mac本地部署Qwen3实战:Apple Silicon上的中文大模型生产力方案 大语言模型(LLM)的本地化运行正从概念走向日常实践,尤其在Apple Silicon Mac上,依托Metal加速与优化推理框架(如Ollama、MLX),轻量级开源模型已具备真实生产力价值。其核心原理在于量化压缩(如GGUF格式)与硬件协同推理,显著降低内存与算力门槛;技术价值体现在数据主权可控、响应确定性强、工作流深度集成;典型应用场景覆盖代码辅助、邮件智能摘要、私有知识库RAG等专业工作流。本文聚焦Qwen3在Mac平台的原生部署与工程化落地,详解Ollama配置、Metal加速调优及VS Code 阅读详情
AI摘要

本文介绍在Mac上使用Ollama本地部署阿里开源大语言模型Qwen3,其成本低、支持多语言,在GitHub获高关注。还提到用Cherry Studio构建知识库实现基于知识库的提问。此外,分享大模型AI学习的四个阶段,包括初阶应用、高阶应用、模型训练和商业闭环,并提供学习资料领取方式。

五一回老家那会,和发小吃了个饭,聊到了现在的 AI。

发小说看我玩 AI 玩的挺疯的,也想用在工作中提效,可公司电脑不让联网。

这一下就把我拉回到了数年前,在讯飞某保密项目中无网干撸代码的情形。

这真是太痛苦了。
img

为了让发小能在工作中用到 AI,我尝试教他本地部署最近很火的 Qwen3。

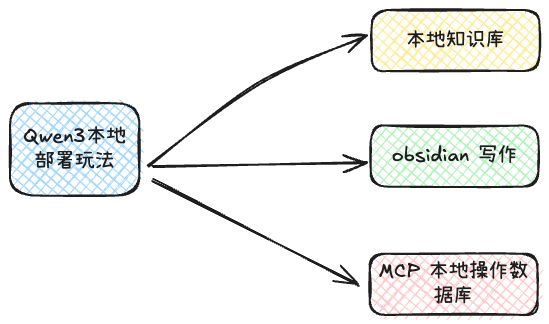
并发现了下面 3 种有趣实用的玩法,该说不说,Qwen3 确实让人上头。
img

经过一番折腾,发现果然官方说的“Qwen3-4B 这样的小模型也能匹敌 Qwen2.5-72B-Instruct 的性能。”,诚不欺我。
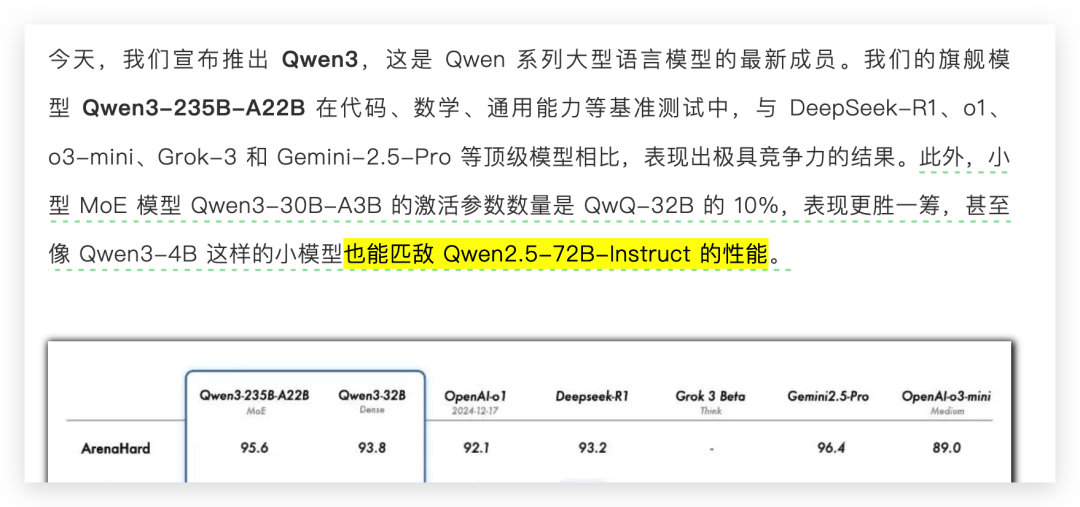
img

我的 Mac 部署的是最新的 Qwen3-8b,如果配置再好点,搞个 14b,那效果又上一个层次了。

不过在介绍本地部署和我的几个实践之前,觉得还是有必要和大家先聊聊 Qwen3。

后面会介绍如何本地部署 Qwen3 以及 3 大玩法。

Qwen3 是阿里在上个月底发布的新一代开源大语言模型系列,属于通义千问(Qwen)家族的最新一代模型。

短短半个多月,就已经在 GitHub 上获得了可怕的 21.1 k 的 star。
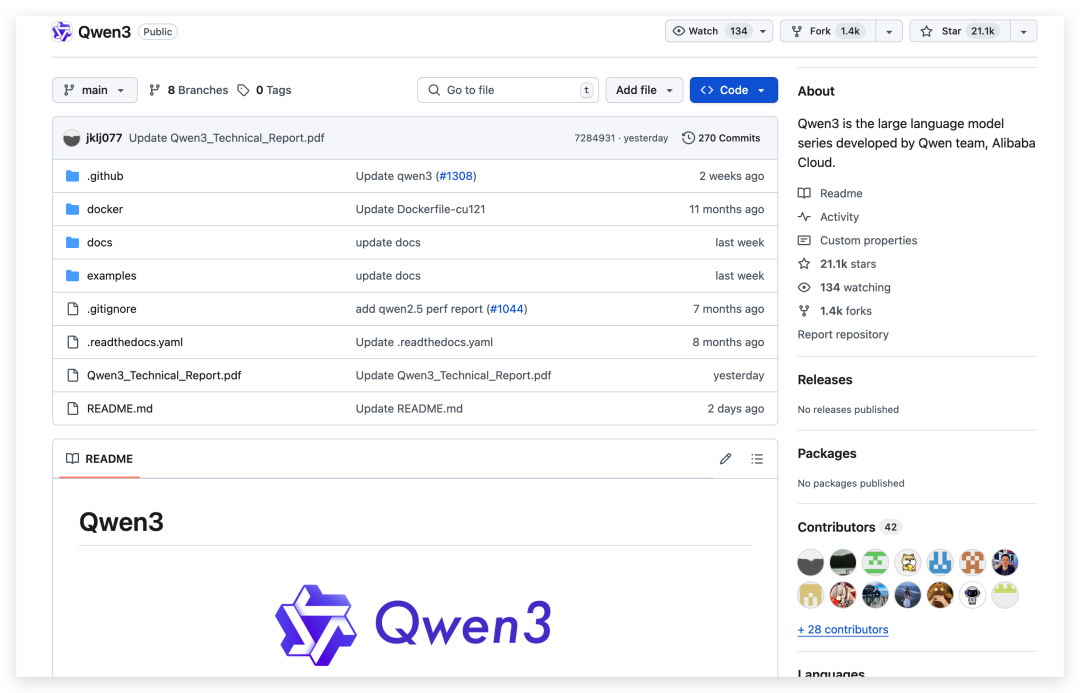
img

牛逼,我的开源项目 PmHub 快一年了也才三百多个 star。

还有一个很让我意外的新闻,国际权威媒体日本经济新闻(NIKKEI)4月公开的AI模型评分榜,阿里的通义千问在113个模型中排名第6,是排名第一的开源模型。
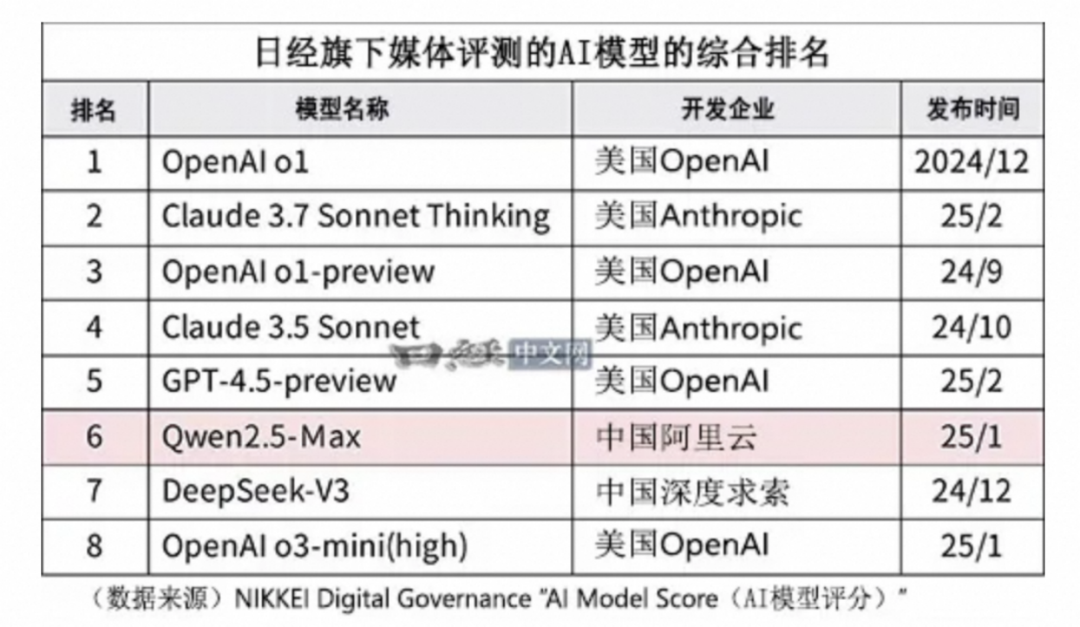
img

据说,日本企业中得分最高的模型ABEJA-Qwen2.5-32B正是基于千问开发,日经媒体官方甚至也表示:千问已经成为了日本AI开发的基础。

写到这里的时候,我其实是有些热泪盈眶的,忽然想起钱学森归国时说过的话:"手里没剑和有剑不是一回事。

Qwen3 目前能支持 119 种语言,还能支持一些地方语言。
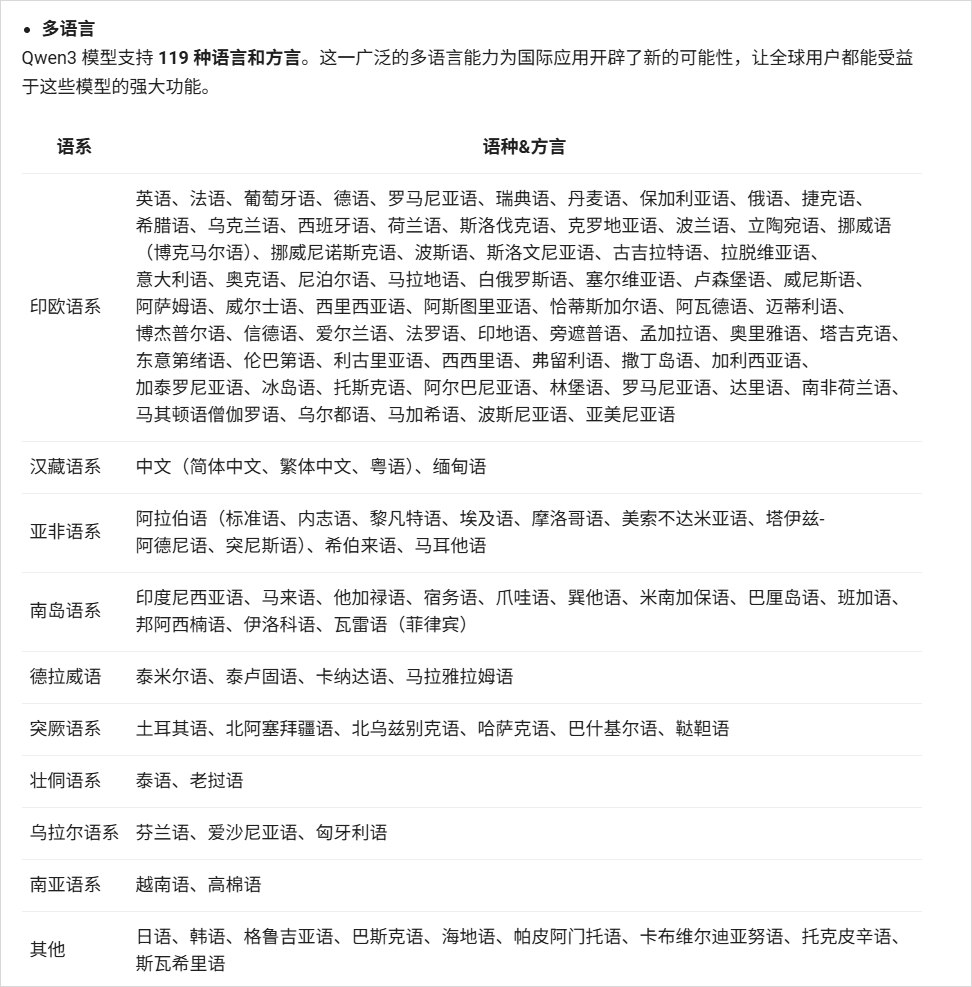
img

这个其实意义还蛮大的,别看 AI 这么火,但还是很多国家并没有技术能力去开发自己语种的 AI 大模型。

Qwen3 的开源,直接让他们有了可以依赖的开源模型。
img

可以看到的是,不止是日本,通义千问已经成为多国AI开发基础,

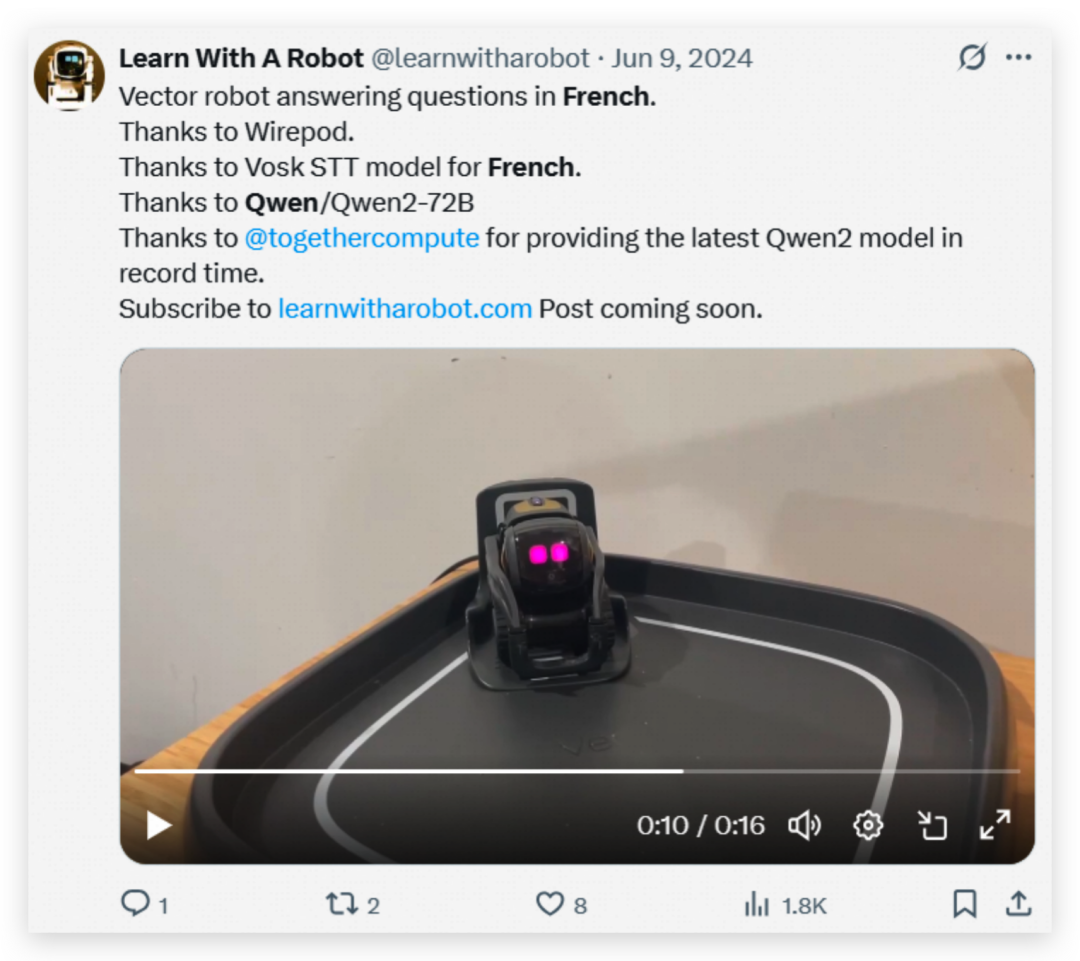
比如这位国外的 X 老哥基于Qwen/Qwen2-72B 开发了个用法语回答问题的机器人。
img

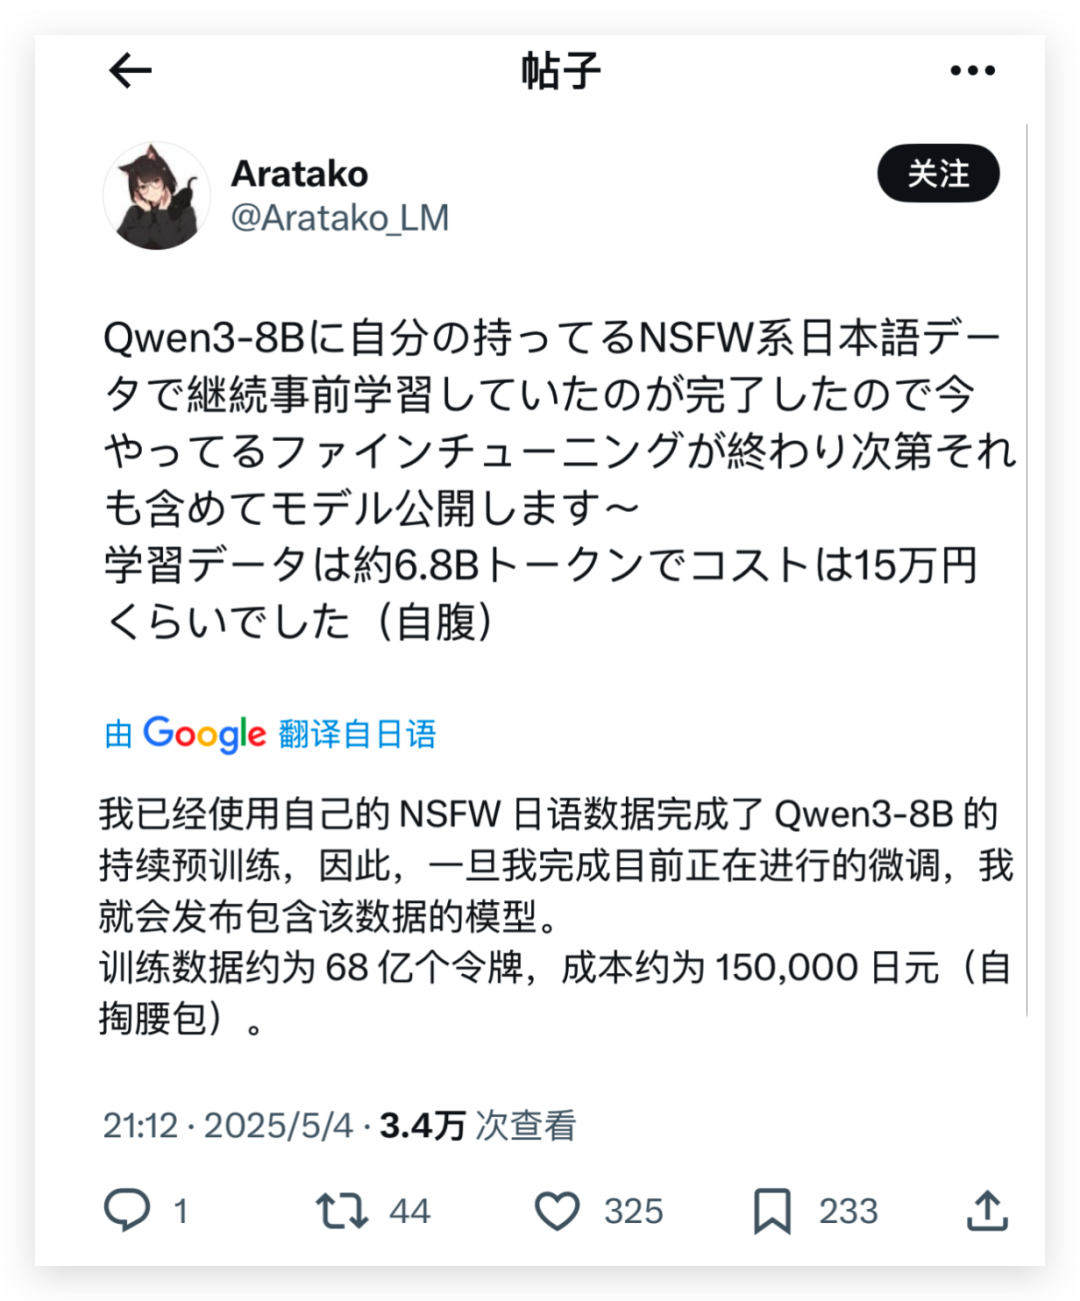
还有这个日本老哥(或是老姐?)用 Qwen3-8 B 进行日语微调。

img

我发现,在 X 上,对 Qwen3 大家还是相当认可的,国外博主都在争相报道。也难怪 GitHub 飙升的这么快。

突然感觉,这一幕似成相识,这不咱们这边蹲OpenAI的既视感吗?

在墙外人的眼中,它好像真是香饽饽。

很多人好奇为啥不是 DeepSeek?从数据来看,DeepSeek 的部署成本还是相对高了,Qwen3 的成本很低,旗舰模型235B参数部署成本几乎只要DeepSeek-R1的三分之一。

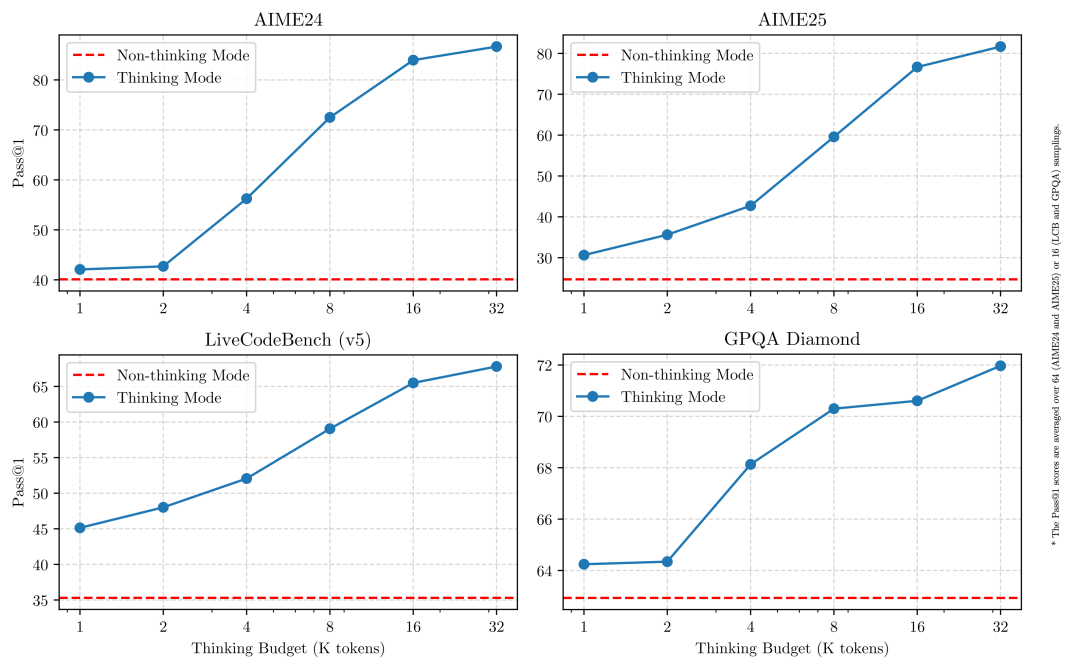
而且 Qwen3 是一个开源的混合推理模型,能够在思考模式和非思考模式下自由切换,可以帮助在成本效益和推理质量之间实现更优的平衡。
img

除此之外,Qwen3 在 Agent 能力上表现很出色,模型底层天然支持MCP协议。

这就很舒服了呀,也难怪那么人选择作为 AI 开发基础。

好啦,如果想更多了解,大家可以通过以下地址了解和体验 Qwen3:

Qwen Chat:https://chat.qwenlm.ai
通义 APP:https://www.tongyi.com/
GitHub:https://github.com/QwenLM/Qwen3

当然你也可以向苍何一样本地部署个小模型 Qwen3,玩一玩,还可以进行微调。

下面我们沉浸式体验下。

本地部署Qwen3

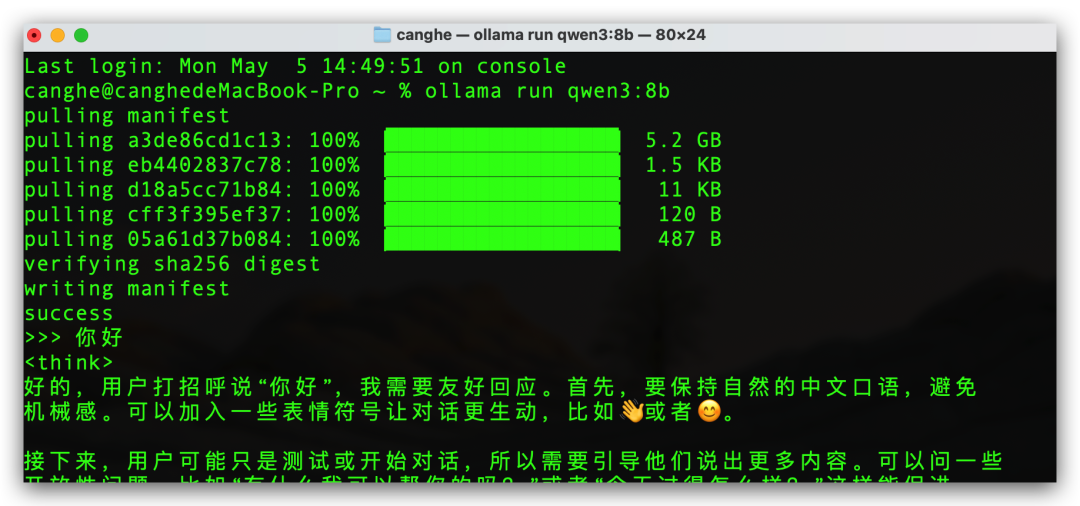
这里我依旧使用 Ollama 来部署。

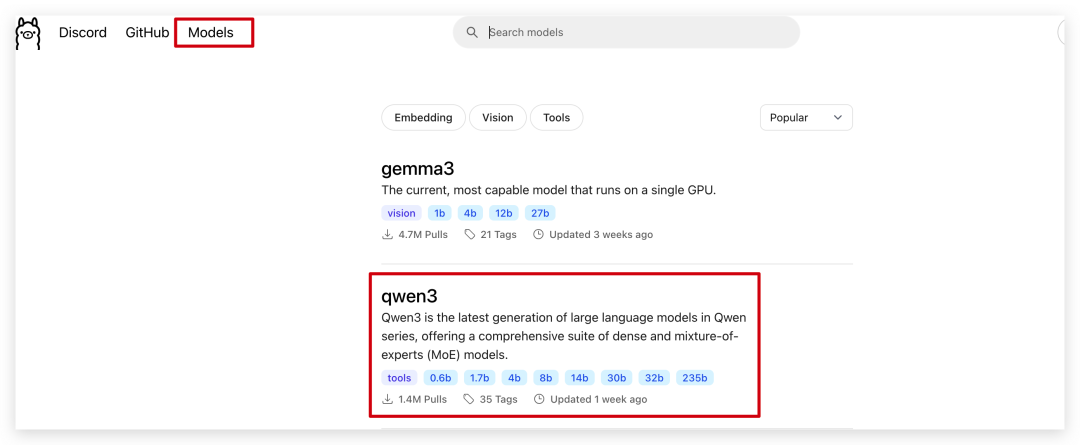
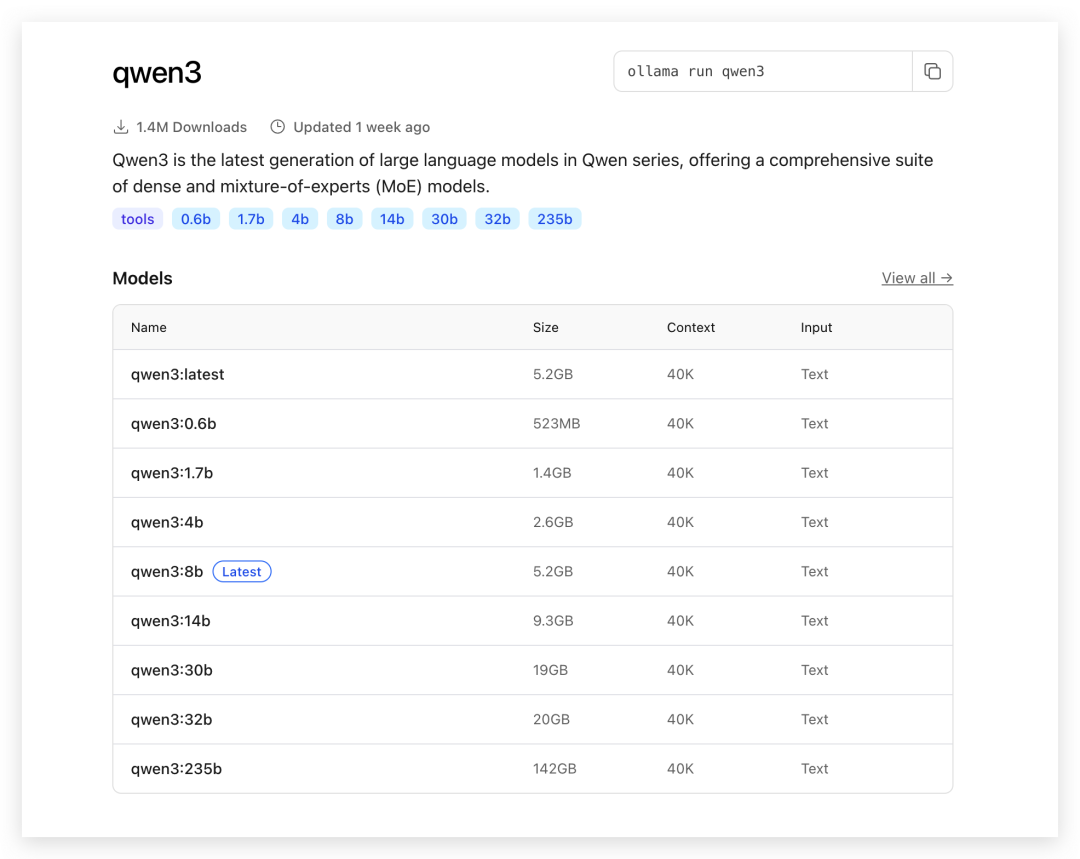
在 Ollama 选择 Models,找到 qwen3:
img

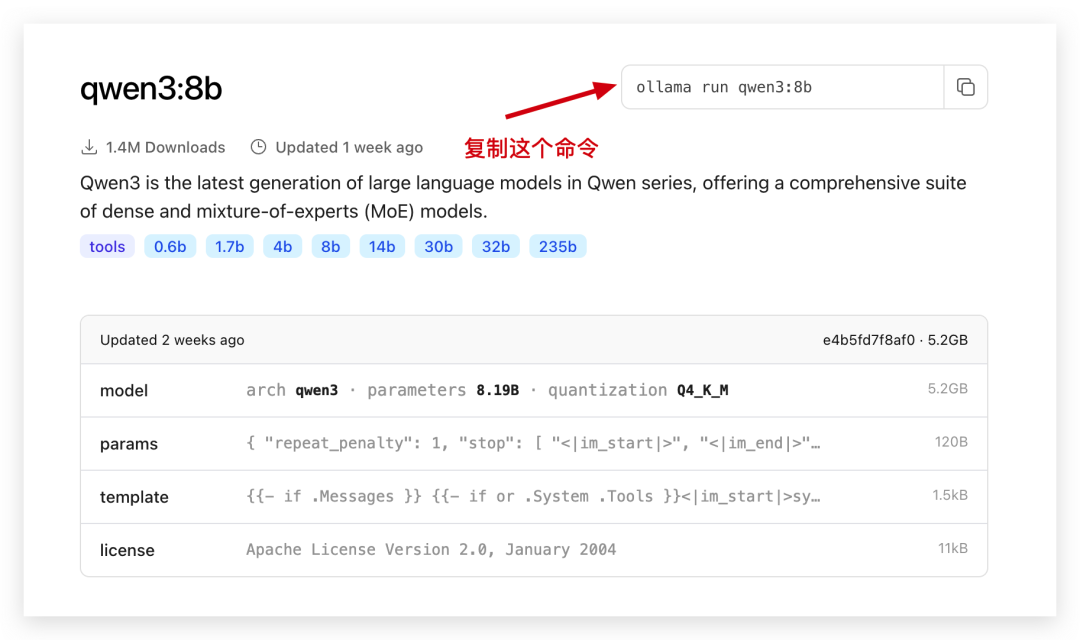
选择对应尺寸参数,我的 Mac 最多支撑 8 b 了。

具体计算大家可以参考这个公式:模型所需GPU内存大小≈模型大小×1.2。
我的 mac 是 16 G,理论上能跑 8 b。
img

复制这个命令,本地终端执行。

img

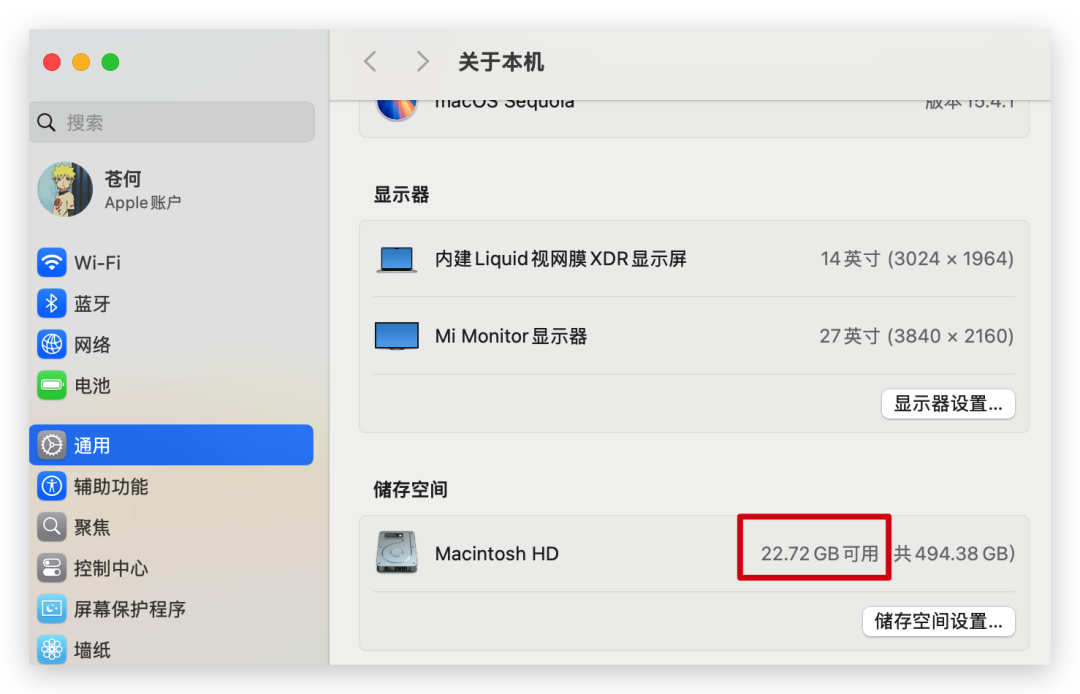
一共 5.2 G,偷偷看了一眼电脑剩余空间,留下了不争气的泪水。

img

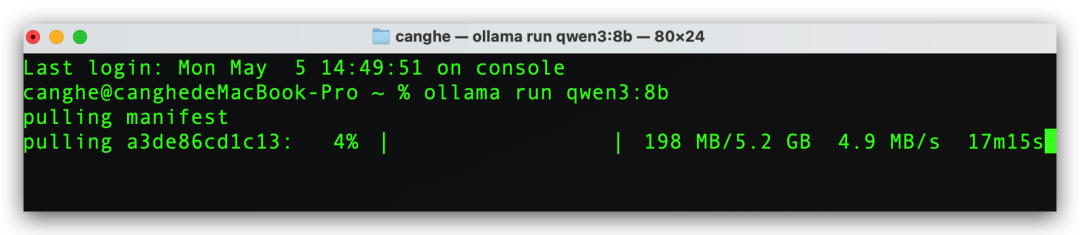
复制命令后,慢慢等他下载模型,等就好了。

img

部署完后,你就可以直接和他对话。

img

但我想没人会直接这么完。通常会结合具体的使用场景来搞。

下面是一些我觉得本地部署模型能给我们实际带来的一些帮助 case。

本地部署数据隐私可以保护,而且可以针对性的做微调,做 RAG。

知识库

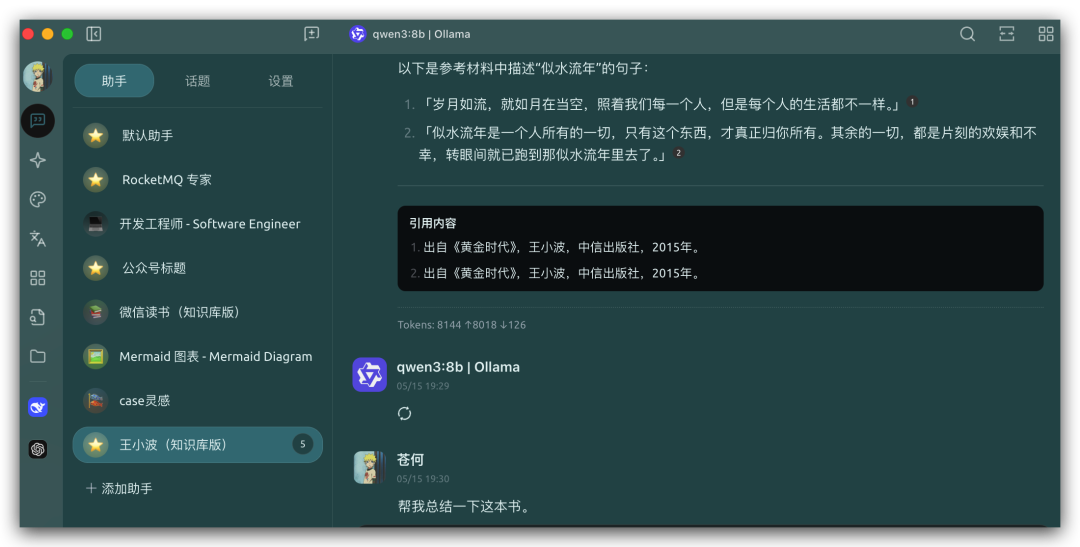
这里我用 Cherry Studio 做了 3 个知识库,把相应的数据导入。
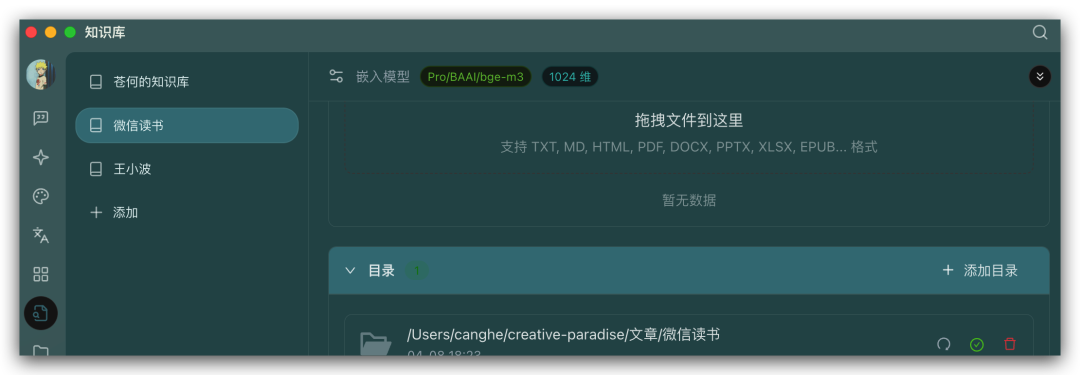
img

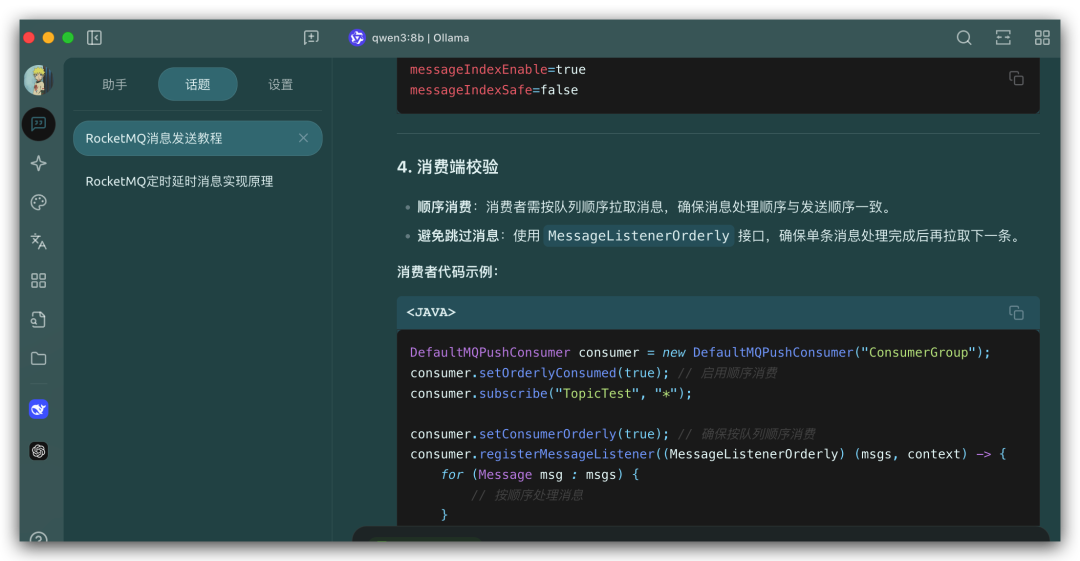
然后在模型这里选择刚部署的 Qwen3,就可以实现基于知识库的提问了。比如我的知识库里面有之前自己写的 rocketmq 专栏,他都能给我快速找到。
img

基于微信读书笔记进行特定语句提问以及总结。

img

整体效果我体验下来是比之前要好很多的。不过知识库不能太大,不能小模型也抵不住。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

Mac本地部署Qwen3:M系列芯片+llama.cpp+GGUF实战指南 大语言模型(LLM)本地化部署是当前AI工程实践的核心趋势之一,其本质是将模型推理能力从云端迁移至终端设备,在保障数据隐私与低延迟响应的同时,构建可控、可定制的智能工作流。技术原理上依赖于模型量化(如GGUF格式)、硬件加速(Apple Silicon的Metal后端)与轻量推理框架(如llama.cpp)的深度协同。该方案显著提升中文语义理解、代码生成与文档处理等场景下的实用性与工程鲁棒性,广泛适用于知识管理、结对编程、私有办公自动化等真实生产力环节。本文聚焦Mac平台,详解Qwen3在M系列芯片上的高效 阅读详情

相关推荐

Mac本地部署Qwen3:Metal加速+Ollama实战指南

大语言模型(LLM)本地化运行正成为开发者提升隐私性、低延迟与工作流集成能力的关键路径。其核心原理在于利用终端设备的硬件加速能力(如Apple Silicon的Metal神经引擎)替代云端API调用,通过量化压缩、内存优化与原生推理框架实现高效部署。技术价值体现在数据不出本地、响应毫秒级、可深度嵌入Terminal/ComfyUI/Obsidian等开发工具链。典型应用场景包括终端智能错误诊断、多模态截图转代码、个人知识库语义关联等。本文聚焦Mac平台,详解Qwen3开源模型在Ollama框架下的Metal

weixin_30134145的博客 243

Qwen3-Embedding-8B:文本嵌入界的“卷王”,多语言检索新标杆!

先来个官方介绍:Qwen3-Embedding-8B,是Qwen家族的最新专有嵌入模型,专为文本嵌入和排序任务设计,参数量高达8B(80亿),支持100+自然语言和多门编程语言,继承Qwen3系列的长文本理解、多语言、推理能力。但光说这些,怕你没感觉。文本嵌入,就是把一段文字变成一串“高维向量”,让机器能“理解”文本之间的相似关系。比如你问“北京是中国的首都吗?”,它能把“北京是中国的首都”这句话和你的问题变成很接近的向量,方便检索、排序、聚类、分类等一系列操作。8B参数量。

许泽宇的技术分享 6452

Mac本地部署Qwen3:Metal加速实战指南

大语言模型(LLM)本地化运行正成为开发者提升数据安全与响应效率的关键路径。其核心原理在于绕过云端API的网络延迟与权限限制,依托终端硬件(如Apple Silicon)实现CPU+GPU异构推理。技术价值体现在低延迟闭环、数据主权可控、可深度定制等维度,广泛应用于智能办公、PDF多模态分析、邮件自动化等真实工作场景。Qwen3作为阿里开源旗舰模型,原生支持macOS Metal加速,结合Ollama原生客户端与GGUF量化格式,可在M系列芯片上达成近实时推理性能。本文聚焦Mac平台下Qwen3的高效部署、

weixin_30296995的博客 327

Qwen3全系列对比:8B/14B/32B怎么选?云端2小时全测完

本文介绍了基于星图GPU平台自动化部署Qwen3-32B镜像的高效方案,用户可快速启动大模型实例,无需繁琐环境配置。该平台支持一键拉起高性能GPU资源,适用于模型微调、AI应用开发等场景,尤其适合需要对Qwen3系列进行性能对比与验证的技术团队,显著提升研发效率。

MoonbeamOwl67的博客 2214

Mac本地部署Qwen3:开源大模型在M系列芯片上的实战指南

本地大模型是指不依赖云端API、直接在终端设备上运行的开源语言模型,其核心原理是通过模型量化、硬件加速(如Apple Metal)和轻量推理框架(如llama.cpp)实现高效推理。技术价值在于保障数据隐私、降低延迟、提升工作流嵌入性与可控性。典型应用场景包括技术文档摘要、代码辅助重构、会议纪要结构化等生产力任务。本文聚焦Mac平台——依托M系列芯片的统一内存架构与Metal加速栈,实测部署Qwen3-4B开源模型,详解从Hugging Face权重下载、GGUF格式转换、Q4_K_M量化到Python直驱

weixin_29816689的博客 296

Mac本地部署Qwen3:Apple Silicon+开源大模型实战指南

大语言模型(LLM)本地化部署正成为隐私敏感、离线可用与可控AI落地的关键路径。其核心原理在于模型量化、硬件加速(如Metal)与轻量推理框架的协同优化,技术价值体现在低延迟响应、数据不出域及全链路可审计。典型应用场景覆盖内容创作、数据分析、教育演示与企业内网AI工具集成。本文聚焦Mac平台——依托Apple Silicon统一内存架构与Metal加速能力,深度适配Qwen3-8B开源模型,结合Ollama+Q5_K_M量化+MCP协议原生支持,实现高性能、低功耗、开箱即用的本地AI生产力闭环。

weixin_31499265的博客 278

Qwen3-8B 与 Qwen3-14B 的 TTFT 性能对比与底层原理详解

Qwen3 系列是通义实验室于 2025 年推出的最新一代大语言模型,包含 6 个密集模型(Qwen3-0.6B、Qwen3-1.7B、Qwen3-4B、Qwen3-8B、Qwen3-14B、Qwen3-32B)和 2 个 MoE 模型(Qwen3-30B-A3B、Qwen3-235B-A22B)。其中,Qwen3-8B 和 Qwen3-14B 作为中型和大型密集模型的代表,均支持32K token的上下文长度,但在响应速度(TTFT)和推理效率上存在显著差异。

喜欢猪猪 2643

Mac本地部署Qwen3:GGUF量化+llama.cpp零依赖实战

大语言模型本地化部署正成为数据安全与低延迟场景的核心需求。基于Apple Silicon芯片的macOS系统,凭借统一内存架构和Metal加速能力,为轻量级推理提供了独特优势。Qwen3系列采用FP16+GGUF双轨发布,结合llama.cpp原生适配,显著降低内存占用与温控压力;其深度耦合的文本理解、代码生成与工具调用能力,使模型不再局限于对话,而可作为本地智能体调度中心。本文聚焦Mac平台真实工程约束——绕过Homebrew、Docker与Conda,实现零依赖编译、OpenAI兼容API服务及VS C

weixin_30694389的博客 383

我在Mac上部署了阿里Qwen3,这3个玩法让我上头

大家好,我是苍何。五一回老家那会,和发小吃了个饭,聊到了现在的 AI。发小说看我玩 AI 玩的挺疯的,也想用在工作中提效,可公司电脑不让联网。这一下就把我拉回到了数年前,在讯飞某保密项目中无网干撸代码的情形。这真是太痛苦了。为了让发小能在工作中用到 AI,我尝试教他本地部署最近很火的 Qwen3。并发现了下面 3 种有趣实用的玩法,该说不说,Qwen3 确实让人上头。经过一番折腾,发现果然官方说的“”,诚不欺我。

一个成长中的程序员,期待用技术的眼光生活 1483

开源模型应用落地-qwen模型小试-Qwen3-8B-快速体验(一)

阿里云推出国内首个集成“快思考”与“慢思考”能力的 Qwen3-8B 大语言模型,以80亿参数和 128K 上下文支持,重塑AI应用边界并助力开发者高效部署

以微薄之力,予他人些许温暖. 2万+

Ollama部署Qwen3-Embedding和Qwen3-Reranker

wen3 Embedding系列是基于Qwen3开发的专有文本嵌入与排序模型,提供0.6B、4B和8B三种尺寸选择。该系列支持100+种语言,具备32k上下文长度,并允许自定义输出维度(32-4096)。

没刮胡子的程序员专栏 3255

让Mac mini秒变AI工作站!手把手教你本地部署运行Qwen3,白嫖阿里千亿级AI

根据各平台测试结果显示,Qwen3在表现出色,全面吊打DeepSeek开源的R1模型以及OpenAI的o1模型等知名对手。

2301_81888214的博客 3384

告别付费!手把手教你用DataV.GeoAtlas获取全国街道级GeoJSON数据(附完整避坑指南)

本文详细介绍了如何免费使用阿里云DataV.GeoAtlas工具获取全国街道级GeoJSON数据。通过可视化选取、格式转换、数据校验等步骤,提供了一套完整的避坑指南和工作流,帮助前端和可视化开发者高效解决高精度地图数据获取难题,节省成本并提升开发效率。

weixin_29085865的博客 900

用ollama在PC一键私有化部署qwen3

阿里最新开源的Qwen3模型在多个领域表现优异,甚至超越了一些知名模型如OpenAI-O1和谷歌Gemini2.5。Qwen3提供了两个系列模型:混合专家模型MOE和稠密模型,分别适合不同型号的机器。MOE模型如Qwen3-235B-A22B通过激活最擅长的“专家”参数,实现快速且准确的推理。稠密模型如Qwen3-32B则在推理过程中激活所有参数,性能同样强劲。用户可以通过官网免费使用Qwen3,或通过API调用。对于需要私有部署的用户,ollama提供了一键安装和运行Qwen3的便捷方式。此外,文章还提到

m0_65555479的博客 1803

某10kV纺织厂供电系统设计【CAD图纸源码+Word文档】

本文详细介绍了设计变电所原始资料,负荷统计,基于负荷统计给出了变压器的选型,变电所主接线方式的设计、高低压母线、电缆的技术要求、短路电流的计算以及相关电气设备的保护参数及保护定值的计算、安全措施的规定。

weixin_761237174的博客 2744

SCRFD算法解读及环境安装实践

SCRFD检测算法及环境安装

lishanlu136的博客 1009

零基础也能玩转AI!手把手教你本地部署阿里Qwen3大模型

Qwen3的本地部署不仅让普通用户也能体验顶尖AI技术,更为开发者提供了无限创新可能。无论是学生、程序员,还是科研工作者,都能从中找到适合自己的解决方案。赶紧按照教程动手试试吧!

kaka0722ww的博客 1699

D触发器版图设计的艺术:最小化面积与最大化性能的平衡之道

本文探讨了D触发器版图设计中如何平衡最小化面积与最大化性能的核心挑战。通过分析晶体管布局、互联优化、时钟分布等关键策略,结合先进制程下的功耗与信号完整性考量,为数字IC工程师提供了从基础优化到制造验证的实用解决方案,助力实现高性能、低面积的芯片设计。

aa123的博客 910

Mac mini秒变AI工作站!本地部署运行Qwen3全指南,免费使用阿里千亿级AI模型!

阿里巴巴最新发布的大规模语言模型Qwen3在性能测试中表现卓越,超越了DeepSeek的R1模型和OpenAI的o1模型。本文提供了在Mac mini M4上部署Qwen3的详细教程,包括下载和安装必要的软件,以及如何设置和使用不同参数规模的Qwen3模型进行本地运行。此外,文章还探讨了大模型AI技术的快速发展及其对就业市场的影响,指出掌握AI技术的从业者将获得显著的生产效率和薪资优势。最后,作者分享了一系列AI大模型学习资源,旨在帮助读者快速掌握相关技能,提升在AI领域的竞争力。

2401_85343303的博客 8628

手把手教你学Simulink——光伏储能系统双向DC-AC逆变器恒功率控制(PQ控制)仿真

本文详细介绍了光伏储能系统中双向DC-AC逆变器的恒功率控制(PQ控制)仿真方法。主要内容包括:1)PQ控制原理及其在光伏满发和储能充放电中的应用;2)系统架构设计,重点推导了功率到dq电流的数学映射关系及电流内环控制算法;3)Simulink建模步骤,涵盖功率电路搭建、PLL设计、电流参考转换等关键环节;4)仿真结果分析,验证了系统在10kW光伏满发和-5kW储能充电模式下的稳态精度和动态切换性能;5)工程实践建议,包括数字控制延迟补偿、低电压穿越处理等实际问题解决方案。该指南为新能源并网系统的功率精准控

MHD0815的博客 425

Android功耗系列专题理论之一:功耗优化分析思路简介

本文系统介绍了电子系统功耗分析方法,涵盖静态与动态功耗原理、电流波形分析技术和模块化拆解策略。重点阐述了PMIC与CPU协同管理机制、DVFS动态调节技术,以及通过示波器捕获波形特征定位异常的方法。针对亮屏等典型场景,提出三阶段对比分析法,并详细说明硬件/软件拆解方案及混合验证策略。文章还总结了常见问题模块(CPU、多媒体、外设)的排查流程,强调需结合日志分析、温度控制及重复测试确保数据可靠性,为功耗优化提供系统化解决方案。

1459

阿里Qwen3.8-27B完全部署指南:消费级显卡跑270亿参数原生多模态模型

阿里Qwen3.8-27B开源完全部署指南:270亿参数Dense模型原生多模态,RTX 4060 Ti 16GB INT4量化即可流畅运行,含Ollama/llama.cpp/vLLM三种部署方案全解析。

deepin20100的博客 4869

把 SAP Fiori Launchpad 配置文件放进 MIME Repository:从上传、缓存控制到可访问路径的完整实践

文章摘要: 在 SAP Fiori 项目中,Launchpad 配置文件的部署是关键挑战,核心在于通过 MIME Repository 而非直接修改标准文件来实现稳定配置。与 BSP Repository 相比,MIME Repository 支持显式设置客户端缓存时间(如 SAP 推荐的 7 天),适合生产环境治理。配置文件需为 JSON 格式,部署时需确保路径可访问(通过 ICF node 和 external alias),并注意语法错误会导致静默失效。实操步骤包括:在 SE80 中创建专用目录、设置

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 92
上一篇: AI大模型趋势报告丨2025Q1:从“思考型模型”到中国AI崛起
下一篇: 2025年,多模态特征融合只会更火
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值