华为&中科大最新进展!VLADBench:多模态自动驾驶大模型的细粒度评测与分析

多模态感知融合算法详解:自动驾驶核心要点 深入解析多模态感知融合算法如何提升环境识别精度,助力自动驾驶系统实现高效决策与安全行驶,是当前自动驾驶技术发展的核心方向之一。 阅读详情

概述

**随着多模态大模型(VLMs)在自动驾驶领域中的快速发展,考量现有VLMs是否能够胜任智驾,以及如何面向智驾的实际应用 是非常具有应用价值的课题。为此,作者提出了*VLADBench*,一个具有挑战性且细粒度的评估数据集,包含从基础知识和静态元素到动态路况推理的封闭式问答。所提出的评估基准涵盖了五个关键领域:*交通知识理解*、*通用要素识别*、*交通图谱生成*、**目标属性理解**以及*自车决策与规划*。为了更精细的评估,这些领域进一步细分为二级的**11**个方面和三级的**29**个任务。*VLADBench*包含2000个静态和3000个动态场景,经人工挑选于12个开源数据集,标注QAs总计12K。

**作者首先在20个通用(4B->76B)和垂域的VLMs上进行了全面评估,揭示了它们在智驾领域中的优势与关键限制。进一步地,为了探索五大关键领域之间的认知与推理之间的交互关系,作者从一个小规模的通用模型出发,在各个领域的数据集上训练垂域模型(训练数据集构建于1.4M个开源QAs)。通过*VLADBench*, 分别验证五大领域数据对自动驾驶场景中的**理解推理**和*运动规划*上的作用。

**一系列实验结果表明,*VLADBench*能够更全面地评估VLMs在自动驾驶领域的性能表现,其五大关键领域的设计进一步推动模型向更具推理能力、更智能、更可靠的方向发展。

*结论*

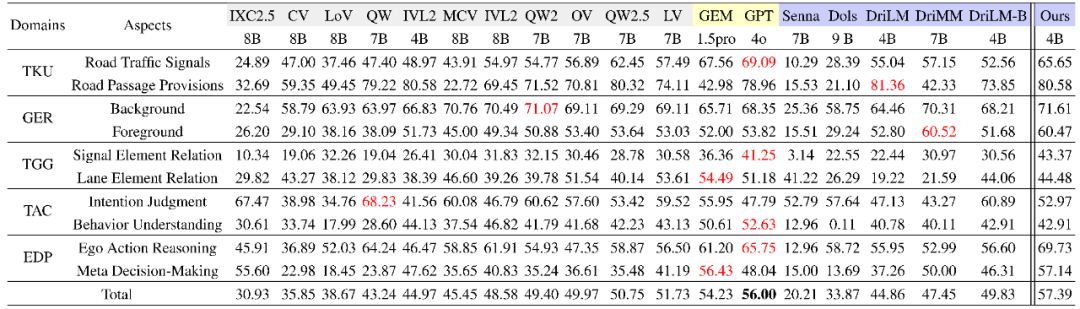
  1. **当前的VLMs,包括Qwen2.5-VL-72B、GPT-4o 或垂域模型DriveMM,在*VLADBench*上的准确率仍未达到 60%,说明现有VLMs在面向智驾实际应用上仍有很大的提升空间。
  2. 在交通信号理解与图谱生成、交通参与者的意图判断、自车的决策这几个方面,现有模型表现得尤为糟糕,而这些是通往自动驾驶实际应用所必需的能力。
  3. 特定的垂域训练数据虽然可以在某些自动驾驶专用任务中提升模型性能,但却可能导致模型在某些需要通用知识和能力的智驾任务上表现不佳。
  4. 按照五个关键领域划分的垂域数据是相互关联的,不仅表现出了跨领域的互补优势,还展现出显著的协同效应。
  5. 扩展自动驾驶VLMs,提升视觉编码器的性能可能比单纯扩大语言模型的规模更为关键。

*介绍*

作者首先观察到现有的自动驾驶领域中的评估基准存在以下几个方面的不足:

  • *粗粒度类别*: 现有的评估数据集通常将任务划分为感知、预测和规划等方面,无法全面评估自动驾驶面向实际应用时所需的认知和推理能力。
  • *缺乏动态元素分析*: 现有的评估数据集侧重于静态场景,而忽略了对动态场景中时序推理能力(特别是交通参与者的意图理解和时空推理能力)的有效评估。
  • *数据集同质化*: 现有评估数据集缺乏多样性,难以测试模型在各种真实场景下的泛化能力和对“corner cases”(极端情况)的处理能力。

*结构化分层设计*

***VLADBench*将自动驾驶任务分解为五个关键领域,每个领域又进一步细分为多个方面和任务。这种分层结构允许对VLMs的能力进行精细的评估,并识别模型在特定领域的优势和劣势。任务划分的目的是模拟人类驾驶员在不同认知层面上的决策过程,从对交通规则和环境的理解开始,到最终的驾驶决策和运动规划。

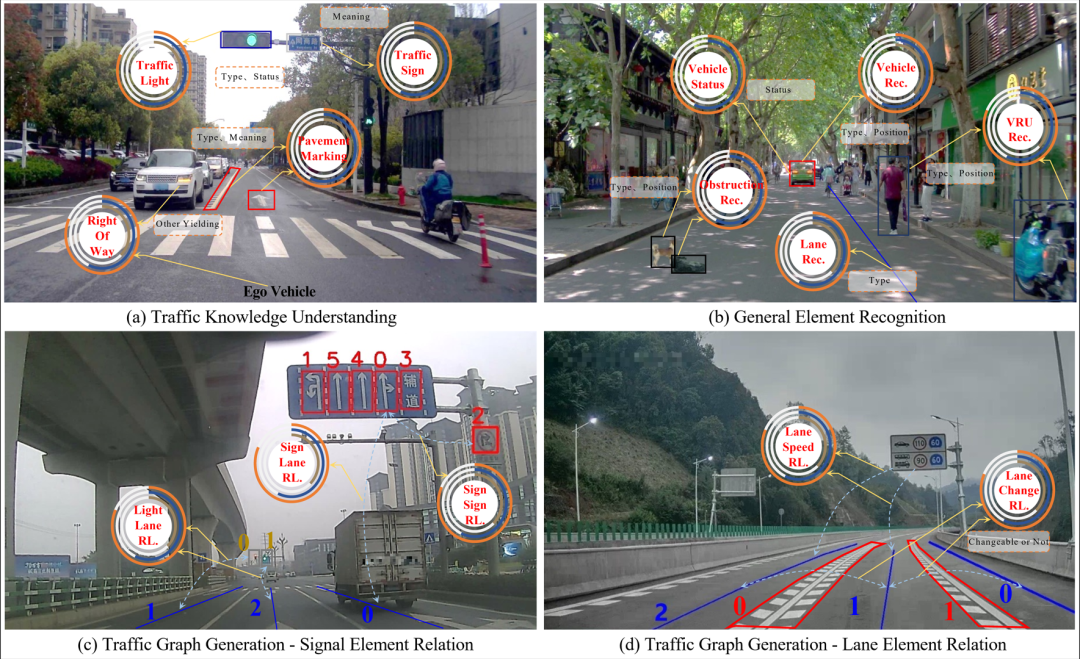
**下图展示了*交通知识理解*、*通用要素识别*、*交通图谱生成*中的图例。其中Rec表示识别,RL表示关系。
img

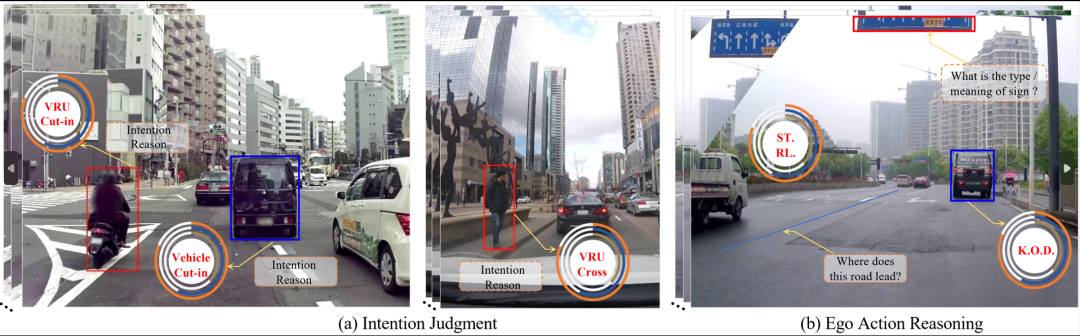
**下图展示了**目标属性理解**中意图判断以及*自车决策与规划*中关键物体检测和时空关系推理。
img

更多详细图例,请参见原文。

*封闭式问答设计*

**为了实现精确的评估,*VLADBench*采用了封闭式问答形式。每个问题都配有一组预定义的答案选项,模型需从中选出正确答案。这种方式有效避免了开放式问答中答案歧义性和主观性的影响,使得评估结果更加可靠和可重复。为了增加评估难度,答案选项通常在语义或结构上保持相似,从而提升了问题的挑战性。

*数据标注与评估指标*

*VLADBench* 从12个公共数据集中收集数据,确保了数据集的多样性和覆盖面。数据筛选和标注过程使用了具有相关经验的专业人员,对数据的难度进行统一的控制,并对收集到的数据进行标注。标注过程采用多重审核机制,以确保标注质量和一致性。评估指标主要由准确率和指令遵从率构成,此外针对不同的任务加入更细致的指标,如识别任务增加IOU指标,轨迹预测增加L2和碰撞率。

*VLADBench评估结果*

作者在20个开源和闭源的通用模型(4B->76B)以及垂域模型上进行了测试,部分测试结果如下。
(详细结果以及分析见原文。)
img

*五大领域的交互关系*

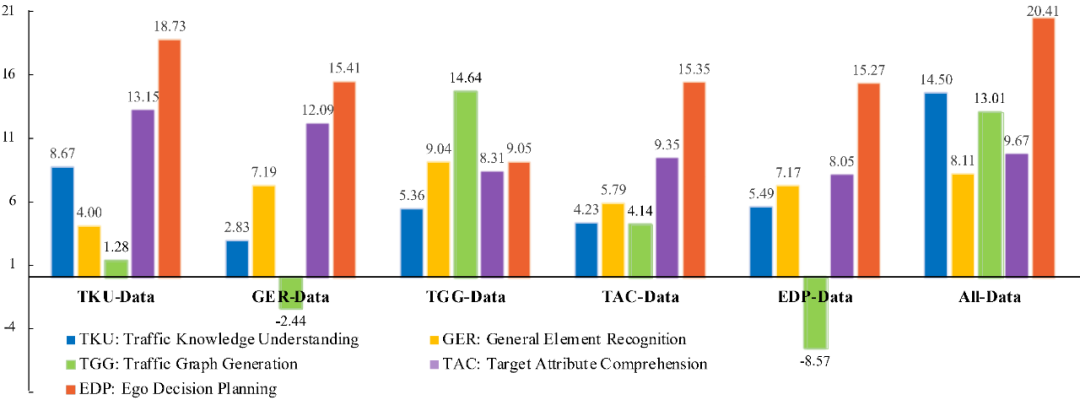
**由上表中垂域模型结果可以得出:特定的垂域训练数据可以在自动驾驶的某些专门领域提高性能,但可能会导致模型在需要更广泛和通用知识的任务中丧失泛化能力。为了深入探索本文五个关键领域之间的相互关系,我们使用不同领域的垂域数据集分别训练基模型(垂域训练数据来自于1.4M开源QAs,通用训练数据来自于1.3M开源QAs且数量保持不变),并在*VLADBench*上的不同领域进行测试。
与基模型相比的性能收益图如下所示:
img

我们可以看出每个领域数据的作用并非孤立存在,它们也会对其他领域产生积极的影响。当所有数据一起训练时,模型出现明显的协同效应,除交通图谱生成外,各领域的表现均高于单独训练每个领域时的表现。

*五大领域对运动规划的影响*

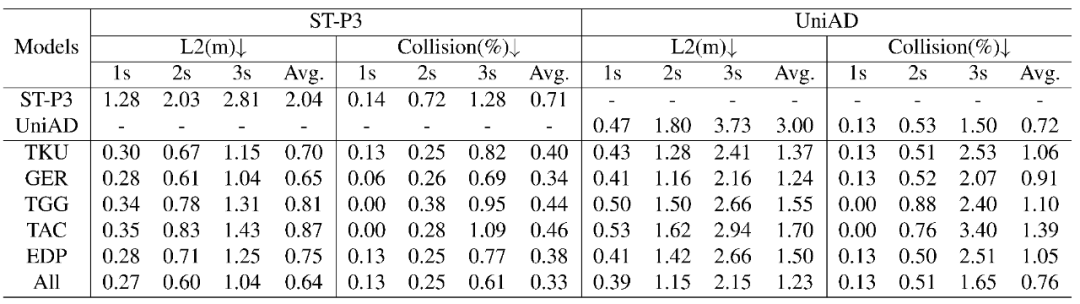
最后,作者将轨迹预测任务单独取出,分别验证模型五大领域能力对运动规划的影响。训练过程中,作者基于nuScenes中构建了4K个带有场景分析和轨迹预测的数据集,并结合上述的各领域数据进行训练,在800个数据上进行测试。实验结果如下:
img

可以观察到,GER(通用要素识别)数据对轨迹预测任务最为重要,其次是EDP(自车决策与规划)数据。TKU(交通知识理解)数据的结果与EDP数据相当,这表明交通知识的理解在轨迹预测中也起到了至关重要的作用,而这是传统模型无法实现的能力。尽管TGG(交通图谱生成)和TAC(目标属性理解)数据在L2距离方面的实验结果较差,但它们显著降低了短期内的碰撞率。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

万字长文总结多模态大模型最新进展(Modality Bridging篇) 方法上,引入 vit 做图像的 encoder 和 MLP adapter,来将图像编码到和 text 一样的 embedding 空间中,然后是在 LLM 的各层添加 visual expert,它具有独立的 QKV 和 FFN 相关的参数,并使用 LLM 中的层来做初始化,训练的时候冻结已经训练好的 LLM 部分,训练图像相关的部分。比如在实际实验中,ViT-L/14 的模型的输出的特征是 257x1024 的大小,最后也是 32x768 的 Query 特征。首先,是响应格式上的模糊提示。 阅读详情

相关推荐

多模态AI在自动驾驶中的应用与挑战

多模态AI, 自动驾驶, 计算机视觉, 自然语言处理, 语音识别, 传感器融合, 深度学习, 挑战 1. 背景介绍 自动驾驶技术作为未来交通运输的重要发展方向,近年来取得了显著进展。传统的自动驾驶系统主要依赖于单一传感器数据,例如摄像头、雷达或激光雷达,但单一传感器的数据往往存在局限

AGI×大数据,开启智能时代的认知跃迁;解码AGI,赋能数据驱动的智能革命。 1525

2022最新综述!一文详解自动驾驶中的多模态融合感知算法(数据级/特征级/目标级)...

点击下方卡片,关注“自动驾驶之心”公众号ADAS巨卷干货,即可获取后台回复【多模态综述】获取论文!后台回复【ECCV2022】获取ECCV2022所有自动驾驶方向论文!后台回复【领域综述】获取自动驾驶全栈近80篇综述论文!1简介多模态传感器融合意味着信息互补、稳定和安全,长期以来都是自动驾驶感知的重要一环。然而信息利用的不充分、原始数据的噪声及各个传感器间的错位(如时间戳...

CV_Autobot的博客 5757

STM32CubeMX+FreeRTOS实战:3步搞定LED任务配置(附代码解析)

本文详细解析了如何使用STM32CubeMX图形化工具配置FreeRTOS实时操作系统,并创建LED闪烁任务。通过剖析MX_FREERTOS_Init()函数和CMSIS-RTOS封装层,深入理解任务创建、调度及osDelay()协作机制,帮助开发者从点击生成进阶到内核原理掌握,实现高效的多任务嵌入式开发。

weixin_29192141的博客 469

2024自动驾驶(多模态)大模型综述:从DriveGPT4、DriveMLM到DriveVLM、DriveMM

​ 本文主要涉及以下4篇paper的解读(按发表的时间顺序排列) DriveGPT4: Interpretable End-to-end Autonomous Driving via Large Language Model DriveMLM: Aligning Multi-Modal Large Language Models with Behavioral Planning States for Autonomous Driving DriveLM: Driving with Graph Visual

结构之法 算法之道 2万+

用CesiumLab2+nginx零成本构建三维地形服务:从DEM数据到浏览器渲染全流程

本文详细介绍了如何利用CesiumLab2和nginx零成本构建私有三维地形服务的完整流程。从获取DEM数据、使用CesiumLab2进行格式转换,到配置nginx服务器并重点解决跨域问题(Access-Control-Allow-Origin),最终实现在Cesium中流畅加载与渲染自定义地形,为内网或涉密项目提供了高性价比的解决方案。

weixin_29300931的博客 118

基于CODESYS与EtherCAT的步进电机单轴控制实践

本文详细介绍了基于CODESYS平台与EtherCAT总线技术实现步进电机单轴控制的完整实践流程。从硬件选型、软件工程创建、EtherCAT主从站配置,到运动控制功能块编程与在线调试,手把手指导读者完成从零到一的搭建,并提供了常见问题的排坑指南,帮助自动化开发者快速掌握这一高效、灵活且成本可控的工业运动控制解决方案。

hh234的博客 491

综述:自动驾驶中的多模态 3D 目标检测

论文笔记:《Multi-modal 3D Object Detection in Autonomous Driving: A Survey and Taxonomy》

学习记录 4326

别再踩坑了!QT5.15.2配置Android开发环境保姆级避坑指南(含Java8、SDK Tools版本选择)

本文提供QT5.15.2配置Android开发环境的详细避坑指南,重点解决版本锁定、SDK工具选择和QtCreator配置等常见问题。通过实测推荐的Java8、Android SDK Tools版本及NDK配置,帮助开发者高效完成环境搭建,避免隐性冲突和配置失败。

weixin_42537919的博客 240

一文详解自动驾驶中的多模态融合感知算法(数据级/特征级/目标级)

点击下方卡片,关注“自动驾驶之心”公众号ADAS巨卷干货,即可获取>>点击进入→自动驾驶之心【多传感器融合】技术交流群论文作者| 汽车人编辑 | 自动驾驶之心1 简介多模态传感器融合意味着信息互补、稳定和安全,长期以来都是自动驾驶感知的重要一环。然而信息利用的不充分、原始数据的噪声及各个传感器间的错位(如时间戳不同步),这些因素都导致融合性能一直受限。本文全面调研了现有多模态自动驾驶...

CV_Autobot的博客 1万+

拼多多Android面试题及参考答案

Android 系统采用分层架构设计,从底层到上层依次为Linux 内核层硬件抽象层(HAL)系统运行时库层应用框架层应用层,共五层。位置:Linux 内核层与系统运行时库层之间,是“硬件与系统的隔离层”。核心作用:屏蔽硬件差异,为上层提供统一的硬件访问接口,解决 Android 开源与硬件厂商闭源的矛盾,具体功能如下:硬件能力抽象:将硬件的具体实现(如不同厂商的摄像头芯片、音频芯片)封装为标准化接口(如Camera HALAudio HAL。

大模型大数据攻城狮的专栏 1285

cartographer实现纯定位

实现纯定位 (1)因为正常的cartographer的建图的map是由cartographer发布的;如下 rostopic info /map Type: nav_msgs/OccupancyGrid Publishers: * /cartographer_occupancy_grid_node 因此需要把map的发布替换成 <node name="map_server" pkg="map_server" type="map_server" args="/home/lx.

Studying…… 5888

2023最新综述!自动驾驶中的多模态3D目标检测(特征表示/对齐/融合)

点击下方卡片,关注“自动驾驶之心”公众号ADAS巨卷干货,即可获取点击进入→自动驾驶之心【多传感器融合】技术交流群后台回复【3D检测综述】获取最新基于点云/BEV/图像的3D检测综述!自动驾驶车辆需要持续的环境感知以获得障碍物的分布,从而实现安全驾驶。具体来说,3D目标检测是一个至关重要的功能模块,因为它可以同时预测周围物体的类别、位置和大小。一般来说,自动驾驶汽车配备了多个传感器,包括摄像头和激...

CV_Autobot的博客 4823

探索数据库领域 SQL 的 JSON 数据处理技巧

在当今数字化时代,JSON(JavaScript Object Notation)作为一种轻量级的数据交换格式,被广泛应用于各种领域,如 Web 应用、移动应用、大数据处理等。数据库作为数据存储和管理的核心,需要具备处理 JSON 数据的能力。本文章的目的在于深入探索 SQL 语言在数据库中处理 JSON 数据的技巧,涵盖从基础的 JSON 数据查询到复杂的 JSON 数据操作,帮助读者全面了解和掌握 SQL 处理 JSON 数据的方法。

2502_91592937的博客 925

学术最前沿!2024最新深度多模态数据融合综述来袭!

多模态人工智能 (Multimodal AI) 通常涉及各种类型的数据(例如,图像、文本或从不同传感器收集的数据)、特征工程(例如,提取、组合/融合)和决策。随着架构变得越来越复杂,多模态神经网络可以将特征提取、特征融合和决策过程集成到一个模型中。这些过程之间的界限越来越模糊。融合所基于的传统多模态数据融合分类法(例如,早期/晚期融合)已不再适合现代深度学习时代。编码器-解码器方法注意力机制方法图神经网络方法生成神经网络方法和其他基于约束的方法。大多数现有的。

具身机器人和通用AI 3299

Python 爬虫 + 数据分析:社会调查数据抓取与结果可视化分析

在当今数字化时代,数据已成为推动社会发展的关键资源之一。无论是市场调研、学术研究还是政策制定,社会调查数据都扮演着至关重要的角色。通过 Python 爬虫技术,我们可以高效地获取这些数据,并结合数据分析与可视化工具,深入挖掘数据背后的价值。本文将通过一个完整的实战项目,带你掌握如何使用 Python 爬虫抓取社会调查数据,并进行可视化分析。

yansideyucsdn的博客 126

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

自动驾驶~多模态融合感知算法

然而,只有少数的综述[15, 81]聚焦于多模态融合的方法论本身,并且大多数文献都遵循传统分类规则,即分为前融合、深度(特征)融合和后融合三大类,重点关注算法中特征融合的阶段,无论是数据级、特征级还是提议级。此外,在输入和特征空间的转换过程中,还存在一些其他信息的丢失。多模态融合离不开数据表达形式,图像分支的数据表示较简单,一般均指RGB格式或灰度图,但激光雷达分支对数据格式的依赖度较高,不同的数据格式衍生出完全不同的下游模型设计,总结来说包含三个大方向:基于点、基于体素和基于二维映射的点云表示。

whaosoft143ai的博客 894

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

多模态大语言模型最新进展

在过去的一年中,多模态大型语言模型(MM-LLMs)取得了实质性的进步,通过成本效益良好的训练策略增强了现成的LLMs,以支持MM输入或输出。由此产生的模型不仅保留了LLM固有的推理和决策能力,还为各种不同的MM任务提供了动力。在本文中,我们提供了一个全面的调查报告,旨在促进MM-LLMs的进一步研究。首先,我们概述了模型架构和训练流水线的通用设计制定。随后,我们介绍了一个包括122个MM-LLM的分类,每个都以其特定的制定而著称。

Python_cocola的博客 971

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

从视觉到雷达:多模态感知如何引领自动驾驶安全革命

本文探讨了多模态感知技术在自动驾驶中的应用,包括视觉、雷达和超声波数据的融合。通过对这些感知数据的结合处理,提升自动驾驶系统在复杂环境中的感知能力和决策精准性。文章还提供了基于此概念的代码实现以及多模态数据融合的实际应用案例。这是整个代码的核心部分,通过继承 PyTorch 的nn.Module,定义了一个用于多模态感知数据融合的神经网络模型。图像处理分支(使用卷积神经网络(CNN)提取图像特征。特征提取流程:卷积层 → 激活函数(ReLU) → 池化层 → 全连接层。

记录从移动端、鸿蒙到物联网与AI的完整实战与思考。专注于分享可复用的工程方案与产品思维,尤其深入鸿蒙生态与全栈开发。以十年工程与管理沉淀,为你提供清晰的技术纵深路径。坚信技术的价值在于“贯通”与“落地”。 2005

自动驾驶感知模块的多模态数据融合:时序同步与空间对齐的框架解析

本文提出时空联合校准架构(ST-JCA)解决自动驾驶多传感器数据融合的时空异构性问题。该架构采用三层级处理流程,通过硬件触发、PTP/NTP协议实现时序同步,结合标定矩阵和坐标变换完成空间对齐。特征级融合方案在65ms延迟下达到0.79mAP,较传统方法提升显著。部署方案包含容器化架构及四项安全审计机制,并探讨了NeRF、脉冲神经网络等前沿技术应用。实验表明,动态标定模块可将误差控制在0.3°以内,恶劣环境下的检测召回率提升23.7%。最后建议采用FPGA加速以满足车规级ASIL-D安全要求。

嵌入式毕设/课设资料清单(速查手册·文档模板·题库,持续更新)→ 见最新文章 1833

ICLR 2025 多模态RAG最新进展!

2024上半年是大模型的时代,但随着训练推理的深入,大模型也逐渐暴露出幻觉问题, 一些回复与事实知识不符,研究落地面临极大挑战。于是,多模态检索增强生成(mRAG)技术应运而生。近年顶会更是激增了一批基于mRAG技术的MLLMs幻觉工作!鉴于传统的mRAG方法遵循固定的检索流程,检索效率不高。阿里最新推出的研究OmniSearch就以动态检索规划框架,打破了传统mRAG局限!模拟了人类在解决复杂问...

阿木寺的博客 3881

端到端自动驾驶如何评价?快来看看这个刚开源的平台。训练大模型、评测大模型,都教会你

闭环测试(如CARLA固定路线)虽模拟真实环境,但考题单一(如Town05Long仅6种路况),导致同一算法多次考试得分差异超30%,更因各厂商自建"私人题库"而丧失公平性;:主流方法依赖开环测试(如nuScenes),像让学生对着固定题库刷答案,仅通过回放历史数据验证单帧决策,却无法检验连续驾驶中动态交互的真实能力;所以,一个更全维度的题库,一个更公平的考场,一个更有权威的评分方法,一个更有效率的评估平台成为。,为此,Bench2Drive应运而生。刚从驾校拿到驾照的学员如此,刚上车的。

weixin_50262060的博客 274

foundation model

基础大模型

yuanl15的博客 2094

低质量多模态数据融合方法最新进展!天津大学携手顶尖高校推出重磅综述!

多模态融合侧重于整合多种模态的信息,以实现更准确的预测,在自动驾驶、医疗诊断等多种场景中取得了显著的进展。然而,多模态融合的可靠性在很大程度上仍未得到探索,特别是在低质量数据设置下。本文调查了多模态融合的常见挑战和最新进展,并**以数据为中心的角度**,确定了低质量数据的多模态融合面临的四个主要挑战,即 **(1)被异质噪声污染的噪声多模态数据,(2)缺少某些模态的不完整多模态数据, (3)不平衡多模态数据,不同模态的质量或属性显著不同;(4)质量变化多模态数据,每种模态的质量相对于不同样本动态变化**。这

奋斗小青年 2570

AI大模型应用开发的多模态前沿:从Agent构建到视频AIGC

智能 = 大脑(LLM/多模态模型) + 身体(传感器+执行器) + 世界(物理环境)。纯数字Agent:依赖API调用、浏览器控制,局限于虚拟环境。具身Agent(Embodied Agent):具备物理身体,能处理实时传感器数据(视觉、深度、力触觉、IMU),执行连续动作,并在失败中实时学习调整。2026年关键转变:Agent从“意图拆解+工具调用”升级为“世界建模+物理规划+闭环执行”,实现零样本/少样本适应新环境。

专注于前沿技术的探索与实践,热衷于从代码逻辑、架构设计到行业应用等多维度深挖技术本质。期待在技术之路上与你共同成长~ 964

大模型评测方法(一)

大模型能够协助我们完成各种任务,改变我们的生产和生活的方式,提高生产力,为我们带来便利,但同时使用过程中也伴随着诸多风险与挑战,如泄露隐私数据,生成带有偏见、暴力、歧视、违反基本道德和法律法规的内容,传播虚假信息等。因此对大模型能力及其不足之处形成更深入的认识和理解,预知并防范大模型带来的安全挑战和风险,需要针对大模型开展多方位的评测,一般也叫大模型基准测试。大模型基准测试体系涵盖了大模型的测评指标、方法、数据集等多项关键要素,是指导大模型基准测试落地实践的规范。

Guzith的博客 4945
上一篇: PromptPro:你的AI提示词管理专家
下一篇: 基于大语言模型的知识蒸馏
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值