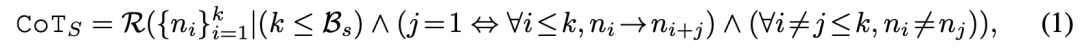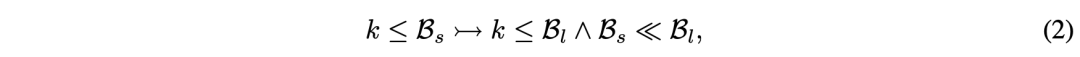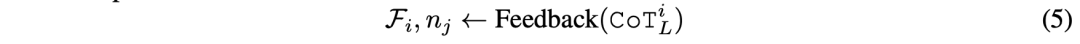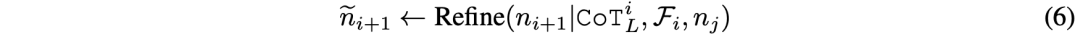
这篇Long CoT Reasoning综述隐藏好多idea啊!

DeepSeek-R1与Kimi k1.5实战对比:国产大模型推理架构与多模态落地指南 大语言模型(LLM)推理能力与多模态理解正从学术指标走向工程可用性。推理链优化、长上下文处理、跨模态语义对齐等核心技术,已成开发者选型关键。DeepSeek-R1通过强化学习重写隐状态激活路径,显著提升数学与代码逻辑推演稳定性;Kimi k1.5则以语义锚点对齐技术打通图像与文本表征,在架构图-代码映射等真实场景中实现高精度关联。二者均深度适配OpenAI API协议,支持低门槛集成至VSCode、LangChain等主流开发管线。当‘codex接入deepseek’与‘claude code kimi’成 阅读详情

img

img

1. 引言与背景

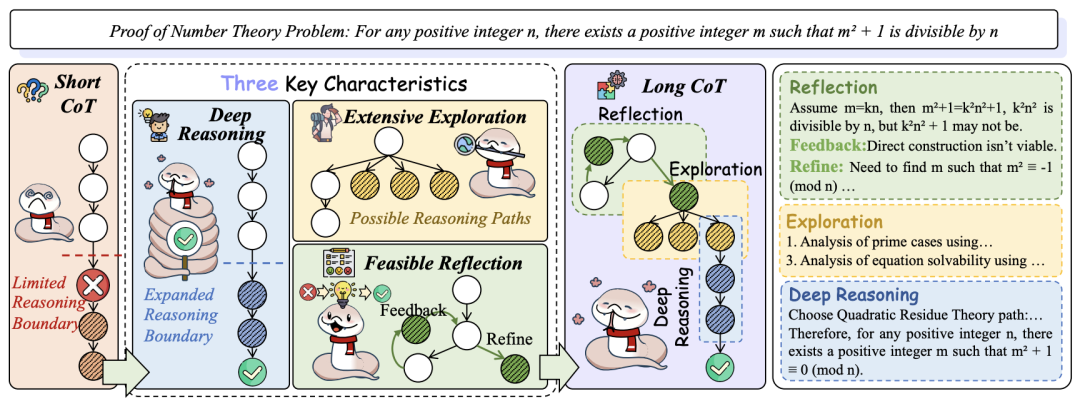
近年来,以OpenAI O1和DeepSeek R1为代表的推理型大语言模型(RLLMs)在数学、编程等复杂任务中展现出强大能力,其核心在于**长思维链(Long CoT)**的应用。传统短思维链(Short CoT)因推理深度不足、路径单一,难以解决需要多步逻辑推导的问题。本文首次系统化梳理Long CoT的特征,填补了该领域的综述空白,并为解决“过思”和“测试时扩展”等争议提供统一视角。
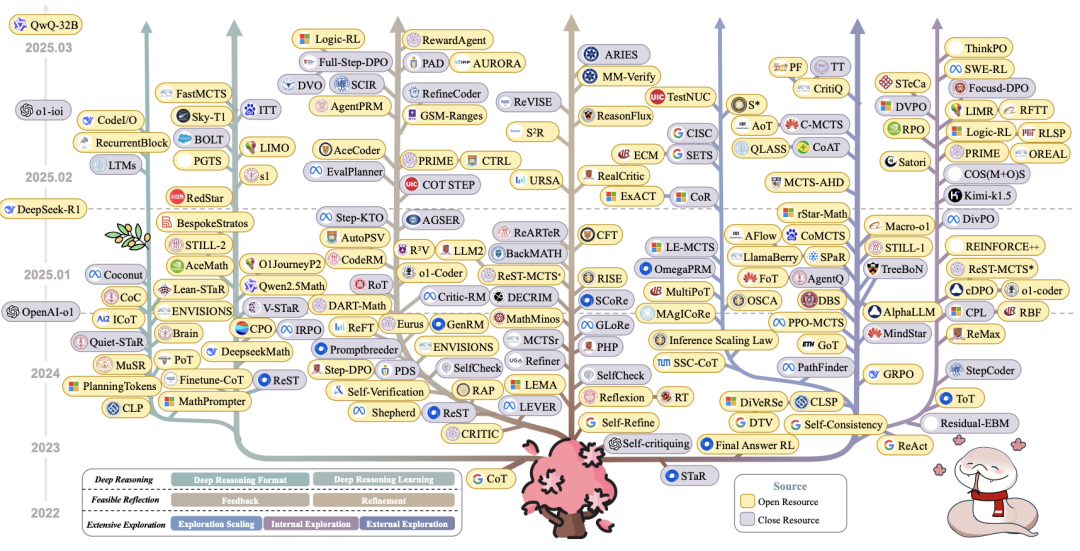
Long CoT的演进脉络Long CoT的演进脉络

2. Long CoT与Short CoT的核心区别

论文通过形式化定义对比两者:

  • 推理深度:Short CoT受限于浅层线性推理(如公式1中的节点数限制),而Long CoT通过放宽节点边界(公式2)支持更复杂的逻辑结构。imgimg
  • 探索广度:Short CoT仅探索固定路径,Long CoT允许并行探索不确定节点(公式3),覆盖更多潜在解空间。
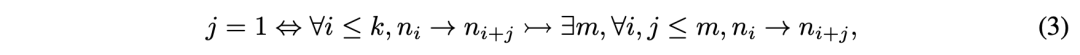
    img
  • 反馈修正:Short CoT无法回溯修正,Long CoT通过反馈(公式5)和优化(公式6)动态调整推理路径。imgimg

两者的三维特性差异,如深度、探索、反思的整合两者的三维特性差异,如深度、探索、反思的整合

3. Long CoT的关键特性

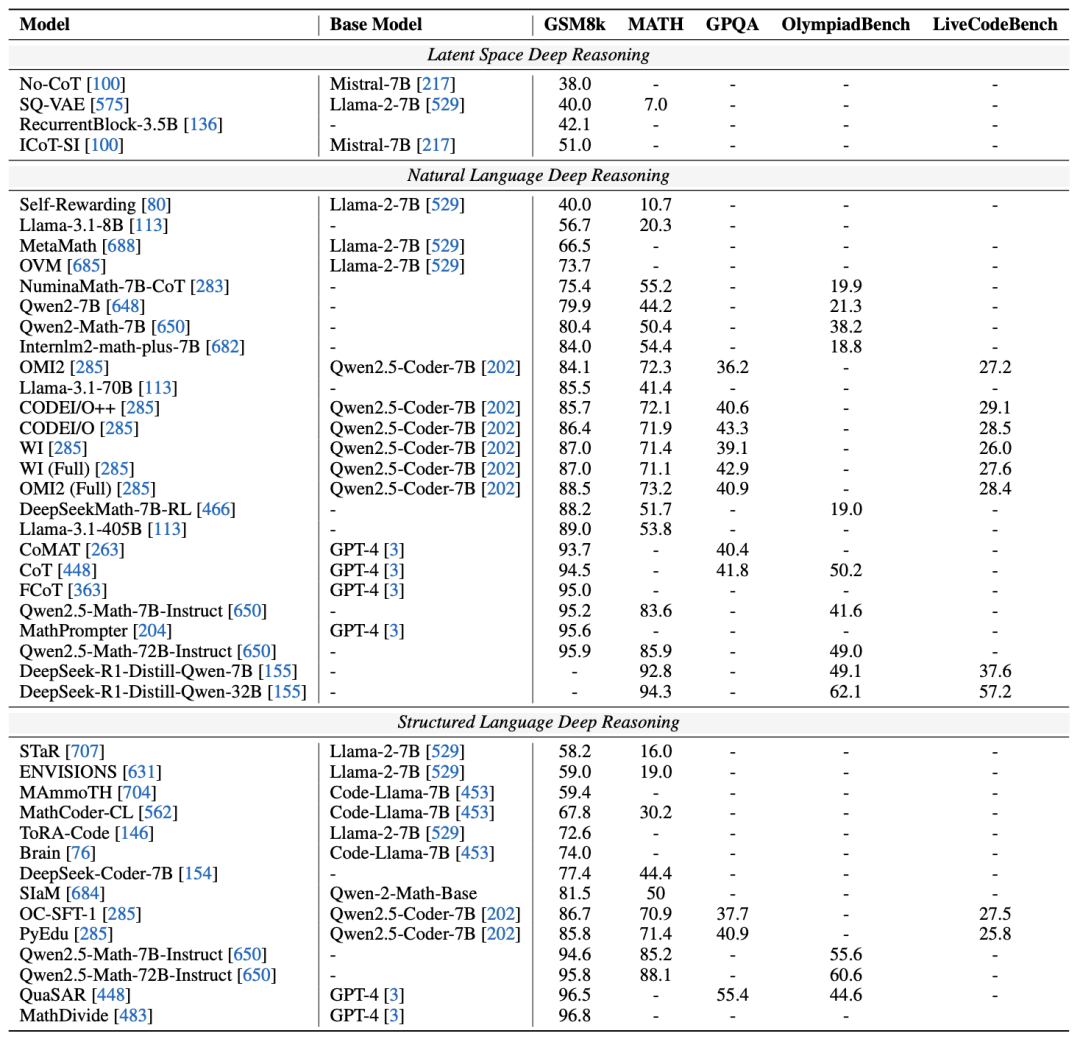
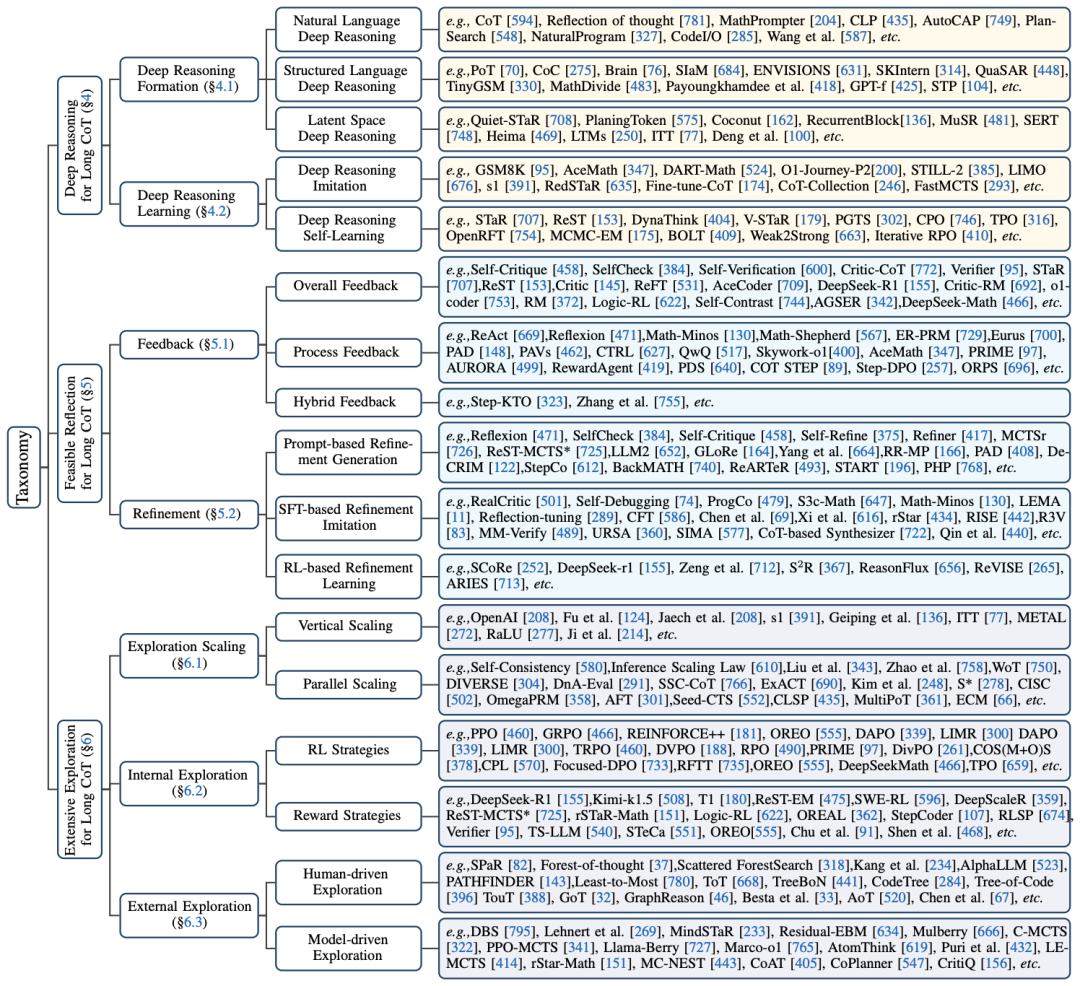
  • 深度推理:支持多层次逻辑分析,例如通过自然语言(如CodeI/O)、结构化语言(如数学符号推理)或隐空间操作(如递归块)实现。
  • 广泛探索:在编码和数学问题中,通过蒙特卡洛树搜索(MCTS)生成多样化解路径。
  • 可行反思:结合过程反馈(PRM)和结果反馈(ORM),减少错误传播。

不同推理格式在GSM8K等基准上的性能对比不同推理格式在GSM8K等基准上的性能对比

4. 现象分析与评估方法

  • 过思现象:当推理链超过模型能力边界时,性能不升反降(如Chen et al.提出的“推理边界”模型)。
  • 测试时扩展:垂直扩展(增加推理步长)与并行扩展(多路径采样验证)的权衡。
  • 评估基准:数学(GSM8K)、编程(HumanEval)、常识(BIG-Bench Hard)等任务的多样化指标(如Pass@k、Cons@k)。
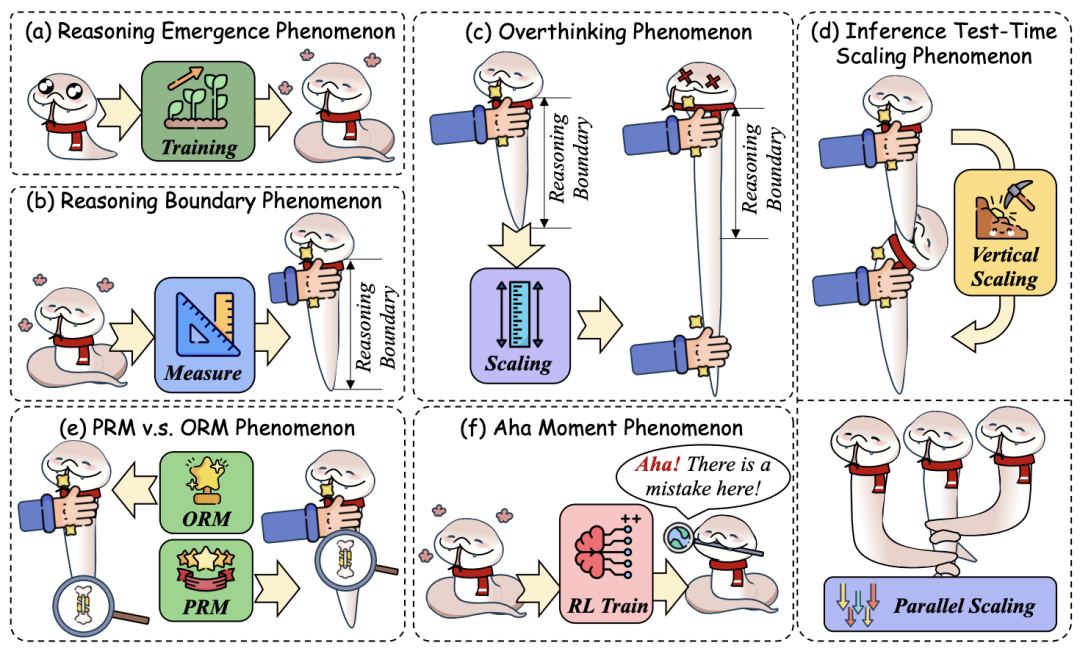
六大现象,如过思、测试时扩展六大现象,如过思、测试时扩展

5. 技术实现与资源

  • 训练框架:结合监督微调(SFT)与强化学习(RL),如DeepSeek-R1通过规则奖励激活自我反思。
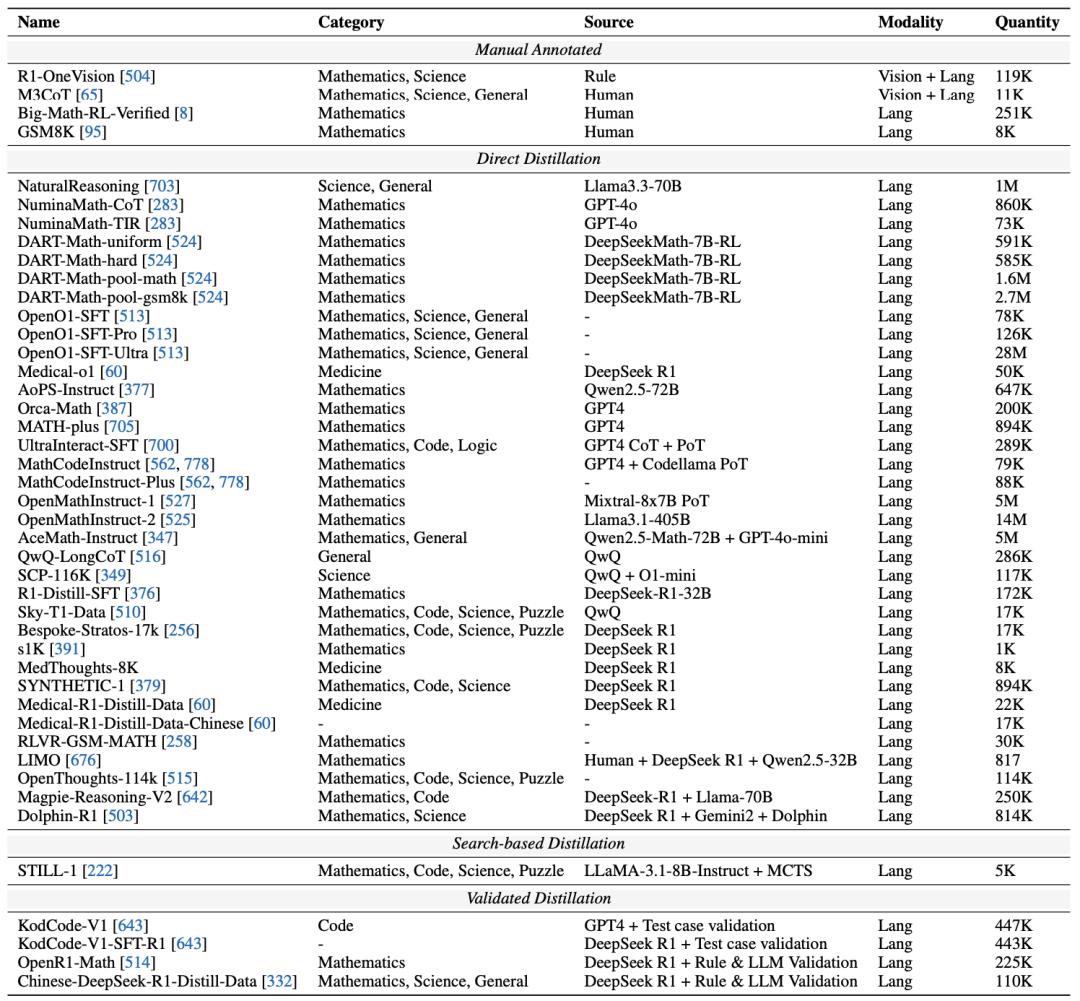
  • 数据集:涵盖人工标注(如GSM8K)、蒸馏数据(如NuminaMath-CoT)和验证数据(如KodCode-V1)。
  • 开源工具:Open-R1、Logic-RL等框架推动社区复现与扩展。

开源数据集类别与规模开源数据集类别与规模

6. 未来方向与挑战

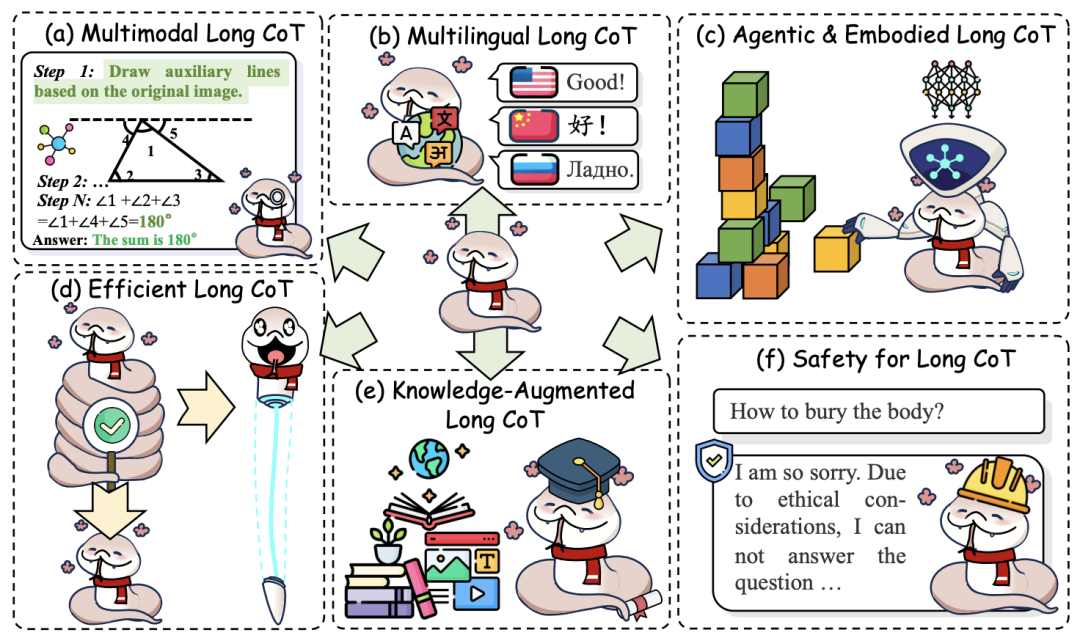
  • 多模态推理:融合视觉与文本链式推理(如M3CoT)。
  • 效率优化:通过隐空间推理压缩计算成本(如Heima的单令牌推理)。
  • 安全性:避免长链推理中的误导性输出(如对抗性攻击研究)。

未来方向的六大领域图示未来方向的六大领域图示

7. 结论与贡献

本文首次系统化区分Long CoT与Short CoT,提出统一分类法,并揭示其核心特性如何推动LLMs在复杂任务中的表现。通过开源框架与数据集,为后续研究奠定基础,标志着LLMs进入“深度推理时代”。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

【信息科学与工程学】【数据科学】数据科学领域——第三篇 数学08 几何学00总篇 编号英文名称中文名称简要说明/归属1Foundations of Geometry几何基础公理化方法, Hilbert《几何基础》2Euclidean Geometry (Synthetic)欧几里得几何(综合法)《几何原本》传统3Analytic Geometry解析几何坐标方法, Descartes, Fermat4Plane Geometry平面几何三角形、圆、共点共线等经典问题5Solid Geometry立体几何三维空间中的图形与度量6Non-Euclidean Geometry非欧几何平行公设不 阅读详情

相关推荐

Kairos02:面向 Physical AI 的具备后悔感知能力的原生世界-动作模型栈

评估结果表明,Kairos 为控制充分的 world-action 建模奠定了若干重要前提。在 embodied world-model 基准上Kairos-robot-4B 展现出较强的物理合理性、指令 grounding 和 Parameter 效率。在 World Action Model 基准(RoboTwin 2.0、LIBERO-Plus)上,Kairos 实现了较强的操作性能与鲁棒性,支持对世界动力学与动作演化进行联合建模的价值。

u013250861的博客 84

MiniMind - 从0训练语言模型

一、关于 MiniMind 📌 项目包含 二、📌 Environment 三、📌 Quick Start Test 四、📌 Quick Start Train 0、克隆项目代码 1、环境安装 2、如果你需要自己训练 3、测试模型推理效果 五、📌 Data sources 1、分词器🤖 2、Pretrain数据 📙 3、SFT数据 📕 4、DPO数据 📘 5、更多数据集 6、数据集下载地址 六、模型📌 七、 Experiment 📌 训练完成的模型权重 八、Eval📌 1、RLHF篇

AI工程化、开源分享、文档翻译、代码笔记 9006

WAM-2026-06:Kairos【骨架:4B VideoDiT;VLM:Qwen3.5-2B;原生MoT双DiT+FM;数据:数百万小时开放视频+10万小时人类数据;形态:单/双臂+灵巧手+人形】

Learning, Maintaining, and Deploying Control-Sufficient World States Kairos Team学习、维护与部署控制充分的世界状态 Kairos TeamWorld models are becoming a central substrate for Physical AI, yet their current development is differentiating across representational, generative

u013250861的博客 193

MiniMind:已开源!只要3小时就能训练一个26M的大模型,教程非常清晰我感觉我又行了!

MiniMind 是一个轻量级的大语言模型项目,让用户可以在个人设备上快速训练和运行GPT模型。该项目可以使用极小的数据和计算资源,在3小时内训练出一个26M的模型,使大模型技术使用更加简单。MiniMind 支持单机单卡和多卡训练,兼容多个流行的框架,并提供完整的代码和文档支持,帮助初学者和研究者快速上手并进行定制和扩展。MiniMind现在总共有5个模型,最小的是26M,已经有不错的对话能力了。

m0_59235945的博客 7065

轻量级大语言模型 MiniMind 源码全流程解读:含 tokenizer、RoPE 等组件

资源下载链接为: https://pan.quark.cn/s/5e76b60401ea 轻量级大语言模型 MiniMind 源码全流程解读:含 tokenizer、RoPE 等组件(最新、最全版本!打开链接下载即可用!)

minimind最小开源大模型,可以自己训练自己的大模型

minimind最小开源大模型,可以自己训练自己的大模型

MiniMind用极低的成本训练属于自己的大模型

在2小时,训练出属于自己的28M大模型。特性说明:1、在家用电脑中即可进行大模型的训练。2、训练时间可在一天之内,让你获得低成本训练出的大模型。3、适用于性能不高的电脑本地运行及训练迭代。

任聪聪的博客 4090

时间同步中 TOD 与GPRMC和IRIG-B的区别

时间同步中 TOD 与GPRMC和IRIG-B的区别

ftdlk的博客 1723

AI4Research 综述 25 人工智能如何助力科研

本文系统综述了人工智能(AI)在科研领域的应用(AI4Research),提出了涵盖科学理解、学术调研、科学发现、学术写作和同行评审五大任务的新分类体系。研究梳理了AI在跨学科科研中的核心能力,包括文本/图表理解、文献检索、假设生成、实验自动化、论文撰写与评审等关键环节。文章不仅整合了相关多学科应用和资源(如数据集、工具库),还指出了未来六大研究方向:跨学科AI模型开发、科研伦理治理、协作研究系统、可解释性增强、动态实验优化及多模态整合。这项工作为AI驱动科研提供了系统性框架,有望推动科研范式的智能化转型。

人无远虑,必有近忧 278

Vivado ChipScope Debugging: Overcoming Common DRC Errors in FPGA Design

本文深入解析Vivado ChipScope调试中常见的DRC错误,特别是AVAL-244和AVAL-245等时钟相关问题,提供实用的Tcl命令解决方案和最佳实践。通过将DRC错误降级为警告的技巧,帮助FPGA设计者高效完成调试流程,同时强调何时应保留DRC检查以确保设计可靠性。

weixin_30335575的博客 415

AHB—SRAMC项目(结构图,核心代码、Testbench架构)

文章目录一、AHB_SRAMC项目介绍1.1.AHB总线控制单元(ahb_slv_if.v)1.2.SRAM控制单元(sramc_top.v)1.3.主要的传输路径二、结构框图2.1.AHB_SRAMC结构图(重点)2.2.总线控制单元与SRAM控制单元结构图三、部分核心代码(重点理解)四、SystemVerilog Testbench架构(重点)五、目录结构 一、AHB_SRAMC项目介绍 本项...

Mr.翟的博客 3万+

ICML 2026 | Heima:面向多模态大模型的思维链压缩与隐式推理框架

这背后其实有一个很有意思的判断:人类写出来的推理文本,未必是模型内部 “思考” 的唯一形式。该方法将冗长的文本 CoT 压缩为少量抽象的 “thinking tokens”,让模型在隐空间中完成高效推理,在大幅减少生成 token 数量的同时,尽可能保留 CoT 推理带来的能力提升。Heima 提供了一种新的多模态大模型高效推理思路:与其让模型显式生成冗长的自然语言 CoT,不如将中间推理过程压缩进少量 thinking tokens 中,让模型在隐空间中完成更高效的 “隐藏思考”。

阿木寺的博客 226

Scale-up,scale-out技术概述

本文系统分析了Scale-up与Scale-out两种扩展技术在现代计算中的应用与发展。Scale-up通过增强单节点性能,适用于高耦合任务,而Scale-out通过横向扩展节点,实现高可用性和无限扩展。在芯片层面,Chiplet技术推动Scale-up发展;在数据中心层面,二者协同工作构建强大集群。光模块在长距离高带宽传输中发挥关键作用。文章对比了NVIDIA、AMD和Broadcom三家公司的技术路线,指出NVIDIA采用封闭生态,AMD选择开放标准,Broadcom则主导底层连接技术。未来发展方向将聚

元直的博客 1445

【系统架构设计师】综合知识篇

本文是软考系统架构设计师备考笔记,系统梳理了考试核心知识点,重点涵盖中间件技术、缓存问题和解决方案。主要内容包括: 中间件概述:定义位于OS与应用间的软件层,分类包括数据库访问、RPC、消息队列等,分析7大技术优点。 消息中间件:对比RabbitMQ/Kafka/RocketMQ特性,详解点对点和发布订阅模型,列举异步解耦、流量削峰等典型场景。 Redis缓存:介绍单线程模型、5种数据结构,重点分析RDB/AOF持久化机制和集群高可用方案。 缓存三大问题:通过流程图解析雪崩(随机过期时间/熔断降级)、穿透(

你的博客 879

YOLOv11 改进 - 注意力机制 | LS-YOLO MSFE 多尺度特征提取模块:并行分支结构增强多尺度感知,优化遥感与小目标检测

本文介绍了一种用于滑坡检测的模型LS-YOLO及其在YOLOv11中的结合应用。LS-YOLO首先构建多尺度滑坡数据集MSLD,为模型训练提供丰富数据。设计了基于高效通道注意力、平均池化和空间可分离卷积的多尺度特征提取模块MSFE,充分提取滑坡特征信息。在解耦头中采用膨胀卷积增加模型感受野。我们将MSFE模块集成进YOLOv11,替换部分原有模块。实验表明,改进后的YOLOv11在数据集中表现出色 。

魔改工程师的博客 870

优快云独家首发!万字长文,YOLOv5/v7/v8算法模型yaml文件史上最详细解析与教程!小白也能看懂!掌握了这个就掌握了魔改YOLO的核心!

🍀🍀🍀YOLOv5/v7/v8算法模型yaml文件史上最详细解析与教程,全网最强,学不会算我输!!!

Coding... 1万+

51c大模型~合集111

OpenAI 的某发言人表示:「为了提高清晰度和安全性,我们增加了一个额外的后处理步骤,其中模型会审查原始的思维链,删除任何不安全的内容,然后简化某些复杂的思维。可以看到,虽然 ChatGPT 确实完成了任务并展示了总结版的思维链,但似乎并未如 OpenAI 发言人说的那样给出与提示词语言同样语言的总结版。北大-灵初联合实验室表示,Align-DS-V的多模态强推理能力是VLA模型大脑端的核心,接下来的研究训练计划,是利用多模态推理模型的跨模态穿透能力,实现action穿透,最终实现真正高效的VLA模型。

whaosoft~aiotの开发板商城 2313

AI人工智能领域持续学习:提升技术能力的关键

在当今科技飞速发展的时代,AI人工智能已经渗透到我们生活的方方面面。本文章的目的就是帮助大家了解在AI人工智能领域持续学习的重要性,以及如何通过持续学习来提升自己的技术能力。文章会涵盖AI的核心概念、持续学习的原理和方法、实际应用场景等方面,让大家对AI领域的持续学习有一个全面的认识。本文首先会介绍AI人工智能的核心概念,让大家对这个领域有一个初步的了解。然后详细讲解持续学习的原理和方法,通过代码示例展示如何在实际项目中实现持续学习。接着会分析AI持续学习在不同场景的应用,推荐一些学习工具和资源。

AI 原生应用开发的博客 1288

鱼皮《Vibe Coding 概念大全》精讲:一文吃透 AI 编程的核心术语体系

> 本篇技术指南以仓库内 [Vibe Coding 零基础教程/70 Vibe Coding 概念大全.md](https://link.gitcode.com/i/db8135ae17bd10a31e126ce81b9c2224) 为骨架,系统梳理 Vibe Coding(氛围编程)中的全部核心术语,涵盖 AI 基础概念、提示词工程、智能体编程模式、上下文管理、AI 输出控制、开发工具、项目管理

gitblog_00705的博客 328

JavaScript实现边缘检测Canny(附完整源码)

JavaScript实现边缘检测Canny(附完整源码)

希望我的博客,能帮上你解决学习中工作中所遇到的问题 705

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

2025-02-18 Github 热点项目 minimind:3小时训练个人GPU轻量语言模型教程

该工具支持融合多种大语言模型,可应用于自动化办公助手、无障碍操作辅助等场景,最新版本在界面元素检测准确率上达到业界领先水平,特别擅长识别细小图标和判断元素是否可交互,大幅提升AI执行点击、输入等操作的可靠性。它能智能处理大文件防止卡顿,提供可视化文件树和模糊搜索,自带代码缩进指引和智能重命名功能,支持流畅滚动动画和专注模式,还能通过美观仪表盘快速访问常用文件。这套插件既包含调试代码的实用工具,也提供便捷的终端管理,特别适合需要优化开发流程、追求界面美观的开发者,所有功能都可按需启用组合使用。

opentrending的博客 2514

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

自己训练大模型?MiniMind 全流程解析 (一) 预训练

MiniMind是一个开源的大语言模型训练框架,提供从预训练到推理的全流程解决方案。本文解析其预训练流程的核心技术:1)采用余弦退火学习率调度平衡收敛与精度;2)混合精度训练结合float16前向计算与float32梯度管理加速训练;3)梯度累积技术突破显存限制;4)基于NCCL的分布式训练实现多GPU并行。框架通过模块化设计(参数解析、数据加载、训练循环等)支持高效训练,并确保实验可复现性(随机种子管理)。项目完全开源,代码详见GitHub仓库。

翊歌 1998

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

MiniMind环境搭建&训练推理测试

该项目可以使用极小的数据和计算资源,在3小时内训练出一个26M的模型(ps:也许有读者会问,为啥我总是写推理,没有写训练,那显然是我没那个硬件条件呀,嗯,那这会儿这个条件有了。MiniMind 支持单机单卡和多卡训练,兼容多个流行的框架,并提供完整的代码和文档支持,帮助初学者和研究者快速上手并进行定制和扩展。MiniMind现在总共有5个模型,最小的是26M,已经有不错的对话能力了。但是这个方向还是一直要有人坚持去做的,这不,这两天翻到一个,MiniMind,只要3小时就能训练一个26M的大模型。

zzq1989_的专栏 1341

MiniMind:完全从 0 训练自己的大模型

是 B 站 UP 主近在远方的远开源的一个微型语言模型,改进自 DeepSeek-V2、Llama3 结构,项目包含整个数据处理、pretrain、sft、dpo 的全部阶段,包含混合专家(MoE)模型。其目标是把上手 LLM 的门槛无限降低, 直接从 0 开始训练一个极其轻量的语言模型,最低仅需 2G 显卡即可推理训练!

weixin_51674085的博客 961

AI 实战篇:从零训练你的大模型 ——MiniMind 全流程实战

作为一名AI从业者,亲测后发现它不仅是一个可落地的项目,更是入门大模型训练的绝佳教程。今天就带大家手把手体验这个“大道至简”的实战过程。

python1234567_的博客 891
上一篇: AI智能体的概念和应用场景
下一篇: 人形机器人大脑:具身智能--行业全解析(附核心标的)
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2826原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值