【TPAMI】知识蒸馏+元学习+对抗防御

知识蒸馏学习 大模型在部署到资源有限的设备上(手机、嵌入式设备等)会遇到体积和速度问题,知识蒸馏作为有代表性的模型压缩和加速的技术之一(其他还有:参数裁剪和共享、低秩分解和Transferred compact convolutional filters等),近年来受到了学术界和工业界的广泛关注。为了在资源有限的设备上部署深度模型,Bucilua 等人在2006年首次提出了模型压缩技术来迁移大模型或集成模型里的信息去训练小模型而精度不会有显著的下降。 阅读详情

论文背景

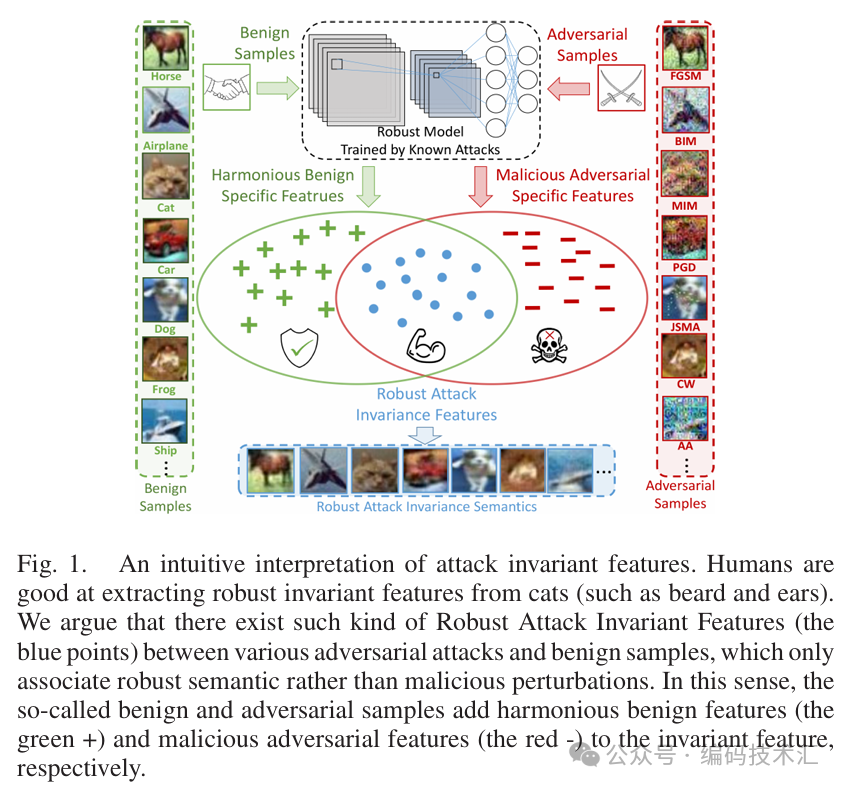
深度神经网络(DNN)在计算机视觉任务中表现出色,但极易受到对抗攻击的影响。当前的防御方法大多针对已知攻击,而对未知攻击的鲁棒性被严重忽视。此外,常用的自适应学习和微调技术在对抗防御中并不适用,因为这本质上是一个零样本问题。为解决这一挑战,本文提出了一种攻击无关的防御方法 Meta Invariance Defense(MID)。
主要贡献

  1. 提出了一种针对未知攻击具有泛化鲁棒性的 Meta Invariance Defense(MID)方法,通过模拟对已知和未知攻击的防御,选择和保留对两种攻击都具有相似激活的参数。

  2. 提出了一种包含对抗一致性、标签一致性和循环一致性约束的多一致性蒸馏协议,有助于学习攻击不变特征。

  3. 理论和实验证明了 MID 的可行性和优越性。

方法概述

元不变性防御(MID)
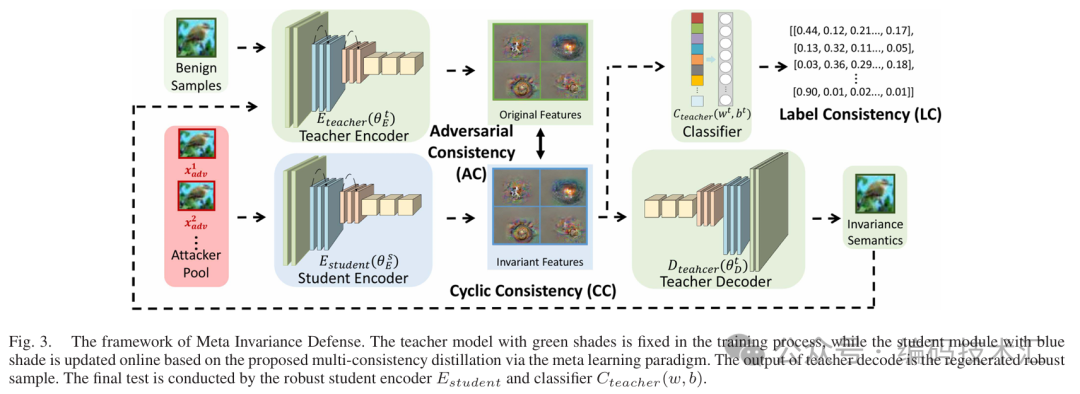
MID 结合了两阶段的元学习机制和多一致性蒸馏约束,训练学生编码器从攻击者池中提取攻击不变特征。具体步骤如下:

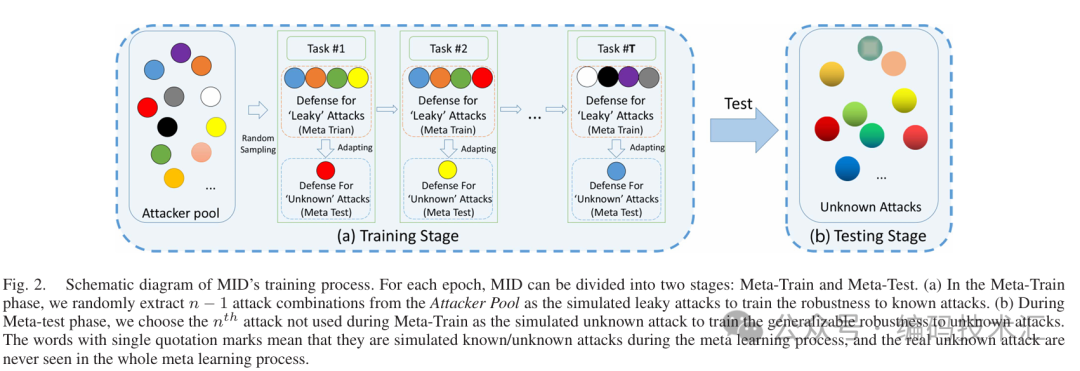
  1. 构建攻击者池:手动构建一个包含多种攻击方法的攻击者池。

  2. 元训练阶段:随机从攻击者池中抽取一组攻击,模拟已知攻击的防御训练。通过单步梯度下降优化临时模型,并计算元训练损失。

  3. 元测试阶段:选择未在元训练中使用的攻击,模拟未知攻击的防御测试。计算元测试损失。

  4. 联合优化:结合元训练和元测试的损失,训练具有泛化鲁棒性的学生编码器。

多一致性蒸馏协议

包括对抗一致性(AC)、循环一致性(CC)和标签一致性(LC):

  • 对抗一致性(AC):约束学生模型学习与教师模型相似的特征,使用 KL 散度衡量教师和学生模型特征的概率分布差异。

  • 循环一致性(CC):确保学生模型学习的特征仅包含真实语义,不包含对抗扰动特征。通过教师解码器解码学生模型的输出,再重新编码,约束再生图像与原始图像的特征分布相似。

  • 标签一致性(LC):确保学生编码器和教师分类器能够准确预测攻击者池中采样的任何对抗样本。

实验结果

实验在多个常用数据集上进行,包括 MNIST、FashionMNIST、CIFAR10、SVHN、CIFAR100、Tiny-ImageNet-200、ImageNet-100 和 ImageNet-1K。针对不同数据集,使用了不同的骨干网络和基线模型。
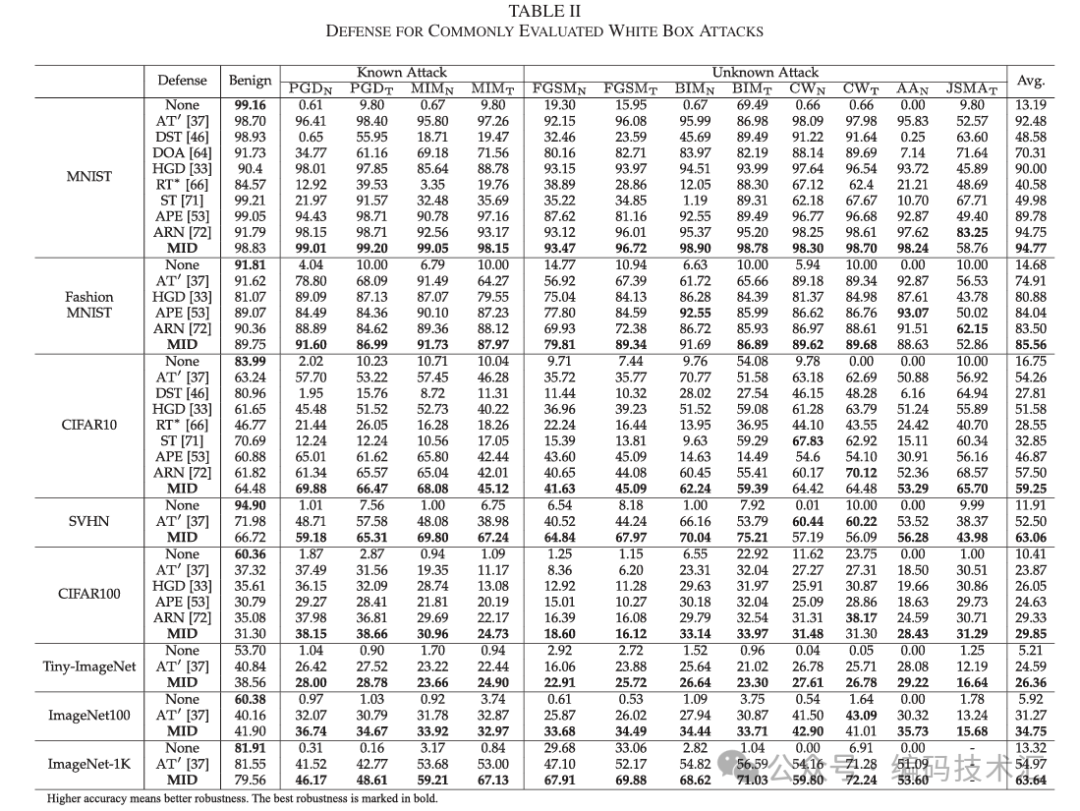
  • 对已知和未知攻击的鲁棒性:MID 在白盒和黑盒攻击下均表现出最佳的鲁棒性,对训练阶段使用的已知攻击(如 PGD 和 MIM)以及未见过的攻击(如 FGSM、BIM、CW、AA 和 JSMA)都能有效防御。

  • 黑盒攻击的防御性能:MID 对来自不同源模型的黑盒攻击表现出更优的防御性能。

  • 对启发式或高级未知攻击的测试:MID 在 CIFAR10、CIFAR100 和 Tiny-ImageNet 上对多种启发式或高级未知攻击(如 SPA、SSAH、stAdv、DDN、FAB 和 Adv-Drop)表现出优越性。
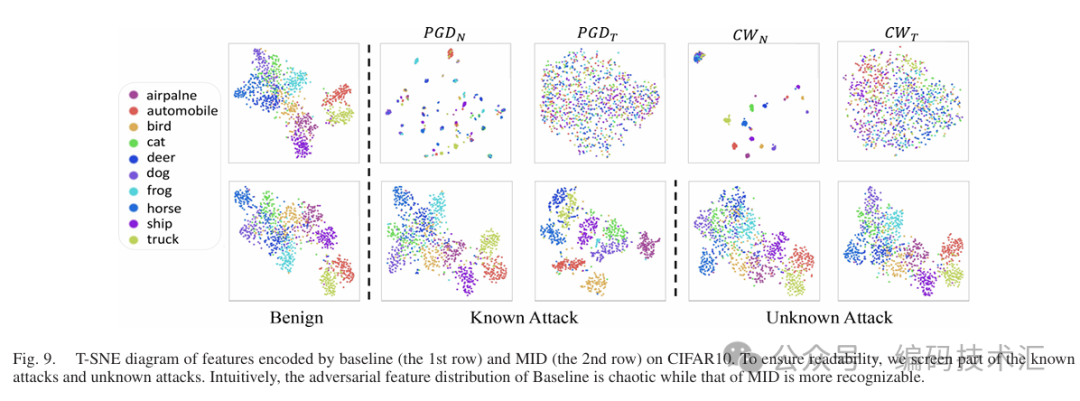
MID 的局限性和失败案例

  • 准确率与鲁棒性的权衡:MID 未能完全解决良性样本准确率与对抗样本鲁棒性之间的权衡问题,良性样本的准确率有所下降。

  • 计算成本:MID 的训练时间比对抗训练(AT)长 5 倍,但与经验风险最小化(ERM)相当。

  • 泛化鲁棒性不足:未知攻击的性能与攻击者池中已知攻击的数量有关,缺乏针对未知目标攻击的防御能力。

结论

本文提出的 Meta Invariance Defense(MID)方法通过元学习和多一致性蒸馏协议,实现了对未知攻击的泛化鲁棒性。理论和实验证明了 MID 的有效性和优越性,为追求对未知攻击的泛化对抗鲁棒性提供了新的思路。未来工作可以探索测试时训练或在线适应新攻击的训练范式,以进一步提高模型的鲁棒性和泛化能力。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

【知识蒸馏】知识蒸馏(Knowledge Distillation)技术详解 知识蒸馏综述 阅读详情

相关推荐

蒸馏作为对抗深度神经网络对抗性扰动的防御

精心设计的输入是为了迫使深度神经网络(DNN)提供对手选择的输出。此类攻击可能会严重破坏 DNN 支持的系统的安全性,有时会带来毁灭性的后果。例如,自动驾驶车辆可能会崩溃,非法或非法内容可能会绕过内容过滤器,或者生物识别系统可能会被操纵以允许不当访问。在这项工作中,我们引入了一种称为防御蒸馏的防御机制,以降低 DNN 上对抗性样本的有效性。我们分析研究了在训练 DNN 时使用防御蒸馏所赋予的通用性和稳健性。我们还实证研究了我们的防御机制在对抗环境中的两个 DNN 上的有效性。

weixin_47208848的博客 840

【论文翻译_对抗攻击、知识蒸馏】AGKD-BML: Defense Against Adversarial Attack by Attention Guided Knowledge

AGKD-BML: Defense Against Adversarial Attack by Attention Guided Knowledge Distillation and Bi-directional Metric Learning Hong Wang, Yuefan Deng, Shinjae Yoo, Haibin Ling, Yuewei Lin Stony Brook University, Stony Brook, NY, USA Brookhaven National Laborat

qq_45128278的博客 1553

【论文笔记】(防御蒸馏)Distillation as a Defense to Adversarial Perturbations against Deep Neural Networks

防御蒸馏(defensivedistillation)

.. 4624

​ACL 2022 | MetaDistil:基于元学习的模型蒸馏

©PaperWeekly 原创 ·作者 |BNDSBilly研究方向 |自然语言处理Abstract模型蒸馏是当下较为主流的模型压缩方法,通过将大规模教师模型的知识传递给小规模学生模型,从而既能降低模型大小,提升推理速度,又能得到与原模型基本相当的表现。之前分享的几篇论文大多是对蒸馏目标函数及学生模型架构的探究,但本文的作者转而对教师模型的知识传达能力进行了探究。最...

Paper weekly 1715

TPAMI 2024 | 面向对未知对抗性攻击具有泛化鲁棒性的元不变性防御

尽管为计算机视觉任务提供了高性能的解决方案,但深度神经网络(DNN)模型已被证明极易受到对抗性攻击的影响。当前的防御主要集中在已知攻击上,但对未知攻击的对抗性鲁棒性却严重被忽视。此外,常用的自适应学习和微调技术在对抗性防御中不适用,因为在部署时本质上是一个零样本问题。因此,为了应对这一挑战,我们提出了一种名为Meta Invariance Defense(MID)的攻击不可知防御方法。

小白学视觉 230

TPAMI 2024 | 变分对抗性防御:对抗性训练的贝叶斯视角

近年来,针对对抗性攻击的防御方法层出不穷。然而,这些方法普遍缺乏足够的理论保证,导致两个问题:首先,必要的对抗性训练样本的缺乏可能会削弱正常梯度的反向传播,从而导致过拟合并潜在的梯度掩盖问题。其次,逐点的对抗性采样为对抗性数据提供了不充分的支持区域,因此无法形成强大的决策边界。为了解决这些问题,我们提供了理论分析,揭示了对抗性训练中鲁棒准确性与训练集复杂性之间的关系。结果,我们提出了一种名为变分对抗性防御(Variational Adversarial Defense)的新的训练方案。

小白学视觉 192

通俗易懂解读 AI、RAG、Agent 等概念

1956 年夏天,计算机科学家约翰·麦卡锡(John McCarthy)首次提出"人工智能"(AI)这个概念。人工智能(AI通过软件和硬件,来完成通常需要人类智能才能完成的任务。它的研究对象,就是在机器上模拟人类智能。早期,人工智能研究分成两个阵营。第一个阵营是规则式(rule-based)方法,又称专家系统(),指的是人类写好一系列逻辑规则,来教导计算机如何思考。可想而知,对于复杂的、大规模的现实问题,很难写出完备的、明确的规则。所以,这种方法的进展一直很有限。第二个阵营就是机器学习(

2301_76168381的博客 2030

TPAMI 2024 | 通过滤波器权重分布重新审视准确性与鲁棒性之间的权衡

对抗攻击已被证明是深度神经网络(DNNs)的潜在威胁,许多方法被提出来防御对抗攻击。然而,在增强鲁棒性的同时,干净样本的准确性会有所下降,这表明在准确性和对抗鲁棒性之间存在一种权衡。本文中,作者通过理论探索标准训练模型和鲁棒训练模型之间滤波器权重分布的差异,认为这是静态神经网络的内在属性,因此难以从根本上同时提高准确性和对抗鲁棒性。基于这一分析,作者提出了一种样本自适应的动态网络架构,称为对抗权重变化网络(AW-Net),该网络采用“分而治之”的权重策略来处理干净样本和对抗样本。

小白学视觉 110

自动驾驶物理对抗攻击:动态贴膜如何12毫秒攻破场景感知

物理对抗攻击是人工智能安全中的基础性概念,指通过在真实物理环境中施加微小、人眼难辨的扰动,诱导AI感知系统产生确定性误判。其核心原理在于利用传感器成像特性与深度模型决策边界的耦合脆弱性,在输入端‘欺骗’而非攻击模型本身。该技术具备强隐蔽性、高迁移性与工程可实现性,正从实验室静态场景快速演进至车载动态环境。典型应用已覆盖自动驾驶交通标志识别、BEV空间定位、多模态融合等关键环节,并暴露出当前L2+/L3系统在光学鲁棒性、时序容错与物理层验证方面的深层缺陷。北航TPAMI 2025工作以‘动态物理对抗攻击’和‘

weixin_33863087的博客 341

Chronos:学习时间序列的大语言模型(论文解读)

《Chronos:学习时间序列的大语言模型》论文翻译

qq_20144897的博客 9075

Xilinx XDMA IP核配置实战:AXI Memory Mapped vs Stream选型指南(附PCIe调试技巧)

本文深入解析Xilinx XDMA IP核配置中AXI Memory Mapped与AXI Stream两种DMA接口的核心区别与选型策略。针对PCIe高速数据传输场景,详细对比了二者在数据特性、延迟、硬件资源及软件复杂度上的差异,为FPGA工程师在数据采集、实时处理等项目中做出高效设计决策提供实战指南,并附有关键的PCIe调试技巧。

qsc901234的博客 585

TPAMI 2025 —— 视觉基础大模型的多模态融合与安全挑战:构建可信AI的新范式

本文探讨了TPAMI 2025中视觉基础大模型的多模态融合与安全挑战,提出了构建可信AI的新范式。文章详细分析了多模态融合的现状、安全威胁图谱及防御技术,特别关注了视觉重采样防御技术和可解释性增强方法,为医疗、自动驾驶等高风险领域的AI部署提供了实用建议。

9o8p7i6u5y的博客 758

【生产实践】SSH服务弱加密算法修复指南(附完整操作流程)

SSH服务弱加密算法漏洞修复方案 检测发现SSH服务存在支持弱加密算法漏洞,主要风险包括: 使用arcfour、aes128-cbc等易被破解的算法 面临密钥恢复、重放攻击等安全威胁 提供两种修复方案: 推荐方案:升级OpenSSH至最新版本 替代方案:修改SSH配置禁用弱算法(需注意可能影响旧客户端连接) 修复步骤: 编辑/etc/ssh/sshd_config 注释或删除弱算法配置 添加强加密算法(如aes128-ctr等) 重启SSH服务 注意事项: 建议先在测试环境验证 可能需配合客户端升级 操作前

SunMy的博客 3107

基于生成对抗网络的知识蒸馏数据增强

思想来源:仅对原标签做简单的线性变化或直接使用原标签作为新样本标签的方法是无法表示标签中离散信息的 ,这会导致网络模型无法将离散信息也作为一种特征进行学习。针对上述问题,在区域丢弃算法的基础上,提出一种基于生成对抗网络的知识蒸馏数据增强算法。使用补丁对丢弃区域进行填补,减少区域丢弃产生的非信息噪声。在补丁生成网络中,保留生成对抗网络的编码器-解码器结构,利用编码器卷积层提取特征,通过解码器对特征图上采样生成补丁。

weixin_50094312的博客 1554

小米万兆路由器里的Docker安装可道云(Kodexplorer)私有网盘

小米2022年12月份发布了万兆路由器,里面可以使用Docker。 今天尝试在小米的万兆路由器里安装[可道云](http://kodcloud.com/)(Kodexplorer)私有网盘。

engchina的专栏 1万+

大疆Livox Mid-70雷达的使用

一、前期准备 (一)、使用Livox Viewer测试雷达 1、设置静态IP sudo ifconfig enx081f7152092a 192.168.1.50 查看IP是否设置成功 lacyexsale@lacyexsale-KLV-WX9:~$ ifconfig enx081f7152092a Link encap:以太网 硬件地址 08:1f:71:52:09:2a inet 地址:192.168.1.50 广播:192.168.1.255 掩码:255.255.25

LacyExsale的博客 1万+

从噪声中提取情感:中山大学与腾讯AI实验室基于元学习的多模态情感分析新方法

随着科技的迅猛发展和社交媒体平台的普及,多模态数据在各种下游应用中变得越来越普遍。多模态情感分析(Multimodal Sentiment Analysis, MSA)作为一种能够从语言、声学和视觉数据流中提取人类情感和观点的技术,近年来受到了广泛关注。MSA在多个领域具有重要应用,包括通过分析用户在社交媒体上的文本、语音和视频内容,了解用户的情感倾向和观点,有助于品牌管理和市场营销。在智能助手和聊天机器人中,MSA可以帮助系统更好地理解用户的情感状态,从而提供更自然和人性化的交互体验。

m0_59163425的博客 2152

华为OD机试真题 新系统 2026-09-26 Java&Go&C【数据中心最佳维护时间窗】

数据中心使用一个整数数组 scores,记录 N 小时内每小时的服务器得分(可正可负)。0 表示服务器故障(无效小时)。

MISAYAONE的博客 112

第05篇:对抗蒸馏(Adversarial Knowledge Distillation)——让学生“骗过”判别器的秘密

知识蒸馏(Knowledge Distillation, KD)中,学生模型模仿教师模型的输出,学习其“行为”或“特征”。传统 KD 偏重于逐点对齐,比如 Soft Target KD 通过 KL 散度对齐 soft logits,而 Feature-based KD 则是直接对齐中间特征。但这些方式对“整体分布”理解有限。如果把教师当作一个“真实样本的生成器”,那么我们能否训练一个“判别器”来判断学生输出是否“足够像老师”?这正是。

m0_45101613的博客 2234

uniapp - 实现APP后台持续定位+手机息屏后能持续上传位置信息数据,详解后台保活持续运行+手机锁屏保证后台持续/实时定位的解决方案及示例源码(完美兼容安卓android与苹果ios系统手机)

使用uniapp开发app实现后台保活定位能力,uniapp实时定位保活 息屏定位后台运行,uniapp APP实时定位高德 后台运行 支持锁屏息屏运行,持续获取定位信息,uniapp App端后台间隔时间发送定位功能实现,UniApp实现手机应用常活,固定时间内上传手机位置信息,后台(或锁屏)持续/实时定位的实现方案,uni-app后台持续定位,锁屏后能持续上传位置信息,实现后台定位持续无限制定位高德定位,百度定位,UniApp后台持续定位保如何在APP退到后台时保持定位服务,uniapp 切换app仍能

🏆 前端领域优质创作者 1万+

MATLAB - 机械臂手眼标定(眼在手内) - 估计安装在机器人上的移动相机的姿态

执行手眼校准有助于操作配备末端执行器(简称 “手”)的机械臂,该末端执行器依赖于摄像头提供的视觉数据。一旦完成了眼在手外的校准,机械臂就能准确地移动到摄像头识别的特定像素位置。这种能力是执行精确拾放任务(如分类、堆垛和分拣)的基础,即使在摄像机的确切位置和方向未知的情况下也是如此。机器人-摄像机系统有两种构型:眼在手内和眼在手外。在眼在手内构型中,摄像头直接安装在机器人手臂的末端执行器上。相反,在眼在手的构型中,摄像头固定在一个静止的物体上,机器人手臂在其视野内。

机器人控制与仿真应用 3355

元学习—对抗式元学习(ADML)

元学习—对抗式元学习(ADML) 在之前的文章中,我们介绍了MAML模型,有兴趣的读者可以参考元学习—模型不可知元学习(MAML)。在下面的文章中,我们将介绍MAML模型在对抗式学习中的应用,即MAML模型的一个变体ADML模型。 1 FGSM方法 在对抗式的学习中,需要同时使用到真实样本和对抗样本。对于对抗样本的生成,有很多种方法,我们下面来看其中的一种方法,即基于梯度的攻击算法(FGSM)。 一般情况下,我们会计算模型参数的梯度值来更新模型参数,以求得使得模型的Loss最小,在FGSM中,为了获取对抗样

hei653779919的博客 4958

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

常见知识蒸馏方法总结记录

常见知识蒸馏方法总结记录

Together_CZ的博客 4857

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

Knowledge Distillation(知识蒸馏,DistillBERT,Theseus,KR)

Do Deep Nets Really Need to be Deep? 虽然近年来的趋势如BigGAN,BERT等,动辄上亿参数,几乎就是数据驱动+算力的“暴力”结果。但同时,更加轻量级的升级版模型如ALBERT也能以更少的参数和架构持续刷榜,元学习(meta learning)和零样本学习(Zero-shot learning),还有只需要个位数层数就能取得优异效果的GCN等,都似乎证明了“大...

nakaizura 4579

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

融合知识蒸馏与元学习的联邦学习新范式提升隐私保护下的模型泛化能力

未来,随着差分隐私、同态加密等安全技术更深度地融入该框架,以及针对通信效率、激励机制等实际问题的进一步探索,这一融合范式有望在医疗健康、智慧金融、物联网等对数据隐私要求极高的领域发挥更大价值,最终推动人工智能在保护用户权利的前提下实现更广泛、更可靠的应用。一种可行的思路是,在联邦学习的聚合阶段引入元学习策略,使服务器能够更智能地融合来自异构客户端的模型更新,学习一个更具适应性的全局模型初始化。它使得来自不同领域、不同分布的数据能够共同贡献于一个更强健的全局模型,极大地提升了数据的利用效率和模型的泛化潜力。

lxs_569190的博客 379

元学习(meta-learning)的通俗解释

还以目标检测为例,仍然拿一个很大的数据集来训练模型,而 meta-learning 的目标不是让模型在没见过的图片中学会分辨训练集中提到过的类别,而是让模型学会分辨事物的异同,学会分辨这两者是相同的东西还是不同的东西,当模型学会分辨异同之后再在具体的分类任务中使用极少的数据集训练很少的次数即可达到甚至超越传统目标检测训练范式的效果(这种方式也称为。以上是元学习在目标检测方面的一种应用,通过元学习训练模型提取不同种类图片的特征,然后在这个预训练的模型的基础上实现快速辨别新的图片种类。元学习可以用来学算法。

Flag_ing的博客 9295
上一篇: Claude 是懂本质的
下一篇: 论文精选 | 多模态大模型最新进展
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值