基于Transformer的图像处理预训练模型

超分算法IPT:Pre-Trained Image Processing Transformer 本文是一个基于transformer的预训练通用模型,针对低级视觉任务还没有人提出预训练的模型,所以作者使用了超大数据集训练出了image processing transformer (IPT)。可以微调后应用于图像重建、去噪、去雨等等。具体结构作者使用了一个多头多尾共享躯干的结构。应对不同的任务,有针对性不同的头部和尾部,分别使用不同的处理方式(三个卷积层)。中间是一个transformer编解码器结构。将头部输出的特征图像unfold成”词向量“形式和位置嵌入相加后输入encoder,encoder. 阅读详情
AI摘要

本文介绍了基于Transformer的图像处理预训练模型IPT,它可在小数据集微调后用于去噪、超分等任务。还阐述了其结构、训练图像生成、损失函数及实验结果。此外,分享了大模型AI学习的四个阶段,包括初阶应用、高阶应用、模型训练和商业闭环,并提供免费学习资料。

Pre-Trained Image Processing Transformer

本文介绍一篇发表在CVPR 2021上的文章,该文章提出了一种基于Transformer的图像处理预训练模型,可以在较小的数据集上进行微调后,直接应用到具体的图像处理任务(如去噪,超分,去雨等)。

随着现代硬件计算能力的大幅提升,在大规模数据集上训练的预训练深度学习模型(如BERT、GPT-3)已经显示出比传统方法更好的效果。这一重大进展主要得益于Transformer及其变体架构的强大表示能力。 在本文中,我们研究了低层次计算机视觉任务(如去噪、超分辨率和去雨)并开发了一种新的预训练模型,称为图像处理Transformer(IPT)。

为了最大限度地挖掘Transformer的潜力,我们采用了知名的ImageNet基准数据集来生成大量的损坏图像对。IPT模型在这些图像上进行训练,具有多头和多尾结构。此外,引入了对比学习,以便更好地适应不同的图像处理任务。因此,经过微调后,该预训练模型可以高效地应用于目标任务。仅使用一个预训练模型,IPT就在各种低层次基准上超越了当前的最新方法。

Chen, Hanting, et al. “Pre-trained image processing transformer.” Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. 2021.

Introduction

图像处理是更全局的图像分析或计算机视觉系统的低级部分的一个组成部分。 图像处理的结果可以极大地影响后续的高级部分对图像数据的识别和理解。 最近,深度学习已广泛应用于解决低级视觉任务,如图像超分辨率、修复、去雨和着色。 由于许多图像处理任务都是相关的,因此很自然地期望在一个数据集上预训练的模型可以对另一个数据集有帮助。但很少有研究将预训练推广到图像处理任务中。

预训练有可能通过解决以下两个挑战为图像处理任务提供有吸引力的解决方案: 首先,特定于任务的数据可能有限。这个问题在涉及付费数据或数据隐私的图像处理任务中更加严重,例如医学图像和卫星图像。各种不一致的因素(例如相机参数、照明和天气)会进一步扰乱用于训练的捕获数据的分布。 其次,在测试图像呈现之前,我们无法知道需要执行哪种类型的图像处理任务。 因此,我们必须准备一系列图像处理模块。它们的目的各不相同,但一些底层操作可以共享。

现在,在自然语言处理和计算机视觉预训练进行预训练已很常见,但现存的方法主要研究预测试分类任务,而图像处理任务中的输入和输出都是图像。 直接应用这些现有的预训练策略可能不可行。 此外,如何在预训练阶段有效解决不同的目标图像处理任务仍然是一个艰巨的挑战。

在本文中,他们使用 Transformer 架构开发了一个用于图像处理的预训练模型, 即图像处理 Transformer (IPT)。由于预训练模型需要兼容不同的图像处理任务,包括超分辨率、去噪和去雨, 整个网络由对应于不同任务的多对头和尾以及单个共享主体组成。 由于需要使用大规模数据集来挖掘 Transformer 的潜力,因此他们准备了大量具有相当多样性的图像来训练 IPT 模型,选择了包含 1,000 个类别的各种高分辨率的 ImageNet 基准。 对于 ImageNet 中的每张图像,会使用几个精心设计的操作生成多个损坏的对应图像以服务于不同的任务。 例如,超分辨率任务的训练样本是通过对原始图像进行下采样生成的。整个用于训练 IPT 的整个数据集包含大约 1000 多万张图像。

Image Processing Transformer

IPT 结构
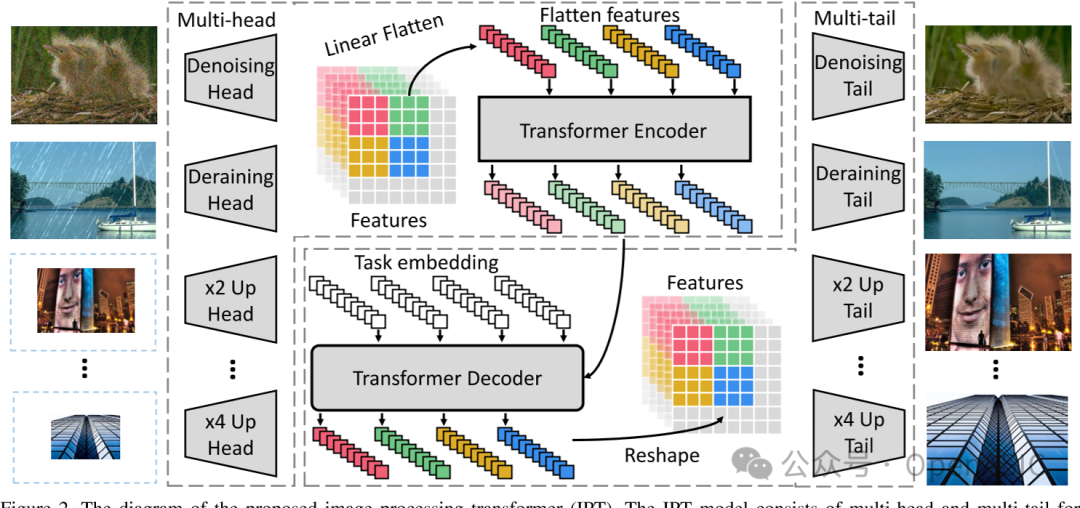
IPT的整体结构主要包括四个部分:Heads, Transformer encoder, Transformer decoder和Tail。

  • Heads
    为了处理不同的任务,我们使用多头架构来分别处理每个任务,其中每个头由三个卷积层组成。每个head主要用来提取输入有损图像的特征。

  • Transformer encoder && decoder和Tail
    本文所采用的transformer的与Attention is all you need结构相同,如下所示:

在这里插入图片描述

在把提取到的特征输入到Transformer body之前,会对特征进行分块处理,特征会被分成若干个大小的patch,每个patch会被看成是一个word。对这些patch进行展开即可得到对应的embedding,表示为, 为了保持patch之间的位置关系,本文采用了基于学习的位置编码,然后会把作为transformer encoder的输入进行处理。

本文所采用的Transformer encoder的处理过程可以表示为下述形式:

其中表示编码器的输出,LN表示Layer Norm,MSA表示Multi-Head Attention,FFN表示Feed Forward模块

decoder部分主要由两个多头注意力机制和一个Feed Forward Network模块组成,与原始的Transformer不同,在decoder中,这篇文章额外使用了特定于任务的embedding()作为解码器的附加输入, decoder处理结果如下:

其中表示解码器的输出。

  • Tail
    与heads类似,我们使用了多个tail来应对不同图像处理的任务,每个tail的输出是一个的图像,最后图像的尺寸有具体的任务决定,例如对于超分任务。

Pre-training on ImageNet

训练图像的生成

对于ImageNet中的原始图像,文章会通过对不同任务自定义的变换来获得有损图像,该过程可以表示为:

f表示退化变换,对于超分任务,f为双三次下采样;对于去噪任务,表示加信高斯噪声。在训练的过程中以退化后的图像作为输入,以原始的图像作为ground-truth来训练。

损失函数

在监督模式下,IPT的损失函数为:

该公式表示多个任务的损失函数的求和。表示传统的损失。

在训练时,对于每个批次,从个任务中随机选择一个任务进行训练, 每个任务将同时使用相应的头、尾和任务嵌入进行处理。 在对IPT模型进行预训练后,它将捕获大量图像处理任务的内在特征和转换。 训练完成后只需使用对应任务提供的数据集进行参数微调,就可以应用于特定的任务。 此外,为了节省计算成本,在微调时将删除其他头部和尾部,并根据反向传播更新剩余的头部、尾部和主干中的参数。

由于在训练的过程中所使用的退化的图片还是有限的,为了应对在实际任务中可能出现的不同特征的有损图像,同时同一图像中的不同patch又是相互关联的,所以文章使用对比学习来提高模型泛化能力。 其目的是最小化来自同一张图片的特征patch间的距离,而最大化来自不同图片的特征patch间的距离。 对比学习的损失函数定义如下:

最后在训练过程中使用的损失函数为:

Experiments

预训练的数据集采用的是ImageNet,训练时,patch size均为,测试时,patch size尺寸一致, 但是具有10像素的交叠。训练的硬件平台为32张NVIDIA Tesla V100, 使用的优化器为Adam优化器。一共训练了300个Epoch,学习率为,在200个epoch后衰减为。训练时所采用的batch size为256.

在具体任务上进行微调时,采用的学习率为,训练次数为30个Epoch。最后的结果如下所示。

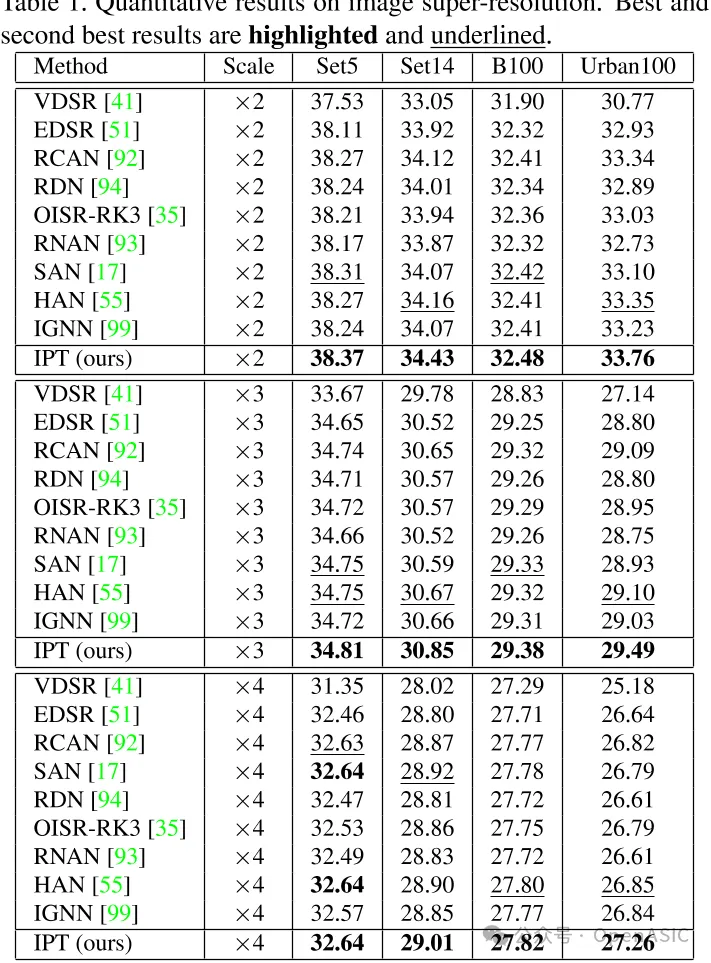
图像超分

IPT模型在x2图像超分任务中表现良好,在Urban100数据集上超过其他方法。实现了33.76dB的psnr,而先前SOTA的方法只能超越其他方法,结果如下:
在这里插入图片描述

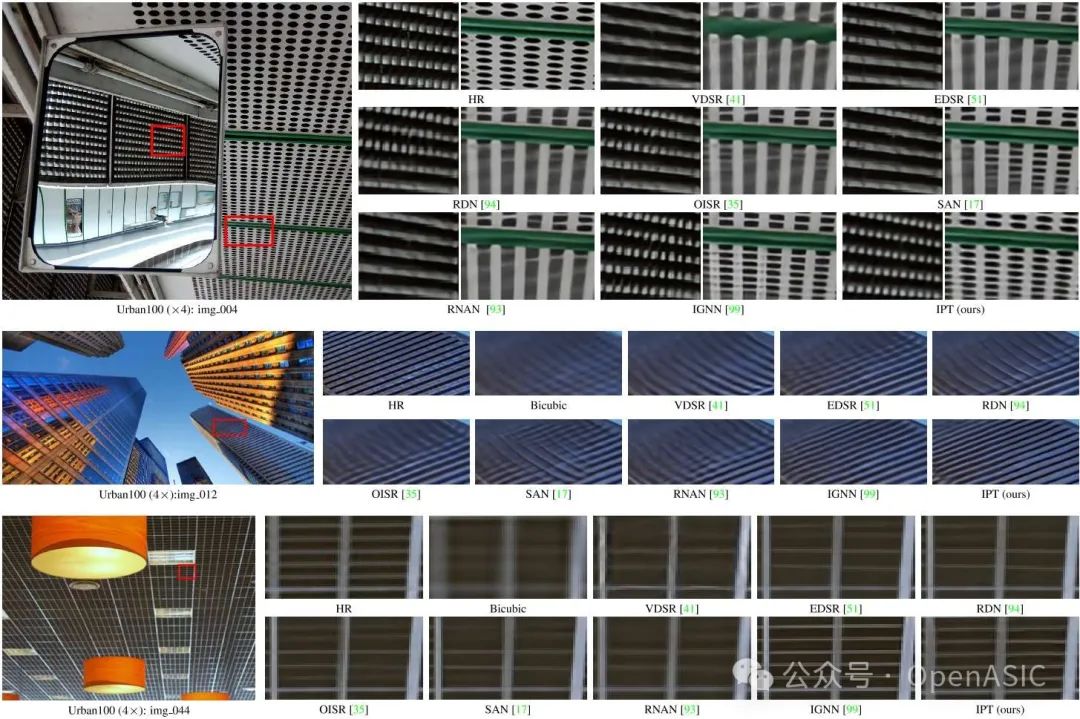
在Urban100数据集实现x4的超分任务时,先前SOTA的方法生成的图像会包括一些模糊,但是使用IPT生成的图像可以很好地保留图像中的细节。如下图所示:
去噪

IPT模型在BSD68和Urban100数据集上与其他SOTA的方法进行去噪比较,发现IPT实现了最好的效果,并且在Urban100数据集上,IPT相较于SOTA的方法有的性能提升,所得到的结果如下:
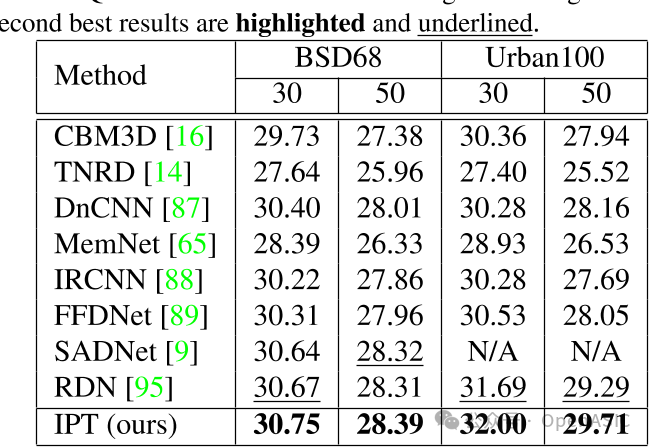
去噪的可视化效果如下所示:
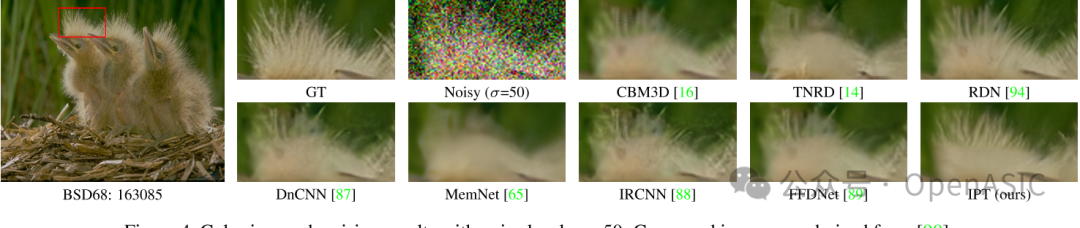
可以发现,IPT去噪后的图像中,对原始图像的细节保留到位。

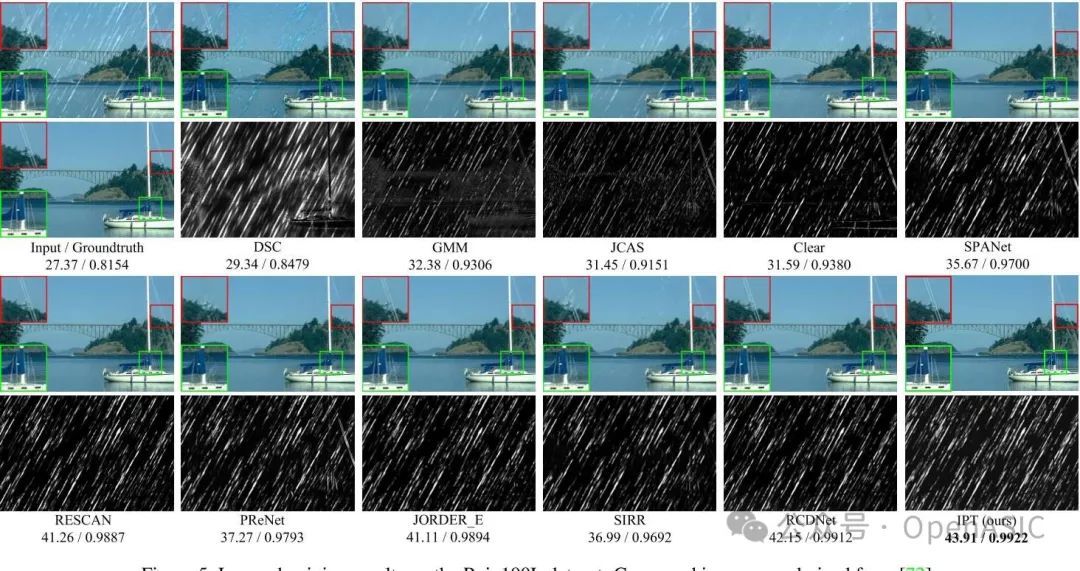
去雨

对于去雨任务,使用Rain100L数据集对其进行评估,相比于先前的SOTA算法,IPT实现了1.62dB的提升,结果如下所示:
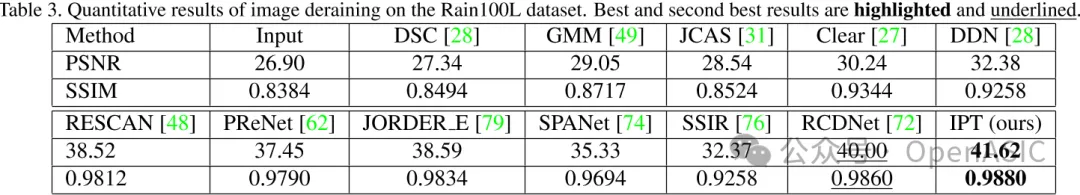
在这里插入图片描述

去雨的可视化结果如下:

以前的SOTA算法都没有办法重建一个很干净的原始图像,但IPT去雨后的图片实现几乎和原始图片质量一致。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

Pre-Trained Image Processing Transformer论文阅读 证明预训练模型对未见任务的强适应性。:在解码器中注入任务嵌入。图6:数据规模对性能的影响。 阅读详情

相关推荐

一文窥探近期大火的Transformer以及在图像分类领域的应用

本文首先将简要介绍Transformer的原理与其各个组成部分、Transformer在自然语言处理(NLP)领域的应用;接下来文章从图片分类与目标检测的角度介绍相应Transformer的应用;最后本文将介绍Transformer在应用到CV领域时依然存在的不足以及未来可能的研究方向。

果菌药的博客 2万+

5.10.1 Pre-Trained Image Processing Transformer

图像处理是更全局的图像分析或计算机视觉系统的低级部分的组成部分之一。图像处理的结果很大程度上影响后续高层部分对图像数据的识别和理解。近年来,深度学习已广泛应用于解决低级视觉任务,例如图像超分辨率、修复、去雨和着色。由于许多图像处理任务都是相关的,因此很自然地期望在一个数据集上预训练的模型可以对另一个数据集有所帮助。在计算机视觉中,deraining是指图像去雨的过程。具体来说,deraining技术旨在从被雨水影响的图像中恢复出清晰、无雨的图像内容。

qq_47896523的博客 1105

预训练图像处理Transformer:华为诺亚、北大等提出IPT模型,刷榜多项底层视觉任务...

作为自然语言处理领域的主流模型,Transformer 近期频频出现在计算机视觉领域的研究中。例如 OpenAI 的 iGPT、Facebook 提出的 DETR 等,这些跨界模型多应用于图像识别、目标检测等高层视觉任务。而华为、北大、悉大以及鹏城实验室近期提出了一种新型预训练 Transformer 模型——IPT(Image Processing Transformer),用于完成超分辨率、去噪、去雨等底层视觉任务。该研究认为输入和输出维度相同的底层视觉任务更适合 Transformer 处理。

迈微AI研习社 · 号主 999

【论文精读】Pre-Trained Image Processing Transformer

出处 摘要 随着现代硬件计算能力的强劲增长,在大规模数据集上学习的预训练深度学习模型(如BERT,GPT-3)已经显示出比传统方法更有效的效果。这一重大进展主要得益于transformer及其变体网络模型的表现能力。本文对底层计算机视觉任务(如去噪、超分辨率和去噪)进行了研究,提出了一种新的预训练模型,即图像处理变换器(IPT)。为了最大限度地挖掘转换器的能力,我们提出利用著名的ImageNet基准测试来生成大量损坏的图像对。IPT模型在这些具有多头和多尾的图像上进行训练。此外,为了更好地适应不同的图像处理

weixin_42780429的博客 4149

【Transformer-Hugging Face 05/10】 使用 AutoClass 加载预训练实例

作为 Transformers 核心理念的一部分,使库易于、简单且灵活地使用,它会AutoClass从给定的检查点自动推断并加载正确的架构。

gongdiwudu的专栏 3342

别再手动写ZPL了!用C#和斑马官方SDK搞定ZT410 RFID打印机(附中文乱码解决方案)

本文详细介绍了如何使用C#和斑马官方SDK驱动ZT410 RFID打印机,解决中文乱码和RFID数据写入等常见问题。通过实战指南,开发者可以快速掌握从基础连接到高级调试的全流程,提升打印效率和可靠性。特别适用于物流、零售和资产管理领域的应用。

weixin_29267307的博客 224

Transformer再下一城!low-level多个任务榜首被占领,北大华为等联合提出预训练模型IPT

来自Transformer的降维打击!北京大学等最新发布论文,联合提出图像处理Transformer。通过对low-level计算机视觉任务,如降噪、超分、去雨等进行研究,提出了一种新的预训练模型IPT,占领low-level多个任务的榜首。 本文首发自极市平台,作者@Happy,转载需获授权。 paper: https://arxiv.org/abs/2012.00364 该文是清华大学&华为诺亚等联合提出的一种图像处理transformer。Transformer自提出之日起即引起极大的

极市平台的技术博客 937

TCN(Temporal Convolutional Networks)时序卷积网络详解及代码

TCN(Temporal Convolutional Networks)时序卷积网络详解及代码

zhulewen的博客 7883

Transformer进行底层图像处理任务

最近看了篇使用transformer进行底层图像处理任务的工作Pre-trained image processing transformer,这里分享一下。 这篇文章使用ImageNet数据集和transformer结构训练出一个专门用于底层图像分处理任务的预训练模型image processing transformer (IPT),在执行具体任务时只需要微调head和tail就可以处理自己的任务,同时还引入了对比学习用于模型适应不同任务。文中对去噪、超分辨和去雨都进行了实验对比,均获得SOTA效果。

SSyangguang的博客 3556

AMD Ross FPGA Agent 实战:用 AI 驱动 Vivado 开发流程

在 EDA 领域,FPGA 开发长期面临工具链重、反馈周期长、报错晦涩等痛点。AI Agent 通过自然语言交互与工具调用,将 Vivado 的 Tcl 批处理流程封装为可编排、可观测的智能体,显著降低查文档与读报告的时间成本。其核心在于 Harness 与 Agent 的协同:Harness 提供安全执行环境,Agent 负责决策与迭代。典型应用包括工程创建、约束生成、综合实现报告解读及比特流失败排查。本文以 AMD Ross 为例,拆解其架构设计与实操方法,帮助开发者理解如何将 Agent 落地到高门槛

weixin_29189363的博客 1021

Spark 大数据环境搭建( Linux 系统安装和配置)

(1)选择典型安装(2)选择“安装程序光盘映像文件(iso)”,点击右侧的浏览按钮, 找到下载好的iso 文件,然后点击下一步。(3)将全名、用户名、密码、确认等几项均设为“spark”, 方便后面使用,然后点击下一步。(4)在命名虚拟机的窗体中,可以设定一下虚拟机名称或直接按默认,然后点击下一步。(5)在指定磁盘容量的窗体中,设定虚拟机使用的最大磁盘大小为60GB,虚拟机文件尺 寸是在使用过程中按需增长的,最大限制为 60GB。

2301_80186825的博客 1604

Pre-Trained Image Processing Transformer论文笔记

Pre-Trained Image Processing Transformer论文笔记

weixin_46872424的博客 532

从零搭建uniapp+vue3+ts+tailwindcss多端兼容开发环境

本文详细介绍了如何从零搭建uniapp+vue3+ts+tailwindcss多端兼容开发环境,包括环境准备、TailwindCSS集成、小程序兼容性解决方案以及样式优化技巧。通过实战步骤和常见问题解答,帮助开发者快速掌握这套技术栈,提升开发效率。

weixin_28693309的博客 323

IPT:Pre-Trained Image Processing Transformer

Transformers的变体,如BERT[19]和GPT-3[5],进一步丰富了训练数据,提高了训练前的技能。还为其他任务提出了各种出色的工作,如去噪[68,32,37,45,24],去杂[6,46,85,80],去噪[36,78,62,29,74,47]和去杂[67,53,23,10]。我们IPT的总体架构由四个组件组成:头部用于从输入损坏的图像(例如,具有噪声和低分辨率图像的图像)中提取特征,建立编码器-解码器转换器用于恢复输入数据中丢失的信息,尾部用于将特征映射到恢复的图像中。

mytzs123的博客 624

MGC3130 3D手势识别传感器原理图设计,已量产(交互传感器)

最近在落地一款互动艺术装置的控制模块,选了 Microchip 的 MGC3130 做核心 —— 这颗芯片算是 GestIC® 近场传感技术的 “熟面孔” 了,把 3D 手势识别、运动跟踪的信号处理都集成在一颗芯片里,0-10cm 的检测距离刚好适配桌面级互动场景,挥挥手就能控设备的体验,放在艺术装置里确实很出效果。今天扒一下实际跑通的原理图,聊聊每个模块的设计思路。

不脱发的程序猿 369

【学习系列】SAP RAP 4:通过注解来完成一些常规需求

本文介绍了RAP应用中常用注解的实现方式,包括搜索帮助、文本描述绑定、联动搜索、字段控制等功能。通过@Consumption、@UI等注解可以实现搜索帮助定义、多字段联动、必输校验、默认排序和默认值设置。管理字段可通过@Semantics注解自动记录创建/修改信息,长文本使用@UI.multiLineText实现多行显示。这些注解可优化界面交互和数据管理,为后续行为定义功能开发奠定基础。文章结构清晰,针对不同需求提供了具体的实现方案和代码示例。

DeveloperMrMeng的博客 694

文献阅读:Pre-Trained Image Processing Transformer(2021.5.28.arXiv)

Pre-Trained Image Processing Transformer 1.四个问题 要解决什么问题 低视觉任务(去燥、超分辨率、去雨、去模糊等):图像处理 探索一种用于图像处理任务的通用预训练方法 用什么方法解决 基于Transformer架构,通过大规模数据集,开发了一个用于图像处理的预训练模型,即图像处理转换器(IPT),以端到端的方式进行学习。 整个模型分为3个部分:a.从损坏图像中提取特征的头部;b.用于恢复属于数据中心丢失信息的编码器-解码器转换器;c.用于将特征恢复为图像的尾部 将I

MRzzyy的博客 913

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

华为北大等联手打造的Transformer竟在CV领域超过了CNN:多项底层视觉任务达到SOTA...

杨净 发自 凹非寺 量子位 报道 | 公众号 QbitAI提起Transformer,就会想到BERT、GPT-3。但其实,这个在各种自然语言处理任务中「混迹」,强大的无监督预训练模型,...

量子位 411

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

【论文阅读】IPT:Pre-TrainedImageProcessingTransformer

随着现代硬件的计算能力在强烈增加,预训练的深度学习模型(如33.42928 216. BERT、GPT-3)在大规模数据集上的学习表现出 33.32933.226.7 与传统方法相比的有效性。big28.933.126.6IPTHANIPT的进步主要归功于transformer及其变体架构的表示能力-HANHAN IPT(ECCV 2020)(ECCV 2020)(ECCV 2020)。

博客 2137

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

DINOv2 Vision Transformer预训练模型实战指南:从入门到精通

当你在生物医学图像分析项目中尝试使用DINOv2预训练模型时,是否遇到过这样的困惑:明明按照官方文档配置参数,却在加载模型时频频报错?这很可能是输入尺寸与位置编码不匹配导致的典型问题。作为Meta AI推出的新一代自监督视觉Transformer,DINOv2通过自蒸馏技术实现了卓越的视觉表征学习能力,但正确配置其预训练模型参数需要掌握一些关键技巧。 ## 五大实战问题深度解析 ### 问题一

gitblog_00692的博客 1104

Pre-Trained Image Processing Transformer阅读笔记

Pre-Trained Image Processing Transformer阅读笔记 Abstract 我们研究了底层计算机视觉任务(如去噪,超分辨率和去雨),开发了IPT。只通过一个预训练好的模型,IPT在各种低水平的benchmark上达到state-of-the-art的水平。 1 Introduction 图像处理是更全局的图像分析,或者是计算机视觉系统的低级部分 的一个组成部分。图像处理的结果很大程度上影响后续的对图像数据的识别和理解。 [56, 22]应用基于self-attention的模

weixin_43540533的博客 1025

Pre-Trained Image Processing Transformer

论文地址:2012.00364.pdf (arxiv.org)Abstract:随着现代硬件计算能力的强劲增长,在大规模数据集上学习的预训练深度学习模型(如BERT、GPT-3)已显示出其优于传统方法的有效性。这一巨大进步主要归功于transformer及其变体架构的表示能力。在本文中,我们研究了低级计算机视觉任务(如去噪、超分辨率和去噪),并开发了一种新的预训练模型,即图像处理变换器(IPT)。为了最大限度地挖掘transformer的能力,我们提出利用著名的ImageNet基准生成大量损坏的图像对。IP

mytzs123的博客 141
上一篇: 最新开源:边缘设备优化的多模态模型Omnivision!通义灵码团队开源Lingma SWE-GPT!
下一篇: 中南大学王建新教授团队提出BANDRP模型,通过基于分子指纹和多组学的双线性注意力网络进行药物反应预测
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2829原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值