超全面讲透一个算法模型,XGBoost!!

XGBoost详解(原理篇) XGBoost全称为eXtreme Gradient Boosting,即极致梯度提升树。XGBoost是Boosting算法的其中一种,Boosting算法的思想是将许多弱分类器集成在一起,形成一个强分类器(个体学习器间存在强依赖关系,必须串行生成的序列化方法)。Note:关于Boosting算法详见博文集成学习详解_tt丫的博客-优快云博客XGBoost是一种提升树模型,即它将许多树模型集成在一起,形成一个很强的分类器。其中所用到的树模型则是CART回归树模型。 阅读详情
AI摘要

本文详细介绍了XGBoost算法,它是一种极限梯度提升算法,擅长解决结构化数据问题,具有速度快、准确性高、防过拟合等特点,还给出公式推导和房价预测案例。此外,分享了大模型AI的学习路径,包括初阶应用、高阶应用、模型训练和商业闭环四个阶段。

XGBoost作为一个非常牛逼的算法模型,大家一定要非常清楚其原理。

XGBoost 特别擅长解决结构化数据问题,比如表格数据。它的全称是「eXtreme Gradient Boosting」,意思是「极限梯度提升」。听起来有点复杂,其实用通俗的语言解释,它就是一种让模型一步步变得更聪明的算法。

下面我们一步步来看看它的思路~

1. 什么是「梯度提升」?

想象我们要训练一个模型来预测房价。我们一开始用一个很简单的模型,它可能只会做一些粗略的预测,误差会很大。然后我们让第二个模型来专门学习第一个模型的错误,想办法减少这个误差。接着,第三个模型再学习前两个模型的误差……每一步都「纠正」前面的错误,让模型不断「提升」。这种逐步提高模型的方式就叫「梯度提升」。

2. XGBoost 是一种「强化」版的梯度提升

XGBoost 是梯度提升的一个升级版,在很多细节上做了优化,让它训练更快、效果更好。比如,它会使用一种叫做「并行计算」的技术,让计算机同时进行多个计算,大大加速了训练速度。还有一些优化的数学技巧,可以让它在不损失准确性的前提下更快地找到答案。

举个easy案例:预测房价

假设我们在某个城市的房产数据上训练 XGBoost 模型来预测房价。数据包括房子的面积、房间数、建造年份等特征。具体步骤如下:

  1. 初始化模型:XGBoost 一开始会用一个非常简单的预测方式,比如预测每个房子价格的平均值。这种预测通常误差很大。

  2. 计算误差:接着,模型会检查哪里预测得不准,比如有些房子的价格预测得偏高,有些偏低。

  3. 学习误差:然后,XGBoost 会生成一个「决策树」,专门用来预测这些误差。决策树就像一张分支图,它会根据数据特征一步步地把房子分类,比如先按照面积大小分,再按照房间数量分,直到找到价格的规律。这个新的决策树就会「修正」第一个模型的误差。

  4. 重复多次:再接着,XGBoost 会不断创建更多的树,每棵树都是为了修正之前树的误差。每次生成新的树,模型的预测都会更准确一点。最终,把所有树的预测加起来就会得到一个很不错的结果。

XGBoost 的一些特点

  1. 速度快:它计算效率很高,尤其适合大数据。

  2. 准确性高:XGBoost 在比赛和实际应用中常常表现优异,因为它在训练过程中逐步减少误差。

  3. 可以防止过拟合:XGBoost 有一些机制可以防止模型过度拟合,比如设置最大深度、学习率等参数。

总的来说,XGBoost 就像一个由很多「小树」组成的团队,这些小树各自负责一部分任务,彼此互相纠正错误,最终得出一个更加准确的预测。对于大部分表格数据问题,比如预测价格、用户行为等,XGBoost 都是一个表现很好的选择。

下面,我们通过详细的原理解释和案例,让大家更加深入的理解XGBoost。

公式推导

1. 树模型和损失函数

XGBoost 的目标是利用决策树集合来预测一个目标变量。假设我们有一个数据集 ,其中 是特征, 是目标值。模型的预测值可以表示为各棵树的加权和:

其中, 表示第 棵树的结构。每棵树 会将数据分到不同的叶子节点,每个叶子节点有一个得分值。

我们的目标是找到一组树,使得预测值与真实值的误差最小。因此,我们定义一个损失函数来度量误差,通常可以用均方误差或其他误差函数。对于均方误差的情形,损失函数可以写作:

2. 二阶泰勒展开

XGBoost 通过迭代地优化损失函数来训练每棵树。在每一轮中,我们新增一个树 ,希望能最小化损失。使用泰勒展开,损失函数可以近似写作:

其中 是一阶导数, 是二阶导数。通过最小化这个近似的损失函数,我们能更高效地找到最优解。

3. 叶子节点的得分

对于每个叶子节点,我们可以计算一个最优权重,以此来降低误差。假设叶子节点集合为 ,则第 个叶子节点的最优权重为:

其中, 是正则化参数,用于控制模型的复杂度,防止过拟合。

完整案例

  1. 生成虚拟数据:包含房屋面积、房间数量、建造年份等特征。

  2. 使用 XGBoost 模型训练:预测房价。

  3. 数据可视化:绘制数据分布、模型训练过程的损失变化、特征重要性、预测效果等图表。

代码实现

import numpy as np   import pandas as pd   import matplotlib.pyplot as plt   import seaborn as sns   from sklearn.model_selection import train_test_split   from sklearn.metrics import mean_squared_error   from xgboost import XGBRegressor, plot_importance   import xgboost as xgb      # 生成虚拟数据集   np.random.seed(42)   n_samples = 5000   area = np.random.normal(1500, 500, n_samples)  # 房屋面积   rooms = np.random.randint(2, 7, n_samples)  # 房间数量   age = np.random.randint(1, 30, n_samples)  # 建造年份   location_score = np.random.uniform(1, 10, n_samples)  # 位置评分      # 假设真实的房价与这些特征的线性关系,再加入噪声   price = 5000 + 0.3 * area + 10000 * rooms - 150 * age + 5000 * location_score + np.random.normal(0, 10000, n_samples)      # 创建 DataFrame   data = pd.DataFrame({       'Area': area,       'Rooms': rooms,       'Age': age,       'Location_Score': location_score,       'Price': price   })      # 数据分为训练集和测试集   X = data[['Area', 'Rooms', 'Age', 'Location_Score']]   y = data['Price']   X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)      # 定义和训练 XGBoost 回归模型,添加 eval_set 参数   eval_set = [(X_train, y_train), (X_test, y_test)]   model = XGBRegressor(objective='reg:squarederror', max_depth=4, learning_rate=0.1, n_estimators=100, random_state=42)   model.fit(X_train, y_train, eval_set=eval_set, eval_metric="rmse", verbose=False)      # 预测结果   y_pred = model.predict(X_test)   rmse = np.sqrt(mean_squared_error(y_test, y_pred))      # Data Distribution   plt.figure(figsize=(10, 6))   sns.scatterplot(x='Area', y='Price', hue='Rooms', size='Location_Score', sizes=(20, 200), data=data, palette="viridis")   plt.title("Relationship between Area and Price (by Room Count and Location Score)")   plt.xlabel("Area (Square Feet)")   plt.ylabel("Price")   plt.legend(title="Room Count & Location Score", loc="upper left", bbox_to_anchor=(1, 1))   plt.show()      # Loss Change during Training   results = model.evals_result()   epochs = len(results['validation_0']['rmse'])   x_axis = range(0, epochs)      plt.figure(figsize=(10, 6))   plt.plot(x_axis, results['validation_0']['rmse'], label='Train')   plt.plot(x_axis, results['validation_1']['rmse'], label='Test')   plt.title("RMSE during XGBoost Training")   plt.xlabel("Epoch")   plt.ylabel("RMSE")   plt.legend()   plt.show()      # Feature Importance   plt.figure(figsize=(10, 6))   plot_importance(model, importance_type='weight', title='Feature Importance (Based on Frequency of Use)')   plt.show()      # Actual vs Predicted Values   plt.figure(figsize=(10, 6))   plt.scatter(y_test, y_pred, c='red', marker='o', edgecolor='k', alpha=0.6)   plt.plot([y_test.min(), y_test.max()], [y_test.min(), y_test.max()], 'k--', lw=2)   plt.title("Actual vs Predicted Prices")   plt.xlabel("Actual Price")   plt.ylabel("Predicted Price")   plt.show()      # Output RMSE   print(f"Test RMSE: {rmse:.2f}")   

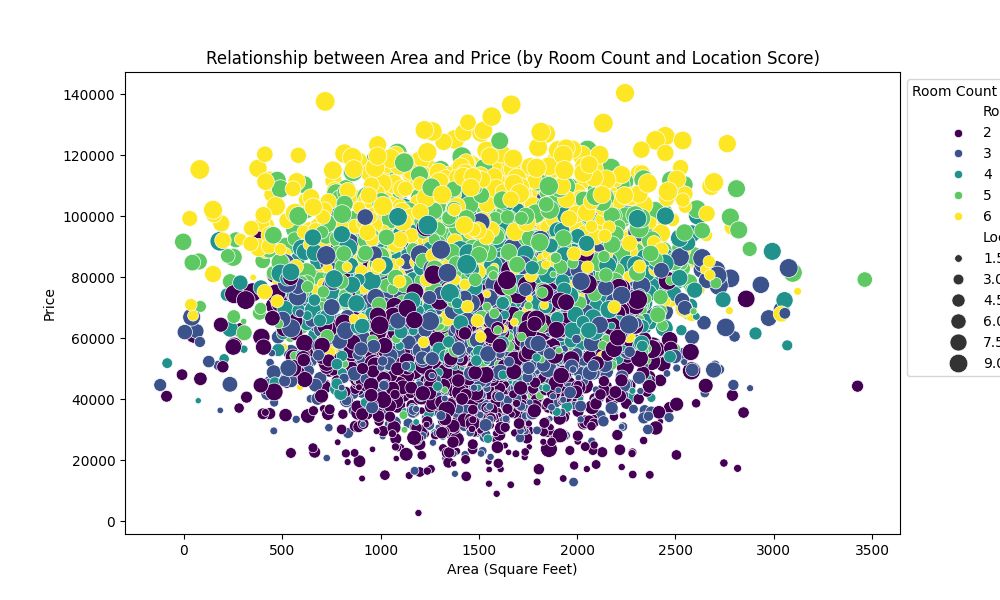
图表1:房屋面积和价格的关系:这是特征的基本分布图。横轴表示面积,纵轴表示价格,颜色代表房间数量,大小代表位置评分。我们可以从中看到一些特征间的相关性,比如面积越大、房间越多,价格也越高。
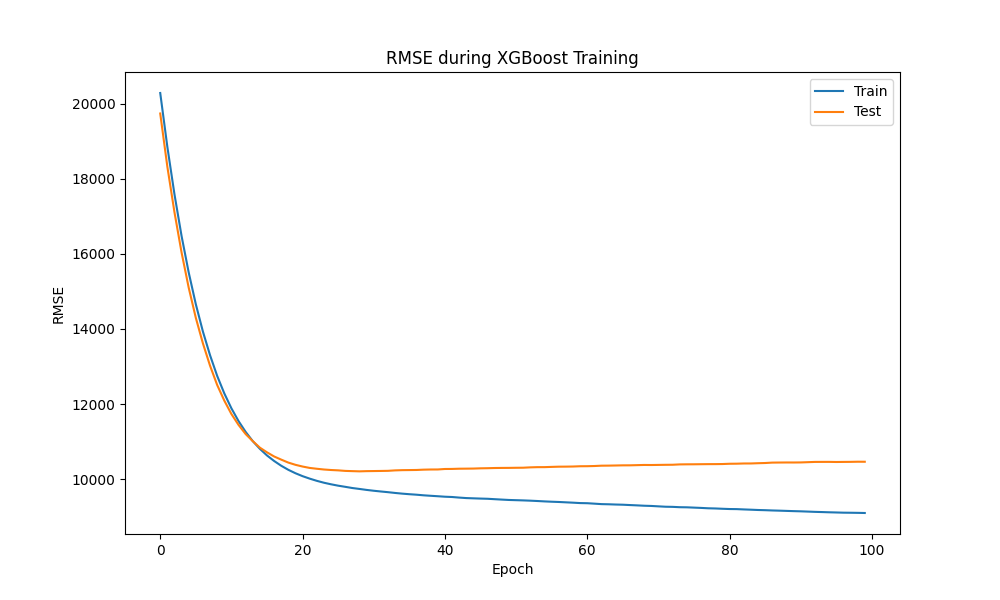
图表2:训练过程中的损失变化(RMSE):这个图展示了模型在训练过程中 RMSE 的变化趋势。通过观察曲线的下降速度,我们可以评估模型收敛的情况。如果曲线平稳,说明模型训练得较好;如果曲线过早停止下降,可能需要调整参数。
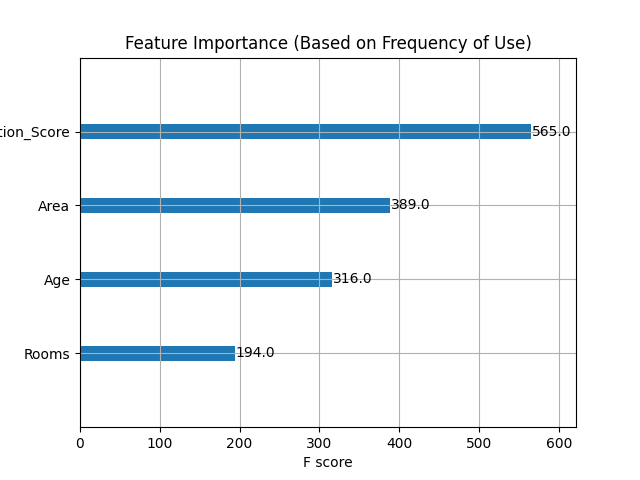
图表3:特征重要性:这是 XGBoost 自动计算的特征重要性。每个特征的重要性由其在模型中出现的频率决定。重要性高的特征对预测结果影响更大。我们可以看到哪些特征对房价预测的贡献最大,比如「面积」和「房间数量」。
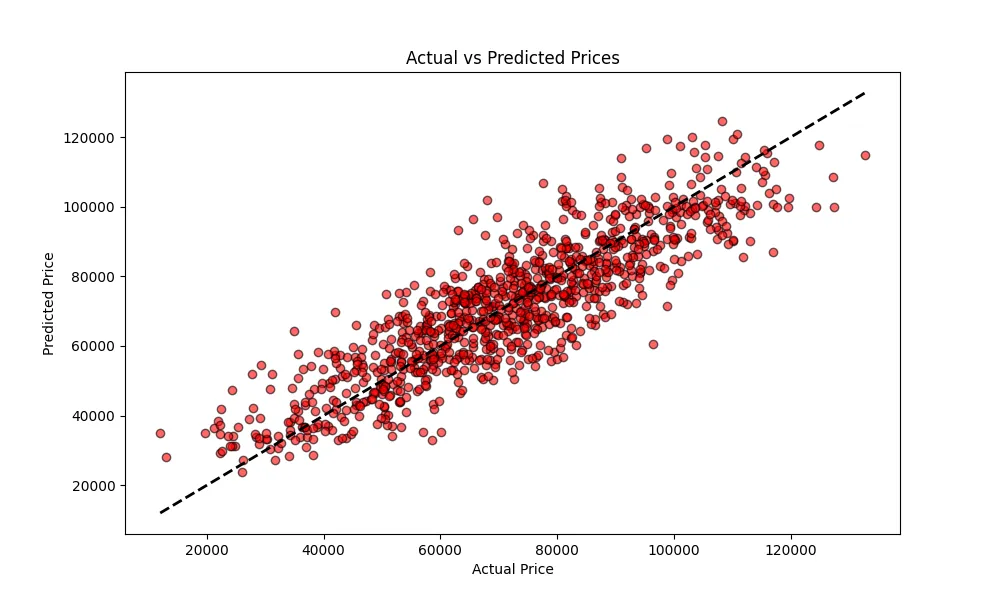
图表4:真实值 vs 预测值:该图展示了测试集的真实房价和模型预测的房价的关系。理想情况下,所有点应落在对角线附近。点越靠近对角线,说明模型的预测越准确。散布较远的点说明模型误差较大。
在这里插入图片描述

整个过程,咱们展示了 XGBoost 如何预测房价,并且用多个图表展示了数据和模型训练的细节。这些图表有助于大家很好的理解数据特征、训练过程和模型的表现。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

机器学习---xgboost算法 问题上表现的十分顶尖,本节将较详细的介绍XGBoost的算法原理。成和剪枝分别对应了经验风险最小化和结构风险最小化, XGBoost的决策树生成是结构风险最小。式(1.1)称为经验风险最小化,训练得到的模型复杂度较高。出结果, 是模型的输出结果;等式右边第⼀部分是模型的训练误差,第⼆部分是正则化项,这里。其中,F是假设空间,假设空间是在已知属性和属性可能取值的情况下,对所有可能满足目标的情。最小化,结构风险最小化的模型往往对训练数据以及未知的测试数据都有较好的预测。的正则化项是K棵树的正则化项相加而来的。 阅读详情

相关推荐

天池龙珠计划寒假训练营学习笔记:利用XGBoost进行分析的完整流程

天池龙珠计划寒假训练营学习笔记:利用XGBoost进行分析的完整步骤 工具:天池NoteBook 训练数据10.9MB 训练数据下载链接:https://tianchi-media.oss-cn-beijing.aliyuncs.com/DSW/7XGBoost/train.csv 声明: 本文主要内容来源于天池龙珠计划寒假训练营教材,部分内容有修改。 原文地址: 添加链接描述 1、XGBoost 的优缺点: 1.1 XGBoost的主要优点: 简单易用。相对其他机器学习库,用户可以轻松使用XGBoost

AI_SupplyChain的博客 953

XGBoost模型详解

1.什么是XGBoost?   GBDT,它是一种基于boosting增强策略的加法模型,训练的时候采用前向分布算法进行贪婪的学习,每次迭代都学习一棵CART树来拟合之前 t−1t-1t−1 棵树的预测结果与训练样本真实值的残差。XGBoost对GBDT进行了一系列优化,比如损失函数进行了二阶泰勒展开、目标函数加入正则项、支持并行和默认缺失值处理等,在可扩展性和训练速度上有了巨大的提升,但其核心思想没有大的变化。 2.XGBoost的核心原理 2.1 如何构造目标函数?   对于一个给定有 nnn 个样本和

weixin_44852067的博客 2万+

一文速学-XGBoost模型算法原理以及实现+Python项目实战_xgboost金融领域模型实战(2)

变换后的目标函数可以被二阶泰勒展开,使得目标函数在每个节点的损失函数可以被表示为关于该节点预测值的二次函数,这样可以在计算最优分裂点时,使用牛顿法或拟牛顿法等高效的优化算法来求解。变换后的目标函数可以解决梯度爆炸和梯度消失问题,这是由于使用指数函数和对数函数进行变换,将目标函数的值范围映射到了一个合适的区间,从而避免了数值溢出和数值不稳定的情况。变换后的目标函数可以解决分类问题的类别不平衡问题,这是由于在分类问题中,负样本数量通常远大于正样本数量,导致算法容易偏向于负样本。

2401_84166376的博客 1448

XGBoost算法介绍

XGBoost算法介绍一、简介二、基本原理三、目标函数新的改变功能快捷键合理的创建标题,有助于目录的生成如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出导入 一、简介   XGBoost(eXtreme Gradient Boosting)又叫极度梯度提升树,是boosting

Silence的博客 5万+

一文速学-XGBoost模型算法原理以及实现+Python项目实战_xgboost金融领域模型实战(1)

这里不再复述,仅讲XGBoost改动,我们知道单独的使用GBDT模型,容易出现过拟合,在实际应用中往往使用 GBDT+LR的方式做模型训练。一般情况下,我们的树模型越深越茂密那么复杂度越高,或者叶子节点值越大模型复杂度越高。在XGBoost算法的实现中,是采用下式来衡量模型复杂度的:其中代表叶子节点个数,:各个叶子节点值的求和,:超参数,控制惩罚程度。那么我们将原目标函数的和给取代掉:那么此时我们定义在叶子结点中的实例的集合为:计算损失函数时是以样本索引来遍历的。

2401_84166376的博客 1250

Xgboost模型

一.Xgboost简介 1.Xgboost是大规模并行boosted tree的工具,它是目前最快最好的开源boosted tree工具包之一,比常见的工具包快10倍以上,他是GB方法里的完全加强版本,也是基于残差优化的算法,希望建立K个回归树,使得树群的预测值尽量接近真实值(准确率)而且有尽量大的泛化能力。 2.Xgboost相对于GBDT的优点:         (1)传统GBDT以CA...

马飞飞的博客 1万+

【机器学习】讲透一个强大算法模型,Prophet!!

一直以来,都断断续续的会给大家分享有关时间序列的模型,以及一些常用方法。今天,咱们分享的Prophet是非常好用且效果不错的一个模型,Prophet最初是由Facebook 开发,用来帮助预测数据的未来趋势。简单来说,时间序列预测就是通过分析历史数据,猜测未来会发生什么。比如你有过去几年每天的销售额数据,想预测明年的销售额趋势,Prophet 就是用来做这个的工具。咱们简单的来解释一下Prophe...

fengdu78的博客 1万+

树模型系列之XGBoost算法

文章目录XGBoost算法理论 XGBoost算法理论

召唤师的峡谷 8789

一个必会算法模型,XGBoost !!

XGBoost是一种集成学习算法,基于决策树构建强大的预测模型。它通过迭代训练多个决策树模型,利用梯度提升技术不断优化模型性能。XGBoost在各种数据集上都表现出色,并且被广泛应用于分类和回归问题。

FeelTouch Labs 1629

来自工业界的知识库 RAG 服务(二),RagFlow 源码全流程深度解析

前面介绍过有道 QAnything 源码解析,通过深入了解工业界的知识库 RAG 服务,得到了不少调优 RAG 服务的新想法。因此本次趁热打铁,额外花费一点时间,深入研究了另一个火热的开源 RAG 服务RagFlow的完整实现流程,希望同样有所收获。首先依旧可以先从框架图入手,与常规的 RAG 架构进行一些比较可以看到右侧知识库被明显放大,同时最右侧详细介绍了文件解析的各种手段,比如OCR等,这些在常规的 RAG 中可能会作为一个不起眼的。

易迟的专栏 2万+

低成本主从机械臂系统构建:6D位姿数据采集与VLA模型训练实战

本文详细介绍了如何构建低成本主从机械臂系统,实现高精度6D位姿数据采集与VLA模型训练。通过300美元级别的硬件组合,系统达到±1mm位置精度和≤0.5°姿态误差,满足Vision-Language-Action模型的多模态训练需求。文章涵盖硬件选型、数据采集技巧、模型训练实战经验,为机器人研究提供经济高效的解决方案。

r7s8t的博客 266

最强总结机器学习算法模型,XGBoost!!

Boosting是一种集成学习的方法,旨在通过将多个弱学习器(通常是决策树)组合起来,逐步提升模型的预测性能。与Bagging(如随机森林)不同,Boosting中的弱学习器是依次训练的,每一个新的弱学习器试图纠正前一个弱学习器的错误。因此,每一步都在改进整体模型的效果。我们使用XGBoost算法构建了一个房价预测模型。通过分析虚拟数据集的特征,我们发现房屋面积和房间数是影响房价的主要因素。经过模型训练与调优,最终得到了较为准确的房价预测结果。

lvaolan的博客 2003

(目录)微气候模型ENVI-met模拟的基本使用教程

ENVI-met模拟操作系列(一) 介绍:

ysqzhatian的博客 2万+

GBDT、XGBoost、LightGBM,树模型全面对比 !!

最近已有不少大厂都在秋招宣讲了,也有一些在 Offer 发放阶段。节前,我们邀请了一些互联网大厂朋友、今年参加社招和校招面试的同学。针对新人如何快速入门算法岗、如何准备面试攻略、面试常考点、大模型项目落地经验分享等热门话题进行了深入的讨论。今儿和大家聊聊GBDT、XGBoost和LightGBM的区别和联系~

Python数据挖掘 3962

博途PLC模糊PID控制(附SCL完整源代码)

操作人员根据对象的当前状态和以往的控制经验,用手动控制的方法给出适当的控制量,对被控对象进行控制。用电脑模拟操作人员手动控制的经验,对被控对象进行控制。用模糊数学的知识模仿人脑的思维方式,对模糊现象进行识别和判决,给出精确的控制量,对被控对象进行控制。与经典控制理论和现代控制理论相比,模糊控制的特点是不需要建立对象的精确模型。根据操作人员手动控制的经验,总结的完整控制规则,在根据系统当前的运行状态,经过模糊推理,模糊判决等运算,求出控制量,实现对被控对象的控制。......

RXXW_Dor的博客 8966

智能车图像处理14-进阶篇6--坡道的判定

这篇文章主要讲述智能车图像处理中 : 如何判断坡道

taiyuezyh的博客 9231

LightGBM、XGBoost 与深度学习模型到底该选谁?一文讲透!

在选择机器学习模型时,LightGBM、XGBoost和深度学习各有其适用场景。LightGBM和XGBoost都是基于梯度提升树的集成学习算法,适用于结构化数据,具有训练速度快、可解释性强的特点,尤其在小样本场景下表现优异。LightGBM在训练速度和内存使用上优于XGBoost,适合大规模数据。深度学习模型则擅长处理非结构化数据(如图像、文本、声音),支持多模态融合,但训练速度较慢且可解释性差。总结来说,结构化数据预测任务推荐使用LightGBM,而复杂数据处理任务则非深度学习莫属。

m0_68856746的博客 2514

[Dify] HTTP 请求节点总是调不通?先把请求头、参数、变量和返回 JSON 拆开查

这篇文章围绕 Dify HTTP 请求节点调不通、接口能通但流程不稳定、返回 JSON 后续节点读不到等问题展开,从 Method、URL、Header、Body、变量映射和返回字段提取几个角度梳理排查顺序。适合正在把 Dify Workflow 接入企业微信、CRM、工单系统或内部接口的读者阅读,帮助你把接口调用从一次性跑通推进到可复用、可验证的业务流程。

技术小甜甜:传播可落地技术,帮助个人和企业降低解决真实场景问题的成本 3944

一文讲透XGBoost:从原理到实践的完整指南

XGBoost是一种高效的梯度提升决策树算法,通过二阶泰勒展开优化目标函数,结合正则化项防止过拟合。相比传统GBDT,XGBoost创新性地利用二阶导数信息加速收敛,并引入列块设计、缓存优化等工程技巧提升计算效率。其核心优势包括:精确贪心算法和近似算法优化节点分裂,加权分位数草图处理特征重要性,以及内置缺失值处理和列采样功能。这些理论创新与工程优化使XGBoost在准确性和速度上显著优于传统GBDT,成为机器学习竞赛和工业实践中的首选算法。

goodparty的专栏 3314

基于C++的MMC仿真与PSCAD建模

MMC是一种基于模块化设计的多电平换流器,通常由若干个基本单元(子模块)组成。每个子模块包含一个电容和两个开关,通过控制开关的开闭,实现输出电压的级联和多电平化。高效率:由于开关频率较低,开关损耗小,效率高。高可靠性:模块化设计使得故障模块易于更换,提高了系统的可靠性。灵活扩展:可以通过增加或减少子模块的数量,方便地调整输出电压和功率。PSCAD(Power Systems Computer Aided Design)是广泛应用于电力系统仿真的专业软件,具有强大的建模和仿真能力。

qq_38334677的博客 295

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

XGBoost算法模型

XGBoost算法小计

qq_45913945的博客 1236

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

最强总结机器学习模型,XGBoost !!

最终结果表明,价格和库存量是预测销售额的重要因素,而促销和季节对销售额的影响次之。模型的预测效果较为理想,但在极端样本上存在一定的误差。这为我们在实际业务中使用XGBoost模型提供了重要参考,同时也表明在实际应用中还需要更多的数据和更复杂的模型优化手段。

2201_75910862的博客 1054

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

XGBoost算法梳理

XGBoost是boosting算法的其中一种。Boosting算法的思想是将许多弱分类器集成在一起形成一个强分类器。因为XGBoost是一种提升树模型,所以它是将许多树模型集成在一起,形成一个很强的分类器。而所用到的树模型则是CART回归树模型。讲解其原理前,先讲解一下CART回归树。 一、CART回归树 CART回归树是假设树为二叉树,通过不断将特征进行分裂。比如当前树结点是基于第j个特征值进...

herosunly的博客 1万+

超强预测算法:XGBoost预测模型

XGBoost是一种强大的机器学习算法,适用于预测任务。它通过梯度提升树的方式有效地处理复杂数据,并在许多领域中取得了令人瞩目的成果。本文基于前期介绍的风速数据(文末附数据集),利用XGBoost模型分别对多变量序列、单序列的数据进行建模,来实现精准预测。

3865

xgboost简单介绍_XGBOOST模型介绍

描述前言这是机器学习系列的第三篇文章,对于住房租金预测比赛的总结这将是最后一篇文章了,比赛持续一个月自己的总结竟然也用了一个月,牵强一点来说机器学习也将会是一个漫长的道路,后续机器学习的文章大多数以知识科普为主,毕竟自己在机器学习这个领域是个渣渣,自己学到的新知识点会分享给大家的。前面的文章谈了谈这次比赛非技术方面的收获,对数据集的初步了解和特征工程的处理,今天主要介绍这次使用的模型--XGBOO...

weixin_33407806的博客 5260
上一篇: 15种高级RAG技术:从预检索到生成全面提升RAG效果
下一篇: LLM的Prompt竟然是图灵完备的?LLM提示范式的第一个研究 | 重磅
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值