谷歌ICLR 2024力作:从压缩视角看语言大模型

ICLR 2024录用率31%!精选10篇高分论文分享!(附PDF) 本文指出视觉Transformer(ViT)在有监督和自监督学习中出现的一些问题,特别是在图像的低信息区域产生的伪像,并提出了一种简单方法,通过添加额外令牌到输入序列来解决这些问题。本文中,研究人员利用基于分数的生成模型(SGM)的特定结构来解决一系列中间的线性逆问题,这些问题随着噪声水平的降低逐渐接近原始逆问题的目标后验。研究人员使用顺序蒙特卡洛(SMC)方法从这些后验序列中采样,提出的MCGDiff算法在理论上得到了证明,并在处理病态的贝叶斯逆问题时的数值模拟中展现了优于竞争基线的效果。 阅读详情

摘要

已有研究表明,预测模型可以转化为无损压缩器,反之亦然。近年来,机器学习领域逐渐专注于训练规模越来越大、性能越来越强的自监督(语言)模型。由于这些大型语言模型展现了强大的预测能力,因此在压缩方面也具有潜力。

在本研究中,我们主张从压缩的视角审视预测问题,并评估大型(基础)模型的压缩能力。我们证明,大型语言模型不仅是强大的通用预测器,压缩视角还为理解其扩展规律、分词方法和上下文学习提供了新的见解。

例如,尽管Chinchilla 70B模型主要接受文本训练,但它能够将ImageNet图像块压缩至原始大小的43.4%,将LibriSpeech语音样本压缩至16.4%,分别优于专用压缩器如PNG(58.5%)或 FLAC(30.3%)。

最后,我们展示了预测和压缩的等价性,利用这一特性可以通过任意压缩器(如gzip)来构建条件生成模型。

1 引言

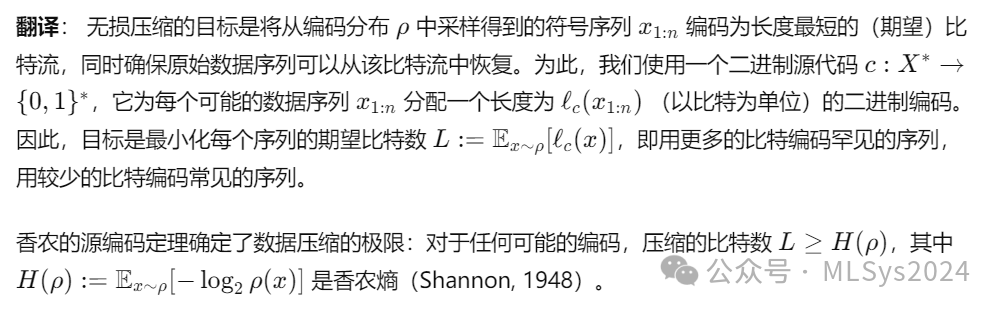
信息论与机器学习密不可分,甚至常被比喻为“一枚硬币的两面”(MacKay, 2003)。其中一个优雅的联系在于数据的概率模型与无损压缩之间的本质等价性。香农的源编码定理(1948)就描述了这一概念:最佳熵编码的期望信息长度等于统计模型的负对数似然值。换句话说,最大化对数似然(数据的对数概率)等同于最小化每条信息所需的比特数。

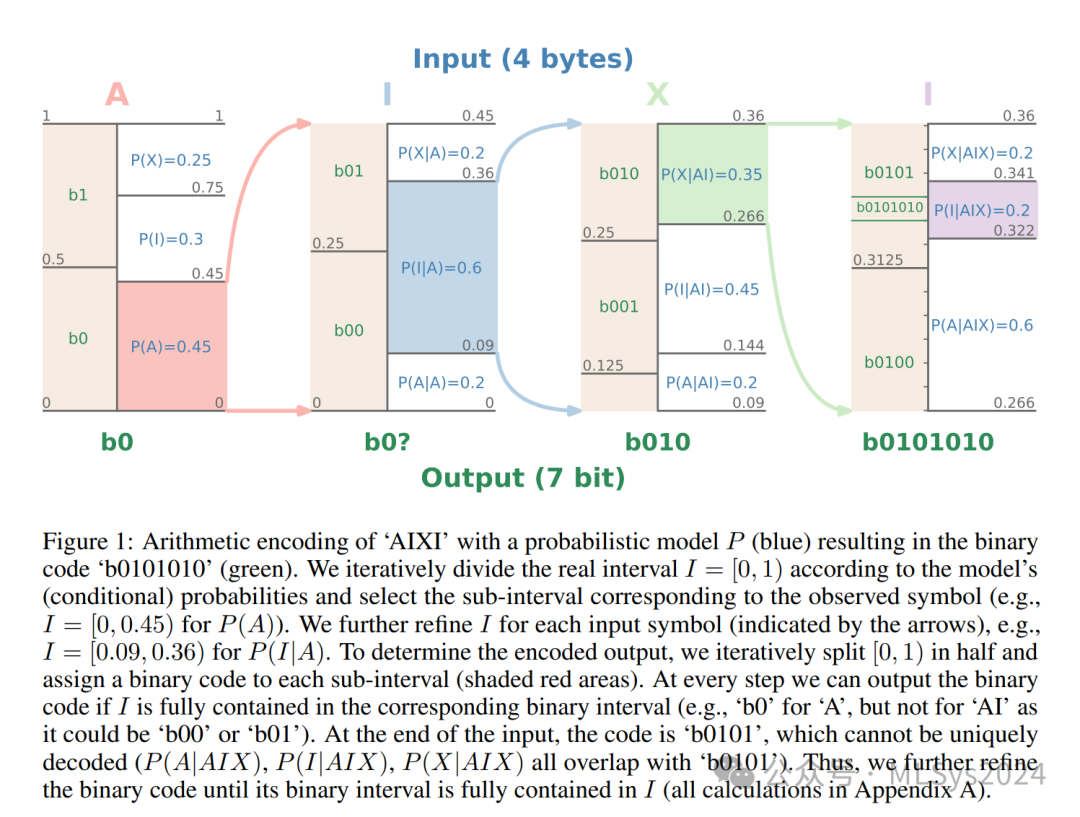
基于概率模型的无损压缩可以通过多种方式实现,如哈夫曼编码(Huffman, 1952)、算术编码(Pasco, 1977; Rissanen, 1976)和非对称数字系统(Duda, 2009)。其中,算术编码因编码长度最优而被认可,其总体压缩效果取决于概率模型的性能(见图1算术编码概述)。
近年来,经过大规模预训练的Transformer模型(Vaswani等, 2017),即所谓的基础模型(Bommasani等, 2021),在各种预测任务中展现了卓越的表现(Bubeck等, 2023; Rae等, 2021),因此被认为是适用于算术编码的理想选择。

基于Transformer的算术编码压缩已在在线(Bellard, 2021; Mao等, 2022)和离线(Valmeekam等, 2023)场景中取得了最先进的结果。在在线场景中,模型以伪随机初始化后直接训练于需压缩的数据流上;而离线场景(本文研究的重点)则是在外部数据集上训练模型,再用于压缩不同的数据流。

因此,离线压缩是在上下文环境下进行的,模型参数固定。Transformer展现了出色的上下文学习能力(Laskin等, 2023; Brown等, 2020; Wei等, 2022; Genewein等, 2023),非常适合用于离线压缩任务。

上下文长度是离线压缩的一个关键限制因素,因为它决定了一个模型一次可以压缩的字节的最大数量。Transformer模型只能压缩几千字节(每个“令牌”用2或3字节编码),同时需要大量的计算。相应地,许多具有挑战性的预测任务(例如,算法推理或长期记忆)需要长的上下文(Delétang等人,2023),因此,扩展这些模型的上下文长度是一个关键的挑战,正在得到越来越多的关注(Zaheer等人,2020;Guo等人,2022;Bulatov等人,2023)。上下文压缩视角为我们提供了对当前基础模型失效模式的洞察。

在这项工作中,我们主张使用(无损)压缩来研究基础模型。为此,我们对大型语言模型的离线(上下文)压缩能力进行了广泛的实证研究,理由是它们已经变得容易获得(Touvron等人,2023a;2023b),因此可以用于压缩,无需训练开销。我们实证显示,这些模型虽然主要在文本上进行(元)训练,但在不同的数据模态上都能实现具有竞争力的压缩率,超过领域特定的标准压缩器(不考虑模型参数大小)。

此外,我们认为scaling law(Kaplan等,2020)的理念同样适用于模型压缩,但需注意的是在压缩时要关注“压缩率”而非通常用来衡量性能的“对数损失”。这是一个关键点,因为scaling law常用于描述模型规模和性能的关系,在这里被引入到压缩中。

随着压缩比的提升(即模型压缩得越来越小),一旦超过某个临界点,压缩反而会损害性能。原因在于,模型压缩过程中需要在输出中引入模型参数的信息量,过度压缩会导致对模型结构信息的过多依赖,从而影响最终性能。

作者主张从压缩的角度构建(自我监督)预测模型,原因是“好的压缩”也能提高模型泛化能力。Hutter(2006)的观点支持这一说法:在训练数据之外能保持良好表现的模型往往也是压缩率较高的模型,因为它们包含的信息更具代表性并去除了冗余。

  • 语言模型研究与压缩之间的联系:通过算术编码和预测模型进行压缩。

  • 大型语言模型(LLM)在文本之外的数据模态(如图像和语音)上也展现出高效的压缩能力,甚至超越了专门设计的压缩算法。例如,Chinchilla 70B在ImageNet补丁上的压缩率为43.4%,在LibriSpeech样本上的压缩率为16.4%,超过了专门的压缩器如PNG(58.5%)或FLAC(30.3%)。

  • 虽然提升模型规模能带来更好的压缩效果,但当数据集大小固定时,模型大小的增加会遇到一个“硬限制”,即模型可能无法再显著提升压缩性能。这对模型扩展的“scaling law”提出了挑战,表明增加模型参数并非始终有效的策略。

  • 使用压缩器作为生成模型,并直观地展示了基础压缩器的性能。

  • tokenization 可以被视为预压缩,一般不会提高压缩性能,但允许模型增加其上下文中的信息内容,因此通常被用来提高预测性能。

2 背景

在这一部分,我们回顾了信息理论所需的背景知识,以及它与似然最大化的关系。为此,我们考虑来自有限符号集 X 的长度为 n 的数据流 x1:n := x1x2…xn ∈ X^n。对于j ≤ n,我们用 x≤j = x<j+1 := x1:j 表示数据流的 前j个字符,并将空字符串表示为 ϵ。最后,我们用 sr 表示两个字符串s和r的连接。

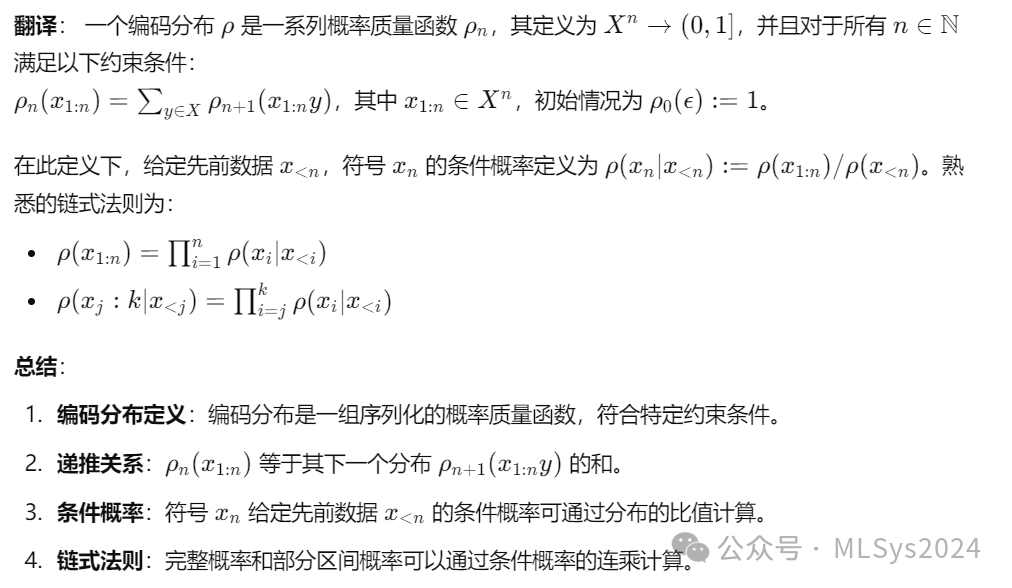
编码分布
无损压缩
算术编码
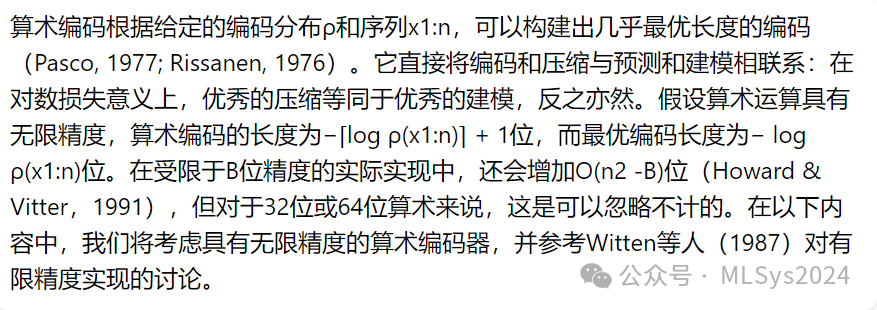
算术编码器:将序列 x1:n 编码为一个介于 [0, 1) 区间内的数 λ 的二进制表示。我们通过逐步缩小包含 λ 的区间(在整个过程中保持 λ 的二进制表示的前缀不断增长)来确定 λ。最初,这个区间是 I0 = [0, 1)。在第 k 步(即编码 xk),我们首先将前一个区间 Ik-1 = [lk-1, uk-1) 分成 N 个子区间 ˜Ik(x1), ˜Ik(x2), …, 每个子区间对应 X = {x1, x2, …, xN} 中的一个字母。表示字母 y 的子区间 ˜Ik(y) 的大小是 (uk-1 − lk-1)·ρ(y | x<k)。形式上,我们定义
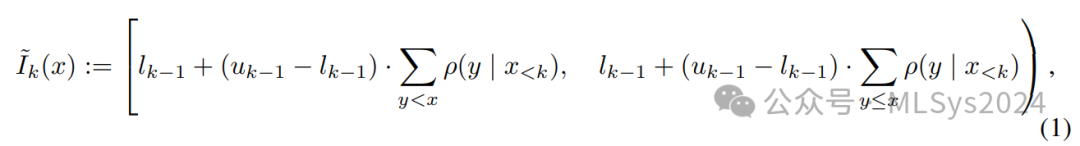
假设 X 上有一个严格的顺序。为了编码 xk,我们继续使用与其对应的区间,即 Ik = ˜Ik(xk)。最后,我们从终止区间 In 中选择具有最短二进制表示的 λ,并使用该二进制表示来编码 x1:n,图 1 展示了这个过程。

算术解码器:给定 λ 和条件概率 ρ,解码第 k 个字符的过程十分简单:从初始区间 I0 = [0, 1) 开始。寻找一个 y,使得 λ 落在 ˜Ik(y) 区间内,从而解码出 xk = y。接着,将 Ik 设置为 ˜Ik(xk),并继续解码下一个字符,即第 k+1 个字符。

最大似然估计:在实践中,源分布 ρ 通常未知,而是用一个参数化的概率模型 ρˆ 来估计。因此,我们不是实现序列 x1:n 的编码长度 −∑_{i=1}^{n} log2 ρ(xi | x<i),而是得到了次优长度 −∑_{i=1}^{n} log2 ρˆ(xi | x<i)。结果,期望的(次优)位数是交叉熵:
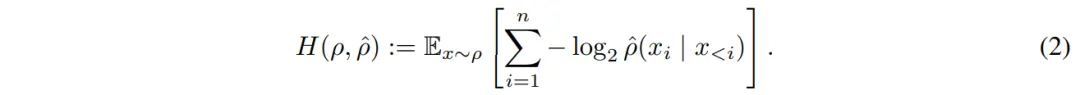
在这里插入图片描述

因此,我们可以通过最小化与某些 ρˆ 相关的交叉熵来最小化编码数据流的期望长度,这相当于似然最大化(MacKay, 2003)。然而,公式(2)正是用于训练当前基础模型的目标,即,对数损失。因此,最小化对数损失相当于最小化作为无损压缩器使用算术编码的该模型的压缩率,即,当前的语言模型训练协议使用最大压缩目标。

基于压缩的序列预测:类似于如何使用预测分布进行无损压缩(通过算术编码,如上所述),任何压缩器都可用于序列预测(Frank et al., 2000)。主要思想是将 ρ(x1:n) 定义为编码分布 2^(-ℓc(·)),其中 ℓc(x1:n) 是使用压缩器 c(例如 gzip)编码序列 x1:n 的长度。因此,我们通过计算 2^(ℓc(x<i) - ℓc(x<ixi)) 来恢复条件分布 ρ(xi | x<i),对所有的 xi 都这样做。

通用编码:在信息论中,我们通常考虑如何最优地压缩数据,即找到一种编码方法,使得数据的平均编码长度尽可能短。对于一个固定的分布ρ,我们可以设计一种最优编码(如算术编码)。但是,如果我们不知道数据的分布,或者数据可能来自多种不同的分布,我们就需要一种“通用”的编码方法,它对所有可能的数据分布都是最优的。

Kolmogorov复杂度是一个序列的最短描述的长度。它是一种理论上的度量,表示对序列进行编码的最短可能长度。如果我们能够根据Kolmogorov复杂度来编码数据,那么我们就能实现通用编码。

最优压缩等同于最优预测,这是因为,如果我们能够预测序列的下一个元素,那么我们就可以为它分配一个更短的编码,从而减少整体的编码长度。反之,如果我们能够最优地压缩一个序列,那么我们也必须在某种程度上预测了序列的结构,因为这样才能减少编码长度。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

人工智能和计算机视觉领域国际学术会议submission 人工智能和计算机视觉领域国际学术会议submission参考。 阅读详情

相关推荐

Vitis开发环境下的双核ARM通信:Hello World背后的AMP架构解析

本文深入解析了Vitis开发环境下ZYNQ双核ARM Cortex-A9处理器的AMP架构与通信机制。通过详细的硬件配置、内存分配和核间通信实现步骤,展示了如何构建高效的双核Hello World系统,为嵌入式系统开发者提供了实用的开发指南和性能优化技巧。

weixin_29162439的博客 217

人工智能顶会ICLR 2024热门研究方向大揭秘

本文可视化分析了人工智能顶会ICLR 2024的研究热点,归纳和总结了十大热门研究方向,可以为读者追踪人工智能的研究热点提供一些有价值的参考。

audyxiao001的博客 1万+

【同花顺公式编辑教程】第4章 功能函数

本章节主要给出大部分能够运行且常用的同花顺指标编辑器提供的函数。其中,计算类函数不作演示,绘图类函数提供示例及示例运行结果。

LiaoYi2016218的博客 2万+

ICLR 2026 史上最严新规!

若是把论文内容输入LLM的过程中,泄露了机密信息,就违背了准则,后果非常严重——审稿人提交的所有稿件被直接拒稿。如果在投稿中,包含此类提示词注入,并因此生成了一篇正面的LLM审稿意见,ICLR组委会将其视为一种「合谋行为」。还有一些作者,恰恰抓住了审稿人用LLM参审的机会,便在论文中「注入好评指令」,让AI不能打低分。这意味着,审稿人借用LLM审稿,更加常见。另一方面,作者注入提示这一行为,意在操控评审,本身就是一种合谋的企图,同样违反《伦理准则》。也就是说,不论是写稿的,还是审稿的,用了AI一定要明示。

阿木寺的博客 3323

北京理工大学计算机学院赵曜,中国进出口银行2016年度拟接收毕业生情况公示...

《中国进出口银行2016年度拟接收毕业生情况公示》由会员分享,可在线阅读,更多相关《中国进出口银行2016年度拟接收毕业生情况公示(5页珍藏版)》请在技术文库上搜索。1、二级(三级)单位二级(三级)单位姓名姓名性别性别学历学历毕业学校毕业学校专业专业 中国进出口银行总行 机关 许凯男硕士研究生北京大学法学 中国进出口银行总行 机关 冯晨男硕士研究生北京大学教育技术学 中国进出口银行总行 机关 刘鹏...

weixin_42168902的博客 4273

拼多多笔试真题-多多送快递(C++/Py/Java /Js/Go)

拼多多技术岗笔试 8月2号真题,拼多多笔试第三题【多多送快递】,提供详细思路讲解以及Java、C++、Python、Go、JavaScript多语言代码实现。拼多多笔试真题【多多送快递】多语言题解。

qq_45776114的博客 291

ICLR 2024论文审稿结果出炉!7000+高产论文创新纪录,扩散模型占比最高

来源| 新智源 ID |AI-eraICLR 2024审稿结果公布了!ICLR是机器学习领域重要的学术会议之一,每年举办一次。2024年是第十二届,将在奥地利维也纳5月7日-11日召开。根据OpenReview官方放出的结果显示,今年共有7135篇投稿论文。此外,另有国内开发者魏国强自己爬虫做了完整的统计数据,论文投稿有7215篇,平均分为4.88。https://guoqiangwei.x...

fengdu78的博客 3619

微信小程序启用蓝牙设备特征值变化时的notify功能

注意:这里的serviceUUID、notifyCharacteristicUUID 我会在后面写入数据时做重点说明。isNotifyBLECharacteristic:false, //是否启用蓝牙设备服务特征 notify。二、启用蓝牙设备特征值变化时的notify功能。下一篇 将继续介绍 微信小程序蓝牙设备写入数据。

wsk198726的专栏 1171

【论文解读】ICLR 满分论文,ControlNet 作者新作:Imposing Consistent Light Transport

国际学习表征会议(简称:ICLR),是深度学习领域的顶级会议,顶中顶。最近 ICLR 2025 正在陆陆续续评分中,本次评议阶段真的是热闹啊,状况连连,官方没办法都将评审过程延长了一周。前些天有低分作者硬刚了审稿人,rebuttal 结果还相当成功,平均分提高 2 分,一举跃升为 top9 论文。,这篇论文很多朋友应该不陌生,出来 ControlNet 作者张吕敏之手,并且这款新的 IC-Light 模型已经可以在 SD 和 Flux 中进行使用了。

战场小包的博客 5351

Open3D KD-tree的使用【2025最新版】

Open3d使用FLANN构建KDTree以便进行快速最近邻检索。博客长期更新,本文最近一次更新时间为:2025年1月1日,代码已同步更新至Open3D 0.18.0版本。

点云侠的博客 40万+

华为OD机试真题 2026-9-2【查找幸运数】

华为OD机试真题 新系统【查找幸运数】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。华为OD机试真题 【查找幸运数】多语言题解。

qq_45776114的博客 496

ICLR:人工智能领域的顶级学术会议

本文深入解析了人工智能领域的顶级学术会议——ICLR(International Conference on Learning Representations),并探讨了顶会论文与SCI期刊的异同。通过详实的内容和清晰的对比表格,你将了解ICLR的独特魅力,包括其创新性的Open Review评审机制、创办背景以及在学术界的影响力。同时,文章还为你梳理了热门顶会推荐及投稿建议,帮助科研人员更好地选择适合自己的成果展示平台。无论你是初入科研领域的小白,还是希望深入了解学术会议的专业人士,本文都将为你提供实用的

我是Xtaiyang,我的学习不止于自己掌握,更在于与你一起前行。所以我把笔记公开,把心得共享,只为构建一个自由学习的空间 。这里没有“我的”,只有“我们的”。 1万+

双像素传感器的AI计算摄影实战:单目深度估计与图像去模糊的融合创新

本文介绍了双像素传感器技术在计算机视觉中的应用,包括深度估计、图像去模糊和图像重建等任务。双像素传感器通过两个子单元捕捉视差信息,使摄像头能够分析场景的三维结构和运动轨迹。文章以图像去模糊为例,详细展示了从数据准备到模型训练的完整流程,包括构建自定义数据集、设计双像素特征提取模块、训练去模糊模型及推理测试。通过模拟双像素的"双视角"信息融合,该AI算法能有效恢复模糊图像的清晰细节。

know_F0727的博客 255

深度学习&机器学习&人工智能--常见、顶级会议介绍

深度学习&机器学习&人工智能–常见、顶级会议介绍 ICLR全称为“International Conference on Learning Representations”(国际学习表征会议)。 ICLR被认为是“深度学习的顶级会议”。 会议由位列深度学习三大巨头之二的Yoshua Bengio和Yann LeCun牵头创办; NIPS(NeurIPS),全称神经信息处理系统大会(Conference and Workshop on Neural Information Processin

Andrehao的博客 7318

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

【学术渣解惑】ICLR是个什么样的会议?

ICLR 简介 ICLR,全称为「International Conference on Learning Representations」(国际学习表征会议),2013 年开始每年举办一次,2020年将举办第八届会议,该会议已经得到学术研究者们的广泛认可,被认为是深度学习领域的顶级会议,虽然成立时间不长,但是与AAAI、CVPR、ACL 及 NIPS 等老牌学术会议一样,被 CCF 评选为一类会...

weixin_43090631的博客 4万+

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

全球顶尖AI学者在关注什么?ICLR 2025 研究热点解析!

本文回顾了此次会议的研究热点,希望能为读者提供人工智能领域最前沿研究方向的参考和启发。

audyxiao001的博客 3742

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

ICLR 2025 首个满分论文!ControlNet作者可能再获一个Best Paper!

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【Mamba/多模态/扩散】交流群添加微信号:CVer2233,小助手会拉你进群!扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文/搞科研/涨薪,强烈推荐!转载自:PaperWeeklyIC-Light论文的分数从均分9分(8/8/10/10...

阿木寺的博客 3042

AI/DM相关conference ddl(更新中)

【**】ICML 2022International Conference on Machine LearningKDD 2022KNOWLEDGE DISCOVERYAND DATA MININGCIKM 2022The Conference on Information and Knowledge ManagementAbstract Deadline: 12 May 2022Papers Notifications:1 August 2022 Oct 17-22, 2022,Atlanta, Geor

qq_40206371的博客 2513

为何ICLR未能进入CCF推荐期刊会议列表?

1、CCF推荐列表的评审标准:CCF作为中国计算机领域的权威学术组织,CCF推荐的期刊和会议列表是基于一系列的评审标准制定的,这些标准可能包括会议的影响力、录用率、历史和传统、以及学术界的认可度等。这可能是ICLR未被收录的原因之一。ICLR作为一个较新的会议,可能还没有经过完整的评选和评估程序,或是评审过程可能受到多种因素的影响,包括专家的推荐、会议表现的波动等。CCF推荐的列表旨在覆盖计算机科学的各个领域,可能在某个版本中,由于多样性和平衡性的考虑,某些会议可能暂时未被包括在内。

ConferenceEye的博客 9646

ICLR 2026 惊现 SAM 3,匿名提交,实现“概念分割”,CV领域再迎颠覆性突破?

有评论者犀利地指出,根据文本描述分割物体的任务,在学术界早已有之,并被广泛称为 “指代分割”。因此,他们认为SAM 3更像是给一个已有的研究领域换上了“Promptable Concept Segmentation”这个新名字,并利用Meta的工程和数据优势进行了大规模包装和实现,其核心思想并非从零开始的颠覆。对SAM系列熟悉的朋友应该知道,前两个版本 SAM 与 SAM 2 均由 Meta 推出,对于 SAM 3 大家也是纷纷猜测,这篇论文出自 Meta,毕竟文风和 Meta 以前发布的论文非常相似。

Coovally_AI的博客 1368

ICLR 2024爆火!杰出论文出炉!

然后通过仔细编排沿不同轴的丰富数据,本文表明 UniSim 可以成功地合并不同轴数据的经验并泛化到数据之外,通过对静态场景和对象的细粒度运动控制来实现丰富的交互。作者提出了这种现象发生的关键假设,并提供了一个简单而优雅的解决方案,使用额外的 register tokens 来解决这些痕迹,从而增强了模型在各种任务上的性能。,是朝着这个方向迈出的重要一步,也是一项工程壮举,它利用了基于视觉感知和控制的文本描述的统一接口来聚合数据,并通过利用视觉和语言领域的最新发展来训练机器人模拟器。

Angelina_Jolie的博客 1788

分析近三年ICLR会议投稿记录,我发现......

从三年标题词云结果可以看出,三年来,reinforcement_learning始终保持器热门的位置,24和25年large_language_models、diffusion_models出现次数开始领先reinforcement_learning,这也是这两年最火的两个方向。论文发表量前五机构Google、tsinghua_university、zhejiang_university、massachusetts_institute_of_technology、peking_university。

helloaiti的博客 2885

新加坡见!快手11篇论文入选人工智能领域顶会ICLR 2025

快手11篇论文入选人工智能领域顶会ICLR 2025

kuaishoutech的博客 1863

ICLR 2024接收率31%,清华LCM论文作者:讲个笑话,被拒了

关注公众号,发现CV技术之美本文转自机器之心,有修改。你被接收了吗?ICLR 2024 国际学习表征会议已经来到了第十二届,将于今年 5 月 7 日 - 11 日在奥地利维也纳会展中心举行。在机器学习社区中,ICLR 是较为「年轻」的学术顶会,它由深度学习巨头、图灵奖获得者 Yoshua Bengio 和 Yann LeCun 牵头举办,2013 年才举办了第一届。不过 ICLR 很快获得学术研究...

我爱计算机视觉 670

ICLR 惊现满分论文,ControlNet 作者新作,Github 5.8k 颗星

来源:机器之心四个 10 分!罕见的一幕出现了。您正在收看的,不是中国梦之队的跳水比赛,而是 ICLR 2025 的评审现场。虽说满分论文不是前无古人,后无来者,但放在平均分才 4.76 的 ICLR,怎么不算是相当炸裂的存在呢。https://papercopilot.com/statistics/iclr-statistics/iclr-2025-statistics/这篇征服了列位审稿人的...

weixin_40920183的博客 557

人工智能顶会巡礼:NeurIPS, ICML, ICLR 的风格差异与投稿选择

本文对人工智能领域三大顶级学术会议——NeurIPS、ICML和ICLR——进行系统性巡礼与深度对比。文章超越简单的投稿数据罗列,深入剖析了三大会议因历史渊源与社区文化而形成的独特“气质”:NeurIPS作为规模宏大的“年度盛会”,其广度与影响力无出其右;ICML作为历史最悠久的“经典旗舰”,对理论与算法的严谨性有着执着追求;ICLR作为后起之秀的“开放先锋”,以前沿、开放和实验驱动的风格引领潮流。通过比较它们在理论深度、应用导向、开放性偏好和评审文化等方面的核心差异,并结合大模型时代的新趋势,本文为研究者

AladdinEdu,你的AI学习实践工作坊。让想法落地,让研究加速。助力高校AI人才成长,点亮创新未来。 5098
上一篇: 数字孪生与AI大模型的融合基础:技术、数据与算法的协同
下一篇: OpenAI科学家震惊TED大会:让AI模型多思考20秒,提升10万倍性能!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2826原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值