Nature Med | ChatGPT赋能疾病护理,大模型将如何变革医疗行业?

【Nature medicine】Integrated image-based deep learning and language models for primary diabetes care 由于训练有素的初级保健医生(PCP)短缺,尤其是在资源匮乏的环境中,初级糖尿病护理和糖尿病视网膜病变(DR)筛查仍然是主要的公共卫生挑战。在此,为了弥合这一差距,我们开发了一个集成图像和语言的系统(DeepDR-LLM),结合了大型语言模型(LLM模块)和基于图像的深度学习(DeepDR-Transformer),为PCP提供个性化的糖尿病管理建议。在回顾性评估中,LLM模块在英语测试中表现出与PCP和内分泌科住院医师相当的表现,并且在中文测试中表现优于PCP,且与内分泌科住院医师表现相当。 阅读详情

近日发表在Nature Medicine的文章《Integrated image-based deep learning and language models for primary diabetes care》针对糖尿病护理和视网膜病变筛查问题,结合类ChatGPT的语言大模型和基于眼底影像的图像模型提出一种综合性解决方案DeepDR-LLM。本文将对该方案进行解读,希望能够为各位读者的研究提供思路。

引言

糖尿病在全球范围内影响着超过5亿人,其中80%生活在中低收入国家。视网膜病变是糖尿病患者中最常见的并发症,影响着30%到40%的糖尿病患者,是劳动年龄段成人失明的主要原因,定期进行视网膜病变筛查是糖尿病护理的重要组成部分。由于中低收入国家基础设施和人力资源的不足,视网膜病变筛查往往被忽视,这导致了严重的健康后果和广泛的社会经济影响。

近年来出现了多种新技术用于解决糖尿病护理面临的困境,包括远程医疗、基于人工智能的血糖监测、基于视网膜图像的深度学习模型以及低成本便携式视网膜相机。然而,这些方案通常只专注于某一方面的改进,无法全面整合糖尿病护理的需求。此外,这些技术依赖于训练有素的基层医生,而在资源匮乏的地区合格的基层医生数量无疑是远远满足不了需求的。近期语言大模型的迅速发展为解决上述问题带来了新的希望。语言大模型具备自然语言理解和生成能力,能够优化患者监测、个性化治疗方案,进而改善糖尿病和视网膜疾病患者的健康状况。本文介绍的这篇论文结合语言大模型的进展和影像方面人工智能技术的积累,针对糖尿病护理工作提出一种综合性解决方案DeepDR-LLM。

DeepDR-LLM

DeepDR-LLM由语言大模型模块和DeepDR-Transformer和两个模块组成,语言大模型模块基于开源的LLAMA模型(LLAMA和ChatGPT类似,可以视作开源版本的ChatGPT)进行微调,为糖尿病患者提供个性化的护理建议。DeepDR-Transformer基于Vision Transformer架构实现,对眼底图像进行病变分割和病变分级。
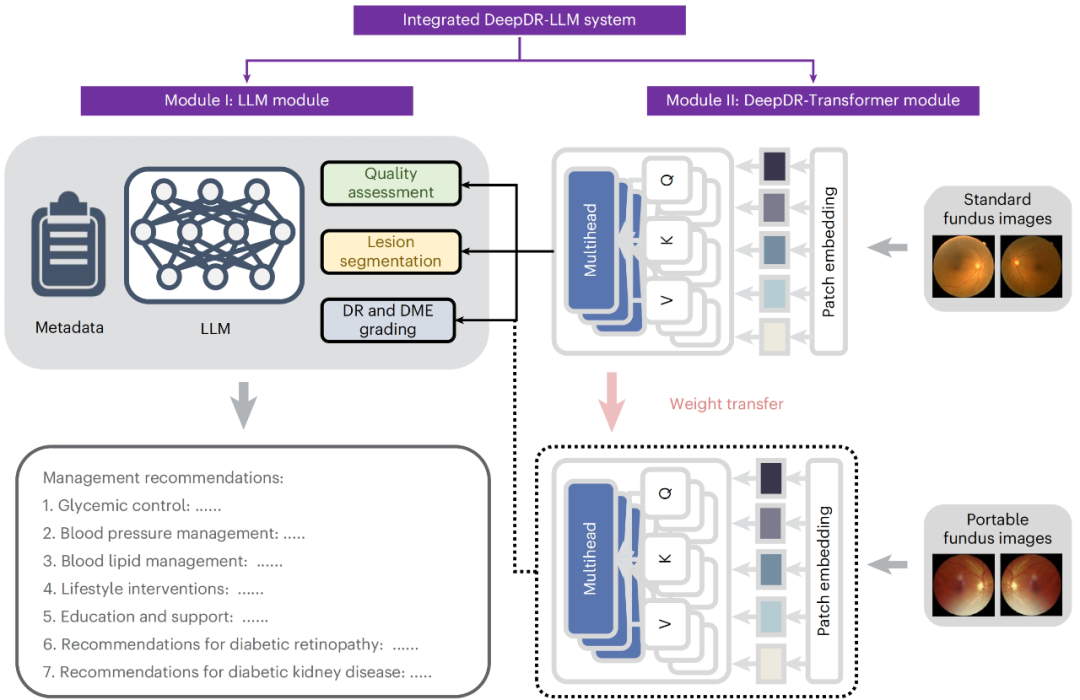
语言大模型模块旨在根据病史、体检、实验室检查以及病变分级等各种临床数据制定糖尿病护理建议。语言大模型模块基于Meta开发的语言大模型LLAMA,类似于ChatGPT,LLaMA能够处理文本生成、翻译、问答和总结等多种任务,并在多个基准测试中表现出色。由于缺乏特定领域的专业知识,直接将LLAMA用于生成糖尿病护理建议这一任务并不能取得较好的效果。该研究利用上海第六人民医院和华东疗养院267730名参与者的数据,通过LoRA对LLaMA-7B进行微调,使语言大模型具备较佳的糖尿病护理建议生成能力。
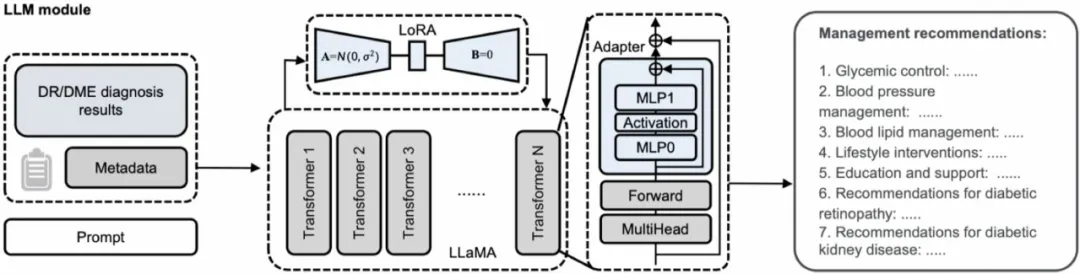
在这里插入图片描述

DeepDR-Transformer模块旨在分析眼底图像以预测糖尿病视网膜病变。DeepDR-Transformer基于Vision Transformer架构,由ImageNet的预训练权重初始化,并在该研究团队收集整理的数据集上训练。DeepDR-Transformer包含四个不同的模型分别用于完成图像质量评估(是否可读)、视网膜病变分级、黄斑水肿分类(有、无)以及病变分割(微动脉瘤、出血、棉絮斑和硬性渗出物)。
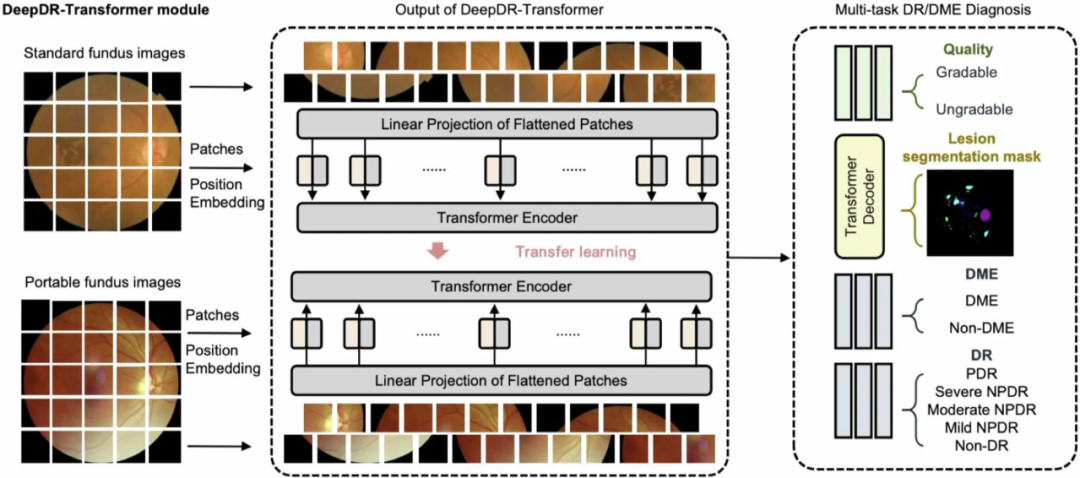
通过将DeepDR-Transformer模块生成的结果按照固定的模板,例如“视网膜病变等级:0(无DR);黄斑水肿等级:0(无DME)”,即可和其它临床数据一起作为提示词输入语言大模型模块,进而生成糖尿病护理建议。

效果分析

该研究通过回顾性实验和前瞻性研究对语言大模型模块、DeepDR-Transformer以及DeepDR-LLM进行评估分析。
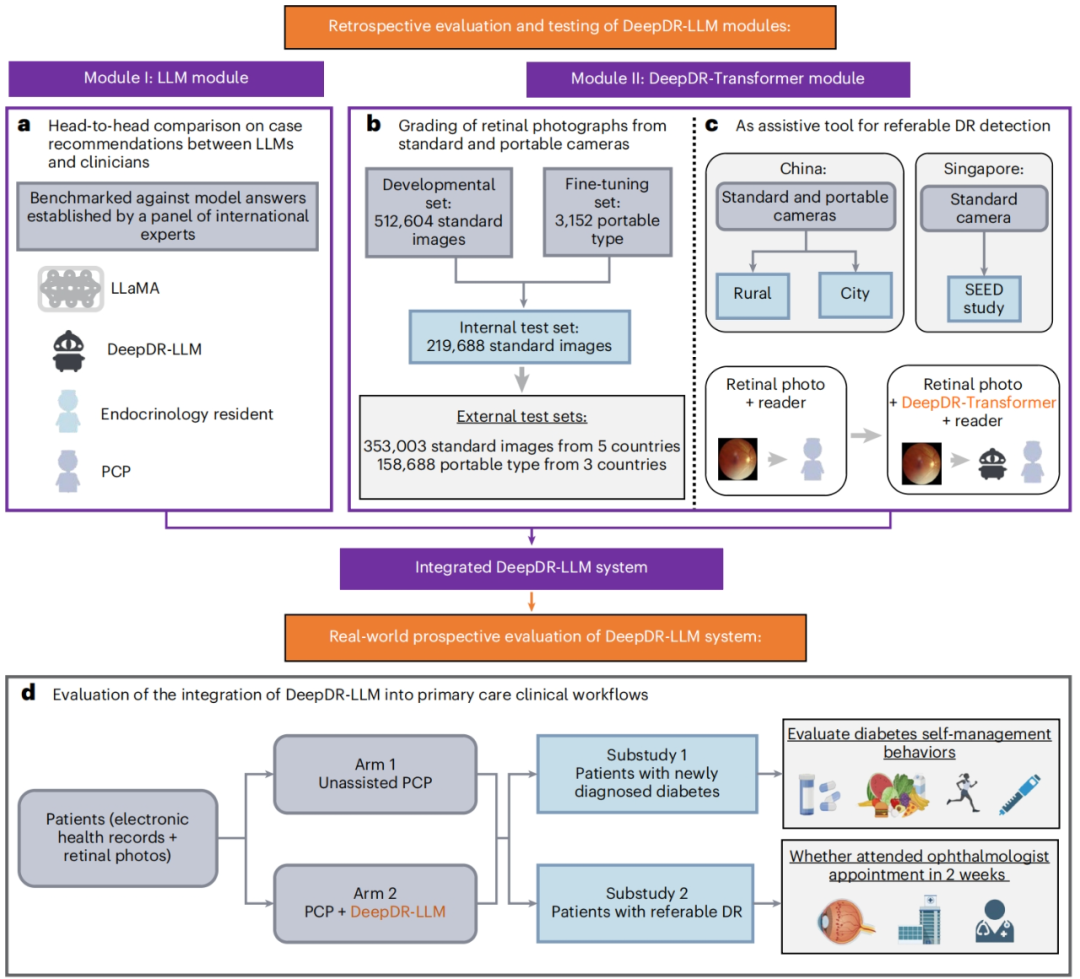
语言大模型模块的评估基于三个方面:不适当内容的程度、缺失内容的程度和可能的伤害风险。结果显示,在英语上下文条件下,71%的DeepDR-LLM建议被认为是适当的,高于LLaMA(51%),与基层医生(71%)相当;36%的DeepDR-LLM建议没有缺失内容,高于基层医生(27%);57%的DeepDR-LLM建议被评为“低可能性”伤害风险,与基层医生(55%)相当。在中文上下文条件下,77%的DeepDR-LLM建议没有不适当内容,高于LLaMA(66%)和基层医生(54%)。此外,63%的DeepDR-LLM建议没有缺失内容,高于基层医生(46%)。88%的DeepDR-LLM建议被评为“低可能性”伤害风险,而基层医生为60%。

DeepDR-Transformer模块在14个标准眼底影像数据集和7个便携式眼底影像数据集中进行了评估。评估结果显示,该模型在检测视网膜病变方面表现出色。对标准眼底影像而言,在12个外部测试集中模型的AUC值的取值范围为0.892到0.933。对便携式眼底影像而言,在6个外部测试集中模型的AUC值取值范围为0.896到0.920。

DeepDR-LLM通过一个前瞻性研究进行评估。评估结果显示,基层医生+DeepDR-LLM的建议在质量和同理心方面均优于单独的基层医生或DeepDR-LLM,且基层医生对DeepDR-LLM系统的理解性、节省时间、有效性和安全性评价较高。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

如何解决 ChatGPT 在科研学术写作中“不说人话”? 短视频真正改变的,是知识抵达人的方式。真正该改的是信息顺序:先给结论,再讲原因和证据,最后补充必要的边界,边界在这里是护栏,不该挡在正文前面。读者还没质疑,例外和边界已经先摆好了,不敢把话说透,真正好的文章会先把核心判断稳稳立住,再补充复杂性,不会让读者猜半天你到底想说什么。观点还没展开,就先回应并不存在的反对意见,大量篇幅都在证明我没这么说,不过度防御的文章都是前者忙着管理风险,后者才是在推进认识。逐句查看文章中的转折、退让和补充说明,追问一句,如果拿掉这句话,事实是否仍然准确,推理是否依然成立。 阅读详情

相关推荐

Bright Data ChatGPT 搜索抓取器(Python)

使用 GitHub 登录,然后 fork 该仓库开始进行更改。本项目提供一个使用 Bright Data Web Scraper API 抓取结果的简易 Python 样板代码。

亮数据 Bright Data 的博客 327

上海交通大学:关于使用深度学习模型配合大语言模型对糖尿病的诊断和治疗进行辅助的验证

本次我们分享了一篇发表在Nature子刊 Nature Medicine(IF = 58.7)上的一篇文章《Integrated image-based deep learning and language models for primary diabetes care》。文章向我们展示了研究者如何使用深度学习模型配合大语言模型成功的提高了欠发达地区对糖尿病的诊断和治疗能力,为欠发达地区预防和治疗糖尿病做出了很大的贡献。文章亮点本次实验首次使用深度学习模型成功的做到了对早期糖尿病的准确判断。

m0_59164304的博客 2134

Windows域账户无管理员权限也能装软件?3步搞定UAC设置(附安全提醒)

本文探讨了在Windows域环境中,如何通过配置用户账户控制(UAC)实现临时提权,让无管理员权限的域账户也能安装软件。文章详细介绍了三步走策略:临时加入本地管理员组、调整UAC行为以及至关重要的权限回收,并提供了脚本化部署方案与安全实践指南,旨在平衡企业IT管理的效率与安全。

fox11的博客 759

Nature Medicine:基于图像的深度学习和语言模型用于原发性糖尿病护理

为了解决糖尿病护理中存在的差距,我们开发了一种创新的系统DeepDR-LLM,它将一个LLM模块和一个基于图像的DL模块结合在一起,提供全面的初级糖尿病护理和DR筛查方法。糖尿病视网膜病变(DR)是最常见的糖尿病特定并发症,影响30-40%的患有糖尿病的人群11,12,13,并且仍然是经济活跃、工作年龄成人失明的主要原因11,14,15。然而,在低资源环境下,由于基础设施、人力资源和可持续性具有成本效益的DR筛查计划匮乏,往往忽视了DR筛查在低收入国家中不足之处。

u014546828的博客 1522

DeepSeek-OCR又更新:一起看下OCR1和OCR2

DeepSeek-AI 最近又又开源了,这次是DeepSeek-OCR2,结合之前发布的DeepSeek-OCR ,可以发现DeepSeek走出了一条不同于主流 OCR 方案的技术路线。第一代模型探索了**“视觉作为文本压缩介质”的可行性,打破了传统的序列长度限制;第二代模型则通过“Visual Causal Flow(视觉因果流)”**架构,将因果推理引入视觉编码器,解决了复杂排版下的阅读顺序难题。本文将从架构设计、逻辑结构、训练范式及工程实现四个维度,深度剖析这两代模型的异同与创新。

kakaZhui的博客 623

7.7 数据分析助手:用AI洞察业务数据价值

摘要:AI数据分析助手构建指南 本文介绍了如何构建AI数据分析助手,帮助企业从业务数据中提取价值。系统包含四大核心模块:自然语言理解模块解析用户查询意图,查询规划模块转换为SQL语句,数据可视化模块生成图表,以及洞察生成模块提供深度分析。文章通过销售数据分析助手案例,展示了从数据库准备到自然语言处理的完整实现流程,包括示例代码和系统架构图。该解决方案可降低数据分析门槛,让业务人员直接参与数据探索,提升决策效率。

yonggeit的博客 4092

大模型及其在医疗中的应用(二)

大模型及其在医疗领域的应用研究

qq_30066733的博客 1512

Unity 数字孪生笔记1 工具介绍

前言 工欲善其事必先利其器 流程思考 数字孪生本质上一种基于实际物理数据的可视化方案,通过对接实际数据,在三维界面中展示孪生结果。 那么这个流程就很简单了。 整个流程分为三块:数据来源-》数据分析-》数据展示 输入数据 首先我们需要考虑我们能拿到什么。第一,实际物体的三维数据从哪里来,第二,实际数据怎么获取到。 模型数据 工业上常常会用到CAD模型,CAD模型具有精确、统一的特点,但是CAD不是三角面片,我们不能直接导出到Unity中,而且导入之后有很多不合理的地方,例如面片杂乱、面数过高等问题。针对这个

Thissky的专栏 1万+

2024年新发布的37个医疗大模型汇总,辅助诊断与决策领域数量达到了13个!|行业动态·25-01-05

除了哪些单位发布了大模型以外,我们还需要了解。

罗小罗同学的博客 3003

【鸿蒙游戏上架审核规范指南】

华为鸿蒙游戏上架审核规范指南摘要

weixin_44161102的博客 919

51单片机超声波测距数码管显示并报警(Proteus 仿真)

HC-SR04超声波 实物图 使用方法 1、给TRIG端口至少10us 的高电平信号 2、模块自动发送 8 个 40khz 的方波,自动检测是否有信号返回 3、有信号返回,ECHO端口会输出一个高电平,高电平持续的时间就是超声波从发射到返回的时间 计算的话这里就不考虑温度的影响直接用声速340m/s Proteus仿真 HC-SR04可以用Proteus中的SRF04代替 下面附上代码 ...

m0_46254883的博客 1万+

重磅!NAT MED丨上海交通大学携手清华大学与新加坡国立大学研制国际首个糖尿病诊疗多模态大模型DeepDR-LLM

针对当前的技术空白和临床的实际需求,**本研究成功研发了全球首个面向糖尿病基层诊疗的视觉-大语言模型多模态集成智能系统DeepDR-LLM。

python1234567_的博客 1323

USB驱动(URB)

本文介绍了Linux内核中USB驱动开发的核心概念URB(USB Request Block)。URB是主机与USB设备间传输数据的抽象结构体,包含目标设备、端点信息、数据缓冲区等关键字段。文章详细解析了URB的生命周期(分配、填充、提交、回调、释放)、四种传输类型(控制、批量、中断、等时)及其应用场景,并提供了鼠标设备的中断传输示例代码。最后强调了URB使用注意事项,包括DMA缓冲区分配、错误处理和资源释放等。URB作为USB驱动与内核通信的桥梁,是构建稳定USB驱动程序的基础。

m0_49476241的博客 915

常见的 OCT 眼底疾病数据集(OCT2017、Eye OCT Datasets、OCTDL、RetinalOCT_Dataset-C8、RETOUCH和OCTA-500)

本文旨在介绍几个常用的OCT数据集,包括OCT2017、Eye OCT Datasets、OCTDL、RetinalOCT_Dataset-C8、RETOUCH和OCTA-500,分析它们的特点、用途和适用场景,为研究人员在选择合适的数据集时提供参考。:该数据集包含500只眼睛的OCT和OCTA两种模态的三维数据,六种投影图像,四种文本标签(年龄、性别、左右眼、疾病类型)以及两种分割标签(视网膜大血管、无血管区)。:数据来自真实临床场景,分辨率高,适合精细病变分割任务,但样本量较小,需结合数据增强技术。

weixin_43518285的博客 5024

OpenClaw使用ClawHub安装skill网络不稳定?Rate limit exceeded报错?试试这个国内高速镜像工具!

使用 ClawHub 安装 Skill 时遇到 🌐 网络不稳、❌ Rate limit 或命令不可用?使用这个镜像工具,轻松解决skill安装问题,⚡

XiaoqiangClub的博客 1260

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

在AI时代看清糖网:糖尿病视网膜病变筛查的转型之路

人工智能技术在糖尿病视网膜病变筛查中的研究与应用进展 糖尿病视网膜病变(DR)是全球糖尿病患者最常见的致盲并发症。随着深度学习技术的发展,基于卷积神经网络的AI模型在DR筛查中展现出90%以上的敏感性和特异性,部分系统已获临床应用许可。目前研究聚焦于解决三大挑战:算法泛化性不足、黑箱决策问题以及临床标准化差异。未来发展方向包括:结合远程医疗和手持设备提升筛查可及性,开发多病种联合检测系统,以及增强模型可解释性。值得注意的是,OCT技术对DME检测的准确性比传统方法提高42.1%,而风险分层筛查策略可减少40

是纯一的博客 1452

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

ChatGPT 广告技术栈架构拆解:多轮意图、LLM 工具编排、ANN 召回与拍卖闭环

基于 OpenAI 官方工程文章,拆解 ChatGPT 广告系统如何用有状态会话理解多轮意图,以独立链路隔离自然回答,再由 LLM 编排召回、过滤、相关性评分、拍卖和最终交付,并给出可复用的超时、观测、安全与反馈闭环设计。

jerry764的博客 375

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

ChatGPT Projects 使用教程:项目指令、文件管理与上下文复用

使用ChatGPT的Projects功能可高效处理长期任务,避免重复说明背景与要求。通过设置项目指令、上传参考文件、复用上下文,实现代码分析、文档维护等任务的持续优化。建议按任务类型建项目,配置简洁规则,重要结论存为独立文档,避免依赖记忆遗漏。适用于有固定流程、需多资料协作的场景,但不可替代Git版本管理。

carriedream的博客 289

《C++ 项目:手写大模型接入 SDK》ChatGPT接口设计(下):流式响应实现和测试

本文详细实现了ChatGPT ResponsesAPI的流式响应接口,重点解析了SSE半包缓冲处理的必要性及多事件类型(如response.output_text.delta、error等)的差异化处理逻辑。针对200状态码不等于调用成功的坑点,通过content_receiver回调捕获业务异常。基于抽象基类LLMProvider,仅需修改20%适配代码,即可完成新模型接入,验证了SDK架构的高扩展性与可维护性。

2501_91275995的博客 659

ChatGPT、Codex工程实战:数据库迁移脚本开发环境测试通过,为什么生产上线仍可能锁表甚至丢数据?

ChatGPT、Codex生成的数据库迁移脚本开发环境测试通过,为什么生产上线仍可能锁表甚至造成数据不一致?本文从Java订单系统生产变更切入,分析MySQL DDL、元数据锁、大批量数据回填、新旧版本兼容和数据迁移风险,并介绍Expand-Contract分阶段迁移方案。

lb654509656的博客 314

姿势库 / 服装库 / 人像库一键填充到 ChatGPT、Gemini、豆包(无需 API Key,附安装教程)

一个用户脚本,在 ChatGPT、Gemini、Grok、豆包、通义千问、腾讯元宝、Kimi、即梦等页面里嵌入「参考库」面板,把姿势、服装、人像参考图和规范化提示词一键填入对话框。版权说明:脸库 CC0;姿势库、服装库禁止二次分发。脚本不含本地图片,只在运行时读取公开地址。

yjc_1111的专栏 227

ChatGPT Images 2.6 实测解读:一句话直出 GIF,Flare 提速 46%,API 支持 2~64 帧动图

过去两年,AI 生图解决了"画得像不像""字写得对不对"的问题,但交付物始终是一张静态图。想让它动起来,通常要另外找视频模型,或者自己拆帧、用 PS、ffmpeg 合成 GIF——对运营、设计、做表情包的人来说,这一步既麻烦又容易翻车:帧之间画风跳变、角色走样、文件体积失控。这次 OpenAI 发布的,把这一步直接收进了生图本身:在对话里说一句"能做成 GIF 吗",返回的就是一张可循环播放的动图,而且生成后还能接着改。按 OpenAI 的说法,这是第一个原生直出 GIF 的主流生图产品。

JEECG官方博客 227

ChatGPT Images 2.6 入门:保存角色参考图并生成循环 GIF

按官方 Images in ChatGPT 说明,介绍在 ChatGPT 中把照片存成角色参考并用 @名字复用,再用提示词或静图生成循环 GIF、打开后调速并保存分享的完整步骤。

死磕音视频 203

ChatGPT Images 2.6 商业落地与场景应用指南

本文聚焦电商与设计团队的视觉生产痛点,提出“人机协同”的AI高效工作流。通过十大实战场景,系统拆解商品图生成、海报自动化、风格一致性控制、提示词工程等关键环节,构建可复制、可量化的视觉生产管线。强调以标准化模板、模块化提示词与人机协作闭环,实现从构思到成图的极速落地,显著提升效率与质量,助力各行业实现视觉内容的智能化升级。

frt的博客 274

QVeris MCP 连接到 ChatGPT:让 AI 调用专业数据

一个远程地址,完成 OAuth 授权,把 QVeris 接进 ChatGPT。本文整理网页版、桌面端配置,并用 AAPL 报价查询验证连接。

QVeris_Friends的博客 205
上一篇: 一个包含15种大模型Agent技巧的项目开源
下一篇: 跟AI大模型实时语音通话解决方案
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值