《封号码罗》python爬虫之140行代码五步法破解字体反爬虫(五)

爬虫学习笔记(二十)—— 字体反爬 文章目录一、什么是字体反爬二、编码原理2.1、ASCII编码对照表2.2、Unicode编号2.3、UTF-8编码方式2.4、字符矢量图三、案例:58同城反爬字体3.1、代码实现 一、什么是字体反爬 网页开发者自己创造一种字体,因为在字体中每个文字都有其代号,那么以后在网页中不会直接显示这个文字的最终的效果,而是显示他的代号,因此即使获取到了网页中的文本内容,也只是获取到文字的代号,而不是文字本身。 简单的说,字体反爬指的就是浏览器页面上的字符和调试窗口或者源码中的内容,显示的不一样,这就是字体反爬。 阅读详情

五步法破解字体反爬虫

由于字体的加载和映射工作都是由css完成的,所以就算是借助来自动化工具也无法获取对应的文字内容
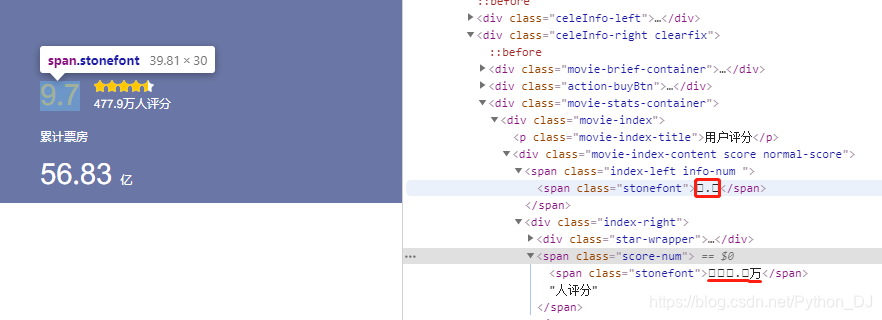
在这里插入图片描述
就是这种情况,它就是字体反爬虫,与之前SVG反爬虫最大的区别就是,它所有的class都是一个值,而且标签的文本也是一个方框来表示的,所以处理起来可能会比较复杂,不要担心,继续跟着我的思路,你会豁然开朗,加油吧!
再来看看网页的源码
在这里插入图片描述
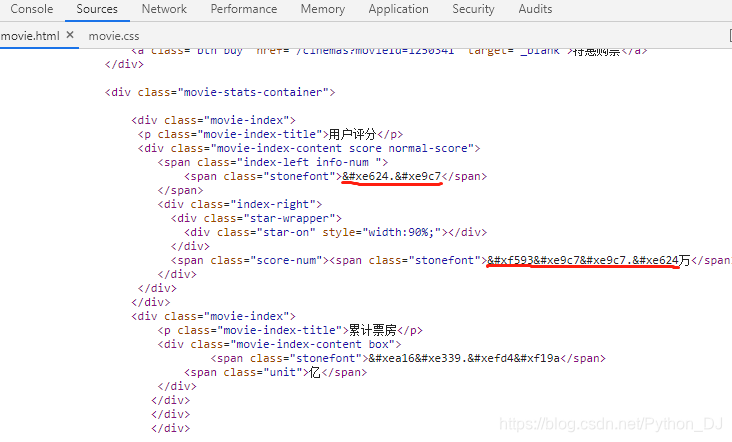
可以看到,在网页源码里面,是不同的类似符号的数据来代表网页的显示数据,例如

"""&#xe624.&#xe9c7代表的就是网页显示的9.7"""

我们可以针对这种映射关系来破解字体反爬,但是,如果网站有多套字体映射,那这个恐怕就不好用了,我们要用Python来实现这种映射算法,这样就算网站更换来其他字体,我们也不用担心爬虫的健壮性
在这里插入图片描述
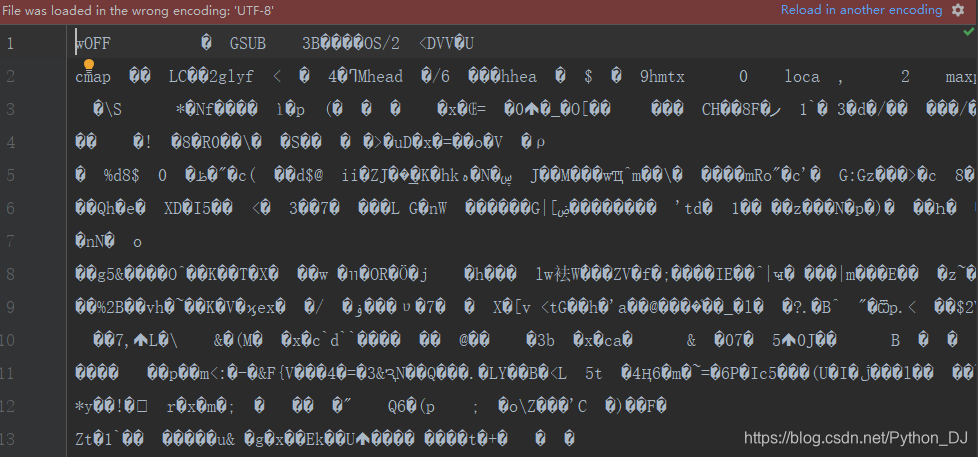
可以看到,网站加载了一个字体文件,那我们把这个文件下载到本地,查看一下它是什么个情况
在这里插入图片描述
显示的是乱码,那是不是就没办法查看了呢,在Python中有一个专门处理字体的库from fontTools.ttLib import TTFont,在字体反爬过程中,我们要反复的使用这个库,如果不熟悉,那就要去问问度娘了,或者跟着我的思路走,我也会讲到一部分项目里面用到的方法,例如:

font = TTFont(r"D:\gcw\learn_crawler\font\movie.woff")  # 打开字体文件
# 保存之后直接注释该代码,不然下面使用会报错,说--没有某某属性
font.saveXML(r"D:\gcw\learn_crawler\font\movie.xml")  # 另存为xml格式

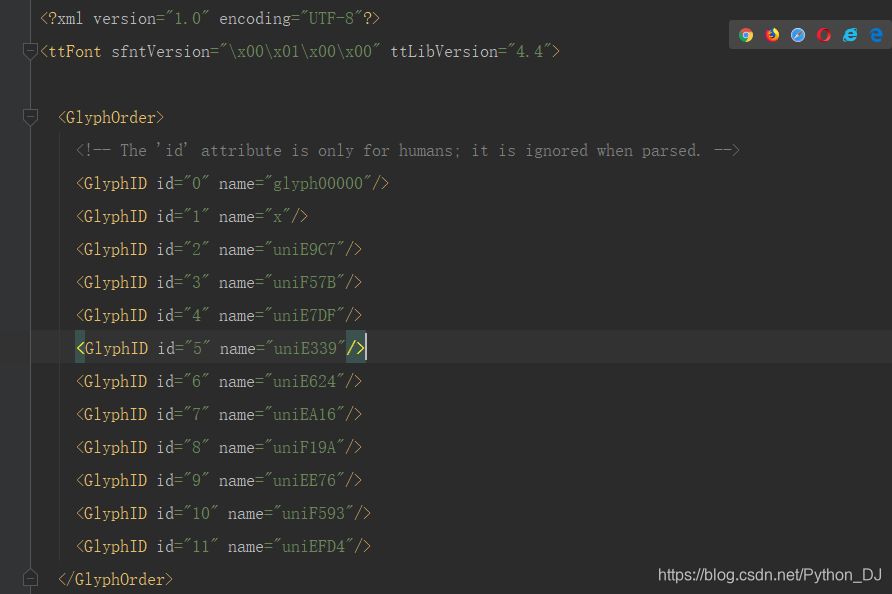
你看到了,现在是XML格式的文件了,那我们来看看XML是个啥样子吧
在这里插入图片描述
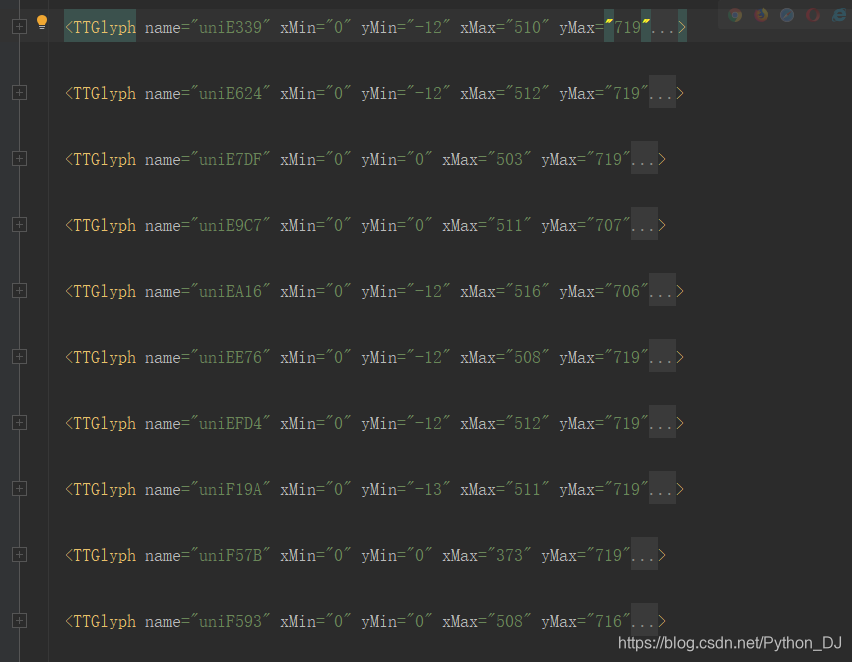
是不是有惊喜,看到了和网页有相同的内容&#xe624.&#xe9c7,这么看来&#x只是和uni替换了而已,在映射的时候我们逆向替换就行了,另外网页都是小写,上图的name值都是大写,这有什么关系呢,一个upper()即可迎刃而解
在这里插入图片描述

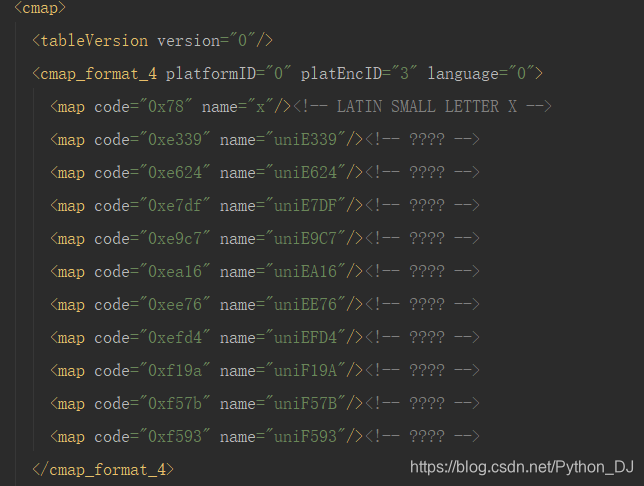
cmap # 就是网页和字体数据的一些映射情况

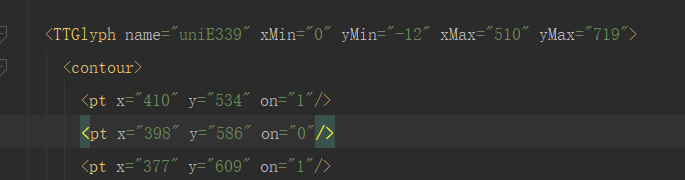
当然cmap属性我们是用来参考的,真正使用的是下面这个数据
在这里插入图片描述
在这里插入图片描述
这个数据包含的是字体的字形数据,字形数据相同,那么这两个字肯定代表的是同一个字,至于推理过程就不在详述,只需要知道这个字形数据才是关键就可以了。
讲完这些之后,你应该会对字体反爬有一些了解了,话不多说,直接上源码,几乎一步一个注释,你想看不懂都难,嗯哼!!!

from fontTools.ttLib import TTFont
import requests
import re
import os
import hashlib
from parsel import Selector
from urllib import parse
import xml.etree.ElementTree as ET

# 第一步 :手动获取网站的字体,粘贴到项目对应目录,以备分析

# 第二步:使用TTFont生成字体文件对象后另存为xml,毕竟下载的直接看是乱码
font = TTFont(r"D:\gcw\learn_crawler\font\movie.woff")  # 打开字体文件
# 保存之后直接注释该代码,不然下面使用会报错,说--没有某某属性
# font.saveXML(r"D:\gcw\learn_crawler\font\movie.xml")  # 另存为xml格式

# 第三步:观察xml数据,这一步尤为重要,很多参数不太重要,只需要知道一点,使用的是字形数据glyf
#       字符              字形名
# <map code="0xe339" name="uniE339"/><!-- ???? -->

# 第四步:根据xml的原始数据,手动给出映射数据
xml_path = os.path.dirname(__file__)
# 读取字体的xml文件
tree = ET.ElementTree(file=xml_path + "/font/movie.xml")
# tree = ET.parse(xml_path + "/font/movie.xml")     # 上下两种方式都可以读取数据
# 简单介绍tree对象的一些方法,如下面的这一行可以获取根元素对象
root = tree.getroot()
# 根元素对象的标签名和属性
# print(root.tag, root.attrib)
# 还有一些其他属性,有需要自行测试使用
# 'append', 'attrib', 'clear', 'extend', 'find', 'findall', 'findtext', 'get',
# 'getchildren', 'getiterator', 'insert', 'items', 'iter', 'iterfind', 'itertext',
# 'keys', 'makeelement', 'remove', 'set', 'tag', 'tail', 'text'
# 先定义两个空白字典,用于存储映射数据,然后遍历元素
s = {"name": "", "value": "0", "hex": ""}  # s并没有使用,只是为来定义数据的格式给的参考
ys = {"name": ""}
# 遍历XML的TTGlyph这个标签,用的是iter这个方法
for elem in tree.iter(tag="TTGlyph"):
    #    标题         属性字典格式      字典键值对
    # print(elem.tag, elem.attrib, elem.attrib["name"])
    if len(elem.attrib["name"]) == 7:
        ys["name"] = elem.attrib["name"]
        # print(ys)
# 注意:为了更好的观测数据,我用打印出来的ys数据,填充到来下面的这个字典,value值是通过网页对比获得
base_font = {
    "font": [{'name': 'uniE339', "value": "6", "hex": ""},
             {'name': 'uniE624', "value": "9", "hex": ""},
             {'name': 'uniE7DF', "value": "2", "hex": ""},
             {'name': 'uniE9C7', "value": "7", "hex": ""},
             {'name': 'uniEA16', "value": "5", "hex": ""},
             {'name': 'uniEE76', "value": "0", "hex": ""},
             {'name': 'uniEFD4', "value": "8", "hex": ""},
             {'name': 'uniF19A', "value": "3", "hex": ""},
             {'name': 'uniF57B', "value": "1", "hex": ""},
             {'name': 'uniF593', "value": "4", "hex": ""}]}
data_list = base_font["font"]
# print( data_list)
# [{'name': 'uniE339', 'value': '6', 'hex': ''}, {'name': 'uniE624', 'value': '9', 'hex': ''},...
# 遍历字典并填充数据
for n in data_list:
    w = n["name"]
    # 需要注释font.saveXML,否则报错没有data属性
    # content得到的是bytes型的数据,而且数据量很长,所以使用哈希md5处理
    content = font["glyf"].glyphs.get(w).data
    glyph = hashlib.md5(content).hexdigest()
    n["hex"] = glyph
# print(base_font["font"])
# [{'name': 'uniE339', 'value': '6', 'hex': '0833d3b4f61f02258217421b4e4bde24'},...
# print(base_font)  # 这个是最终的字典 name是字体文件,value是网页映射值,hex是字形数据
# {'font': [{'name': 'uniE339', 'value': '6', 'hex': '0833d3b4f61f02258217421b4e4bde24'},...

# 第五步:爬取数据自动化,熟悉来前四步,最后一步就是水到渠成
# 请求网页源数据
url = "http://www.porters.vip/confusion/movie.html"
resp = requests.get(url=url)
sel = Selector(resp.text)

# 让程序自动提取页面加载的所有css文件路径
css_path = sel.css("link[rel=stylesheet]::attr(href)").extract()
# print(css_path)
# ['https://cdn.jsdelivr.net/npm/bootstrap@3.3.7/dist/css/bootstrap.min.css', './css/movie.css']

# 遍历获取到的css链接
woffs = []
for c in css_path:
    # 拼接正确的css文件路径
    css_url = parse.urljoin(url, c)
    # print(css_url)
    # https://cdn.jsdelivr.net/npm/bootstrap@3.3.7/dist/css/bootstrap.min.css
    # http://www.porters.vip/confusion/css/movie.css
    # 向css文件发起请求,然后使用正则获取字体文件路径
    css_resp = requests.get(url=css_url)
    # print(css_resp.text)
    # 其中一段数据为:这个正式网页加载的字体文件路径,但是需要用正则表达式把路径找出来
    # @font-face {
    #   font-family: stonefont;
    #        src:url('../font/movie.woff') format('woff');
    # }
    # 匹配css文件中的woff文件路径
    woff_path = re.findall(r"src:url\('..(.*.woff)'\) format\('woff'\);", css_resp.text)
    if woff_path:
        # print(woff_path)  # ['/font/movie.woff']
        # 如果匹配到数据则添加到woffs列表中
        woffs += woff_path  # 结果为['/font/movie.woff']
        # woffs.append(woff_path)  # 结果为[['/font/movie.woff']]
# 拼接字体文件的链接 pop()从列表中删除一个元素并返回该元素
woff_url = "http://www.porters.vip/confusion" + woffs.pop()
# 请求字体文件
woff = requests.get(woff_url)
filename = "target.woff"
# file_path = os.path.dirname(os.path.abspath(__file__))
file_path = os.path.dirname(__file__)
# print(os.path.dirname(__file__))    # D:/gcw/learn_crawler
# print(os.path.abspath(__file__))    # D:\gcw\learn_crawler\字体反爬.py
# print(file_path)    # D:\gcw\learn_crawler
# os.path.abspath(__file__) 获取当前文件所在的路径
# os.path.dirname 当前文件目录名,绝对路径
with open(file_path + "/" + filename, "wb") as f:
    # 将字体文件保存到本地
    f.write(woff.content)
# 使用TTFont库打开刚才下载的文件
font = TTFont(file=file_path + "/" + filename)
# 因为TTFont可以直接读取woff文件的结构,所以不需要将woff保存为XML文件,
# 接着以用户平分9.7对应的编码&#xe624.&#xe9c7测试,在原来的代码中引入基准字体数据base_font
web_code = "&#xe624.&#xe9c7"
# 编码文字转换
woff_code = [i.upper().replace("&#X", "uni") for i in web_code.split(".")]
# print(woff_code)  # ['uniE624', 'uniE9C7']

result = []
for w in woff_code:
    # 从字体中取出对应编码的字形信息 glyf是字形数据
    content = font["glyf"].glyphs.get(w).data
    #     # 字形信息MD5
    glyph = hashlib.md5(content).hexdigest()
    for b in base_font.get("font"):
        # 与基准字形中的MD5值进行对比,如果相同则取出该字形描述的文字
        if b.get("hex") == glyph:
            result.append(b.get("value"))
            break
# print(result)   # ['9', '7']

爬虫技术-字体反爬 文本混淆章节 1. 文本混淆简介 简单而言就是利用前端技术干扰,页面可以正常展示,而使用爬虫下载后无法提取正常的数据。 1.1 常见的干扰方式 字体反爬 2. 字体反爬 2.1 字体反爬简介 ​ 在 CSS3 之前,Web 开发者必须使用用户计算机上已有的字体。目前的技术开发者可以使用@font-face为网页指定字体,开发者可将心仪的字体文件放在 Web 服务器上,并在 CSS 样式中... 阅读详情

相关推荐

爬虫:碰见字体反爬如何处理

目录 THE BEGIN 一 什么是字体反爬? 二 如何解密 1. 人工解密 2.工具解密 三 建立映射关系 四 解密 THE BEGIN 网页数据爬取可以简单分为三步:抓取页面,分析页面,存储数据。其中第一二步最为头疼,因为每个站点各有特色,你要不断检查网页结构寻找其规律,更不用说现在各种各样的反爬虫手段了。 一般来说,大多数网站会从三方面反爬虫:用户请求,如...

数据自留地的博客 5960

爬虫-------字体反爬

爬虫-------字体反爬

Dexter的博客 2972

CSS 反爬之字体反爬

郑重声明:本项目的所有代码和相关文章, 仅用于经验技术交流分享,禁止将相关技术应用到不正当途径,因为滥用技术产生的风险与本人无关。

m0_53227339的博客 850

16.网络爬虫—字体反爬(实战演示)

一·字体反爬原理 🧾 🧾 Python字体反爬原理是指爬虫在爬取网站数据时,遇到了基于字体反爬的防护措施。这种反爬措施是通过将网站的文字转换成特定的字体文件,然后在页面上引用该字体文件来显示文字,使得爬虫无法直接获取文字内容。 🧾 具体原理如下: 网站将需要显示的文字转换成特定的字体文件,通常是TrueType或OpenType格式的字体文件。 网站在页面上引用该字体文件,并使用CSS样式将需要显示的文字的字体设置为该字体文件。 爬虫在获取页面源代码时,无法直接获取到需要显示的文字内容,只能获

weixin_50804299的博客 8675

Python字体反爬

网页中一个数据:333.67万我们在检查元素中的看到该部分数据是反爬的,即元素中看不出实际数据/文字,如图进入源代码中,源代码中获取的数据是加密后的数据,如图:把该串数据分成几部分 ,即33367。

Clarity_W的博客 1305

别再到处找模型了!手把手教你将TI、ADI官网的SPICE模型导入LTspice(附路径避坑指南)

本文详细介绍了如何将TI、ADI官网的SPICE模型导入LTspice的全流程,包括模型获取、路径配置、符号生成等关键步骤,并提供了路径避坑指南。通过实战案例和技巧分享,帮助电子工程师高效利用外部元器件模型进行电路仿真,提升设计效率。

weixin_42535703的博客 405

爬虫笔记41之反爬系列四:字体反爬、JS反爬

1

微信公众号进阶的阿牛哥的博客 1348

Python量化投资入门教程:从零构建你的第一个交易策略

量化投资教程以数学模型和计算机程序实现超额收益,选用Python工具链完成数据获取、策略构建及回测。通过移动平均线交叉策略示例,展示数据预处理、信号生成、收益计算及可视化全流程,结合收益率、最大回撤和夏普比率评估策略,并建议参数优化与策略融合提升稳健性。

ylmx5201314的博客 2454

爬虫 — 字体反爬

合并成一个字典 = {‘-0px’:第1个数字,‘-21.4px’:第2个数字,‘-42.8px’:第3个数字,‘-64.2px’:第4个数字}x_lst = [‘-0px’,‘-21.4px’,‘-42.8px’,‘-64.2px’]——图片上数字的间距(不会发生变化)12、选择“API文档”,选择“通用场景文字识别”,选择“通用文字识别(标准版)”,选中“Python”;num_lst = [第1个数字,第2个数字,第3个数字,第4个数字]——图片上的数字(会发生变化)

GitHub质检员 2488

对族实例进行任意的矩阵变换,需要什么样的族?

问:一个小问题,想向您请教一下。 能不能实现一个这样的操作:创建了一个常规模型的FamilyInstance,然后知道旋转和平移的矩阵,能否根据变换矩阵更新FamilyInstance的位置,绕任意轴旋转任意角度。 请问什么样的实体才能在revit项目文件中任意旋转?貌似一般的实例只能在XY平面内旋转,并且LocationPoint中只有一个Rotation参数。答:您好,因为Revit里面的构件

我爱Revit —— BIM应用及BIM应用软件解决方案专栏 3626

基于 Quest 摄像头数据开发的原理介绍【Unity Meta Quest MR 开发教程】

比如想在识别到的现实物体上叠加虚拟物体,需要知道这个现实物体在 Unity 的世界坐标下的哪个位置,是带有 x,y,z 三个轴的数据的。而 WebCamTexture 捕捉到的图像只是个 2D 的平面,没有三维世界的深度信息,我们通过物体识别算法识别到的物体坐标只是在这个 2D 平面上的一个屏幕坐标,可以理解为 Quest 拍摄了一张照片,我们识别到这张照片上的某个像素点为需要识别的现实物体的中心。是不是看起来比较复杂?Quest 的相机访问功能是在安卓的。

qq_46044366的博客 2103

Python之字体反爬详细操作

一、使用工具:Pycharm,High-Logic FontCreator(字体解析器)二、字体反爬原理:将网页上爬取下来的数据进行解密,最后还原成网页最终呈现的效果即为字体反爬。​三、举例-爬取网站:https://www.shixiseng.com/interns/iconfon/file?rand=0.22862737400022937 ​

qq_44746241的博客 2212

基于泰勒展开改进的物理信息神经网络

基于泰勒展开改进的物理信息神经网络

天天酷科研的博客 502

字体反爬积累知识

字体反爬是一种常见的反爬虫技术,它通过将网页中的文本内容转换为特殊的字体格式来防止爬虫程序直接获取和解析文本信息。字体反爬的原理是将常规的字符映射到特殊的字体图标或者Unicode码点上,使得爬虫无法直接识别和提取文本内容。字体文件准备:网站将需要显示的文本内容转换为特殊字体格式,并将字体文件嵌入到网页中。字体映射表生成:网站根据字体文件中的字符映射关系,生成一个字体映射表,用于将特殊字体格式转换回原始文本内容。字体样式应用:网页使用CSS样式将特殊字体应用到需要隐藏的文本内容上。

m0_57265868的博客 2460

基于STM32的智能血氧、心率、体温、血压监测系统

摘要:本文设计了一款基于STM32F103C8T6的多功能健康监测系统,可实时检测血氧、心率、体温和血压四项生理参数。系统集成MAX30102、DS18B20等传感器模块,采用OLED显示和蓝牙无线传输技术,实现一键血压测量、阈值报警及手机APP数据管理功能。硬件设计包含传感器采集、电源管理、显示报警等模块;软件采用模块化架构,实现数据采集处理、蓝牙通讯等功能。测试表明系统测量准确可靠,为家庭健康监测提供了便携解决方案。未来可扩展更多监测参数和智能分析功能。

3254968421的博客 766

Centos 7 Linux 安装单机 Hadoop(HDFS):下载、安装、配置、测试

本文详细介绍了在 CentOS 7 系统上安装与配置单机 Hadoop(HDFS)的完整流程,涵盖 JDK 环境准备、Hadoop 安装包下载与部署、核心配置文件(core-site.xml、hdfs-site.xml 等)修改、SSH 免密登录设置、HDFS 格式化及服务启动,并通过命令行与 Web 界面验证 HDFS 和 YARN 功能,适合 Hadoop 初学者快速搭建本地测试环境。

寒水馨 · 轻量级技术文档 · hanshuixin.org 3234

我去!爬虫遇到字体反爬,哭了

大家好,我是辰哥今天准备爬取某某点评店铺信息时,遇到了『字体』反爬。比如这样的:还有这样的:可以看到这些字体已经被加密(反爬)竟然遇到这种情况,那辰哥就带大家如何去解决这类反爬(字体反爬类...

公众号:Python研究者 892

C-Lodop打印服务系统存在任意文件读取

C-Lodop打印服务系统存在任意文件读取

weixin_43567873的博客 2872

干货丨用相似度算法分析和解决字体反爬问题

大家好,我是崔庆才。今天给大家分享我的一位朋友写的文章,这篇文章利用了相似度算法来进行了字体反爬相关分析,解决思路比较新颖,推荐大家一看,希望对大家有帮助~如下是正文。一、什么是字体反爬?前言:字体反爬就是将关键性数据对应于其他Unicode编码,浏览器使用该页面自带的字体文件加载关键性数据正常显示,而当我们将数据进行复制粘贴、爬取操作时,使用的还是标准的Unicode字...

静觅 761

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

反爬篇 | 手把手教你处理 JS 逆向之字体反爬

本篇文章将聊聊另一种更加常见的反爬方案「 字体反爬 」它的实现原理为通过自定义的字体替换网页元素中的部分内容来实现的反爬策略常见的字体格式包含:ttf、eot、woff,我们一般在网页中通过关键字「 @font-face 」定义字体样式,然后再设置到元素控件样式中去 目前有很多主流网站引入了字体反爬,比如:某 8 同城、某车之家等今天研究的目标对象是:aHR0cHM6Ly93d3cuZ3VhemkuY29tL2J1eQ==1、分析一下打开目标页面及浏览器的开发者工具栏,我们发现汽车价格、首付金额、公里数

sixqingfeng的博客 1281

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

爬虫进阶-- 字体反爬终极解析

爬取一些网站的信息时,偶尔会碰到这样一种情况:网页浏览显示是正常的,用python爬取下来是乱码,F12用开发者模式查看网页源代码也是乱码。这种一般是网站设置了字体反爬 什么是字体反爬? 字体反爬虫:在网页中的关键部分中采用自定义的字体来显示,防止爬虫爬取到关键信息。 采用自定义字体文件是CSS3特性,可参考CSS3字体。 这是网友的见解。(ps:比我高明多了) 字体反爬也就是自定义字...

u011295259的博客 3602

字体反爬(一)

简单的字体反爬

qq_44744457的博客 1790

Python爬虫编程12——字体反爬

什么是字体反爬 就是网页的制作者,他在发布他网页数据的时候。将其中一部分的字体变成乱码。即使你把网页的数据爬取下来,你也获取不到真实数据的样貌。这样就达到了一个反爬虫的目的。 如何解决字体反爬 1.下载.ttf文件; 2.将.ttf文件转换成xml文件; 3.分析字体规律找到映射关系。 就是找到字体文件,发现替换关系,将爬取下来的数据替换的过程。 如何找到字体文件 1.定位到进行了字体反爬的位置,在对应的styles里面找到font-family; 2.复制font-fam

qq_52914337的博客 2440

python爬虫---字体反爬

目标地址:http://glidedsky.com/level/web/crawler-font-puzzle-1 打开google调试工具检查发现网页上和源码之中的数字不一样, 已经确认该题目为 字体反扒 直接进入正题: ###获取字体文件: ####1丶直接找到数字节点属性:style 的 font-family 的值:glided_sky,在源码中找到 引入的的字体文件 并保存下来到本地 ####2丶该字体文件通过base64编码保存的 直接请求 将编码的值 和 节点中的数字内容 获取到 (

bmx_rikes的博客 1284
上一篇: 记忆碎片之python线程池、submit()、done()、result()、wait()、as_completed()、map()方法
下一篇: 记忆碎片之python自动化渲染工具selenium和pyppeteer,完美避开网站webdriver识别
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值