序列化模块-json和pickle

Python序列化中json模块和pickle模块(详解) 把对象(或变量)从内存变成可存储或可传输的过程称之为序列化,在python中被称为picking,在其他语言中也被称之为serialization,marshalling,flattening等等,都是一个意思。 阅读详情

一、json 

json是所有语言都通用的一种序列化格式 ,只支持 列表、 字典、 字符串、 数字 ,
字典的key必须是字符串
1、dumps、loods 
# 在内存中做数据转换 : 
# durps  数据类型  转成  字符串      序列化 
# loods    字符串    转成  数据类型  反序列化 
2、dump、 load 
# 直接将数据类型写入文件,直接从文件中读出数据类型
# dump  数据类型   写入  文件         序列化 
# load    文件          读出  数据类型  反序列化 

3、扩展:特殊的参数

import json

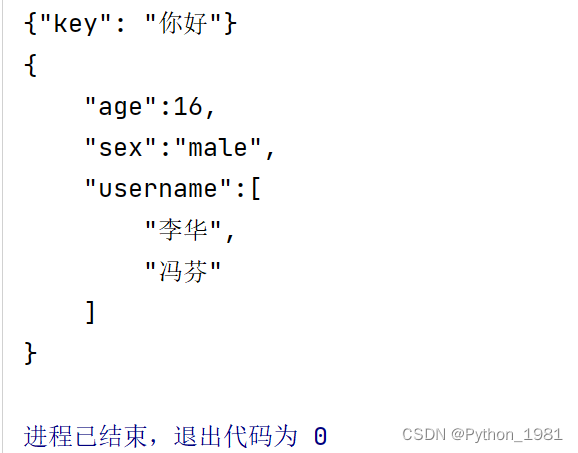
dic= {'key':'你好'}
print(json.dumps(dic,ensure_ascii=False))


# 格式化查看:
dic2 ={'username': ['李华','冯芬'],'sex':'male','age':16}
json_dic2= json.dumps(dic2,sort_keys=True,indent=4,separators=(',' , ':'),ensure_ascii=False)
print(json_dic2)
二、pickle

import pickle
#1.支持在python中几乎所有的数据类型
#2.只能在python中使用
dic = {(1,2,3):('a','b'),1:'abc'}
ret = pickle.dumps(dic)
#3.dumps 序列化的結果只能是字节
print(ret)
#b'\x80\x04\x95\x1f\x00\x00\x00\x00\x00\x00\x00}\x94(K\x01K\x02K\x03\x87\x94\x8c\x01a\x

print(pickle.loads(ret))
# {(1, 2, 3): ('a', 'b'), 1: 'abc'}

#4.在和文件操作的时候,需要用rb wb的模式打开文件
# dump
with open('pickle_file', 'wb') as f:
    pickle.dump(dic,f)
# Load
with open('pickle_file','rb') as f:
    ret = pickle.load(f)
    print(ret,type(ret))
    # {(1, 2, 3): ('a', 'b'), 1: 'abc'} <class 'dict'>

#5.可以多次dump和多次lood
dic = {(1,2,3):('a','b'),1:'abc'}
dic1 = {(1,2,3):('a','b'),2:'abc'}
dic2 = {(1,2,3):('a','b'),3: 'abc'}
# dump
with open('pickle_file', 'wb') as f:
    pickle.dump(dic,f)
    pickle.dump(dic1,f) 
    pickle.dump(dic2,f)
    
# Load
with open('pickle_file','rb') as f:
    while 1:
        try:
            ret = pickle.load(f)
            print(ret,type(ret))
            # {(1, 2, 3): ('a', 'b'), 1: 'abc'} <class 'dict'>
            # {(1, 2, 3): ('a', 'b'), 2: 'abc'} <class 'dict'>
            # {(1, 2, 3): ('a', 'b'), 3: 'abc'} <class 'dict'>
        except EOFError:
            break

序列化模块pickle和json有什么区别 pickle是Python中的内置模块,用于将Python对象序列化和反序列化为字节流。它提供了一种将复杂的数据结构(如列表、字典、类实例等)转换为字节流或将字节流反序列化为原始对象的方法。pickle模块使用特定的二进制格式表示对象,这使得它非常适合在网络传输或持久化存储中使用。pickle模块的主要函数如下:- `pickle.dumps(obj)`:将Python对象`obj`序列化为字节流,并返回字节流结果。 阅读详情

相关推荐

Ubuntu桌面消失?可能是lightdm配置在捣鬼:详细解析/etc/lightdm.conf的优先级机制与实战修复

本文详细解析了Ubuntu系统因lightdm显示管理器配置错误导致桌面消失的问题。通过分析/etc/lightdm.conf的优先级加载机制,提供了从systemctl诊断、调试模式运行到实战修复配置语法错误(如缺失[Seat:*]组)的完整方案。文章还探讨了在系统无法启动时使用chroot或恢复模式进行高级救援,并对比了lightdm与gdm3在NVIDIA驱动环境下的不同表现,帮助用户高效恢复图形界面。

weixin_29313547的博客 420

[Python学习日记-50] Python 中的序列化模块 —— pickle 和 json

什么叫序列化?序列化指的是将对象转换为可以在网络上传输或者存储到文件系统中的字节流的过程。序列化使得对象可以被保存、传输和恢复,而不损失其状态和属性。在序列化过程中,对象的属性和数据会被编码为二进制数据,以便能够在不同的环境中被解码和重建成原来的对象。常见的序列化格式有 JSON、XML 和二进制格式等。有了序列化,那有没有反序列化呢?当然有了,反序列化是序列化的逆过程,指的是将序列化后的字节流重新转换为对象的过程。

JovaZou的成长之路 1137

shader基于高度的权重混合

效果图: 基于高度的权重混合 , 效果描述: (1)混合:三层混合, 例如 第一层是草,第二层是石头,第三层是沙子,三者混合显示 (2)权重: 三层的权重的和 为1, 三者是此消彼长的关系 (3)高度:高度会限制或者说是 束缚 着 效果 关于混合,再多说几句: (1)基于权重的混合:权重 ,跟顺序没有关系 只跟权重的大小有关系(在一层一层界限不清晰的地方,特别适用!!效果极好!!!!) (2)基于叠加的混合: 叠加 就是 一层一层的往上加。。。。 所以顺序特别重要(在雪地等效果中使用:因为

木马人 1119

序列化模块之json和pickle

序列化模块—pickle和json 序列化:把不能直接存储的数据变得可存储的过程 反序列化:把文件中的数据拿出来,恢复到原来的类型的过程 (文件中存储的数据或者传输的数据,只能是字节流或者字符串,不能是其他类型;若想存储或者传输,需要序列化) pickle 1.介绍 pickle模块可以序列化一切数据类型 dumps把任意对象序列化成一个bytes;loads把任意bytes反序列化成原来的数据; dump把对象序列化后写入文件对象;load把文件对象中的内容拿出来反序列化成原来的数据; 2.使用 2.1

未知性别程序员的博客 277

告别付费!手把手教你用DataV.GeoAtlas获取全国街道级GeoJSON数据(附完整避坑指南)

本文详细介绍了如何免费使用阿里云DataV.GeoAtlas工具获取全国街道级GeoJSON数据。通过可视化选取、格式转换、数据校验等步骤,提供了一套完整的避坑指南和工作流,帮助前端和可视化开发者高效解决高精度地图数据获取难题,节省成本并提升开发效率。

weixin_29085865的博客 905

芯擎SEC1000芯片参数详细介绍

随着龙鹰一号的不断进化和应用,未来的智能座舱将不仅仅是显示和控制的集成,更是人与车之间的一种默契和无缝交互的体现。在汽车行业迈向智能化和电动化的浪潮中,座舱已不仅仅是一个驾驶者的操作空间,而是逐渐演变为一个集娱乐、信息、控制于一体的智能交互平台。今天的汽车不仅需要强劲的动力和炫酷的外观,更需要一颗强大而智能的“心脏”来支撑复杂的座舱体验和安全驾驶需求。想象一下,未来的汽车不再仅仅是交通工具,它将成为你的移动私人管家,了解你的习惯,甚至提前预测你的需求。让我们一起走进龙鹰一号的世界,探索智能座舱的无限可能!

weixin_43199439的博客 1725

python 序列化模块之 json 和 pickle

JSON(JavaScript Object Notation) 是一种轻量级的数据交换格式,采用完全独立于语言的文本格式,支持不同程序之间的数据转换.但是只能转换简单的类型如:(列表、字典、字符串、数字、)等,比如日期格式、类对象等json就处理不了。 在python中,有专门处理json格式的模块 json 和 pickle模块: json模块用于字符串和python数据类型间进行转换;pi...

python学习者的博客 484

2、系统建模、状态估计与故障诊断中的滤波设计与故障诊断方法

本文综述了系统建模、状态估计与故障诊断中的滤波设计与故障诊断方法。首先介绍了基于分析模型、知识和信号处理的三类故障诊断方法及其特点;随后总结了传统滤波方法(如维纳滤波、卡尔曼滤波)与非概率的集员滤波方法,重点阐述了在未知但有界噪声假设下的椭球、立方、多面体、区间和Zonotope等集员滤波算法原理与发展。文章还展示了各类集员滤波算法的应用实例与流程图,并对比了其计算复杂性与准确性。最后指出,根据不同系统特性选择合适的故障诊断与滤波方法至关重要,未来趋势将趋向于多方法融合与实际工程应用深化。

kmeans3miner的博客 139

序列化和反序列化之json和pickle模块

文章目录一、json&pickle模块1.什么是序列化?2.为什么要序列化?二、json三、pickle三、猴子补丁?猴子补丁的功能(一切皆对象)monkey patch的应用场景四、 总结 一、json&pickle模块 之前我们学习过用eval内置方法可以将一个字符串转成python对象,不过,eval方法是有局限性的,对于普通的数据类型,json.loads和eval都能用,但遇到特殊类型的时候,eval就不管用了,所以eval的重点还是通常用来执行一个字符串表达式,并返回表达式的值。

人丑就要多读书的博客 431

[漏洞挖掘与防护] 03.漏洞利用之WinRAR安全缺陷复现(CVE-2018-20250)及软件自启动分析

上一篇文章将详细介绍MS08-067远程代码执行漏洞(CVE-2008-4250)及防御过程,它是Windows Server服务RPC请求缓冲区溢出漏洞,利用445端口,并通过Metasploit工具获取shell及进行深入的操作。这篇文章将详细讲解WinRAR漏洞(CVE-2018-20250),并复现了该漏洞和讲解了恶意软件自启动劫持原理。基础性文章,希望对入门的同学有帮助。

杨秀璋的专栏 1091

手把手教你学Simulink实例:基于Simulink的超级电容器充放电仿真

超级电容器(Supercapacitor)是一种高容量电容器,具有快速充放电能力、长寿命和高功率密度等优点。它在能量存储系统、电动汽车、不间断电源(UPS)等领域有广泛应用。为了更好地理解和设计超级电容器的应用系统,通常需要进行详细的仿真分析。Simulink 提供了一个强大的仿真环境,可以用来设计、分析和验证超级电容器充放电系统的控制策略。本教程将详细介绍如何使用 Simulink 进行超级电容器充放电的仿真实例。通过本教程,我们详细介绍了如何使用 Simulink 进行超级电容器充放电的仿真实例。

MHD0815的博客 581

python 序列化 json_python序列化模块json和pickle

序列化相关1. json应用场景:json模块主要用于处理json格式的数据,可以将json格式的数据转化为python的字典,便于python处理,同时也可以将python的字典或列表等对象转化为json格式的数据,便于跨平台或跨语言进行数据交互功能:Json模块提供了四个功能:dumps、dump、loads、loadPython 编码为 JSON 类型转换对应表:PythonJSONdict...

weixin_39790528的博客 141

零差云控 ZeroErr eRob 电机 CAN、CANopen、EtherCAT、ROS2 机器人开发详细教程

TwinCAT 3(Windows 控制与自动化技术)是 Beckhoff 提供的开发平台,可将任何兼容 PC 转变为实时控制系统,用于管理各种类型的工业自动化系统,如 PLC(可编程逻辑控制器)、运动控制、机器人等。

机器人控制与仿真应用 1万+

python中序列化模块json和pickle

json模块:json是第三方包,不是系统内置模块,以字符串序列 常用操作有: json.dumps() # 将变量序列化,即将功能性字符转化为字符串 例: >>> import json >>> name = {"name":"egon","age":18} >>> res = json.dumps(name) >&g...

weixin_30508309的博客 139

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

Python序列化模块json和pickle

json和pickle都是Python对json格式数据进行序列化的模块 json: 用于字符串和python数据类型间进行转换pickle: 用于python特有的类型和python的数据类型间进行转换 不同的是json序列化出来的是通用格式,而pickle序列化出来的是只能用于Python的格式 json: json.dump(obj, fp) #序列化obj...

161

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

Python json和pickle 序列化模块

Python的序列化模块非常实用,尤其是json用的非常多,文章整理了两者众多知识点和需要注意的方面!

storyfull 194

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

Python中的序列化以及pickle和json模块介绍

Python中的序列化指的是在程序运行期间,变量都是在内存中保存着的,如果我们想保留一些运行中的变量值,就可以使用序列化操作把变量内容从内存保存到磁盘中,在Python中这个操作叫pickling,等下次再使用保存的变量时,可以通过反序列化操作提取数据内容到内存,即unpickling我们先来介绍pickle模块,它就是Python提供用来序列化对象的模块,假如现在我们把一个对象序列化。import

张康的博客 769

python序列化模块json和pickle

1. json 应用场景:         json模块主要用于处理json格式的数据,可以将json格式的数据转化为python的字典,便于python处理,同时也可以将python的字典或列表等对象转化为json格式的数据,便于跨平台或跨语言进行数据交互 功能: Json模块提供了四个功能:dumps、dump、loads、load Python 编码

琦彦 1万+

Python序列化模块 json和pickle

1 序列化模块 文件的存和取遇到的矛盾: 目前我们将数据结构(list,dict)转化成字符串可以直接存储在文件中,但是读取出来时,遇到麻烦了,不能将读取到的字符串类型数据转回原来的数据类型(列表、字典),取出来的是字符串类型,不好操作。 l = [1,2,3] with open('test', encoding='utf-8', mode='a') as f: f.write(str(l)) # 写进文件的都是字符型类型 with open('test', encoding='utf-8

m0_57787326的博客 348

序列化模块(pickle和json)

### 序列化模块 pickle(转换的都是字节流) 序列化: 把不能够直接存储在文件中的数据变得可存储,这个过程就是序列化\ 反序列化:把文件中的数据内容拿出来,恢复成原来的数据类型,这个过程就是反 序列化 php: serialize unserialize 在文件中存储的数据,要么是字符串,要么是字节流 python中,所有的数据类型都可以通过dumps和loads进行序列化和反序列化 错误案例 列表不能够直接塞到文件中 lst = [1,2,3] with open("ceshi2.txt"

lempoo的博客 171

python序列化模块struct_Python之序列化模块json、pickle和shelve

有时候需要将某种类型的数据转化为字符串类型,那么这个过程叫做序列化,反之则叫做反序列化。在看《Python核心编程》中介绍了几个序列化模块,有pickle、marshal、shelve及DBM风格的模块。不过还是json、pickle和shelve最为常用吧!0x00 关于序列化序列化就是将一些类似字典、列表等内容转化为一个字符串的过程,序列就是字符串的意思。其主要用在数据存储上及网络上传输的时候...

weixin_39949894的博客 366

序列化的两个模块(json和pickle)

到底什么是序列化(picking)呢?   我们把变量从内存中变成可存储或传输的过程称之为序列化   序列化之后,就可以把序列化后的内容写入磁盘,或者通过网络传输到别的机器上。   反过来,把变量内容从序列化的对象重新读到内存里称之为反序列化,即unpickling json和pickle   json和pickle模块,两个都是用于序列化的模块 json #json 是通...

afftl7302的博客 112

Python序列化模块的使用(json和pickle)

Python 序列化模块 序列化 将原本的列表或字典等内容转换为字符串的过程叫做序列号 ​比如python中,我们想将代码计算出的数据给另外一段程序使用,怎么做? 现在想到的办法就是将,数据保存到文件中,然后另外一段程序再从文件中读取出来。 但是,都知道文件是没有字典这个概念的,所以我们只能转换为字符串然后存储的文件中 你可能会想str({1,2,3,4})不就好了,转换为字符串容易,但是如果从文...

qq_36850246的博客 288

常用模块一(os模块、序列化模块(json和pickle))

一、os模块 os模块是与操作系统交互的一个接口。   import os   # 和文件和文件夹的操作有关 os.makedirs('dirname1/dirname2') # 可生成多层递归目录   os.removedirs('dirname1') # 若目录为空,则删除,并递归到上一级目录,如若也为空,则删除,依此类推   os....

aijian8502的博客 163
上一篇: JavaScript_Node节点属性_nodeName
下一篇: 面向对象成员之属性
python_198
博客等级 码龄3年 359粉丝 112原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

python_198

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值