网络爬虫-爬取网页的通用代码框架

python笔记—>网页爬虫 python爬虫学习笔记 阅读详情

一、引入

通用代码框架是一组代码,可以准确可靠地爬取网页上的内容。

在使用Requests库进行页面访问时,经常使用request.get(url)获取指定URL的相关内容,但并不是总能正确获取,因为网络连接有风险,这时对于这样的语句的异常处理很重要。

二、Requests库支持6种常见的连接异常
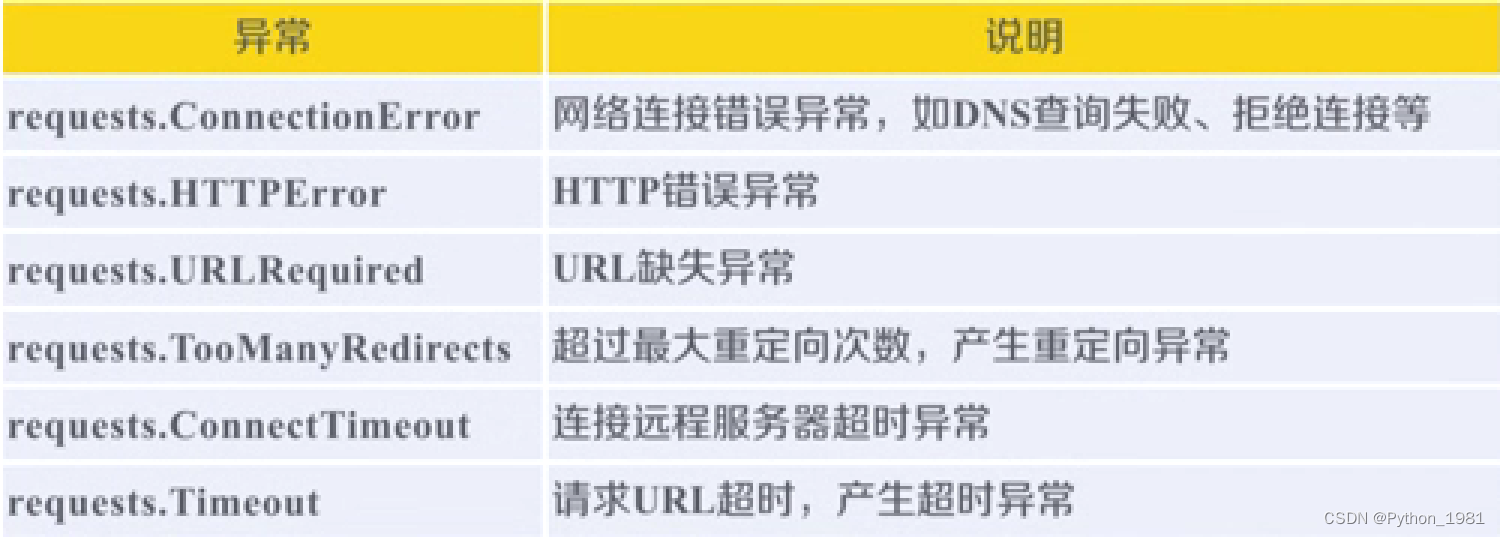
三、Response对象返回了 页面所有内容,也提供一个方法,专门与异常打交道
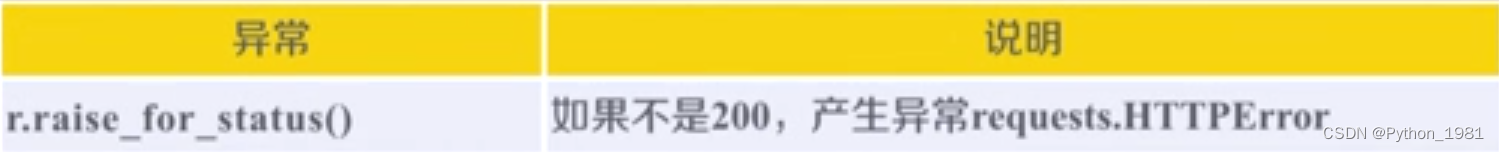
 r.raise_for_status(): 判断返回的Response类型的状态是不是200,200表示返回页面的内容是正确的;否则,产生HTTPError 异常

四、爬取网页的通用代码框架
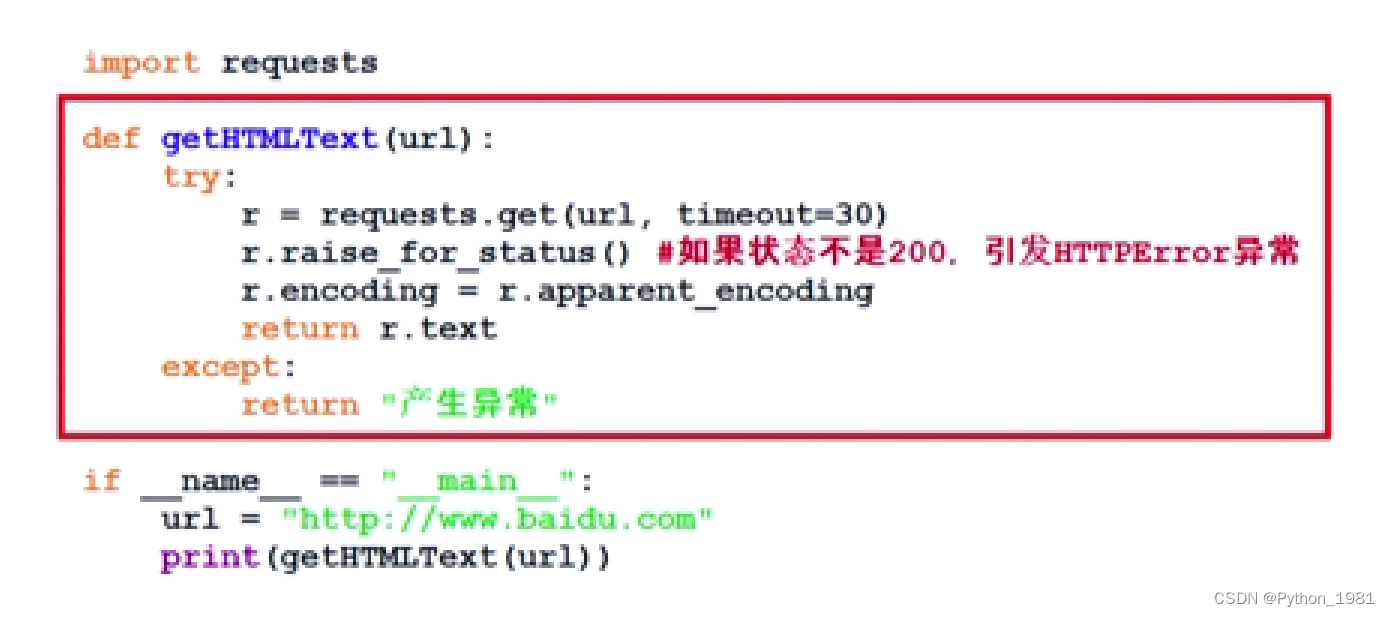
 测试:

五、总结

 通用代码框架使得爬取网页更稳定、更可靠。

爬虫爬取网页的通用代码框架(附实例) 通过一个爬虫网页的通用代码框架来实现一个网页的爬取,附实例:京东商品页面的爬取,百度搜索关键字提交,ip地址自动查询。 阅读详情

相关推荐

Python网络爬虫与信息提取 网络爬虫之规则

一、Requests库入门1.1 Requests库的安装1、Requests库是Python的第三方库,它也是公认最好爬取网页的库。它的特点是:简单,简洁。Request库更多信息查询网站:Requests库。2、Requests安装 在命令行中输入下列代码pip install requests它会帮我们自动下载并安装requests库,版本为(2.13.0),要使用最新的pip,如果不是最新

Jinbao 3593

python-爬虫(最后附爬取数据的源码)

爬虫初识 什么是爬虫? 网络爬虫,是一种按照一定规则,自动抓取互联网信息的程序或者脚本。由于互联网数据的多样性和资源的有限性,根据用户需求定向抓取相关网页并分析已成为如今主流的爬取策略。 只要能通过浏览器访问的数据都可以通过爬虫抓取。 爬虫的本质:模拟浏览器打开网页,获取网页中我们想要的那部分数据。 1. 获取数据 python一般使用urllib2获取页面数据 2. 解析数据 通过导入from bs4 import BeautifulSoup from bs4 import Beautiful

iconada的博客 1万+

爬取网页的通用代码框架(自用)

爬取网页的通用代码框架: import requests def gethtmltext(url): try: r=requests.get(url,timeout=30) r.raise_for_status()#如果状态不是200,引发HTTPError异常 r.encoding=r.apparent_encoding return r.text except: return "产生异常" if __nam

xiaochenishere的博客 303

python爬取网站数据(含代码和讲解)

python爬取网站数据~

weixin_50706330的博客 7万+

使用再生龙还原镜像文件到硬盘

1. 把制作好的再生龙光盘插入需要的电脑,开机按F4使用再生龙启动2. 选择默认的:Clonezailla live(Default settings,VGA 800*600),然后等待几分钟 3. 选择语言:简体中文 4. 选择不修改键盘映射 5. 选择使用再生龙          6. 选择硬盘/分区(存到/来自)镜像文件,此选项既可以制作镜像,也可以恢复镜像。 7. 使用本机的分区     ...

weixin_42168893的博客 1万+

如何在软件复位后保留指定RAM区域的数据

本文主要介绍S32K144的RAM retention功能

北极熊的脖子(16605192620@163.com) 1万+

Python网页爬虫代码

网页爬虫是一种自动化程序,可以自动地访问网页并提取其中的信息。它可以用于各种目的,例如搜索引擎的索引、数据挖掘、价格比较、舆情监测等。网页爬虫通常使用编程语言编写,例如Python、Java等。

weixin_44617651的博客 5769

Python+whisper/vosk实现语音识别

Whisper 是一个由 OpenAI 开发的人工智能语音识别模型,它能够将语音转换为文本。Whisper 模型特别之处在于它的设计目标是能够理解和转录多种语言的语音,包括但不限于英语。Whisper 模型在训练时使用了大量不同语言的语音数据,这使得它具有很好的跨语言能力。Vosk 是一个开源的语音识别库,它可以在离线环境下工作,不依赖于任何外部服务。Vosk 基于Kaldi语音识别框架,支持多种语言,包括中文。Vosk提供了多种预训练模型,可以根据需求选择适合的模型进行语音识别。

weixin_44458771的博客 5942

7个经典python爬虫案例代码分享

本次的7个python爬虫小案例涉及到了re正则、xpath、beautiful soup、selenium等知识点,非常适合刚入门python爬虫的小伙伴参考学习。注:若涉及到版权或隐私问题,请及时联系我删除即可。

大模型工程师老蓝的博客 4万+

Mac用户必看:Typora最新版永久激活+弹窗屏蔽保姆级教程(附崩溃解决方案)

本文为Mac用户提供了一份详尽的Typora最新版永久激活与弹窗屏蔽教程。通过修改关键JS文件,实现软件激活状态并彻底关闭成功提示弹窗。文章深入剖析了操作原理,并重点提供了解决由此引发的多文档崩溃问题的实用临时方案,同时客观讨论了该方法的局限性与潜在风险。

wine的专栏 2384

从加权最小二乘(WLS)到IAA:手把手推导DOA估计中的迭代自适应核心公式

本文深入解析了从加权最小二乘(WLS)到迭代自适应算法(IAA)在DOA估计中的数学推导与应用。通过动态调整加权矩阵,IAA在低快拍数、相干源等复杂场景中展现出卓越性能,显著提升角度分辨率和检测概率。文章详细介绍了算法核心步骤、工程优化策略及前沿发展,为雷达探测和无线通信领域提供重要参考。

weixin_30847865的博客 291

网络爬虫之Requests库及爬取网页的通用代码框架

Requests库 7个主要方法 方法 说明 requests.request() 构造一个请求,支撑以下方法的基础 requests.get() 获取HTML网页的主要方法,对应于HTTP的GET requests.head() 获取HTML网页头信息的方法,对应于HTTP的HEAD requests.post() 向HTM...

JarlenJohn 1145

华大HC32F460 TCP Server实验

华大HC32F460 TCP Server实验

ZhuoWuKeJi的博客 1272

python爬取jsp网页_python网络爬虫—爬取网页的通用代码框架及HTTP协议【2】

​-Modest_Proud-一、爬取网页的通用代码框架首先,我们使用Requests库进行网页访问的时候,经常用get(),获得url的相关内容。由于网络连接是有风险的,所以异常处理语句很重要。理解爬取网页的通用代码框架import requests ##加载Requests库def getHTMLText(url):##定义getHTMLTexl函数try:r=requests.get(ur...

weixin_39851457的博客 841

炉石传说游戏系统拆解和部分系统分析

一.游戏综述 《炉石传说:魔兽英雄传》是一款由暴雪娱乐公司出品的策略类卡牌游戏。中国大陆地区的独家运营由网易公司代理。2014年3月13日全球同步正式运营。游戏背景设定于暴雪的魔兽系列,共十位魔兽中的角色作为十种不同的职业。而玩家要做的,就是根据己方现有的卡牌组建合适的卡组,指挥英雄,驱动随从,施展法术,与游戏好友或素不相识的对手一决高下。 二.游戏系统拆解图 三.游戏系统部分分析 1. 对战系统 (1)战斗准备 炉石传说开始前都需要配置至少30张卡牌作为出战卡组 .....

Jimmy72236的博客 4926

ISO13849功能安全从入门到精通(3):安全功能及其对降低风险的贡献4

例如,如果机器必须在有限速度下运行时进行设置,那么在低加速度值下进行设置时,参数P1将是正确的选择:随着危险缓慢出现并给予足够的运动自由,操作员将能够移出危险区域。例如,在无故障的条件下,在操作者的手的方向移动的滚子不能陷住它。在所有其他情况下,F1是正确的选择,前提是危险暴露的持续时间不超过机器总操作时间的1/20。需求来源于必要的风险降低。由于这些考虑而降低的PLr在任何情况下都不得低于通过比较方式考虑的机器的PLr,因为并不能从事故发生率低和严重程度低得出实施的安全功能提供的安全水平高于要求。

wdconan001的博客 837

python—网络爬虫(爬取网页的通用代码框架)

python—网络爬虫(爬取网页的通用代码框架) 理解Requests库的异常 异常 说明 requests.ConnectionError 网络连接错误异常,如DNS查询失败,拒绝连接等 requests.HTTPError HTTP错误异常 requests.URLRequired URL缺失异常 requests.TooMany...

weixin_30828379的博客 235

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

网络爬虫学习2 - 爬取网页的通用代码框架、HTTP协议、Requests库的各种方法

网络爬虫MOOC学习打卡 - 第二天 文章目录网络爬虫MOOC学习打卡 - 第二天一、爬取网页的通用代码框架1.理解requests库的异常2.Respones类提供了一个方法 —— r.raise_for_status()3.爬取网页的常用代码框架二、HTTP协议与Requests库方法1.重温HTTP协议(hypertext transfer protocol)2.重温URL —— URL的结构3.Requests库的方法4.get()方法和header()方法输出方式的不同5.1使用post()方法,

励志成为会前后端、运维、云服务、嵌入式开发、AI和自动化技术的创业小老板! 775

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

2.零基础系统学习Python爬虫之爬取网页的通用代码框架

爬取网页的通用代码框架理解Resquests库的异常爬取网页的通用代码框架通用代码框架讲解 理解Resquests库的异常 在我们进行网络爬虫时常会出现错误,比如requests.ConnectionError;requests.HTTPError等,下面对Resquests库的异常做个总结: 异常 说明 request.ConnectionError 网络连接异常,如DNS查询失...

让技术没有门槛 2853

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

python网络爬虫学习笔记

python网络爬虫学习笔记Requests第三方库入门requests.get()Response对象获取网络资源的基本流程爬取网页的通用代码框架网络爬虫的盗亦有道Requests爬取实例 Requests第三方库入门 自动爬取HTML页面;自动网络请求提交 主要方法 说明 requests.request() 构造一个请求 requests.get() 获取HTML网页的主...

actually_ture的博客 369

Requests库学习(2):爬取页面的通用代码框架

网络连接有风险,异常处理很重要 1. 理解Requests库的异常 异常 说明 requests.ConnectionError 网络连接错误异常,如DNS查询失败,拒绝连接等 requests.HTTPError HTTP错误异常 requests.URLRequired URL缺失 requests.TooManyRedirects 超过最大重定向次数,产生重定向异...

我心自在天的博客 352

http status 400 – bad request_Python爬虫入门-request库

对于网络爬虫,我们最常用的应该是request库,首先熟悉一下request库的基本用法:import 熟悉request库之后,我们应该掌握一个用request库建立的爬取网页的通用代码框架# 爬取网页的通用代码框架 ...

weixin_39944638的博客 588

人生苦短之爬虫爬取网页的通用代码框架

我们首先打开IDLE选择File->new window命令(或者可以直接按键Ctrl+N键,在很多地方这个按键是新建文件的意思) 在这里还是要推荐下我自己建的Python开发学习群:725479218,群里都是学Python开发的,如果你正在学习Python ,小编欢迎你加入,大家都是软件开发党,不定期分享干货(只有Python软件开发相关的),包括我自己整理的一份2018最新的Pyth...

qq_42022255的博客 933

Python爬虫(一):爬虫介绍、Requests库介绍及实例

本文主要内容: 1.爬虫的相关概念。 2.Requsets库安装。 3.Requests库介绍。 4.爬取网页的通用代码框架。 1.爬虫相关概念。 网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。(百度百科) 网络爬虫就是从网页中...

番茄哈哈的博客 2146

[网络爬虫基础] 1. Request库

Request库入门,Robots协议理解,用Request库进行网络爬取的实例

magic_jiayu的博客 797
上一篇: 网络爬虫-Requests库入门
下一篇: HTTP协议及Requests库方法
python_198
博客等级 码龄3年 359粉丝 112原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

python_198

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值