


摘要:在学习agent的过程中,很多小伙伴在理解深度分析如何利用skills完成复杂的分析的任务的时候,一直处于懵懂的状态,很难以理解,本文基于一个开源项目代码来解析DeepAgents如何利用系统提示词来调用skills和工具完成任务的。而且我们通常也会遇到一个问题:处理简单任务时表现出色,但面对需要多步骤规划的复杂任务时,要么中途迷失方向,要么输出质量断崖式下跌?这就像没有规划能力的旅行者,只能走一步看一步,最终往往偏离目的地。
LangChain团队开源的DeepAgents框架正是为了解决这一痛点而生。它通过skills机制和系统提示词工程两大核心设计,让AI智能体具备了类似人类的深度分析能力。今天,我们就以DeepAgents为例,深度解析agent如何利用这两大法宝完成复杂的深度分析任务。
一、DeepAgents框架:深度智能体的基石
DeepAgents是LangChain推出的开源框架,专门解决长周期任务的执行问题。它的核心能力包括:声明式 Skills 系统(核心特性)、Memory 管理系统、多智能体协作(Multi-Agent)、工具整合与编排、流式执行与输出。
例如下面是使用deepagents 框架中创建了一个深度分析的agent:
def_create_sql_deep_agent(self, datasource_id: int, session_id: str):
"""
创建 text-to-SQL Deep Agent
这是 skills 被调用的关键位置!
"""
# 1. 获取数据源信息
datasource = DatasourceService.get_datasource_by_id(session, datasource_id)
# 2. 创建 LLM 模型
model = get_llm(timeout=self.LLM_TIMEOUT)
# 3. 根据数据源类型创建工具
if db_enum.connect_type == ConnectType.sqlalchemy:
# SQLAlchemy 方式
db = SQLDatabase.from_uri(uri, sample_rows_in_table_info=3)
toolkit = SQLDatabaseToolkit(db=db, llm=model)
sql_tools = toolkit.get_tools()
else:
# 原生驱动方式
sql_tools = [sql_db_list_tables, sql_db_schema, sql_db_query, ...]
# 4. 创建 Deep Agent(关键!)
agent = create_deep_agent(
model=model,
memory=[os.path.join(current_dir, "AGENTS.md")], # ← 系统提示词
skills=[os.path.join(current_dir, "skills/")], # ← 技能目录!
tools=sql_tools,
backend=FilesystemBackend(root_dir=current_dir),
)
return agent
上面这段代码很好的说明了创建一个agent,它必须加载大模型model. 系统提示词,技能目录下的skills,工具集,还有当前的文件目录。
关键点:
- memory=[AGENTS.md] :加载系统提示词,定义智能体行为
- skills=[skills/] : 将整个 skills 目录传递给 DeepAgents 框架
- tools=sql_tools :提供 SQL 执行工具
二、Skills机制:智能体的“能力插件”
在DeepAgents框架中,skills是智能体的能力模块,每个skill是一个包含md格式的SKILL.md文件,存储在后端的特定路径中。
例如深度分析的文件夹中包含如下技能:

这几个skill的能力如下图:
| 名称 | 顺序技能 |
| query-writing | 识别表 → 获取架构 → 编写 SQL → 执行 → 回答 |
| report-generation | 理解需求 → 查询数据 → 深度分析 → 生成 HTML |
| schema-exploration | 列出表 → 获取架构 → 查看关系 → 回答 |
| ui-ux-pro-max | 分析需求 → 搜索样式 → 生成代码 |
我们可以看一下其中一个重要的skills:query-writing:
---
name: query-writing
description: 用于编写和执行 SQL 查询 - 从简单的单表查询到复杂的多表 JOIN 和聚合操作
---
# 查询编写技能
## 何时使用此技能
当您需要通过编写和执行 SQL 查询来回答问题时应使用此技能。
## 简单查询工作流程
对于涉及单个表的直接问题:
1.**识别表** - 哪个表包含所需数据?
2.**获取架构** - 使用 `sql_db_schema` 查看列
3.**编写查询** - 使用 WHERE/LIMIT/ORDER BY 选择相关列
4.**执行** - 使用 `sql_db_query` 运行
5.**格式化答案** - 清晰地呈现结果
## 复杂查询工作流程
对于需要多个表的问题:
### 1. 规划方法
**使用 `write_todos` 分解任务:**
- 识别所有需要的表
- 映射关系(外键)
- 规划 JOIN 结构
- 确定聚合操作
### 2. 检查架构
对每个表使用 `sql_db_schema` 查找连接列和所需字段。
### 3. 构建查询
- SELECT - 列和聚合函数
- FROM/JOIN - 通过 FK = PK 连接表
- WHERE - 聚合前的过滤条件
- GROUP BY - 所有非聚合列
- ORDER BY - 有意义的排序
- LIMIT - 默认 5 行
### 4. 验证和执行
检查所有 JOIN 都有条件,GROUP BY 正确,然后运行查询。
## 示例:按国家统计收入
```sql
SELECT
c.Country,
ROUND(SUM(i.Total), 2) as TotalRevenue
FROM Invoice i
INNER JOIN Customer c ON i.CustomerId = c.CustomerId
GROUP BY c.Country
ORDER BY TotalRevenue DESC
LIMIT5;
```
## 质量指南
- 只查询相关列(不使用 SELECT *)
- 始终应用 LIMIT(默认 10)
- 使用表别名以提高清晰度
- 对于复杂查询:使用 write_todos 进行规划
- 绝不使用 DML 语句(INSERT, UPDATE, DELETE, DROP)
三、系统提示词工程:智能体的“思维框架”
如果说skills是智能体的“肌肉”,那么系统提示词就是智能体的“大脑”——它定义了智能体如何思考、如何规划、如何调用工具,上面我们也看到创建智能体的时候,需要加载系统提示词文件:AGENTS.md

它的主要内容为:
1. 核心执行流程(强制三步走)
这是整个提示词最核心的约束,要求智能体必须严格遵守:
-
第一步:思考与规划—— 在执行任何工具前,必须先输出分析计划(包含需求理解和执行步骤),且使用特定格式。
-
第二步:严格按计划执行—— 逐步推进,不跳过、不重复。
-
第三步:总结与回答—— 汇总结果,根据需求选择文字回答或生成 HTML 报告。
2. 角色定位与职责
-
定位为 SQL 数据库交互专家。
-
核心职责:自然语言 → 分析计划 → 探索库表 → 检查架构 → 编写/执行 SQL → 分析数据 → 格式化答案。
3. 关键行为规则(防错机制)
重点解决智能体在长任务中容易出现的循环调用和重复操作问题:
-
禁止重复调用同一工具(如多次获取表列表、多次获取同一表架构)。
-
禁止重复执行相同的 SQL 语句。
-
任务完成立即停止,不进行多余的验证或探索。
-
规定了高效执行的标准步骤(列表→架构→SQL→分析→结束)。
-
失败重试机制:最多重试 2 次,超限后向用户说明。
4. 数据库操作指南
-
查询限制:默认 LIMIT 100,按相关性排序,只查必要列(禁止 SELECT *)。
-
安全红线:明确禁止 INSERT/UPDATE/DELETE/DROP/ALTER/TRUNCATE/CREATE,仅限只读 SELECT 权限。
5. 复杂问题规划方法
-
要求先输出分析思路。
-
使用
write_todos工具将任务分解为最多 5 个步骤。 -
强调规划后严格按步骤执行,避免来回反复。
6. 报告生成规范(强约束)
这是针对“生成报告”类请求的专项规定,细节非常丰富:
-
纠正误解:明确指出“技能是文档,不是工具调用”,智能体无需等待调用,而应直接执行。
-
完整流程:先查询数据 → 分析数据 → 直接输出完整 HTML。
-
输出格式强制要求:
-
必须使用
<!-- REPORT_HTML_START -->和<!-- REPORT_HTML_END -->包裹 HTML。 -
必须包含 Chart.js 图表。
-
禁止使用 Markdown 生成报告。
-
禁止调用上传工具(如 MinIO 上传),HTML 直接输出到对话。
-
-
触发词:报告、报表、分析报告、可视化、趋势分析等。
7. 子代理/任务使用指南
-
使用
task工具时,任务描述要清晰具体。 -
子代理应快速完成,避免复杂嵌套。
-
避免创建过多子代理,保持流程简洁。
8. 示例方法
提供简单问题和复杂问题的标准处理路径,作为智能体的行为参考模板。
这个系统提示词定义了深度数据分析的智能体工作的具体步骤,注意事项,约束是什么,生成的报告具体UI要求等内容。
三、系统提示词工程如何隐式调用skills?
整个项目没有明确的代码显示的调用skill,那么智能体是如何使用skills,一切隐藏在系统提示词中。
重要概念:Skills 不是通过代码直接调用的,而是通过 DeepAgents 框架自动加载和使用的!
首先在系统提示词定义完成任务的步骤中包括了需要使用这些技能去完成任务


这些都是调用技能实现的。
那么它调用的完整流程是怎样的?

总结一下 当用户输入相关的问题,由deepAgents框架的大模型通过系统提示词地定义的工作步骤,隐式的调用skills去完成用户输入的问题的任务。
skills触发的机制:
| 用户问题 | skills |
| "查询..."、"统计..."、"多少..." | query-writing |
| "报告"、"报表"、"分析"、"可视化" | report-generation |
| "有哪些表"、"表结构"、"关系" | schema-exploration |
| "设计页面"、"UI"、"前端 | ui-ux-pro-max |
最后来说明一下DeepAgents和LangChain之间的关系
DeepAgents和LangChain之间的关系可以清晰地概括为:DeepAgents是一个构建在LangChain之上的“智能体工具集(Agent Harness)”,而LangChain则是一个更基础的“智能体框架(Agent Framework)”。它们是LangChain生态系统中定位不同、但紧密协作的两款产品。
下面为你详细拆解它们之间的关系:
1. 核心关系:构建与依赖
-
技术栈层级:DeepAgents 是基于 LangChain 的智能体抽象层构建的,而 LangChain 本身又是基于 LangGraph 的智能体运行时环境开发的。你可以把它想象成一个金字塔:
-
底层:LangGraph(运行时环境)—— 提供持久化、流式处理、人机交互等生产级能力。
-
中间层:LangChain(框架)—— 提供模型抽象、工具集成、智能体循环等核心构建模块。
-
顶层:DeepAgents(工具集)—— 基于LangChain,提供了开箱即用的规划工具、文件系统、子智能体等高级功能。
-
2. 功能互补:DeepAgents 的“增强功能”
正是因为DeepAgents站在LangChain的肩膀上,它才能提供LangChain本身没有的、面向复杂任务的“增强功能”:
-
规划工具:内置
write_todos/read_todos,让智能体可以分解和跟踪任务。 -
文件系统:提供
read_file、write_file、edit_file等工具,让智能体可以像人一样读写和管理文件,并且这个文件系统是可插拔的(可以存在内存、数据库或本地磁盘中)。 -
子智能体:可以动态创建和委托任务给专门的子智能体,保持主智能体上下文的清晰。
-
上下文管理:自动对长对话进行摘要,或将大的工具结果转存,以控制token消耗。
总结一下,LangChain提供了构建智能体的“基础乐高”,而DeepAgents则是一个用这些乐高搭好的、能执行复杂任务的“高级机器人模型”。当你需要快速打造一个能自主完成深度分析任务的智能体时,直接使用DeepAgents会非常高效。它在你上一轮提供的Text-to-SQL智能体系统提示词中体现的规划、文件读写(记忆优先协议)、子智能体等能力,正是它作为“工具集”优势的体现。
从0到1!大模型(LLM)最全学习路线图,建议收藏!
想入门大模型(LLM)却不知道从哪开始? 我根据最新的技术栈和我自己的经历&理解,帮大家整理了一份LLM学习路线图,涵盖从理论基础到落地应用的全流程!拒绝焦虑,按图索骥~~
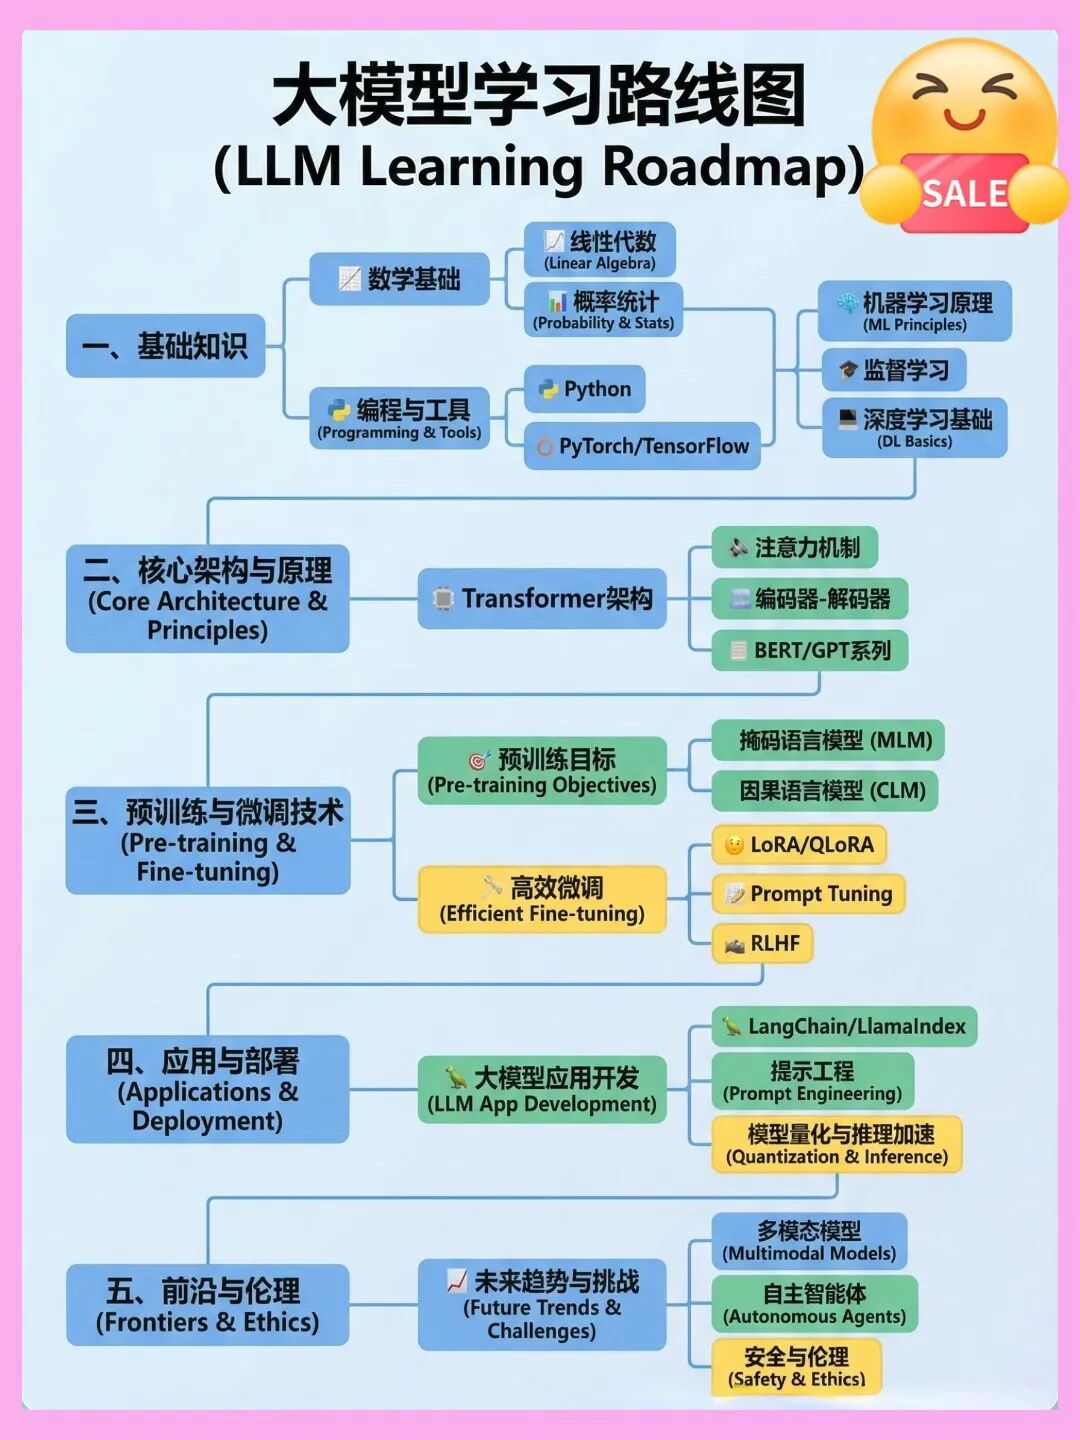
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取