RAG是什么?RAG综述,从原理到实战一篇搞懂!(非常详细)从零基础到精通,收藏这篇就够了!

RAG 入门指南:从零开始构建一个 RAG 系统 在开始之前,我还是打算再次简要的介绍一下 RAG。在 Meta 的官方 Blog 上有这样一段话:这段话主要讲述了一个新的模型架构,也就是RAG (检索增强生成)的重要性和优势。可以概括为以下几点:1. 构建一个能够进行研究和上下文分析的模型虽然更具挑战性,但对未来的技术进步非常关键;2. 通过在知识密集的下游任务上微调,RAG 可以实现最先进的结果,比现有的最大的预训练序列到序列语言模型还要好;3. 与传统的预训练模型不同,RAG 的内部知识可以轻松地动态更改或补充。 阅读详情

1、什么是RAG

RAG(Retrieval Augmented Generation)顾名思义,通过检索外部数据,增强⼤模型的⽣成效果。 RAG即检索增强⽣成,为LLM提供了从某些数据源检索到的信息,并基于此修正⽣成的答案。RAG 基本上是Search + LLM 提示,可以通过⼤模型回答查询,并将搜索算法所找到的信息作为⼤模型的上下⽂。查询和检索到的上下⽂都会被注⼊到发送到 LLM 的提示语中。

2、RAG系统⼯作流程图解
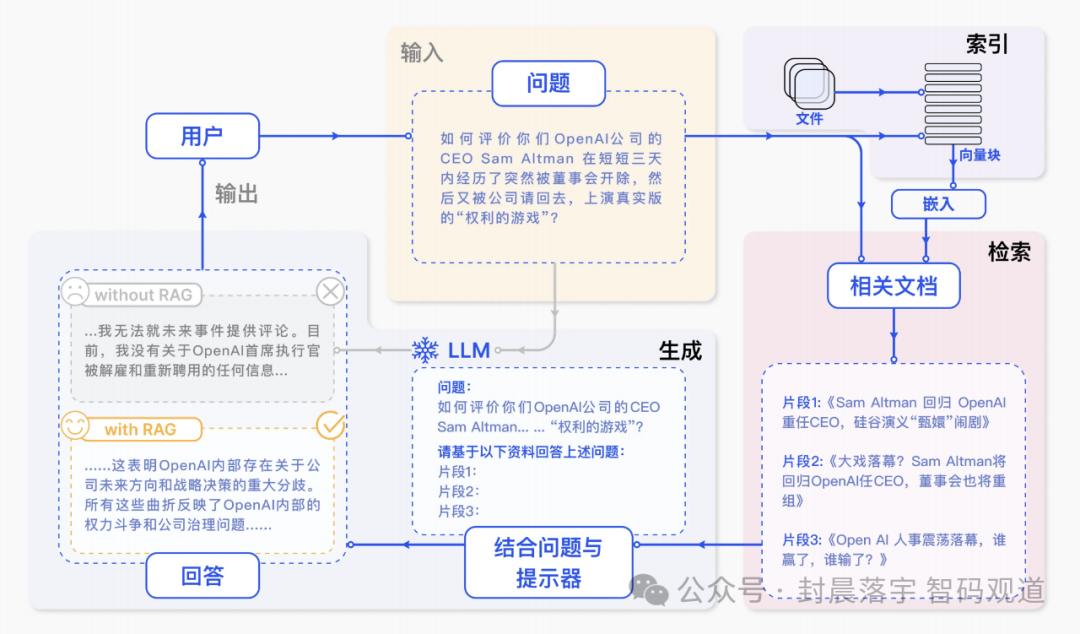
img

3、RAG能干什么,解决什么问题

大模型的问题

将⼤模型应⽤于实际业务场景时会发现,通⽤的基础⼤模型基本⽆法满⾜我们的实际业务需求,主要有以下⼏⽅⾯原因:

  • LLM的知识不是实时的,不具备知识更新
  • LLM可能不知道你私有的领域/业务知识
  • LLM有时会在回答中⽣成看似合理但实际上是错误的信息

用RAG解决上面的问题

  1. 提⾼准确性: 通过检索相关的信息,RAG可以提⾼⽣成⽂本的准确性。

  2. 减少训练成本 :与需要⼤量数据来训练的⼤型⽣成模型相⽐,RAG可以通过检 索机制来减少所需的训练数据量,从⽽降低训练成本。

  3. 适应性强 :RAG模型可以适应新的或不断变化的数据。由于它们能够检索最新 的信息,因此在新数据和事件出现时,它们能够快速适应并⽣成相关的⽂本。

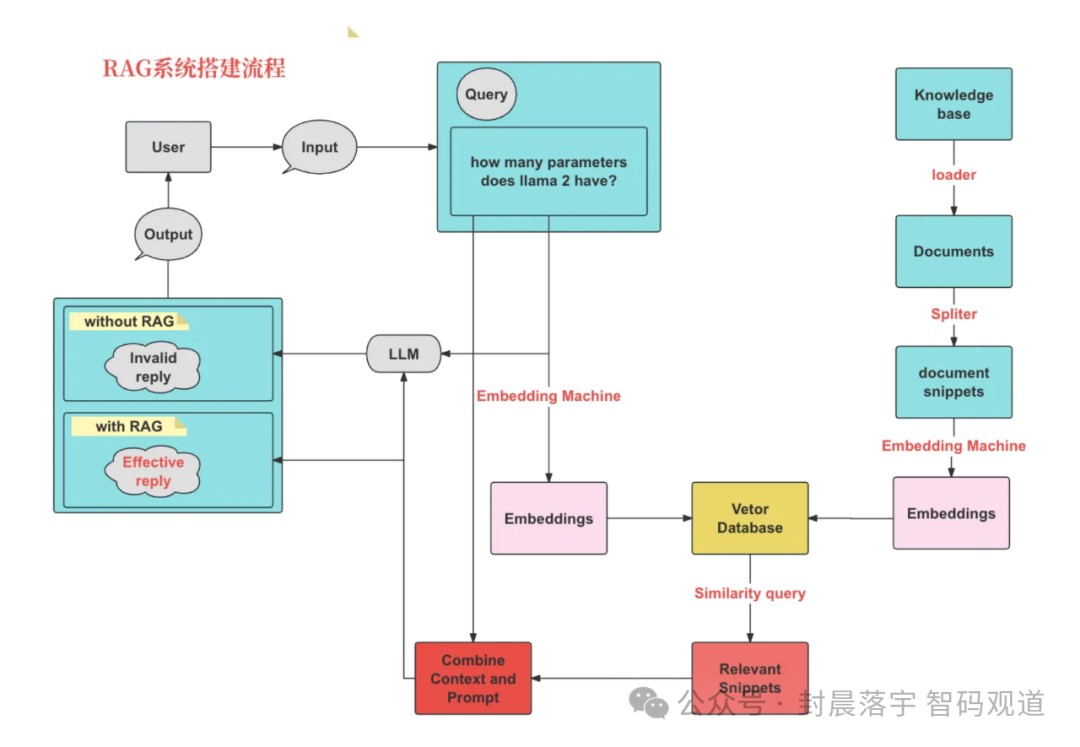
4、RAG系统怎么搭建

搭建流程图
img

流程图拆解

第一步是要索引数据

img

1、加载数据

清理和提取各种格式的原始数据,如 PDF、 HTML、 Word 和 Markdown,然后将其转换为统⼀的纯⽂本格式。

2、切块

为了适应语⾔模型的上下⽂限制,⽂本被分割成更⼩的、可消化的块(chunk)。

3、嵌入和保存

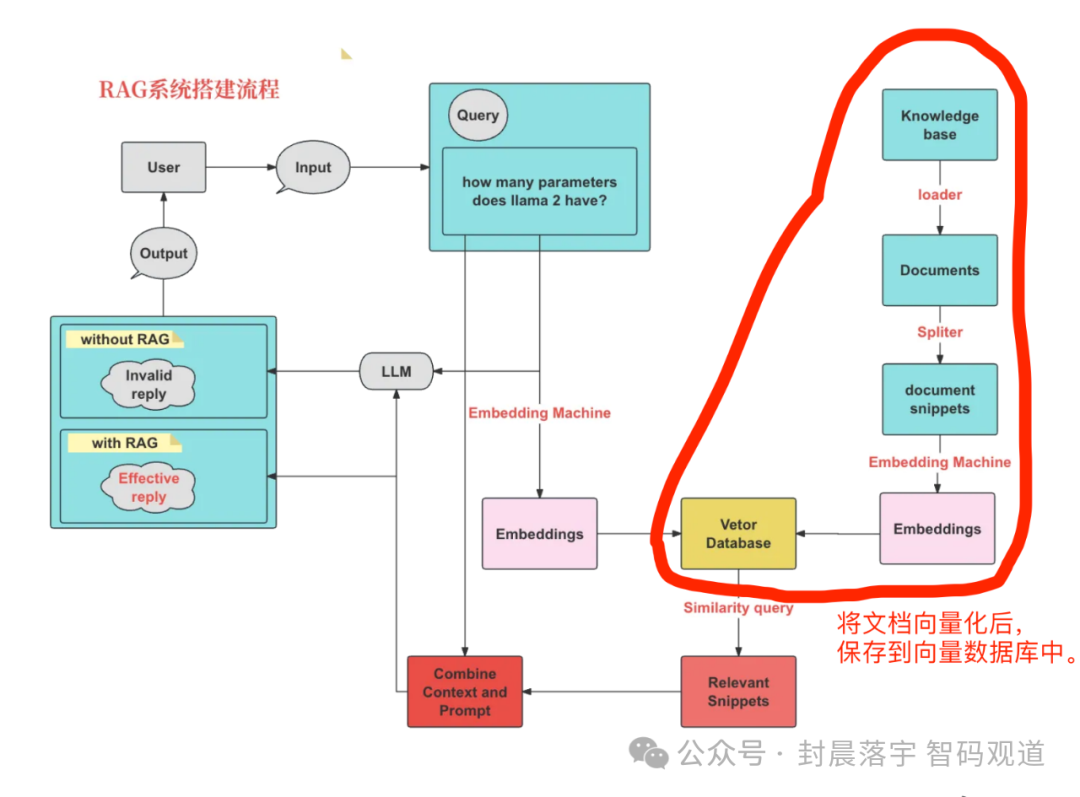
使⽤嵌⼊模型将块编码成向量表示,并存储在向量数据库中。这⼀步对于在随后的检索阶段实现⾼效的相似性搜索⾄关重要。知识库分割成 chunks,并将 chunks 向量化⾄向量库中

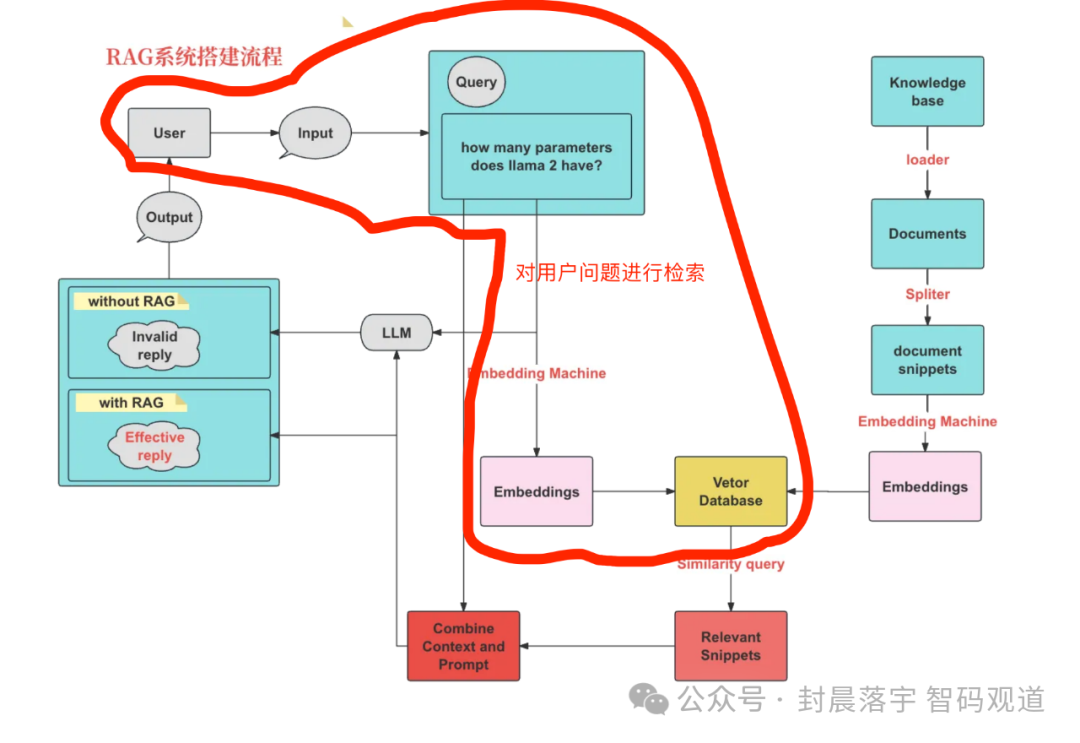
第二步是要查询索引数据
img

1、 检索(Retrieval)

在收到⽤户查询(Query)后,RAG 系统采⽤与索引阶段相同的编码模型将查询转换为向量表示,然后计算索引语料库中查询向量与块向量的相似性得分。

2、 检索返回Top-K的块

该系统优先级和检索最⾼ k (Top-K)块,显示最⼤的相似性查询。这些块随后被⽤作 prompt 中的扩展上下⽂。

第三步就是返回答案了
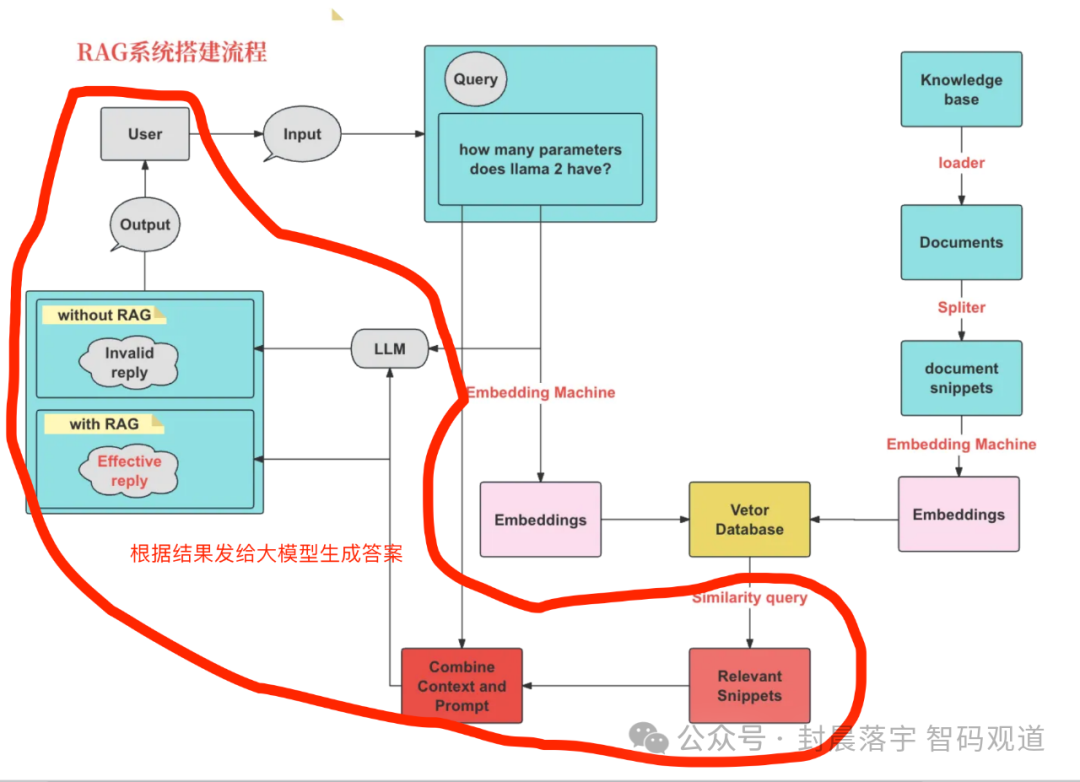
img

到这我想你已经了解和明白为什么要有RAG,RAG能能够解决大模型在商业化落地过程中面临的挑战:1、数据泄露,隐私问题,2、幻觉问题,3、效果问题,结果不稳定,确定性不强,4、数据更新不及时 等问题。

总结一下RAG具体实现流程:加载⽂件 => 读取⽂本 => ⽂本分割 =>⽂本向量化 =>输⼊问 题向量化 =>在⽂本向量中匹配出与问题向量最相似的 top k 个 =>匹配出的⽂本作 为上下⽂和问题⼀起添加到 prompt 中 =>提交给 LLM ⽣成回答

代码实现

from dotenv import load_dotenv
load_dotenv()
from openai import OpenAI
import chromadb
from chromadb.config import Settings
import os
import json

client = OpenAI()

prompt_template = """
你是一个问答机器人。
你的任务是根据下述给定的已知信息回答用户问题。
确保你的回复完全依据下述已知信息。不要编造答案。
如果下述已知信息不足以回答用户的问题,请直接回复"我无法回答您的问题"。

已知信息:
__INFO__

用户问:
__QUERY__

请用中文回答用户问题。
"""

# train_zh.json这是一个json文件,格式是这样的:{"instruction": "这段时间去上厕所本来想小便的可是每次都会拉大便", "input": "", "output": "这可能是因为你的饮食习惯或者消化系统的问题导致的。建议你试着调整一下饮食,增加膳食纤维的摄入量,多喝水,避免过度依赖泻药。同时,如果问题持续存在,建议去医院检查一下,排除肠道疾病等可能性。"}
withopen('train_zh.json', 'r', encoding='utf-8') as f:
    data = [json.loads(line) for line in f]


#data[0:1000],加载1000条数据进行向量化
instructions = [entry['instruction'] for entry in data[0:1000]]
outputs = [entry['output'] for entry in data[0:1000]]

defget_completion(prompt, model="gpt-3.5-turbo"):
'''封装 openai 接口'''
    messages = [{"role": "user", "content": prompt}]
    response = client.chat.completions.create(
        model=model,
        messages=messages,
        temperature=0,  # 模型输出的随机性,0 表示随机性最小
    )
return response.choices[0].message.content

defbuild_prompt(prompt_template, **kwargs):
'''将 Prompt 模板赋值'''
    prompt = prompt_template
for k, v in kwargs.items():
ifisinstance(v, str):
            val = v
elifisinstance(v, list) andall(isinstance(elem, str) for elem in v):
            val = '\n'.join(v)
else:
            val = str(v)
        prompt = prompt.replace(f"__{k.upper()}__", val)
return prompt

classMyVectorDBConnector:
def__init__(self, collection_name, embedding_fn):
        chroma_client = chromadb.Client(Settings(allow_reset=True))

# 为了演示,实际不需要每次 reset()
        chroma_client.reset()

# 创建一个 collection
self.collection = chroma_client.get_or_create_collection(name=collection_name)
self.embedding_fn = embedding_fn

defadd_documents(self, instructions, outputs):
'''向 collection 中添加文档与向量'''
        embeddings = self.embedding_fn(instructions)

iflen(embeddings) != len(instructions) orlen(instructions) != len(outputs):
raise ValueError("嵌入向量、instructions 和 outputs 数量不一致")

self.collection.add(
            embeddings=embeddings,  # 每个文档的向量
            documents=outputs,  # 文档的原文
            ids=[f"id{i}"for i inrange(len(outputs))]  # 每个文档的 id
        )

defsearch(self, query, top_n):
'''检索向量数据库'''
        results = self.collection.query(
            query_embeddings=self.embedding_fn([query]),
            n_results=top_n
        )
return results

defget_embeddings(texts, model="text-embedding-3-large"):
'''封装 OpenAI 的 Embedding 模型接口'''
    data = client.embeddings.create(input=texts, model=model).data
return [x.embedding for x in data]

# 创建一个向量数据库对象
vector_db = MyVectorDBConnector("demo", get_embeddings)

# 向向量数据库中添加文档
vector_db.add_documents(instructions, outputs)

classRAG_Bot:
def__init__(self, vector_db, llm_api, n_results=2):
self.vector_db = vector_db
self.llm_api = llm_api
self.n_results = n_results

defchat(self, user_query):
# 1. 检索
        search_results = self.vector_db.search(user_query, self.n_results)

# 2. 构建 Prompt
        prompt = build_prompt(
            prompt_template, info=search_results['documents'][0], query=user_query)
# print("="*50)
# print(prompt)
# print("="*50)
# 3. 调用 LLM
        response = self.llm_api(prompt)
return response

# 创建一个RAG机器人
bot = RAG_Bot(
    vector_db,
    llm_api=get_completion
)

user_query = "拉肚子怎么办?"

response = bot.chat(user_query)

print(response)

5、总结

RAG 作为人工智能领域极具创新性的技术,通过检索增强生成的独特架构,有效弥补了大语言模型在知识更新和特定领域知识储备上的不足。从基础的索引构建、检索和生成原理,到不断发展演进的不同阶段,再到查询优化、嵌入技术等关键技术细节,RAG 形成了一套完整且不断完善的技术体系。在实际应用中,无论是智能客服系统提升客户服务效率,还是医疗知识问答系统辅助专业决策,RAG 都展现出强大的实用价值和广阔的应用前景。随着技术的持续发展和创新,RAG 有望在更多领域发挥重要作用,推动人工智能应用向更高水平迈进,为解决复杂的实际问题提供更高效、精准的智能解决方案。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享**

一、2025最新大模型学习路线

一个明确的学习路线可以帮助新人了解从哪里开始,按照什么顺序学习,以及需要掌握哪些知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1级别:AI大模型时代的华丽登场

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理,关键技术,以及大模型应用场景;通过理论原理结合多个项目实战,从提示工程基础到提示工程进阶,掌握Prompt提示工程。

L2级别:AI大模型RAG应用开发工程

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3级别:大模型Agent应用架构进阶实践

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体;同时还可以学习到包括Coze、Dify在内的可视化工具的使用。

L4级别:大模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

整个大模型学习路线L1主要是对大模型的理论基础、生态以及提示词他的一个学习掌握;而L3 L4更多的是通过项目实战来掌握大模型的应用开发,针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

二、大模型经典PDF书籍

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

三、大模型视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

四、大模型项目实战

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

五、大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。


因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

RAG 全流程核心技术深度解析:1-工作原理+切片+召回+排序 本文深入解析了检索增强生成(RAG)技术的核心原理与应用。RAG通过将信息检索与大语言模型生成能力结合,有效解决大模型的"幻觉"问题、知识时效性不足和领域专业壁垒等关键问题。文章详细介绍了RAG的工作流程,包括准备阶段的分片(Chunking)和索引(Indexing)技术,以及回答阶段的召回、重排和生成过程。特别针对分片技术,对比分析了固定长度切分、递归字符切分、语义切分、结构切分和LLM智能切分五种方法的优缺点及适用场景。最后,文章还探讨了向量化(Embedding)的核心算法和主流 阅读详情

相关推荐

(13-1)RAG基础知识介绍:RAG模型概述

RAG(Retrieval-Augmented Generation)是一种自然语言处理模型架构,旨在结合检索和生成两个关键的NLP(Natural Language Processing)任务。RAG模型可以应用于诸如问答系统、文本摘要、对话系统等多个领域。在本章的内容中,将详细讲解RAG的基础知识,介绍RAG技术的原理和架构知识,为读者步入后面知识的学习打下基础。

码农三叔 4478

大模型入门到进阶:什么是 RAG?为什么需要 RAG?RAG 的流程

学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频,免费分享!

star_nwe的博客 3万+

RunHarmony报错解析:如何解决data.use与cell.embeddings维度不匹配问题

本文深入解析了单细胞数据分析中RunHarmony函数报错'non-conformable arguments'的根源,即data.use与cell.embeddings矩阵维度不匹配。核心原因是assay(如RNA与integrated)错配导致细胞ID或数量不一致。文章提供了三种解决方案:最推荐显式指定assay.use参数,也可设置project.dim=FALSE或统一数据环境,并给出了最佳实践指南以避免此类错误。

weixin_29093017的博客 576

大模型应用RAG系列(1)初识RAG

之前我们在讲大模型的应用方向和架构时,有提到RAG、Agent、Fine-Tune。在作者写大模型专题的文章时,也是边学习,边梳理,边总结。在这个过程中,大模型在各个方向都不断地快速发展,对应的paper、理论、方向也是不断地涌现出来。

AAI666666的博客 1803

HarmonyOS ArkTS开发实战:用Axios封装一个通用的网络请求工具类(附完整代码)

本文详细介绍了如何在HarmonyOS ArkTS开发中利用Axios封装一个通用的网络请求工具类,涵盖架构设计、核心模块实现、UI状态联动及高级功能扩展。通过单例控制器、拦截器链配置和Token自动刷新机制,提升网络请求的稳定性和可维护性,适用于各类HarmonyOS应用开发场景。

weixin_30772105的博客 491

512分辨率万能遮罩模型实战指南:从下载到高精度应用

本文提供了512分辨率万能遮罩模型的完整实战指南。该模型经过超过540万次迭代,专门优化了对头发、手、眼睛等复杂区域的识别。文章详细介绍了从可靠渠道下载、环境部署、使用DF_ICE工具批量应用遮罩,到利用XSeg Editor进行高精度精修的全流程,旨在帮助用户显著提升AI换脸合成视频的质量与效率。

y2z3a4b5c的博客 1165

【2025版】最新RAG综述来了!从零基础到精通,精通收藏这篇就够了!

近年来,AIGC 的关注度持续攀升,大型生成模型在众多领域和模态中展现出令人瞩目的成果,例如文本和代码领域的 GPT 系列和 LLAMA 系列模型、图像领域的 DALL-E 和 Stable Diffusion 模型、以及文生长视频背后的 Sora 模型。虽然这些强大的生成器能够带来令人惊艳的效果,但仍存在一系列不容忽视的问题和挑战,如难以更新维护知识、不易掌握长尾知识、以及泄露私人训练数据的风险。为了应对这些问题,检索增强生成技术(RAG)应运而生。

Javachichi的博客 5988

abaqus wcm插件下载_Abaqus随机短纤维增强复合材料建模插件

文末附Abaqus随机短纤维增强复合材料建模插件下载链接前言短纤维增强复合材料相对于长纤维增强复合材料来说更容易制备,且短纤维的填充性能略有改善,可制造复杂产品,广泛应用于车辆、航空航天、建筑等行业,对短纤维增强复合材料进行细观力学分析,可对其宏观力学性能进行预测、分析破坏机理等。接下来对随机短纤维增强复合材料建模插件进行介绍。NO.1 【算法简介】难点一:此插件核心在于判断生成的纤维是...

weixin_39974882的博客 2833

AI大模型+RAG的综述!(非常详细)从零基础到精通,精通收藏这篇就够了!

本文全面回顾了当前最先进的RAG技术,包括朴素RAG、进阶RAG和模块RAG等范式,并置于LLM背景下。文章讨论了RAG过程中的核心技术,如“检索”、“生成”和“增强”,并深入探讨了它们的协同作用。此外,文章还构建了一个全面的评估框架,概述了评估目标和度量标准,并进行了比较分析,阐明了RAG的优缺点。最后,文章预测了RAG的未来发展方向,强调了解决当前挑战的潜在增强、多模式设置的扩展以及其生态系统的发展。图1 RAG技术发展科技树。

Python_0011的博客 1010

基于matlab的LFM脉冲压缩仿真

传统雷达测距是通过发射点频脉冲串实现的,通过发射脉冲与回波的时延确定目标的距离。此类方法易于实现,对接收机的要求较低。一般要获取更好的距离分辨力,需要增加发射信号的带宽,对于点频脉冲信号即需要减小发射脉冲宽度;而为获取更大的探测距离,提升雷达威力,则需要发射更大占空比的脉冲串。由于点频信号的时宽带宽积约等于1,因此不能同时增加信号的时宽和带宽。若要保持距离分辨力,增大占空比就需要减少雷达的脉冲重复周期(PRT)。这样会减小雷达的无模糊探测距离,也会造成目标回波频繁被遮挡,损失雷达威力。

平时工作较为繁忙,私信消息一般晚上回复,谢谢大家~~ 1770

攻克反光难题!YOLOv9工业缺陷检测实战:高反光件、微小划痕精准识别(附抗反光代码+产线数据)

文章摘要:本文针对不锈钢、铝合金等高反光工业件的缺陷检测难题,提出了一套“硬件抗反光+YOLOv9小目标增强”的解决方案。通过分析反光干扰(镜面/漫反射)和微小划痕(0.1mm级)两大核心问题,详细介绍了500万像素工业相机+偏振光源的硬件配置方案,以及基于偏振图像融合和超分辨率放大的预处理方法。最终实现误检率1.2%、微小划痕检出率99.3%的工业级检测效果,并提供了可落地的代码实现和车间实测数据。(148字)

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1041

一文搞懂RAG到底是什么!零基础入门到精通,看这一篇就够了

本文将从基础概念到实战技巧,带你全面掌握 RAG。

AI大模型的博客 7082

Pointnet++环境配置(Windows11和ubuntu)及训练教程

PS:前两行命令是数据处理的命令,主要是进行数据读取和生成相应的训练数据格式,在Ubuntu上是正常运行的,在Windows上运行会失败,无法生成训练用的数据格式,所以最好在Ubuntu上训练,如果一定要用Windows,可以ubuntu上生成数据格式在导到Windows上,数据生成不需要安装torch。通过anaconda配置的环境,在官网找的命令安装的,版本是2.1.0+cu118。训练命令:我使用的pycharm,直接在pycharm中打开终端,运行命令。Python版本:3.7。

AIcurator的博客 2558

一篇RAG技术最新综述,(非常详细)从零基础到精通,精通收藏这篇就够了!

检索增强生成(RAG)的出现,利用外部知识数据库来增强LLMs,弥补了LLMs的幻觉问题、知识更新等问题:系统地介绍了RAG的每个组成部分,特别是和重要技术,以及带有教程代码的检索融合技术。展示了不同的,包括。讨论了RAG在下游中的应用。******1. 检索器(Retriever)检索器(Retriever) 是检索增强生成(RAG)中的一个关键组件,其主要作用是从一个外部知识库中检索与输入相关的信息。使用检索器的:将文档分割成小块,对这些块进行编码,并建立索引以支持高效的检索。

Python_0011的博客 675

10种电阻综合对比——《器件手册--电阻》

可变电阻在电子设备中也有很多用途,如在收音机的音量调节电路中,通过旋转可变电阻的旋钮来改变电路中的电阻值,从而改变通过扬声器的电流,实现音量的调节。根据电阻定律,电阻R = ρ(L/S),其中ρ是导体材料的电阻率,L是导体的长度,S是导体的横截面积。比如,同样材料制成的两根电线,粗的电线电阻比细的电线电阻小,长的电线电阻比短的电线电阻大。电流采样电阻的工作原理基于欧姆定律,即电阻两端的电压与通过电阻的电流成正比,公式为 I = V/R,其中 I是电流,V是电阻两端的电压,R 是电阻值。

XU157303764的博客 3144

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

2025年度RAG清单,从零基础到精通,精通收藏这篇就够了!

作者遴选了2025年度典型的RAG系统和论文(含AI注解、来源、摘要信息),并于文末附上RAG综述和测试基准材料,希望阅读完本文可以帮助大家速通RAG。▍作者:范志东,蚂蚁图计算开源负责人、图计算布道师回顾2025,大模型日新月异,智能体百家争鸣。作为AI应用的重要组成部分,RAG也是“群雄逐鹿,诸侯并起”。年初ModularRAG持续升温、GraphRAG大放异彩,年中开源工具如火如荼、知识图谱再创新机,年末图表理解、多模态RAG又启新征程,简直“你方唱罢我登场”,奇技叠出,不胜枚举!

leah126的博客 1577

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

【2025版】最新的检索增强生成RAG综述,从零基础到精通,精通收藏这篇就够了!

人工智能生成内容(AIGC)的发展得益于模型算法的进步、基础模型规模的增加以及大量高质量数据集的可用性。虽然AIGC取得了显著的性能,但仍面临一些挑战,如难以保持最新和长尾知识、数据泄露的风险以及与训练和推理相关的高成本。检索增强生成(RAG)最近出现作为一种范式来解决这些挑战。具体而言,RAG引入信息检索过程,通过从可用数据存储中检索相关对象来增强生成过程,从而提高准确性和鲁棒性。本文全面审查了将RAG技术整合到AIGC场景中的现有努力。

leah126的博客 2021

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

大模型RAG入门到实战基础教程(非常详细),大模型RAG入门到精通,收藏这一篇就够了!

大模型(Large Language Model,LLM)的浪潮已经席卷了几乎各行业,但当涉及到专业场景或行业细分域时,通用大模型就会面临专业知识不足的问题。相对于成本昂贵的“Post Train”或“SFT”,基于RAG的技术方案往成为一种更优选择。本文从RAG架构入手,详细介绍相关技术细节,并附上一份实践案例。前排提示,文末有大模型AGI-优快云独家资料包哦!本文列举了LLM的问题。简单介绍了什么是 RAG ,以及 RAG 的流程。最后使用了一个简单的LangChain代码示例来展示 RAG 的使用。

2301_76161259的博客 3775

RAG是什么?RAG综述,从原理到实战一篇搞懂!

RAG(Retrieval Augmented Generation)顾名思义,通过检索外部数据,增强⼤模型的⽣成效果。 RAG即检索增强⽣成,为LLM提供了从某些数据源检索到的信息,并基于此修正⽣成的答案。RAG 基本上是Search + LLM 提示,可以通过⼤模型回答查询,并将搜索算法所找到的信息作为⼤模型的上下⽂。查询和检索到的上下⽂都会被注⼊到发送到 LLM 的提示语中。

AI大模型的博客 2004

RAG技术架构深度解析(非常详细)零基础入门到精通,收藏这一篇就够了

本文主要介绍了RAG技术架构在AI编程中的创新应用及其面临的挑战。文章深入分析了RAG技术架构的兼容性、实时性和智能化水平等方面的问题,并提出了相应的改进措施,如加强标准化建设、引入实时数据处理技术和先进算法模型。同时,文章预测了RAG技术架构在智能化水平持续提升、跨领域融合加速以及数据隐私与安全保障方面的未来发展趋势。最后,文章回顾了RAG技术在AI编程领域的应用成果,并展望了其广阔的应用前景,同时设定了未来研究方向和目标,以推动RAG技术的进一步发展和优化。第一章 RAG技术概述与基本原理。

Javachichi的博客 3623

大模型RAG实战|零基础入门到精通,收藏这一篇就够了

今天,开始写一个新的系列《大模型RAG实战》。上个月我在2篇文章中,介绍了如何使用LlamaIndex框架,通过少量代码,实现本地可部署和运行的大模型RAG问答系统。我们要开发一个生产级的系统,还需要对LlamaIndex的各个组件和技术进行深度的理解、运用和调优。本系列将会聚焦在如何让系统实用上,包括:知识库的管理,检索和查询效果的提升,使用本地化部署的模型等主题。我将会讲解相关的组件和技术,辅以代码示例。最终这些文章中的代码将形成一套实用系统。过去一年,大模型的发展突飞猛进。

h1453586413的博客 1353

【2025版】AI大模型+RAG的综述!从零基础到精通,精通收藏这篇就够了!

本文全面回顾了当前最先进的RAG技术,包括朴素RAG、进阶RAG和模块RAG等范式,并置于LLM背景下。文章讨论了RAG过程中的核心技术,如“检索”、“生成”和“增强”,并深入探讨了它们的协同作用。此外,文章还构建了一个全面的评估框架,概述了评估目标和度量标准,并进行了比较分析,阐明了RAG的优缺点。最后,文章预测了RAG的未来发展方向,强调了解决当前挑战的潜在增强、多模式设置的扩展以及其生态系统的发展。图1 RAG技术发展科技树。

Javachichi的博客 2676

大模型RAG实战教程(超详细):从入门到精通,一篇就够,建议收藏!

RAG(Retrieval Augmented Generation, 检索增强生成)是一种技术框架,其核心在于当 LLM 面对解答问题或创作文本任务时,首先会在大规模文档库中搜索并筛选出与任务紧密相关的素材,继而依据这些素材精准指导后续的回答生成或文本构造过程,旨在通过此种方式提升模型输出的准确性和可靠性。RAG 技术架构图介绍:富文本 主要存储于 txt 文件中,因为排版比较整洁,所以获取方式比较简单实战技巧:【版面分析——富文本txt读取】

Everly_的博客 1596

java安装教程详细,零基础入门到精通,收藏这篇就够了

指定的是jdk下的bin目录。

leah126的博客 1742

【2025版】一篇RAG技术最新综述,从零基础到精通,精通收藏这篇就够了!

检索增强生成(RAG)的出现,利用外部知识数据库来增强LLMs,弥补了LLMs的幻觉问题、知识更新等问题:系统地介绍了RAG的每个组成部分,特别是和重要技术,以及带有教程代码的检索融合技术。展示了不同的,包括。讨论了RAG在下游中的应用。******1. 检索器(Retriever)检索器(Retriever) 是检索增强生成(RAG)中的一个关键组件,其主要作用是从一个外部知识库中检索与输入相关的信息。使用检索器的:将文档分割成小块,对这些块进行编码,并建立索引以支持高效的检索。

Javachichi的博客 1552

【2025版】卡内基梅隆大学最新RAG综述 ,从零基础到精通,精通收藏这篇就够了!

本文深入探讨了 Retrieval-Augmented Generation (RAG) 的发展历程,从基础概念到最新技术。RAG 通过结合检索与生成模型,有效提升了输出准确性,克服了 LLM 的局限。研究详细分析了 RAG 的架构,展示了检索与生成如何协同处理知识密集型任务。此外,本文还回顾了 RAG 在问答、摘要等领域的关键技术进展,并探讨了提升检索效率的新方法。

Libra1313的博客 2464
上一篇: 2025年各大厂高频大模型(LLMs)面试题集合,看这一篇就够了!(非常详细)从零基础到精通,收藏这篇就够了!
下一篇: 「 网络安全常用术语解读 」什么是0day、1day、nday漏洞(非常详细)从零基础到精通,收藏这篇就够了!
程序员_大白
博客等级 码龄5年 1万+粉丝 4001原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值