


6 个最佳本地运行大模型的工具

运行大型语言模型(LLMs)如 ChatGPT 和 Claude 通常需要将数据发送到由 OpenAI 和其他 AI 模型提供商管理的服务器。尽管这些服务是安全的,但一些企业更喜欢完全离线保存数据以获得更高的隐私保护。
本文涵盖了开发者可以使用的前六种工具,用于在本地运行和测试LLMs,确保其数据永远不会离开设备,类似于端到端加密保护隐私的方式。
为什么使用本地 LLMs?
一个像 LM Studio 这样的工具在用户使用它运行本地LLMs时不收集用户数据或追踪用户的行为。它允许所有聊天数据保留在用户的本地计算机上,而不与 AI/ML 服务器共享。
-
隐私:您可以以多轮的方式提示本地 LLMs,而您的提示数据不会离开您的本地主机。
-
自定义选项:Local LLMs 提供高级的 CPU 线程配置、温度设置、上下文长度、GPU 设置等。这类似于 OpenAI 的游乐场。
-
支持与安全:它们提供与 OpenAI 或 Claude 相似的支持和安全性。
-
订阅和费用:这些工具是免费使用的,不需要月度订阅。对于像 OpenAI 这样的云服务,每个 API 请求都需要付费。本地LLMs有助于节省费用,因为没有月度订阅。
-
离线支持:您可以在离线状态下加载并连接到大型语言模型。
-
连接性:有时,连接到像 OpenAI 这样的云服务可能会导致信号不佳和连接问题。
六种顶级且免费的本地LLM工具
根据您的具体使用场景,您可以选择几种离线 LLM 应用程序。这些工具中的一些完全免费供个人和商业使用。其他可能需要您请求用于商业用途。有几种本地 LLM 工具适用于 Mac、Windows 和 Linux。以下是您可以选择的六款最佳工具。
1. LM Studio

LM Studio 可以运行任何 gguf 格式的模型文件。它支持来自 Llama 3.1、Phi 3、Mistral 和 Gemma 等模型供应商的 gguf 文件。要使用 LM Studio,请点击链接(https://lmstudio.ai/)并下载适用于您机器的应用程序。一旦启动 LM Studio,首页将提供前 LLMs 的模型供下载和测试。还有一个搜索栏,可以筛选并从不同的 AI 提供商下载特定模型。
搜索特定公司的模型会呈现多个模型,从小型到大型量化。根据您的机器,LM Studio 使用兼容性猜测来突出显示在该机器或平台上可以工作的模型。
LM Studio 的主要特点
LM Studio 提供了与 ChatGPT 相似的功能和特性。它具有多个功能。以下突出显示了 LM 工作室的关键特性。
-
模型参数自定义:这允许您调整温度、最大token数、频率惩罚以及更多。
-
聊天历史:允许您保存提示以便日后使用。
-
参数和 UI 提示:您可以悬停在信息按钮上查看模型参数和术语。
-
跨平台:LM Studio 可在 Linux、Mac 和 Windows 操作系统上使用。
-
机器规格检查:LM Studio 检查计算机规格,如 GPU 和内存,并报告兼容的型号。这可以防止下载可能无法在特定机器上运行的模型。
-
AI 对话与游乐场:以多轮对话格式与大型语言模型聊天,并通过同时加载多个LLMs进行实验。
-
本地推理服务器供开发者使用:允许开发者设置一个类似于 OpenAI API 的本地 HTTP 服务器。

本地服务器提供示例 Curl 和 Python 客户端请求。此功能有助于使用 LM Studio 构建 AI 应用程序以访问特定的LLM。
# Example: reuse your existing OpenAI setup from openai import OpenAI # Point to the local server client = OpenAI(base_url="http://localhost:1234/v1", api_key="lm-studio") completion = client.chat.completions.create( model="TheBloke/Mistral-7B-Instruct-v0.1-GGUF", messages=[ {"role": "system", "content": "Always answer in rhymes."}, {"role": "user", "content": "Introduce yourself."} ], temperature=0.7, ) print(completion.choices[0].message)
使用上述示例 Python 代码,您可以重用现有的 OpenAI 配置并将基础 URL 更改为指向您的本地主机。
-
OpenAI 的 Python 库导入:LM Studio 允许开发人员导入 OpenAI Python 库并将基础 URL 指向本地服务器(localhost)。
-
多模型会话:使用单个提示并选择多个模型进行评估。
使用 LM Studio 的好处
此工具仅供个人使用,允许开发人员通过应用内聊天 UI 和Playground 运行LLMs。它提供了一个美观且易于使用的界面,带有过滤器,并支持连接到 OpenAI 的 Python 库,无需 API 密钥。公司和企业可以应要求使用 LM Studio。然而,它需要 M1/M2/M3 Mac 或更高版本,或者具有支持 AVX2 的处理器的 Windows PC。Intel 和 AMD 用户仅限于在 v0.2.31 版本中使用 Vulkan 推理引擎。
2. Jan
 将 Jan 视为 ChatGPT 的开源版本,旨在离线运行。它由用户社区构建,遵循用户所有制的理念。Jan 允许您在设备上运行 Mistral 或 Llama 等流行模型,而无需将其连接到互联网。借助Jan ,您可以访问远程 API,如 OpenAI 和 Groq。
Jan 的关键特性

Jan 是一个电子应用,其功能类似于 LM Studio。它通过将消费级机器转变为 AI 计算机,使 AI 对所有人开放和可访问。由于这是一个开源项目,开发人员可以贡献并扩展其功能。以下是 Jan 的主要功能分解。
-
本地:您可以在不连接到互联网的情况下,在设备上运行您首选的 AI 模型。
-
可直接使用的模型:在下载并安装 Jan 后,您将获得一组已安装的模型以开始使用。同时,也有可能搜索特定的模型。
-
模型导入:它支持从 Hugging Face 等来源导入模型。
-
免费,跨平台和开源:Jan 是 100%免费、开源,并在 Mac、Windows 和 Linux 上运行。
-
自定义推理参数:调整模型参数,如最大令牌、温度、流、频率惩罚等。所有偏好、模型使用和设置均保留在您的计算机上。
-
扩展:Jan 支持如 TensortRT 和 Inference Nitro 等扩展,用于自定义和增强您的 AI 模型。
使用 Jan 的益处
Jan 提供了一个干净且简单的界面来与 LLMs 交互,并且它将所有数据和处理信息本地化。它已经预装了超过七十个大型语言模型供您使用。这些现成可用的模型使得与远程 API(如 OpenAI 和 Mistral)连接和交互变得容易。Jan 还有很棒的 GitHub、Discord 和 Hugging Face 社区可以关注和寻求帮助。然而,像所有 LLM 工具一样,这些模型在 Apple Silicon Mac 上运行比在 Intel 上更快。
3. Llamafile
Llamafile 由 Mozilla 提供支持,Mozilla 的目标是支持并使开源 AI 对所有人可用,使用快速 CPU 推理且无需网络访问。它将LLMs转换为多平台可执行链接格式(ELF)。它提供了一种最佳选择,可以将 AI 集成到应用程序中,只需一个可执行文件即可运行LLMs。
如何使用 Llamafile
它设计用于将权重转换为多个可执行程序,这些程序无需安装即可在 Windows、MacOS、Linux、Intel、ARM、FreeBSD 等架构上运行。在幕后,Llamafile 使用 tinyBLAST 在 Windows 等操作系统上运行,无需 SDK。
Llamafile 的主要特性
-
可执行文件:与 LM Studio 和 Jan 等其他LLM工具不同,Llamafile 只需要一个可执行文件即可运行LLMs。
-
使用现有模型:Llamafile 支持使用现有模型工具,如 Ollama 和 LM Studio。
-
访问或创建模型:您可以访问来自 OpenAI、Mistral、Groq 等的流行LLMs,还可以支持从头开始创建模型。
-
模型文件转换:您可以使用单个命令将许多流行的LLMs文件格式,例如 .gguf 转换为 .llamafile 。
llamafile-convert mistral-7b.gguf
使用 Llamafile 入门

安装 Llamafile,请访问 Huggingface 网站,选择导航中的 Models,然后搜索 Llamafile。您也可以从下方的 URL 安装您所偏好的量化版本。https://huggingface.co/Mozilla/Meta-Llama-3.1-8B-Instruct-llamafile/tree/main
注意:量化数值越大,响应效果越好。如上图所示,本文中使用了 Meta-Llama-3.1-8B-Instruct.Q6_K.llamafile ,其中 Q6 代表量化数值。
步骤 1:下载 Llamafile
从上面的链接,点击任何下载按钮以获取您所需的版本。如果您在机器上安装了 wget 工具,可以通过下面的命令下载 Llamafile。
wget https://huggingface.co/Mozilla/Meta-Llama-3.1-8B-Instruct-llamafile/blob/main/Meta-Llama-3.1-8B-Instruct.Q6_K.llamafile
你应该替换 URL 为你喜欢的版本。
步骤 2:使 Llamafile 可执行
下载特定版本的 Llamafile 后,应通过导航至文件位置并使用以下命令使其可执行。
chmod +x Meta-Llama-3.1-8B-Instruct.Q6_K.llamafile
第三步:运行 Llamafile
在文件名前添加句点和斜线 ./ 来启动 Llamafile。
./Meta-Llama-3.1-8B-Instruct.Q6_K.llamafile
Llamafile 应用程序现在可以在 http://127.0.0.1:8080 处运行各种LLMs。

使用 Llamafile 的益处
Llamafile 通过使LLMs 对消费级 CPU 用户易于访问,帮助实现 AI 和 ML 的民主化。与类似本地应用 Llama.cpp 相比,Llamafile 提供了最快的提示处理体验和更好的游戏电脑性能。由于其性能更快,它非常适合用于总结长文本和大型文档。它完全离线运行且私密,因此用户不会将其数据共享到任何 AI 服务器或 API。像 Hugging Face 这样的机器学习社区支持 Llamafile 格式,使得搜索与 Llamafile 相关的模型变得容易。它还拥有一个优秀的开源社区,该社区开发并进一步扩展了它。
4. GPT4ALL

GPT4ALL 基于隐私、安全和无需互联网的原则构建。用户可以在 Mac、Windows 和 Ubuntu 上安装它。与 Jan 或 LM Studio 相比,GPT4ALL 的月下载量、GitHub 明星数和活跃用户更多。
GPT4ALL 的主要特性
GPT4All 可以在主要的消费级硬件上运行,如 Mac M 系列芯片、AMD 和 NVIDIA GPU。以下是其关键特性。
-
隐私优先:仅在您的机器上保留私密和敏感的聊天信息和提示。
-
无需互联网:它完全在离线状态下工作。
-
模型探索:此功能允许开发人员浏览并下载不同类型的LLMs以进行实验。您可以从流行选项中选择大约 1000 个开源语言模型,如 Llama、Mistral 等。
-
本地文档:您可以允许本地LLM使用本地文档如 .pdf 和 .txt 访问您的敏感数据,无需数据离开您的设备,也不需要网络。
-
定制选项:它提供了几个聊天机器人调整选项,如温度、批处理大小、上下文长度等。
-
企业版:GPT4ALL 提供包含安全、支持和按设备授权的企业套餐,将本地 AI 带入企业。
使用 GPT4All 入门
要开始使用 GPT4All 在本地运行LLMs,请下载适用于您操作系统的所需版本。
使用 GPT4ALL 的益处
除了 Ollama,GPT4ALL 拥有最多的 GitHub 贡献者和大约 250,000 个活跃用户(根据 https://www.nomic.ai/gpt4all),并且与竞争对手相比。该应用收集匿名用户数据关于使用分析和聊天共享。然而,用户可以选择加入或退出。使用 GPT4ALL,开发者受益于其庞大的用户基础、GitHub 和 Discord 社区。
5. Ollama

使用 Ollama,您可以轻松创建本地聊天机器人,而无需连接到 OpenAI 之类的 API。由于所有内容都在本地运行,因此您无需支付任何订阅或 API 调用费用。
Ollama 的主要特性
-
模型自定义:Ollama 允许您转换 .gguf 模型文件并使用 ollama run modelname 运行它们。
-
模型库:Ollama 在 ollama.com/library 中拥有大量可供尝试的模型。
-
导入模型:Ollama 支持从 PyTorch 导入模型。
-
社区集成:Ollama 无缝集成到网页和桌面应用程序中,如 Ollama-SwiftUI、HTML UI、Dify.ai 等。
-
数据库连接:Ollama 支持多个数据平台。
-
移动集成:类似于 Enchanted 的 SwiftUI 应用将 Ollama 带到 iOS、macOS 和 visionOS。Maid 也是一个跨平台的 Flutter 应用,可以与本地 .gguf 模型文件进行交互。
使用 Ollama 入门
首次使用 Ollama,请访问 https://ollama.com 并下载适用于您机器的版本。您可以在 Mac,Linux 或 Windows 上安装它。安装 Ollama 后,您可以通过以下命令在终端中检查其详细信息。
ollama
要运行特定的LLM,你应该通过以下方式下载它:
ollama pull modelname ,其中 modelname 是您想要安装的模型名称。请访问 GitHub 上的 Ollama 以获取一些示例模型进行下载。pull 命令也用于更新模型。使用后,只会获取差异。
下载完成后,例如 llama3.1 ,在命令行中运行 ollama run llama3.1 启动模型。

在上述示例中,我们提示 llama3.1 模型解决一个物理学功和能量问题。

使用 Ollama 的益处
Ollama 在 GitHub 上有超过 200 位贡献者,且有活跃的更新。它是上述讨论的 1001 个开源工具中贡献者最多的,且可扩展性更强。
6. LLaMa.cpp
 LLaMa.cpp 是底层后端技术(推理引擎),为本地 LLM 工具如 Ollama 等提供动力。LLaMa.cpp 支持显著大的语言模型推理,配置简单,各种硬件上的本地性能优秀。它也可以在云端运行。
LLaMa.cpp 的主要特性
-
设置:它具有极简的设置。您只需使用一个命令进行安装。
-
性能:它在本地和云端的各种硬件上表现非常出色。
-
支持的模型:它支持流行的和主要的 1001#,如 Mistral 7B,Mixtral MoE,DBRX,Falcon 等,以及其他许多模型。
-
前端 AI 工具:LLaMa.cpp 支持开源LLM UI 工具,如 MindWorkAI/AI-Studio(FSL-1.1-MIT),iohub/collama 等。
开始使用 LLaMa.cpp
要运行第一个本地大型语言模型 llama.cpp,你应该通过以下方式安装它:
brew install llama.cpp
接下来,从 Hugging Face 或其他任何来源下载您要运行的模型。例如,从 Hugging Face 下载下面的模型并将其保存在您的机器上的某个位置。
https://huggingface.co/MaziyarPanahi/Mistral-7B-Instruct-v0.3-GGUF/resolve/main/Mistral-7B-Instruct-v0.3.Q4_K_M.gguf
使用您首选的命令行工具,如 Terminal,将 cd 号文件夹导航到您刚刚下载的 .gguf 模型文件的位置,然后运行以下命令。
llama-cli --color \ -m Mistral-7B-Instruct-v0.3.Q4_K_M.ggufb \ -p "Write a short intro about SwiftUI"
总结来说,首先调用 LLaMa 命令行工具并设置颜色和其他标志。-m 标志指定您要使用的模型路径。-p 标志指定您希望使用的提示,以指导模型。
运行上述命令后,您将在以下预览中看到结果。

本地 LLMs 使用案例
本地运行LLMs可以帮助开发者了解他们的性能和工作细节。本地LLMs可以查询私有文档和技术论文,确保这些文档的信息不会通过查询设备查询到任何云 AIAPI。本地LLMs在无网络或网络接收差的地点非常有用。
在远程医疗环境中,本地LLMs可以对患者文件进行分类,无需将它们上传到任何 AI API 提供商,因为存在隐私问题。
评估LLMs的性能以进行本地运行
在本地使用大型语言模型之前了解其性能对于获得所需响应至关重要。有几种方法可以确定特定LLM的性能。以下是几种方法。
-
训练:模型是在哪个数据集上训练的?
-
微调:模型可以定制到什么程度来执行特定任务,或者它可以微调到什么特定领域?
-
学术研究:1001# 是否有学术研究论文?
为了回答上述问题,您可以检查如 Hugging Face 和 Arxiv.org 等优秀资源。同时,打开LLm排行榜和 LMSYS 聊天机器人竞技场提供了各种LLMs的详细信息和基准。
本地 LLM 工具 结论
如本文所述,选择和在本地使用大型语言模型的动机存在几个。如果您不想将您的数据集发送到 AI API 提供商的互联网上,可以将模型微调以在远程医疗应用程序中执行特定任务。许多开源图形用户界面(GUI 基础)本地 LLM 工具,如 LLm 工具和 Jan,提供了无需订阅服务如 OpenAI 或 Claude 的直观前端 UI,用于配置和实验 LLMs。您还发现了各种强大的命令行 LLM 应用程序,如 Ollama 和 LLaMa.cpp,这些应用程序帮助您在本地和无互联网连接的情况下运行和测试模型。
AI大模型学习福利
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
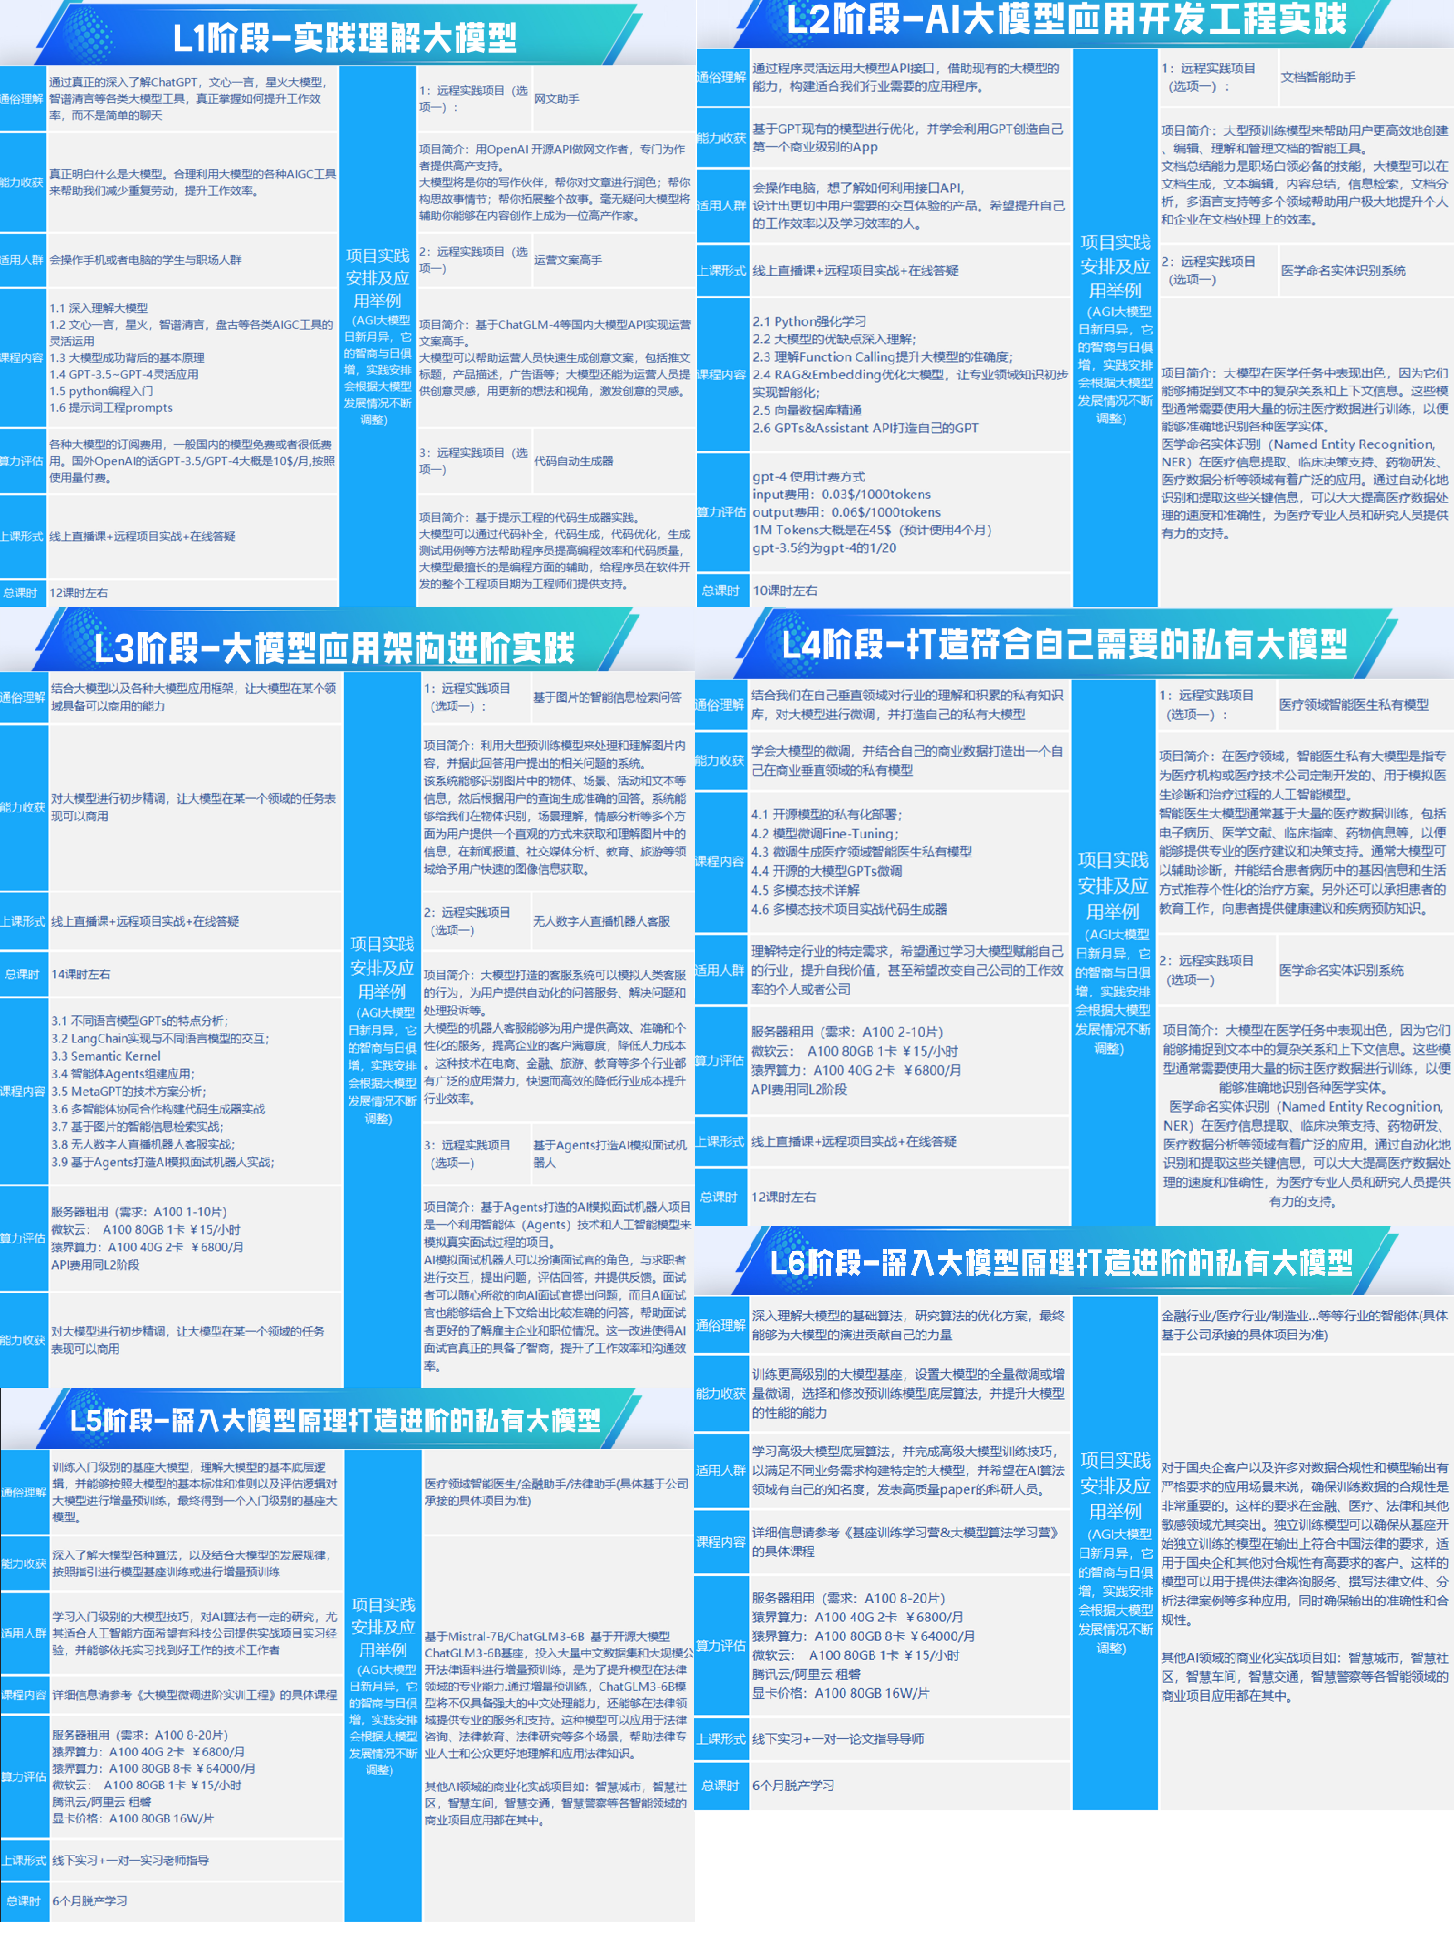
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
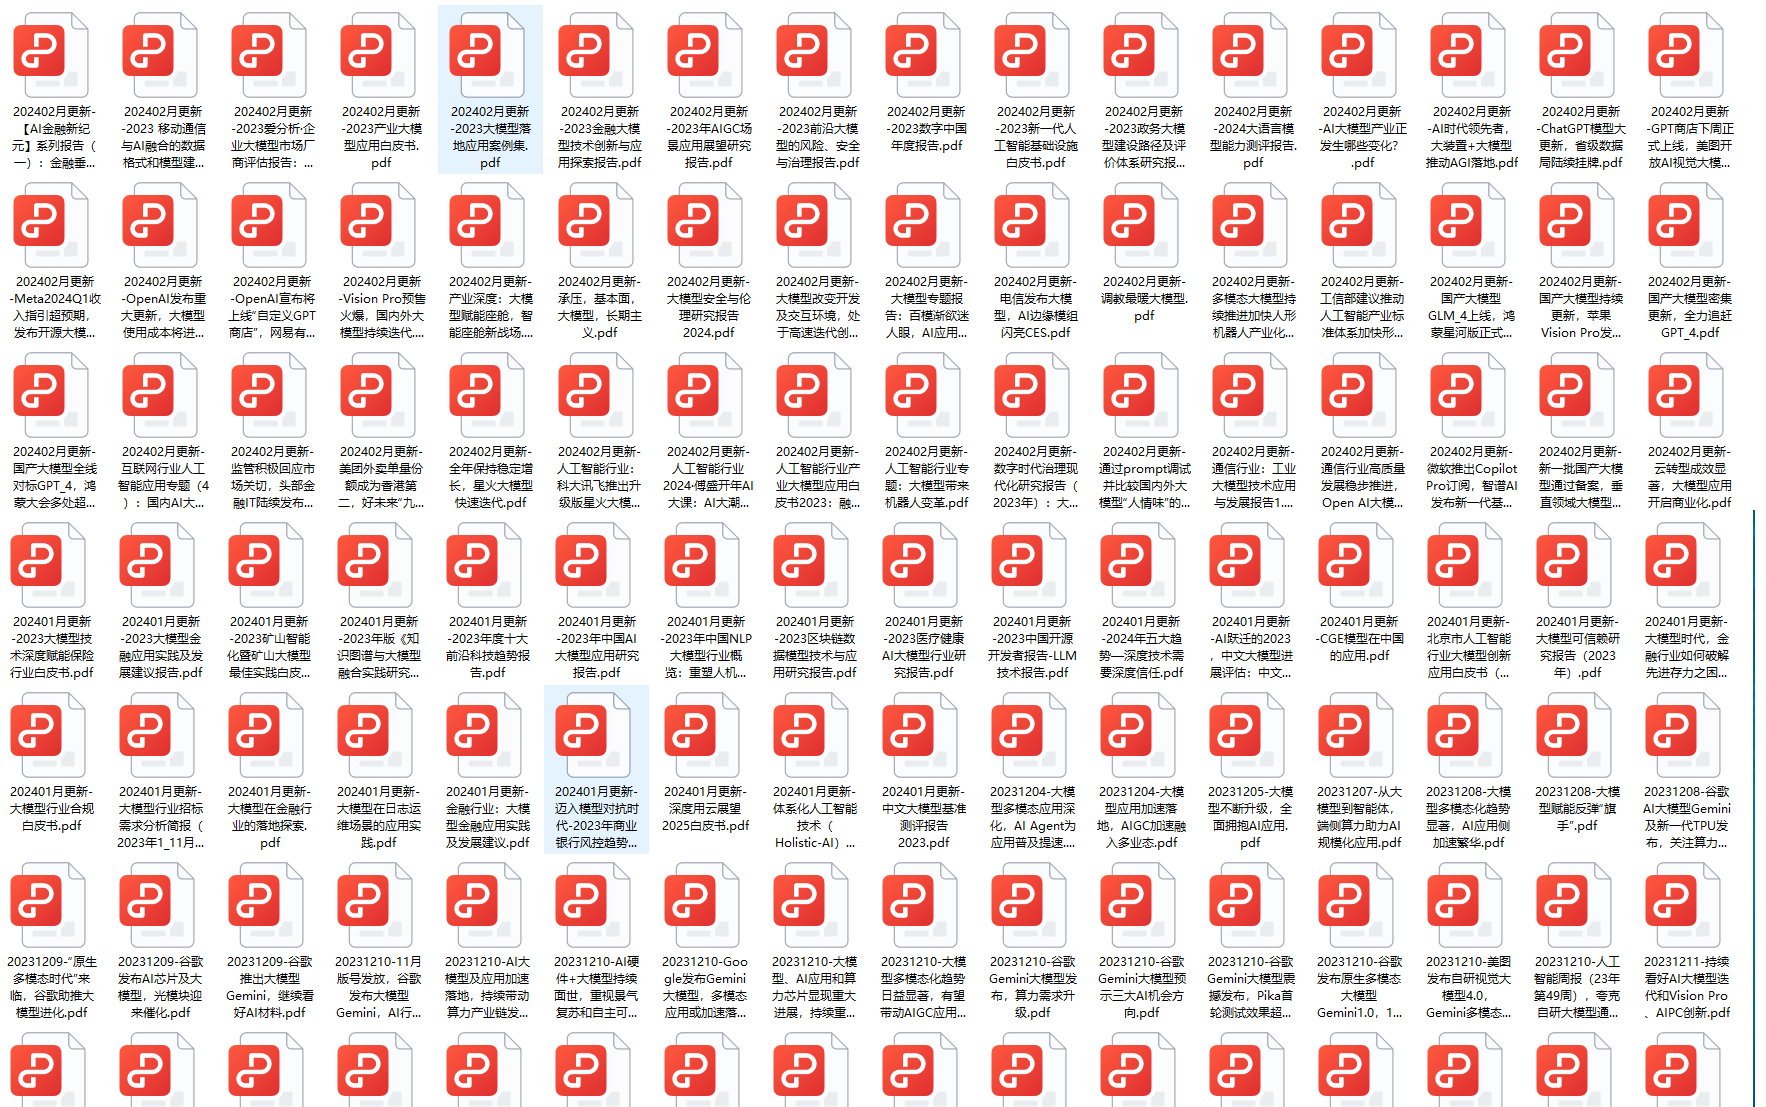
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
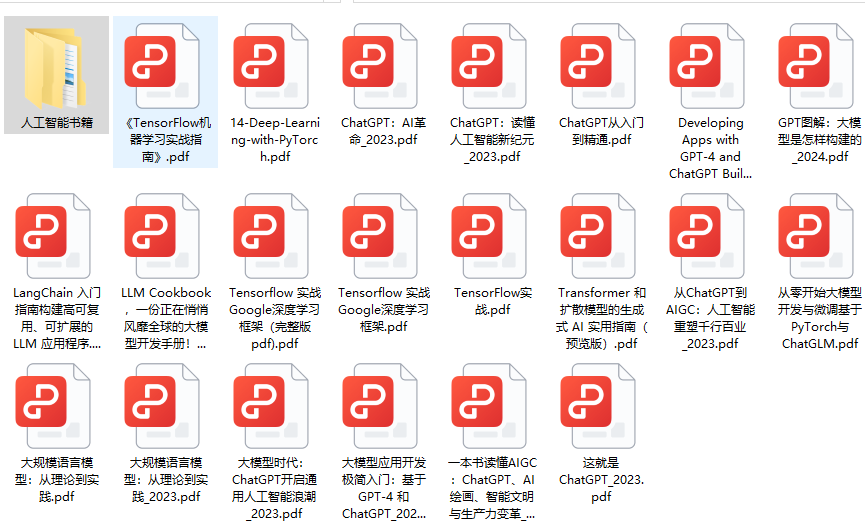
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
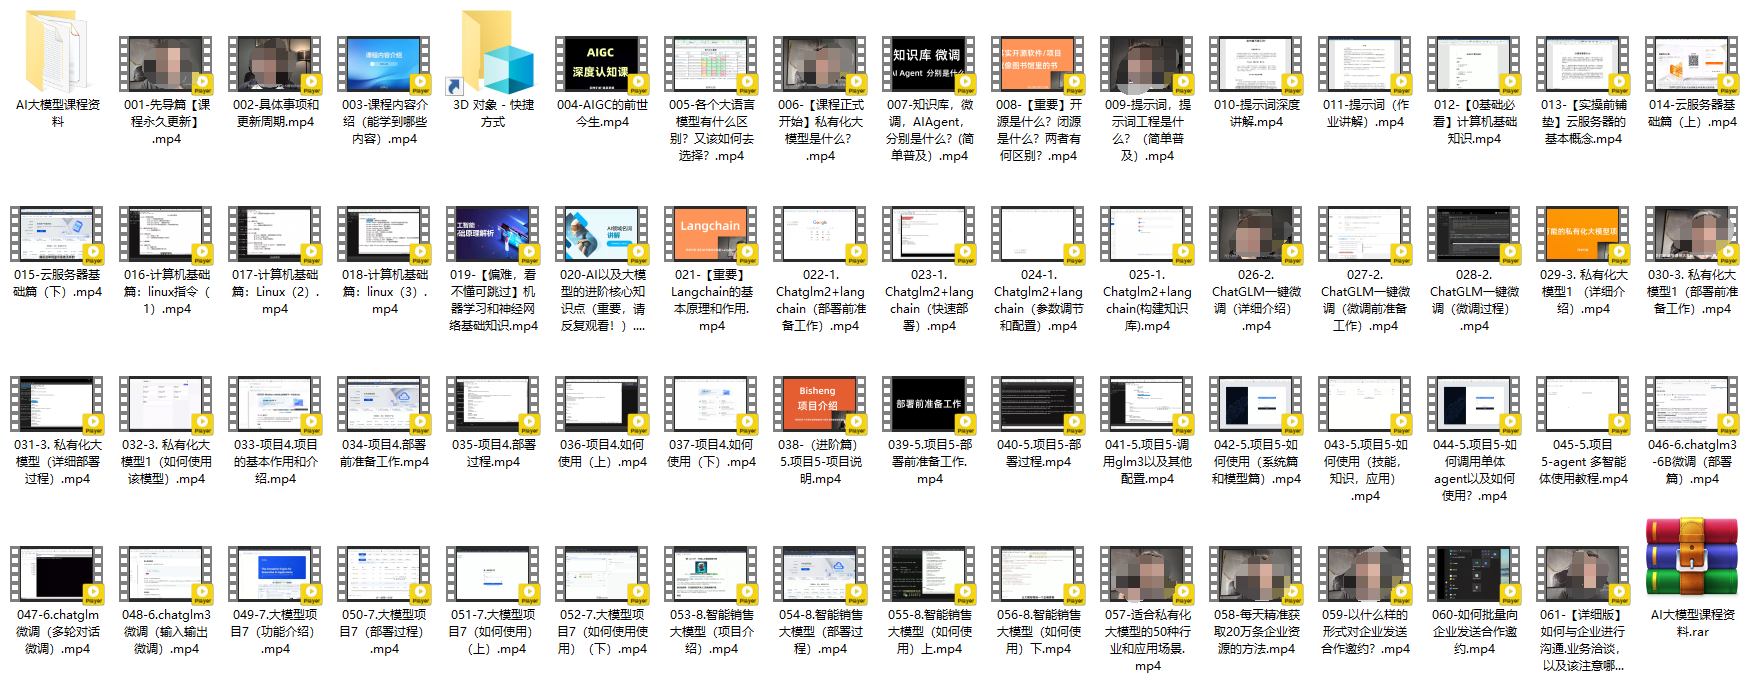
四、AI大模型商业化落地方案
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。



 1135


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


