


近日,国内的一款微调框架发布了自己的论文《LLAMAFACTORY: Unified Efficient Fine-Tuning of 100+ Language Models》,对他们的框架做了系统性的总结。该框架自推出后迅速出圈,现已斩获15.6k的star,逐步成为当下微调的首选工具。
https://arxiv.org/pdf/2403.13372.pdf
模型微调相较于上下文学习来讲,存在比较高的门槛,但又是模型专业化,领域化不可或缺的技术手段。而其复杂性突出表现在这些方面:
1)理论基础,如果说基于大模型写prompt 根据一定范式来构建RAG或者Agent不需要太多机器学习理论知识,然而微调就必须要对这些有理解,比如样本,学习率,logloss等。
2)数据准备,对于普通开发者,高质量的数据是微调成功的关键保证,而如何预处理,清洗,标注这些样本本身就很复杂,更因此诞生了大模型数据工程这样的领域来解决这一问题。
3)基座模型存在分化,虽然当下很多模型都参考llama和huggingface的一些规范,但是仍然都有一些特殊之处,想要微调也需要针对性地去分析和构建相应的策略。
4)超参数优化,微调本身是一个“炼丹”过程,如何能够找到合适的超参数,达到一个最佳性能,是一个重大挑战。
5)AI工程复杂性,涉及到硬件\软件\复杂流程的协同配合以及系统优化,在有限的成本、资源和时间要求下完成模型训练过程。
正是因为这些原因,对于预训练微调,需要一个类似于工厂的工业化手段来降低门槛,提升效率。
因此,行业内出现了很多微调框架,而LLamaFactory(https://github.com/hiyouga/LLaMA-Factory)便是其中之一,从起名上就可以看出它们的目标是成为模型微调的工厂。
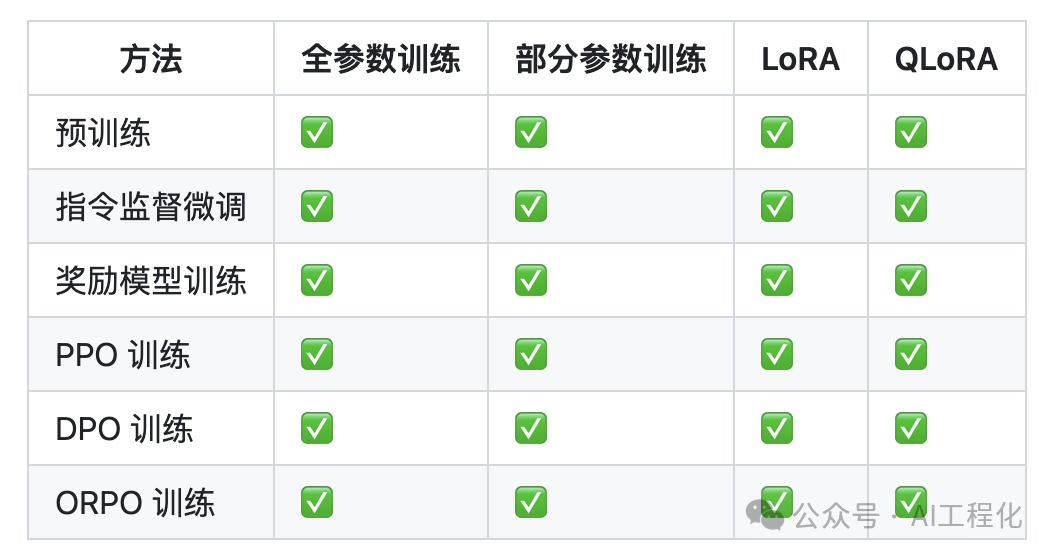
它得以流行主要得益于支持当下主流的大模型百川、千问、LLaMA等,不仅集成了大模型预训练、监督微调和强化微调等阶段的主流的微调技术(支持 LoRA 和 QLoRA 等参数高效微调策略),还提供了预训练、指令微调等丰富的数据集,方便参考使用,最重要的是提供了一个无代码的图形界面,大幅降低使用门槛,非开发者也可以方便地完成模型微调。
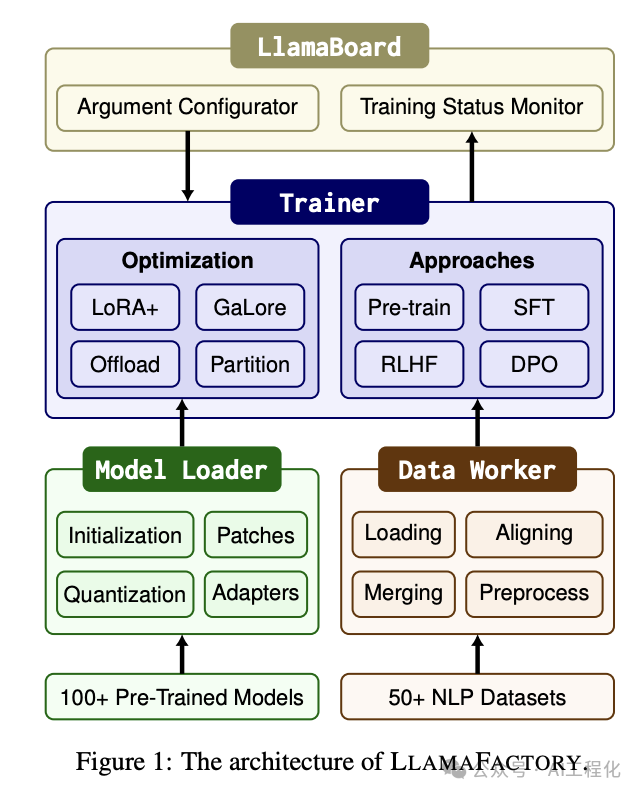
该框架架构上由四个模块构成:模型加载器、数据工作器和训练器,以及用户界面LlamaBoard。
在根据官方文档安装好LLamaFactory后,可以有三种方式进行操作,WebUI、CLI或者Python。
1.webUI。
CUDA_VISIBLE_DEVICES=0 python src/train_web.py
2.CLI,由于有时候界面限制,可能需要命令行的方式进行微调。如果不知道具体格式,可以在界面上配置好,再复制到命令行中调整使用。
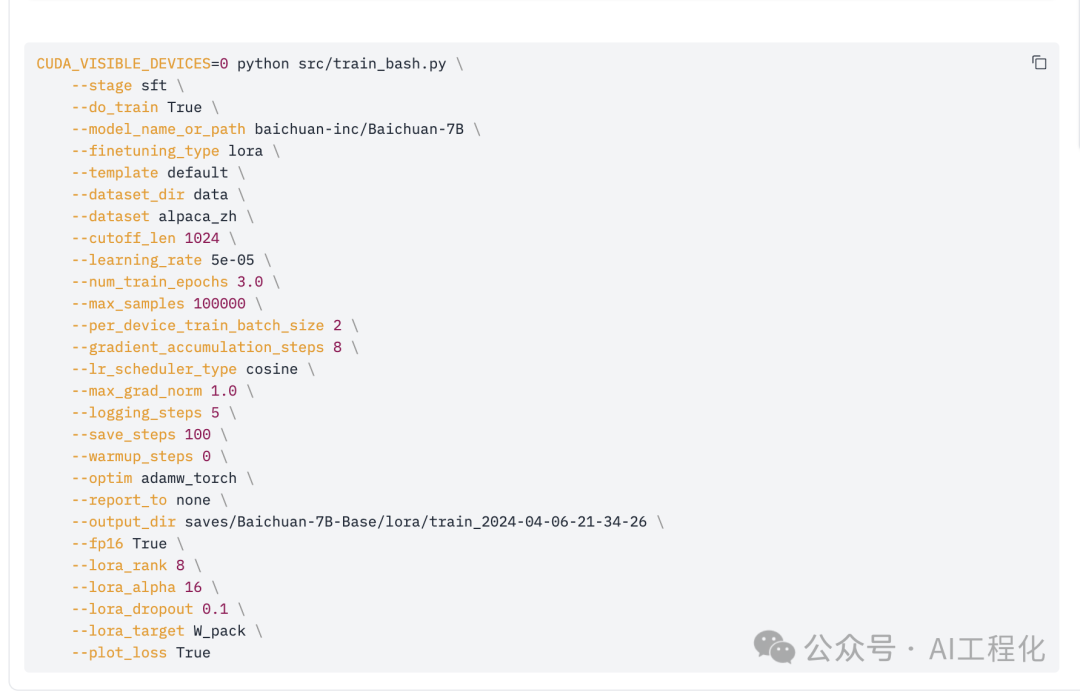
在example目录中有大量的示例可供参考。
examples/``├── lora_single_gpu/``│ ├── pretrain.sh: 进行预训练``│ ├── sft.sh: 进行指令监督微调``│ ├── reward.sh: 进行奖励模型训练``│ ├── ppo.sh: 进行 PPO 训练``│ ├── dpo.sh: 进行 DPO 训练``│ ├── orpo.sh: 进行 ORPO 训练``│ ├── prepare.sh: 保存预处理后的数据集``│ └── predict.sh: 进行批量预测``├── qlora_single_gpu/``│ ├── bitsandbytes.sh: 微调 4/8 比特 BNB 模型``│ ├── gptq.sh: 微调 4/8 比特 GPTQ 模型``│ ├── awq.sh: 微调 4 比特 AWQ 模型``│ └── aqlm.sh: 微调 2 比特 AQLM 模型``├── lora_multi_gpu/``│ ├── single_node.sh: 使用 Accelerate 进行单节点训练``│ └── multi_node.sh: 使用 Accelerate 进行多节点训练``├── full_multi_gpu/``│ ├── single_node.sh: 使用 DeepSpeed 进行单节点训练``│ └── multi_node.sh: 使用 DeepSpeed 进行多节点训练``├── merge_lora/``│ ├── merge.sh: 将 LoRA 权重合并到预训练模型中``│ └── quantize.sh: 使用 AutoGPTQ 量化模型``├── inference/``│ ├── cli_demo.sh: 启动命令行推理接口``│ ├── api_demo.sh: 启动 OpenAI 风格 API``│ ├── web_demo.sh: 启动浏览器推理接口``│ └── evaluate.sh: 在 MMLU 数据集上评测模型``└── extras/` `├── galore/` `│ └── sft.sh: 使用 GaLore 训练模型` `├── loraplus/` `│ └── sft.sh: 使用 LoRA+ 训练模型` `├── llama_pro/` `│ ├── expand.sh: 扩展模型中的层` `│ └── sft.sh: 训练扩展后的模型` `└── fsdp_qlora/` `└── sft.sh: 使用 FSDP 微调量化模型
3)编程方式。
from llmtuner import run_exp``run_exp(dict(` `stage="sft",` `do_train=True,` `model_name_or_path="Qwen/Qwen1.5-0.5B-Chat",` `dataset="identity,alpaca_gpt4_en,alpaca_gpt4_zh",` `template="qwen",` `finetuning_type="lora",` `lora_target="all",` `output_dir="test_identity",` `per_device_train_batch_size=4,` `gradient_accumulation_steps=4,` `lr_scheduler_type="cosine",` `logging_steps=10,` `save_steps=100,` `learning_rate=1e-4,` `num_train_epochs=5.0,` `max_samples=500,` `max_grad_norm=1.0,` `fp16=True,``))
对于用户来讲,准备正确高质量的数据是用好该工具的关键。在使用自定义数据集时需要在 dataset_info.json 文件中按照以下格式提供数据集定义,数据集格式支持两种:alpaca 和 sharegpt,具体可参考其官方文档。
"数据集名称": {` `"hf_hub_url": "Hugging Face 的数据集仓库地址(若指定,则忽略 script_url 和 file_name)",` `"ms_hub_url": "ModelScope 的数据集仓库地址(若指定,则忽略 script_url 和 file_name)",` `"script_url": "包含数据加载脚本的本地文件夹名称(若指定,则忽略 file_name)",` `"file_name": "该目录下数据集文件的名称(若上述参数未指定,则此项必需)",` `"file_sha1": "数据集文件的 SHA-1 哈希值(可选,留空不影响训练)",` `"subset": "数据集子集的名称(可选,默认:None)",` `"folder": "Hugging Face 仓库的文件夹名称(可选,默认:None)",` `"ranking": "是否为偏好数据集(可选,默认:False)",` `"formatting": "数据集格式(可选,默认:alpaca,可以为 alpaca 或 sharegpt)",` `"columns(可选)": {` `"prompt": "数据集代表提示词的表头名称(默认:instruction)",` `"query": "数据集代表请求的表头名称(默认:input)",` `"response": "数据集代表回答的表头名称(默认:output)",` `"history": "数据集代表历史对话的表头名称(默认:None)",` `"messages": "数据集代表消息列表的表头名称(默认:conversations)",` `"system": "数据集代表系统提示的表头名称(默认:None)",` `"tools": "数据集代表工具描述的表头名称(默认:None)"` `},` `"tags(可选,用于 sharegpt 格式)": {` `"role_tag": "消息中代表发送者身份的键名(默认:from)",` `"content_tag": "消息中代表文本内容的键名(默认:value)",` `"user_tag": "消息中代表用户的 role_tag(默认:human)",` `"assistant_tag": "消息中代表助手的 role_tag(默认:gpt)",` `"observation_tag": "消息中代表工具返回结果的 role_tag(默认:observation)",` `"function_tag": "消息中代表工具调用的 role_tag(默认:function_call)",` `"system_tag": "消息中代表系统提示的 role_tag(默认:system,会覆盖 system 列)"` `}``}
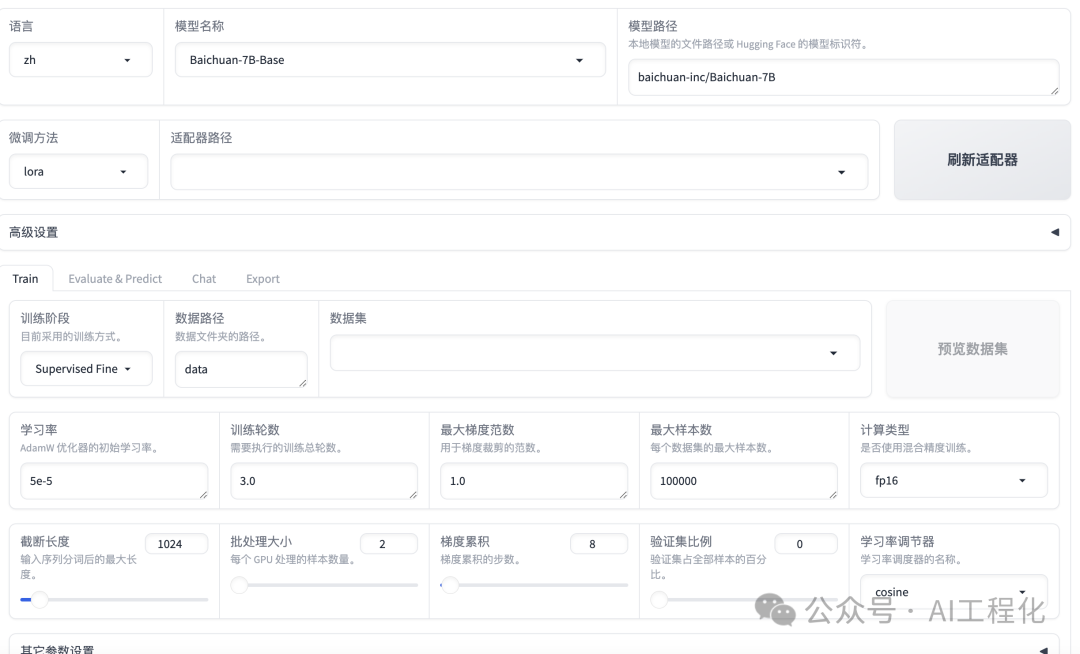
经过以上的步骤,剩下的就是需要耐心的调参和评估了。下面是一个利用webui进行微调操作示例。
小结
相较于其他方法,目前,LlamaFactory可以说是当下最简单快捷又功能强大的一种微调工具,值得大家学习使用。
AI大模型学习福利
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
四、AI大模型商业化落地方案

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。



 3201


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


