Python爬虫来实现Cookie模拟登录

python爬虫实践之模拟登录 有些网站设置了权限,只有在登录了之后才能爬取网站的内容,如何模拟登录,目前的方法主要是利用浏览器cookie模拟登录。 浏览器访问服务器的过程 在用户访问网页时,不论是通过URL输入域名或IP,还是点击链接,浏览器向WEB服务器发出了一个HTTP请求(Http Request),WEB服务器接收到客户端浏览器的请求之后,响应客户端的请求,发回相应的响应信息(Http Response) 阅读详情

在使用爬虫采集数据的规程中,我们会遇到许多不同类型的网站,比如一些网站需要用户登录后才允许查看相关内容,如果遇到这种类型的网站,又应该如何编写爬虫程序呢?Cookie 模拟登录技术成功地解决了此类问题。

Cookie 是一个记录了用户登录状态以及用户属性的加密字符串。当你第一次登陆网站时,服务端会在返回的 Response Headers 中添加 Cookie, 浏览器接收到响应信息后,会将 Cookie 保存至浏览器本地存储中,当你再次向该网站发送请求时,请求头中就会携带 Cookie,这样服务器通过读取 Cookie 就能识别登陆用户了。

提示:我们所熟知的“记住密码”功能,以及“老用户登陆”欢迎语,这些都是通过 Cookie 实现的。

下面介绍如何实现 Cookie 模拟登录,本节以模拟登录人人网(http://life.renren.com/)为例进行讲解。

注册登录

首先你要注册一个人人网的账号,注册过中要填写个人资料,以便后续抓取数据使用。注册成功后点击上方头像进入我的主页(或左侧主页选项卡),如下图所示:
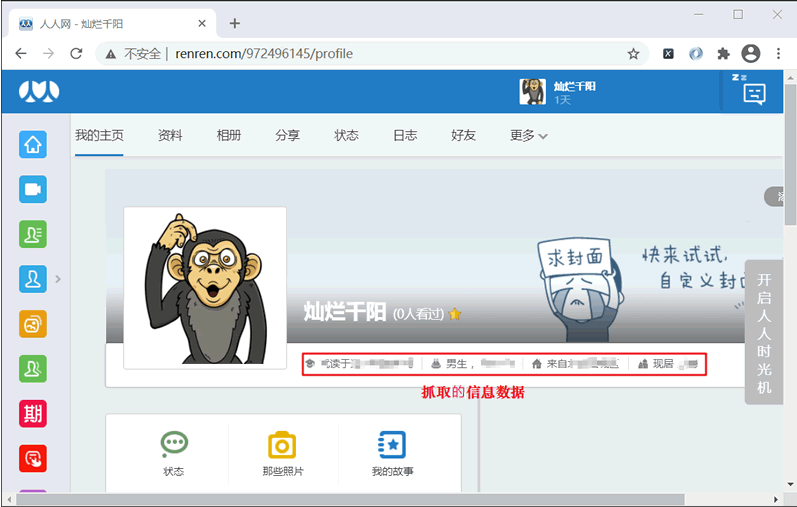
图1:人人网主界面

然后使用 F12 打开调试工具,刷新页面来抓取登录时的数据包(包名:timeline…开头), 并在 Headers 选项中找到请求头中的 Cookie 信息,将 Cookie 值拷贝下来,以备后续使用。如下所示:
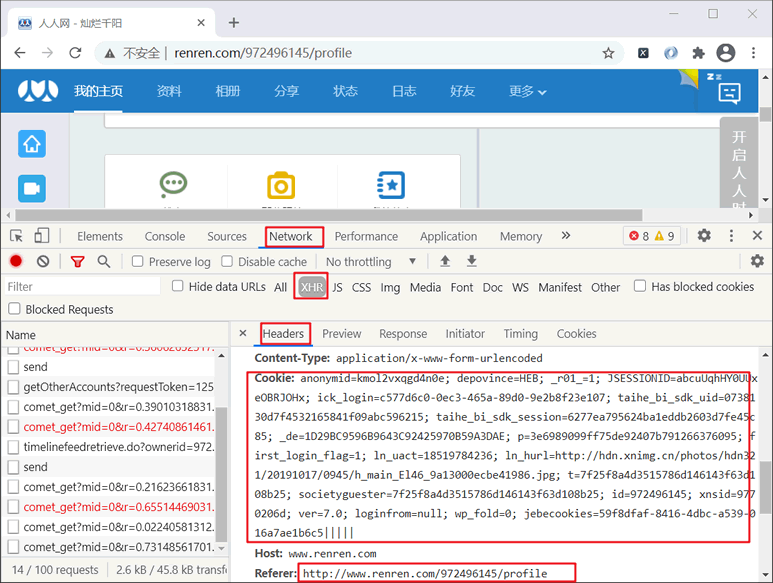

图2:浏览Headers信息

分析网页结构

确定了 Cookie 信息后,接下来分析页面元素结构。通过调试工具审查如图 1 所示的个人信息栏,其元素结构如下:

    • 就读于电子科技大学
    • 男生
    • ,7月7日
    • 来自北京西城区
    • 现居 北京
    • …

    由此可知其 Xpath 表达式为:

    **

    r_school = parse_html.xpath('//*[@id="operate_area"]/div[1]/ul/li[1]/span/text()'
    r_birthday = parse_html.xpath('//li[@class="birthday"]/span/text()')
    home_info=parse_html.xpath('//*[@id="operate_area"]/div[1]/ul/li/text()')
    

    编写完整程序

    完成程序如下所示:

    1. import requests
    2. from lxml import etree
    3. class RenrenLogin(object):
    4. def init(self):
    5. 个人主页的url地址

    6.  self.url = 'http://www.renren.com/972496145/profile'
      
    7.  self.headers = {
      
    8.    # 将拷贝的cookie值放在此处
      
    9.    'Cookie':'anonymid=kmol2vxqgd4n0e; depovince=HEB; _r01_=1; ick_login=c577d6c0-0ec3-465a-89d0-9e2b8f23e107; taihe_bi_sdk_uid=0738130d7f4532165841f09abc596215; taihe_bi_sdk_session=6277ea795624ba1eddb2603d7fe45c85; _de=1D29BC9596B9643C92425970B59A3DAE; p=3e6989099ff75de92407b791266376095; first_login_flag=1; ln_uact=18519784236; ln_hurl=http://hdn.xnimg.cn/photos/hdn321/20191017/0945/h_main_El46_9a13000ecbe41986.jpg; t=7f25f8a4d3515786d146143f63d108b25; societyguester=7f25f8a4d3515786d146143f63d108b25; id=972496145; xnsid=9770206d; wpsid=15900539012757; ver=7.0; loginfrom=null; wp_fold=0; jebecookies=59f8dfaf-8416-4dbc-a539-016a7ae1b6c5|||||',
      
    10.    # 注意,useragent不能改变,否则cookie失效
      
    11.    'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/89.0.4389.90 Safari/537.36'
      
    12.  }
      
    13. def get_html(self):
    14.  html = requests.get(url=self.url,headers=self.headers).text
      
    15.  self.parse_html(html)
      
    16. def parse_html(self,html):
    17.  parse_html = etree.HTML(html)
      
    18.  r_school = parse_html.xpath('//*[@id="operate_area"]/div[1]/ul/li[1]/span/text()')
      
    19.  print(r_school)
      
    20.  r_birthday = parse_html.xpath('//li[@class="birthday"]/span/text()')
      
    21.  print(r_birthday)
      
    22.  home_info=parse_html.xpath('//*[@id="operate_area"]/div[1]/ul/li/text()')
      
    23.  item = {}
      
    24.  item['hometown'] = home_info[2].strip()
      
    25.  item['address'] = home_info[3].strip()
      
    26.  print(item)
      
    27. if name == ‘main’:
    28. spider = RenrenLogin()
    29. spider.get_html()

    最后关闭“人人网”网站,运行上述程序,其结果如下:

    **

    ['就读于电子科技大学']
    ['男生', ',7月7日']
    {'hometown': '来自 北京 西城区', 'address': '现居 上海'}
    

    这里给大家分享一份Python全套学习资料,包括学习路线、软件、源码、视频、面试题等等,都是我自己学习时整理的,希望可以对正在学习或者想要学习Python的朋友有帮助!

    优快云大礼包:全网最全《全套Python学习资料》免费分享🎁

    😝有需要的小伙伴,可以点击下方链接免费领取或者V扫描下方二维码免费领取🆓

    👉优快云大礼包🎁:全网最全《Python学习资料》免费分享(安全链接,放心点击)👈

    ​

    1️⃣零基础入门

    ① 学习路线

    对于从来没有接触过Python的同学,我们帮你准备了详细的学习成长路线图。可以说是最科学最系统的学习路线,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。
    在这里插入图片描述

    ② 路线对应学习视频

    还有很多适合0基础入门的学习视频,有了这些视频,轻轻松松上手Python~在这里插入图片描述

    ③练习题

    每节视频课后,都有对应的练习题哦,可以检验学习成果哈哈!
    在这里插入图片描述
    因篇幅有限,仅展示部分资料

    2️⃣国内外Python书籍、文档

    ① 文档和书籍资料

    在这里插入图片描述

    3️⃣Python工具包+项目源码合集

    ①Python工具包

    学习Python常用的开发软件都在这里了!每个都有详细的安装教程,保证你可以安装成功哦!
    在这里插入图片描述

    ②Python实战案例

    光学理论是没用的,要学会跟着一起敲代码,动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。100+实战案例源码等你来拿!
    在这里插入图片描述

    ③Python小游戏源码

    如果觉得上面的实战案例有点枯燥,可以试试自己用Python编写小游戏,让你的学习过程中增添一点趣味!
    在这里插入图片描述

    4️⃣Python面试题

    我们学会了Python之后,有了技能就可以出去找工作啦!下面这些面试题是都来自阿里、腾讯、字节等一线互联网大厂,并且有阿里大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。
    在这里插入图片描述
    在这里插入图片描述

    5️⃣Python兼职渠道

    而且学会Python以后,还可以在各大兼职平台接单赚钱,各种兼职渠道+兼职注意事项+如何和客户沟通,我都整理成文档了。
    在这里插入图片描述
    在这里插入图片描述
    上述所有资料 ⚡️ ,朋友们如果有需要 📦《全套Python学习资料》的,可以扫描下方二维码免费领取 🆓
    😝有需要的小伙伴,可以点击下方链接免费领取或者V扫描下方二维码免费领取🆓

    👉优快云大礼包🎁:全网最全《Python学习资料》免费分享(安全链接,放心点击)👈

    ​

    【Python进阶】网络爬虫核心技能——携带cookies(模拟登录和会话状态保存) 本文系统讲解了网络爬虫开发中的Cookie和Session技术。主要内容包括:1)Cookie的定义、功能和工作原理;2)在爬虫中携带Cookie的两种方式;3)使用Session对象简化会话管理。文章还扩展了Cookie属性、Cookie池构建等高级内容,并通过笔趣阁登录案例演示实践应用。这些技术是爬虫处理身份认证的关键,从基础Session使用到高级Cookie池调度,为不同规模的爬虫项目提供了解决方案指南。 阅读详情

    相关推荐

    Python网络爬虫实战——模拟登录!

    对于一个网站的首页来说,它可能需要你进行登录,比如知乎,同一个URL下,你登录与未登录当然在右上角个人信息那里是不一样的。 Python资源共享群:626017123 (登录过) (未登录) 那么你在用爬虫爬取的时候获得的页面究竟是哪个呢? 肯定是第二个,不可能说你不用登录就可以访问到一个用户自己的主页信息,那么是什么让同...

    Pythoncxy的博客 1098

    『python爬虫』12. 模拟登陆之cookie的使用(保姆级图文)

    『python爬虫』12. 模拟登陆之cookie的使用(保姆级图文)

    MZH 3756

    python实现简单爬虫模拟登录淘宝(cookie简介)

    试验了一个晚上,python的小爬虫还是挺可爱的,简单

    Weiguozheng的学习总结 1万+

    Python爬虫——Cookie模拟登录

    现在很多网站需要用户成功登录后才可以查看相关内容。使用Cookie 模拟登录可以很好地解决这种问题。Cookie 是指某些网站服务器为了辨别用户身份和进行Session跟踪,而储存在用户浏览器上的文本文件,Cookie是一个记录了用户登录状态以及用户属性的加密字符串,Cookie可以保持登录信息到用户下次与服务器的会话。Cookie 以键 / 值对形式存储。Cookie 验证流程:当用户第一次登陆网站时,服务端会在返回的响应头 Response Headers 中添加 Cookie数据, 浏览器接收到响应头

    万里顾一程的博客 6298

    Python模拟登录获取Cookie

    通过模拟登录操作,我们可以获取到登录后的Cookie信息,这对于后续的数据爬取或者自动化操作非常有用。通过上述的示例代码,你可以使用Python模拟登录获取Cookie信息。需要注意的是,每个网站的登录方式可能不同,所以你需要根据具体的网站登录方式进行相应的修改。此外,有些网站可能使用验证码等机制来增加登录的安全性,这需要进一步的处理和调整。然后,我们构造了登录请求的URL和数据,将用户名和密码作为表单数据发送给服务器。库,它是一个常用的HTTP请求库,可以用于发送HTTP请求和处理响应。

    Meta_C的博客 918

    Python 爬虫实战:如何处理 Cookie 与 Session 实现模拟登录,轻松抓取身份验证页面数据

    本文介绍了使用Python爬虫模拟登录网站的方法,重点讲解了Cookie和Session的原理及处理流程。文章详细演示了如何通过requests库实现基本登录请求、维持会话状态,并针对验证码和高级反爬机制提供了解决方案,包括OCR识别验证码、使用代理池和Selenium自动化工具。这些技术能有效抓取需要身份验证的网页数据,为处理动态内容和反爬机制提供了实用方法。

    专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1116

    python爬虫爬网页部分内容空白,但源码可以看到,已解决

    python爬虫爬网页部分内容空白,但源码可以看到,已解决 曾尝试各种方法,没有效果。使用的是函数requests.get(),已写header、cookie、User-Agent,也写了rsp.encoding = rsp.apparent_encoding。 但是仍是爬取不了。奇怪的同一个网站同一个榜单,只是页数不同,前若干页能爬取,后若干页就爬取不了,一度怀疑是不允许爬。 最后终于发现原因!...

    一只瞪着你的小饕餮柠檬精的博客 9822

    Python 爬虫黑科技:微信网页版模拟登录(Cookie 注入 + 消息监听实现)

    微信作为国内领先的社交平台,拥有庞大的用户群体和丰富的功能生态。传统的爬虫技术在微信这类拥有复杂反爬机制的平台上面临诸多挑战。本文介绍的模拟登录技术,通过 Cookie 注入绕过部分验证流程,并结合消息监听实现微信消息的实时监控,为微信数据挖掘和自动化应用提供创新思路。

    yansideyucsdn的博客 2504

    爬虫——cookie模拟登陆

    cookie适用于抓取需要登录才能访问的页面网站 cookie和session机制 http协议为无连接协议,cookie: 存放在客户端浏览器,session: 存放在Web服务器 人人网登录案例 方法一:登录网站手动抓取Cookie 1、先登录成功1次,获取到携带登陆信息的Cookie 登录成功 - 个人主页(http://www.renren.com/971...

    凌逆战的博客 693

    半桥LLC谐振变换器及同步整流MATLAB仿真(二)

    接上文,半桥LLC谐振变换器及同步整流MATLAB仿真

    qq_55203246的博客 4330

    Adams与matlab联合仿真的一些小技巧

    Adams与simulink联合仿真之快速设置初值 去年到现在一直做的两个项目要用到Adams与simulnk联合仿真,虽然网上有很多这方面的教程,但都比较基本,要实现一些稍微复杂的要求就比较困难了,比如我需要改变模型的初始位姿,原来的方式是在adams中设置,再生成联合仿真需要的文件,再在matlab中进行调用和仿真,如果工况多的话这样就特别耗时耗力,进过长时间的摸索,终于找出了在matlab中直接改变Adams模型参数的方法,下面具体说明一下。 我这里的模型是一个小球通过弹簧连接在坐标原点,仿真开始后

    weixin_40962901的博客 4785

    Python爬虫实现Cookie模拟登录

    Python爬虫实现Cookie模拟登录 在使用爬虫采集数据的规程中,我们会遇到许多不同类型的网站,比如一些网站需要用户登录后才允许查看相关内容,如果遇到这种类型的网站,又应该如何编写爬虫程序呢?Cookie 模拟登录技术成功地解决了此类问题。 Cookie 是一个记录了用户登录状态以及用户属性的加密字符串。当你第一次登陆网站时,服务端会在返回的 Response Headers 中添加 Cookie, 浏览器接收到响应信息后,会将 Cookie 保存至浏览器本地存储中,当你再次向该网站发送请求时,请求头中

    ccc369639963的博客 1万+

    【深度学习】基于BERT模型的情感分析(附实战完整代码+数据集)

    情感分类是一个快速发展的研究领域,尽管众多模型和数据集在二分类任务中显示出很高的准确性,但细粒度的情感分类任务仍然是一个很大改进空间的领域。分析SST-5数据集,Munikar等人的先前工作表明,嵌入工具BERT允许使用简单的模型来实现最新的准确性。

    aaaa_hsjsueu的博客 2万+

    【Python】【进阶篇】二十、Python爬虫实现Cookie模拟登录

    【Python】【进阶篇】二十、Python爬虫实现Cookie模拟登录

    deepboat的博客 868

    【滤波跟踪】多雷达协同下的多目标跟踪:航迹管理优化与卡尔曼滤波融合策略

    本文深入探讨了多雷达协同下的多目标跟踪技术,聚焦于航迹管理优化与卡尔曼滤波融合策略两大核心。通过分析分布式融合架构、航迹关联算法(如匈牙利算法)以及应对非线性与机动目标的扩展卡尔曼滤波(EKF)与无迹卡尔曼滤波(UKF)等方法,旨在解决多源信息融合难题,提升复杂环境下目标跟踪的精度与鲁棒性。

    weixin_29214199的博客 281

    2024年全国大学生电子设计竞赛H题_自动行驶小车

    自动行驶小车(H题)【本科组/高职高专组】

    qq_74395263的博客 1万+

    Python Requests库实现模拟登录全攻略

    本文介绍了使用Python Requests库实现模拟登录的核心技术与实践。主要内容包括:1. 模拟登录的必要性,如获取需身份验证的网页内容;2. Cookie与Session机制的原理及差异,Cookie存储在客户端,Session在服务器端;3. 两种模拟登录方法:直接携带Cookie和使用Session对象维持会话;4. 通过豆瓣网站的实际案例,演示了分析登录URL、构造请求参数、创建会话和验证登录状态的完整流程。文章强调理解状态保持机制的重要性,并展示了Requests库在模拟登录中的高效应用。

    2401_89720799的博客 2271

    LTE网络下的SMS收发(SMS Over SGs方案的详细流程)

    关键词: IMS,SMS, LTE, MSC, MME, EPS,eNodeB, SMS Over SGs, SMS Over IMS 2G时代由于采用了比较复杂的CS/PS域架构,所以SMS(短信)作为上个世纪的产物,一直寄居在2G的CS域架构下。看看核心网的配置,其实SMS的收发还是比较复杂的。 介绍下面的信息之前你需要去百度一下这些关键词,这里我只说明比较重要的三个单元 MS 移动终端...

    kevin的博客 2万+

    python脚本根据cookies自动登录网站_Python爬虫利用cookie实现模拟登陆实例详解

    Cookie,指某些网站为了辨别用户身份、进行session跟踪而储存在用户本地终端上的数据(通常经过加密)。举个例子,某些网站是需要登录后才能得到你想要的信息的,不登陆只能是游客模式,那么我们可以利用Urllib2库保存我们以前登录过的Cookie,之后载入cookie获取我们想要的页面,然后再进行抓取。理解cookie主要是为我们快捷模拟登录抓取目标网页做出准备。我之前的帖子中使用过urlop...

    weixin_39630880的博客 489

    锂电池SOH预测 | 基于BP神经网络的锂电池SOH预测(附matlab完整源码)

    锂电池SOH预测 | 基于BP神经网络的锂电池SOH预测(附matlab完整源码)

    天天酷科研的博客 1114

    低轨通信 | 手机直连低轨卫星通信:架构、关键技术与未来展望

    手机直连低轨卫星通信正推动人类进入"全域连接"时代。当中国星网GW星座与千帆星座的万颗卫星点亮夜空,当普通智能手机在珠峰之巅仍能流畅视频通话,当远洋渔船通过卫星物联网实现精准捕捞——这些场景不仅重构通信产业格局,更将深刻改变人类生产生活方式。正如工信部《指导意见》所规划,到2030年我国将发展超千万卫星通信用户,催生万亿级新市场[1][5]。在这场太空基建竞赛中,技术创新与标准制定的双重突破,将决定未来数字文明的星空版图。

    尘世冰封的专栏 938

    python爬虫模拟登录在基础教育中的应用_Python爬虫利用cookie实现模拟登陆实例详解...

    Cookie,指某些网站为了辨别用户身份、进行session跟踪而储存在用户本地终端上的数据(通常经过加密)。举个例子,某些网站是需要登录后才能得到你想要的信息的,不登陆只能是游客模式,那么我们可以利用Urllib2库保存我们以前登录过的Cookie,之后载入cookie获取我们想要的页面,然后再进行抓取。理解cookie主要是为我们快捷模拟登录抓取目标网页做出准备。我之前的帖子中使用过urlop...

    weixin_28822955的博客 193

    RU DOS版、EFI版32bit/64bit BIOS常用工具

    DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

    Python爬虫:爬取需要登录的网站(附爬虫视频教程)_python 爬虫如何爬取需要登录

    要访问的目标页面# 代理服务器(产品官网 www.16yun.cn)# 代理隧道验证信息# 设置 http和https访问都是用HTTP代理# 访问三次网站,使用相同的Session(keep-alive),均能够保持相同的外网IP# 设置cookieresponse1 = requests.get(url_login) # 未登陆response2 = requests_session.get(url_login) # 已登陆,因为之前拿到了Response Cookie!

    m0_60607971的博客 2271

    VB摄像头监控

    该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

    jre9下载 jdk9

    (Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

    python cookie使用_Python使用cookielib模块操作cookie的实例教程

    cookielib是一个自动处理cookies的模块,如果我们在使用爬虫等技术的时候需要保存cookie,那么cookielib会让你事半功倍!他最常见的搭档模块就是python下的urllib和request。核心类1.Cookie该类实现了Netscape and RFC 2965 cookies定义的cookie标准,基本可以理解为某一条cookie数据。部分代码如下,很多属性是不是很眼熟?...

    weixin_39614637的博客 213

    TMS_WebGMaps_1.9.8.0_Full_Source

    TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

    Python网络爬虫:Cookie池详细介绍

    在网络爬虫的开发过程中,处理HTTP请求和响应中的Cookie是一个核心环节。为了高效地管理和利用Cookie,特别是当需要模拟多个用户登录或绕过网站的反爬虫机制时,Cookie池的概念应运而生。本文将详细介绍Python网络爬虫中的Cookie池。

    2301_79727522的博客 1580

    python模拟登录教程_Python爬虫利用cookie实现模拟登陆实例详解

    Cookie,指某些网站为了辨别用户身份、进行session跟踪而储存在用户本地终端上的数据(通常经过加密)。举个例子,某些网站是需要登录后才能得到你想要的信息的,不登陆只能是游客模式,那么我们可以利用Urllib2库保存我们以前登录过的Cookie,之后载入cookie获取我们想要的页面,然后再进行抓取。理解cookie主要是为我们快捷模拟登录抓取目标网页做出准备。我之前的帖子中使用过urlop...

    weixin_39639040的博客 335
    上一篇: Python json模块常用方法
    下一篇: Python的多线程爬虫详解
    AI大模型学习
    博客等级 码龄4年 2471粉丝 620原创
    评论
    成就一亿技术人!
    拼手气红包6.0元
    还能输入1000个字符
     
     条评论被折叠 查看
    添加红包

    请填写红包祝福语或标题

    个

    红包个数最小为10个

    元

    红包金额最低5元

    当前余额3.43元 前往充值 >
    需支付:10.00元
    成就一亿技术人!
    领取后你会自动成为博主和红包主的粉丝 规则
    hope_wisdom
    发出的红包
    实付元
    使用余额支付
    点击重新获取
    扫码支付
    钱包余额 0

    抵扣说明:

    1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
    2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

    余额充值