Python的多线程爬虫详解

Python多线程爬虫入门到精通教程 本教程介绍了Python多线程爬虫的基本概念、实现步骤和注意事项,并提供了一个简单的示例代码。希望通过本教程,你能够了解多线程爬虫的基本原理和使用方法,并能够根据实际需求进行相应的扩展和优化。多线程爬虫是爬虫技术中的重要内容,掌握多线程爬虫技术对于提高爬取效率和性能非常有帮助。如果你对多线程爬虫还有其他问题,可以随时提问。祝你在爬虫之路上取得成功!创建线程类:继承自类,并重写run方法,在run方法中实现具体的爬取逻辑。创建线程对象:根据需要爬取的任务数量,创建相应数量的线程对象。 阅读详情

多线程使用流程

Python 提供了两个支持多线程的模块,分别是 _thread 和 threading。其中 _thread 模块偏底层,它相比于 threading 模块功能有限,因此推荐大家使用 threading 模块。 threading 中不仅包含了 _thread 模块中的所有方法,还提供了一些其他方法,如下所示:

  • threading.currentThread() 返回当前的线程变量。
  • threading.enumerate() 返回一个所有正在运行的线程的列表。
  • threading.activeCount() 返回正在运行的线程数量。

线程的具体使用方法如下所示:

  1. from threading import Thread
  2. ​#线程创建、启动、回收
  3. t = Thread(target=函数名) # 创建线程对象
  4. t.start() # 创建并启动线程
  5. t.join() # 阻塞等待回收线程

创建多线程的具体流程:

  1. t_list = []
  2. for i in range(5):
  3. t = Thread(target=函数名)
  4. t_list.append(t)
  5. t.start()
  6. for t in t_list:
  7. t.join()

除了使用该模块外,您也可以使用 Thread 线程类来创建多线程。

在处理线程的过程中要时刻注意线程的同步问题,即多个线程不能操作同一个数据,否则会造成数据的不确定性。通过 threading 模块的 Lock 对象能够保证数据的正确性。

比如,使用多线程将抓取数据写入磁盘文件,此时,就要对执行写入操作的线程加锁,这样才能够避免写入的数据被覆盖。当线程执行完写操作后会主动释放锁,继续让其他线程去获取锁,周而复始,直到所有写操作执行完毕。具体方法如下所示:

  1. from threading import Lock
  2. lock = Lock()
  3. 获取锁

  4. lock.acquire()
  5. wirter.writerows(“线程锁问题解决”)
  6. 释放锁

  7. lock.release()

Queue队列模型

对于 Python 多线程而言,由于 GIL 全局解释器锁的存在,同一时刻只允许一个线程占据解释器执行程序,当此线程遇到 IO 操作时就会主动让出解释器,让其他处于等待状态的线程去获取解释器来执行程序,而该线程则回到等待状态,这主要是通过线程的调度机制实现的。

由于上述原因,我们需要构建一个多线程共享数据的模型,让所有线程都到该模型中获取数据。queue(队列,先进先出) 模块提供了创建共享数据的队列模型。比如,把所有待爬取的 URL 地址放入队列中,每个线程都到这个队列中去提取 URL。queue 模块的具体使用方法如下:

  1. 导入模块

  2. from queue import Queue
  3. q = Queue() #创界队列对象
  4. q.put(url) 向队列中添加爬取一个url链接
  5. q.get() # 获取一个url,当队列为空时,阻塞
  6. q.empty() # 判断队列是否为空,True/False

多线程爬虫案例

下面通过多线程方法抓取小米应用商店(https://app.mi.com/)中应用分类一栏,所有类别下的 APP 的名称、所属类别以及下载详情页 URL 。如下图所示:
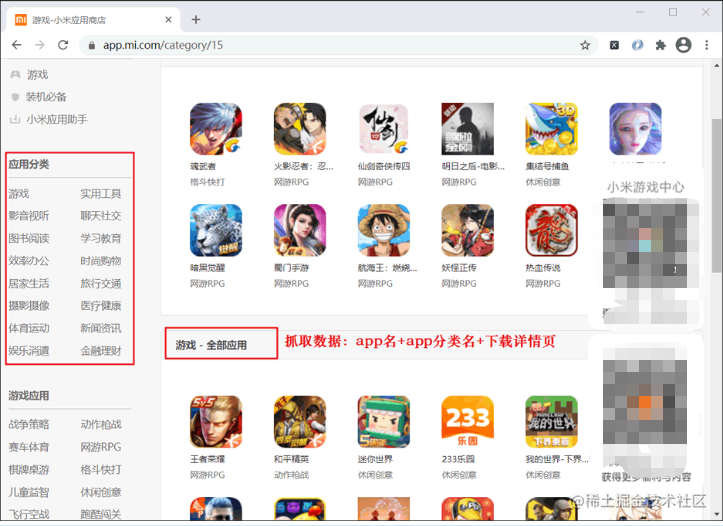
image.png
图1:小米应用商城

抓取下来的数据 demo 如下所示:

**

三国杀,棋牌桌游,http://app.mi.com/details?id=com.bf.sgs.hdexp.mi
1) 案例分析

通过搜索关键字可知这是一个动态网站,因此需要抓包分析。

刷新网页来重新加载数据,可得知请求头的 URL 地址,如下所示:

**

https://app.mi.com/categotyAllListApi?page=0&categoryId=1&pageSize=30

其中查询参数 pageSize 参数值不变化,page 会随着页码的增加而变化,而类别 Id 通过查看页面元素,如下所示

    • 游戏
    • 实用工具
    • 影音视听
    • 聊天社交
    • 图书阅读
    • 学习教育
    • 效率办公
    • 时尚购物
    • 居家生活
    • 旅行交通
    • 摄影摄像
    • 医疗健康
    • 体育运动
    • 新闻资讯
    • 娱乐消遣
    • 金融理财

    因此,可以使用 Xpath 表达式匹配 href 属性,从而提取类别 ID 以及类别名称,表达式如下:

    **

    基准表达式:xpath_bds = '//ul[@class="category-list"]/li'
    提取 id 表达式:typ_id = li.xpath('./a/@href')[0].split('/')[-1]
    类型名称:typ_name = li.xpath('./a/text()')[0]
    

    点击开发者工具的 response 选项卡,查看响应数据,如下所示:

    **

    {
    count: 2000,
    data: [
    {
    appId: 1348407,
    displayName: "天气暖暖-关心Ta从关心天气开始",
    icon: "http://file.market.xiaomi.com/thumbnail/PNG/l62/AppStore/004ff4467a7eda75641eea8d38ec4d41018433d33",
    level1CategoryName: "居家生活",
    packageName: "com.xiaowoniu.WarmWeather"
    },
    {
    appId: 1348403,
    displayName: "贵斌同城",
    icon: "http://file.market.xiaomi.com/thumbnail/PNG/l62/AppStore/0e607ac85ed9742d2ac2ec1094fca3a85170b15c8",
    level1CategoryName: "居家生活",
    packageName: "com.gbtc.guibintongcheng"
    },
    ...
    ...
    

    通过上述响应内容,我们可以从中提取出 APP 总数量(count)和 APP (displayName)名称,以及下载详情页的 packageName。由于每页中包含了 30 个 APP,所以总数量(count)可以计算出每个类别共有多少页。

    **

    pages = int(count) // 30 + 1
    

    下载详情页的地址是使用 packageName 拼接而成,如下所示:

    **

    link = 'http://app.mi.com/details?id=' + app['packageName']
    
    ​2) 完整程序

    完整程序如下所示:

    1. -- coding:utf8 --

    2. import requests
    3. from threading import Thread
    4. from queue import Queue
    5. import time
    6. from fake_useragent import UserAgent
    7. from lxml import etree
    8. import csv
    9. from threading import Lock
    10. import json
    11. class XiaomiSpider(object):
    12. def init(self):
    13. self.url = ‘http://app.mi.com/categotyAllListApi?page={}&categoryId={}&pageSize=30’
    14. 存放所有URL地址的队列

    15. self.q = Queue()
    16. self.i = 0
    17. 存放所有类型id的空列表

    18. self.id_list = []
    19. 打开文件

    20. self.f = open(‘XiaomiShangcheng.csv’,‘a’,encoding=‘utf-8’)
    21. self.writer = csv.writer(self.f)
    22. 创建锁

    23. self.lock = Lock()
    24. def get_cateid(self):
    25. 请求

    26. url = ‘http://app.mi.com/’
    27. headers = { ‘User-Agent’: UserAgent().random}
    28. html = requests.get(url=url,headers=headers).text
    29. 解析

    30. parse_html = etree.HTML(html)
    31. xpath_bds = ‘//ul[@class=“category-list”]/li’
    32. li_list = parse_html.xpath(xpath_bds)
    33. for li in li_list:
    34. typ_name = li.xpath(‘./a/text()’)[0]
    35. typ_id = li.xpath(‘./a/@href’)[0].split(‘/’)[-1]
    36. 计算每个类型的页数

    37. pages = self.get_pages(typ_id)
    38. #往列表中添加二元组
    39. self.id_list.append( (typ_id,pages) )
    40. 入队列

    41. self.url_in()
    42. 获取count的值并计算页数

    43. def get_pages(self,typ_id):
    44. 获取count的值,即app总数

    45. url = self.url.format(0,typ_id)
    46. html = requests.get(
    47. url=url,
    48. headers={‘User-Agent’:UserAgent().random}
    49. ).json()
    50. count = html[‘count’]
    51. pages = int(count) // 30 + 1
    52. return pages
    53. url入队函数,拼接url,并将url加入队列

    54. def url_in(self):
    55. for id in self.id_list:
    56. id格式:(‘4’,pages)

    57. for page in range(1,id[1]+1):
    58. url = self.url.format(page,id[0])
    59. 把URL地址入队列

    60. self.q.put(url)
    61. 线程事件函数: get() -请求-解析-处理数据,三步骤

    62. def get_data(self):
    63. while True:
    64. 判断队列不为空则执行,否则终止

    65. if not self.q.empty():
    66. url = self.q.get()
    67. headers = {‘User-Agent’:UserAgent().random}
    68. html = requests.get(url=url,headers=headers)
    69. res_html = html.content.decode(encoding=‘utf-8’)
    70. html=json.loads(res_html)
    71. self.parse_html(html)
    72. else:
    73. break
    74. 解析函数

    75. def parse_html(self,html):
    76. 写入到csv文件

    77. app_list = []
    78. for app in html[‘data’]:
    79. app名称 + 分类 + 详情链接

    80. name = app[‘displayName’]
    81. link = ‘http://app.mi.com/details?id=’ + app[‘packageName’]
    82. typ_name = app[‘level1CategoryName’]
    83. 把每一条数据放到app_list中,并通过writerows()实现多行写入

    84. app_list.append([name,typ_name,link])
    85. print(name,typ_name)
    86. self.i += 1
    87. 向CSV文件中写入数据

    88. self.lock.acquire()
    89. self.writer.writerows(app_list)
    90. self.lock.release()
    91. 入口函数

    92. def main(self):
    93. URL入队列

    94. self.get_cateid()
    95. t_list = []
    96. 创建多线程

    97. for i in range(1):
    98. t = Thread(target=self.get_data)
    99. t_list.append(t)
    100. 启动线程

    101. t.start()
    102. for t in t_list:
    103. 回收线程

    104. t.join()
    105. self.f.close()
    106. print(‘数量:’,self.i)
    107. if name == ‘main’:
    108. start = time.time()
    109. spider = XiaomiSpider()
    110. spider.main()
    111. end = time.time()
    112. print(‘执行时间:%.1f’ % (end-start))

    运行上述程序后,打开存储文件,其内容如下:

    **

    在我们之间-单机版,休闲创意,http://app.mi.com/details?id=com.easybrain.impostor.gtx
    
    粉末游戏,模拟经营,http://app.mi.com/details?id=jp.danball.powdergameviewer.bnn
    
    三国杀,棋牌桌游,http://app.mi.com/details?id=com.bf.sgs.hdexp.mi
    
    腾讯欢乐麻将全集,棋牌桌游,http://app.mi.com/details?id=com.qqgame.happymj
    
    快游戏,休闲创意,http://app.mi.com/details?id=com.h5gamecenter.h2mgc
    
    皇室战争,战争策略,http://app.mi.com/details?id=com.supercell.clashroyale.mi
    
    地铁跑酷,跑酷闯关,http://app.mi.com/details?id=com.kiloo.subwaysurf
    ...
    ...
    

    这里给大家分享一份Python全套学习资料,包括学习路线、软件、源码、视频、面试题等等,都是我自己学习时整理的,希望可以对正在学习或者想要学习Python的朋友有帮助!

    优快云大礼包:全网最全《全套Python学习资料》免费分享🎁

    😝有需要的小伙伴,可以点击下方链接免费领取或者V扫描下方二维码免费领取🆓
    👉优快云大礼包🎁:全网最全《Python学习资料》免费分享(安全链接,放心点击)👈

    ​

    1️⃣零基础入门

    ① 学习路线

    对于从来没有接触过Python的同学,我们帮你准备了详细的学习成长路线图。可以说是最科学最系统的学习路线,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。
    在这里插入图片描述

    ② 路线对应学习视频

    还有很多适合0基础入门的学习视频,有了这些视频,轻轻松松上手Python~在这里插入图片描述

    ③练习题

    每节视频课后,都有对应的练习题哦,可以检验学习成果哈哈!
    在这里插入图片描述
    因篇幅有限,仅展示部分资料

    2️⃣国内外Python书籍、文档

    ① 文档和书籍资料

    在这里插入图片描述

    3️⃣Python工具包+项目源码合集

    ①Python工具包

    学习Python常用的开发软件都在这里了!每个都有详细的安装教程,保证你可以安装成功哦!
    在这里插入图片描述

    ②Python实战案例

    光学理论是没用的,要学会跟着一起敲代码,动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。100+实战案例源码等你来拿!
    在这里插入图片描述

    ③Python小游戏源码

    如果觉得上面的实战案例有点枯燥,可以试试自己用Python编写小游戏,让你的学习过程中增添一点趣味!
    在这里插入图片描述

    4️⃣Python面试题

    我们学会了Python之后,有了技能就可以出去找工作啦!下面这些面试题是都来自阿里、腾讯、字节等一线互联网大厂,并且有阿里大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。
    在这里插入图片描述
    在这里插入图片描述

    5️⃣Python兼职渠道

    而且学会Python以后,还可以在各大兼职平台接单赚钱,各种兼职渠道+兼职注意事项+如何和客户沟通,我都整理成文档了。
    在这里插入图片描述
    在这里插入图片描述
    上述所有资料 ⚡️ ,朋友们如果有需要 📦《全套Python学习资料》的,可以扫描下方二维码免费领取 🆓
    😝有需要的小伙伴,可以点击下方链接免费领取或者V扫描下方二维码免费领取🆓

    👉优快云大礼包🎁:全网最全《Python学习资料》免费分享(安全链接,放心点击)👈

    ​

    爬虫从入门到精通| 高并发爬虫-使用多线程/多进程/协程创建爬虫 多进程和多线程和协程创建的爬虫可以实现快速抓取 阅读详情

    相关推荐

    Python 爬虫进阶技巧:多线程并发爬取提升采集速度

    在单线程串行爬虫开发模式下,程序遵循 “请求发送 - 等待响应 - 数据解析 - 存储写入” 的线性执行逻辑,网络请求阻塞会造成大量时间冗余。目标站点数量庞大、分页数据繁多、单页采集链路复杂时,串行执行效率极低,大规模数据采集周期会成倍拉长。为解决爬虫效率瓶颈,多线程并发技术成为轻量化高性能采集的核心解决方案。计算机 CPU 运算速度远高于网络传输速率,爬虫程序绝大多数运行时长消耗在网络等待阶段,属于典型 IO 密集型任务。

    2503_91057718的博客 188

    【Python 爬虫】多线程爬取

    文章目录前言一、多进程库(multiprocessing)二、多线程爬虫三、案例实操四、案例解析1、获取网页内容2、获取每一章链接3、获取每一章的正文并返回章节名和正文4、将每一章保存到本地5、多线程爬取文章 前言 简单的爬虫只有一个进程、一个线程,因此称为单线程爬虫。单线程爬虫每次只访问一个页面,不能充分利用计算机的网络带宽。一个页面最多也就几百KB,所以爬虫在爬取一个页面的时候,多出来的网速和从发起请求到得到源代码中间的时间都被浪费了。如果可以让爬虫同时访问10个页面,就相当于爬取速度提高了10倍..

    懂得一千零一种,赋予你失败的方法! 2万+

    Python爬虫技术详解:多线程爬虫实现与优化

    在这篇博客中,我们将深入探讨如何使用Python构建高效的多线程爬虫来抓取大量数据。通过多线程的方式,我们不仅可以提高爬虫的抓取速度,还能优化爬虫程序的性能。通过本文的介绍,我们不仅了解了如何使用Python构建一个多线程爬虫,还深入探讨了如何处理异常、如何优化性能以及如何应对反爬虫策略。它通过向目标网页发送HTTP请求并获取网页的HTML响应,提取网页中的数据,存储到本地或者数据库中。在抓取大量数据时,单线程爬虫可能会受到响应时间和数据量的限制,导致程序效率低下。在上面的代码中,我们使用了。

    2201_76125261的博客 892

    python如何在网络爬虫程序中使用多线程(threading.Thread)

    本文介绍了如何在python爬虫程序中使用多线程

    hubing_hust的专栏 1万+

    从传统扫描到SSN:Tessent数据包技术如何减少90%测试时间

    本文深入探讨了Tessent流式扫描网络(SSN)如何通过其核心的数据包技术,彻底改变芯片测试范式。该技术将测试数据封装成标准化数据包,在共享总线上进行智能路由与分发,实现了动态带宽分配与核心独立测试,从而将复杂SoC(如AI芯片)的总体测试时间大幅削减90%,并显著提升测试灵活性与可扩展性。

    meat5的博客 490

    深度学习动画实战:用MotorNerve系统5步实现自然角色交互

    本文详细介绍了如何利用腾讯游戏的MotorNerve系统,通过深度学习技术5步实现自然角色动画交互。从环境搭建、基础运动控制到交互过渡和行走转向优化,该系统能显著提升游戏动画制作效率,尤其适合中小团队替代昂贵的动捕方案。重点解析了骨骼动画配置、PFNN控制器使用及Blender工作流集成等核心技术。

    book8的博客 686

    Python爬虫——Python多线程爬虫详解

    网络爬虫程序是一种 IO 密集型程序,程序中涉及了很多网络 IO 以及本地磁盘 IO 操作,这些都会消耗大量的时间,从而降低程序的执行效率,而 Python 提供的多线程能够在一定程度上提升 IO 密集型程序的执行效率。

    Itmastergo的博客 2048

    【抓包工具】Windows 10/11:Charles 从零到精通(下载、安装、配置与HTTPS证书实战)

    本文提供了一份详尽的Charles抓包工具在Windows 10/11系统上的从零到精通指南。内容涵盖下载安装、初始配置、解决端口冲突,并重点解析了HTTPS抓包的核心步骤——安装CA证书。此外,还介绍了手机抓包配置及映射、断点等高效使用技巧,帮助开发者和测试人员快速掌握网络调试与安全分析技能。

    weixin_29251131的博客 551

    Python网络爬虫

    Python网络爬虫—给????爪巴????1.网络爬虫的安全性2.网络爬虫的工作原理3.requests库1.requests库的常用函数2.request操作步骤3.response返回响应4.beautifulsoup4库1.常用的解析技术2.beautifulsoup4的操作步骤 网络爬虫,又被称为网页蜘蛛,网络机器人,是一种按照一定的规则,自动请求万维网网站并提取网络数据的程序或脚本。 网络爬虫的相...

    Aurora_1970s的博客 4576

    【RT-DETR有效改进】利用MobileNetV3替换Backbone(轻量化网络结构,提点)

    本文给大家带来的改进机制是,其主要改进思想集中在结合硬件感知的网络架构搜索(NAS)和NetAdapt算法,以优化移动设备CPU上的性能。它采用了新颖的架构设计,包括反转残差结构和线性瓶颈层,以及新的高效分割解码器Lite Reduced Atrous Spatial Pyramid Pooling(LR-ASPP),以提升在移动分类、检测和分割任务上的表现。实验表明,MobileNets在资源和准确性的权衡方面表现出色,并在多种应用(如对象检测、细粒度分类、面部属性识别和大规模地理定位)中展现了其有效性。

    Snu77的博客 2748

    【Python机器学习】主成分分析(PCA):高维数据的“瘦身术“

    主成分分析(PCA)的历史可以追溯到1901年,当时Karl Pearson首次提出了这个概念。在计算机还不存在的年代,PCA是一个纯粹的数学构想,用来简化多变量数据的分析。几十年后,当计算机出现时,PCA成为了数据分析中最早实现的算法之一。从那时起,超过一个世纪的发展中,PCA一直保持着其核心的理论框架和实用价值,这本身就是对这个方法深刻科学性的证明。在现代深度学习时代,许多人可能会认为PCA已经过时了。但事实恰好相反。

    nmdbbzcl的博客 981

    《python3网络爬虫开发实战 第二版》之爬虫基础-多线程和多进程的基本原理 详解

    《python3网络爬虫开发实战 第二版》1.6 多进程和多线程、主要讲述了进程、线程、多进程、多线程、并发、并行、python的多线程和多进程

    半妖 863

    中台战略-第五章、中台建设方法论

    文章目录第五章、中台建设方法论5.1 中台架构整体策略5.2 业务顶层设计5.3 业务中台设计方法论5.3.1 能力支撑是基础5.3.2 中心自治是承载形式5.3.3 3层模型是骨架5.3.4 5步法是指导思想1. 业务抽象2. 高阶设计3. 组件建模4. 开发交付5. 持续运营5.4 数据中台设计方法论5.4.1 总体规划5.4.2 数据集成5.4.3 模型建设5.4.4 通用研发5.4.5 资产管理5.4.6 数据服务5.5 应用向中台迁移的3中途径和方法5.5.1 方法1:新应用替换旧应用5.5.2

    沧海之巅的专栏 1461

    python爬虫多线程是什么意思_python爬虫中多线程的使用详解

    queue介绍queue是python的标准库,俗称队列.可以直接import引用,在python2.x中,模块名为Queue。python3直接queue即可在python中,多个线程之间的数据是共享的,多个线程进行数据交换的时候,不能够保证数据的安全性和一致性,所以当多个线程需要进行数据交换的时候,队列就出现了,队列可以完美解决线程间的数据交换,保证线程间数据的安全性和一致性。#多线程实战栗子...

    weixin_39998462的博客 226

    把 ABAP ALE Change Pointers 讲透:从 CDHDR/CDPOS 到 BDCP2,再到 RBDMIDOC 的自动分发链路

    摘要:SAP ALE Change Pointers机制在系统集成中实现业务变更与数据分发的解耦。它记录业务对象变更(如SAP主数据修改),但不立即发送,而是由后续分发逻辑决定发送时机和方式。该机制包含两层:Change Documents记录审计级变更明细,Change Pointers标记需分发的关键变更。配置核心包括全局开关、消息类型激活和字段选择。典型应用如零售价格条件变更自动推送至POS系统,通过BDCP2表存储待处理队列,由RBDMIDOC程序定时评估生成IDoc。运维需关注定期清理和性能优化,

    2007 年 ~ 2025 年,深耕 SAP 技术 18 年 209

    WOFOST作物模型(1):PCSE环境配置

    get_summary_output() 方法通常用于在 PCSE 模拟过程结束后,获取模拟结果的摘要信息,例如模拟期间的总产量、总水分需求等。它可以提供对模拟结果的快速总结,方便用户进行后续的分析和处理。用.get_output来获取过程参数,并将这些参数转为dataframe显示。用run_till_terminate()代表终止。安装好之后,打开jupyter notebook。也可以指定运行时间,并获取最后一天的参数。首先还是打开之前建好的gee虚拟环境。

    所有专家都曾始于新手 681

    Python多线程爬虫实现详解【重点】

    一文详解Python多线程爬虫实现

    大学生活与学习一站式解决方案. 936

    Camera2Demo

    在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

    Python多线程爬虫——数据分析项目实现详解

    前些天发现了一个巨牛的人工智能学习网站,通俗易懂,风趣幽默,忍不住分享一下给大家雪碧的个人网站ChatGPT体验地址。

    web13688565871的博客 1796

    汉书HE8,好用的汇编代码编写工具

    汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

    IEM模型,地表粗糙度模拟

    利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

    Python爬虫之多线程练习——多线程爬取表情包详解

    多线程爬取表情包详解1. 普通爬取表情包2.多线程爬取工作原理3.多线程爬取表情包代码 ''' 需求:在斗图网爬取表情包并且保存 网址: https://www.doutula.com/photo/list/?page=1 https://www.doutula.com/photo/list/?page=2 https://www.doutula.com/photo/list/?page=3 目标url形式为 url = 'https://www.doutula.com/photo/list/?page=%

    Claire_chen_jia的博客 742

    文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

    主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

    python3多线程爬虫小说_Python 爬虫多线程详解及实例代码

    python是支持多线程的,主要是通过thread和threading这两个模块来实现的。thread模块是比较底层的模块,threading模块是对thread做了一些包装的,可以更加方便的使用。虽然python的多线程受GIL限制,并不是真正的多线程,但是对于I/O密集型计算还是能明显提高效率,比如说爬虫。下面用一个实例来验证多线程的效率。代码只涉及页面获取,并没有解析出来。# -*-codi...

    weixin_39521009的博客 240

    爬虫代码详解Python多线程、多进程、协程

    一、前言 很多时候我们写了一个爬虫,实现了需求后会发现了很多值得改进的地方,其中很重要的一点就是爬取速度。本文就通过代码讲解如何使用多进程、多线程、协程来提升爬取速度。注意:我们不深入介绍理论和原理,一切都在代码中。 二、同步 首先我们写一个简化的爬虫,对各个功能细分,有意识进行函数式编程。下面代码的目的是访问300次百度页面并返回状态码,其中parse_1函数可以设定循环次数,每次循环将当...

    早起Python 1064

    Python多线程爬虫编程中队列的问题详解

    Python多线程爬虫能够快速有效的完成数据采集的工作,他的工作效率高,深受各类互联网公司的青睐,那么在多线程爬虫中如果有下面的问题可以尝试的我的方法来解决。

    weixin_44617651的博客 655

    看几段爬虫代码,详解Python多线程、多进程、协程

    线程就是实现异步的一个方式,也就是说多线程是异步处理异步就意味着不知道处理结果,有时候我们需要了解处理结果,就可以采用。爬虫的加速是重要技能,但适当控制速度也是爬虫工作者的良好习惯,不要给服务器太大压力,拜拜~很多时候我们写了一个爬虫,实现了需求后会发现了很多值得改进的地方,其中很重要的一点就是爬取速度。首先我们写一个简化的爬虫,对各个功能细分,有意识进行函数式编程。配合动态协作就可以达到异步非阻塞的目的,本质只用了一个线程,所以很大程度利用了资源。库的代码稍繁琐,但支持更多的拓展。

    wadfdhsajd的博客 332

    python多进程加多线程爬虫_爬虫代码详解Python多线程、多进程、协程

    一、前言很多时候我们写了一个爬虫,实现了需求后会发现了很多值得改进的地方,其中很重要的一点就是爬取速度。本文就通过代码讲解如何使用多进程、多线程、协程来提升爬取速度。注意:我们不深入介绍理论和原理,一切都在代码中。二、同步首先我们写一个简化的爬虫,对各个功能细分,有意识进行函数式编程。下面代码的目的是访问300次百度页面并返回状态码,其中parse_1函数可以设定循环次数,每次循环将当前循环数(从...

    weixin_39764212的博客 249
    上一篇: Python爬虫来实现Cookie模拟登录
    下一篇: Python Selenium的下载以及安装
    AI大模型学习
    博客等级 码龄4年 2471粉丝 620原创
    评论
    成就一亿技术人!
    拼手气红包6.0元
    还能输入1000个字符
     
     条评论被折叠 查看
    添加红包

    请填写红包祝福语或标题

    个

    红包个数最小为10个

    元

    红包金额最低5元

    当前余额3.43元 前往充值 >
    需支付:10.00元
    成就一亿技术人!
    领取后你会自动成为博主和红包主的粉丝 规则
    hope_wisdom
    发出的红包
    实付元
    使用余额支付
    点击重新获取
    扫码支付
    钱包余额 0

    抵扣说明:

    1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
    2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

    余额充值