


简介
Sora 概述
Sora 是 OpenAI 的视频生成模型,旨在接收文本、图像和视频输入并生成新视频作为输出。用户可以创建各种格式的分辨率高达 1080p(最长 20 秒)的视频,从文本生成新内容,或增强、重新混合和融合自己的资产。用户将能够探索精选和最新动态,这些动态展示了社区创作并为新想法提供灵感。Sora 以 DALL·E 和 GPT 模型的经验为基础,旨在为人们提供更多讲故事和创意表达的工具。
Sora 是一种扩散模型,它从看起来像静态噪声的基础视频开始生成视频,并通过多步消除噪声逐渐对其进行转换。通过让模型一次预测许多帧,我们解决了一个具有挑战性的问题,即确保主题即使暂时消失在视野之外也能保持不变。与 GPT 模型类似,Sora 使用transformer架构,可实现卓越的扩展性能。
Sora 使用了 DALL·E 3 中的重新字幕技术,该技术涉及为视觉训练数据生成高度描述性的字幕。因此,该模型能够更忠实地遵循生成的视频中用户的文本指令。
除了能够仅根据文本指令生成视频外,该模型还能够获取现有的静止图像并从中生成视频,以精确度和对细节的关注为图像内容制作动画。该模型还可以获取现有视频并对其进行扩展或填充缺失的帧。Sora 是能够理解和模拟现实世界的模型的基础,我们相信这一能力将成为实现 AGI 的重要里程碑。
Sora 的功能也可能带来新的风险,例如可能滥用相似性或生成误导性或露骨的视频内容。为了安全地在产品中部署 Sora,我们借鉴了 DALL·E 在 ChatGPT 中的部署的安全工作以及其他 OpenAI 产品(如 ChatGPT)的 API 和安全缓解措施的经验。该系统卡概述了由此产生的缓解堆栈、外部红队工作、评估和正在进行的研究,以进一步完善这些保障措施。
模型数据
正如我们 2024 年 2 月的技术报告中所述,Sora 从大型语言模型中汲取灵感,这些模型通过对互联网规模的数据进行训练获得了通用能力。LLM 范式的成功部分得益于使用 token 优雅地统一了各种文本模式——代码、数学和各种自然语言。通过 Sora,我们考虑了视觉数据的生成模型如何继承这些好处。LLM 有文本 token,而 Sora 有视觉patches. patches以前已被证明是视觉数据模型的有效表示。我们发现patches是一种高度可扩展且有效的表示,可用于在不同类型的视频和图像上训练生成模型。在高层次上,我们首先将视频压缩到低维潜在空间,然后将表示分解为时空补丁,从而将视频转换为patches.
Sora 接受了各种数据集的训练,包括公开可用的数据、通过合作伙伴关系获取的专有数据以及内部开发的自定义数据集。这些数据集包括:
- 选择公开可用的数据,主要从行业标准的机器学习数据集和网络爬虫中收集。
- 来自数据合作伙伴的专有数据。我们建立合作伙伴关系以访问非公开可用的数据。例如,我们与 Shutterstock Pond5 合作构建和交付 AI 生成的图像。我们还合作委托和创建符合我们需求的数据集。
- 人工数据:来自 AI 培训师、红队成员和员工的反馈。
预训练过滤和数据预处理
除了在预训练阶段后实施的缓解措施外,预训练过滤缓解措施还可以提供额外的防御层,与其他安全缓解措施一起,有助于从我们的数据集中排除不需要的有害数据。因此,在训练之前,所有数据集都会经过此过滤过程,删除最露骨、最暴力或其他敏感的内容(例如,一些仇恨符号),这是用于过滤我们训练其他模型(包括 DALL·E 2 和 DALL·E 3)的数据的方法的扩展。
风险识别和部署准备
我们进行了一项强有力的过程,以了解潜在的滥用和现实世界的创意用途,以帮助为 Sora 的设计和安全缓解措施提供信息。在 2024 年 2 月 Sora 发布后,我们与来自 60 多个国家的数百名视觉艺术家、设计师和电影制作人合作,以获得有关如何改进模型以最有助于创意专业人士的反馈。我们还与外部红队成员一起制定了一系列内部评估,以发现和评估风险并迭代改进我们的安全性和风险缓解措施。
我们为 Sora 制定的安全堆栈建立在这些经验教训以及我们在其他模型和产品(如 DALL·E 和 ChatGPT)中采用的现有安全缓解措施以及针对我们的视频产品定制的缓解措施的基础上。由于这是一个强大的工具,我们采取了迭代方法来确保安全,特别是在背景很重要或我们预见到与视频相关的新风险的领域。我们的迭代方法的例子包括对 18 岁或以上的用户进行年龄限制访问、限制使用肖像/面部上传,以及在发布时对未成年人的提示和上传设置更保守的审核门槛。我们希望继续了解人们如何使用 Sora,并进行迭代以在安全性和最大限度地发挥用户的创造潜力之间取得最佳平衡。
外部红队
OpenAI 与位于 9 个不同国家的外部红队成员合作,对 Sora 进行了测试,找出了安全缓解措施中的弱点,并就与 Sora 新产品功能相关的风险提供反馈。从 2024 年 9 月开始,红队成员可以使用各种安全缓解措施和系统成熟度迭代的 Sora 产品,一直持续到 2024 年 12 月,测试了超过 15,000 代。这项红队工作建立在 2024 年初的工作基础之上,当时测试了一个没有生产缓解措施的 Sora 模型。
红队成员探索了 Sora 模型和产品工具的新潜在风险,并在开发和改进安全缓解措施时对其进行了测试。这些红队活动涵盖了各种类型的违规和禁止内容(性内容、暴力和血腥、自残、非法内容、错误/虚假信息等)、对抗策略(提示和工具/功能使用)以逃避安全缓解措施,以及如何利用这些工具逐步降低审核工具和保障措施。红队成员还就他们对 Sora 在偏见和总体表现等方面的看法提供了反馈。
我们探索了使用直接提示和对抗提示策略在上述所有内容类别中进行文本到视频的生成。媒体上传功能通过各种图像和视频(包括公众人物)和各种内容类别进行了测试,以测试生成违规内容的能力。我们还测试了修改工具(故事板、重新剪辑、重新混音和混合)的各种用途和组合,以评估它们生成禁止内容的效用。
红队成员确定了特定类型的禁止内容和一般对抗策略的值得注意的观察结果。例如,红队成员发现,在建立额外的缓解措施之前,使用带有医疗情况或科幻/幻想背景的文本提示会降低防止生成色情和性内容的保障措施。红队成员使用对抗策略来逃避安全堆栈的元素,包括暗示性提示和使用隐喻来利用模型的推理能力。经过多次尝试,他们可以识别会触发保护措施的提示和单词趋势,并测试不同的措辞和单词来逃避拒绝。红队成员最终会选择最令人担忧的一代作为种子媒体,进一步开发成无法用单一提示技术创建的违规内容。越狱技术有时被证明可以有效降低安全策略,从而让我们能够改进这些保护措施。
红队成员还使用公开可用的图像和 AI 生成的媒体测试了媒体上传和 Sora 的工具(故事板、重新剪辑、重新混合和混合)。这揭示了在 Sora 发布之前需要加强的输入和输出过滤方面的差距,并帮助完善了包括人物在内的媒体上传的保护措施。测试还表明需要更强大的分类器过滤来降低非违规媒体上传被修改为禁止的色情、暴力或深度伪造内容的风险。
红队成员生成的反馈和数据使我们能够创建额外的安全缓解层并改进现有的安全评估,这些在特定风险领域和缓解措施部分中进行了描述。这些努力使我们能够进一步调整我们的提示过滤、阻止列表和分类器阈值,以确保模型符合安全目标。
从早期艺术家访问中学到的东西
在过去的九个月里,我们观察了来自 60 多个国家/地区的 300 多名用户的 500,000 多个模型请求的用户反馈。这些数据有助于增强模型行为并提高模型对安全协议的遵守程度。例如,艺术家的反馈帮助我们了解可见水印对其工作流程的限制,这促使我们决定允许付费用户下载没有可见水印的视频文件,同时仍嵌入 C2PA 数据。
这个早期访问计划还告诉我们,如果 Sora 旨在成为讲故事和创意表达的扩展工具,那么我们就需要为艺术家提供更大的灵活性,以解决一些敏感领域,而这些领域在 ChatGPT 等通用工具中会以不同的方式处理。我们希望艺术家、独立电影制作人、工作室和其他娱乐行业组织将 Sora 作为其开发流程的重要组成部分。同时,识别积极的用例和潜在的滥用使我们能够确定需要更严格的产品级缓解措施以减轻伤害或滥用风险的领域。
评估
我们针对关键领域制定了内部评估,包括裸体、欺骗性选举内容、自残和暴力。这些评估旨在支持缓解措施的改进,并帮助确定我们的审核阈值。评估框架将提供给视频生成模型的输入提示与应用于转换后的提示或最终制作的视频的输入和输出分类器相结合。
这些评估的输入提示来自三个主要渠道:在早期 alpha 阶段收集的数据(如第 3.2 节所述)、红队测试人员提供的对抗性示例(在第 3.1 节中引用)以及使用 GPT-4 生成的合成数据。Alpha 阶段数据提供了对现实世界使用场景的洞察,红队成员的贡献有助于发现对抗性和边缘情况内容,而合成数据允许在意外的色情内容等领域扩展评估集,而这些领域的自然发生的示例很少。
准备
准备框架旨在评估前沿模型能力是否会在四个跟踪类别中引入重大风险:说服、网络安全、CBRN(化学、生物、放射和核)和模型自主性。我们没有证据表明 Sora 在网络安全、CBRN 或模型自主性方面构成任何重大风险。这些风险与与计算机系统、科学知识或自主决策交互的模型密切相关,而所有这些目前都超出了 Sora 作为视频生成工具的范围。
Sora 的视频生成功能可能会带来潜在的说服风险,例如冒充、误导或社会工程的风险。为了应对这些风险,我们开发了一套缓解措施,如下节所述。其中包括旨在防止生成与知名公众人物相似的缓解措施。此外,考虑到背景和视频是真实的还是由人工智能生成的知识可能是决定生成的视频说服力的关键,我们专注于构建一种多层次的出处方法,包括元数据、水印和指纹识别。
Sora 缓解堆栈
除了下面确定的特定风险和缓解措施外,Sora 的培训、产品设计和政策中的选择有助于广泛缓解有害或不想要的输出的风险。这些可以大致组织成系统和模型级技术缓解措施,以及产品政策和用户教育。
系统和模型缓解措施
下面我们详细介绍了在向用户显示其请求的输出之前我们已实施的主要安全缓解措施:
通过多模式审核分类器进行文本和图像审核
我们的多模式审核分类器为我们的外部审核 API 提供支持,用于识别可能违反我们使用政策的文本、图像或视频提示,包括输入和输出。系统检测到的违规提示将导致拒绝。在此处了解有关我们的多模式审核 API 的更多信息.2
自定义 LLM 过滤
视频生成技术的一个优点是能够执行异步审核检查,而不会增加整体用户体验的延迟。由于视频生成本身需要几秒钟的时间来处理,因此可以利用这段时间窗口来运行精准的审核检查。我们已经定制了自己的 GPT,以实现某些特定主题的审核的高精度,包括识别第三方内容以及欺骗性内容。
过滤器是多模式的:图像/视频上传、文本提示和输出都包含在每个 LLM 调用的上下文中。这使我们能够检测图像和文本中的违规组合。
图像输出分类器
为了直接在输出中处理潜在的有害内容,Sora 使用输出分类器,包括针对 NSFW 内容、未成年人、暴力和潜在滥用肖像的专用过滤器。如果激活了这些分类器,Sora 可能会在视频与用户共享之前屏蔽它们。
阻止列表
我们维护各种类别的文本阻止列表,这些列表是根据我们之前对 DALL·E 2 和 DALL·E 3 的研究、主动风险发现以及早期用户的结果得出的。
产品政策
除了我们在模型和系统中内置的保护措施以防止生成违规内容外,我们还采取了其他措施来降低滥用风险。我们目前仅向 18 岁或以上的用户提供 Sora,并且我们正在对“探索”和“精选”提要中显示的内容应用审核过滤器。
我们还通过产品内和公开的教育明确传达政策指南:
- 未经他人许可使用他人肖像,禁止描绘真实的未成年人;
- 创建非法内容或侵犯知识产权的内容;
- 生成露骨和有害内容,例如非自愿的亲密图像、用于欺凌、骚扰或诽谤的内容,或旨在宣扬暴力、仇恨或他人痛苦的内容;以及
- 创建和分发用于欺诈、诈骗或误导他人的内容。
其中一些滥用形式是通过我们的模型和系统缓解措施解决的,但其他滥用形式则更具情境性——抗议场景可用于合法的创作活动,但作为真实时事呈现的同一场景如果与其他主张搭配,也可能被视为虚假信息。
Sora 旨在让人们能够表达广泛的创意和观点。阻止每一种形式的语境问题内容既不切实际也不明智。
我们为人们提供报告他们认为可能违反我们准则的 Sora 视频的能力,同时利用自动化和人工审核来积极监控使用模式。我们已经建立了执行机制来删除违规视频并惩罚用户。当用户确实违反我们的准则时,我们会通知他们,并提供机会告诉我们他们认为什么是公平的。我们打算跟踪这些缓解措施的有效性,并随着时间的推移对其进行改进。
特定风险领域和缓解措施
除了上述一般安全措施外,早期测试和评估有助于确定几个特别关注安全问题的领域。
儿童安全
OpenAI 致力于解决 3 个儿童安全风险,我们优先考虑预防、检测和报告所有产品(包括 Sora)中的儿童性虐待材料(在新窗口中打开)(CSAM)内容。OpenAI 在儿童安全领域的努力包括负责任地采购我们的数据集以保护它们免受 CSAM 侵害,与美国国家失踪与受虐儿童中心 (NCMEC) 合作以防止儿童性虐待并保护儿童,根据 Thorn 的建议并遵守法律限制进行红队测试,以及在所有输入和输出中对 CSAM 进行强大的扫描。这包括扫描第一方和第三方用户(API 和企业),除非客户满足删除 CSAM 扫描的严格标准。为了防止生成 CSAM,我们构建了一个强大的安全堆栈,利用我们在其他产品(例如 ChatGPT 和 DALL·E4)中使用的系统缓解措施以及我们专门为 Sora 构建的一些其他杠杆。
输入分类器
对于儿童安全,我们在文本、图像和视频输入中利用了 3 种不同的输入缓解措施:
- 对于所有图像和视频上传,我们与 Thorn 开发的 Safer 集成,以检测与已知 CSAM 的匹配。确认的匹配将被拒绝并报告给 NCMEC。此外,我们利用 Thorn 的 CSAM 分类器来识别可能新的、未散列的 CSAM 内容。
- 我们利用多模式审核分类器来检测和审核通过文本、图像和视频输入涉及未成年人的任何性内容。
- 对于 Sora,我们开发了一个分类器来分析文本和图像,以预测是否描绘了 18 岁以下的个人或随附的标题是否提及未成年人。我们拒绝包含 18 岁以下个人的图像到视频的请求。如果文本转视频被判定为未满 18 周岁,我们会对与性、暴力或自残内容相关的审核实施更严格的门槛。
以下是我们对 18 周岁以下人类分类器的评估。我们评估分类器在包含近 5000 张 [儿童 | 成人] 和 [现实 | 虚构] 类别图像的数据集上拒绝真实的 18 周岁以下个体的能力。我们的政策立场是拒绝真实的儿童,同时允许虚构图像,包括动画、卡通或素描风格,只要它们不涉及性。我们对涉及未成年人的内容采取了谨慎的态度,并将继续评估我们的方法,因为我们会通过产品使用了解更多信息,并在允许创造性表达和安全之间找到适当的平衡。
目前,我们的分类器非常准确,但它们偶尔可能会错误地标记成人或非现实的儿童图像。此外,我们承认研究和现有文献强调了年龄预测模型可能表现出种族偏见。例如,这些模型可能会系统地低估某些种族群体的年龄。我们致力于在未来几个月内提高分类器的性能,最大限度地减少误报,并加深对潜在偏见的理解。
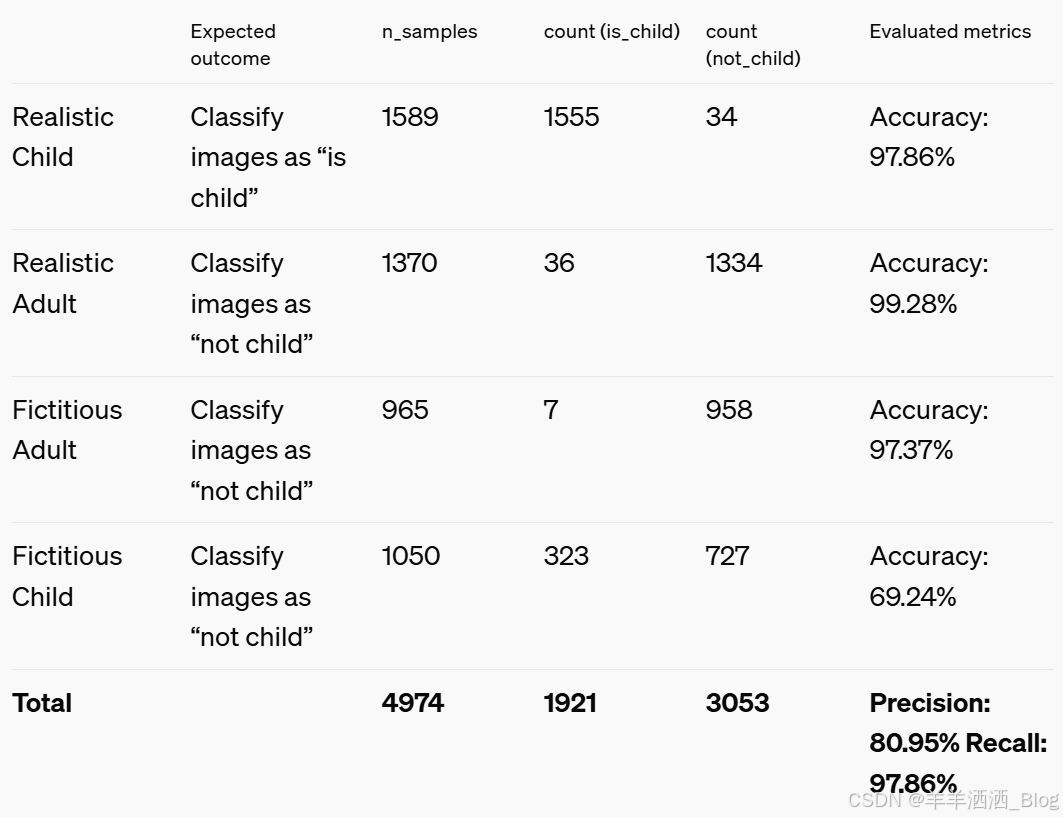
注意:准确率计算为 is_child 分类中真实儿童的百分比,召回率计算为被分类为 is_child 的真实儿童图像的百分比
输出
如上所述,一旦我们用 18 岁以下分类器识别出文本输入中对未成年人的引用,我们就会对输出中与性、暴力或自残内容相关的审核实施严格的阈值。以下是我们用来实现这一点的两个输出分类器:
- 多模式审核分类器扫描不安全的视频输出,拒绝可能特别敏感的请求
- 我们还利用现有的 DALL·E 图像分类器扫描与儿童安全相关的违规行为。
我们的输出分类器每秒扫描 2 帧,当确定视频不安全时,我们会阻止任何输出。
除了我们的分类器和自动审核外,我们还将进行人工审核,作为防止潜在儿童安全违规行为的额外保护层。
产品政策
我们的政策禁止使用 Sora 生成涉及未成年人的性内容。违反我们的儿童安全政策可能会导致内容被删除和用户被封禁。
裸露和暗示性内容
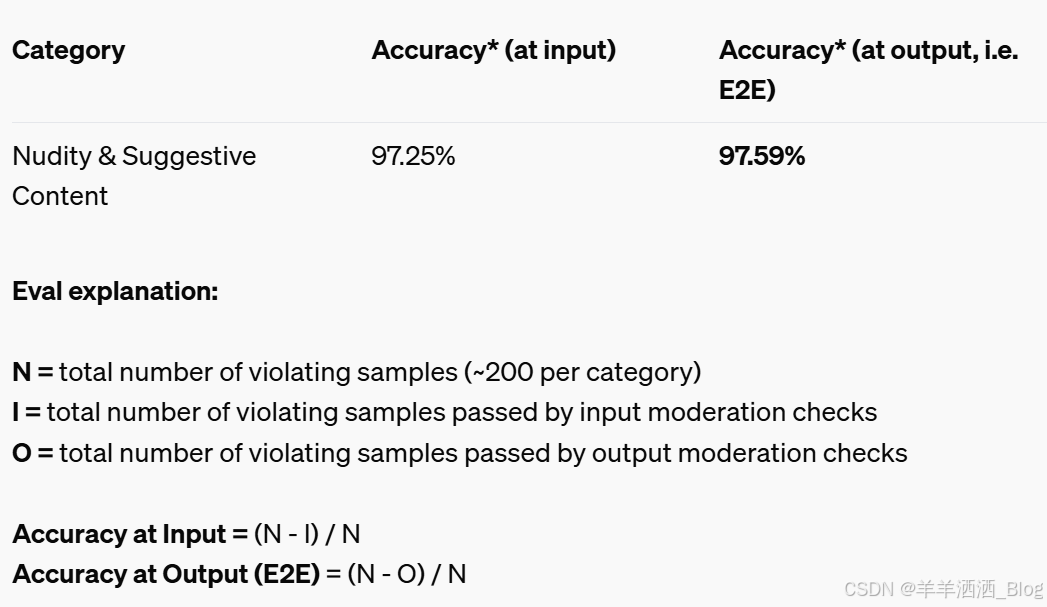
与 AI 视频生成功能相关的新兴风险领域之一是可能创建 NSFW(不适合工作)或 NCII(非自愿亲密图像)内容。与 DALL·E 的方法类似,Sora 使用多层审核策略来屏蔽露骨内容。这些包括提示转换、图像输出分类器和阻止列表,所有这些都有助于限制暗示性内容的系统,特别是针对适合年龄的输出。我们的分类器对图像上传的阈值比对基于文本的提示的阈值更严格。
探索部分中显示的视频会通过更高的阈值进行进一步过滤,以针对适合广泛受众的观看体验。
以下是我们对裸露和暗示性内容的评估结果,旨在评估跨输入和输出的多层缓解措施的有效性。根据调查结果,我们迭代了阈值并对包含人物的上传图像实施了更严格的审核。
产品政策
我们的政策禁止使用 Sora 生成露骨的性内容,包括非自愿的亲密图像。违反这些政策可能会导致内容被删除和用户受到惩罚。
欺骗性内容
相似性滥用和有害的深度伪造
Sora 针对基于相似性的提示的审核监视器旨在标记可能有害的深度伪造内容,目的是密切审查涉及可识别个人的视频。相似性滥用过滤器进一步标记试图以潜在有害或误导的方式修改或描绘个人的提示。Sora 的一般提示转换进一步降低了 Sora 根据包含某人姓名的提示生成私人不想要的肖像的风险。
欺骗性内容
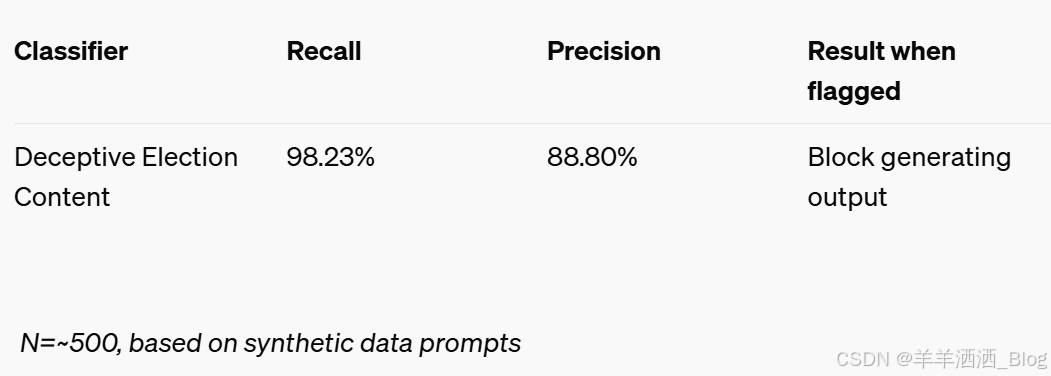
Sora 的输入和输出分类器旨在防止生成与选举相关的欺骗性内容,这些内容描绘了欺诈、不道德或其他非法活动。 Sora 的评估指标包括分类器,用于标记在选举背景下可能产生误导性视频的样式或过滤技术,从而降低现实世界滥用的风险。
以下是我们对欺骗性选举内容 LLM 过滤器的评估,重点是帮助识别可能有意在各种输入(例如文本和视频)中创建违禁内容的情况。我们的系统还会扫描每秒 1 帧的输出视频,以评估可能的输出违规行为。
出处
鉴于与 Sora 相关的许多风险(例如有害的深度伪造内容)都严重依赖于上下文,我们优先考虑增强我们的出处工具。我们认识到出处问题没有单一的解决方案,但我们致力于改善出处生态系统,并帮助为从 Sora 创建的内容建立上下文和透明度。
对于普遍适用性,我们的出处安全工具将包括:
- 所有资产上的 C2PA 元数据(可验证来源,行业标准)
- 默认情况下动画可见的 Sora 水印(此“AI”的查看者透明度)
- 内部反向视频搜索工具,帮助 OpenAI 情报与调查团队的成员高度自信地评估内容是否由 Sora 创建
产品政策
我们的政策禁止使用 Sora 欺骗、诈骗或误导他人,包括通过制造和传播虚假信息。他们还禁止未经他人许可使用他人的肖像。违反这些政策可能会导致内容被删除和用户受到惩罚。
艺术家风格
当用户在提示中使用在世艺术家的名字时,模型可能会生成在某种程度上类似于该艺术家作品风格的视频。在创作中,借鉴其他艺术家的风格有着悠久的传统,但我们理解一些创作者可能会有顾虑。随着我们更多地了解创意社区如何使用 Sora,我们选择对这个版本的 Sora 采取保守的态度。为了解决这个问题,我们添加了提示重写功能,当用户尝试以在世艺术家的风格生成视频时,这些提示重写功能会触发。
与我们的其他产品类似,Sora 编辑器使用 LLM 重写提交的文本,以便更有效地提示 Sora。这个过程促进了我们指南的遵守,包括删除公众人物的名字、用特定属性来描述人物以及以通用的方式描述品牌对象。我们维护各种类别的文本阻止列表,这些列表基于我们之前对 DALL·E 2 和 DALL·E 3 的研究、主动风险发现以及红队成员和早期用户的结果。
未来工作
OpenAI 采用迭代部署策略来确保负责任且有效地推出其产品。这种方法将分阶段推出、持续测试和持续监控与用户反馈和真实数据相结合,以随着时间的推移改进和提高我们的性能和安全缓解措施。以下是我们计划在 Sora 迭代部署中开展的一系列工作。
相似性试点
使用上传的真实人物照片或视频作为“种子”来生成视频的能力是潜在滥用的载体,我们正在采取特别渐进的方式来从早期的使用模式中学习。艺术家的早期反馈表明,这是一个他们看重的强大创意工具,但考虑到滥用的可能性,我们最初不会向所有用户提供它。相反,为了遵循我们的迭代部署实践,上传人物图像或视频的功能将提供给部分用户,我们将进行主动、深入的监控,以了解它对 Sora 社区的价值,并在学习过程中调整我们的安全方法。在此测试期间,不允许上传包含未成年人图像的内容。
出处和透明度计划
Sora 的未来迭代将继续通过研究反向嵌入搜索工具和继续实施 C2PA 等透明度措施来加强可追溯性。我们很高兴探索与非政府组织和研究组织的潜在合作伙伴关系,以发展和改善出处生态系统,并为 Sora 测试我们的内部反向图像工具。
扩大我们输出中的代表性
我们致力于通过及时改进、反馈循环和持续识别有效的缓解措施来减少潜在的输出偏差——认识到过度纠正同样有害。我们承认身体形象偏见和人口代表性等挑战,并将继续改进我们的方法,以确保平衡和包容的输出。
持续的安全、政策和道德协调
OpenAI 计划持续评估 Sora,并努力进一步提高 Sora 对 OpenAI 政策和安全标准的遵守程度。在不断发展的最佳实践和用户反馈的指导下,计划在相似性和欺骗性内容等领域进行进一步改进。
 492


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


