


c语言修炼秘籍 - - 禁(进)忌(阶)秘(技)术(巧)【第一式】数据的存储
【心法】
【第零章】c语言概述
【第一章】分支与循环语句
【第二章】函数
【第三章】数组
【第四章】操作符
【第五章】指针
【第六章】结构体
【第七章】const与c语言中一些错误代码
【禁忌秘术】
【第一式】数据的存储
【第二式】指针
【第三式】字符函数和字符串函数
【第四式】自定义类型详解(结构体、枚举、联合)
【第五式】动态内存管理
【第六式】文件操作
【第七式】程序的编译
文章目录
前言
本章节的重点是
- 数据类型详细介绍
- 整型在内存中的的存储:原码、反码、补码
- 大小端字节序介绍及判断
- 浮点型在内存中的存储解析
一、类型的介绍
在前面章节中我们已经学习了基本的内置类型:
char // 字符数据类型
short // 短整型
int // 整型
long // 长整型
long long // 更长的整型
float // 单精度浮点数
double // 双精度浮点数
// c语言有没有字符串类型?
// 没有
以及他们所占存储空间的大小。
类型的意义:
- 使用这个类型开辟内存空间的大小(大小决定了使用范围)
- 如何看待内存空间的视角
1.类型的基本归类
整型家族:
// 整形家族
char
	unsigned char
	signed char
short
	unsigned short
	signed short
int
	unsigned int
	signed int
long
	unsigned long [int]
	signed long [int]
浮点数家族:
float
double
构造类型:
// 数组类型
// 结构体类型 struct
// 枚举类型 enum
// 联合类型 union

// 数组类型
int arr1[10]; // 数组类型为int [10]
char arr2[5]; // 数组类型为char [5]
float arr3[7]; // 数组类型为float [7]

// 结构体类型
struct Stu
{
	char name[20];
	int age;
}

// 枚举类型
enum {
	Monday, // 默认为0
	Tuesday,
	Wednesday,
	Thursday,
	Friday,
	Saturday,
	Sunday
}

// 联合类型
union Un
{
	int i;
	char ch;
};
整型家族没什么可讲的,后三种会在后续章节介绍。
指针类型:
int *pi;
char *pc;
short *ps;
long *pl;
float *pf;
void *pv;
空类型:
void 表示空类型(无类型)
通常用于函数的返回参数、函数的参数、指针类型
二、整型在内存中的存储
众所周知,变量的创建是要在内存中开辟空间的。空间的大小是由变量的类型来决定的。
接下来我们就来讨论,数据在开辟给它们的内存中是如何存储的?
比如:
int a = 10;
int b = -20;
我们都知道,int类型占据4个字节的空间,那么它们在这4个字节中是如何存储的呢?
我们先了解下面的概念。
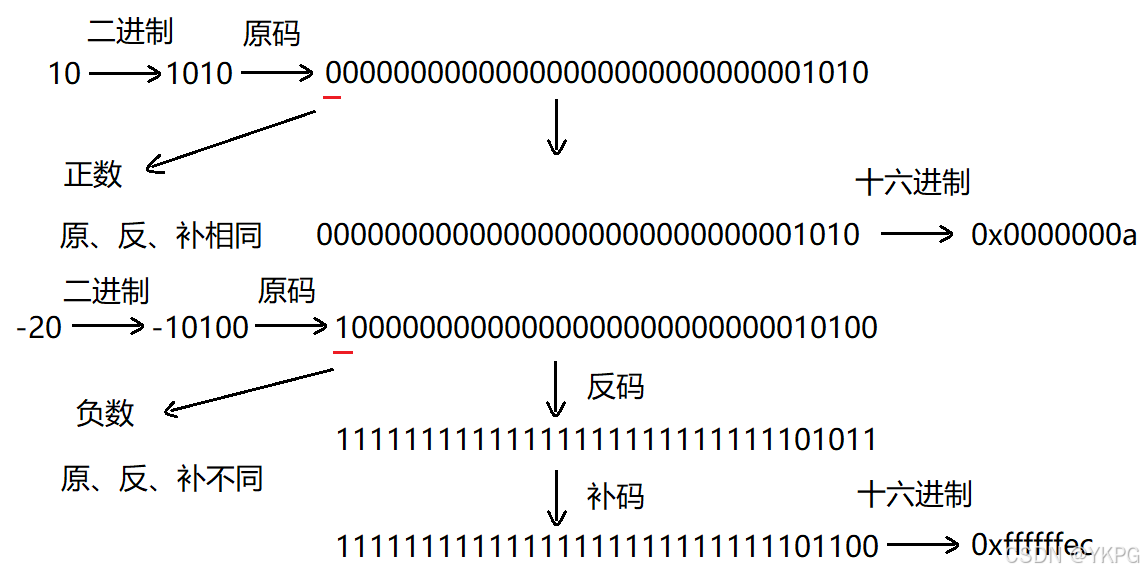
1.原码、反码、补码
计算机中的整数有三种表示方式:原码、反码、补码。
这三种表示方式都有:符号位和数值位两部分,符号位都是用0表示“正”,用1表示 “负”;
而数值位则是两种情况:
正数的原码、反码、补码都相同。
负数的这三种表示方式各不相同。
原码:
直接将二进制按照绝对值的形式翻译成二进制,再将符号位置1即可。
反码:
将原码的符号位不变,其他位依次按位取反即可。
补码:
反码 + 1即可得到。
对于整型来说,数据在内存中是以补码的形式存储的。
这是为什么呢?
在计算机系统中,数值一律以补码来表示和存储。原因在于,使用补码,可以将符号位和数值域统一处理。
同时,加法和减法也可以统一处理(CPU只有加法器),此外,补码和原码之间的转换,使用的逻辑相同,运算过程相同,不需要额外的电路。
原码 -> 反码 -> 反码 + 1 == 补码
补码 -> 反码 -> 反码 + 1 == 原码
让我们来看看变量a和b在内存的存储:
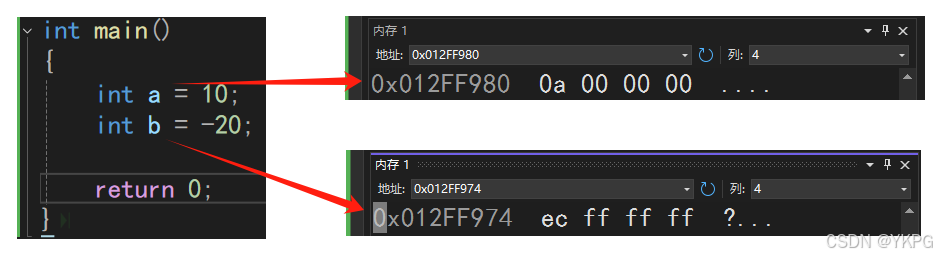
可以看到内存中存储的值好像是它们的补码,但它们的存储顺序好像比较奇怪,倒过来了?
这又是为什么呢?
2.大小端介绍
什么是大端小端?
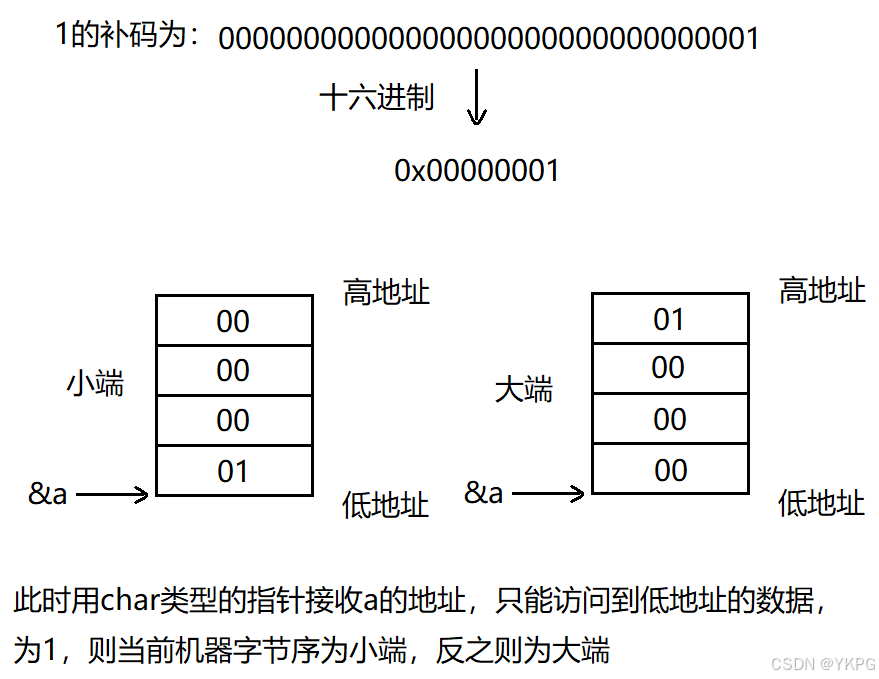
大端(存储)模式:指数据的高位存放在内存中的低地址,而数据的低位,保存在内存的高地址中;
小端(存储)模式:指数据的低位存放在内存中的低地址,而数据的高位,保存在内存的高地址中;
一个数据所占空间大于1个字节时,和数组的空间使用类似,从低位用到高位;
0a是变量a的值的低位,存放在内存分配给它的空间的低位地址上,显然上面的例子中,机器使用的就是小端存储模式。
那为什么要有大端小端呢?
这是因为在计算机系统中,我们的数据是以字节为单位进行存储的,每个地址都代表一个字节,但c语言中除了只占一个字节的char类型之外,还有长度大于1字节的类型,如short、int、long、float等等。另外,对于位数大于8位的处理器,由于其寄存器宽度大于一个字节时,此时对于这些数据,应付存在它们是以何种顺序安排在这片空间的问题。因此就有了大端和小端两种存储模式。
一道百度笔试题:
请简述大端字节序和小端字节序的概念,设计一个小程序来判断当前机器的字节序
// 方法一
#include <stdio.h>

int main()
{
	int a = 1;
	char *ch = (char*) &a;
	(*ch == 1)?printf("小端\n"):printf("大端\n");

	return 0;
}
运行结果:

还有另一种方法 - - 使用联合体union
#include <stdio.h>

int main()
{
	typedef union
	{
		char ch;
		int i;
	} Un;

	Un un;
	un.i = 1;
	(un.ch == 1) ? printf("小端\n") : printf("大端\n");

	return 0;
}
关于联合体如何使用,请看后续章节详解。
3.一些练习
练习1
#include <stdio.h>

int main()
{
	char a = -1;
	signed char b = -1;
	unsigned char c = -1;
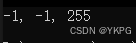
	printf("%d, %d, %d\n", a, b, c); // 会输出什么?

	return 0;
}
分析:
a,b,c都是用-1赋值的,所以它们在内存中的值都是11111111
在printf()函数中要以int类型的格式输出时,因为长度不足4个字节,需进行整型提升
变量a和b都是有符号的变量,在整型提升时需要考虑符号位(最高位),它们的符号位为1,所以用1补足至4个字节,此时它们的值为11111111111111111111111111111111,转换为int类型,它表示-1;
变量c是无符号的变量,整型提升时直接补0即可,此时它的值为00000000000000000000000011111111,表示255。
所以该代码输出为:
-1, -1, 255
运行结果:
练习2
#include <stdio.h>

int main()
{
	char a = -128;
	printf("%u\n", a);

	return 0;
}
分析:
-128的补码为11111111111111111111111110000000,将其赋值给char类型的变量a,此时会进行截断处理,a的内存空间中保存的值是10000000。
要以无符号整型的格式输出,此时要进行整型提升,a是有符号的变量,以其符号位补足4字节,补码为11111111111111111111111110000000,将该补码以无符号的格式输出,输出结果为4294967168
运行结果:
练习3
#include <stdio.h>

int main()
{
	char a = 128;
	printf("%u\n", a);

	return 0;
}
分析:
128的补码为00000000000000000000000010000000,a中保存的值为10000000,输出打印时,需要整型提升,a为char类型有符号,补1,此时补码为11111111111111111111111110000000,输出4294967168。
运行结果:
练习4
#include <stdio.h>

int main()
{
	int i = -20;
	unsigned int j = 10;
	printf("%d\n", i + j);

	return 0;
}
分析:
-20的补码为11111111111111111111111111101100,10的补码为00000000000000000000000000001010,无符号整型+有符号整型,结果会隐式转换为无符号整型,结果的补码为11111111111111111111111111110110,以有符号整型的格式输出,所以输出结果为-10。
运行结果:

练习5,下面代码会输出什么?
#include <stdio.h>

int main()
{
	unsigned int i;
	for (i = 9; i >= 0; i--)
	{
		printf("%u\n", i);
	}

	return 0;
}
分析:
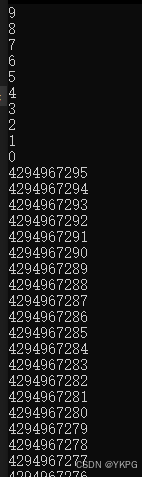
此程序会陷入死循环;
变量 i 是一个无符号整型,它的最小值就是0,出就是说 i 不可能小于0,这个for判断条件恒为真,所以陷入了死循环。
运行结果:
练习6
#include <stdio.h>
#include <string.h>

int main()
{
	char a[1000];
	int i;

	for (i = 0; i < 1000; i++)
	{
		a[i] = -i - 1;
	}
	printf("%d\n", strlen(a));


	return 0;
}
分析:
该程序在for循环中对char类型的数组赋值,并在结束时输出该char数组的长度,也就是要找数组中’\0’是位置,'\0’对应的ASCII码值为0,也就是要找一个 i 使得-1 - i的二进制后八位全为0,-1的补码为11111111111111111111111111111111,离它最近的满足条件的补码为11111111111111111111111100000000,也就是-256,所以 i == 255时,a[i] == ‘\0’。
运行结果:

练习7
#include <stdio.h>

unsigned char i = 0;

int main()
{
	int count = 0;
	for (i = 0; i <= 255; i++)
	{
		printf("hello world, ");
		printf("count == %d\n", ++count);
	}

	return 0;
}
分析:
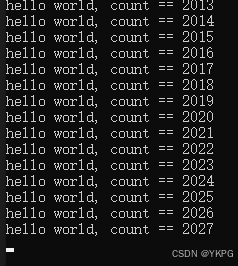
变量 i 是一个无符号的char类型,取值范围为0 ~ 255,所以这也是一个死循环。
运行结果:
三、浮点型在内存中的存储
常见的浮点数
3.14159
1E10
浮点数家族包括:float、double、long double类型。
浮点数表示的范围:在float.h中定义
1.一个例子
浮点数存储的例子:
#include <stdio.h>

int main()
{
	int n = 9;
	float *pf = (float*)&n;
	printf("n的值为:%d\n", n);
	printf("*pf的值为:%f\n", *pf);

	*pf = 9.0;
	printf("n的值为:%d\n", n);
	printf("*pf的值为:%f\n", *pf);

	return 0;
}
运行结果:
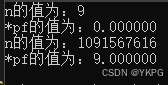
可以看到,使用整型格式和浮点数格式打印的结果并不相同。
这就说明了,整型数据和浮点数的内存格式是不同的。
整型数据在内存中是以补码的形式存储的,那么浮点数在内存中是如何存储的呢?
2.浮点数的存储规则
根据国际标准IEEE754,任意一个二进制浮点数V可以表示成下面的形式:
-1 ^ S * M * 2 ^ E
-1 ^ S表示符号位,当S=0时,表示正数;S=1时,表示负数;
M表示有效数字,大于等于1,小于2;
2 ^ E表示指数位;
举个例子
十进制的5.0,写成二进制为101,相当于1.01 * 2 ^ 2。
那么按照上面的V的形式,S=0,M=1.01,E=2。
十进制的-5.0,写成二进制为-101,相当于-1.01 * 2 ^ 2。
写成V的形式,S=1,M=1.01,E=2。
IEEE754规定:
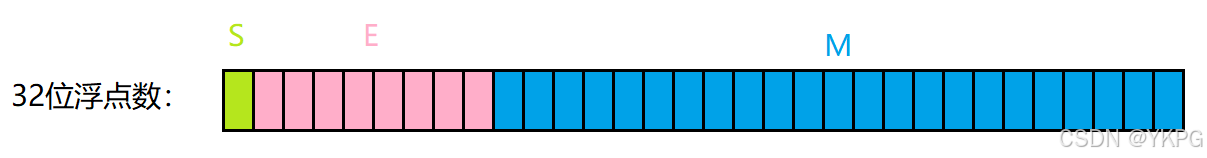
对于32位的浮点数,最高的1位为符号位S,接着的8位为指数位E,剩余的23位为有效数字M。
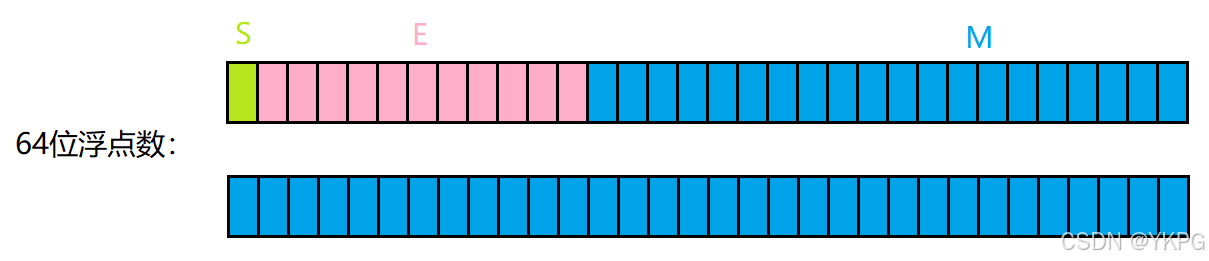
对于64位的浮点数,最高的1位为符号位S,接着的11位为指数位E,剩余的52位为有效数字M。
IEEE754对有效数字M和指数E,还有一些特殊规定。
有效数字M:
存入内存:
因为有效数字M的取值范围为1≤M<2,所以M的第一位永远都是1,所以该位可以省略,直接从小数点后的第一位开始存储。
比如保存1.01时,只保存01,等到要读取的时候再把第一位的1加上。这样做的目的是节省一位有效数字。以32位的浮点数为例,M只有23位,将第一位的1省略,就可以保存24位有效数字。
指数E:
首先,E是一个无符号整数;
如果E为8位,那么E的取值范围为0~255;如果E为11位,那么E的取值范围为0~2047。但这存在一个问题,科学计数法中的E是可能出现负值的,所以IEEE 754规定,存入内存的E的真实值必须再加上一个中间数,对于8位的E,这个中间数是127;对于11位的E,这个中间数为1023。
比如:2 ^ 10,此时E=10,所以保存为32位浮点数时,指数E必须保存为10 + 127 = 137,即10001001
从内存中取出:分为三类
- E不全为0或不全为1:
这时浮点数的值就采用下面的规则,E的计算值(保存在内存中的值)减去127(或1023),得到指数E的真实值,M的前面加上第一位的1。
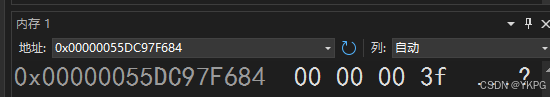
例如,0.5的二进制形式为0.1,由于有效数字M必须在1和2之间,所以写成,1.0 * 2 ^ -1,M为1.0,写入内存中时去掉第一位的1,所以就是23个0,指数E的真实值为-1,存入内存需要+127,所以E的计算值为126,所以内存中的E为01111110,0.5为正数,符号位S=0,所以0.5在内存中的二进制为0 01111110 00000000000000000000000,写成十六进制为0x3f000000。
可以看到这里是小端字节序。2.E全为0:
此时E的真实值固定为1 - 126(或1 - 1023),有效数字M不再加上第一位的1,而是直接还原成0.xxxxxx的小数。这样用来表示±0,以及接近0的很小的数字。
换个角度想想,指数E在+127之后都还是全0,那么这个数至少都是M * 2 ^ -127,2 ^ -127这是一个极小的数了,也就相当于0。
测试代码在下面。
- E全为1
这种情况最简单,有效数字M全为0表示无穷大(inf);不全为0表示无效数字(NaN)。
测试代码在下面
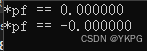
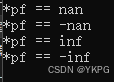
// 指数 E全为 0
#include <stdio.h>

int main()
{
	float f = 0.5;
	int i = 7340032; // 0000 0000 0111 0000 0000 0000 0000 0000 -- 0x0070 0000
	float *pf = &i;
	printf("*pf == %f\n", *pf);

	i = -2140143616; // 1000 0000 0111 0000 0000 0000 0000 0000 -- 0x8070 0000
	pf = &i;
	printf("*pf == %f\n", *pf);

	return 0;
}
// 指数 E全为 1
#include <stdio.h>

int main()
{
	float f = 0.5;
	int i = 2146435072; // 0111 1111 1111 0000 0000 0000 0000 0000 -- 0x7ff0 0000
	float* pf = &i;
	printf("*pf == %f\n", *pf);

	i = -1048576; // 1111 1111 1111 0000 0000 0000 0000 0000 -- 0xfff0 0000
	pf = &i;
	printf("*pf == %f\n", *pf);

	i = 2139095040; // 0111 1111 1000 0000 0000 0000 0000 0000 -- 0x7f80 0000
	pf = &i;
	printf("*pf == %f\n", *pf);

	i = -8388608; // 1111 1111 1000 0000 0000 0000 0000 0000 -- 0xff80 0000
	pf = &i;
	printf("*pf == %f\n", *pf);

	return 0;
}
这下我们讲解了浮点数在内存中是如何存储的之后,我们再来看看,最开始的例子:
9的二进制形式为00000000000000000000000000001001,将其以浮点数格式输出,此时的E为全0,对应第二种情况,所以输出0。
浮点数9.0的二进制数为1001,有效数字M为1.001,E的真实值为3,所以E的计算值为130,表示为二进制为10000010,符号位S为0,所以内存中的值为0 10000010 00100000000000000000000对应十六进制为0x41100000,对应10进制数为1091567616,结果符合预期。
总结
本节详细的介绍了c语言中定义的类型在内存中是以何种形式进行保存的,在学习完这部分之后,应该尽量在写代码或读代码时,就能像是在看内存一样,这样能减少许多逻辑正确,但因为数据保存在内存的格式与预期设计不符而出现的错误。

 478


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


