


c语言修炼秘籍 - - 禁(进)忌(阶)秘(技)术(巧)【第六式】文件操作
【心法】
【第零章】c语言概述
【第一章】分支与循环语句
【第二章】函数
【第三章】数组
【第四章】操作符
【第五章】指针
【第六章】结构体
【第七章】const与c语言中一些错误代码
【禁忌秘术】
【第一式】数据的存储
【第二式】指针
【第三式】字符函数和字符串函数
【第四式】自定义类型详解(结构体、枚举、联合)
【第五式】动态内存管理
【第六式】文件操作
【第七式】程序的编译
文章目录
前言
本章重点:
- 为什么使用文件
- 什么是文件
- 文件的打开和关闭
- 文件的顺序读写
- 文件的随机读写
- 文本文件和二进制文件
- 文件读取结束的判定
- 文件缓冲区
一、为什么使用文件
前两章中我们使用结构体写了通讯录的程序,当通讯录运行起来时,可以在通讯录中增加、删除数据,此时数据是放在内存中的,当程序退出时,通讯录中的数据就不得存在了,下次再次运行通讯录时,数据又得重新录入,这样用户的使用体验是极差的。
使用通讯录的目的就是保存联系人的信息,只有当我们删除一个信息时,它才会消失,这涉及到了数据持久化的问题。而数据持久化的方法有:将数据存放在磁盘文件中、存放在数据库中等方式。
所以我们使用文件的目的就是实现数据持久化;
二、什么是文件
磁盘上的文件就是文件。
但是在程序设计上,我们谈到的文件一般有两种:程序文件、数据文件;
1. 程序文件
包括源程序(后缀为.c),目标文件(后缀为.obj),可执行文件(windows环境下后缀为.exe)
2. 数据文件
文件的内容不一定是程序,也可以是程序运行时读写的数据,比如程序运行时,需要从中读取数据的文件,或用于保存输出数据的文件。
本章讨论的文件是数据文件;
在以前各章所处理的数据都是以终端为对象的,即从终端的键盘输入数据,运行结果输出显示到显示器上。
其实有时候我们会把信息输出到磁盘上,当需要的时候再从磁盘中把数据读取到内存中使用,这里处理的就是磁盘上的文件;
3. 文件名
一个文件要有一个唯一的文件标识,以便用户识别和引用;
文件名包括3个部分:文件路径、文件名主干、文件后缀;
例如:C:\code\test.txt
为了方便起见,文件标识常被称为文件名
三、文件的打开和关闭
1. 文件指针
缓冲文件系统中,关键的概念是“文件类型指针”,简称“文件指针”。
每个被使用的文件都在内存中开辟了一个相应的文件信息区,用来存放文件的相关信息(如文件的名字,文件状态及文件当前的位置等)。这些信息是保存在一个结构体变量中的。该结构体类型是有系统声明的,取名FILE。
每当打开一个文件的时候,系统都会根据文件的情况创建一个FILE结构的变量,并填充其中的信息,使用者不需要关心其中的细节。
一般都是通过一个FILE类型的指针来维护这个FILE类型的变量;
一般通过下面的方式来创建一个指向文件类型的指针
FILE *pf = NULL; // 初始化为空指针
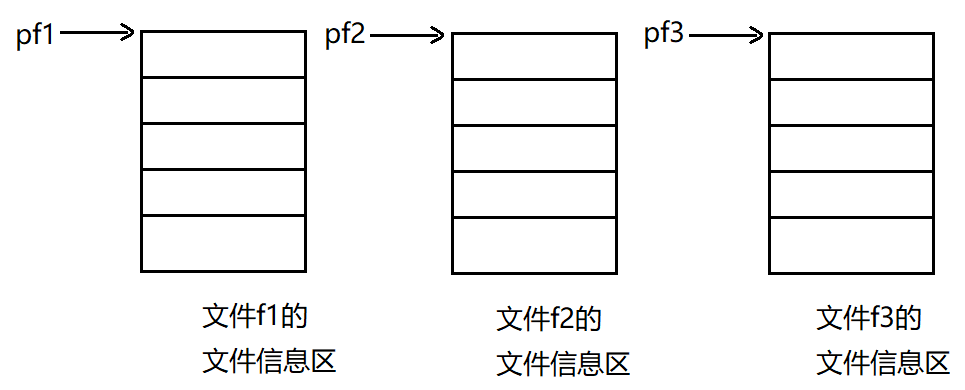
这个变量pf可以用来指向一个文件的文件信息区(这是一个结构体变量)。通过访问文件信息区中的内容就可以获取到这个文件中保存的信息,也就是说这个指针变量找到与它关联的文件,可以通过它来访问这个文件中保存的信息,并修改其中的内容。
例如:
2. 文件的打开和关闭
文件在读写之前应该要先打开文件,在使用结束之后应该要关闭文件。
在编写程序的时候,在打开文件的同时都会返回一个FILE*的指针变量指向该文件,也相当于建立了指针和文件之间的关系。
ANSIC规定使用fopen函数来打开文件,fclose函数来关闭文件;
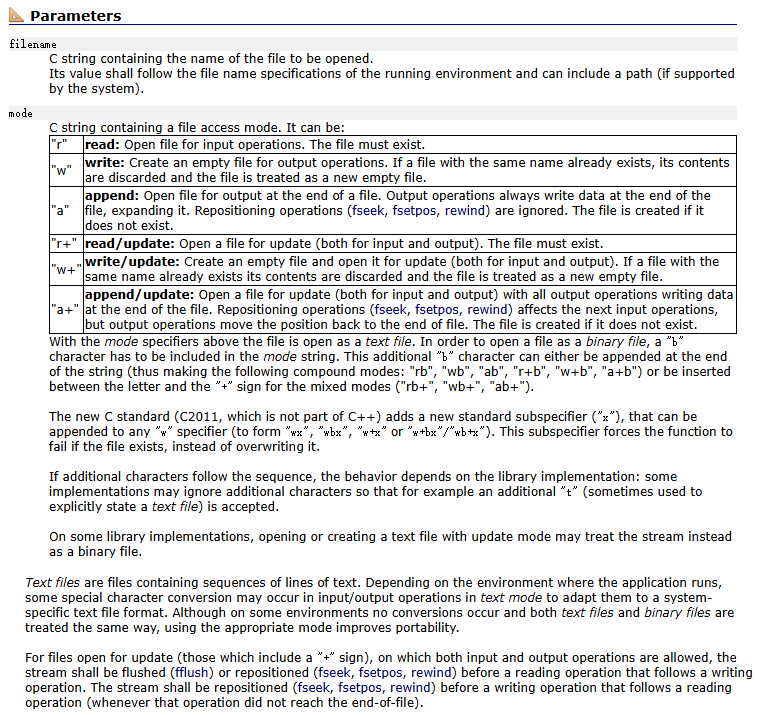
fopen函数的功能是打开一个文件,接收两个参数,一个表示文件名,一个表示以什么方式打开文件,返回一个FILE类型的指针,并将这个文件和一个流相关联,在之后的操作中可以通过返回的FILE类型的指针来识别这个流;- 流上允许的操作和这些操作如何执行由mode这个参数决定;
- 默认情况下,返回的流在未指定要交互的设备时,会被完全缓冲;
- 返回的指针可以通过调用fclose或freopen来与文件解绑定,所有打开的文件都会在程序结束时自动关闭;
- filename这个参数是一个const修饰的字符指针,表示要打开的文件名;它的值应该满足运行环境的命名标准,并且可以包含一个路径(如果系统支持);
- mode这个参数也是一个字符指针(一般是一个字符串常量),用这个参数来表示以什么方式打开文件。
| 文件使用方式 | 含义 | 指定的文件不存在 |
|---|---|---|
| “r” | 输入数据,打开一个已存在的文件 | 出错 |
| “w” | 打开一个文件用于输出数据(如果这个文件不存在,创建一个新的空文件;如果已经存在这个文件,会擦除里面的内容,将它当作一个新的空文件) | 创建一个新文件 |
| “a” | 打开一个文件用于输出数据,将数据追加到文件中内容的末尾,会忽略重定位操作。和"w"一样,如果文件不存在会创建一个新文件。 | 创建一个新文件 |
| “r+” | 打开一个文件用于输入和输出,这个文件必须存在 | 出错 |
| “w+” | 创建一个新文件,打开并更新它(既有输入也有输出);如果这个文件已存在,则将它的内容全部清除,将它当成一个新的空文件来使用 | 创建一个新文件 |
| “a+” | 打开一个文件并更新这个文件(输入和输出),所有的输出操作都在文件的末尾添加,重定位操作会影响下一个输入操作,要输出时会将位置自动移到文件末尾 | 创建一个新文件 |
使用上面的模式说明符,文件将作为文本文件来打开;为了以二进制文件形式来打开文件,应该在上面的模式符字符串中包含一个b字符。它可以添加在最后,就像(“rb”、“wb”、“ab”、“r+b”、“w+b”、“a+b”);或者将它加在字母和’+'之间,就像(“ab+”、“wb+”、“ab+”)
文本文件是包含了文本行序列的文件;取决于应用的运行环境,在读入、写出过程中会出现一些特殊字符的转换以适配系统指定的文本文件格式;虽然有些环境下并不会出现这种转换,并且该环境以相同的方式来处理文本文件和二进制文件,但使用恰当的mode参数可以提高可移植性。
对于那些为更新数据而打开的文件(打开模式中有’+'的),或输入和输出两种操作都可以的文件,在写操作之后执行读操作应该将流刷新或进行重定位操作;在进行读操作后面的写操作时,应该执行重定位;
至于前面提到的输入输出,是以内存为参照物的,数据向内存中流动就是输入,也叫读入;从内存流向外部就是输出,也叫写出;
- 如果文件成功打开,这个函数就返回一个指向这个文件的指针;否则返回一个
NULL指针;
注意:参数mode是一个字符串,不能误写成'w'这种;
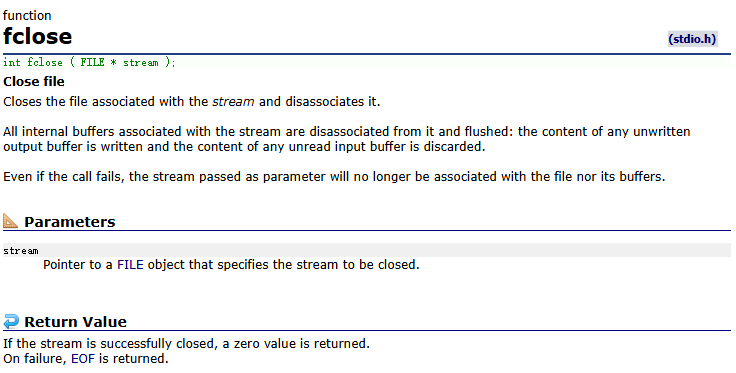
- fclose的功能是关闭文件,关闭与流相关联的文件,并取消它们之间的关联;
- 所有与流相关联的内部缓冲区都将与该流解除关联并刷新:输出缓冲区中的未写的内容都将被写出,输入缓冲区中未读入的内容都将被丢弃;
- 即使调用失败,参数中传递进来的流也将与文件和缓冲区解除关联;
- 只有一个参数,它是指向FILE对象的指针,它指定要被释放的流;
- 如果流被成功的关闭了,就返回一个0;关闭失败返回一个EOF;
注意
这里和free函数相同,fclose仅会将这个指针和流解除关联,并不会自动将它置为NULL指针,所以在fclose之后,应该跟上一个将指针置空的语句;
实例代码:
#include <stdio.h>

int main()
{
	FILE *pf;
	pf = fopen("test.txt", "w");

	if (pf == NULL)
	{
		perror("fopen");
		return ;
	}

	char *str = NULL;

	fputs("fopen example", pf);
	fclose(pf);
	pf = NULL;

	return 0;
}
上方中提到的流到底是什么呢?
它是一个高度抽象的概念;
程序是会向外输出数据的,这些数据可以输出到各种不同的设备中,如屏幕、硬盘、U盘、光盘,还可以上传到网络中,而数据流向这此设备的方式是不同的,程序员要将数据输出到这些设备中就需要了解数据在这些设备上的格式,显然这是相当不便于使用的,所以就设计出了流这么一个概念,将程序和设备之间增加一个中间件,这样程序员就只需要将数据交给流,剩下的工作交给流来完成;
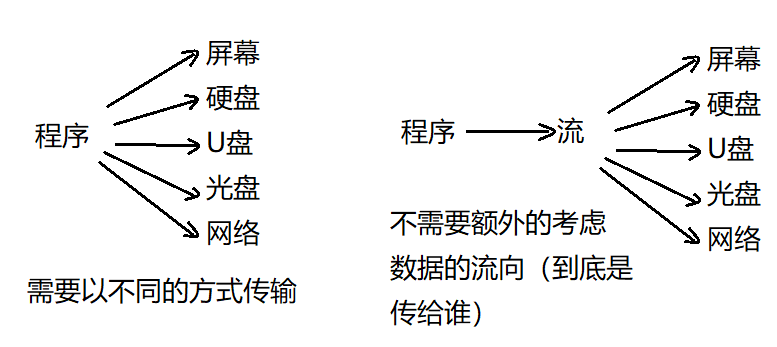
程序中的数据就像水流一样,流向不同的终点,但过程不需要理会,所以它就叫作流
而c程序运行起来就会默认打开3个流:
- stdin:标准输入流,对应键盘;
- stdout:标准输出流,对应屏幕;
- stderr:标准错误流,对应屏幕;
所以之前我们的程序使用printf()函数进行输出时,输出的结果都显示在屏幕中;使用scanf函数可以从键盘中读取数据;
四、文件的顺序读写
可以使用下面的函数来对文件进行顺序读写:
| 功能 | 函数名 | 适用于 |
|---|---|---|
| 字符输入函数 | fgetc | 所有输入流 |
| 字符输出函数 | fputc | 所有输出流 |
| 文本行输入函数 | fgets | 所有输入流 |
| 文本行输出函数 | fputs | 所有输出流 |
| 格式化输入函数 | fsacnf | 所有输入流 |
| 格式化输出函数 | fprintf | 所有输出流 |
| 二进制输入函数 | fread | 文件 |
| 二进制输出函数 | fwrite | 文件 |
1. fgetc与fputc
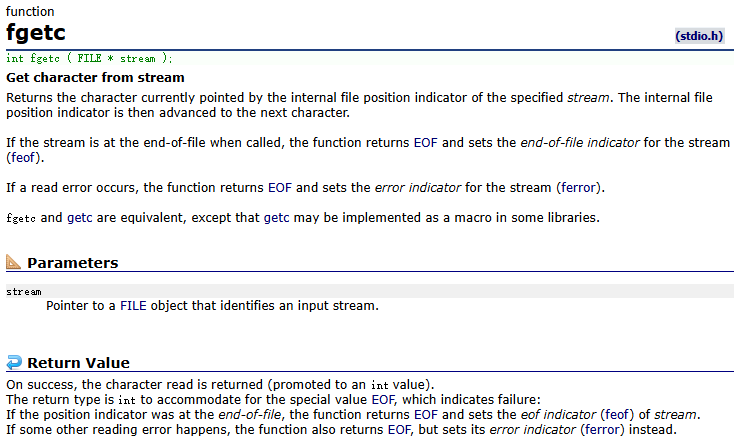
- fgetc的功能是从流中获取字符,返回指定流中内部的文件位置指针当前指向的字符。并将这个内部的文件位置指针移向下一个字符;
- 如果调用时发现这个流处于文件的末尾,这个函数将会返回
EOF并为流设置文件结束标志; - 如果读取失败,这个函数会返回EOF,并且为流设置错误标志;
fgetc和getc这两个函数是等价的,除了某些库会将getc以宏的形式来实现;- 参数是一个指向
FILE类型对象的指针,用它来识别一个输入流; - 当这个函数成功时,将返回被读取的字符(以整型返回,ASCII值);返回整型类型的原因是为了适应出错时返回的特殊值
EOF:- 如果位置指针指在文件尾,函数返回EOF,并为流设置结束标志EOF;
- 如果读取出错,函数也返回
EOF,但改设错误标志代替;
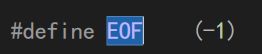
头文件stdio.h中定义了EOF:它是一个整型数值,-1;
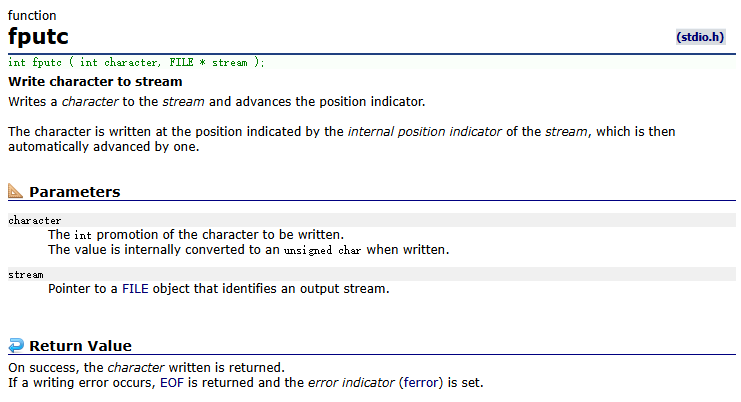
- 写一个字符到流中,并将位置指示标志往后移动一位;
- 这个字符将被写在由流的内部位置标志指示的位置,并在此之后自动往后移动一位;
- 有两个参数:
- character:要写入的字符的ASCII码值;这个值会在写入内部时转换成一个无符号的字符类型;
- stream:指向一个标识了一个输出流的
FILE对象的指针;
- 当成功时,会返回这个被成功写入的字符,同样以整型类型;如果写操作失败,会返回一个EOF,并设置一个错误标志;
看代码:
#include <stido.h>
int main()
{
	// 以 r模式打开一个文件,从中读取数据,此文件必须存在
	FILE* pf = fopen("test.txt", "r");
	// 此时当前目录下并没有这个文件
	if (pf == NULL)
	{
		printf("test.txt isn`t exist");
	}
	fclose(pf);
	pf = NULL;

	// 以 w模式打开文件,往里面写数据
	pf = fopen("test.txt", "w");
	// 以 w模式打开文件时,如果文件不存在则会自动创建一个文件
	if (pf == NULL)
	{
		perror("fopen");
		return ;
	}

	// 往test.txt这个文件中写hello
	fputc('h', pf);
	fputc('e', pf);
	fputc('l', pf);
	fputc('l', pf);
	fputc('o', pf);

	// 写操作结束,关闭文件
	fclose(pf);
	pf = NULL;

	// 再打开文件从中读取数据
	pf = fopen("test.txt", "r");
	// 此时当前目录下已经存在这个文件,里面的内容为hello
	if (pf == NULL)
	{
		printf("test.txt isn`t exist");
		return ;
	}

	// 依次从pf这个流中读取5个字符
	printf("%c", fgetc(pf));
	printf("%c", fgetc(pf));
	printf("%c", fgetc(pf));
	printf("%c", fgetc(pf));
	printf("%c", fgetc(pf));
	// 读取结束,关闭文件
	fclose(pf);
	pf = NULL;

	return 0;
}
运行结果:
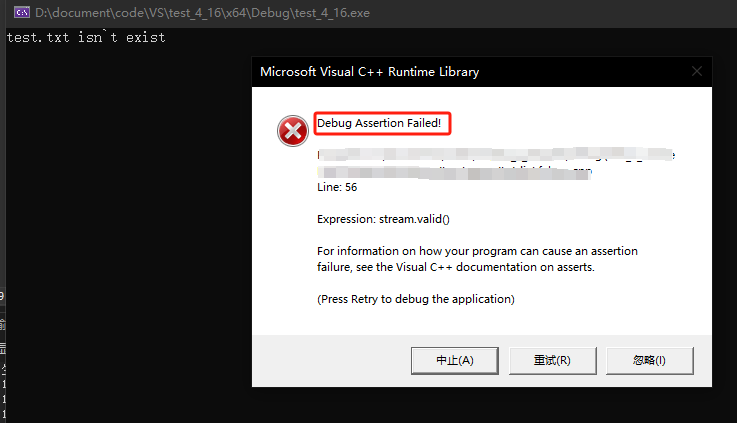
可以看到当目录中没有要打开的文件时,使用fopen的r模式是会出错的;
将第一个打开文件的代码注释掉,继续执行:
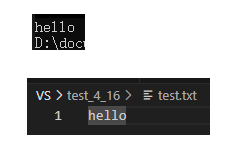
可以看到最后的执行结果是符合预期的,并且也在当前目录下创建了test.txt文件;
从不同的流中读取数据:
#include <stdio.h>

int main()
{
	// 读文件
	FILE* pf = fopen("test.txt", "r");
	if (pf == NULL)
	{
		perror("fopen");
		return ;
	}

	int ret = 0;

	// 从文件中读数据
	ret = fgetc(pf);
	printf("%c", ret);
	ret = fgetc(pf);
	printf("%c", ret);
	ret = fgetc(pf);
	printf("%c", ret);
	ret = fgetc(pf);
	printf("%c", ret);
	ret = fgetc(pf);
	printf("%c", ret);

	// 关闭文件
	fclose(pf);
	pf = NULL;

	printf("\n");
	// 从标准输入流中获取数据,键入world
	ret = fgetc(stdin);
	printf("%c", ret);
	ret = fgetc(stdin);
	printf("%c", ret);
	ret = fgetc(stdin);
	printf("%c", ret);
	ret = fgetc(stdin);
	printf("%c", ret);
	ret = fgetc(stdin);
	printf("%c", ret);

	return 0;
}
运行结果:

2. fgets与fputs
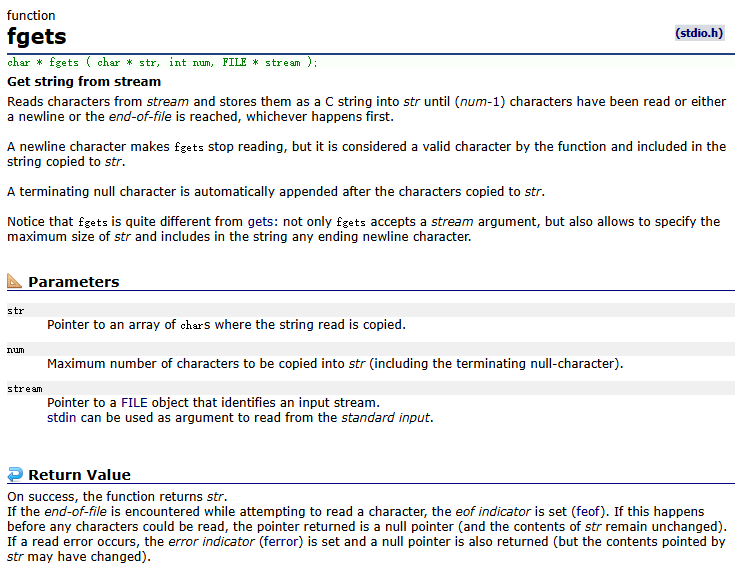
- 它的功能是从流中获取一个字符串,从流中获取字符并将它们以一个字符串的形式保存在
str这个字符指针中,一直进行到保存了num-1个字符,或读取到一个换行符,亦或是遇到了文件结束标志; - 一个换行符会让
fgets函数停止读取,但它仍被认为是一个有效字符,并会被包含在字符串str中; - 这个函数会自动在拷贝到str的字符后面添加一个
\0 - 它接受三个参数:
- str:指向接收读取到的字符串的字符数组;
- num:表示str这个字符数组中最多能接收的字符数;
- stream:指向标识输入流的FILE类型对象,可以使用stdin作为参数,也就是能从键盘中读取数据;
- 函数执行
成功,它就会返回字符指针str;当读取字符时遇到了文件结束标志,(EOF),则会设置eof指示标志,如果在发生这种情况时,还未读取到任何字符,该函数就会返回一个空指针(此时str中的内容并没有发生改变),之前读取到了字符就正常返回str即可;如果读取时出错,就会设置错误标志,并返回一个空指针(此时str指向的空间中的内容已经发生改变);
注意:该函数并不会检查溢出;
使用示例:
#include <stdio.h>

int main()
{
	// 打开一个文件,向文件中写入数据
	FILE* pf = fopen("test.txt", "w");
	if (pf == NULL)
	{
		perror("fopen");
		return ;
	}

	fputc('h', pf);
	fputc('e', pf);
	fputc('l', pf);
	fputc('l', pf);
	fputc('o', pf);

	fclose(pf);
	pf = NULL;

	pf = fopen("test.txt", "r");
	if (pf == NULL)
	{
		perror("fopen");
		return;
	}

	char str[10] = { 0 };
	// 从文件test.txt中读取5个字符,实际只读取 5 - 1个字符
	// 所以预期输出结果为hell
	printf("%s", fgets(str, 5, pf));

	fclose(pf);
	pf = NULL;

	return 0;
}
运行结果:

当提前遇到了\0
#include <stdio.h>

int main()
{
	// 打开一个文件,向文件中写入数据
	FILE* pf = fopen("test.txt", "w");
	if (pf == NULL)
	{
		perror("fopen");
		return;
	}

	fputc('h', pf);
	fputc('e', pf);
	fputc('l', pf);
	fputc('l', pf);
	fputc('o', pf);

	fclose(pf);
	pf = NULL;

	pf = fopen("test.txt", "r");
	if (pf == NULL)
	{
		perror("fopen");
		return;
	}

	char str[10] = { 0 };
	// 从文件test.txt中读取8个字符,实际只读取 7 - 1个字符
	// 此时文件中只有5个字符
	printf("%s", fgets(str, 8, pf));

	fclose(pf);
	pf = NULL;

	return 0;
}
运行结果:

当文件中没有数据时
#include <stdio.h>

int main()
{
	// 打开一个文件,向文件中写入数据
	FILE* pf = fopen("test.txt", "w");
	if (pf == NULL)
	{
		perror("fopen");
		return;
	}
	fclose(pf);
	pf = NULL;

	pf = fopen("test.txt", "r");
	if (pf == NULL)
	{
		perror("fopen");
		return;
	}

	char str[10] = { 0 };
	// 从文件test.txt中读取8个字符,实际只读取 7 - 1个字符
	// 此时文件test.txt是一个空文件
	printf("%s", fgets(str, 8, pf));

	fclose(pf);
	pf = NULL;

	return 0;
}
运行结果:

出现溢出时
#include <stdio.h>

int main()
{
	// 打开一个文件,向文件中写入数据
	FILE* pf = fopen("test.txt", "w");
	if (pf == NULL)
	{
		perror("fopen");
		return ;
	}

	fputc('h', pf);
	fputc('e', pf);
	fputc('l', pf);
	fputc('l', pf);
	fputc('o', pf);
	fputc(' ', pf);
	fputc('w', pf);
	fputc('o', pf);
	fputc('r', pf);
	fputc('l', pf);
	fputc('d', pf);

	fclose(pf);
	pf = NULL;

	pf = fopen("test.txt", "r");
	if (pf == NULL)
	{
		perror("fopen");
		return;
	}

	char str[5] = { 0 };
	// 从文件test.txt中读取8个字符,实际只读取 7 - 1个字符
	// 但str这个数组只能容纳5个字符,此时会出现越界访问
	printf("%s", fgets(str, 8, pf));

	fclose(pf);
	pf = NULL;

	return 0;
}
运行结果:

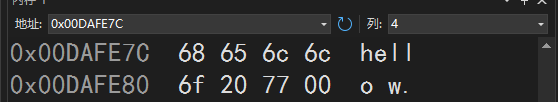
可以看到,str这个数组只能存储5个字符,结果fgets函数向str指向的空间复制了7个字符(第八个字符是自动添加的\0);
由此可见,该函数确实不会对越界访问作检查;
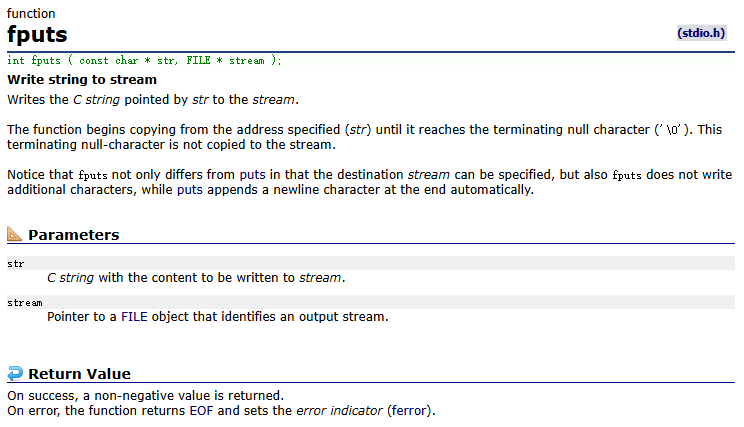
- 向一个流中写一个字符串;将字符指针
str指向的字符串写入流中; - 这个函数会将str指向的整个字符串全部写入stream标识的流中(一直写到遇到了
\0),\0并不会写入流中; - 该函数有两个参数:
- str:一个字符指针,指向要写的内容;
- stream:标识了输出流的FILE类型对象;
- 当执行成功时会返回一个非负值;出错时,函数会返回
EOF,并设置错误标志;
使用示例:
#include <stdio.h>

int main()
{
	FILE* pf = fopen("test.txt", "w");
	if (pf == NULL)
	{
		perror(pf);
		return ;
	}

	const char *str = "hello";
	fputs(str, pf);

	fclose(pf);
	pf = NULL;

	return 0;
}
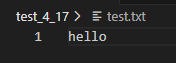
3. fscanf与fprintf
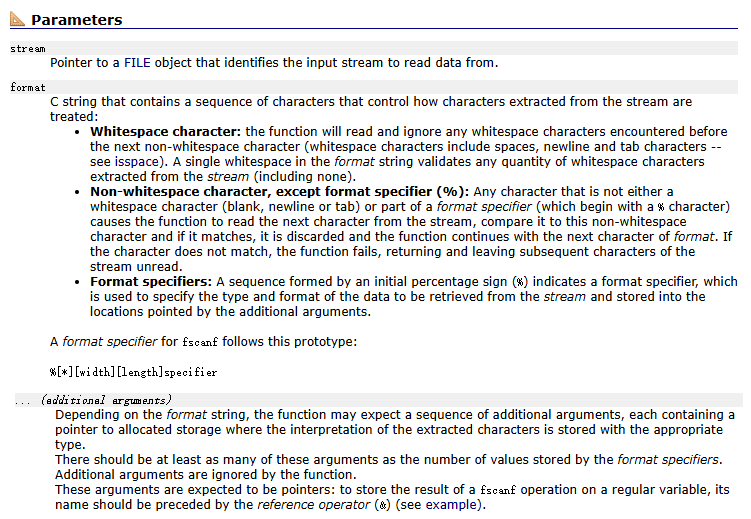
- 该函数的功能和用法都与scanf类似,都是从流中读取数据,并根据参数format的指定的格式将读取到的数据保存到由额外参数指定的位置中;额外参数应该是一个指向一片保存format参数中对应类型的空间的指针;
- 有多个参数:
- 第一个参数stream表示将要从这个流中获得数据,scanf函数中,就没有这个参数,因为scanf函数使用的是标准输入流stdin,该函数可以由使用者指定流;
- 第二个参数format,它是一个字符串,包含了一个字符序列,该序列控制字符从流中的提取方式;
- 空白字符:该函数会读取并忽略在下一个非空白字符前遇到的所有空白字符(包括,空格、换行、制表符等等);在参数format中的一个单独的空白符会与流中任意数量的空白符进行匹配(包括0个,所以在format参数中,连续的空白符与单个空白符等价);
- 非空白字符,除了格式标识符(%):任何既不是空白字符也不是一个格式标识符的一部分的字符,会让函数将从流中读取的下一个字符与它进行比较,如果相同则读取这个字符并将其丢弃,函数再继续往后读取;如果不相同,则函数出错,返回已经读取的数据,并释放流中剩余的未读取的字符;
- 格式标识符:一个由%开始的字符序列表明了一个格式标识符,它用来指明从流中读取出的数据的类型和格式,并将它们保存在由额外参数指定的位置中;该参数的原型为:%[*][width][length]specifier;其中[length]并不常用;*表示在流中遇到这个类型的数据时,忽略掉它们,并将它们丢弃,例如:
%*s表示读取到字符串类型会被丢弃;[width]表示这个标识符对应能读取的字符数量;
- 额外参数:与format中的类型对应,用于接收从流读取的数据;
- 成功时,函数会返回本次读取操作成功读取了多少个参数列表中的对应数据,这个返回值应该等于或小于format中数量,因为可能出现匹配失败、读错误或读到文件尾;如果发生了读错误或在读取数据时遇到了文件结束符,会设置对应的标记,并且返回EOF;
| 标识符 | 含义 | 能提取的字符 |
|---|---|---|
| i,u | 整型 | 由0-9组成的任意数字,前面可以加一个符号(+ \ -),如果有前缀0则表示八进制(0-7),有前缀0x表示十六进制(0-9,a-f) |
| d | 十进制数 | 0-9之间的数字组成,可添加符号(+-) |
| o | 八进制数 | 0-7之间的数字组成的数,可添加符号(+-) |
| x | 十六进制 | 0-9,a-f,A-F之间的字符组成的数字,可添加符号(+-) |
| f,lf | 浮点数 | 有小数点的十进制数,可添加符号(+-) |
| c | 字符 | 读取流中的下一个字符,不会在其后面自动添加\0 |
| s | 字符串 | 读取任意个非空字符,直到遇到第一个空白字符就停止,会在存储位置的最后自动添加一个\0 |
| p | 指针的地址 | 一个代表指针的字符序列,它的特殊结构取决于系统和库实现 |
| [字符] | 指定字符集 | 可以在[]中设置任意数量的字符,流中存在与之相同的则读取成功,否则读取失败 |
| [^字符] | 不包含指定字符集 | 任意数量的不属于字符集的字符 |
使用示例:
#include <stdio.h>

int main()
{
	// 文件中的数据为hello 98 bbcd
	FILE* pf = fopen("test.txt", "r");
	if (pf == NULL)
	{
		perror("fopen");
		return ;
	}

	char buffer[100] = { 97 };
	int tmp = -2;
	int ret = fscanf(pf, "%s %d", buffer, &tmp);
	// 输出fscanf函数读取几条数据
	printf("%d\n", ret);
	printf("%s\n%d\n", buffer, tmp);
	// 此时预期的输入应该是bbcd
	ret = fscanf(pf, "%[bbcd]", buffer);
	printf("%d\n", ret);
	printf("%s\n", buffer);

	fclose(pf);
	pf = NULL;

	return 0;
}
运行结果:
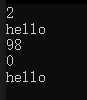
可以看到在使用%[]指定字符读取时出现了错误,并没有读取到文件中对应的bbcd字符串,而是直接结束了函数(ret的值为0);可以看出使用fscanf时,是从文件的起始位置开始读取的;
使用*修饰标识符
#include <stdio.h>

int main()
{
	// 文件中的数据为hello 98 bbcd
	FILE* pf = fopen("test.txt", "r");
	if (pf == NULL)
	{
		perror("fopen");
		return;
	}

	char buffer[100] = { 97 };
	int tmp = -2;
	int ret = fscanf(pf, "%*s %d", buffer, &tmp);
	// 输出fscanf函数读取几条数据
	printf("%d\n", ret);
	printf("%s\n%d\n", buffer, tmp);

	fclose(pf);
	pf = NULL;

	return 0;
}
运行结果:

这个函数只读取了一个数据,第一个字符串是被丢弃了,此时buffer中的值是98对应的字符,也就是’b’;
使用%[字符]时,注意读取的数据必须与其完全匹配(字符序列的顺序和内容完全一致)才能读取成功;
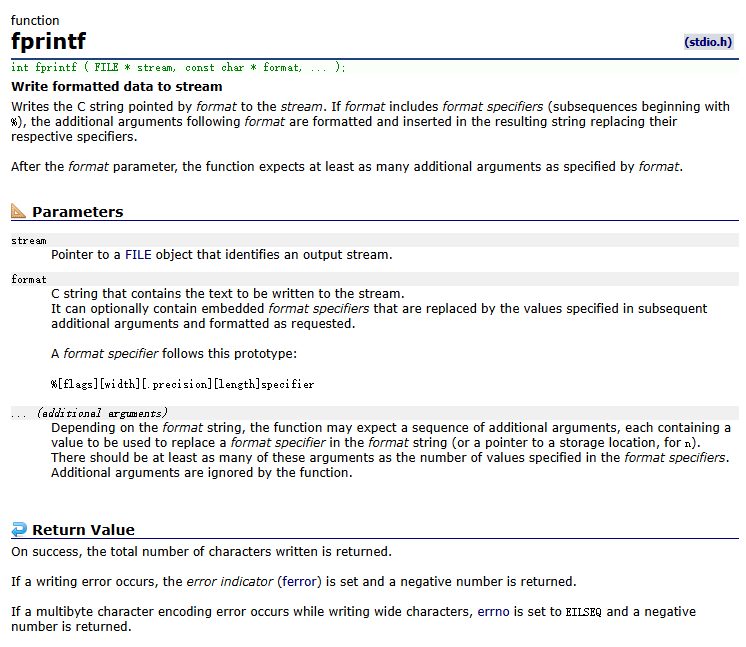
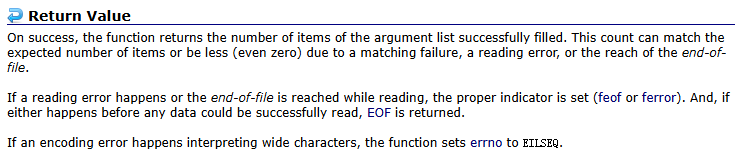
- 以格式化的数据写入流中,将字符串以指定的格式写入流中。与printf函数相同,在format参数指定的对应的格式类型之后,后面需要跟上相应的额外的参数,将它们对应的值输出到流中;
- 与fscaf一样有多个参数,第一个表示要数据将要输出到的流,第二个表示以数据将什么格式输出,之后参数表示要输出的数据;
- 返回值是成功输出的数据的个数;当出错时会设置错误标志,并返回一个负数;
#include <stdio.h>

int main()
{
	int tmp = 1;
	FILE *pf = fopen("test.txt", "w");
	if (pf == NULL)
	{
		perror("fopen");
		return ;
	}

	int ret = fprintf(pf, "%d", tmp);
	printf("%d\n", ret);

	fclose(pf);
	pf = NULL;

	return 0;
}
4. fread与fwrite
前面的三组函数都是以文本的形式读取或写出数据的;该组函数以二进制的形式来进行数据的读写;
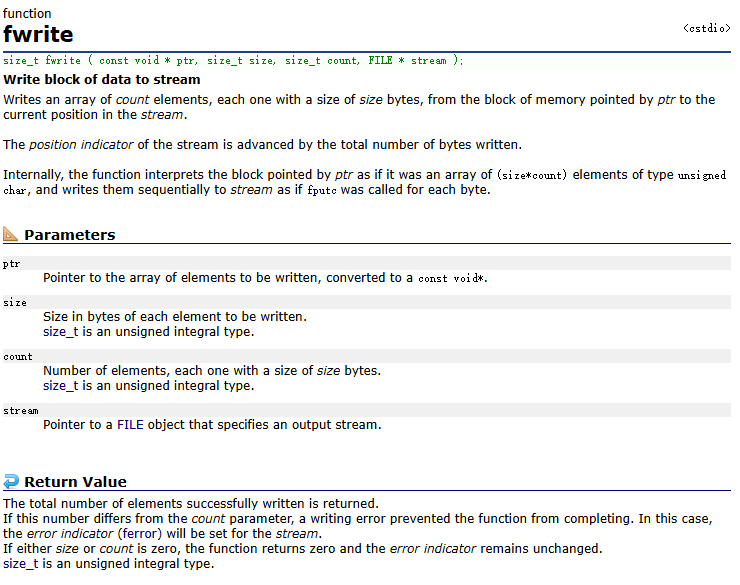
- 将数据输出到流中,将ptr指向空间中的count个元素输出到流stream中,每个元素占size个字节;
- 函数有4个参数:
- ptr:指向将要写入流中的count个元素,将该指针转换为一个常void类型指针;
- size:每个元素占据的字节数;
- count:要写到流的元素个数;
- stream:标识一个输入流的FILE类型的指针;
- 函数调用成功会返回成功输出的元素个数。如果返回的值与count不同,就出现了写错误。在这种情况下,函数会为流设置错误标记;
使用示例:
#include <stdio.h>

int main()
{
	FILE* pf = fopen("test.txt", "a");
	if (pf == NULL)
	{
		perror("fopen");
		return ;
	}

	int i = 12;
	typedef struct
	{
		int a;
		char b;
		double c;
		char arr[5];
	} Test;
	Test t = { 13, 'a', 3.14, "haha" };

	// 往文件中写入一个int类型的数 - 二进制形式
	fwrite(&i, sizeof(int), 1, pf);
	// 往文件中写入一个Test类型的数据 - 二进制形式
	fwrite(&t, sizeof(Test), 1, pf);

	fclose(pf);
	pf = NULL;

	return 0;
}
写操作后的文件
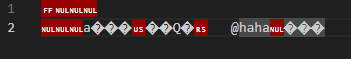
可以看到打开文件之后,文件的内容是一堆乱码,这是因为二进制数据的编码和文本格式的编码是完全不同的,而文件是以文本形式打开的,所以我们看到的文件内容是乱码;
接下来我们再使用fread函数,同样以二进制的形式将文件读出来,看能否获得正确的数据;
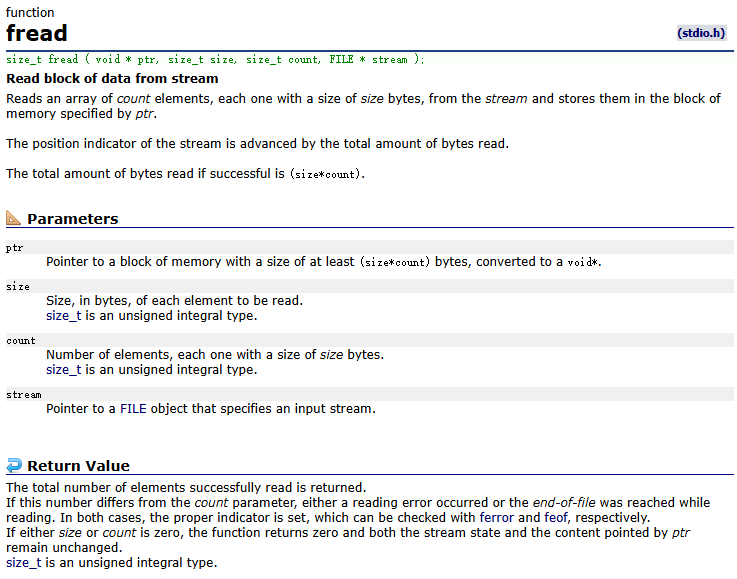
- 从流stream中读取总共count个元素,每个元素占的空间为size个字节,将这些元素存储在由str指针指定的空间中;该函数会从流中读取的空间大小为(size * count)个字节(在成功的情况下);
- 该函数有4个参数:
- ptr:一个void类型的指针,可以接收任何类型的数据,它的空间至少应该等于(size * count)个字节;
- size:要读取数据中每个元素占据的空间的大小;
- count:要读取的元素的个数;
- stream:指向标识了一个输入流的文件对象;
- 当函数调用成功时,会返回成功读取到的元素的个数。如果这个返回的数字和count不同,要么是发生了读错误,要么是读到了文件尾(整个文件的内容全部读取完成),所以
读取结束标志就是返回值不等于count;在遇到这两种情况时,函数会自动设置合适的,能被ferror和feof识别的标记;如果参数中的size或count为零,函数将会返回0,并且流的状态和ptr中的内容都不会发生改变;
使用示例:
#include <stdio.h>

int main()
{
	FILE* pf = fopen("test.txt", "r");
	if (pf == NULL)
	{
		perror("fopen");
		return;
	}

	int i = 0;
	typedef struct
	{
		int a;
		char b;
		double c;
		char arr[5];
	} Test;
	Test t = { 0 };

	// 从文件中读一个int类型的数 - 二进制形式
	fread(&i, sizeof(int), 1, pf);
	printf("%d\n", i);
	// 从文件中读一个Test类型的数据 - 二进制形式
	fread(&t, sizeof(Test), 1, pf);
	printf("%d %c %lf %s\n", t.a, t.b, t.c, t.arr);

	fclose(pf);
	pf = NULL;

	return 0;
}
运行结果:
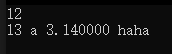
可以看到,fread正确的将文件中的内容读取了出来,计算机内部是能够识别二进制数据的;
在比较完上面4组函数之后,我们再来看看下面两组函数:
printf、fprintf、sprintf;
printf:对标准输出流的格式化输出语句;
fprintf:对所有输出流的格式化输出语句;
sprintf:将格式化的数据,输出成一个字符串;
第一个函数,大家都已经非常熟悉了,第二个函数也在上面刚刚讲解;现在我们来看看第三个函数是如何工作的;
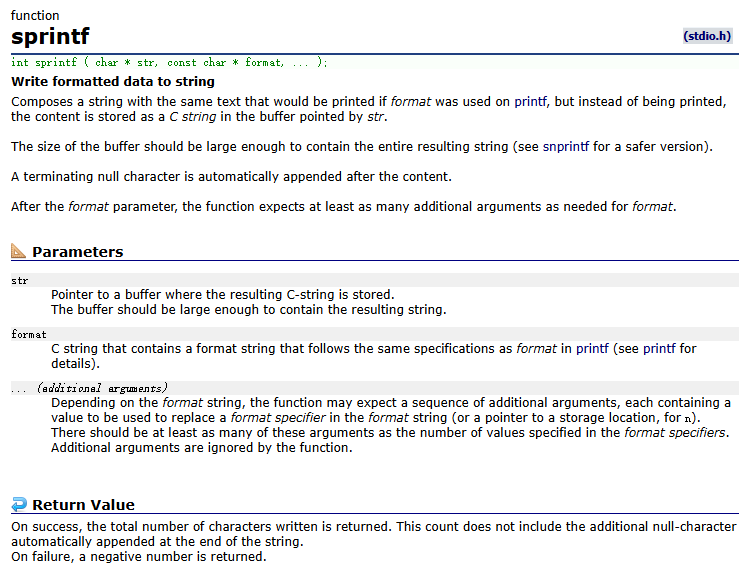
与fprintf函数只有第一个参数不同;在fprintf中第一个参数表示输出流,在sprintf中表示一个字符串;相信大家在写程序时都会有需要将一个数据转换成字符串来处理的情况,有了这个函数就能够非常方便的实现这一目的了;
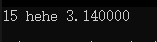
使用示例:
#include <stdio.h>

int main()
{
	typedef struct
	{
		int i;
		char str[10];
		double d;
	} Test;

	Test t = { 15, "hehe", 3.14 };
	char str[20] = { 0 };

	sprintf(str, "%d %s %lf", t.i, t.str, t.d);
	printf("%s\n", str);

	return 0;
}
运行结果:
scanf、fscanf、sscanf;
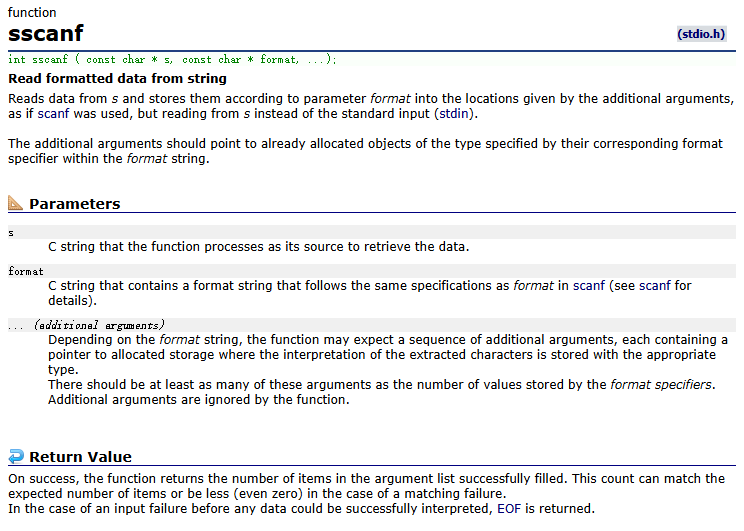
前两个函数我们都已经讲解过了,现在就只对第三个函数进行解释;
与sprintf类似,sscanf函数是将字符串转换成对应的格式化数据;相当于sprintf的逆过程;
使用示例:
#include <stdio.h>

int main()
{
	typedef struct
	{
		int i;
		char str[10];
		double d;
	} Test;

	Test t = { 15, "hehe", 3.14 };
	char str[20] = { 0 };

	sprintf(str, "%d %s %lf", t.i, t.str, t.d);
	//printf("%s\n", str);

	Test t1 = { 0 };
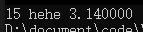
	sscanf(str, "%d %s %lf", &(t1.i), t1.str, &(t1.d));
	fprintf(stdout, "%d %s %lf", t1.i, t1.str, t1.d);

	return 0;
}
运行结果:
五、使用文件修改通讯录
在学习完上面的文件顺序读写的函数之后,我们再返回去看看上一章中我们实现的通讯录程序,在上一个版本中,我们使用了动态内存开辟技术,根据实际需求分配空间,节省了空间资源的消耗;但是仍存在一个问题,每次我们关闭程序之后,通讯录中所有的数据都没有了,当我们再次打开它的时候,需要重新输入这些数据,这与我们通讯录实现的初衷是不符的,我们需要通讯录中的数据能够一直保存下去,直到我们手动删除掉它们;
在此之前,我们是没有办法将数据保存下来的,因为此前我们的程序使用的数据都是保存在内存中的,无法长期保留,现在我们学习的文件的使用操作,我们就再来对这个程序进行修改,使得它的功能更加完善;
需要修改的地方只有通讯录打开和关闭操作;打开:从文件中读取数据;关闭:将数据保存到文件中;
// 初始化函数,在程序启动时,读取文件,将保存在文件中的通讯联系人的信息读取到内存中
void initContact(Contact* contact)
{
	assert(contact);

	// 动态分配 INIT_COUNT * sizeof(Peoinfo) 个字节的空间
	contact->data = (Contact*)calloc(INIT_COUNT, sizeof(Peoinfo));
	contact->count = 0;
	contact->num = INIT_COUNT;

	FILE *pf = fopen("contact", "r");
	// 文件打开失败
	if (pf == NULL)
	{
		perror("init");
		return ;
	}

	Peoinfo tmp = { 0 };
	// 从文件中读取一个人的信息
	// 此操作需要循环进行,直到将整个文件的信息全部读取
	// fread函数的返回值表示当前执行读取到的元素个数
	// 此时只读取一个元素,在不出错的情况下,返回0表示遇到了EOF,文件读取结束,循环结束
	while (fread(tmp, sizeof(Peoinfo), 1, pf))
	{
		// 通讯录满,需进行扩容
		if (isFull(contact))
		{
			increase_Capacity(contact);
		}
		// 结构体中没有指针变量,可以使用浅拷贝
		contact->data[contact->count] = tmp;
		(contact->count)++;
	}

	fclose(pf);
	pf = NULL;
}
// 保存数据到文件中
void saveContact(Contact* contact)
{
	FILE* pf = fopen("contact", "w");
	if (pf == NULL)
	{
		perror("save");
		return ;
	}

	int i = 0;
	for (i = 0; i < contact->count, i++)
	{
		fwrite(contact->data[i], sizeof(Peoinfo), 1, pf);
	}

	fclose(pf);
	pf = NULL;
}
在主函数中添加:
case exit:
	saveContact(&contact);
	free(contact.data);
	contact.data = NULL;
	printf("退出通讯录\n");
	break;
六、文件的随机读写
接下来讲解文件的随机读写,我们需要先学习几个函数,来在文件中定位;
1. fseek
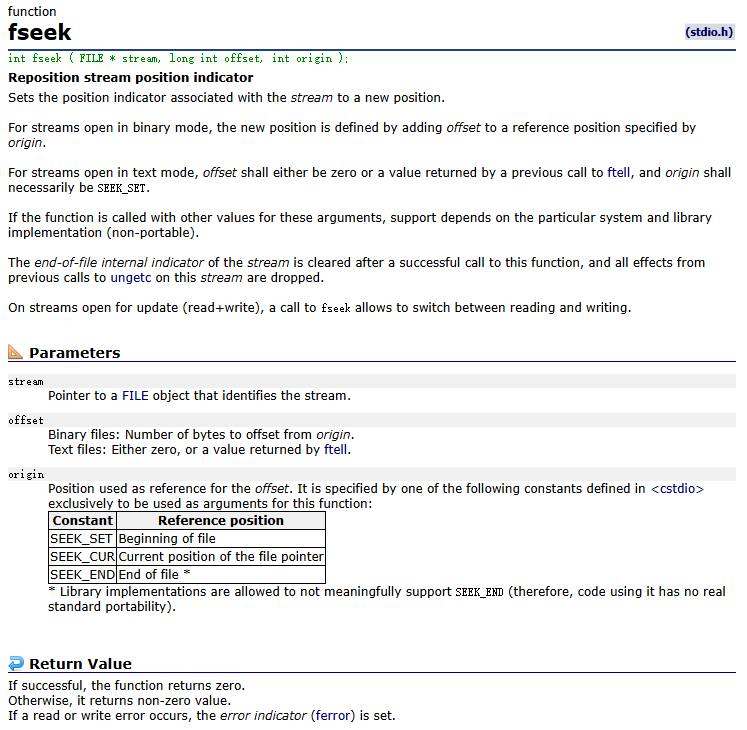
- 重定位流的位置指针,将与流关联的位置指针设置到一个新位置上;
- 对于以二进制形式打开的文件,文件的新位置是由参考位置origin和偏移量offset共同决定的;
- 对于以文本形式打开的文件,偏移量offset只能是0或由在此之前调用
ftell返回的值,且参考位置origin一定是SEEK_SET;(关于这个参考位置后面会列表说明) - 在成功调用该函数之后,流内部的文件结束标记会清除,并且所有调用ungetc函数对流产生的影响都会丢弃;
- 在以更新为目的(read + write)打开的流中,调用fseek函数使得可以在读和写操作之间切换;
- 函数有3个参数
- stream:表示一个能标识一个FILE类型对象的流;
- offset:二进制文件:从origin位置开始的偏移量,字节为单位;文本文件:要么是0,要么是由ftell返回的值;
- origin:作为偏移量的开始的位置;
- 如果函数调用成功,函数将会返回0;否则,将会返回一个非0值;如果出现了读错误或是写错误,将会设置一个错误标记;
| 常量 | 参考的位置 |
|---|---|
| SEEK_SET | 文件的开始 |
| SEEK_CUR | 文件指针当前的位置 |
| SEEK_END | 文件的末尾 |
offset可以为负数,所以当将文件指针位置设置为SEEK_END时,使用负的偏移量就可以获取到文件的内容;
使用示例:
// 二进制形式
#include <stdio.h>

int main()
{
	FILE* pf = fopen("test.txt", "wb+");
	if (pf == NULL)
	{
		perror("fopen");
		return;
	}

	char str[40] = { 0 };
	// 对文件内容进行初始化
	fwrite("hello world, haha hehe", sizeof(str), 1, pf);

	fseek(pf, 6, SEEK_SET);
	char arr[40] = { 0 };
	fread(arr, sizeof(arr), 1, pf);
	fprintf(stdout, "%s\n", arr);

	return 0;
}

//// 文本形式
#include <stdio.h>

int main()
{
	FILE* pf = fopen("test.txt", "wb+");
	if (pf == NULL)
	{
		perror("fopen");
		return ;
	}

	// 对文件内容进行初始化
	fprintf(pf, "%s", "hello world, haha hehe");

	// 这个代码是否正确是和平台有关的,在文本文件中,一个换行符\n或回车符\r可能并不是占一个字节,此时使用字节数来偏移字节并不准确
	// 所以在需要考虑移植性的程序中,应该优先使用二进制形式的定位,这种模式是一定准确的
	fseek(pf, 6, SEEK_SET);
	char arr[20] = { 0 };
	fscanf(pf, "%s", arr);
	fprintf(stdout, "%s\n", arr);

	return 0;
}
2. ftell
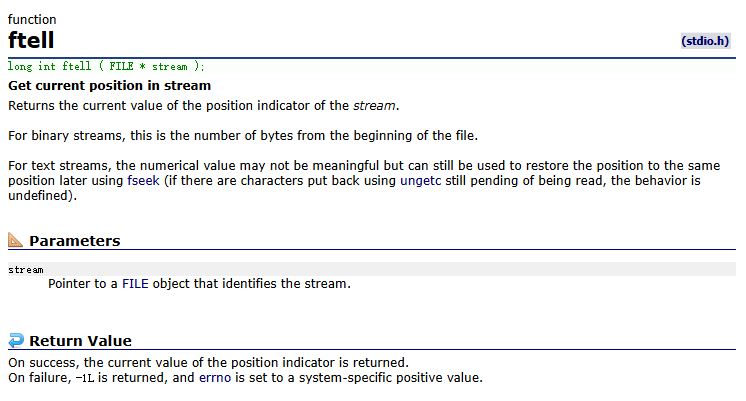
- 获取流中的内部位置指针当前的位置;
- 对于二进制流,这个函数获取的值是当前位置距文件开始位置有多少个字节;
- 对于文本流,这个数值可能并没有意义,但是仍可以在之后使用fseek函数将指针位置恢复到这个位置;
上面使用fseek时,提到了在对以文本形式打开文件时,需要辅以ftell使用,这是因为,在不同的环境中相同字符占据的字节数可能不同,如在windows系统中换行符是\r\n需要转换为\n,这就导致了文本模式下使用fseek定位并不准确,所以一般在文本模式下只使用SEEK_SET和之前调用ftell保存的位置,将文件指针恢复到同一个位置,不会使用其他的参考位置;
使用示例:
#include <stdio.h>

int main()
{
	FILE* pf = fopen("test.txt", "w");
	if (pf == NULL)
	{
		perror("fopen");
		return;
	}

	fprintf(pf, "%s", "hello haha");
	int ret = ftell(pf);
	printf("ret = %d\n", ret);

	fseek(pf, -4, SEEK_END);
	fprintf(pf, "%s", "hehe");

	fclose(pf);
	pf = NULL;

	return 0;
}
运行结果:
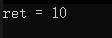
文件中的内容:
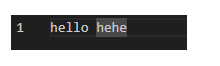
过程分析:
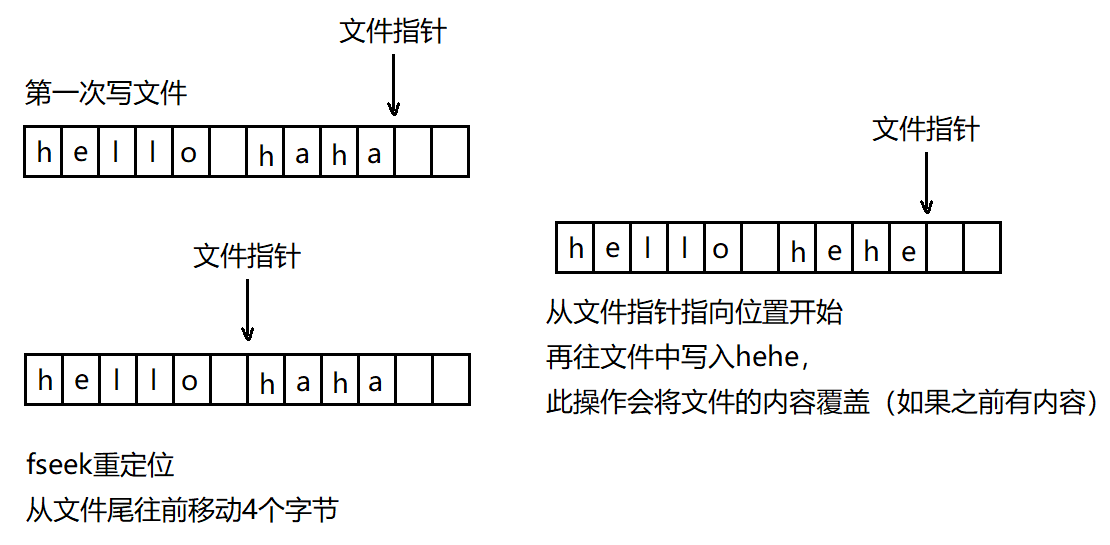
3. rewind
- 将文件指针回到文件的起始位置;
- 文件内部的文件结束和错误标记会被清除;
- 使用这个函数可以在文件的读写操作之间切换;
- 没有返回值
使用示例:
#include <stdio.h>

int main()
{
	FILE* pf = fopen("test.txt", "w+");
	if (pf == NULL)
	{
		perror("fopen");
		return ;
	}

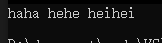
	fprintf(pf, "%s", "haha hehe heihei");
	rewind(pf);
	char arr[20] = { 0 };
	// 因为fscanf不能读取中间隔有空白符的字符串,所以使用fgets
	fgets(arr, 20, pf);
	printf("%s\n", arr);

	return 0;
}
运行结果:
七、文本文件和二进制文件
根据数据的组织形式,数据文件可以分为文本文件和二进制文件
数据在内存中是以二进制的形式存储的,如果不做任何处理直接输出到外存中,保存这些数据的文件就是二进制文件;
如果数据在外存上需要以ASCII码的形式存储,这些数据在输出到外存前就需要先将二进制数据转换成对应的ASCII值,以特定的编码形式(除了ASCII之外,还有utf-8、GBK、ISO-8859等等)存储在外存中的文件就是文本文件;
那么一个数据在文件中是如何存储的呢?
数据型数据即可以用ASCII形式存储,也可以使用二进制形式存储;如:一个整数10000,如果要以ASCII码的形式输出到磁盘中,则它会在磁盘中占据5个字节的空间,一个字符1,4个字符0;如果是以二进制形式存储,则只占4个字节,00000000000000000010011100010000(0x00002710);
字符一律以编码的形式存储,注意直接将内存中的数据以二进制的形式输出到文件中也是一种编码;
#include <stdio.h>

int main()
{
	FILE* pf = fopen("tset", "w+");

	if (pf == NULL)
	{
		perror("fopen");
		return ;
	}

	fprintf(pf, "%d", 10000);
	int tmp = 10000;
	fwrite(&tmp, sizeof(int), 1, pf);

	rewind(pf);
	int i = 0;
	fscanf(pf, "%d", &i);
	int j = 0;
	fread(&j, sizeof(int), 1, pf);
	printf("%d %d\n", i, j);

	fclose(pf);
	pf = NULL;

	return 0;
}
上面代码将10000分别以文本形式和二进制形式存储到文件中
输出结果和文件中的数据:
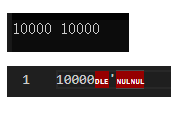
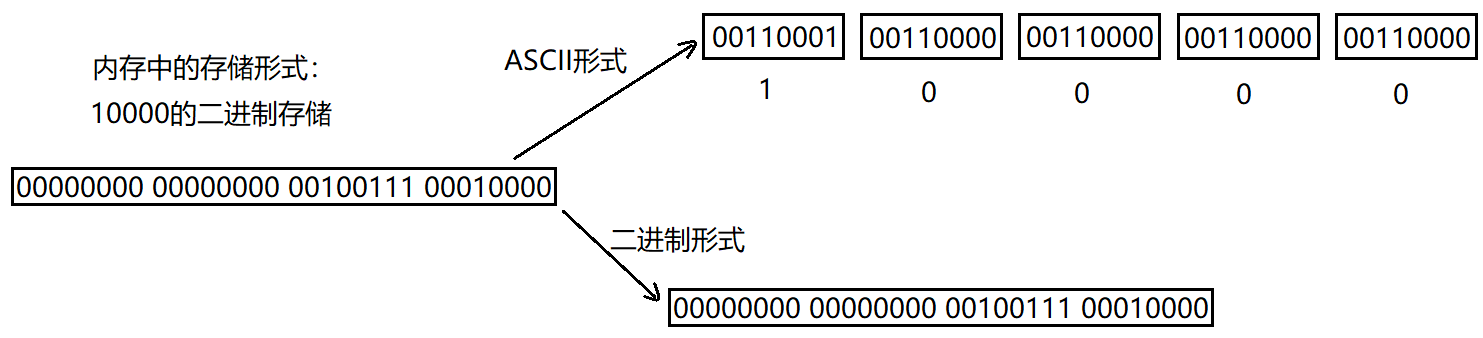
对于上面文件中的存储可以对照ASCII表,可以发现DLE对应是十六进制数就是10,'对应的十六进制数是27,NUL对应的是0,这是因为当前机器是小端字节序,在内存中的存储是10270000,所以文件中保存的如上图所示;
八、文件读取结束的判定
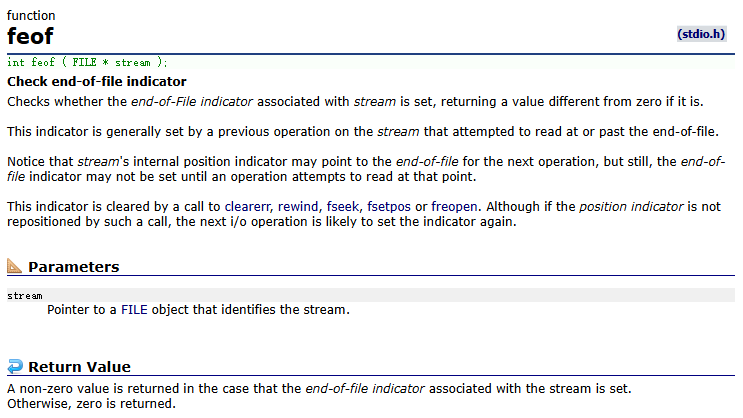
- 这个函数的作用是检查文件结束标志,检查一个流是否被设置了文件结束标志,如果是,则返回一个不为0的值。这个标志通常是在一些试图读文件结束标志处或之后数据的操作执行而设置的。
简单来说这个函数的作用是在文件读取结束后,判断这个文件是因为遇到文件尾结束的,还是因为读写错误而结束的;
常见的对feof函数的错误使用就是用它来判断一个文件是否读取结束;
那么现在问题来了,我们要如何判断一个文件是否读取结束呢?
对于文本文件:可以使用判断函数的返回值是否为EOF(fgetc、fscanf),或者NULL(fgets);
注意:调用文件读取函数,并不会马上就返回结果,是会等到函数调用结束之后,才将结果返回,即只有在当前调用文件位置指针已经处于文件结束标志处时,函数才会返回文件读取结束的值(因为在fgets中,当文件读取到不足指定数量的字符时,是会返回指向这些被读取到的字符的指针,并将文件位置指针指向文件尾,下一次读取时,直接遇到了文件尾,此时才会返回NULL指针)
对于二进制文件的读取判断:根据前面我们对fread的学习,我们知道这个函数的返回值是从文件中读取到字节数,当返回值为0时,也就代表了文件读取结束;
feof的正确使用示例:
文本文件
#include <stdio.h>

int main()
{
	FILE* pf = fopen("test", "w+");
	if (pf == NULL)
	{
		perror("fopen");
		return ;
	}

	fprintf(pf, "%s", "This is a test sample\n");

	// 在写操作后,将文件位置指针重置到文件起始位置
	rewind(pf);
	char arr[30] = { 0 };

	// 当fscanf函数的返回值不为EOF时,表示文件中仍有内容,可以继续读取
	while (fscanf(pf, "%s", arr) != EOF)
	{
		printf("%s\n", arr);
	}

 	if (feof(pf))
	{
		printf("End of file reached successfully\n");
	}
	else if (ferror(pf))
	{
		printf("I/O error when reading\n");
	}

	fclose(pf);
	pf = NULL;

	return 0;
}
运行结果:
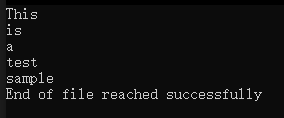
可以看到上面的代码成功的完成的预期的功能,说明之前的分析是正确的;
二进制文件
#include <stdio.h>

int main()
{
	FILE* pf = fopen("test", "wb+");
	if (pf == NULL)
	{
		perror("fopen");
		return ;
	}

	char arr[5] = "haha";
	fwrite(arr, sizeof(arr), 1, pf);

	rewind(pf);
	char arr2[5] = { 0 };
	int i = 0;
	while (fread((arr2 + i), sizeof(char), 1, pf) != 0)
	{
		i++;
	}
	printf("%s\n", arr2);

	if (feof(pf))
	{
		printf("End of file reached successfully\n");
	}
	else if (ferror(pf))
	{
		printf("I/O error when reading\n");
	}

	return 0;
}
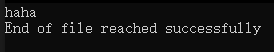
运行结果:
九、文件缓冲区
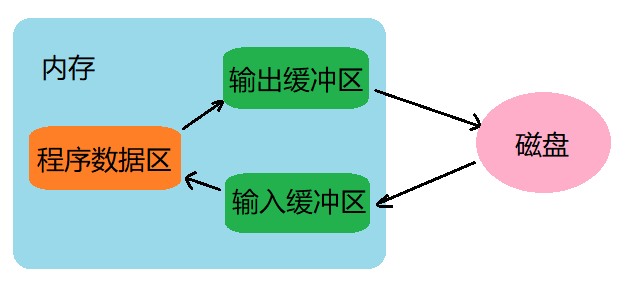
ANSIC标准中采用文件缓冲区系统来处理数据文件,所谓的文件系统是指系统自动地在内存中为程序中每个正在使用的文件开辟的一块“文件缓冲区”。从内存向磁盘输出数据,会首先将数据传输到内存中的缓冲区,装满缓冲区之后,再将这些数据一起送入磁盘。如果从磁盘向内存中读入数据,则从磁盘文件中读取数据输入到内存缓冲区中,然后(装满后)再从缓冲区中将数据输入到内存中的程序数据区;
测试代码:
#include <stdio.h>
#include <windows.h>

int main()
{
	FILE* pf = fopen("test.txt", "w");
	if (pf == NULL)
	{
		perror("fopen");
		return;
	}

	// 将数据放入缓冲区
	fputs("this is a test sample", pf);
	printf("数据已经写入缓冲区,睡眠10秒,打开文件,观察是否有数据写入\n");
	Sleep(10000);
	printf("刷新缓冲区\n");
	fflush(pf);
	printf("再睡眠10秒,打开文件,观察文件中是否有内容\n");
	Sleep(10000);
	fclose(pf);
	pf = NULL;

	return 0;
}
大家可以使用上面的代码在自己的机器上试试看,自己验证一下是否有文件缓冲区的存在;
此时需要注意有时可能因为缓冲区的存在,一些数据在输入之后还在缓冲区中,此时进行读操作就可能导致一些预料之外的错误;
总结
本节详细的对c语言中数据文件的使用进行了详细的介绍,包括对文件读写操作使用的函数,以及通过文件位置指针的操作函数来对文件进行随机读写,并指出了feof函数可能出现的使用错误,在最后,介绍了文件缓冲区的概念;

 1544


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


