DIBS:通过未标记数据的伪边界生成提升密集视频字幕预测性能 | CVPR 2024

网络安全系列-四十三:使用Suricata分析恶意流量pcap文件 本文基于[网络安全系列-三十六:使用Suricata IDS分析pcap文件]和 [网络安全系列-四十二: Suricata之rulesets的激活、更新及动态加载]的基础上,使用suricata针对包含恶意流量的pcap文件进行分析,触发事件告警,并对suricata输出的日志进行逐个分析,让你掌握针对恶意流量的分析步骤,及怎么查看suricata输出的日志。 阅读详情

本文简要介绍CVPR 2024录用论文“DIBS: Enhancing Dense Video Captioning with Unlabeled Videos via Pseudo Boundary Enrichment and Online Refinement  ”的主要工作。论文提出了一种用于密集视频字幕(Dense video captioning, DVC[1])的新的预训练框架Dive Into the BoundarieS(DIBS),它详细阐述了从未标记视频中提高生成的事件字幕及其相关伪事件边界的质量。通过利用大语言模型(LLM)的功能生成丰富的面向DVC的字幕,并在几个精心设计的目标下优化了相应的伪边界。此外,论文还提出一种新的在线边界细化策略,该策略在训练过程中迭代地提高了伪边界的质量。该方法在YouCook2和ActivityNet标准DVC数据集上取得了显著进步,在指标上都优于之前最先进的Vid2Seq[2],仅使用了用于Vid2Seq[2]预训练的0.4%的未标记视频数据就实现了这一点。
图片

论文链接:https://arxiv.org/abs/2404.02755

研究背景

随着视频数据的爆炸式增长,视频理解技术日益受到关注,其中,DVC任务因其对视频内容的深度解读和结构化表达而显得尤为重要。DVC旨在对未剪辑视频中的所有事件进行精确的时间定位和详细的文本描述,为用户提供更丰富、细致的视频内容理解。然而,高质量的视频事件标注数据极为匮乏,严重限制了DVC技术的进一步发展。

研究动机

现有的DVC方法主要依赖于有限的标注数据集进行训练,虽取得一定进展,但受制于数据量和标注质量,性能提升遇到瓶颈。为克服这一难题,部分研究尝试利用含有字幕的未标注视频进行预训练,以期利用大量未充分利用的资源。然而,直接将原始字幕转化为事件描述和边界的做法,由于字幕信息往往包含大量非事件相关的内容,可能导致生成的标签数据包含大量噪声,无法充分挖掘未标注视频的潜在价值。因此,迫切需要一种新方法,能在大规模未标注视频中高效地生成高质量的事件标签,以突破现有方法的性能限制。

方法介绍

为应对上述挑战,本文提出Dive Into the BoundarieS (DIBS)框架,创新性地结合大型语言模型和优化算法,从大规模未标注视频中生成高质量事件标签,推动DVC等核心任务的进步。DIBS框架的关键组成部分包括:

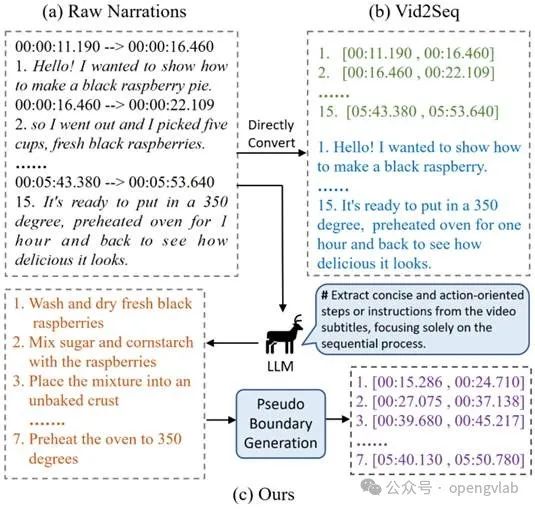
事件描述生成:如下图所示不同于Vid2Seq[2]直接使用原始字幕作为事件描述,DIBS利用大型语言模型(LLM),通过精心设计的任务提示,从视频字幕中提取出丰富、准确的事件描述候选。这一过程过滤掉了字幕中的无关信息和噪声,确保生成的事件描述更为聚焦、精确。
事件描述生成

如下图所示不同于Vid2Seq[2]直接使用原始字幕作为事件描述,DIBS利用大型语言模型(LLM),通过精心设计的任务提示,从视频字幕中提取出丰富、准确的事件描述候选。这一过程过滤掉了字幕中的无关信息和噪声,确保生成的事件描述更为聚焦、精确。

图片

伪边界生成与优化

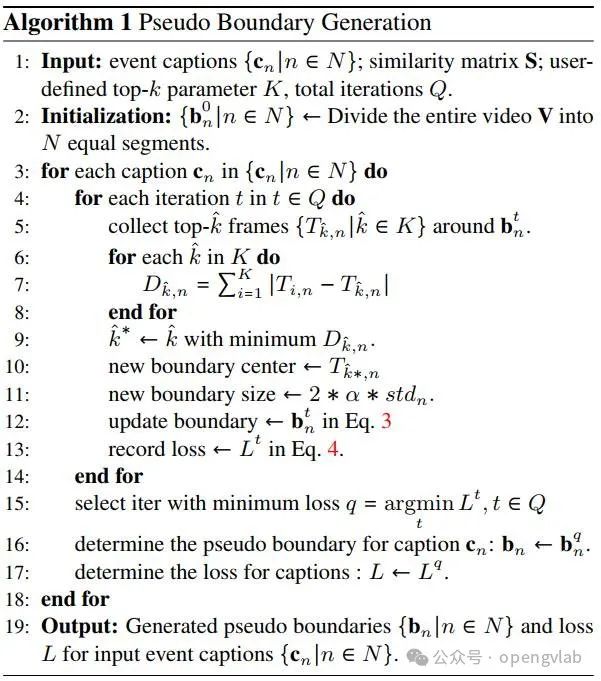
DIBS采用新颖的边界生成与优化算法,根据事件描述与视频帧之间的相似度构建相似度矩阵,生成与每个描述对应的伪事件边界,并在多个目标下进行优化,确保边界质量,详细流程可以参考下面的伪代码。相比之下,Vid2Seq[2]的边界生成过程相对直接,对边界质量的精细化优化不足,可能导致生成的边界不够精确。
图片

此外,DIBS还引入了在线边界优化策略。在模型训练过程中,DIBS不仅生成伪事件边界,还通过迭代优化的方式不断精炼这些边界。具体来说,该策略包括以下几个关键步骤:

1. 多候选边界设定:在每个伪边界附近设置多个候选边界,为边界细化提供丰富的可能性空间。

2. 模型评估与边界更新:使用预训练的密集视频描述模型对这些候选边界逐一评估,依据评估结果,以迭代方式不断调整和优化伪边界,确保每次迭代后边界质量得到提升。

通过在线边界精炼机制,DIBS不仅生成初始的伪边界,还在训练过程中持续优化这些边界,使其更加贴近真实事件的发生时刻,从而显著提升了模型对事件定位的准确性。

实验结果

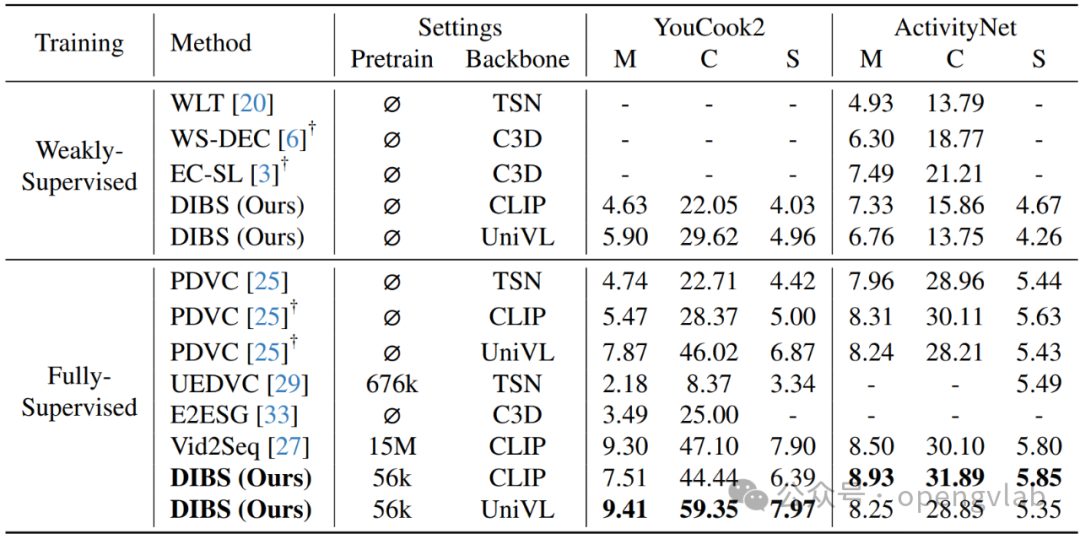
如下表所示,在YouCook2和ActivityNet等多个公开数据集中,DIBS框架在METEOR、CIDEr、SODA_c、Recall和Precision等多个评价指标上均超越了当前最先进的Vid2Seq[2]模型,树立了新的性能标杆。尤其值得一提的是,DIBS仅使用了Vid2Seq[2]预训练所用无标注视频数据的0.4%,却展现出如此卓越的性能,有力地证明了其在低资源条件下高效利用未标注数据的能力,尤其是在边界精炼方面带来的显著改进。
图片

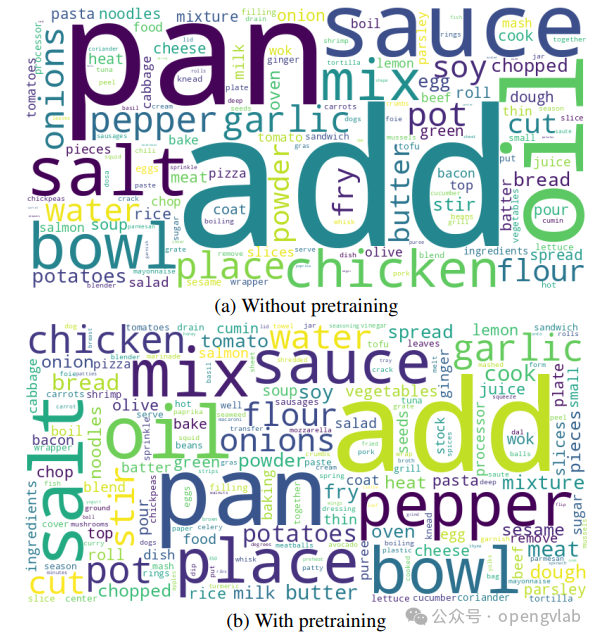
除了在相关数据集进行对比评测外,我们还可视化了预训练前后模型生成文本的丰富度。如下图所示,我们比较了有和没有我们提出的预训练的DIBS模型预测的字幕的词云,可以看出,预训练后的预测字幕比未经预训练的预测字幕显示出更丰富的词汇,突出了我们的方法在字幕生成多样化方面的成功。预训练后单词量的大小和多样性的变化表明,模型的细微理解有了显著改善,支持了我们关于预训练对丰富多样的密集视频字幕的好处的假设。
图片

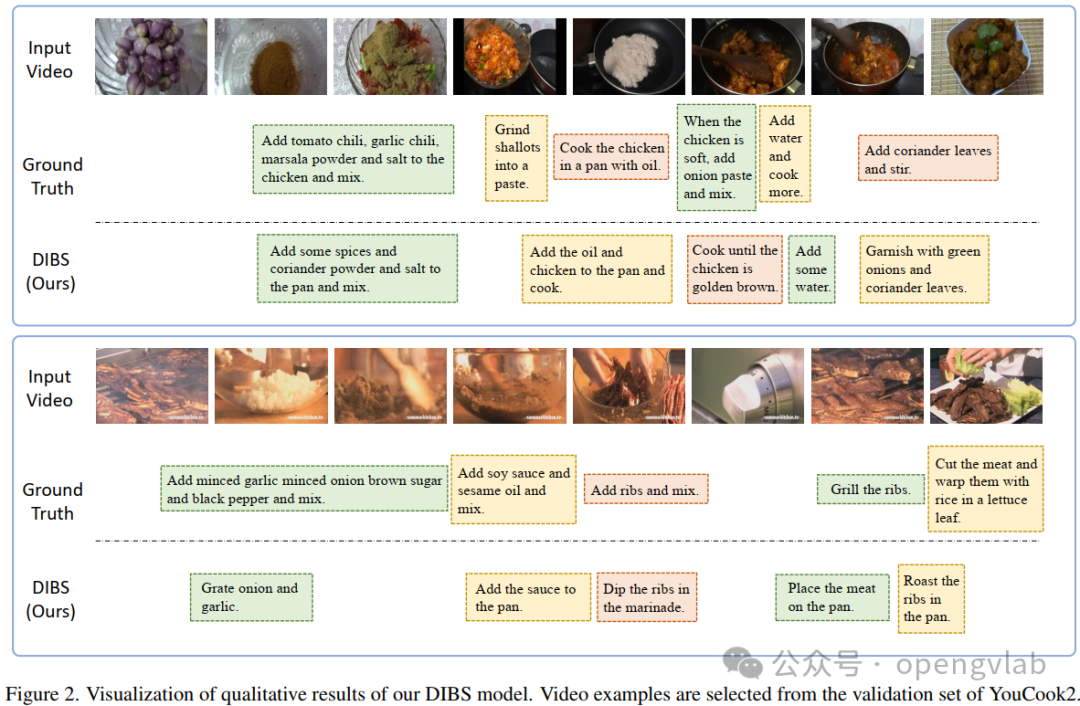
最后,为了进一步证明我们方法的有效性,在下图中我们针对YouCook2数据集上给出了DIBS的一些定性结果。我们可以从这些示例中看到,我们的DIBS可以预测准确的事件边界以及丰富的字幕。
图片

综上,DIBS框架通过创新的事件描述生成方式(区别于Vid2Seq[2]的直接字幕转化)、伪边界生成与优化算法,以及独特的在线边界精炼策略,开创了视频理解领域利用大规模未标注视频资源的新路径。它不仅能够从未标注视频中提取出高质量事件标签,推动DVC等核心任务的发展,也为整个视频理解领域带来了新的机遇。

Reference

[1] Dense-Captioning Events in Videos, ICCV, 2017

[2] Vid2Seq[2]: Large-Scale Pretraining of a Visual Language Model for Dense Video Captioning, CVPR, 2023

uniapp - H5人脸识别认证与活体检测功能(纯前端免费方案+微信sdk人脸识别)完整源码,微信公众号网页/h5端人脸识别功能人脸核身(微信方案提供后端spring boot+thinkphp源码 uniapp实现人脸认证,uniAPP h5手机拍照+人脸识别,免费人脸识别插件,前端人脸识别解决方案,uniapp H5人脸识别带前后摄像头,人脸识别在H5页面进行采集,微信公众号H5人脸核身,H5端人脸识别功能实现,免费h5人脸识别插件方案,微信公众号H5网页实现人脸识别,uniapp人脸监测,uniapp人脸生物监测,使用uniapp开发H5人脸采集功能/人脸识别功能,uniapp项目—h5端人脸采集功能实现,uniapp vue3人脸核身,H5活体检测认证,人脸认证张嘴摇摇头指引动作,人脸核身 微信 阅读详情

相关推荐

从原理图到PCB:Cadence Allegro 17.4网表同步全流程详解(含第三方网表配置)

本文详细解析了Cadence Allegro 17.4中从Orcad原理图到PCB布局的网表同步全流程。核心内容包括标准的第一方网表同步步骤,以及针对第三方网表导入时关键的封装库路径配置方法,并提供了常见同步错误的排查思路,帮助工程师高效、准确地完成设计数据传递,确保PCB设计顺利开局。

salt9的博客 657

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 384

影视站泛目录程序(泛目录站群):构建多元化影视内容平台的利器

同时,搭建多元化影视内容平台还能够为平台创造更多商业价值,提升平台的竞争力。构建多元化影视内容平台:通过影视站泛目录程序,影视平台可以整合来自不同渠道和来源的影视资源,打破传统影视平台的局限性,提供更加多样化的影视内容供用户选择。提高用户体验:泛目录站群程序能够自动化处理和分类整理影视资源,提供便捷的搜索功能,使用户能够快速找到所需的影视内容,提升用户的使用体验。增加用户粘性:通过提供多元化的影视资源和个性化的推荐服务,影视站泛目录程序可以吸引用户长时间停留在平台上,增加用户的粘性和忠诚度。

qq_20005121的博客 825

UML面向对象-分析、建模与设计(第三版·微课视频·题库版)顺序图画图

该顺序图展示了客户端(Client)通过事务对象(Transaction)与ODBC代理(ODBCProxy)的交互过程。客户端创建事务,设置操作参数并提交,事务调用代理完成数据设置,最后销毁事务。整个流程体现了对象间协作与生命周期管理,清晰展现了系统内部调用顺序与状态变化。

一亩高粱 34

论文理解【LLM-Clarification】—— 【QDrawer】Asking the Right Question at the Right Time: Human and Model Unce

本文基于 CoDraw 任务对 LLM 澄清提问的触发方式进行探索,发现模型内部不确定性与人类澄清决策相关性弱,使用不确定性阈值触发澄清提问相比模仿人类提问时机,性能和计算效率都更好

佚失的诗篇 771

与本地电脑PDF文档对话的PDF问答程序

紧接着,从PDF文档中提取文本,这部分代码的作用是遍历PDF文档中的每一页,并使用extract text(0方法提取每一页的文本内容,然后将这些文本内容累加到raw text变量中。PDF问答程序的实现方式是利用LangChain已实现的向量存储、嵌入,以及使用查询和检索相关的链来获取外部数据集及处理文档,在进行相关性检索后进行合并处理,将其置入大语言模型的提示模板中,实现与PDF文件交流的目的。例如,你正在为一项重要的报告寻找资料,你必须知道你需要查找的关键词,然后在大量的信息中筛选出你需要的部分。

weixin_43961909的博客 1422

AI 视频进入智能体时代:一条短片,如何从灵感走到成片?

AI 视频创作正在从单点生成走向完整流程。本文结合 Adobe Firefly 的新动向,梳理从确定目标、准备授权素材、设计画面到配音字幕和发布前复核的五步方法,并介绍 Aivo容剪如何辅助团队衔接创作环节。

AIVOClaw的博客 145

构建基于知识图谱的金融风险关联网络

在金融领域,风险的识别和管理至关重要。传统的风险分析方法往往只能处理单一维度的数据,难以全面捕捉金融市场中复杂的风险关联关系。构建基于知识图谱的金融风险关联网络的目的在于整合多源异构的金融数据,通过知识图谱的方式清晰地展示金融实体之间的复杂关系,从而更准确地识别潜在的金融风险,为金融机构的风险管理决策提供有力支持。本项目的范围涵盖了从金融数据的收集、预处理,到知识图谱的构建,再到金融风险关联网络的搭建和分析。

SuperAGI2025 1421

AI动画视频生成器免费在线怎么用?新手完整操作教程

AI动画视频生成器让零基础用户也能快速制作动画内容,本文拆解在线创作全流程:剧本构思、角色场景设定、提示词撰写、分镜生成、后期剪辑导出。对比免费版与付费版本的差异,讲解免费工具常见限制,分享素材导入、提升画面一致性的实操技巧,解答角色跑脸、提示词难写等高频问题,同时介绍适合短剧团队的规模化创作方案,帮助个人创作者和团队按需挑选AI动画工具。

2601_96477822的博客 370

手把手教你安装 OpenClaw 小龙虾(MAC安装教程),一次成功不踩坑

本文详细介绍了在Mac上安装OpenClaw的完整流程。主要内容包括:1)准备工作(磁盘空间、网络环境、终端工具);2)安装Homebrew包管理器及常见问题解决;3)安装Node.js 22+版本(环境核心);4)Git安装与验证;5)OpenClaw项目克隆、依赖安装及运行配置;6)大模型配置方法(以MiniMax为例)。文章提供了详细的命令行操作步骤和常见错误解决方案,特别强调了网络环境要求和Apple Silicon芯片的原生支持注意事项。最后展示了验证配置成功的方法和资源获取渠道。

Chengbei11的博客 6345

双重分组进位跳跃进位链

跳跃进位链

qq_62260432的博客 942

视频解说交付前,用 Python 检查字幕时轴与证据镜头是否对齐

用普通 SRT 和 Python 标准库复现两类字幕错误:时轴重叠,以及结论比证据画面提前出现。附可运行示例、修正结果和人工审片边界。

linan96的博客 149

DMA engine initialization failed rk3568的原因及解决方案

刚开始调试 switch 芯片的时候由于rgmii 时钟是output , rk3568的 GMAC 需要 switch 芯片提供 125M的时钟,如果没有这个时钟就会初始化失败,进入文件系统后 ethx 不会出现(当然,如果屏蔽掉这里ethx 会出现,但是引发更多的问题,笔者在这块耍小聪明,导致耗费了近一个月时间,把网络这块整个查了一遍 -----)dma 软复位是在进入文件系统后,网络系统启动的时候,我想如果在这个之前只要提供合适的时钟那么就是可以的,那么------以上是官方的文档说明。

Nyiragongo的博客 4577

从一段视频到可漫游的 4D 有声场景:思路拆解与最小复现手记

只需一段手机视频,你就能生成可"走进去"的 4D 有声场景:转头时狗叫声方向随之变化,走近时声音更清晰。本文拆解 Video-to-4DAVScene 的核心思路,手把手带你用几十行 Python 搭出最小管线,把视频中的运动物体变成带空间位置的声源,并附上三个真实踩坑的排障经验,代码可直接跑。🎧

helloagent的博客 246

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

本地化部署会议视频软件如何替换旧平台?账号迁移、历史数据与用户培训怎么安排?

账号先映射:身份与权限验证通过,再开放使用。资料分级处理:能查、能读、权限正确,比“全部搬完”更重要。切换可恢复:入口、增量数据和业务通知都要纳入回退方案。培训按岗位落地:让用户完成真实任务,而不是只听功能介绍。这套方法适合政企、集团及医疗等具有长期资料留存、多终端接入和业务集成需求的组织。小规模替换可以简化批次与流程,但不应省略权限验证、备份恢复和关键会议演练。

hz56789的博客 292

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

打字就能剪视频的AI工具

AI 会替代剪辑师吗?这个问题和“AI 会替代程序员吗”一样,问错了方向。会用 AI 工具的人,正在替代不会用的人。一个剪辑师用传统方式花三天做的宣传片,另一个人用 UniCut 一天做完,质量差不多,市场会选谁,答案很明显。工具的进化从来不是把专业的人淘汰掉,而是把专业的门槛拆掉。浏览器已经打开了,剩下的就是你愿不愿意试一下。体验地址:https://unicut.h5ds.com/开源仓库:https://github.com/mtsee/unicut。

d676015863的博客 166

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

AI 礼盒开箱视频怎么做?让商品亮相更有仪式感

AI商品视频通过精细设计开箱动作与场景节奏,将礼盒从静态包装转化为沉浸式送礼体验。从暖光布景、情感化构图到手部停顿、商品细节特写,每一帧都传递“精致”与“珍视”。以珠宝礼盒为例,俯拍视角下,红色对开门展开如舞台揭幕,银色项链在深蓝夜空衬底中缓缓呈现,掌心承托、缓慢转动,强化视觉记忆。结尾平铺构图,礼盒与商品共存,情绪由期待落至静谧珍藏。全程无文字,靠画面叙事,实现仪式感与品牌调性的深度融合。

yunhhhhh的博客 130

RN鸿蒙空间音频实战

示例仓库:https://atomgit.com/m0_37170006/react-native-ohos-spatial-audio 社区导引:框架源码与版本发布见 https://atomgit.com/CPF-RN/ohos_react_native/tree/0.84-main CPF-RN 鸿蒙社区:https://atomgit.com/CPF-rn。

buhuisuanfa的博客 2万+

通过 AIGC 生成视频何时才能告别“抽卡”!

如果视频的主体内容已经符合要求,只存在错误字幕或局部画面瑕疵时,重新生成不仅增加成本,还可能改变原本满意的部分。针对这类问题,WAND-EraseVibe+ 提供了视频擦除与画面重建能力。根据腾讯云披露的技术方案,该工具采用基于隐空间 Transformer 的生成式修复架构,先将视频画面编码为隐空间特征,在特征层推断并重建需要修复的区域,再解码为视频画面。白模前置、垂直场景调优和局部修复分别作用于不同环节,目的都是减少为了获得可用内容而付出的重复生成成本。

Enweitech Software Works 163

网页视频资源识别与本地化管理:从 HTTP 流媒体技术到完整的视频工作流

现代网页视频技术已经从简单的文件传输发展到分段传输、自适应码率和浏览器端媒体处理。这使视频播放体验不断改善,也让资源识别和本地管理变得更加复杂。对于技术人员而言,理解 HTTP、HLS、MPEG-DASH 和 MSE 的基本工作机制,有助于更准确地分析网页视频的传输过程。对于视频创作者和研究人员而言,建立从内容发现、资源识别到本地整理的完整工作流,可能比单纯寻找一个下载工具更有长期价值。

m0_68263549的博客 453

Android 音频 Player 体系

Android 音频框架中,"Player"是统一抽象的音频播放实例,涵盖 AudioTrack、MediaPlayer 等。每个 Player 由唯一 piid 标识,通过 PlayerBase 注册至 PlaybackActivityMonitor,状态机管理其生命周期(idle→started→stopped→released)。关键事件如 portId 绑定、静音(位掩码标识主静音、音量为0等)、设备切换等均通过 PLAYER_UPDATE_* 通知系统。静音原因以掩码形式记录,日志中“source

aningxiaoxixi的博客 146

15. 调用ComfyUI生成视频!

在“导演大师”中,我们不仅支持导出分镜导演包并一键导入运行,还为用户提供了极高的自定义自由度。许多创作者希望结合自己精心调试的 MiniMax H3 工作流来生成视频,这当然是完全支持的。通常有两种操作方式:一种是手动复制,将分镜的资产与提示词手动粘贴至本地工作流中;另一种则是更为高效的自动化方案——直接在“导演大师”中调用 ComfyUI 工作流,实现一键生成。本文将重点介绍后者的配置与使用全流程,帮助你打通从分镜脚本到视频直出的自动化链路。

2601_95544990的博客 285

[黎阳之光] 边海防无人机巡检实战教程:航线规划、目标发现与视频孪生联动一次讲透

本文给出的是简化版模型与参考框架,面向真实项目的完整落地,还需结合具体海域、设备与业务规则做针对性设计。它的角色不是替代固定感知,而是做“机动确认层”——雷达和固定视频负责发现,无人机负责在 10 分钟内飞到目标上空,把“有个点”变成“看清是什么”。数据流的关键指标:无人机视频接入孪生平台延迟不超过 800ms,位置上报频率 1Hz,吊舱角度反馈 10Hz。位置或角度一滞后,图上无人机的视野锥就会和实际画面错位,指挥员按图指挥就会指错地方。这样既不断档,又不烧钱。

m0_75019831的博客 309

面向强噪声工业场景的 KL‑2510 音频 DSP 模组设计与多场景落地分析

KL-2510是一款22×16mm邮票孔SMT封装音频模组,集成ADC/DAC、AI-ENC降噪(45–90dB)与AEC回声消除(100dB),支持USB免驱及模拟/PDM麦克风输入,具备4档硬件拾音增益,适配医疗、矿山、安防等复杂噪声场景。通过五类真实案例验证其在病房对讲、井下报警、门铃对讲等应用中的稳定性与易用性。重点提示:需接入AEC_IN参考信号、输出加分压电路、外设勿接3V3电源,避免烧毁。适用于空间紧凑、无算法团队的嵌入式项目,显著降低音频开发门槛。

R190_6589的博客 418

翻译配音后音画对不上?用 ffmpeg + Python 把新音轨对齐到原视频时间轴

做视频出海、课程本地化的同学迟早会撞上这个坑:原片是中文 3 分钟口播,你换成英文 AI 配音后,要么配音在 2 分 10 秒就播完了、后面画面在放"默片",要么配音拖到 4 分钟、视频早黑屏了——也就是**音画不同步(A/V desync)**。 根因很简单:不同语言的"信息密度"不一样。同一段意思,英文往往比中文多 30%~50% 的音节,中文又比英文短。你把原音轨换成翻译后的配音,新音轨长度和原视频时间轴天然对不上。本文把"怎么测量偏差、怎么用 ffmpeg 把新音轨拉伸/压缩到刚好贴合原视频、...

weixin_60261120的博客 350

视频已经变模糊了,为什么还是会卡?

视频播放中画质忽清忽糊、画面转圈,根源在于下载速率与缓冲消耗不匹配。即使测速快,也未必能持续支撑高画质播放。自适应码率切换需综合考虑缓冲余量、持续吞吐与切换成本,盲目升档易导致卡顿。测试时应固定片源、模拟真实网络变化,记录缓冲、切换与停顿细节,结合下载、缓冲与轨道变化时间线分析问题,才能优化体验。稳定中等画质往往比频繁跳变更可接受。

NetworkSimulator的博客 258
上一篇: MVBench多模态大模型视频理解能力基准 | CVPR Highlight
下一篇: DCNv4: 动态与稀疏操作的高效融合 | CVPR Highlight
OpenGVLab
博客等级 码龄2年 418粉丝 38原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值