
InternVideo2 视频理解大模型已开源,更强VideoChat来袭!

【学习笔记】行为识别SOTA方法比较 本博客主要针对四类行为识别算法中表现较优模型进行介绍,包括SlowFast、Video TimeSformer、Video Swin Transformer、VideoMAE和Intern Video。 阅读详情
AI摘要

上海人工智能实验室等单位开源新一代视频理解大模型InternVideo2。它在多个视频/音频任务上达SOTA,具备更强语义感知与理解能力。采用Scaling law指导的三阶段渐进式预训练范式,构建大规模多模态数据集。全系列模型和代码已开源,还提供Demo试用。

作者 @王毅 @Sakura.D @何逸楠@王利民

在当下,视频无疑是连接我们日常沟通与分享的纽带。据最新数据表明,互联网上超过70%的流量都来源于视频内容,然而,AI大模型做视频理解并非易事,LeCun就曾在访谈中谈及他在视频理解领域数十年的经验心得(阅读详情)。

书生系列大模型是最早在此领域取得突破的大模型之一。2022年,InternVideo已经成在视频理解标杆Kinetics 700和Kinetics400上获得SOTA性能,且成为世界首个在K400上突破90% Top1 accuracy的大模型;2023年成为我们超受欢迎的VideoChat:以聊天为中心的通用视频理解新范式的基础模型。最近,上海人工智能实验室携手南京大学、中国科学院深圳先进技术研究院等单位,共同探索并开源了新一代的视频理解大模型——InternVideo2。这款模型在6B的视频编码器和超过4亿视觉样本的训练下,通过渐进式学习显著提升了视频语义理解和世界建模能力,能够进行长视频理解和过程性推理,在具身智能、自动驾驶等重要领域,具有良好的应用前景。

InternVideo2在Kinetics 400获得92.1% Top1 accuracy ,在60余个视频/音频相关的任务上SOTA,在Perception Test、EgoSchema、MVbench等多模态视频大模型能力评测上,性能超越或比肩GPT4V、Gemini、Llama3V等,具备更强的动态场景语义感知与时序内容理解能力,支持动态语义的精确解析、时序内容关联与综合理解、复杂时序关系推理与预测,能够理解过程性知识(人类技能),实现动作或事件的时序分解。

点击观看视频展示👇

来和AI视频对话吧!InternVideo2 开源视频理解大模型_哔哩哔哩_bilibili

来和AI视频对话吧!InternVideo2 开源视频理解大模型_哔哩哔哩_bilibili​www.bilibili.com/video/BV1dXYTesEMj/?spm_id_from=333.999.0.0

添加图片注释,不超过 140 字(可选)

🚀开源链接-进入后点击InternVideo2:

GitHub - OpenGVLab/InternVideo: [ECCV2024] Video Foundation Models & Data for Multimodal Understanding

📃论文链接:

https://arxiv.org/abs/2403.15377

👉试用Demo:

https://vchat.opengvlab.com

❤️加群:添加小助手(gvxiaozhushou),发送“视频”

能力展现:多个场景性能最佳的视频理解大模型,掌握从基础感知,开放问答,到复杂推理

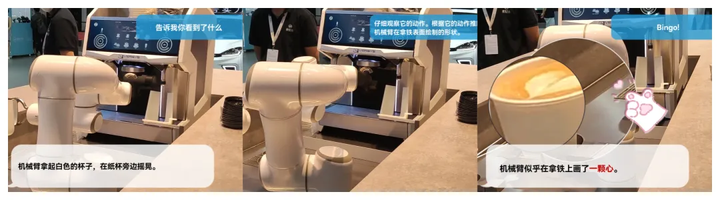
InternVideo2在60个主流的视频理解任务上取得了世界领先性能,涵盖了从经典动作识别到视频语音任务,再到高阶视频对话问答的任务。相较于2022年发布的InternVideo,InternVideo2具备更强的动态场景语义感知与时序内容理解能力,支持动态语义的精确解析、时序内容关联与综合理解、复杂时序关系推理与预测,能够理解过程性知识(人类技能),实现动作或事件的时序分解。正如演示视频(或下图)所示,InternVideo2可以更精细地描述一个过程的先后细节动作。这使其在多模态视频交互、视频内容分析、自动视频标注和视频检索等多个领域具有广泛的应用潜力,为构建多模态世界基础模型和通用具身智能提供技术支持。

技术创新:Scaling law指导下的三阶段渐进式视频预训练范式

在Scaling law的指导下,InternVideo2在参数规模 (视频编码器60亿参数)、数据规模(3亿图文对+1亿视频文本对)和标注质量(通过文本对齐实现视频、语音和字幕的协调)三个方面上达到了新的高度。

在技术创新上,采用渐进式训练方案构建。学习过程分为三个阶段:(1)通过掩码重建捕捉时空结构,(2)跨模态的语义对齐,(3)通过下一个词元预测增强其开放式对话能力。在初始阶段,模型学习重建未掩码的视频词元,使视频编码器具备基本的时空感知能力。为估计现有词元,采用了不同训练的视觉编码器(InternViT和VideoMAE-g)作为代理。在跨模态学习第二阶段,架构扩展为包含音频和文本编码器。这不仅改善了视频与文本之间的对齐,还赋予InternVideo2处理视频-音频任务的能力。通过整合这些额外模态,模型对视频的理解得到了丰富,并与其语义对齐。最后,在下一个词元预测阶段,构建了一个以视频为中心的对话系统,以进一步调整InternVideo2。通过将InternVideo2与大语言模型连接,视频编码器通过下一个词元预测训练进一步更新,增强了其在开放式任务(如视频问答和视频描述)中的能力。

在数据处理上,我们构建了包含4亿多数据项的大规模多模态数据集,其中对视频进行了精准的时序分割,提升数据的时空一致性,并通过新的多模态标注系统从视频、音频、语音多角度进行标注,提升标注的模态一致性,从而增强模型的训练质量和泛化能力。
添加图片注释,不超过 140 字(可选)

开源生态建设: 从基础视频表征模型到多模态对话模型

我们致力于开放共享,InternVideo2的模型从基础视频表征模型到多模态对话模型一应俱全。除了发布InternVideo2每个阶段的模型,我们还提供了常用的对话模型和一些专用的小模型,以便社区更好地体验和使用我们的研究成果。目前,InternVideo2的全系列模型和相关代码已经全面开源,并且提供了Demo供公众试用。希望各界朋友能够亲自体验demo、使用InternVideo模型,并向我们反馈宝贵意见,共同推进大模型落地应用!

🚀开源链接-进入后点击InternVideo2:

GitHub - OpenGVLab/InternVideo: [ECCV2024] Video Foundation Models & Data for Multimodal Understanding

📃论文链接:

https://arxiv.org/abs/2403.15377

👉试用Demo:

https://vchat.opengvlab.com

❤️加群:添加小助手(gvxiaozhushou),发送“视频”


关注OpenGVLab 获取通用视觉团队最新资讯

🔗开源主页:https://github.com/OpenGVLab

📮官方邮箱:opengvlab@pjlab.org.cn

😊转载,加群,咨询博士招生等,私信GV小助手(ID:gvxiaozhushou)

【ECCV 2024】InternVideo2: Scaling Foundation Models for Multimodal Video Understanding Authors单位【Paper】【Project】我们推出了 InternVideo2,这是一个新的视频基础模型 (ViFM) 系列,它在视频识别、视频文本任务和以视频为中心的对话方面取得了最先进的结果。我们的核心设计是一种渐进式训练方法,它将屏蔽视频建模、跨模态对比学习和下一个标记预测相结合,将视频编码器大小扩展到 6B 参数。在数据层面,我们通过对视频进行语义分割并生成视频音频语音字幕来优先考虑时空一致性。这改善了视频和文本之间的对齐。 阅读详情

相关推荐

Fanuc机器人的坐标变换矩阵的研究2

一、Funuc用户坐标系的介绍 二、用户坐标系与世界坐标系的坐标转换 三、 以用户坐标系1为基础旋转变换后的用户坐标系 四、关于点的WPR的含义 4.1:点在用户坐标系和世界坐标系下的坐标关系 4.2 通过转换矩阵返回去推导WPR

qq_34047402的博客 1524

多模态基础模型-InternVideo2:Scaling Video Foundation Models for Multimodal Video Understanding

1、模型训练上,设计了一种渐进式的训练方法,将掩码视频建模、跨模态对比学习和下一个token预测统一起来, 2、数据质量上,强调时空一致性,通过语义分割视频并生成视频-音频-caption,改善了视频和文本之间的对齐 3、将参数量扩展到了60亿,视频识别、视频-文本任务、音频和以及视频中心对话取得sota

lovep1的博客 2543

Rockchip硬件编码实战:5分钟搞定RK3588上的H.265视频压缩(附FFmpeg集成指南)

本文深入解析了在Rockchip RK3588平台上利用硬件编码器实现高效H.265视频压缩的完整实战流程。文章详细介绍了MPP库的基础使用、FFmpeg集成方法,并重点分享了零拷贝、多实例编码等关键性能优化技巧,帮助开发者充分发挥RK3588的硬件编码能力,实现从YUV原始数据到高质量H.265码流的高效转换。

h6i7j8的博客 1098

论文解读|InternVideo2重塑视频理解新标杆,多模态学习引领行业风向

InternVideo2重塑视频理解新标杆,多模态学习引领行业风向

柏企阅文 4781

STM32进入HardFault_Handler时,如何找到问题所在?

当STM32进入HardFault_Handler时,定位问题发生的点

m0_60831979的博客 2150

拥有AI助手便能解放双手?——抖音直播脚本的生成

科技改变生活,AI助手帮你完成抖音创作!

Scientist_的博客 2352

【论文分享】InternVideo: General Video Foundation Models via Generative and Discriminative Learning

最近,基础模型在计算机视觉领域的各种下游任务上表现出色。然而,大多数现有的视觉基础模型仅关注图像层次的预训练和适应(adaption),这对于动态且复杂的视频层次理解任务来说是有限的。为了填补这一空白,我们通过利用生成式和判别式自监督视频学习的优势,提出了通用视频基础模型InternVideo。具体来说,InternVideo高效地探索了遮罩视频建模和视频-语言对比学习作为预训练目标,并以可学习的方式选择性地协调这两个互补框架的视频表示,以提升各种视频应用。

crazyjinks的博客 4639

【AI智能体】基于OpenCode 搭建Skills环境与项目实战开发详解

基于OpenCode 搭建Skills环境与项目实战开发详解

congge 8899

10 分钟在 Windows 装好第一个安卓应用:APK Installer 实操指南

APK Installer 是一个安卓应用安装工具,直接跑在 Windows 上,不需要模拟器。本文带你完成第一次安装 APK 的全过程,预计 10 分钟。 ## 📋 核对 4 项条件再动手 - **Windows 10 Build 17763 及以上版本** - **处理器支持 ARM64 / x86 / x64 架构** - **至少 400 MB 空余空间** - **已安装 Wind

gitblog_00495的博客 943

C++之2048小游戏 第二期

游戏会有初始化、绘制界面、处理输入、更新游戏状态、判断胜负等部分。所以,可能需要一个二维数组来表示4x4的网格,存储每个格子的数值。然后,需要处理键盘输入,尤其是方向键的控制,这可能需要使用EasyX的键盘事件处理函数。然后,关于图形绘制部分,每个格子的大小、颜色、数字的显示都需要设计。不同的数字对应不同的颜色,比如2是浅色,4稍深,以此类推。可能需要一个函数根据数字的值返回对应的颜色,然后在绘制时调用。接下来,处理数字的移动和合并逻辑。这是比较复杂的部分。

Lucky_Glory的博客 805

【WRF模拟】如何查看 WPS 的输入静态地理数据(二进制格式)?

如何查看 WPS 的输入静态地理数据(二进制格式)?

WW、forever的博客 633

VideoChat2_stage3_Phi3初探:OpenGVLab开源的多模态视频理解大模型检查点,一文全解析

**VideoChat2_stage3_Phi3** 是 OpenGVLab 团队开源的一个**多模态视频理解大模型检查点(Checkpoint)**,基于 PyTorch 框架,内置 Phi-3 作为语言模型底座,属于 VideoChat2 系列模型的 Stage 3(多任务视频理解微调)权重。对于想快速上手**视频理解大模型**的新手来说,这是无需漫长训练、直接加载即可复用的现成权重文件。本文

gitblog_00770的博客 287

【3D Slicer】的小白入门使用指南一

3D Slicer 是一个免费的开源软件平台,用于医学、生物医学和其他 3D 图像的可视化、处理、分割、配准和分析。Slicer 的功能包括:读/写。

图挖掘领域,新晋砖家 ☞ 未来可期,欢迎和静静一起学习交流吖 5555

InternVideo2_Chat_8B_InternLM2_5 完整指南:8B 参数开源视频大语言模型的一站式视频理解方案

**InternVideo2_Chat_8B_InternLM2_5** 是 OpenGVLab 开源的 8B 参数视频大语言模型(Video LLM),采用 MIT 协议免费开放。它将 InternVideo2-1B 视频编码器、Q-Former 视觉桥接器和支持 1M 超长上下文的 InternLM2.5-7B 语言模型组合在一起,只需几行 Python 代码,就能让模型"看懂"视频并以自然语

gitblog_00568的博客 856

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

InternVideo2-Stage1-1B-224p-f8 应用实战:动作识别、视频检索与VideoChat生态联动

**InternVideo2-Stage1-1B-224p-f8** 是上海AI Lab OpenGVLab 团队开源的 **InternVideo2 视频基础模型** 中一个关键预训练检查点(checkpoint),专为**动作识别、视频检索和视频理解**等下游任务设计。 它来自论文《InternVideo2: Scaling Video Foundation Models for Multi

gitblog_00034的博客 190

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

如何免费给旧Mac升级macOS:OpenCore Legacy Patcher完整指南

OpenCore Legacy Patcher 是一款开源工具,让 2008 至 2017 年间生产的 Intel Mac 能够免费安装更新的 macOS 版本,覆盖 Big Sur 到 Sequoia 的完整范围。本文按真实操作路径讲解旧Mac升级macOS的全过程,看完即可动手。 [![旧Mac升级macOS主菜单界面](https://raw.gitcode.com/GitHub_Tren

gitblog_00346的博客 503

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

一文读懂 Video_Encoders_for_Training_VideoChat-Flash 的 2 个权重文件:UMT-L_f4 与 InternVideo2-1B_f4 详解

如果你正在训练视频大模型(Video-LLM),或想复现 OpenGVLab 的 VideoChat-Flash 长视频理解方案,这个仓库正是起点。**Video_Encoders_for_Training_VideoChat-Flash** 由 OpenGVLab 开源,仅用 2 个核心权重文件——[UMT-L_f4_vision.pt](https://link.gitcode.com/i/8

gitblog_00182的博客 436

如何快速上手VideoChat-Flash-Qwen2_5-7B_InternVideo2-1B_rai_1.8.0_npu_16K:Ryzen AI 1.8本地NPU部署完整教程

📌 **VideoChat-Flash-Qwen2_5-7B_InternVideo2-1B_rai_1.8.0_npu_16K** 是 AMD 官方针对 Ryzen AI 硬件深度优化的多模态视频理解模型,基于 Qwen2.5-7B 语言模型 + InternVideo2-1B 视觉编码器,通过 UINT4 量化 + OGA 工具链完成 NPU 部署(16K Token 融合),让你在本机 R

gitblog_07545的博客 454

VideoChat2 Stage2 训练原理揭秘:多阶段训练如何赋予 Mistral 7B 真正的视频理解能力

VideoChat2 Stage2 是 OpenGVLab 团队基于 Mistral 7B 大模型训练的视频理解检查点,通过"预训练 + 指令微调"的多阶段训练路线,让原本只会处理文本的 Mistral 7B 具备了"看懂视频"的能力。本文用通俗的方式拆解它的训练原理、各阶段的作用,以及这个 Stage2 权重文件到底装了什么,帮助你快速上手这个模型。 ## 一、为什么需要"多阶段训练"?🎬

gitblog_00432的博客 417

InternVideo2_Chat_8B_InternLM2_5三段式架构全解析:InternVideo2编码器+Q-Former+InternLM2.5如何协同看懂视频

InternVideo2_Chat_8B_InternLM2_5 是一款开源视频大模型(VideoLLM),由 **InternVideo2 视频编码器 + Q-Former 桥接器 + InternLM2.5 语言大模型** 三段式架构组成,让模型能够"看懂视频"并用自然语言作答。本文带你完整拆解这三大组件各自的角色、协同工作的推理流程,以及如何快速上手运行视频问答。🎬 ## 这是什么模型?

gitblog_00652的博客 603

VideoChat2社区生态:InternVideo团队、论文引用规范与后续研究路线图

**VideoChat2** 是 InternVideo 团队开源的对话式视频理解多模态大模型,而本仓库 `VideoChat2_stage2_Phi3` 提供了基于 Phi-3 语言骨干的 Stage2 训练检查点(约 15.8 GB)。本文带你快速了解它的社区生态、如何规范引用相关论文,以及这条研究路线的后续走向,帮助新手顺利上手视频理解模型。 ## 📦 这个仓库里有什么:VideoCha

gitblog_00022的博客 221

VideoChat-Flash-Qwen2_5-7B_InternVideo2-1B_rai_1.8.0_npu_16K NPU推理性能调优清单:KV缓存、4096分块与5个关键提速点

本文基于 VideoChat-Flash-Qwen2_5-7B_InternVideo2-1B_rai_1.8.0_npu_16K 模型,面向新手讲解在 AMD Ryzen AI NPU 上做推理性能调优的关键点:KV 缓存绑定、4096 分块上下文、NPU 后端直出等 5 个提速配置,帮助你在本地 NPU 上跑得更快、更省内存。 ## 一、这个模型是什么?🎬 VideoChat-Flash

gitblog_00988的博客 236

dd_metastate控制包是什么?VideoChat-Flash-Qwen2_5-7B_InternVideo2-1B_rai_1.8.0_npu_16K的NPU 16K长上下文工程拆解

本文带你完整拆解 VideoChat-Flash-Qwen2_5-7B_InternVideo2-1B_rai_1.8.0_npu_16K 模型仓库:搞清楚神秘的 dd_metastate 控制包(ctrlpkt)到底是什么,以及 NPU 16K 长上下文部署背后的一整套工程细节。 ## 这个模型是什么? 在深入文件之前,先明确这个仓库的定位(来源见 [README.md](https://l

gitblog_01152的博客 361

VideoChat-Flash-Qwen2_5-7B_InternVideo2-1B_rai_1.8.0_npu_16K部署FAQ:已知限制、MIT/TPN许可说明与从1.8.0升级的完整路线图

**VideoChat-Flash-Qwen2_5-7B_InternVideo2-1B_rai_1.8.0_npu_16K** 是 AMD 面向 **Ryzen AI NPU(16K 上下文)** 发布的 VideoChat-Flash 多模态视频理解模型包:Qwen2.5-7B 语言模型 + InternVideo2-1B 视频编码器,经 AWQ/UINT4 量化与 ONNX 转换后可直接部署

gitblog_00819的博客 729

【免费下载】 InternVideo 项目使用教程

InternVideo 是一个专注于视频基础模型的开源项目,由 OpenGVLab 开发。该项目旨在通过生成和判别学习的方法,提供通用的视频基础模型。InternVideo 系列包括多个版本,如 InternVideo 和 InternVideo2,分别用于不同的视频理解和生成任务。此外,项目还提供了大规模的视频-文本数据集 InternVid,用于多模态理解和生成。 ## 2、项目快速启动 ...

gitblog_00735的博客 2078

MiniMax-H3 5 分钟从下载到出片:ComfyUI 视频模型新手部署指南

MiniMax-H3 是一款在 ComfyUI 中运行的视频生成模型,核心能力包括文生视频(T2V)、图生视频(I2V)、参考生视频(R2V)。下面这条路径带你走完"自检 → 落位权重 → 加载工作流 → 调参出片"的完整流程。 ## 部署前自检:硬件门槛与路径规划 MiniMax-H3 比较吃显存:视频模型之外还有一个 32B 的文本编码器。动手前对一下这张表: | 项目 | 最低要求 |

gitblog_00126的博客 227
上一篇: 万字干货分享!基于PaddleMIX实现InternVL2多模态模型推理
下一篇: A3VLM: 一种基于视觉语言模型的关节感知的通用操作解决方案 | 联培生佳作
OpenGVLab
博客等级 码龄2年 418粉丝 38原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值