InternVid:用于多模态视频理解与生成的大规模视频-文本数据集 | ICLR Spotlight

SiameseFC-TensorFlow 代码详细注解(二):训练数据VID2015预处理 说明:该系列博客源码链接为:https://github.com/bilylee/SiamFC-TensorFlow,是实验室同小组的师兄用TensorFlow实现SiameseFC算法的最终公开版本,经过了长时间的打磨,各个模块功能明确,整体可读性和可移植性极好,我相信这对做Tracking的小伙伴来说,是个入门SiameseFC Tracker的特别好的选择。哈哈,觉得代码很棒的小伙伴们可以点... 阅读详情
AI摘要

InternVid是一个大规模视频-文本数据集,包含700万个视频,总时长近76万小时,旨在推动视频理解和生成任务的发展。数据集覆盖多种领域,并附带详细的文本描述,支持视频分类、检索、描述生成等多种任务。

InternVid 是一个开源的大规模视频-文本数据集,旨在促进视频理解和生成任务的发展,由上海人工智能实验室与南京大学、中国科学院等单位联合发布,相关的工作已经被ICLR2024接收。它包含超过 700 万个视频,总时长近 76 万小时,并附带详细的文本描述。InternVid 的发布将推动文本-视频的多模态理解和生成的进步,并为相关研究和应用提供新的机遇,包含以下特点:

  • 规模庞大:InternVid 是目前公开的最大的视频-文本数据集之一,包含超过 700 万个视频,总时长近 76 万小时。

  • 内容丰富: 视频内容涵盖日常生活、体育运动、娱乐、教育等多个领域,能够满足不同研究和应用的需求。

  • 高质量: 视频和文本都经过精心挑选和处理,保证了数据集的高质量,提供了丰富的描述,CLIP-SIM,视频美学分数。

InternVid 可用于以下任务:

  • 视频理解: 视频分类、视频检索、视频描述生成、视频摘要生成等。

  • 视频生成: 视频编辑、视频合成、视频特效等。

  • 多模态学习: 视频-文本语义匹配、视频-文本检索、视频-文本生成等。

论文:

https://arxiv.org/abs/2307.06942

开源链接:

https://github.com/OpenGVLab/InternVideo/tree/main/Data/InternVid

HuggingFace:

https://huggingface.co/datasets/OpenGVLab/InternVid


一 InternVid的出发点

学习可迁移的视频-文本表示对于视频理解至关重要,尤其是在自动驾驶、智能监控、人机交互和视觉搜索等实际应用中。近期,OpenAI发布的Sora模型在文生视频领域取得了显著进展。Sora不仅打破了视频连贯性的局限,还在多角度镜头切换中保持一致性,并展示出对现实世界逻辑的深刻理解。这一突破为视频-语言领域的多模态对比学习提供了新的可能性,尽管目前Sora尚未开放给公众使用,2但其在视频生成领域的GPT-3时刻,预示着通用人工智能的实现可能比预期来得更快。

但是限制住目前探索的一个关键原因是缺乏用于大规模预训练的高质量视频-语言数据集。当前的研究依赖于如HowTo100M [1]、HD-VILA [2] 和 YT-Temporal [3, 4] 等数据集,其文本是使用自动语音识别(ASR)生成的。尽管这些数据集规模庞大,但它们在视频和相应文本描述之间的语义相关性通常较低。这类的数据一方面不太符合文生视频等生成任务的需要,另一方面提高这种相关性(例如,通过将视频与描述对齐以改善它们的匹配度)显著有利于下游任务,如视频检索和视频问答。
图片

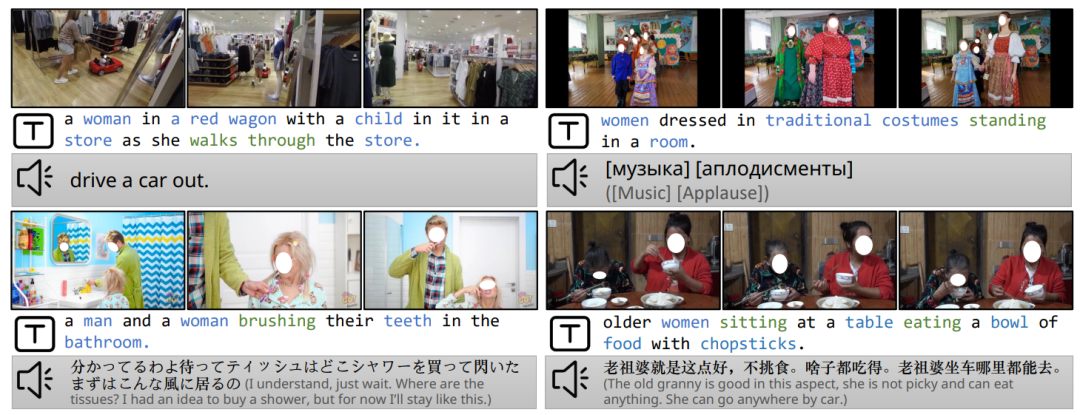
为了解决扩大视频语言建模规模的挑战,同时保持高视频-文本对应性,我们提出了一个大规模的以视频为中心的数据集InternVid,见图1。ASR转录几乎没有描述视频中的视觉元素,而生成的描述则涵盖有更多的视觉内容。该数据集包含高度相关的视频-文本对,包括超过700万视频,总计760,000小时,产生234M个视频片段,涵盖16种场景和约6,000个动作描述。为了提高视频-文本匹配度,我们采用了多尺度方法生成描述。在粗略尺度上,我们对每个视频的中间帧进行描述,并使用描述作为视频描述。在精细尺度上,我们生成逐帧描述,并用语言模型对它们进行总结。

通过InternVid,我们学习了一个视频表示模型ViCLIP,实现了较强的零样本性能。对于文生视频,我们筛选了一个具有美学的子集InternVid-Aes,并涵盖1800万个视频片段。与WebVid-10M[5]一起,InternVid可以显著提高基于diffusion的视频生成模型的生成能力。


Large-scale Video Classification with Convolution Neural Networks Large-scale Video Classification with Convolution Neural Networks 摘要:卷积神经网络(CNNs)在图像识别问题中已经被当做一个有力的模型被建立起来。受这些成果的影响,我们在大规模的视频分类数据集上准备了大量的对于CNNs经验的评价,我们用了一个新的数据集,它包括一百万个YouTube视频,属于487个不同的类别。为了扩展CNN 阅读详情

相关推荐

视频动作识别、行为识别、时空动作检测数据集整理(持续更新)

动作、行为、事件 在计算机视觉的相关研究中,人体的动作、行为识别是一个基础研究问题。但目前识别、检测人类的动作/行为仍然是一个巨大的挑战。这里整理下当前相关的细分任务、数据集和开源代码(持续更新中)。

人工智能算法与工程实践 3万+

ImageNet VID数据集 / ILSVRC 2015-VID数据集

ImageNet VID数据集 / ILSVRC 2015-VID数据集介绍: 研究方向为视频目标检测,需要使用视频目标检测数据集,发现关于介绍ImageNet VID数据集的博客不多,就自己记录一下 类别 该数据集一共有30个类别,是ImageNet DET数据集200个类别的子集。ImageNet VID数据集一共有3862个视频片段用于训练,555个视频片段用于验证,937个视频片段用于测试。 30个类别为: n02691156 1 airplane n02419796 2 antelope n021

qq_40535862的博客 7743

CTF实战:Flask Session流量解密与内存马路由追踪

本文通过一道CTF实战题目,详细解析了Flask Session流量解密与内存马路由追踪的全过程。文章从破解前端加密密码入手,逐步揭示如何利用泄露的SECRET_KEY解密Session,发现命令执行痕迹,并最终追踪到攻击者植入的内存马路由。内容涵盖Wireshark流量分析、flask-unsign工具使用等实战技巧,为CTF选手和安全研究人员提供了一套完整的Flask应用安全分析思路。

weixin_28309571的博客 306

基于Simulink的魔术公式轮胎动力学仿真

本篇博文主要用来记录汽车系统动力学课程的学习,仅供课程阶段参考,与实际工程应用还有较大距离。基于Simulink的魔术公式轮胎动力学仿真本实例主要有以下任务。1.建立魔术公式轮胎动力学仿真模型。2.绘制不同载荷下的轮胎纵向力—滑动率关系曲线。3.绘制不同载荷下的轮胎侧向力—侧偏角关系曲线。4.绘制不同载荷下的轮胎回正力矩—侧偏角关系曲线。提示:以下是本篇文章正文内容,下面案例可供参考。

shy_201992的博客 6940

零中频接收机实战:DC Offset的5种常见解决方案与调试技巧

本文针对零中频接收机中DC Offset这一核心挑战,深入剖析了其产生机理与对信号解调的严重影响。文章从实战角度出发,系统性地介绍了五种解决方案,包括硬件预防、数字域校正、I/Q不平衡联合校正等,并分享了关键的实验室调试与产线测试技巧,旨在帮助射频工程师有效提升接收机性能。

weixin_29234509的博客 399

10. 重磅!Spring AI 1.0 正式发布,Java 开发者的 AI神器!

重磅!Spring AI 1.0 正式发布,Java 开发者的 AI神器! 全网最详细的Spring AI 文章,每章都会提供代码入口,让你更容易得入门和理解Spring AI 相关概念,直接节约你百分之六十的学习成本时间。

gorgor在码农 1066

【WRF-Chem】预处理工具(Preprocessors)总结

预处理工具(Preprocessors)总结

WW、forever的博客 1179

dify进阶:使用 FastAPI 的 StreamingResponse 实现高效的数据流传输

在 FastAPI 框架中,是一个非常有用的工具,它允许你以流的方式发送数据给客户端,而不是一次性加载所有内容到内存中再发送。这对于处理大型文件下载、视频流或者任何需要长时间处理的任务特别有用。

xiezhipu的博客 1433

C++从入门到进阶的系列书籍推荐(22本书)

要多读书,读好书!一本书要多读几遍才好,每次都可能有新的收获!特别在是有一定的工作年限和工作经验之后!读书百遍,其义自见! 下面就给大家推荐一下C++程序员进阶需要读的经典书籍: 1、C++入门书籍 C++是在C语言的基础上发展而来的,要学习C++之前需要先学习C语言。有了C语言基础之后再去学习C++。 1.1、C语言程序设计(谭浩强) 该书被公认为学习C语言程序设计的优秀教材,被全国大多数高校选用,是学习C语言的主流用书。本书比较通俗易懂,是初入者必备的书籍。 ........

dvlinker的技术专栏 4万+

ThingsBoard PE专业版解决方案技术文档——温度&湿度

温湿度解决方案

weixin_67440240的博客 819

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

上一篇: VideoMamba:用于高效视频理解的状态空间模型 | ECCV 2024
下一篇: 万字干货分享!基于PaddleMIX实现InternVL2多模态模型推理
OpenGVLab
博客等级 码龄2年 418粉丝 38原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值