OpenDataArena全面升级版正式上线,四大核心模块重构数据价值评估新格局

《AI实战嵌入式Agent +MCP+skill》课时2.5|定时器实战 本课讲解定时器时基单元原理,通过PSC、ARR、CNT三寄存器配合实现精确周期控制。以84MHz时钟为例,计算得PSC=8399、ARR=9999可实现1秒溢出周期。采用HAL_TIM_Base_Start_IT启动定时器更新中断,在HAL_TIM_PeriodElapsedCallback中处理周期任务,实现非阻塞、高精度的定时。相比HAL_Delay的阻塞式延时,定时器中断方案不占用主循环,支持并发操作,是嵌入式系统中实现周期任务的高效方式。 阅读详情

(文章发布于2025年12月23日)

导言:

为破解长期以来学界与业界难以对数据进行价值量化的困局,上海人工智能实验室(上海AI实验室)OpenDataLab团队在今年8月开源了首个全面、公正的后训练数据价值评测平台——OpenDataArena(ODA)。该项目致力于将数据选择从“盲目试错”的炼丹术,转变为一门可复现、可分析、可累积的严谨科学。

在初版系统发布后的数月间,项目通过团队内部及小范围社区用户的深度使用,完成了高强度的技术验证与功能打磨。伴随着评测规模、工具链和分析能力的持续扩展,近期,我们终于迎来了ODA的全面升级——一个结论更系统、功能更完整、视角更多元的正式版本,该项目面向全体开发者开放。

项目主页:https://opendataarena.github.io/

开源工具:https://github.com/OpenDataArena/OpenDataArena-Tool

数据集:https://huggingface.co/OpenDataArena/datasets

报告链接:https://arxiv.org/pdf/2512.14051

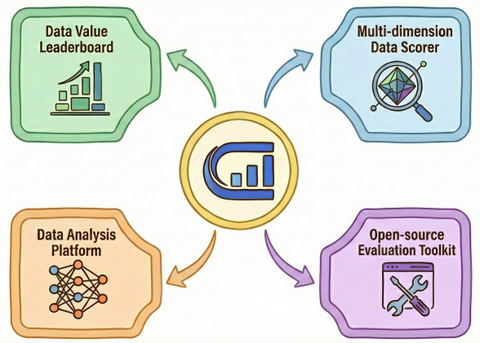
ODA的核心理念非常明确:数据价值必须通过真实的训练来检验,而非主观的臆测。为此,我们立足于全新发布的正式版本,对平台进行了体系化的深度重构,由四个相互支撑的核心模块组成了这套完整的数据评测基础设施。这标志着ODA已经从最初的功能验证阶段,发展成为可以对数据价值进行系统化评测的重要平台。
图片

一、数据价值排行榜

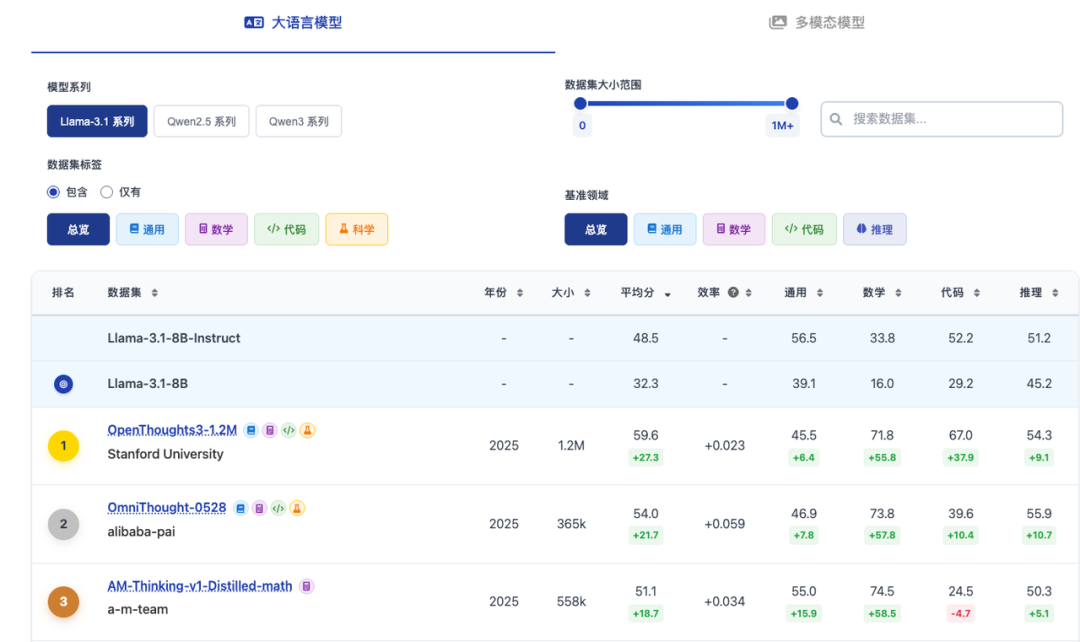
首先,ODA项目打造了数据价值排行榜。通过构建一套统一的训练与评测流程,让数据在固定的模型规模(如Llama3、Qwen2/3 7-8B)和训练配置下,对来自不同领域的文本及多模态数据进行横向评测。

评测覆盖通用、数学、代码、科学与长链推理等能力维度,这使得数据价值能直接通过下游任务(如数学、代码、推理等)的实际表现来量化,而非主观判断。目前,ODA平台已经从初版仅仅只有文本数据的评测,扩展到了多模态数据集的质量评测,并以最先进的Qwen3-VL作为真实训练的基准模型。
图片

二、数据血缘探索器

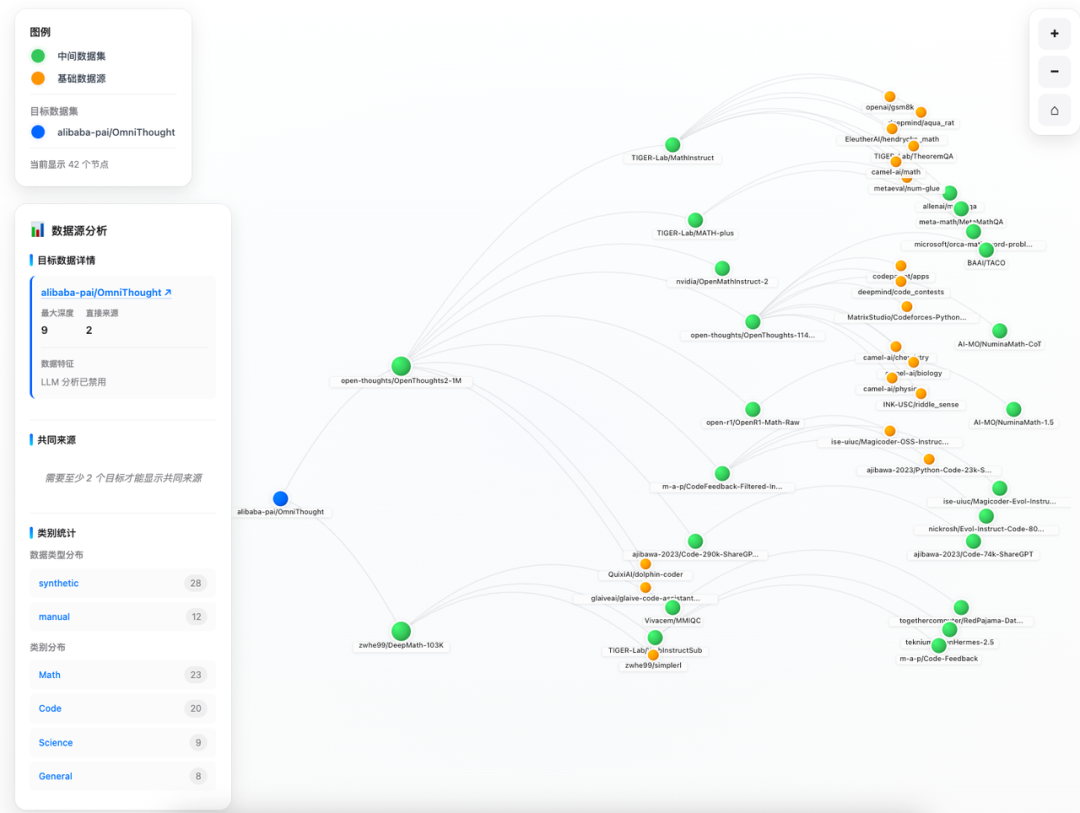
其次,针对数据界常见的“近亲繁殖”问题,ODA全新发布“数据血缘探索器”。它像绘制族谱一样,清晰地刻画出数据集之间的继承、混合与蒸馏关系。通过结构化建模与可视化展示,研究者可以直观地看到不同数据集之间的高度重叠与依赖关系,看到社区中被反复复用的核心数据源,以及更清晰的发现潜在的训练–测试污染与“近亲繁殖”问题。这一能力让“为什么某些数据集长期霸榜”不再是经验结论,而是可以被结构性解释的现象。
图片


三、多位数据评分器

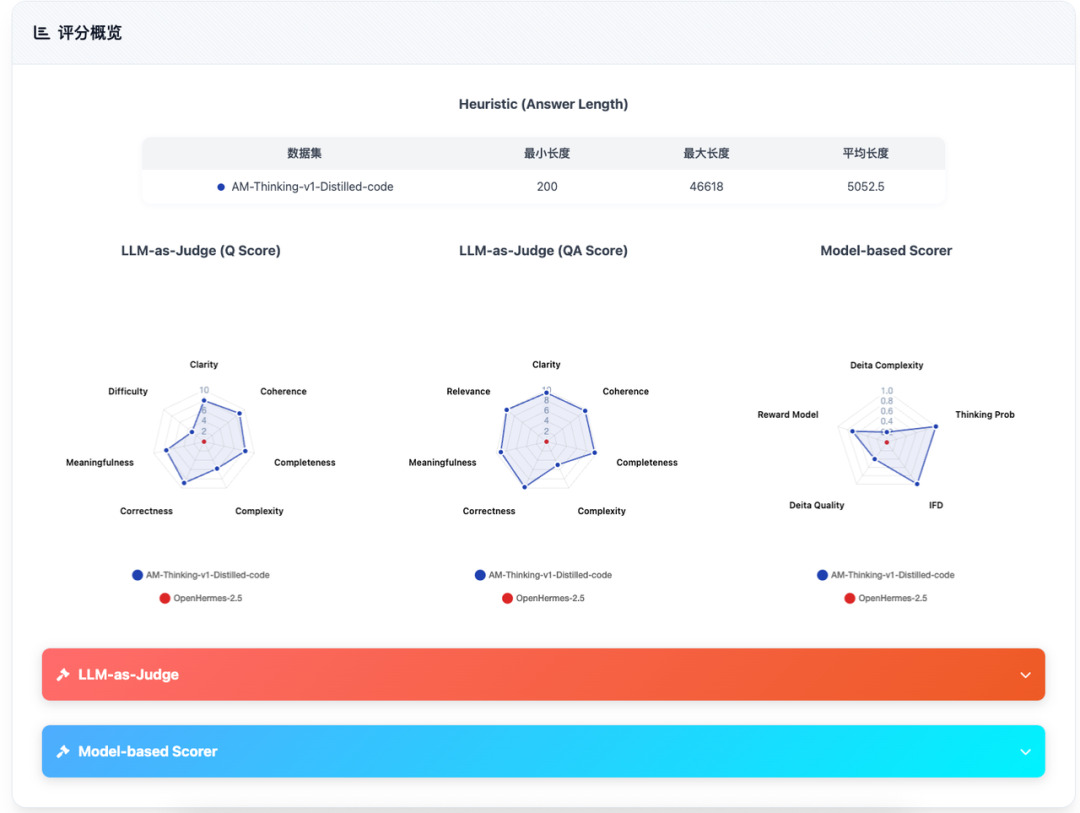
除了看模型结果,ODA还从数据本体出发,对数据质量进行细粒度刻画。ODA提供了一个细粒度的评分框架,基于模型评估、LLM-as-a-Judge与启发式指标等多种方法,从指令复杂度、响应质量、多样性等维度对数据进行深度剖析,生成每份数据的专属“体检报告”,并已对千万级样本的评分结果进行开源。这使得研究者不仅能判断“哪份数据更有效”,还能进一步分析它为什么有效。值得一提的是,在初版的基础上,ODA多维数据评分器目前已经扩展支持80+种多维度的评分器,支持用户一键方便的对所需要的数据维度进行打分。
图片

四、全开源评测工具箱

此外,为了促进社区共建,ODA完全开源了其训练、评分和可视化工具,覆盖从模型微调到结果复现的完整流程,以及上述精细化的数据评价打分器。ODA工具支持用户一键复现结果,或对自己私有数据进行标准化评测,实现真正意义上的横向对比。
图片

五、硬核发现:那些被忽视的数据真相

在对120多个主流数据集进行超过600次训练和4000万条数据的深度分析后,OpenDataLab团队得出了一系列具有指导意义的“硬核”结论,足以重塑业界对高质量数据的认知:

  1. 解答质量比问题复杂度更关键:实验发现,单纯增加问题的复杂度并不能有效预测数据价值。相反,解答的长度(推理过程的充分性)与最终质量呈强正相关,这在数学和科学类任务中尤为突出。

  2. 代码数据的“异类”属性:搞代码模型不能照搬数学的逻辑。代码讲究简洁精准,长篇大论反而会损害效果。这意味着通用的评分标准在代码领域经常失效,必须建立针对性的评估体系。

  3. 开源数据“近亲繁殖”严重:ODA的数据血缘分析显示,社区反复依赖的核心数据源比较有限(例如GSM8K被多次复用),由此造成了严重的数据同质化。借助数据血缘分析,更极端的发现是,数据污染越来越严重:大量训练样本直接与测试集发生重叠。

    “少即是多”的局限性:尽管LIMA等研究曾宣称少量精选数据即可成功,但 ODA的实验证明这极度依赖模型底座的先天能力。如果底座一般,过少的数据量会导致性能崩塌。真正稳健的路径是追求“高质量且具规模(High-Density Volume)”的数据配方。

  4. 为什么有些数据集能霸榜?以AM-Thinking-distilled为代表的超大规模聚集型数据集,能够同时在数学与代码任务上取得明显的优势,关键原因在于其跨领域融合能力。它通过递归方式整合了435个数据节点,显著提升了数据分布的多样性与互补性。

    数据可以弥补底座差距:这是一个令人振奋的发现。即使Llama3.1和Qwen 2.5 之间存在显著的底座分差,只要用上如 OpenThoughts3-1.2M 这样的高质量微调数据,这个差距几乎可以被抹平。可以说,好的数据配方真的能让模型“逆天改命” 。

未来展望

OpenDataArena的远景,绝不仅满足于建立一个排行榜,更致力于将数据研发从“玄学”推向可复现、可分析的“科学”。未来,ODA将持续进化,探索智能体数据,金融、医疗等垂直领域的深层价值。

在这个数据决定AI上限的时代,唯有手握科学的标尺,才能精准丈量每一份数据的真实重量!

5、数据库基础概念与数据建模全解析 本文深入解析了数据库的基础概念,包括函数依赖、决定因素和多值依赖等关键依赖关系,同时探讨了数据建模的重要方法论,如IDEF1X、信息工程和陈方法。此外,还介绍了SQL Server管理工作室的图表功能,帮助用户进行数据库的可视化设计。通过本文,读者将掌握数据库设计的核心知识,为构建高效、可扩展的数据库系统奠定基础。 阅读详情

相关推荐

【Get深一度】小波分析概念1——紧支撑集是什么意思,通俗解释

最近学到小波,在仿真中也用到了紧支撑函数;紧支撑性越好,说明能量越集中;用最通俗的话来讲,紧支撑是这样的: 对于函数f(x),如果自变量x在 0附近的取值范围内,f(x)能取到 C; 而在此之外,f(x)取值为 0; 那么这个函数f(x)就是紧支

Trey_优快云 的优快云博客 8348

6 款电商 AI 图片生成软件实测|国内 + 跨境卖家工具清单

电商 AI 作图工具已经从 "能不能用" 进入了 "好不好用" 的阶段。对于绝大多数卖家而言,现在的 AI 工具已经可以覆盖 60%-80% 的基础商品图需求,显著降低拍摄和设计成本。选择工具的核心逻辑不是 "哪款最强",而是 "哪款最适配你的品类、平台规模和团队能力"。垂直电商工具胜在工作流效率,通用生图工具强在创意上限,模板类工具赢在上手速度。建议根据自身业务阶段,搭配 1-2 款主力工具 + 1 款辅助工具,形成适合自己的视觉生产流程。

Mardi_Ladin的博客 326

告别环境报错:Qt Creator里配置Android SDK/NDK/JDK路径的完整避坑指南

本文详细解析了在Qt Creator中配置Android SDK/NDK/JDK路径的完整避坑指南,深入探讨了路径检测的内部机制、构建套件配置的隐藏逻辑以及项目级与全局配置的优先级。通过实际案例和高级排查技巧,帮助开发者解决常见的环境报错问题,提升Qt安卓开发效率。

weixin_42548829的博客 238

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 171

STM32F103RC学习(一)

STM32F103RC学习(一)

Cat_South_North的博客 6055

2025美赛E题为农业留出空间(附代码+全保姆教程)Making Room for Agriculture

有机农业的核心在于减少化学投入,促进自然控制和可持续性。变量定义CCC: 作物种群III: 害虫种群PPP: 天然捕食者种群(蝙蝠、鸟类等)BBB: 生物多样性水平(以种类数量表示)SSS: 土壤健康指数(影响植物繁殖与作物生长)EEE: 农业生态系统的整体稳定性。

博客 1494

我用 GPUWorks 在 M1 Pro 上搭了个发票识别原型

公司里经常要看电子发票。我想先做个小原型:把 PDF 发给一个自己部署的图文模型,让它提取发票类型、日期、交易双方和金额,再把结果交给同事核对。这个原型不用先接财务系统,先看看从部署到调用要走多少步,模型返回的内容能不能帮上忙。

鸽芷咕的博客 1万+

【无人机路径规划】基于强化学习实现多无人机路径规划附matlab代码

1 简介 本文提出一种基于强化学习实现多无人机路径规划。​ 2 部分代码 % This is used to measure the path length, service rate and risk explosure for each UAVs %% parameters function [PL,ServiceRate,Risk]=measure global N2; % divide [0,1]*[0,1] map into N2*N2 grid when calcul

qq_59747472的博客 6904

医疗 AI 有两种,别混着谈:一个改流程,一个改范式

InfoXMed 是面向医生、医学生和医学科研人员的 AI 医学工具平台,提供文献检索、全文翻译、AI 解读、指南查询和题库练习等功能,辅助临床学习、科研汇报与医学备考。原文是日本医学会杂志(JMA Journal)的一篇综述(Review Article):基本事实:这一点必须先说清:这篇论文提出的是一个研究纲领。它文中的"预测"指的是科学设想,不是可以拿来用的临床预测能力。文中甚至自己承认了一个硬缺口(见第三节)。本文只谈它的术语辨析与科学方法论,不转述任何可作为临床依据的预测或处置主张。这篇论文的全部

2601_96948740的博客 217

基于LLM【M3】驱动的自动化攻击智能体AK(受控使用)

摘要:文章实测了基于大模型的目标驱动型云攻击智能体,展示攻击者仅需输入业务目标(如"窃取BigQuery数据")即可自动完成SSRF、令牌解析、数据导出等全链条攻击。研究发现:(1)攻击编排范式已从固定脚本升级为自适应路径;(2)传统基于IOC的防御与新型攻击存在结构性错位;(3)防御需转向元数据加固、跨服务行为序列检测和AI驱动的紫队演练。实验在授权靶场使用合成数据,验证了攻击智能体"监督者模型+专业执行组"的协作模式,强调防御体系需从单点检测升级为攻击链理解能力。

云上笛暮 307

rk3576 适配以太网(百兆)

百兆以太网,也常被称为快速以太网,是一种在1990年代中期推出的计算机网络技术标准。它相当于把当时主流的10兆以太网速度提升了10倍,最高能提供 100 Mbps 的传输速率,让文件共享、视频传输等网络应用变得流畅许多。它在数据链路层面完全保留了传统以太网的帧格式和MAC机制,这意味着现有的网络软件可以无缝对接,用户从10兆网络升级到百兆网络时,通常只需要更换网卡和集线器/交换机即可,非常方便。 在rk3576平台上,原生以太网接口支持百兆、千兆,还有pcie转换的2.5G。

weixin_35723192的博客 203

在Codex 让AI模型 拥有长期智能记忆

本文介绍Claude-Mem V15新功能——智能记忆召回,解决AI遗忘、重复提示、执行不一致等问题。通过本地部署claude-mem,实现自动记录决策(如数据库选型)、跨会话智能召回,支持记忆写入、检索、遗忘全流程闭环。相比传统记忆方案,其基于Hooks自动捕获工具调用,结构化存储,可追溯、可共享、可清理,显著提升工程效率与协作一致性,是长期项目中理想的“工作黑匣子”与“工程脑”。

米莱虾 264

46、聚类算法在智能交通数据分析中的应用

本文探讨了聚类算法在智能交通数据分析中的应用,介绍了K-均值算法、K-中心点算法和基于模型的聚类算法的基本原理及特点,并结合实际交通数据讨论了其应用场景与挑战。通过聚类分析,能够从海量交通数据中发现隐藏模式,为交通管理和规划提供科学依据。文章还展示了具体的案例分析和实现流程,为未来智能交通系统的发展提供了参考。

zz67890的博客 133

您您这可以把问小白的多个会话比如说。左侧的多个会话一次性导出吗?不是单条会话里面的多次会对话。AI导出鸭

第三层是格式编译层。这个决策背后的判断很清晰:一个批量导出工具的价值,不在于“试三次”,而在于你真正用它处理了几十份技术文档、访谈记录或课程讲义之后,它是否值得留在你的工作流里。问小白的会话列表通过分页接口加载,AI导出鸭 在页面运行时建立旁路监听,捕获每一次分页请求返回的完整对话清单,包括会话 ID、标题、时间戳和隐藏的元数据字段。让AI导出回归优雅——这句话说的是:导出不该是体力活,而应该是一次完整的、可预期的文件交付。注意:这里的“批量”指的是左侧列表里的多个独立会话,不是一条会话内的多轮对话。

laoyunsi的博客 227

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

河道漂浮物目标检测数据集

目标检测,yolo,河道漂浮物目标检测数据集

DL_data_set的博客 183

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

AI Agent之核心框架

A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试,反思作为 记忆,影响后续尝试的策略。工作流程:Action → Evaluation → Reflection → Retry。A: 普通 CoT 只在。

剑雨巍巍的博客 184

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

AI 应用开发工程师技术实践:大模型接入、通用组件封装与性能优化

本文提出AI应用从PoC到生产的核心挑战:模型调用的持续可用、可控与可优化。通过构建统一LLM网关实现多供应商路由与故障转移,封装对话、工具调用与RAG组件以解耦业务逻辑,结合前缀缓存、批处理与流式背压治理等性能优化手段,形成“接通→接稳→接快”的工程路径,最终以工程化能力决定AI应用的生产可用性。

2301_79189962的博客 534

大模型 Embedding 与向量相似度详解

Embedding 解决的问题:计算机不懂文字,但懂数字│▼文本 → 向量(1024维浮点数数组)│▼相似度解决的问题:怎么判断两个向量(文本)有多接近│▼余弦相似度:看向量方向的夹角,越接近0°越相似│▼最终效果:语义搜索——理解意思,而非字面匹配一句话总结:Embedding 把文字变成数字,余弦相似度比较数字的方向,两者结合实现了"理解语义"的搜索。

T3165919332的博客 71

AI前沿日报 · 2026-11-04 | 祛魅时刻:Astra“纯读权重“神话的崩塌

①Astra"裸权重通吃"被spaCy创始人Honnibal精准祛魅——仅1/3实验真裸读,数学能力提升依赖Python+50次迭代;②Simon Willison用Qwen 3.8-27B端侧复现权重空间编程;③Nvidia开源Auto-Ontology自动知识图谱;④$800开源全域抓取机器人Stringman;⑤OpenAI悄然重开Codex训练开关引信任危机;⑥DeepMind发布Gemini 4 Argon机器人基础模型;⑦美国科技巨头隐性AI债务达3.2万亿美元,6个月增90%。

johnsong2009的博客 515

GPT-1 架构和计算细节

下面配合框图,对 GPT-1 的每个组件做公式展开 + 数值实例(配置:12 层 × 768,12 头,FFN 3072,词表 40478,共 117M 参数)。GPT-1 把翻译模型的编码器-解码器砍掉一半,只留解码器,然后以"预测下一个词"为目标在 BooksCorpus 上预训练。与 2017 原版的四个架构差异(框图中标 ★):h0=E[token]+Epos[position],E∈R40478×768, Epos∈R512×768h^0 = E[\text{token}] + E_{pos}[\

eloudy的专栏 243

终端 AI 审计与 “龙虾” 类智能体风险治理:从可见性到闭环溯源

生成式 AI 办公普及之后,数据泄露风险逐步下沉到终端。员工将合同、源代码、客户资料粘贴至公有大模型,以及龙虾(OpenClaw)这类本地开源 AI 智能体的滥用,成为企业安全新挑战。传统网络边界防护存在审计盲区,本文从风险链路拆解、核心能力模型、分级治理策略、落地踩坑点以及技术局限性多角度,分享终端侧 AI 安全治理的实践思路。

2401_86491085的博客 621

2.53 基于极稀疏指纹的室内定位注意力图元学习

该论文发表于IEEE Transactions on Mobile Computing(TMC)2026年6月,面向极稀疏指纹条件下的WiFi室内定位,针对指纹采集人力成本高、标记指纹稀缺时定位精度大幅下降的痛点,提出注意力图元学习模型AGML(Attentional Graph Meta‑Learning),结合图神经网络、元学习、两种指纹数据增强与分布对齐技术,在标记指纹极少的场景实现高精度室内定位,同时公开了多套真实+仿真定位数据集用于基准测试。场景:二维室内空间,障碍物造成信号遮挡,

weixin_42963026的博客 319

语音识别与语音合成的技术原理及应用

语音识别 #语音合成 #人工智能 #大模型。语音识别与语音合成的技术原理及应用。一、语音识别的核心原理。二、语音合成的核心原理。三、工程落地的主要难点。五、需要关注的现实问题。

weixin_62919816的博客 188

设计师工作室 GEO 实操:如何提升 AI 实体推荐概率

设计工作室 GEO 的本质,是把创意服务转化为 AI 可理解的结构化信息。核心动作可归纳为:区分事实与审美、建立实体图谱、预判用户提问、输出脱敏内容、搭建多信源、持续测试验证。梳理工作室的 6 个实体属性:品类、城市、流程、边界、团队、渠道。在官网或作品集平台发布至少 3 篇结构化项目复盘,只陈述事实。输出 1 篇「设计报价影响因素」科普内容,覆盖甲方高频提问。争取 1 次行业媒体或本地媒体专访,形成第三方信源。每周用「XX 城市 + 品类 + 设计工作室推荐」指令测试,记录出现频率。

goujunwe的博客 321

AI作图软件技术选型:从4个技术维度出发的实测对比

AI作图软件技术选型:从4个技术维度出发的实测对比

Vbaoke的博客 196

深入理解 Transformer:Decoder 与 Masked Attention 速查手册

写Decoder时直接套用Encoder自注意力代码,训练loss秒降、推理却不会生成?😵 这份速查手册按“症状→诊断→改法→代价→边界”组织,30秒帮你定位masked_fill、tril、causal_mask的正确写法,附可跑代码与对照表,让你彻底搞懂“为什么不能看到未来”。🔧

2601_94912102的博客 245
上一篇: 超实用!MinerU新增3个新功能,支持文档逐块修正
下一篇: 『面向AGI4S,构建下一代数据基础设施』上海AI实验室青年科学家入选第五届“上海科技青年35人引领计划”
OpenDataLab
博客等级 码龄4年 636粉丝 135原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值