教程 | 给大模型插上小语种“翅膀”,附ms-swift韩语继续预训练与指令微调教程

SWIFT - 轻量级微调模型框架 [魔搭] 🍲 ms-swift是魔搭社区提供的大模型与多模态大模型微调部署框架,现已支持450+大模型与150+多模态大模型的训练(预训练、微调、人类对齐)、推理、评测、量化与部署。其中大模型包括:Qwen2.5、InternLM3、GLM4、Llama3.3、Mistral、DeepSeek-R1、Yi1.5、TeleChat2、Baichuan2、Gemma2等模型; 阅读详情

推荐语

3月22日,上海人工智能实验室发布了全新升级的“万卷·丝路2.0”多语言多模态语料库,在阿语、俄语、韩语、越南语、泰语5个语种基础上,新增塞尔维亚语、匈牙利语、捷克语3个稀缺语料数据,涵盖四大数据模态共计1,150万条数据。

实践证明,在小语种场景下,利用“万卷·丝路”语料库对通用大模型进行微调,使轻量化模型在多语言处理领域展现出超越大模型的卓越表现。本文将基于该语料库数据,分享来自魔搭社区的大模型继续预训练与指令微调详细教程,教你如何为AI插上更强的小语种能力的“翅膀”,欢迎大家动手实践。

数据集地址:https://www.modelscope.cn/organization/OpenDataLab

一键微调框架:https://github.com/modelscope/ms-swift

01 数据集介绍

“万卷·丝路2.0”具有多语言、大规模、多模态、高质量的特点:

1. 语种数量扩充:

在阿拉伯语、俄语、韩语、越南语、泰语5个语种基础上,新增塞尔维亚语、匈牙利语、捷克语等3个稀缺语料数据。

2. 数据模态、总量全面升级:

在纯文本数据基础上,新增图片-文本、音频-文本、视频-文本、特色指令微调SFT四大模态数据,覆盖多模态研究全链路;整体数据总量超过1150万条,音视频时长超过2.6万小时,满足多种研究任务的需求。

3. 超精细数据,多场景适用:

经成熟数据生产管线及安全加固,结合过滤算法与当地专家人工精细化地标注质检,“万卷·丝路2.0”  已成为覆盖多模态、多领域的大规模高质量数据集,含20余种细粒度多维分类标签及详细的文本描述,适配文化旅游、商业贸易、科技教育等不同场景,为开发者提供得力助手。

开源内容

图片-文本累计开源超过200W条; 音频-文本开源超过1600小时; 音频-文本开源超过2.5w小时; SFT数据开源18w条;

开源数据详情:

语种名称

图文模块数据量(张数)

音频模块时长(小时)

视频模块时长(小时)

SFT模块数据量

阿语

220,000

200

1738

23,000

俄语

250,000

212

3491

23,000

韩语

530,000

202

3412

23,000

越南语

450,000

205

2901

23,000

泰语

100,000

201

5684

23,000

塞尔维亚语

80,000

206

2578

23,000

匈牙利语

220,000

208

3470

23,000

捷克语

270,000

202

2453

23,000

02 数据集赋能大模型性能跃迁

经严格评测验证,“万卷·丝路”展现出显著的模型赋能效应:基于7B参数基础模型训练,实现综合性能跃升52.3%;在700亿参数的大模型训练中,仍保持12.8%的性能增益。值得注意的是,依托“万卷·丝路”,使轻量化模型在多语言处理领域展现出超越大模型的卓越表现。
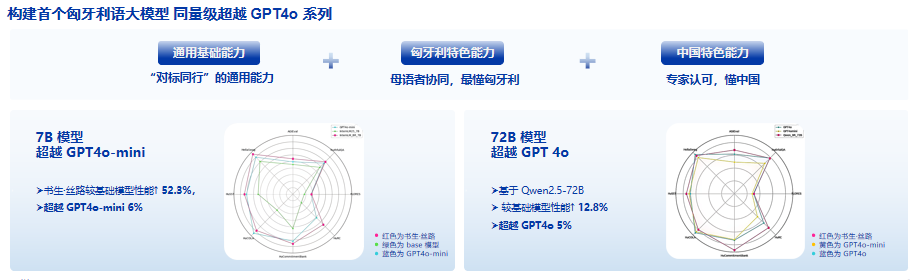
图片

03 韩语数据集继续预训练与指令微调实践

以下是以“万卷·丝路”韩语数据为代表,进行大模型继续预训练与指令微调实践教程,欢迎大家实践与复现:

● 模型准备:Llama-3.1-8B-Instruct

● 数据准备:从“万卷·丝路”多语言多模态语料库抽取部分韩语纯文本预训练数据(OpenDataLab/WanJuan-Korean)、18w条韩语指令微调数据(OpenDataLab/WanJuanSiLu2_sft_ko)

● 训练框架:ms-swift、Megatron-SWIFT;(使用Megatron-SWIFT和ms-swift分别对OpenDataLab/WanJuan-Korean和OpenDataLab/WanJuanSiLu2_sft_ko进行继续预训练和指令微调)

训练框架介绍:

ms-swift是魔搭社区官方提供的大模型与多模态大模型训练部署框架。

ms-swift开源地址:

https://github.com/modelscope/ms-swift

Megatron-SWIFT在ms-swift的基础上

引入了Megatron的并行技术来加速大模型的训练,包括数据并行、张量并行、流水线并行、序列并行,上下文并行,具有更快的训练速度。

Megatron-SWIFT文档查看:

https://swift.readthedocs.io/zh-cn/latest/Instruction/Megatron-SWIFT训练.html

● 操作步骤:

环境准备

在开始微调之前,请确保您的环境已准备妥当。

git clone https://github.com/modelscope/ms-swift.gitcd ms-swiftpip install -e .
a. 使用Megatron-SWIFT对OpenDataLab/WanJuan-Korean数据集进行继续预训练

首先,你需要额外安装Megatron-SWIFT依赖:

pip install pybind11
# transformer_engine
# 若出现安装错误,可以参考该issue解决: https://github.com/modelscope/ms-swift/issues/3793
pip install git+https://github.com/NVIDIA/TransformerEngine.git@stable
# apex
git clone https://github.com/NVIDIA/apex
cd apex
pip install -v --disable-pip-version-check --no-cache-dir --no-build-isolation --config-settings "--build-option=--cpp_ext" --config-settings "--build-option=--cuda_ext" ./

当然你也可以直接使用镜像:

modelscope-registry.us-west-1.cr.aliyuncs.com/modelscope-repo/modelscope:ubuntu22.04-cuda12.4.0-py311-torch2.5.1-modelscope1.25.0-swift3.2.2

由于数据集很大,这里只下载部分数据集进行训练。

# 下载数据集
mkdir my_dataset
cd my_dataset
wget "https://www.modelscope.cn/datasets/OpenDataLab/WanJuan-Korean/resolve/master/raw/culture/common_crawl/part-677f75d865d8-000260.jsonl.gz"
cd ..

(关于HF权重格式与mcore格式转换,参考Megatron-SWIFT文档:https://swift.readthedocs.io/zh-cn/latest/Instruction/Megatron-SWIFT%E8%AE%AD%E7%BB%83.html)

Megatron-SWIFT训练脚本如下(更快的训练速度):

NPROC_PER_NODE=4 \
CUDA_VISIBLE_DEVICES=0,1,2,3 \
megatron pt \
    --load Qwen2.5-7B-mcore \
    --dataset './my_dataset' \
    --tensor_model_parallel_size 4 \
    --micro_batch_size 1 \
    --global_batch_size 8 \
    --packing true \
    --recompute_granularity selective \
    --train_iters 10000 \
    --eval_iters 50 \
    --finetune true \
    --cross_entropy_loss_fusion true \
    --lr 1e-5 \
    --streaming true \
    --lr_warmup_iters 100 \
    --min_lr 1e-6 \
    --save megatron_output/Qwen2.5-7B \
    --eval_interval 500 \
    --save_interval 500 \
    --max_length 8192 \
    --num_workers 8 \
    --dataset_num_proc 8 \
    --no_save_optim true \
    --no_save_rng true \
    --sequence_parallel true \
    --use_flash_attn true

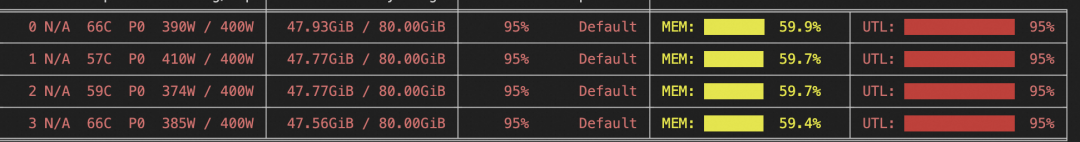
​​​训练显存资源:

图片

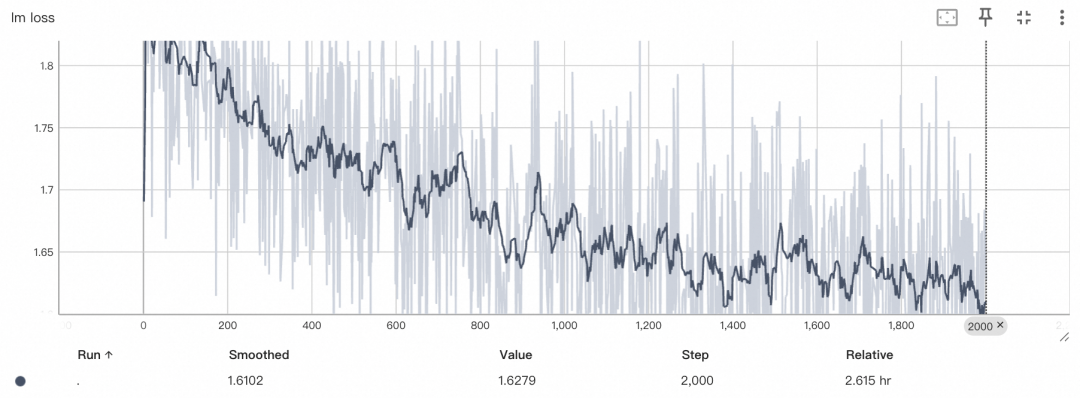
训练loss曲线:

图片

b. 使用ms-swift对OpenDataLab/WanJuanSiLu2_sft_ko数据集进行指令微调
效果评估

目前主流的大语言模型大多具备多语言能力,在多种不同语言上都展现出了强大的生成能力。目前评估多语言任务效果的数据集有以下几个:

  • Belebele数据集:仅关注多项选择形式的阅读理解。

  • BenchMAX数据集:关注大模型的核心性能,这些能力包括但不限于指令遵循能力、推理能力、长文本理解能力、代码生成能力、工具使用能力以及翻译能力。

BenchMAX是一个包含多语言,覆盖多种重要任务和17种多样化的语言的评测基准。对于每个能力,BenchMAX包含了一至两个不同的测试集,并且绝大多数测试集都经过母语使用者的标注,保证了数据集的高质量。

论文地址:https://arxiv.org/pdf/2502.07346

数据集地址:https://github.com/CONE-MT/BenchMAX

评测结果显示,通过上述继续预训练与指令微调后的模型在韩语阅读理解任务指标提升2个点,说明模型在多语言方面能力得到了改进、提升。

研究员也结合热门使用场景,给出更多应用建议:后续可以增加商贸领域的韩语SFT数据,扩增商品场景的韩语视觉-文本SFT数据提升,以适配更多出海、跨语言商贸合作等场景。


以上就是本次教程分享,诚邀您扫码提交“万卷·丝路”数据集使用反馈。您的建议将支持“万卷·丝路”多语言多模态语料库成为更质量的AI基础设施,助力全球开发者构建跨语言智能工具与应用,以人工智能赋能高质量共建“一带一路”。

“万卷·丝路”开发者使用反馈https://www.wjx.cn/vm/hAxkUG0.aspx

ms-swift+llamacpp+ollama微调部署MiniCPM-V教程 介绍了如何使用ms-swift对minicpm-v进行微调,并且使用llama.cpp进行量化,ollama部署及调用 阅读详情

相关推荐

MATLAB信号处理实战:VMD分解参数调优全指南(附避坑技巧)

本文深入探讨了MATLAB中变分模态分解(VMD)的核心参数调优实战技巧。针对模态数K和惩罚系数α的选择难题,提供了从经验估计、可视化观察到量化指标辅助的渐进式调优框架,并分享了避免过分解与欠分解的实用避坑指南,旨在帮助工程师高效处理非平稳信号,提取清晰的物理特征。

weixin_29079671的博客 144

AI大模型ms-swift框架实战指南(八):Qwen2.5-7B高效微调实践指南

在当今人工智能技术飞速发展的时代,大模型的应用日益广泛。基于 MS-Swift 框架的大模型应用开发为开发者提供了强大的工具和平台,其中微调环节更是解锁模型潜能、实现精准适配特定任务的关键步骤。本篇经过深度润色的实战指南将带您深入了解大模型微调的各个环节,从环境准备到最终的 Web-UI 推理微调,为您提供详尽且实用的操作指导。通过这一全面的大模型微调实战指南,结合 MS-Swift 框架的强大功能,您已手握开启模型潜能的钥匙。

寻道AI,探索AI无限可能! 5103

西门子博图编程:使用S7-1500冗余PLC 建立ModbusTCP通信

文章目录1.1 网络结构1.2 系统 IP 介绍1.3 Modbus TCP 通讯编程1.3.1 CPU 做服务器 1.1 网络结构 以 CPU151 7H 为例, 网络结构示意如下图所示: CPU 1517H 冗余 PLC 有 PROFINET X1 接口和 X2 接口, Modbus TCP 通讯可以将设备(例如 Standard PLC)通过交换机接入到任何网络接口中。如果接入 X1 接口,需要通过交换机接入到 MRP 环网中,但是并不需要支持 H-sync 转发。如果接入 X2 接口,只需要使

2万+

大模型管理工具:SWIFT

SWIFT(Scalable lightWeight Infrastructure for Fine-Tuning)是魔搭ModelScope开源社区推出的一套完整的轻量级训练、推理、评估和部署工具,支持200+大模型、15+多模态大模型以及10+轻量化Tuners,让AI爱好者能够使用自己的消费级显卡玩转大模型和AIGC。

m0_37559973的博客 8932

JAVA审批流程,一个简单表结构设计方案By OU

一、表结构设计1.流程表(process)用于存储审批流程的基本信息。字段名类型描述idBIGINT主键,流程IDname流程名称TEXT流程描述DATETIME创建时间DATETIME更新时间statusTINYINT(1)流程状态(0: 停用, 1: 启用)2.节点表(process_node)用于管理流程中的每个审批节点。字段名类型描述idBIGINT主键,节点IDprocess_idBIGINT流程ID,外键关联process.id。

1901

【图形学】后处理下的HDR、颜色分级、颜色映射与颜色空间

目录 一、Color Grading 1.1概念 1.2 内置在Unity/UE4 二、HDR、LDR与VDR 2.1 LDR 2.2 HDR 2.3 VDR 三、Tone Mapping 3.1 概念 3.2 算法发展史 3.3 ACES算法 四、常见的颜色空间标准 参考 一、Color Grading 1.1概念 Color Grading(颜色分级、颜色校正)俗称调色,是游戏后期处理中最常见也是必要的一个环节。它能够改变或矫正最终图像的颜色和亮度,你可以把它想象...

ColorGalaxy 8419

AI大模型ms-swift框架实战指南(二):开发入门之环境准备

通过以上对准备工作的详细介绍、基本概念的理解以及快速上手示例的实践,您应该对swift框架的开发入门有了初步的认识和掌握。这仅仅是一个开始,在后续的开发过程中,swift框架还有更多强大的高级功能等待您去探索,如更复杂的多模态训练、分布式训练等。同时,您可以将swift框架应用到更多的实际场景中,不断优化和扩展您的模型和应用,为解决实际问题提供更高效、更智能的解决方案。希望您在swift框架的开发之旅中,不断创新,取得丰硕的成果。AI大模型提示工程完全指南AI大模型探索之路(零基础入门)

寻道AI,探索AI无限可能! 2948

财务数智化——解读224页 2025年数智技术业财融合应用蓝皮书【附全文阅读】

《数智技术赋能业财融合蓝皮书》面向企业管理者及数字化转型从业者,系统阐述数智技术在业财融合中的应用。全书围绕技术基础(定义、分类、发展趋势)、融合框架(三阶段路径与三层价值)、七大行业应用场景(涵盖核算自动化、智能收款、项目管控等)、关键技术(AI、大数据等)及实施要点(组织协同、数据治理等),通过典型案例为企业提供从技术到实践的全面指导,助力实现数据贯通与价值创造。

cdfunlove的博客 1747

从零训练大模型教程

在这篇文章中,我们将尽可能详细地梳理一个完整的 LLM 训练流程。包括模型预训练(Pretrain)、Tokenizer 训练、指令微调(Instruction Tuning)等环节。

2401_84206094的博客 1180

STM32F103RCT6的FLASH读写操作

STM32F103RCT6是一款常用的32位微控制器,它具有内置的FLASH存储器,可以用于存储程序代码和数据。在本文中,我们将详细介绍如何进行STM32F103RCT6的FLASH读写操作,并提供相应的源代码。写入数据时,我们通过将数据直接写入FLASH地址来完成。通过使用适当的API和规则,我们可以有效地读取和写入数据。写入FLASH时,我们需要按特定的规则进行编程。首先,我们需要包含适当的头文件和定义相关的宏和变量,以便在代码中使用FLASH API。类型的指针,我们可以直接读取FLASH中的数据。

UplKubernetes的博客 1034

39-Halcon-- fit_primitives_object_model_3d函数功能(从3D数据中提取几何基元)

Halcon算子fit_primitives_object_model_3d工业应用精要 该算子专为3D几何特征提取设计,支持平面、球体、圆柱等基元拟合。核心优势: 参数化输出:返回几何元素的数学参数(如平面方程、球心半径) 智能控制:通过max_dist、min_size等参数调节拟合精度 工业场景适配:针对薄壁件、孔系等提供专用优化方案 典型应用流程: 数据预处理(点云降噪/采样) 基元类型与参数设置 多阶段拟合(先平面后圆柱) 几何精度验证 误差控制在0.1%-1.2%范围内(视点云密度而定),适用于

weixin_45590420的博客 1161

使用 ollama 部署本地模型,零基础入门到精通,非常详细收藏我这一篇就够了

在本地启动并运行大型语言模型。运行Llama 2,Code Llama和其他模型。自定义并创建您自己的。

m0_65555479的博客 3733

RT-DETR改进策略【卷积层】| CVPR2025 GBConv轻量门控瓶颈卷积 低秩瓶颈降参 + 门控聚焦形态,强效捕捉纤细目标

裂缝形态不规则、纹理纤细,传统卷积参数大、计算冗余,且无法动态聚焦裂缝形态;背景噪声强易干扰特征提取,需要轻量且能自适应聚焦裂缝形态的卷积单元,因此提出轻量门控瓶颈卷积 GBC。

Limiiiing的博客 140

【LLM】基于ms-Swift大模型SFT和RL的训练实践

Swift框架MoE训练 并行技术选择: Megatron-SWIFT的并行技术采用zero1(默认开启use_distributed_optimizer)+各种并行技术的组合。 DP的速度最快,但显存占用较多,使用其他并行技术以降低显存占用。 TP/EP通信量较大,尽量不跨节点(NVLink域内),跨节点建议使用PP/DP;专家层建议使用EP而不是ETP,ETP更节约显存,但速度较慢。 MoE 并行折叠:MoE 相关的并行组与 Dense 组分离。Attention使用 tp-cp-dp-pp 组,MoE

发现问题,并解决问题,批判性思维 3395

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

ms-swift微调教程

转 gguf / turbomind 等格式部署(视情况选择)。LoRA Rank 一般 32/64 起步,结合资源调整。控制单图分辨率上限,别设太大容易炸显存。微调后权重合并:swift export。数据集可用 JSONL,一行一个样本。会自动识别视觉编码器。

u012374012的专栏 833

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

【大模型理论篇】SWIFT: 可扩展轻量级的大模型微调基础设施

大模型、多模态、微调框架、训练框架、后处理框架、评估、多模态训练、swift、msswift

源泉的小广场 2052

持续更新 | 大模型与多模态训练部署利器:魔搭社区ms-swift框架完全指南

这篇博文主要围绕 SWIFT(Scalable lightWeight Infrastructure for Fine-Tuning)展开。它欢迎各类贡献,如 Feature PR、Bug 反馈等。博文中介绍了丰富的数据集,包括多种 VCR、MMBench 等相关数据集,还给出了数据集具体介绍的查看链接。同时,提供了中英文文档、论文链接等资源,方便用户了解。另外,还有关于许可的说明,框架使用 Apache License (Version 2.0) 进行许可,模型和数据集需查看原资源页面遵守对应 Licen

MnivL的博客 4293

AI大模型ms-swift框架实战指南(十二):模型量化效率提升指南

在人工智能模型的优化过程中,模型量化是一项关键技术,它能够在不显著降低模型性能的前提下,有效地减少模型的存储需求和计算量,从而提高模型的推理效率。本文将深入解读MS-Swift模型量化相关内容,包括支持的量化技术、环境准备、量化命令以及注意事项等,旨在帮助读者全面理解并掌握MS-Swift模型量化的核心要点与操作方法。MS-Swift提供了多种强大的量化技术,以满足不同场景下的模型优化需求。

寻道AI,探索AI无限可能! 2539

ms-swift预训练实战:中文C4数据集全流程演示

本文介绍了基于星图GPU平台,如何自动化部署ms-swift镜像并开展中文C4数据集的预训练实战。通过该平台可快速搭建高效训练环境,利用ms-swift框架实现模型微调与优化,适用于大模型AI应用开发等场景,显著降低大模型训练门槛。

weixin_36483050的博客 934

ms-swift学习笔记

SWIFT的eval能力使用了魔搭社区评测框架EvalScope,并进行了高级封装以支持各类模型的评测需求。注意:EvalScope支持许多其他的复杂能力,例如模型的性能评测,请直接使用EvalScope框架。(1)选择题格式(MCQ)适合用户是选择题的场景,评测指标为准确率(accuracy)。数据准备准备选择题格式的csv文件,该目录结构如下:mcq/├── example_dev.csv # (可选)文件名组成为`{subset_name}_dev.csv`,用于fewshot评测。

hang on it more longer 3422

ms-swift保姆级教程:从安装到微调,小白也能轻松上手

本文介绍了如何在星图GPU平台上自动化部署ms-swift镜像,实现大模型微调功能。ms-swift作为魔搭社区的开源工具,简化了Qwen、Llama等主流大模型的微调流程,特别适合消费级显卡用户快速搭建AI训练环境,应用于智能对话系统、内容生成等场景。

weixin_42609225的博客 175

新手必看!ms-swift保姆级教程,轻松实现大模型微调

本文介绍了如何在星图GPU平台上自动化部署ms-swift镜像,快速实现大语言模型的高效微调。用户可通过图形化界面或命令行,轻松完成LoRA微调、DPO对齐等任务,并将微调后的模型一键部署为OpenAI兼容API,适用于智能客服、营销文案生成等典型业务场景。

weixin_29935511的博客 516

大模型微调神器ms-swift:国内镜像源配置指南,5分钟快速部署

本文介绍了如何在星图GPU平台上自动化部署ms-swift镜像,实现大模型微调的高效开发。通过配置国内镜像源,用户可快速完成ms-swift的安装和模型加载,显著提升Qwen、Llama等大模型的下载速度,适用于AI研究与开发场景。

weixin_26805451的博客 379

ms-swift全流程解析:训练→推理→评测→部署一站式搞定

本文介绍了基于星图GPU平台自动化部署ms-swift镜像的完整流程。该平台支持一键拉取并运行ms-swift环境,实现从模型微调、推理到评测与部署的全链路操作。典型应用场景包括使用LoRA对Qwen等大模型进行高效参数微调,并通过vLLM加速推理,快速构建AI对话服务。

weixin_29092787的博客 1187

Embedding模型微调实战(ms-swift框架)

ms-swift是魔搭社区提供的大模型与多模态大模型微调部署框架,现已支持500+大模型与200+多模态大模型的训练(预训练、微调、人类对齐)、推理、评测、量化与部署。

m0_58054476的博客 2210

【大模型实战】利用ms-swift微调框架对QwQ-32B推理模型进行微调

大模型、大模型微调、大模型微调框架、lora微调、推理模型微调、强化推理、qwq-32b、ms-swift、微调框架

源泉的小广场 4581
上一篇: MinerU 偷偷放大招!3大新功能上线、模型重磅升级,解析效率超级加倍……
下一篇: 2025 OpenDataLab&和鲸社区『大模型赋能科研 』分享会圆满落幕!
OpenDataLab
博客等级 码龄4年 636粉丝 135原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值