OmniAlign-V:多模态大模型人类偏好对齐新突破

Qwen3.7月度迭代:大模型Agent调度范式重构 大语言模型的工具调用与长上下文处理,正从外部解析、后处理拼接的松耦合模式,转向模型原生支持、协议驱动的紧耦合架构。这一演进背后是动态工具路由、硬件感知压缩、跨模态对齐等底层能力的工程化集成,其技术价值在于显著提升Agent工作流的鲁棒性、推理稳定性与部署一致性。典型应用场景包括本地化AI助手开发、企业级RAG系统构建、代码智能补全及多步骤自动化任务编排。Qwen3.7以28天极限迭代节奏落地,标志着国产大模型已进入‘调度即能力’的新阶段,核心热词‘tool calling’与‘MCP v2.1’正是这一范式 阅读详情

多模态大模型(MLLMs)在视觉、语言理解等领域展现出强大的能力,但如何让这些模型更好地对齐人类偏好,生成更符合人类认知习惯的内容,仍然是一个核心挑战。近日,上海人工智能实验室联合团队发布了最新研究成果 OmniAlign-V,针对这一问题提出了新的数据集和评测基准。

核心贡献

1.探索多模态训练对对齐能力的影响

探索了语言数据和多模态数据对多模态大语言模型的语言能力以及多模态客观/主观指标的影响,发现:

  • 高质量语言数据的加入并不能增强多模态模型的对齐能力,还会降低通用视觉问答(General VQA )任务上的性能。

2. 提出 OmniAlign-V-SFT 数据集

  • 包含 205k 开放式问题,涵盖知识性、创造性问题,并提供完备的长输出回答。覆盖自然图像和信息图像在内的九种任务。

  • 通过精心设计的 Prompt Pipeline 确保问题质量和多样性。采用 GPT-4o 生成数据,结合多步后处理,提升数据质量。

  • 实验表明,在 LLaVA-Next 框架下,OmniAlign-V-SFT 数据集能够大幅提升模型回复的完备性。同时,在 General VQA 任务(特别是 MMVet/MMMU)上模型效果提升显著。

3. 提出 OmniAlign-V-DPO 数据集

  • 基于 OmniAlign-V-SFT 数据集构建,可进一步提升模型主观能力,优化人类偏好对齐。

  • 经过实验验证,该数据集能够在大规模训练的 MLLMs(如 InternVL2-8B)上激发模型潜力,显著增强其对齐能力。

4. 提出 MM-AlignBench 评测基准

  • 专注于 MLLMs 人类偏好对齐能力评测

  • 包含 252 道人工筛选的开放式问题,确保数据多样性、准确性和合理性。

目前该项工作的论文、代码、SFT数据、DPO数据,Benchmark,Checkpoints、均已完全开源。

Paper:

[2502.18411] OmniAlign-V: Towards Enhanced Alignment of MLLMs with Human Preference

GitHub:

https://github.com/PhoenixZ810/OmniAlign-V

MM-AlignBench 现已在司南评测社区集上线,欢迎大家使用。

https://hub.opencompass.org.cn/dataset-detail/MM-AlignBench

MM-AlignBench 现已集成至多模态大模型开源评测工具 VLMEvalKit 中,欢迎大家使用。

https://github.com/open-compass/VLMEvalKit

探索实验

多模态训练是否影响语言能力?

研究团队对多个主流开源 MLLMs 在纯语言对齐基准(AlignBench/AlpacaEval2/ArenaHard) 上进行了测试,结果发现经过多模态训练的模型语言能力出现严重退化,这表明多模态数据训练可能削弱 LLM 本身的语言能力。
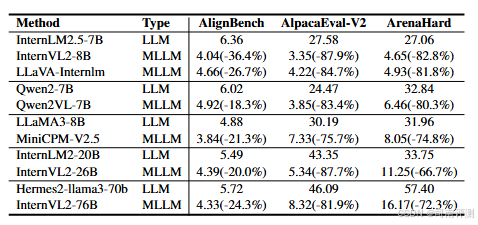
得分由 Qwen2.5-72B 进行 judge

语言数据能否改善多模态模型的对齐能力?

团队进一步实验,使用 LLaVA 框架,并用 InternLM2.5-7B 作为基础模型,采用 LLaVANext-780k 高质量数据,并替换其中的 ShareGPT 数据为更新的 Magpie-LLaMA3.3 和 Condor,在语言对齐基准(AlignBench/AlpacaEval2/ArenaHard)、多模态对齐基准(WildVision)以及 General VQA 基准(MMVet/MMBench/AI2D/OCRBench)上进行评测。

结果表明:

  • 加入了高质量的语言数据之后,模型在语言基准上的能力确实提升了,但是,无论是多模态主观对齐还是 General VQA 任务,都出现了性能下降的情况。

  • 语言数据对多模态对齐能力的影响是十分有限的,在 General VQA 任务以外,仍然需要带有开放式问题以及完备回答的多模态训练数据。
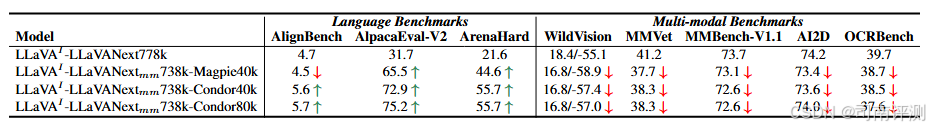
为了展示性能差异,此处 AlpacaEval2 和 Arenahard 的结果均与 GPT3.5 进行对比

OmniAlign-V 数据构建

OmniAlign-V-SFT 数据集

基于上述实验观察,研究团队认为,当前的多模态数据过于看重 VQA 任务的能力,因此数据面临答案过于简短、单一,缺少对预训练知识的运用与理解的问题。

再结合从纯语言数据组成中吸取的经验,研究团队提出多模态数据还应包含以下特点:

  1. 开放式,创造性,需要预训练知识的问题。

  2. 全面,完备,美观,符合指令跟随的回答。

基于以上原则,研究团队提出了 OmniAlign-V 数据构建 Pipeline,如下图所示:

Pipeline of OmniAlign-V

研究团队根据图片场景将图片分为自然图片(Natural)和信息图片(Infographic)两大类,为了得到包含丰富信息的数据,

首先,对自然图片进行了图像复杂度以及物体种类数目的两轮筛选,确保筛选出的图片具有丰富的语义信息。

其次,将自然图片分为 Knowledge/Creation/Inferential 三类任务,将信息图片分为 Chart/Diagram/Poster/Art 四类任务,对不同任务分别应用对应的精心设计的 Pipeline 以及 GPT-4o 生成的对话数据。

而后,再对 Knowledge/Inferential/Chart 分别应用不同的后处理优化,增强了 Inferencial 和 Chart 数据的完备性和准确性,并在 Knowledge 基础上额外添加了 Instruction-Following 指令,将其作为 Instruction-Following 任务。(具体的操作步骤可以参考论文)

最终,得到了 OmniAlign-V-SFT 数据集,包含了 205k 高质量的多模态数据。

OmniAlign-V-DPO 数据集

研究团队发现 OmniAlign-V-SFT 数据集的回答质量较高,非常适合作为 DPO 训练的 正样本(positive sample)。因此,团队对 LLaVANext-InternLM2.5-7B 模型输出应用 reject sampling,生成对应的 负样本(negative sample),由此构建 OmniAlign-V-DPO 数据集,用于进一步优化模型的主观对齐能力。

MM-AlignBench 对齐基准

另外,研究团队发现当前多模态模型对齐基准存在 图像质量低、问题模糊、任务多样性不足 等问题。因此提出 MM-AlignBench,作为专门评估 MLLMs 对齐能力的基准。

从经过预筛选的 3000+ 张图片中人工挑选了 252 张分布多样且高质量的图片,每张图片以及对应的问题都经过人工审查,确保图片和任务问题的多样性以及准确性、合理性。
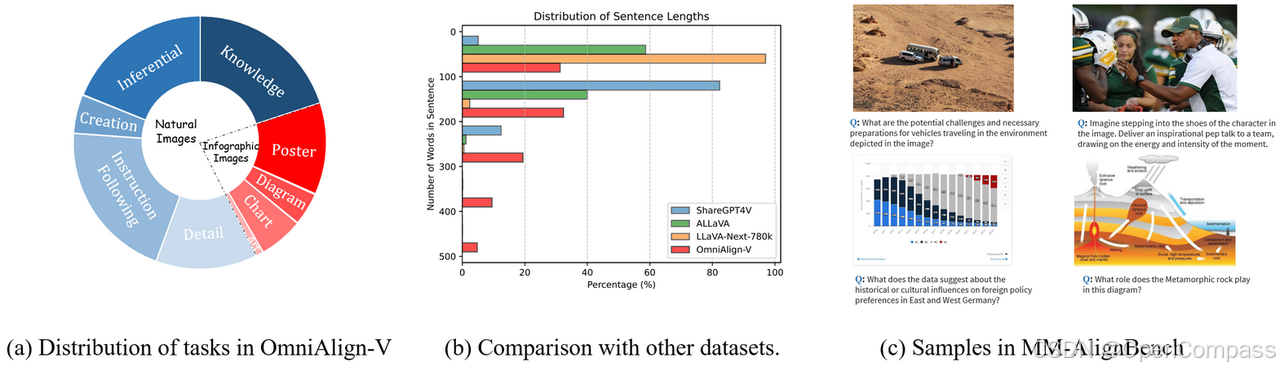
效果验证

SFT 训练带来的提升

研究团队在 LLaVA/LLaVA-Next 框架下,分别使用 InternLM2.5-7B/Qwen2.5-32B 进行实验,并在 3 个多模态对齐基准和 5 个主流 VQA 基准 上进行了评测。
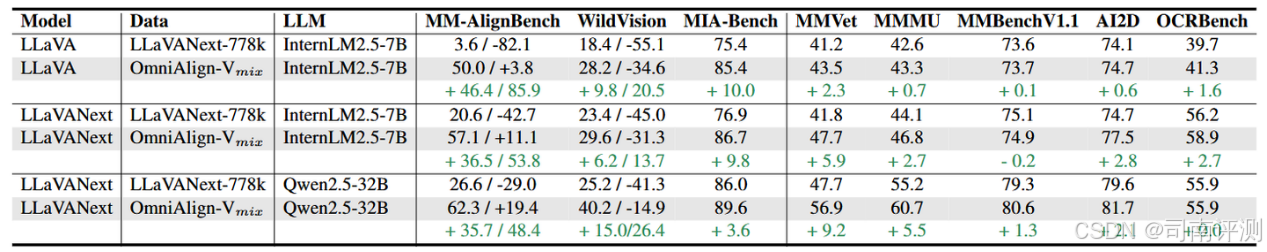
SFT 多模态评测结果

可以看出:

  • 在添加了 OmniAlign-V-SFT 数据集后,模型在 3 个多模态对齐基准上的表现均有大幅提升;

  • 在多个 General VQA Benchmark 上均有不同程度的涨点,尤其是在 MMVet 和 MMMU 上涨点十分显著;

  • LLaVANext-Qwen2.5-32B 在 MMVet 和 MMMU 上分别增加了 9.2 和 5.5!这有力验证了 OmniAlign-V 数据集的有效性。

  • 此外还发现,经过 OmniAlign-V-SFT 训练后,模型在语言对齐基准上也有一定程度的上涨,这也验证了,当添加部分高质量的多模态对齐数据后,能够有效减少 LLM 在多模态训练当中面临的语言能力退化问题。
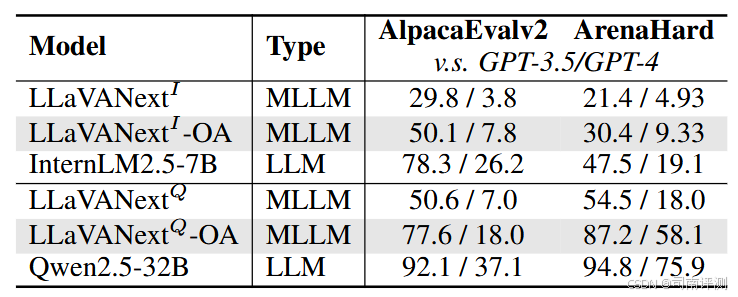
SFT 语言评测结果

DPO 训练的效果

此外,采用 OmniAlign-V-DPO 进行 DPO 训练后,模型的对齐能力进一步增强。

  • 对于未接受长上下文训练的模型,OmniAlign-V-DPO 影响较小;

  • 对于经过高质量长上下文训练的模型(如 InternVL2-8B),OmniAlign-V-DPO 能够显著提升对齐能力。
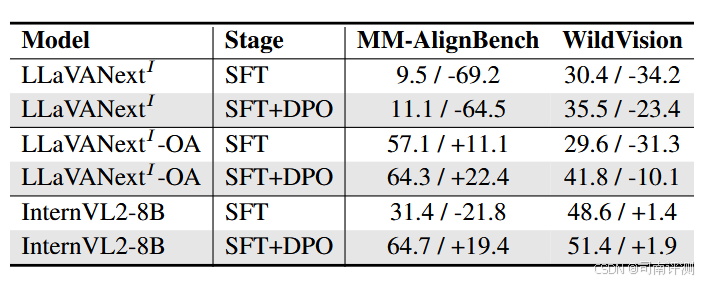
DPO 实验结果

MM-AlignBench 评测表现

研究团队测试了当前主流 MLLMs 在 MM-AlignBench 上的结果:
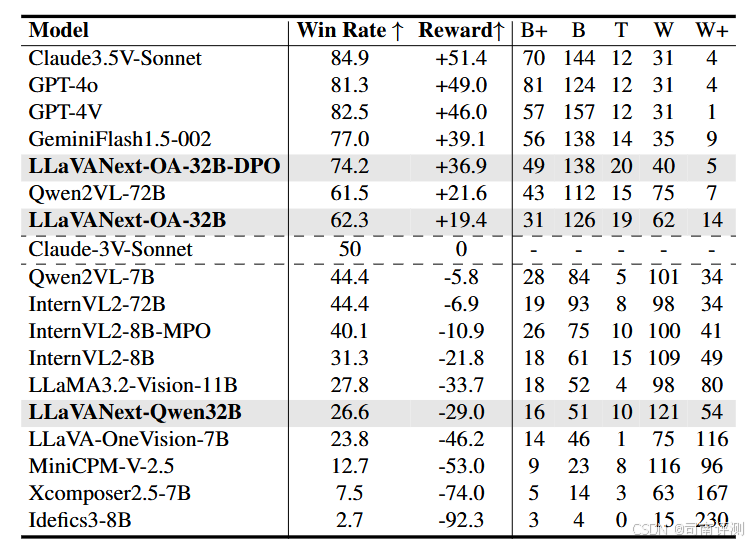
MM-AlignBench Leaderboard

  • 经过 SFT+DPO 训练后,LLaVANext-OA-32B-DPO 的对齐性能提升明显,在 MMAlignBench 上的性能已经超越了QwenVL2-72B。

  • 即使是 QwenVL2-72B 和 InternVL2-78B,在 MMAlignBench 上的表现距离闭源模型(GPT/Gemini/Claude Series)也有较大的差距。

MM-AlignBench 与其他基准的相关性分析

研究团队进一步对 MM-AlignBench 和其他 General VQA Benchmark 计算了相关度,SRCC score 如下所示:
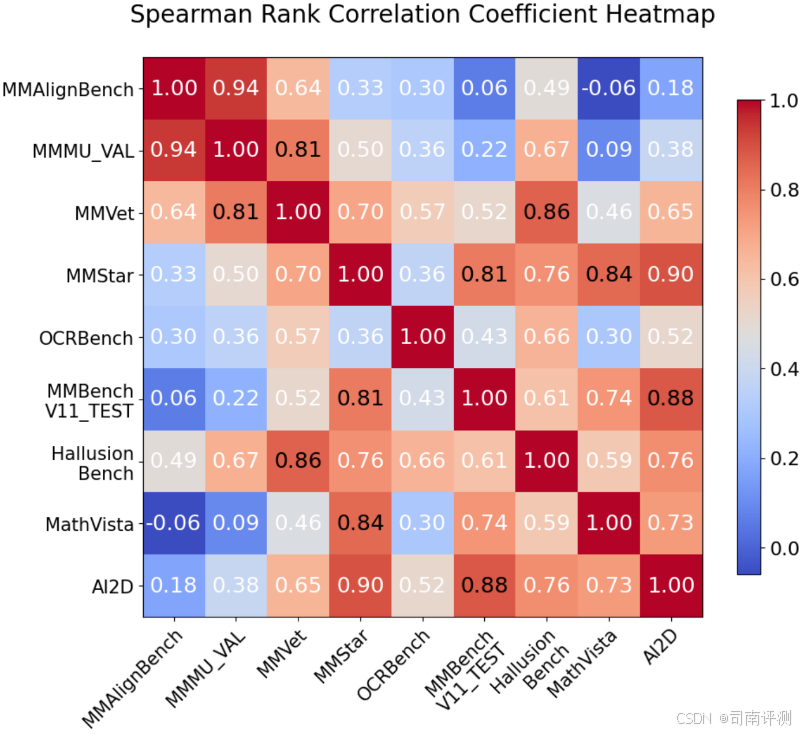
MM-AlignBench 与其他基准的相关性统计

  • MM-AlignBench 与现有多模态评测基准(如 MMBench、OCRBench)相关性较低,但 与 MMMU 表现出极高的相关性。

  • 作为一项涵盖大量跨学科任务的评测基准,MMMU 对模型的知识先验深度和广度提出了极高的要求。尽管 MMMU 采用选择题形式,答案具有唯一正确解,而 MM-AlignBench 则以开放式问答为主,两者的题型设计存在显著差异,但它们所考察的核心能力却高度相似。

  • 这一现象表明,MM-AlignBench 不仅覆盖了广泛的任务领域,还深入挖掘了模型在知识先验上的表现,进一步验证了其评测维度的全面性与挑战性。

上述对多模态大语言模型对齐能力的研究,也引起研究团队的思考:

究竟什么才是通向真正模态融合的正确路径?在多模态微调过程中,大语言模型往往会面临一个棘手的问题——语言能力的“灾难性遗忘”。然而,像GPT-4o 等闭源模型却能够成功实现文本与图像模态的深度融合,充分释放其庞大的预训练语言知识潜能。这背后的技术路线究竟是如何设计的?又是怎样做到如此高效且精准的模态融合的?

这些问题还待继续探索,希望本项工作能给大家带来些许启发。

欢迎大家与我探讨交流!邮箱地址:zxy2855064151@sjtu.edu.cn

【企业知识助手·Agent 实战】如何构建 Agent 运行态可观测体系:从行为基线漂移检测到成本预算治理的深度实战 核心原理:运行态可观测的本质是把"单点阈值"升级为"与基线的分布距离"——埋点回答发生了什么,基线比较回答这是否还正常关键结论:deny 率没有单向好坏语义,必须双边告警 + known-good / known-bad 双哨兵仲裁;成本归因的终点是单位经济与预算三线一位;评测分数入库让质量拥有趋势线。 阅读详情

相关推荐

《AI实战嵌入式Agent +MCP+skill》课时2.5|定时器实战

本课讲解定时器时基单元原理,通过PSC、ARR、CNT三寄存器配合实现精确周期控制。以84MHz时钟为例,计算得PSC=8399、ARR=9999可实现1秒溢出周期。采用HAL_TIM_Base_Start_IT启动定时器更新中断,在HAL_TIM_PeriodElapsedCallback中处理周期任务,实现非阻塞、高精度的定时。相比HAL_Delay的阻塞式延时,定时器中断方案不占用主循环,支持并发操作,是嵌入式系统中实现周期任务的高效方式。

现任某外企的算法工程师!专注于人工智能、嵌入式、FPGA、论文写作四大主题的教程和经验分享!辅导请➕v :sci666888999 137

【AI论文】OmniAlign-V:实现MLLM与人类偏好的增强对齐

OmniAlign-V是一个包含约20万个高质量训练样本的综合数据集,这些样本由多样化的图像、复杂的问题和多样化的回答格式组成。该数据集的目的是提高MLLMs与人类偏好的对齐程度。

m0_66899341的博客 1996

IMU数据处理避坑指南:从理论到实践的加速度计重力消除方案

本文详细解析了IMU数据处理中的重力消除技术,从理论基础到实践应用,涵盖了加速度计和陀螺仪的核心问题。通过ROS2实战案例,介绍了静态标定与动态校准的技术对比,以及多传感器融合的进阶策略,帮助开发者避免常见陷阱,提升IMU数据处理的精度和效率。

purple的博客 739

OmniAlign-V:提升多模态大语言模型与人类偏好对齐

OmniAlign-V:提升多模态大语言模型与人类偏好对齐 项目介绍 OmniAlign-V 是一个旨在提升多模态大语言模型(MLLMs)与人类偏好对齐的开源项目。项目包含了三个主要贡献:OmniAlign-V SFT 数据集、OmniAlign-V-DPO 数据集和 MM-AlignBench。这三个组件相互协作,共同推进多模态大语言模型在理解人类偏好方面的性能。 项目技术分析 OmniAlig...

gitblog_00192的博客 988

别再迷信Intel网卡了!用普通笔记本+TWINCAT3搭建EtherCAT主站的完整避坑实录

本文详细介绍了如何用普通笔记本和TWINCAT3搭建EtherCAT主站的完整避坑指南。通过破除必须使用Intel网卡的迷思,提供软件环境搭建、关键配置步骤、Wireshark抓包技巧及性能优化建议,帮助开发者低成本实现EtherCAT主站功能。

weixin_29305337的博客 702

一文搞懂深度学习:最全神经网络介绍

本文是深度学习系列文章的第二篇,我们将深入探讨各种类型的人工神经网络,探索它们独特的特性和应用。

2402_82802238的博客 2799

上海AI实验室突破:多模态AI实现人类价值观对齐

上海AI实验室突破:多模态AI实现人类价值观对齐

weixin_49122920的博客 509

matlab液体湿润模拟,【水文模型】01 三水源新安江模型

目录一、概述1.1 流域概况1.2 产流方式论证1.3 设计基本任务1.4 设计原始资料二、新安江模型2.1 流域划分2.2 产汇流计算2.2.1 蒸散发计算2.2.2 产流计算2.2.3 水源划分2.2.4 汇流计算2.3 模型参数2.3.1 参数物理意义2.3.2 参数率定结果2.4 模拟结果2.4.1 精度统计表2.4.2 计算与实测流量过程线比较三、精度统计与误差分析3.1 精度统计3.2...

weixin_34173656的博客 5326

6 款电商 AI 图片生成软件实测|国内 + 跨境卖家工具清单

电商 AI 作图工具已经从 "能不能用" 进入了 "好不好用" 的阶段。对于绝大多数卖家而言,现在的 AI 工具已经可以覆盖 60%-80% 的基础商品图需求,显著降低拍摄和设计成本。选择工具的核心逻辑不是 "哪款最强",而是 "哪款最适配你的品类、平台规模和团队能力"。垂直电商工具胜在工作流效率,通用生图工具强在创意上限,模板类工具赢在上手速度。建议根据自身业务阶段,搭配 1-2 款主力工具 + 1 款辅助工具,形成适合自己的视觉生产流程。

Mardi_Ladin的博客 274

ADS使用Smith圆图进行阻抗匹配

在处理RF系统的实际应用问题时,总会遇到一些非常困难的工作,对各部分级联电路的不同阻抗进行匹配就是其中之一。一般情况下,需要进行匹配的电路包括天线与低噪声放大器(LNA)之间的匹配、功率放大器输出(RFOUT)与天线之间的匹配、LNA/VCO输出与混频器输入之间的匹配。匹配的目的是为了保证信号或能量有效地从“信号源”传送到“负载”。 阻抗匹配(impedance matching) 信号源内阻与所接传输线的特性阻抗大小相等且相位相同,或传输线的特性阻抗与所接负载阻抗的大小相等且相位相同,分别称为传输线的输

红茶绿茶和奶茶的博客 3万+

学术类PPT制作总结

本文分享了科技类PPT的制作技巧,希望相关的信息能帮助到读者。

奇妙水果的技术博客,欢迎交流技术~ 2878

我用 GPUWorks 在 M1 Pro 上搭了个发票识别原型

公司里经常要看电子发票。我想先做个小原型:把 PDF 发给一个自己部署的图文模型,让它提取发票类型、日期、交易双方和金额,再把结果交给同事核对。这个原型不用先接财务系统,先看看从部署到调用要走多少步,模型返回的内容能不能帮上忙。

鸽芷咕的博客 1万+

思博伦Spirent TestCenter创建单播流uni-stream

Traffic Generator列表中会出现刚才创建的uni-stream,创建完成。通常测试情况下,主要对Ethenet II和IPv4 Header进行配置。(通常情况下,如果流配置比较规范,选择任意端口接收,也没问题。编辑uni-stream基本信息。配置本条流由STC哪个端口接收。

辗转反测的博客 1680

您您这可以把问小白的多个会话比如说。左侧的多个会话一次性导出吗?不是单条会话里面的多次会对话。AI导出鸭

第三层是格式编译层。这个决策背后的判断很清晰:一个批量导出工具的价值,不在于“试三次”,而在于你真正用它处理了几十份技术文档、访谈记录或课程讲义之后,它是否值得留在你的工作流里。问小白的会话列表通过分页接口加载,AI导出鸭 在页面运行时建立旁路监听,捕获每一次分页请求返回的完整对话清单,包括会话 ID、标题、时间戳和隐藏的元数据字段。让AI导出回归优雅——这句话说的是:导出不该是体力活,而应该是一次完整的、可预期的文件交付。注意:这里的“批量”指的是左侧列表里的多个独立会话,不是一条会话内的多轮对话。

laoyunsi的博客 217

【stm32+K210项目】基于K210与STM32协同工作的智能垃圾分类系统设计与实现(完整工程资料源码)

本系统采用SG90舵机Maix Bit摄像头STM32C8T6主控板以及LX_TRIG_MP3_V6.0语音播报模块,构建了一套高效的智能垃圾分类系统,综合运用了图像识别、语音播报及精准控制技术。SG90舵机负责控制垃圾桶的开盖操作。该舵机通过接收PWM信号来实现转动,内部有一个基准电路产生周期为20ms的PWM信号,通过外部脉冲信号的控制(高电平时间在0.5ms至2.5ms之间),使得舵机的输出轴转动到指定位置。舵机内的位置反馈电位计。

嵌入式技术开发 5097

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

医疗 AI 有两种,别混着谈:一个改流程,一个改范式

InfoXMed 是面向医生、医学生和医学科研人员的 AI 医学工具平台,提供文献检索、全文翻译、AI 解读、指南查询和题库练习等功能,辅助临床学习、科研汇报与医学备考。原文是日本医学会杂志(JMA Journal)的一篇综述(Review Article):基本事实:这一点必须先说清:这篇论文提出的是一个研究纲领。它文中的"预测"指的是科学设想,不是可以拿来用的临床预测能力。文中甚至自己承认了一个硬缺口(见第三节)。本文只谈它的术语辨析与科学方法论,不转述任何可作为临床依据的预测或处置主张。这篇论文的全部

2601_96948740的博客 190

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

在Codex 让AI模型 拥有长期智能记忆

本文介绍Claude-Mem V15新功能——智能记忆召回,解决AI遗忘、重复提示、执行不一致等问题。通过本地部署claude-mem,实现自动记录决策(如数据库选型)、跨会话智能召回,支持记忆写入、检索、遗忘全流程闭环。相比传统记忆方案,其基于Hooks自动捕获工具调用,结构化存储,可追溯、可共享、可清理,显著提升工程效率与协作一致性,是长期项目中理想的“工作黑匣子”与“工程脑”。

米莱虾 249

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

河道漂浮物目标检测数据集

目标检测,yolo,河道漂浮物目标检测数据集

DL_data_set的博客 170

AI 应用开发工程师技术实践:大模型接入、通用组件封装与性能优化

本文提出AI应用从PoC到生产的核心挑战:模型调用的持续可用、可控与可优化。通过构建统一LLM网关实现多供应商路由与故障转移,封装对话、工具调用与RAG组件以解耦业务逻辑,结合前缀缓存、批处理与流式背压治理等性能优化手段,形成“接通→接稳→接快”的工程路径,最终以工程化能力决定AI应用的生产可用性。

2301_79189962的博客 474

大模型 Embedding 与向量相似度详解

Embedding 解决的问题:计算机不懂文字,但懂数字│▼文本 → 向量(1024维浮点数数组)│▼相似度解决的问题:怎么判断两个向量(文本)有多接近│▼余弦相似度:看向量方向的夹角,越接近0°越相似│▼最终效果:语义搜索——理解意思,而非字面匹配一句话总结:Embedding 把文字变成数字,余弦相似度比较数字的方向,两者结合实现了"理解语义"的搜索。

T3165919332的博客 64

AI前沿日报 · 2026-11-04 | 祛魅时刻:Astra“纯读权重“神话的崩塌

①Astra"裸权重通吃"被spaCy创始人Honnibal精准祛魅——仅1/3实验真裸读,数学能力提升依赖Python+50次迭代;②Simon Willison用Qwen 3.8-27B端侧复现权重空间编程;③Nvidia开源Auto-Ontology自动知识图谱;④$800开源全域抓取机器人Stringman;⑤OpenAI悄然重开Codex训练开关引信任危机;⑥DeepMind发布Gemini 4 Argon机器人基础模型;⑦美国科技巨头隐性AI债务达3.2万亿美元,6个月增90%。

johnsong2009的博客 496

GPT-1 架构和计算细节

下面配合框图,对 GPT-1 的每个组件做公式展开 + 数值实例(配置:12 层 × 768,12 头,FFN 3072,词表 40478,共 117M 参数)。GPT-1 把翻译模型的编码器-解码器砍掉一半,只留解码器,然后以"预测下一个词"为目标在 BooksCorpus 上预训练。与 2017 原版的四个架构差异(框图中标 ★):h0=E[token]+Epos[position],E∈R40478×768, Epos∈R512×768h^0 = E[\text{token}] + E_{pos}[\

eloudy的专栏 227

终端 AI 审计与 “龙虾” 类智能体风险治理:从可见性到闭环溯源

生成式 AI 办公普及之后,数据泄露风险逐步下沉到终端。员工将合同、源代码、客户资料粘贴至公有大模型,以及龙虾(OpenClaw)这类本地开源 AI 智能体的滥用,成为企业安全新挑战。传统网络边界防护存在审计盲区,本文从风险链路拆解、核心能力模型、分级治理策略、落地踩坑点以及技术局限性多角度,分享终端侧 AI 安全治理的实践思路。

2401_86491085的博客 590

2.53 基于极稀疏指纹的室内定位注意力图元学习

该论文发表于IEEE Transactions on Mobile Computing(TMC)2026年6月,面向极稀疏指纹条件下的WiFi室内定位,针对指纹采集人力成本高、标记指纹稀缺时定位精度大幅下降的痛点,提出注意力图元学习模型AGML(Attentional Graph Meta‑Learning),结合图神经网络、元学习、两种指纹数据增强与分布对齐技术,在标记指纹极少的场景实现高精度室内定位,同时公开了多套真实+仿真定位数据集用于基准测试。场景:二维室内空间,障碍物造成信号遮挡,

weixin_42963026的博客 310

语音识别与语音合成的技术原理及应用

语音识别 #语音合成 #人工智能 #大模型。语音识别与语音合成的技术原理及应用。一、语音识别的核心原理。二、语音合成的核心原理。三、工程落地的主要难点。五、需要关注的现实问题。

weixin_62919816的博客 171

视觉推理是在看图,还是依赖语言先验猜答案?

问一张香蕉照片“它是什么颜色”,回答黄色可能来自看图,也可能来自常识。把香蕉换成红色,错误才显露出来;但答错仍可能是没看清颜色、没理解问题,或没有把看到的属性用于回答。**总正确率不能独自区分这些解释。**封面中的红色香蕉只是概念插画,不是论文测试样本。

weixin_44369324的博客 138
上一篇: 土木工程领域大模型哪家强?六大维度全面评测!
下一篇: 司南评测集社区 3 月上新一览!
司南评测
博客等级 码龄2年 535粉丝 113原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值