16元推理成本,DeepSeek动了谁的蛋糕?

DeepSeek-R1与GPT-4 Turbo技术解剖:架构、推理与落地差异 大模型选型不能只看参数或benchmark,而需深入理解其底层架构设计与系统级实现。混合专家(MoE)路由机制、KV Cache管理策略、位置编码扩展方式等核心工程决策,直接决定长文本处理稳定性、工具调用可靠性及私有化部署可行性。例如,DeepSeek-R1采用Load Balancing Loss约束的Top-2路由与Ring Attention原生长上下文训练,保障128K输入下的语义连贯性;而GPT-4 Turbo依赖Positional Interpolation扩展与Soft MoE动态剪枝,在灵 阅读详情

近期,国产大模型DeepSeek R1-67B的推理成本引发热议——官方定价16元/百万token,究竟亏不亏?

有分析认为成本可低至4元,也有实测显示高达150元。这背后是算力、通信、显存优化的复杂博弈。本文将用“人话”拆解技术内幕,带你看懂大模型推理的降本逻辑。
分析:

  1. 谈谈微信+DeepSeek

  2. https://zhuanlan.zhihu.com/p/23282743306?utm_medium=social&utm_psn=1873120562987016192&utm_source=wechat_timeline&utm_id=0

  3. https://zhuanlan.zhihu.com/p/24121326326

  4. DeepSeek-R1 Now Live With NVIDIA NIM | NVIDIA Blog

  5. DeepSeek V3 LLM NVIDIA H200 GPU Inference Benchmarking — Blog — DataCrunch

以及之前传播很广的关于4090 做LLM推理的分析:

https://www.zhihu.com/question/615946801/answer/3205148871

为了理解怎么搞才是高性能的模型部署,我们首先要能找到瓶颈在哪里, 或者从优化的角度看就是找到目标函数的限制条件。(以下讨论都不涉及量化等操作)

背景知识

先简单的了解一下Roofline分析,

更深入的理解可以参考文章Roofline
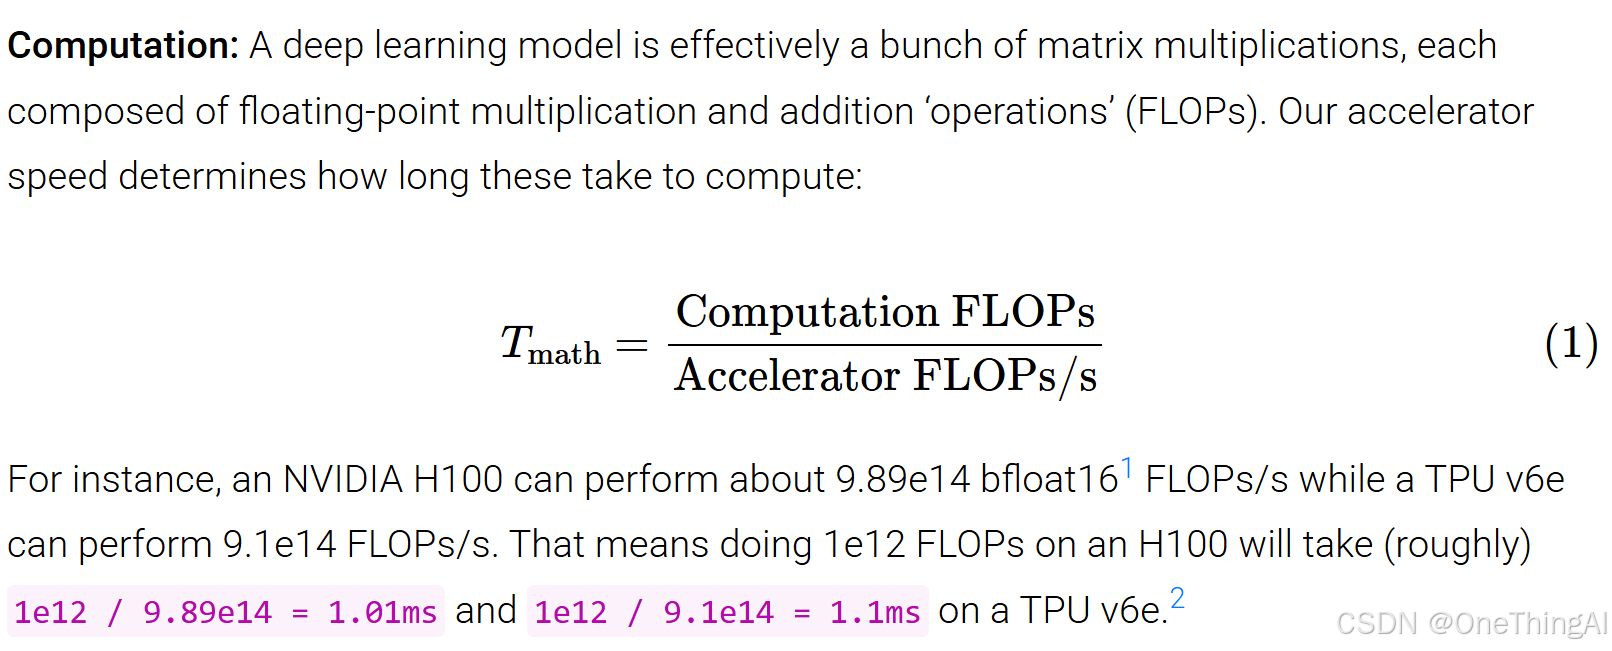
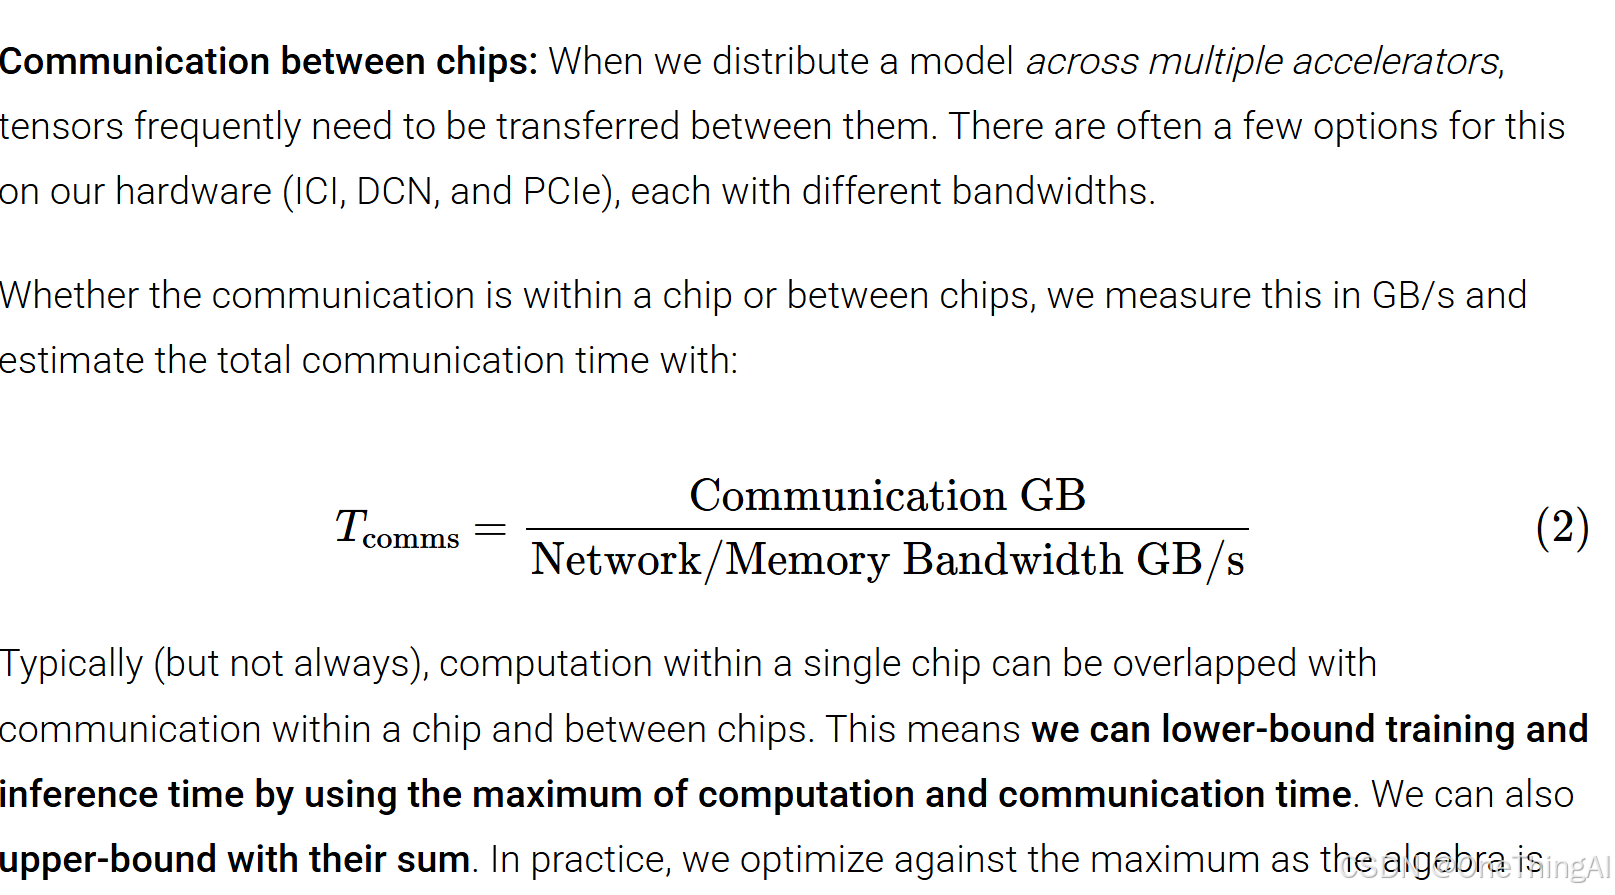
Roofline分析大体上讲主要分析的是到底通信(显存带宽,多卡互联)是瓶颈,还是算力是瓶颈。 在大语言模型的场景下还有一个限制条件没有考虑,就是kvcache 占用的空间大小。

DeepSeek V3 模型结构

MoE概念的理解可以参考 MoE 模型训练

关于DeepSeek 模型结构的解读可以参考DeepSeek V3 模型结构解读

参考 A Mathematical Framework for Transformer Circuits 我们可以把Transformer看作一个残差流
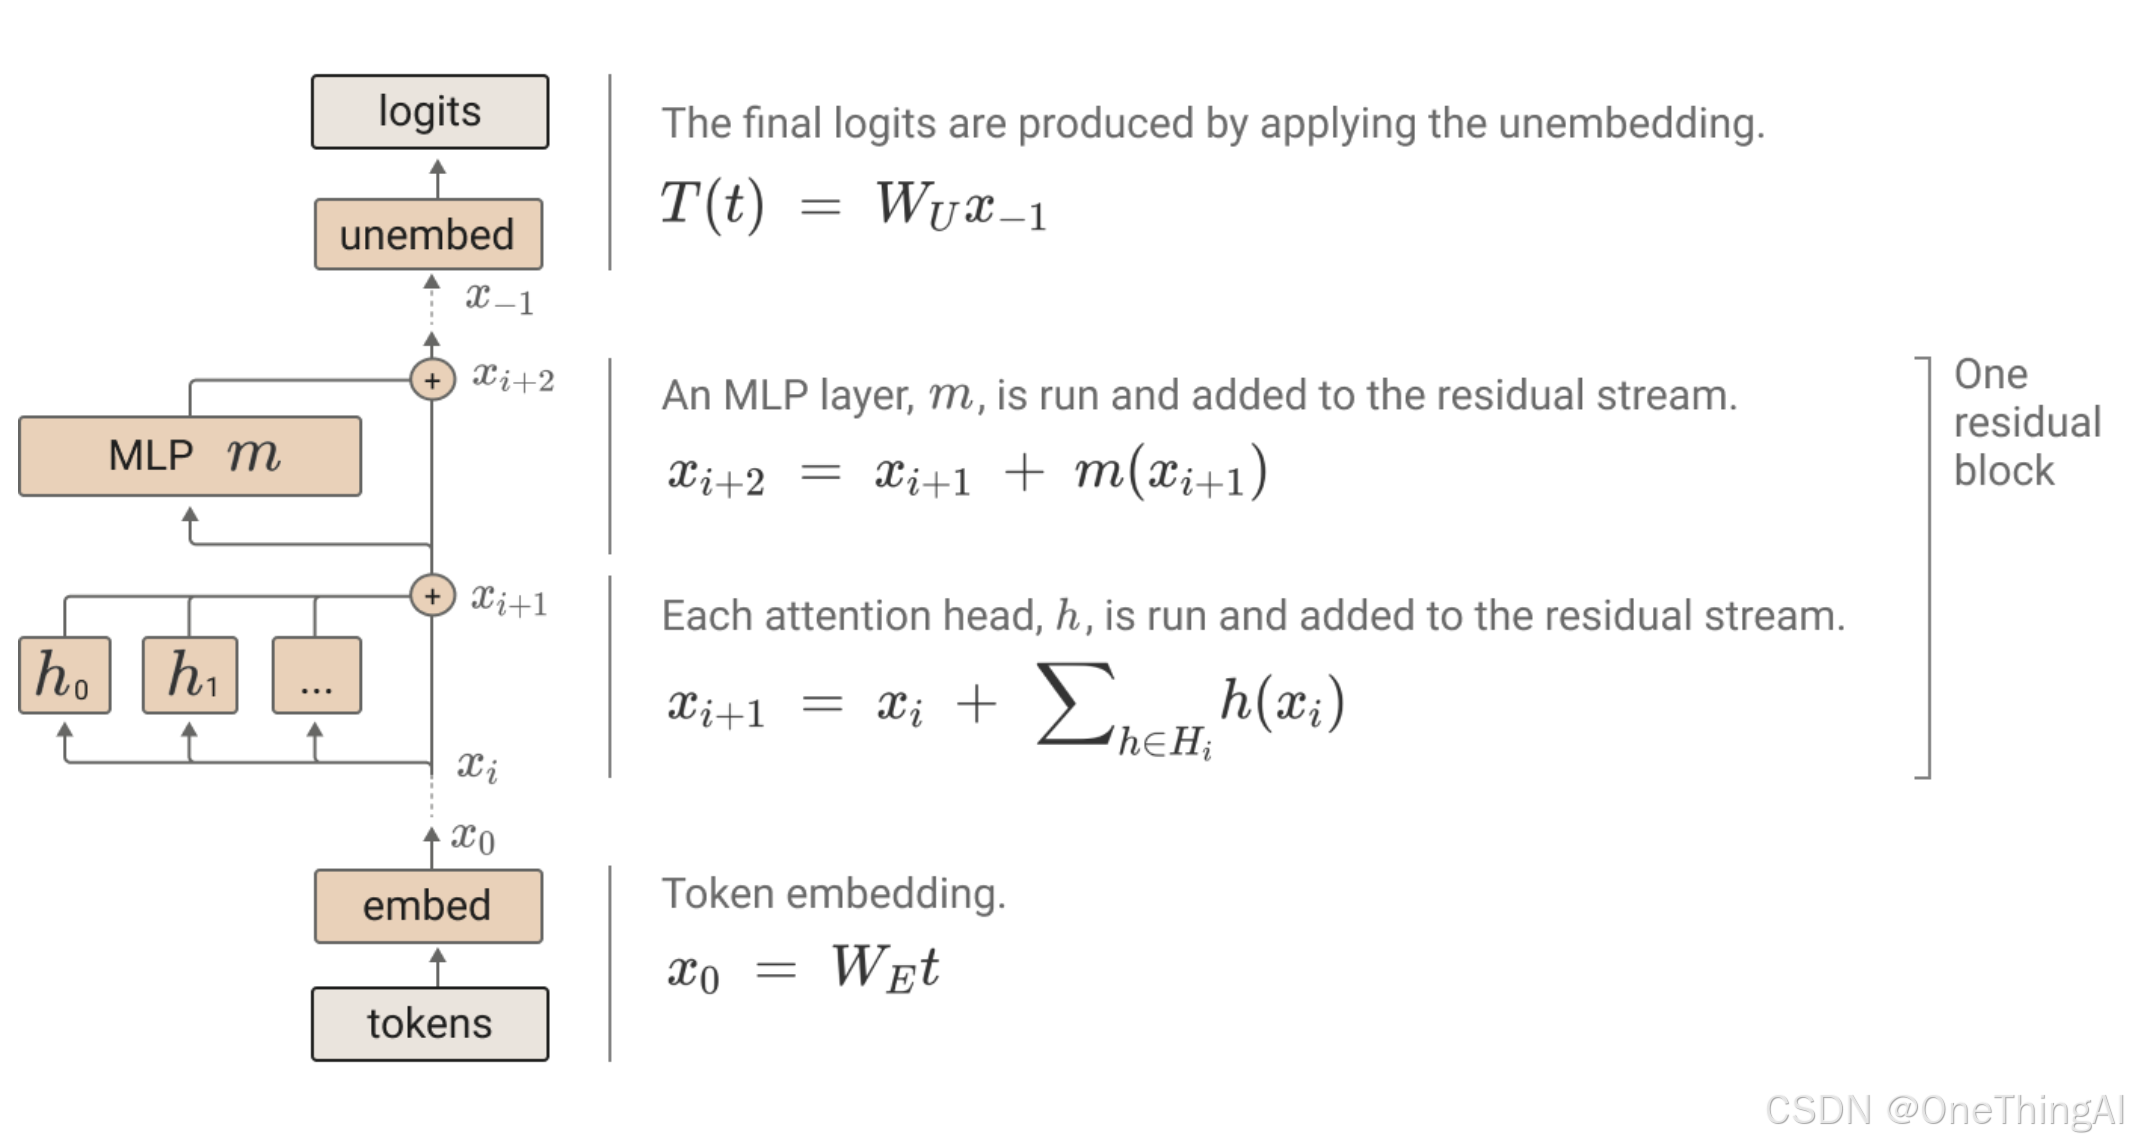
然后结合DeepSeek的论文来看它的架构调整
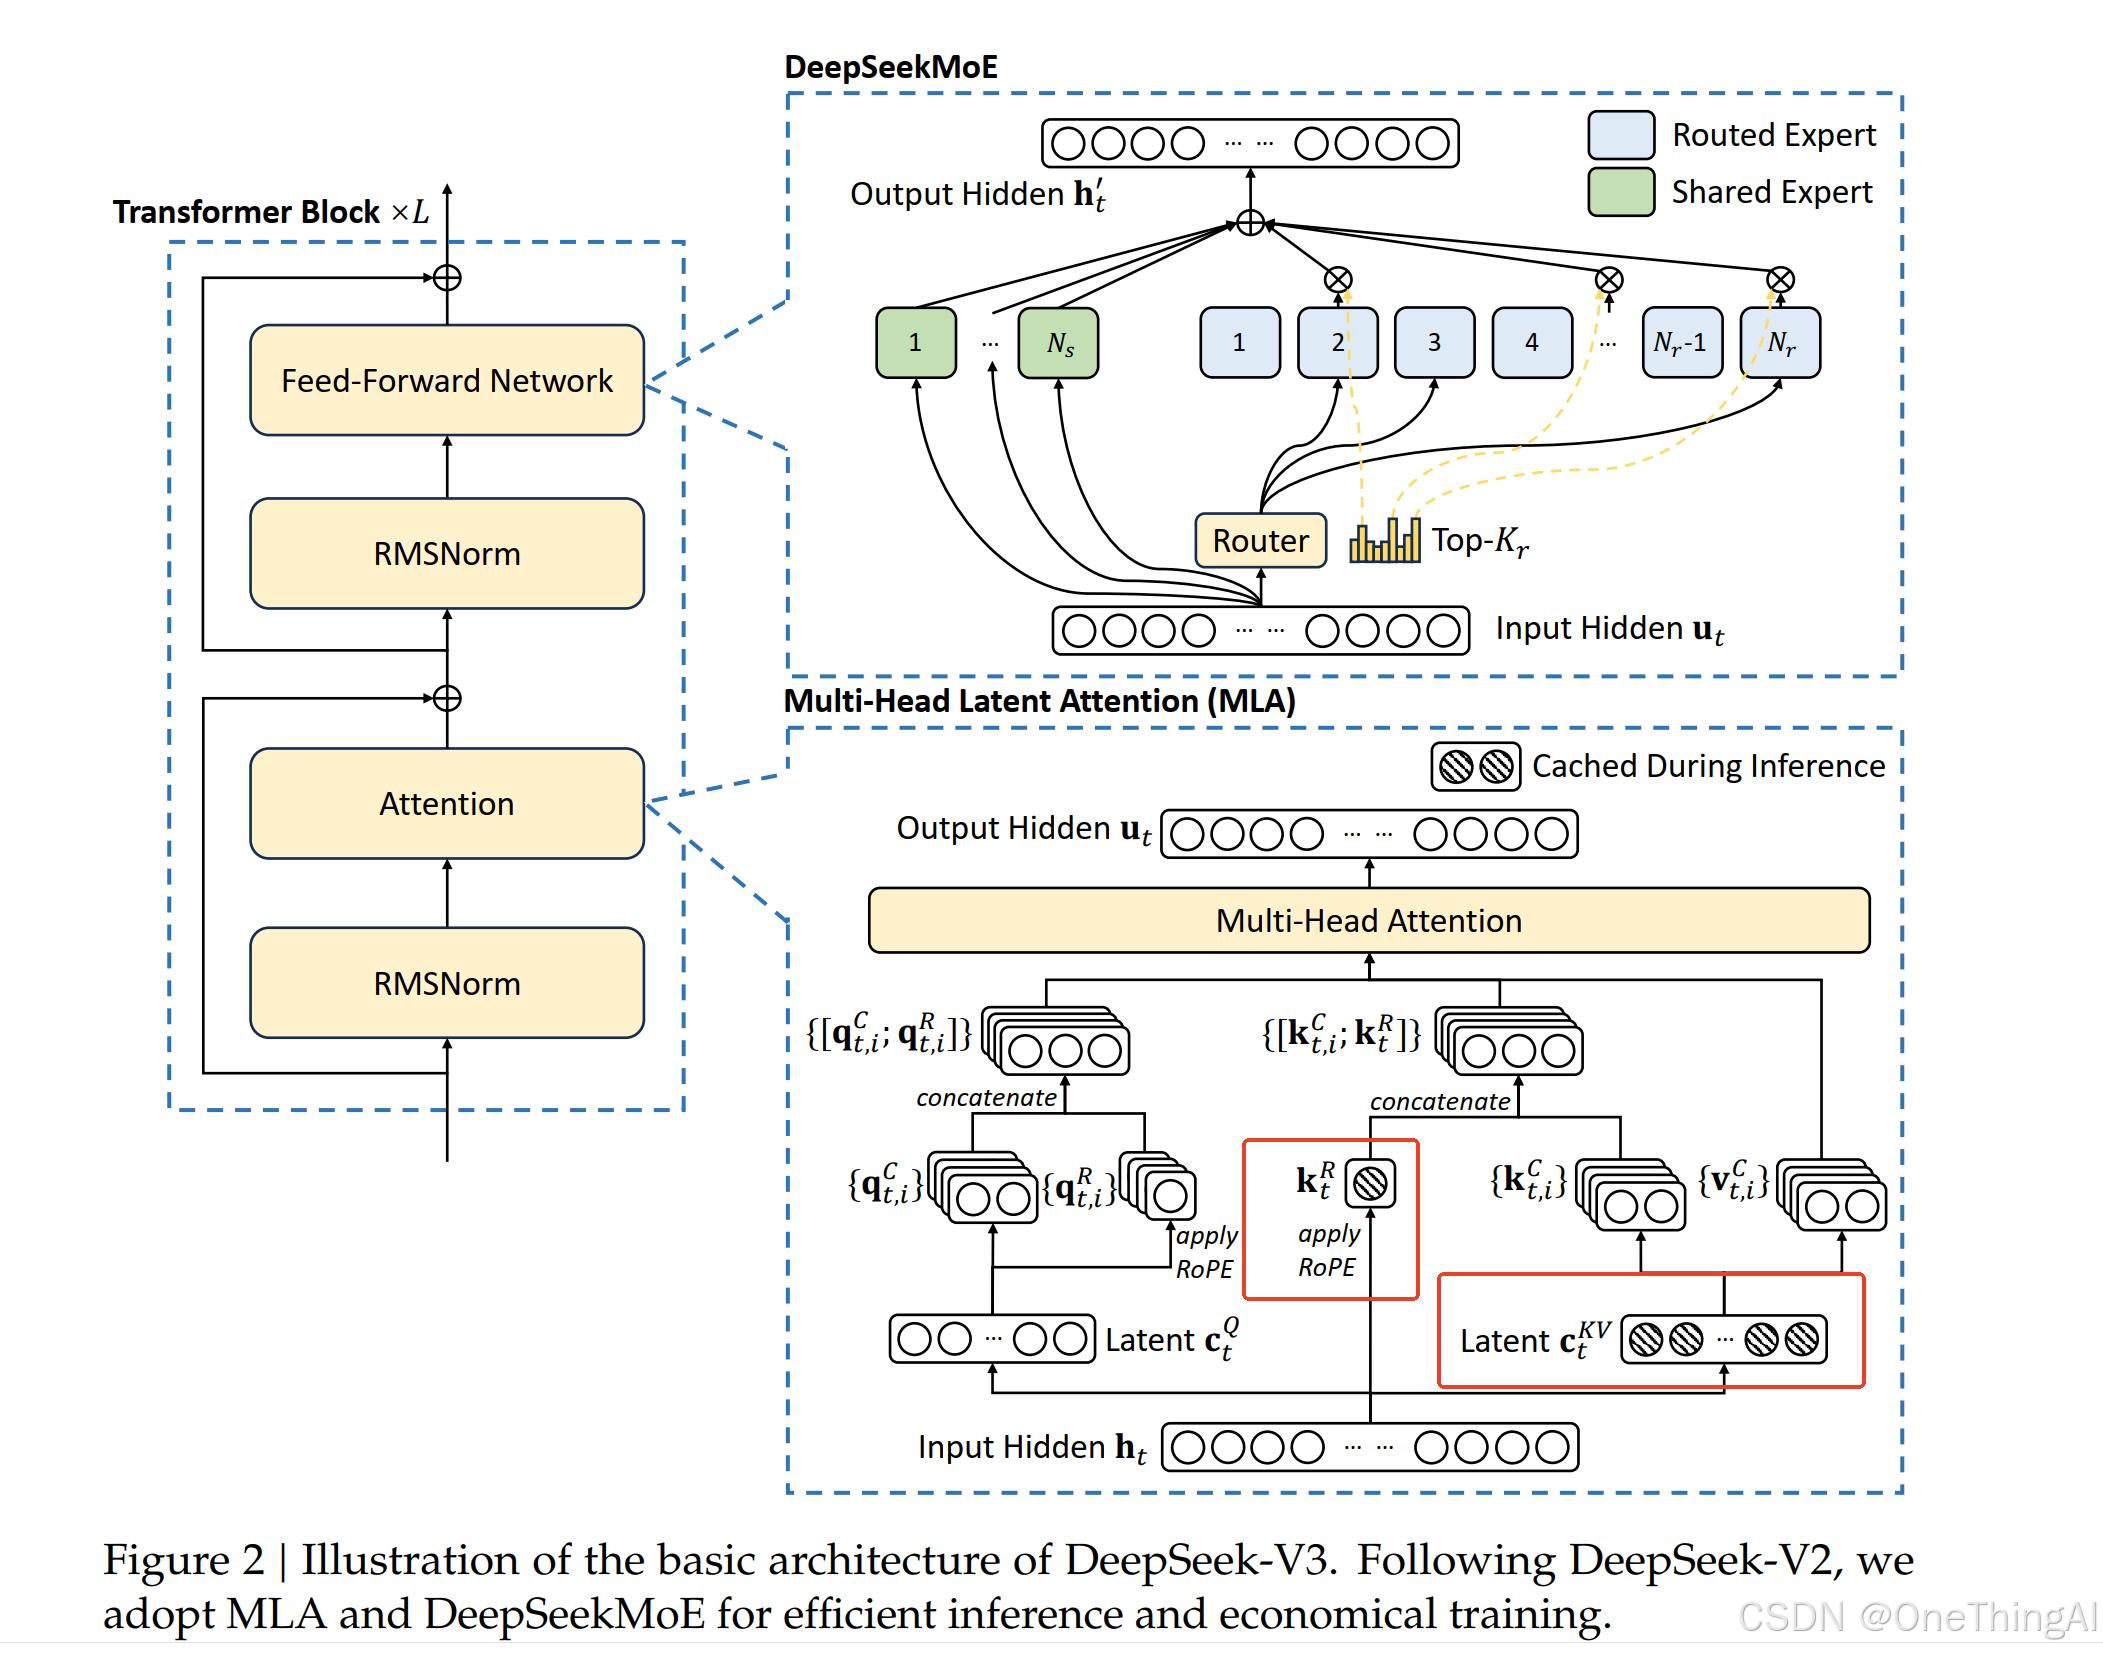
DeepSeek 对Attention和MLP做了替换。

如上图 Attention 层对K,V做了压缩(为什么能压缩,有什么风险),kvcache时只需要存上图红框里的2个部分(更多细节可以参考论文)以此降低kvcache的大小,所以 2 里计算
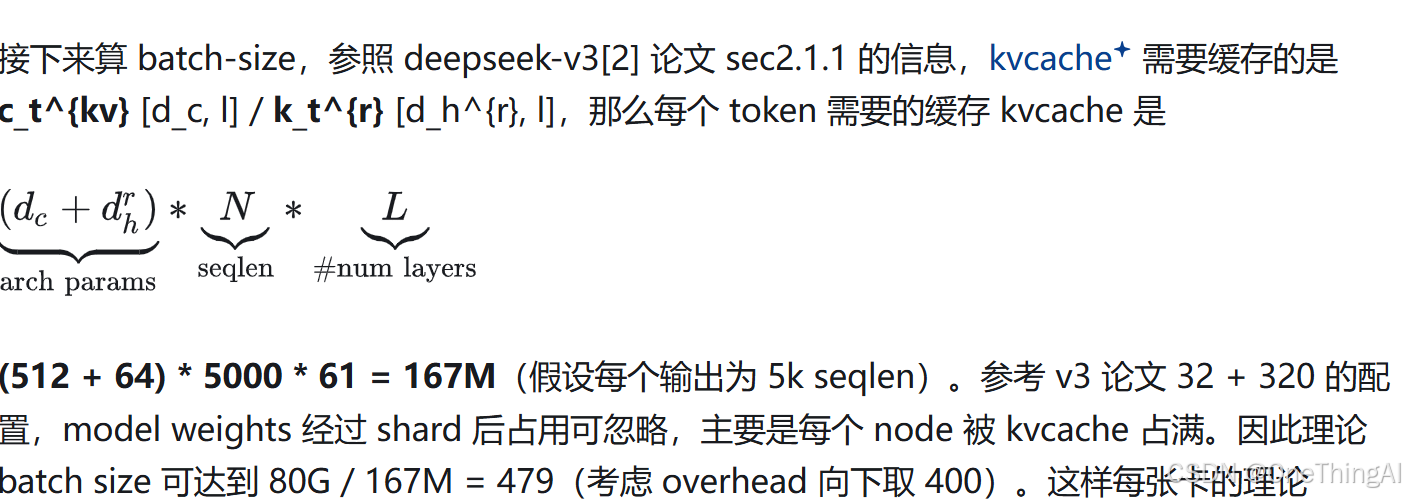
我们这里要做一些修正 k v 按BF16 存储,每个输出长度按1w token计算,那么就只要batch size 113就能占完卡的显存(算力,通信外的另一个限制)。

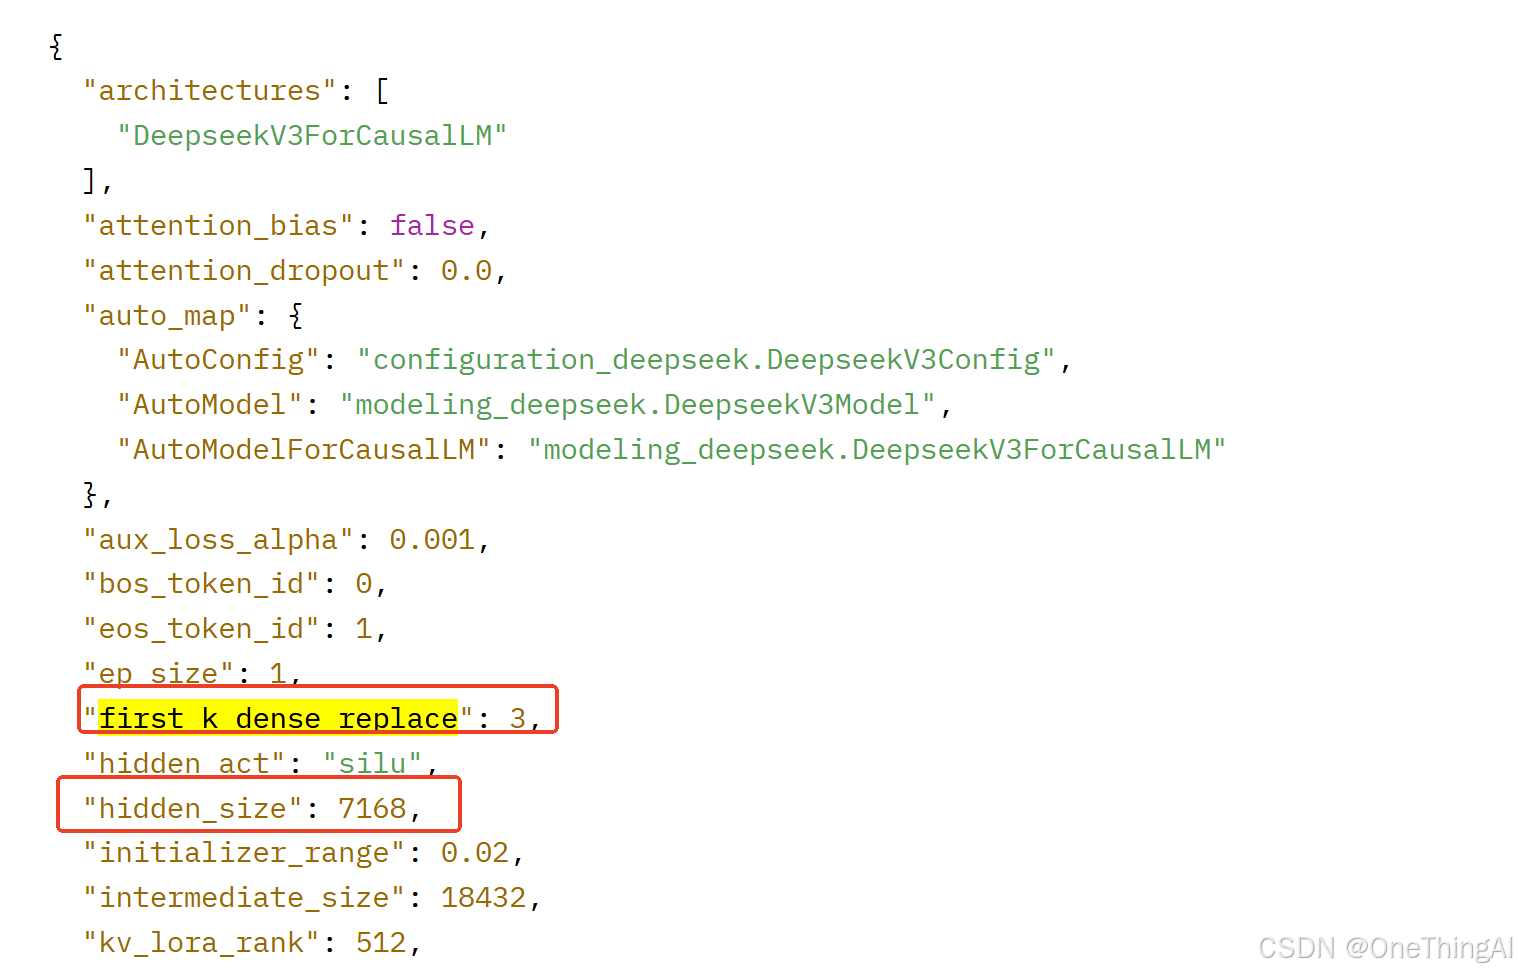
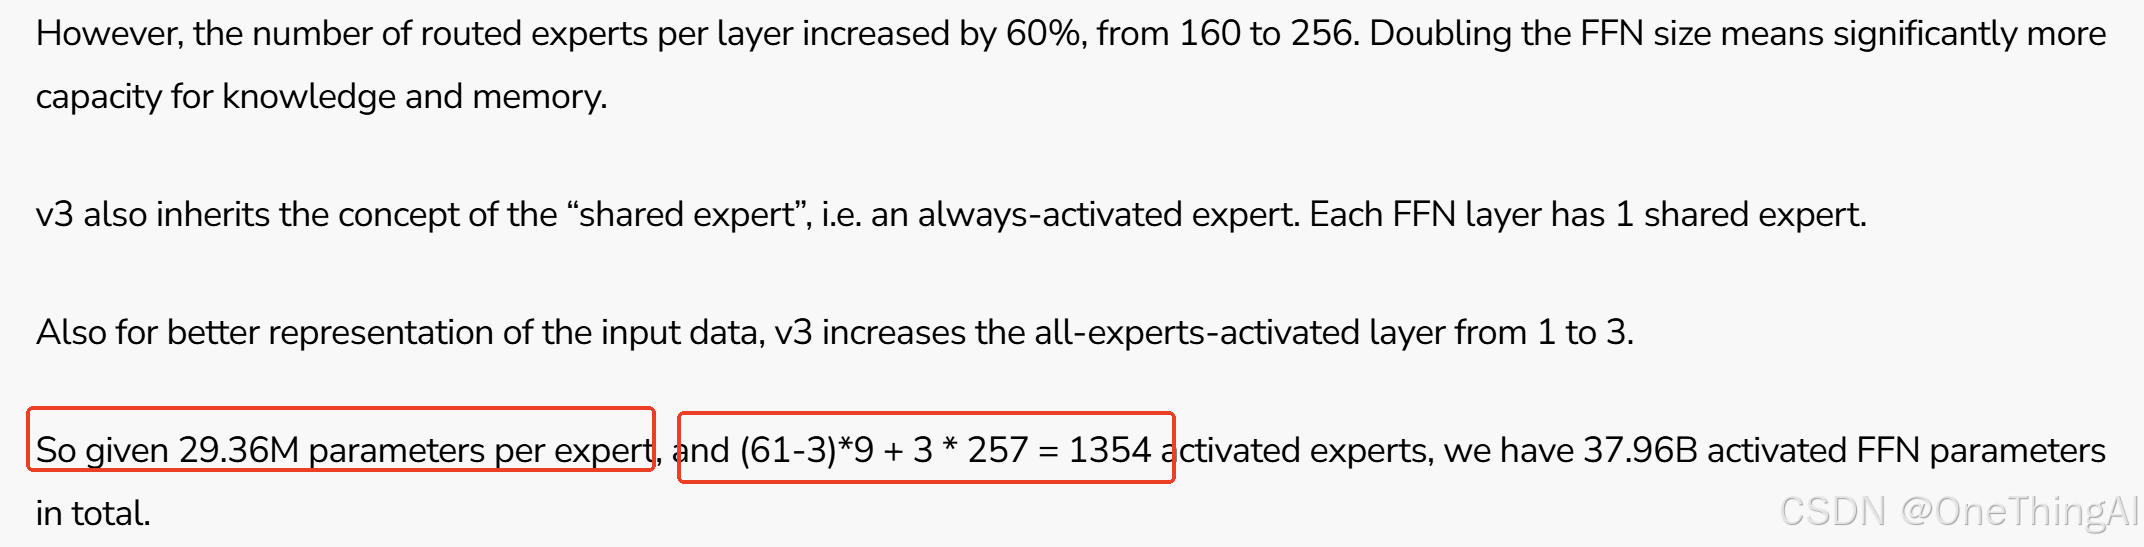
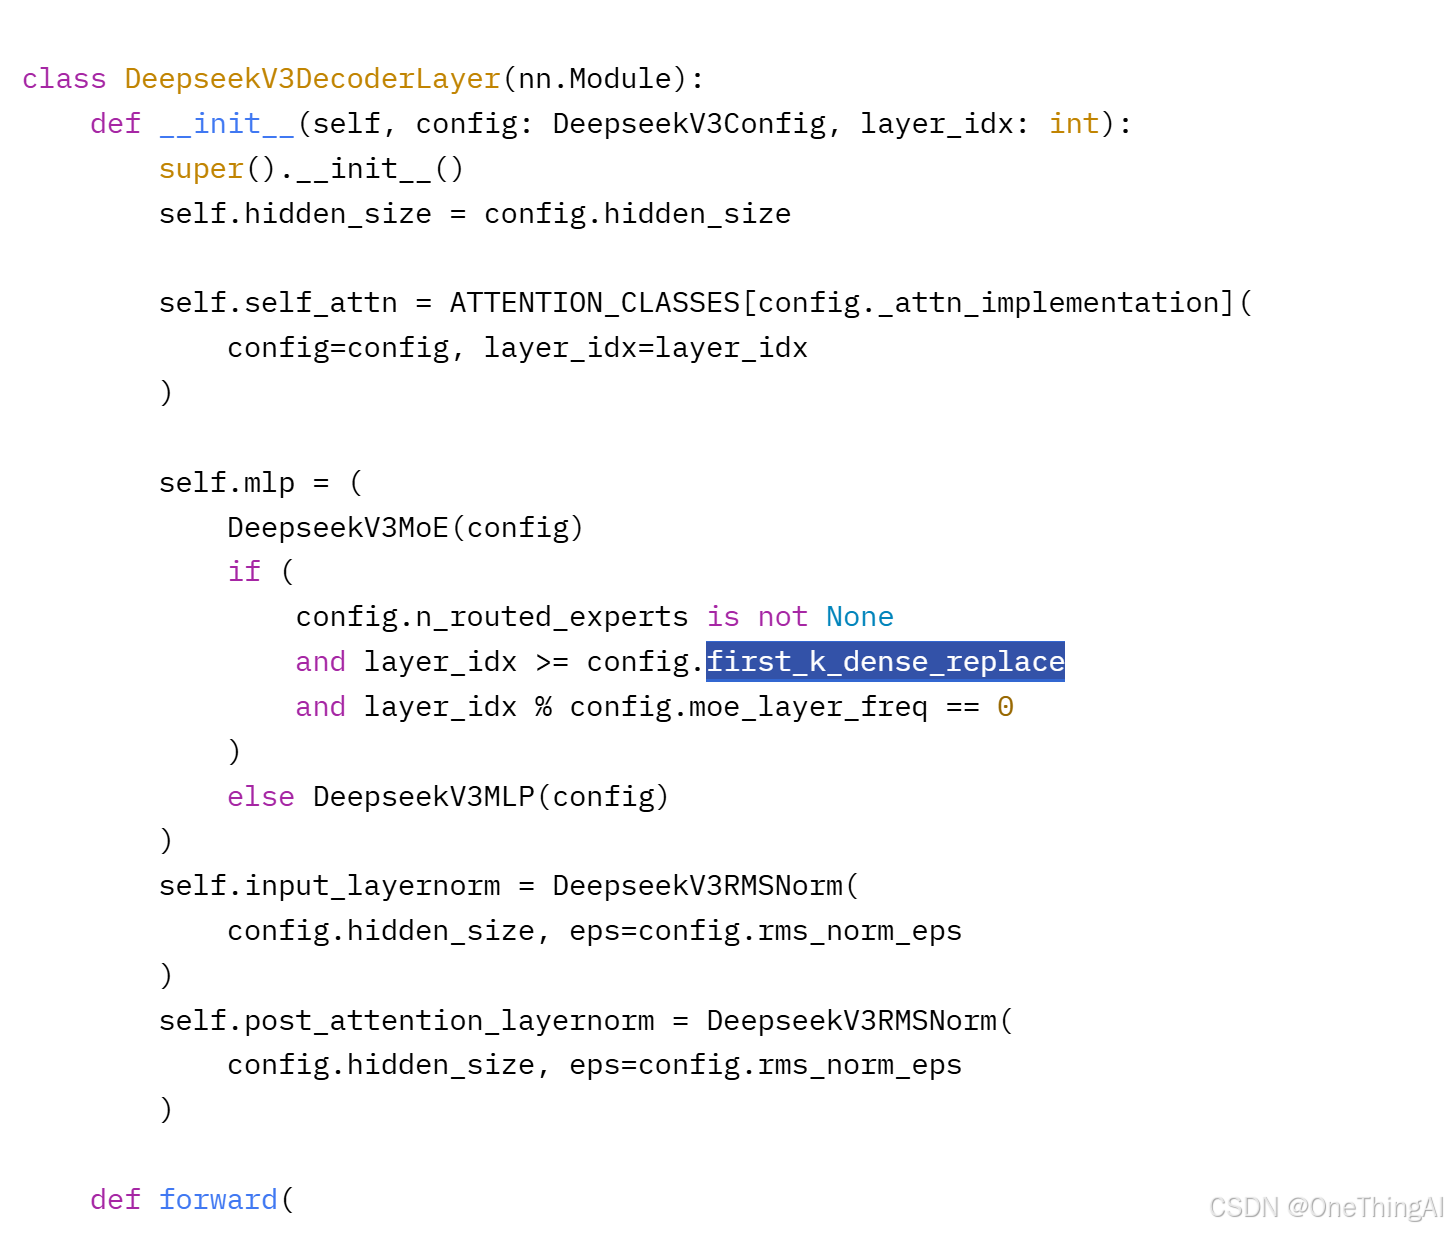
针对MLP替换成了DeepSeekMoE。 在V3 模型61层中前3层还是MLP(模型很深,梯度下降的算法在往后的层从训练数据中得到的特征会少,导致MLP里linear layer天然是低秩的)。细节可以参考下面的代码和配置文件。
总结

1,1-5 篇文章中1,2 估算了EP320 这种部署,到底能可以支持多大的并发。1 认为瓶颈在通信这个判断单台和8卡H100支持600左右的并发请求是很合理的。 因为首先H100 FP16 989TFLOPs的算力,FP8 等于989 * 2,以989 T来做Arithmetic intensity的预估也就是295 FLOPs/byte,大体可以理解为只要单卡batch size 不大于295则算力不是瓶颈。我们回来计算成本,假设单卡按2的预估支持40并发请求,每个请求每秒32 token 做为lower bound, 按道理应该并发数应该高于这个值。 那么按H100 每小时2美元,成本确实不到4块, 16 块钱百万token有利润。API业务能不能赚钱核心问题就转化为跑满率的问题了。(如果低峰期跑不满怎么办呢,是不是可以进一步把算力调度来做RL训练)

2,关于百万token 成本150块,直接见下图
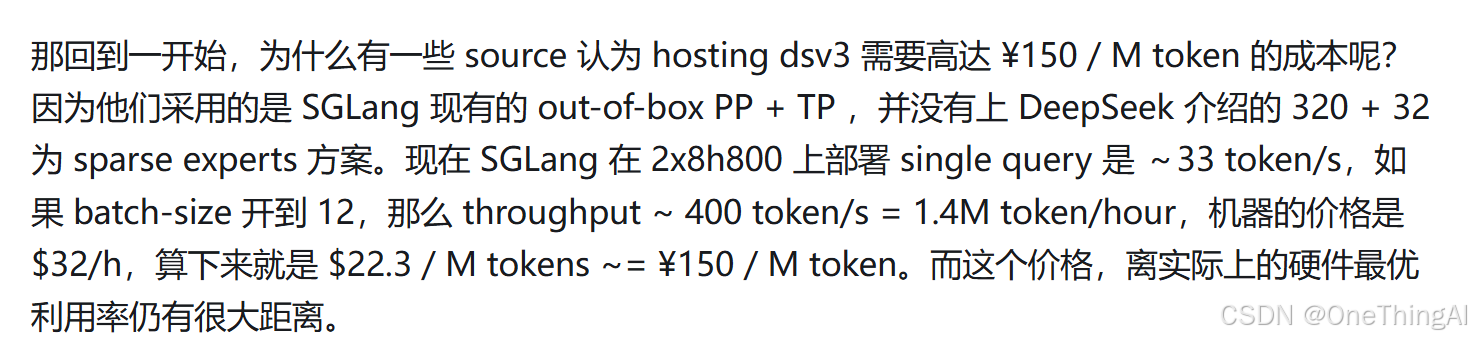
比如5里的测试,效果比上图的结果更差。 为什么2台设备的小集群部署效果是这样呢,batch size 再开大一些,单个用户每秒30tokens/s就无法满足了吗?

1,对于700GB 这么大的模型Prefill就会占用大量的浮点算力资源和显存带宽;
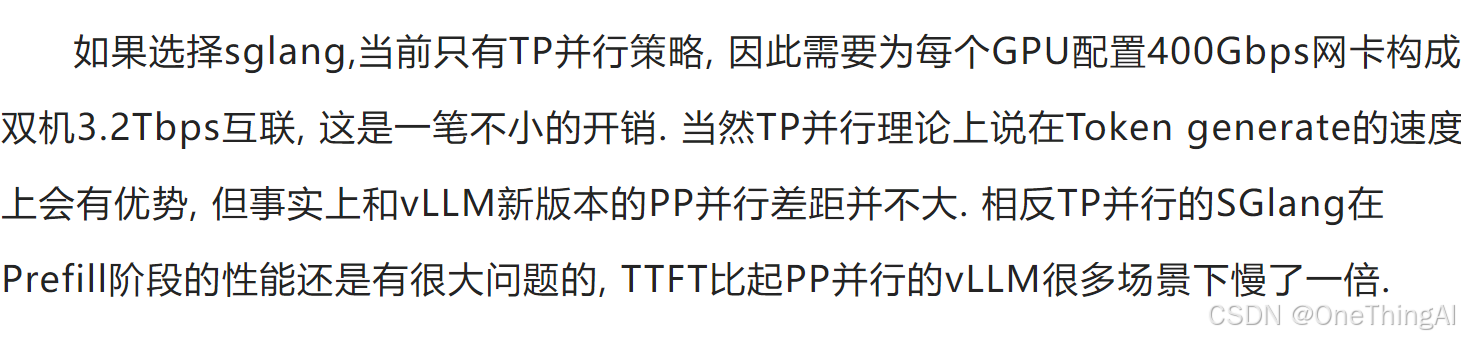
2,参考 谈谈DeepSeek-R1满血版推理部署和优化

通信的压力, sglang 针对deepseek v3 本身并没有优化到最佳等导致目前小集群的整体吞吐还比较低。虽然小集群的性价比方面的上限肯定低于PD分离的EP320 这种部署方案,但是当数据安全是一个约束项时,不得不做小集群部署。

无论sglang还是vllm 针对deepseek v3 都还有很大的优化空间,150/百万token 再优化一个数量级,应该是可实现的。

DeepSeek V4双轨部署:大模型如何驱动AI算力生态扩容 大模型是当前人工智能基础设施的核心引擎,其推理效率与硬件适配能力直接决定AI应用落地深度。随着模型参数规模突破万亿、上下文长度迈向百万token,传统KV缓存机制与单平台依赖已难以支撑高并发、低延迟、跨芯片的工程需求。DeepSeek V4通过分层稀疏注意力、动态MoE路由和双轨部署(昇腾+CUDA)等关键技术,在保持精度的同时显著提升显存利用率与跨平台兼容性。这种‘性能换生态’的设计哲学,不仅缓解了国产GPU算力缺口,更将开源模型转化为硬件采购驱动力。在金融、法律、工业等垂直场景中,V4正推动从‘能用’到 阅读详情

相关推荐

企业级AI私域构建:基于Open-WebUI+Ollama+DeepSeek的LDAP集成与高并发实践

本文详细介绍了基于Open-WebUI、Ollama与DeepSeek-R1模型构建企业级AI私域平台的完整实践方案。重点阐述了如何在内网部署环境中,通过Docker容器化技术集成LDAP/AD认证,实现员工单点登录与数据安全隔离。文章深入探讨了多GPU服务器架构规划、高并发参数调优、Nginx反向代理配置以及生产环境下的安全加固与运维策略,为企业构建私有化、高性能的AI辅助平台提供了可复制的技术路径。

embedding5hiker的博客 438

大模型 Token 的消耗可能是一笔糊涂账

如果您正在部署大模型应用,务必提前和 CEO 打好预防针,大模型应用远不如 Web 应用在资源成本上那么可控。

xingxuechao的专栏 2733

【人工智能】关于硅基智能的DeepSeek定价。价格从输入¥2/ M Tokens变成输出¥8/ M Tokens,应该如何理解这个变化?

在自然语言处理领域,"M Tokens"表示每处理100万个Token的计费单位。输入到输出的价格变化(¥2→¥8)体现了AI服务中数据处理阶段的计算成本差异,输出费用更高是由于生成响应需要更密集的运算和资源投入。

奶爸的编程之路,也就一周冷个三天 1638

一文带大家理解各种AI大模型收费指标tokens到底是什么东东

摘要:Token是大语言模型处理文本的最小单位,作为计费基础,输入收费0.6元/百万tokens,输出3.6元/百万tokens。Token本质是文本的数字编码,通过分词器切分,不同语言处理方式各异。其核心技术包括分词器、嵌入层、上下文窗口和推理成本计算。Token数量直接影响模型的理解能力、计算成本和文本处理长度,是模型运行的核心机制。完整流程涵盖文本输入到计费的各个环节,决定了模型的使用效率和经济性。

liwenxiang629的博客 4954

001-DeepSeek技术全景图:大模型时代的机遇与挑战

摘要 DeepSeek大模型技术全景涵盖基础设施、模型算法和应用生态三层架构,面临诸多实践挑战。训练阶段数据工程是关键瓶颈,混合精度训练需谨慎处理精度问题。推理优化涉及KV Cache内存管理、量化部署和批处理策略等技术细节。现实挑战包括多模态对齐、长上下文处理和领域适应问题。实战建议强调数据质量优先、渐进式开发和监控体系建设,提倡"大模型+传统方法"的务实组合方案。技术快速演进中,保持业务场景理解和系统简洁性仍是核心原则。

annyyim的博客 439

maxwell 平面变压器仿真(一)

在学习开关电源设计的时候,我们难免要设计变压器,采用有限元仿真软件MAXWELL 可以帮助我们确定变压器的励磁电感,漏感等参数。对于我们的理论分析大有裨益。但是苦于这破软件的教程真的是相当的零散,我相信大家用起来也总是苦于没有系统的教程指导,撰写本文的目的有两个,一个是记录自己使用的一些问题,一个是给大家提供一个可以参考的文档。

qq_45405656的博客 8246

输入:0.5元/百万tokens(缓存命中)或2元(未命中) 输出:8元/百万tokens

当请求的数据不在缓存中时,称为缓存未命中。如果你输入的数据已经在缓存中(缓存命中),则输入成本为 0.5 元/百万 Tokens。无论缓存是否命中,输出的 Tokens 都会按照 8 元/百万 Tokens 收费。无论缓存是否命中,输出 Tokens 的收费固定为 8 元/百万 Tokens。如果数据不在缓存中(缓存未命中),则输入成本为 2 元/百万 Tokens。如果数据在缓存中,收费较低(0.5 元/百万 Tokens)。如果数据不在缓存中,收费较高(2 元/百万 Tokens)。

4092

从医疗成像到工业检测:CMOS图像传感器NIR技术的最新应用案例解析

本文深入解析了CMOS图像传感器NIR技术在医疗成像和工业检测中的最新应用案例。通过提升量子效率至70%,NIR技术实现了血管可视化、材料缺陷检测等突破性进展,显著提高了医疗诊断精度和工业质检效率。文章还探讨了系统集成关键考量和前沿发展趋势。

weixin_30879169的博客 90

什么是“每百万token”?-来自DeepSeek的回答。

是文本的基本单位,可以理解为一段文字被拆分后的最小片段。

3万+

Python+whisper/vosk实现语音识别

Whisper 是一个由 OpenAI 开发的人工智能语音识别模型,它能够将语音转换为文本。Whisper 模型特别之处在于它的设计目标是能够理解和转录多种语言的语音,包括但不限于英语。Whisper 模型在训练时使用了大量不同语言的语音数据,这使得它具有很好的跨语言能力。Vosk 是一个开源的语音识别库,它可以在离线环境下工作,不依赖于任何外部服务。Vosk 基于Kaldi语音识别框架,支持多种语言,包括中文。Vosk提供了多种预训练模型,可以根据需求选择适合的模型进行语音识别。

weixin_44458771的博客 5941

Apifox CLI + Claude Skills:将接口自动化测试融入ai

基于 Apifox CLI、Claude Code以及Claude Skills组合,实现自然语言触发接口自动化测试。

wwz_0012的博客 598

DeepSeek-R1-Distill-Llama-8B多GPU并行推理优化指南

本文介绍了如何在星图GPU平台上自动化部署DeepSeek-R1-Distill-Llama-8B镜像,并利用其多GPU并行推理能力优化文本生成任务。通过该平台,用户可以快速配置环境,实现高效的批量文本生成与问答,显著提升AI内容创作与智能客服等场景的响应速度与吞吐量。

weixin_42613018的博客 187

【SPSS实战】手动实现Quade非参数协方差分析:从数据准备到结果解读

本文详细介绍了在SPSS中手动实现Quade非参数协方差分析的实战方法。当数据不满足正态分布等参数检验假设时,通过将协变量和因变量转换为秩,并利用秩回归残差进行Kruskal-Wallis组间比较,提供了一种清晰、可操作的近似解决方案。该方法有效解决了非正态数据的协变量调整问题,适用于实验研究和调查数据分析。

bean的博客 468

DeepSeek R1企业落地手记:推理能力如何嵌入真实工作流

大模型推理能力是AI在企业场景中实现价值跃迁的核心基础,其本质在于从模糊意图中精准识别任务边界、构建可验证的思维链,并在复杂约束下保持输出稳定性。相比单纯追求benchmark高分,企业更关注模型在非结构化文档处理、跨系统协同、合规性校验等高频任务中的鲁棒性与可控性。DeepSeek R1通过99M tokens强化训练,在中文语境下的法律条款解析、金融数据推演、工业故障归因等垂直场景展现出显著的推理跃升,尤其擅长‘知道自身边界’的元认知式输出。这种能力使其成为嵌入CRM、ERP、电子病历等业务系统的关键组

weixin_30654419的博客 396

SSD训练自定义数据集实战:VOC格式标注与模型调参技巧

本文详细介绍了如何使用SSD模型训练自定义VOC格式数据集,包括数据标注工具选择、VOC数据集目录结构规范、数据集划分方法以及模型调参技巧。通过实战案例演示了SSD源码的关键修改点和训练参数优化策略,帮助开发者高效实现目标检测任务。

php55的博客 563

4.DJI-PSDK云台x-port控制:

使用PSDK 的“云台控制”功能,开发者需要先设计负载设备的云台并开发出控制云台的程序,将云台的控制函数注册到PSDK 指定的接口后,用户通过使用DJI Pilot、基于MSDK 开发的移动端App 及遥控器即可控制基于PSDK 开发的具有云台功能的负载设备,同时获得负载设备的相关信息,如姿态等。云台的姿态如 图2.云台姿态 所示,根据用户的控制指令,云台能够调整姿态;云台的关节如 图1.云台关节 所示,云台关节是云台上带动负载设备转动的结构件:云台电机,云台关节角即云台电机转动的角度。

哒宰的博客 857

Deepseek进入业务深水区,为什么需要昇腾大EP?

这意味着,当行业用户基于昇腾底座开发AI应用,能得到生态的全方位助力,减少智能化升级的阻力,降低综合成本。一来,人多了,大量访问请求带来的高并发,就像春运高峰期涌入巨大的人流量,会出现请求积压,模型推理思考时间变长,token吞吐速度下降,用户的等待时延达到50-100毫秒,服务器繁忙和排队让人恼火。很多政企客户在接入了Deepseek之后,使用量进一步增加,有了扩展推理集群规模的需求,推理资源需要从2台扩展到10台,从16卡扩展到千卡,但扩容升级并不是往机房一放、网络一连,就能高枕无忧了。

脑极体 1016

Python爬虫实战:全面采集国家自然科学基金项目数据的全流程指南

国家自然科学基金委员会(NSFC)支持基础研究、应用基础研究,是我国科研投入的核心项目之一。公开的项目数据包括项目名称、负责人、资助金额、年度、单位等,具备极高科研和数据分析价值。requests:基础HTTP请求库,简单直观:异步HTTP请求库,适合大规模并发:HTML解析,提取数据:处理JavaScript渲染网页pandas:数据分析与清洗:数据库存储:重试机制实现。

2201_76125261的博客 753

DeepSeek V4百万token推理的三大硬件级优化技术

长上下文大模型推理的核心瓶颈并非算力不足,而是GPU显存带宽、访存延迟与位置编码精度构成的系统性约束。分块KV缓存通过将注意力状态切分为可调度的数据块,缓解O(n²)访存压力;动态RoPE偏移则重构位置建模逻辑,避免超长序列下浮点精度崩溃;硬件感知内存池调度进一步实现显存通道级负载均衡与L2缓存协同预取。这三者共同构成面向H100/A100等真实硬件的工程闭环,支撑客服对话历史、法律合同比对、科研文献综述等需稳定处理100K+ token的工业场景,使‘百万上下文’从参数表走向终端可部署的推理服务。

weixin_30787531的博客 332

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

基于 DeepSeek LLM 本地知识库搭建开源方案(AnythingLLM、Cherry、Ragflow、Dify)认知

博文内容涉及 基于 Deepseek LLM 的本地知识库搭建使用 ollama 部署 Deepseek-R1 LLM知识库能力通过 Ragflow、Dify 、AnythingLLM、Cherry 提供理解不足小伙伴帮忙指正 😃,生活加油我站在人潮中央,思考这日日重复的生活。我突然想,如果有一天,垂老和年轻都难以惊起心中涟漪,一潭死水的沉闷,鲜花和蛋糕也撼动不了。如果人开始不能为微小事物而感动,那么地震山洪的噩耗想必也惊闻不了。如果活着和死亡的本质无异,那便没有了存在的意义。

山河已无恙 4399

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Token经济的:拆解 AI 推理成本的细节

—省不掉,也不该省。看懂五层结构,就能看懂AI最拧巴的现实:一边价格战打到骨折,一边算力荒从没缓解。原因就一句话——Token经济有两套时钟,转速天差地别。算法是快时钟。三年,推理成本降了99.5%,剩原来的两百分之一。MoE、蒸馏、推测解码……按天迭代,软件一改,成本就降。芯片、机房、电力是慢时钟。物理世界的事,快不起来。数据中心交付要18–36个月,还常延期。2026年美国计划新增16吉瓦,4月只开工5吉瓦。OpenAI的5000亿Stargate项目,因电网排队、变压器缺货,暂停施工。

Black_Rock_br的博客 485

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

DeepSeek-R1-0528 VS Claude-4-Sonnet:全面对比两大AI模型的升级与性能

AI巨头技术对决:DeepSeek与Claude上演巅峰之战 两大AI模型最新版本展现差异化技术路线:DeepSeek-R1-0528以极客风范实现代码能力飞跃,采用动态稀疏注意力机制,在671B参数的MoE架构下实现长文本推理显存占用降低30%;Claude-4-Sonnet则坚持宪法AI路线,200K上下文窗口配合分层记忆机制,在多轮对话连贯性上表现突出。基准测试显示,DeepSeek在HumanEval编程测试中通过率78.2%,略胜Claude的75.6%;而Claude在数学推理(83.4%)和文

全世界的博客 4093

小白必看!DeepSeek-R1-Distill-Llama-8B一键部署教程

本文介绍了如何在星图GPU平台上一键自动化部署DeepSeek-R1-Distill-Llama-8B镜像,快速搭建AI文本生成环境。该模型擅长数学推理、代码编写和逻辑问答,可广泛应用于智能问答、编程辅助和学习辅导等场景,大幅提升内容生成与自动化处理效率。

weixin_35753291的博客 90

Windows 11 高效部署 GPUStack:解锁 DeepSeek 深度学习新体验

本文详细介绍了在Windows 11系统上部署GPUStack以高效运行DeepSeek深度学习模型的完整流程。通过GPUStack这一GPU资源管理工具,用户可以轻松管理和隔离GPU资源,实现DeepSeek模型在本地稳定运行,从而获得隐私安全、低延迟的AI助手体验,适用于代码生成、逻辑推理等多种任务。

zero1的博客 795

DeepSeek-R1响应不准确?提示工程优化实战指南

本文介绍了如何在星图GPU平台上自动化部署🧠 DeepSeek-R1 (1.5B) - 本地逻辑推理引擎镜像,高效支撑结构化逻辑推演任务。通过提示工程优化,该镜像可在纯CPU环境下稳定执行数学求解、编程验证、分步逻辑分析等典型场景,显著提升本地AI推理的准确性与可控性。

weixin_42513870的博客 120

【收藏】大模型推理性能优化全解析:服务层、推理引擎和模型量化三方面详解

本文详细介绍了大模型推理性能优化的三大层面:服务层优化(Continuous Batching、流式生成、长序列推理)、推理引擎优化(KV-Cache、PagedAttention、APC等)和模型量化技术(SmoothQuant、LLM.int8等)。通过这些技术,可平衡GPU计算效率与显存占用,提高推理吞吐量并降低延迟,使大模型在有限资源下更高效运行。

Android23333的博客 858
上一篇: 新年AI爆点!DeepSeek R1与Janus模型开启智能新
下一篇: 【大模型私有化部署要花多少钱?】一张图看懂你的钱用在哪
OneThingAI
博客等级 码龄2年 135粉丝 44原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值