


MyScale 是一款提供完整 SQL 支持的集成向量数据库,而 PostgreSQL 和 OpenSearch 是两个最近都添加了向量相似性搜索功能的传统数据库。本文将对 MyScale 、PostgreSQL 和 OpenSearch 进行比较。
随着大语言模型(LLMs)的出现,人们对将对话界面集成到各种应用程序中的兴趣不断增加,例如搜索引擎、代码生成器和数据分析工具。向量相似性搜索是一项关键技术,在通过检索增强生成(RAG)提高 LLMs 性能方面起着至关重要的作用。
如今,市场上各种各样的向量数据库产品层出不穷;这些数据库大致可以分为以下几类:专门设计用于向量索引的专用向量数据库,集成向量数据库,以及扩展支持了向量搜索的通用数据库。
集成向量数据库与专用向量数据库相比,具有一些明显的优势,包括:
- 将向量和结构化数据存储在同一个数据库中,便于进行更复杂的筛选搜索,以及 SQL 和向量联合查询。
- 利用强大且广泛使用的查询语言(如 SQL)进行结构化和向量数据分析。
- 利用成熟的工具和与通用数据库集成。
- 减少了运维另一个专用数据库的额外成本和购买其许可的费用。
- MyScale:基于 ClickHouse 开发的集成向量数据库,通过完整的 SQL 支持将向量相似性搜索的能力与结构化数据检索能力结合于统一的数据库中。
- PostgreSQL:通过 pgvector 插件提供向量搜索支持
- OpenSearch:在 2.9.0 版本中整合了神经(向量)搜索
正如下文所述,我们全面的基准评估表明,MyScale 在过滤向量搜索的准确性、性能表现、成本效益和索引构建时间方面明显超过其他产品。重要的是,以各种过滤比率下提供良好的搜索准确性和 QPS 为基准,MyScale 是唯一通过测试的产品。
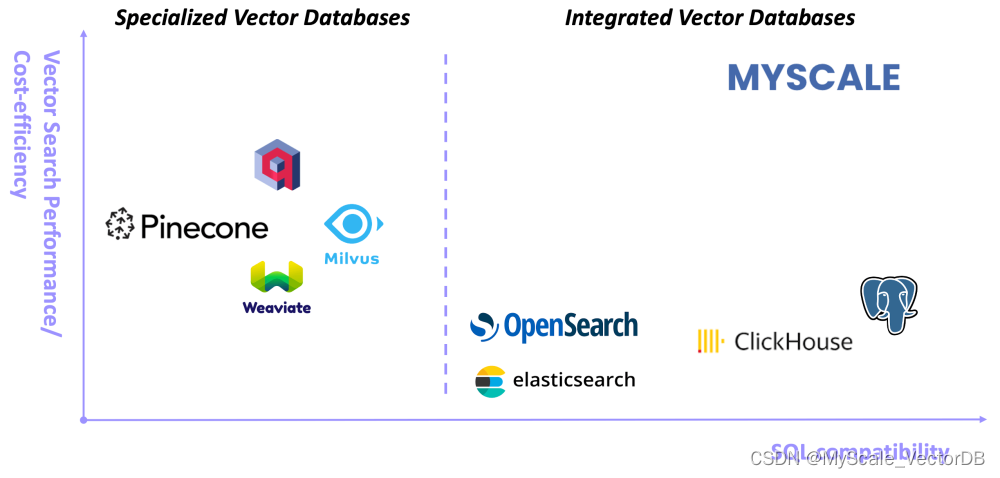
此外,MyScale 在性能方面也优于专用向量数据库,参考文末拓展阅读。如下图所示,完整的 SQL 支持和高性能的向量搜索集合,使MyScale 成为了管理 AI/LLM 相关数据(结构化数据与向量数据)非常有竞争力的选择。
基准设置
我们对MyScale、OpenSearch 和两个 Postgres 向量搜索插件进行了基准测试。设置详情如下:
| 每月成本(美元) |
|||


 484


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


