论文阅读笔记——Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset

我的AI之路(55)--如何获取kinetics数据集和如何制作自己的kinetics数据集 近来做行为动作识别,根据近两年的CVPR、ICCV、ECCV论文实验了一序列的动作识别方面的模型,很多都用到了kinetics数据集或者something-something数据集,但是后者的官网目前已经关闭了(可能是因为上月bn20被高通收购了的原因),所以只好依赖于kinetics数据集了,但是网上没有看到有人把kinetics数据集如何使用说清楚了,只好自己花了点时间看这个数据集的内容以及翻看了多个相关动作识别模型加载kinetics数据集的代码,看是如何做data loading的,做下... 阅读详情

I3D 论文
UCF-101(13000多个视频)和 HMDB-51(7000多个视频)数据集过小,提出了 Kinetics 数据集,并且在其之上预训练之后能够迁移到其他小的数据集。
在这里插入图片描述

  • 2D+LSTM:使用2D CNN的好处是可以直接从 Imagenet 的预训练权重迁移过来,并且使用LSTM提取时序特征。流程是,首先使用2D网络分别提取每一帧图像的特征,然后对于所有特征使用 LSTM 来获取帧之间的时序信息。这种方法的优点是可以直接使用2D网络的预训练权重;缺点是只有在LSTM的部分才能够基于高维抽象的特征进行运动信息的提取,损失了很多低等级的运动信息,此外 LSTM 训练时需要在每个 step 都进行反向传播。
  • 3D CNN:其优点就是可以同时提取时空信息;缺点也显而易见,即具有更庞大的参数数量从而更难训练,因此一般 3D 网络的深度都较浅,单这样又影响了模型的表达能力,此外,没有办法能够有效的把2D网络的预训练权重迁移到3D网络。
  • Two stream:双流网络中一个分支作为 spatial flow,输入RGB图像来提取物体和场景外观特征;另一个分支作为 temporal flow,输入光流来提取运动特征。通常两个网络分开训练,只有在测试时才会平均两个网络的预测。因此,也产生了时空信息在浅层网络中无法有效融合的问题。

Inflate:2D卷积核(和权重)直接复制 N 次得到 3D 卷积核,权重除以 N。
假设我们有一个视频片段,其中的物体移动非常慢,几乎没有运动(比如摄像头拍向一块空地)。我们在这段视频中取一些帧出来,比如取16帧,拼接起来作为3D卷积网络的输入。那么我们可以认为取出来的16帧等价于1帧图像复制16份(视频中几乎没有运动)。
我们来拆分一下 3D 卷积核 h×w×t ,分解成 t 个 h×w 的2D卷积核。这里的 h,w 分别是卷积核的高宽, t 是时间维度的深度,也就是我们把 imagenet 中的1张图像叠加 16 份的 “16”。 h×w 作用在 t=16 上的任意帧时,所提取的空间特征都应该是完全相同的,因为叠加的每一帧都是 1 张图像复制来的。所以把2D卷积核复制N次得到 3D 卷积核,等价于把1张静态图像复制拼接为 boring video ,然后使用 3D 卷积核去预训练是等价的。如果归一化,则改变了下一层卷积的输入特征响应激活值了,所以要对2D卷积核的权重进行归一化, 即除以N。

实验结果
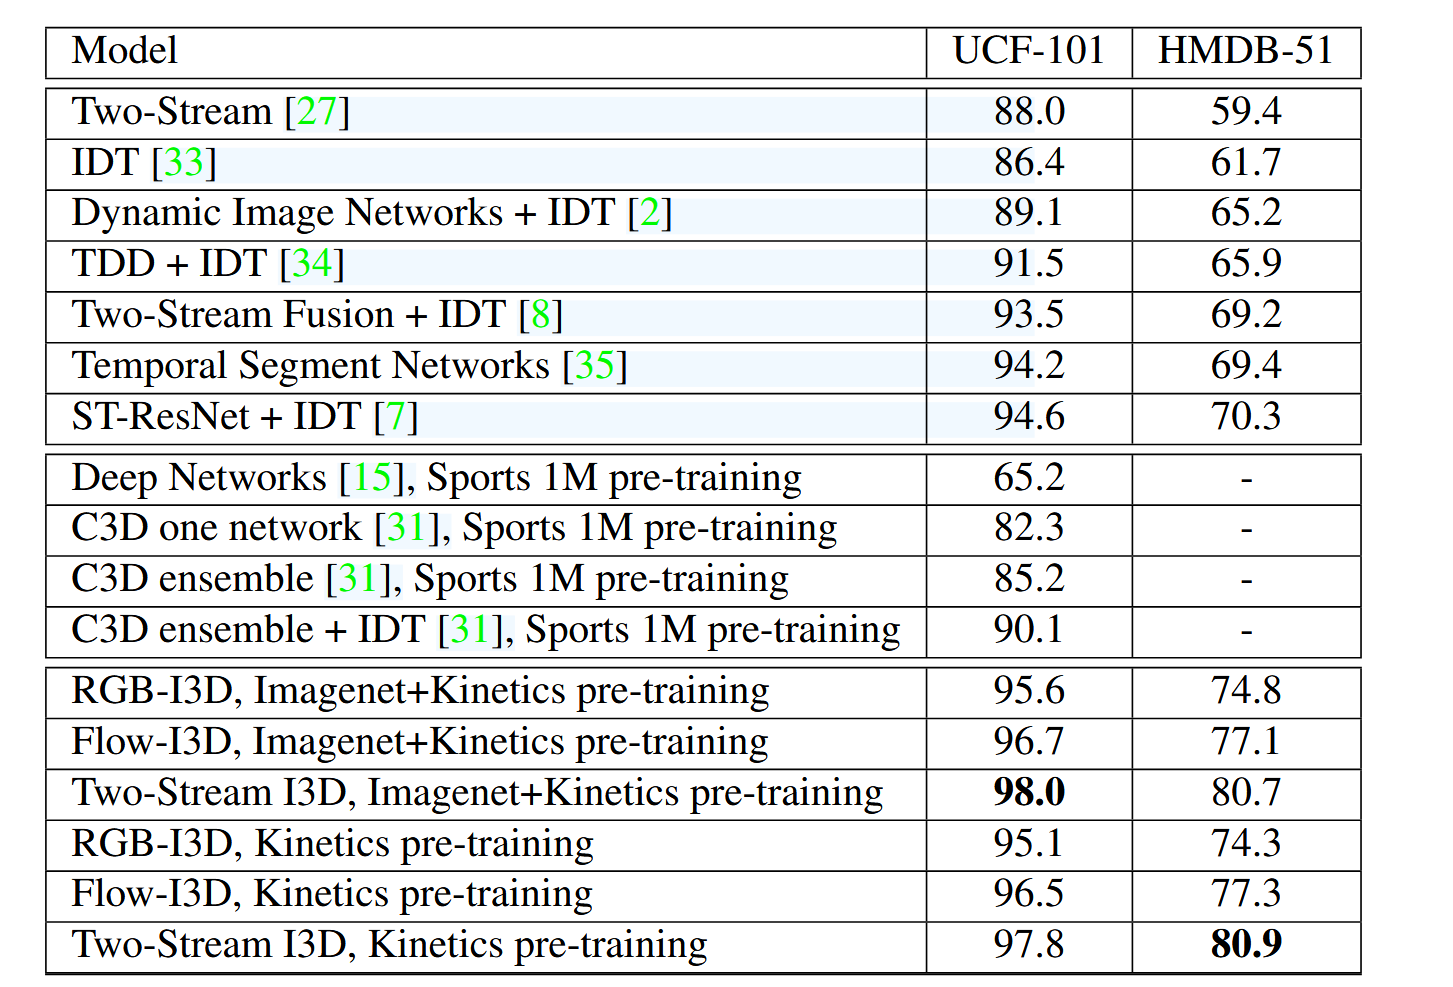
在这里插入图片描述

Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset Abstract 当前动作分类数据集(UCF-101和HMDB-51)中视频的匮乏,使得很难确定好的视频架构,因为大多数方法在现有的小规模基准测试中都获得了类似的性能。本文根据新的Kinetics Human Action Video数据集重新评估了最先进的体系结构。Kinetics的数据量增加了两个数量级,其中包括400个人类动作课程,每个课程超过400个剪辑,它们是从逼真的,具有挑战性的Yo... 阅读详情

相关推荐

人体行为识别:Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset

参考文献:https://arxiv.org/abs/1705.07750 pytorch代码实现:https://github.com/MRzzm/action-recognition-models-pytorch Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset 摘要 由于目前动作分类数据集(UCF-101和HMDB-51)中视频的缺乏,大多数方法在小规模数据集基础上的性能相似,很难得到识别效果好的网络结构,本文根据最

huangyiping12345的博客 1782

动作识别、检测、分割、解析相关数据集介绍

本文将列举介绍目前在动作识别、动作检测、动作分割等相关领域的常用数据集和各自的特点。

小威的博客 6785

【论文精读】Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset

为此,本文提出了一个大规模数据集——Kinetics,以及一种新型的双流膨胀3D卷积网络(I3D),以更好地捕捉视频的时空特征。本文提出的I3D模型通过膨胀操作将2D卷积网络扩展为3D卷积网络,结合双流架构和大规模预训练,显著提升了视频动作识别的性能。I3D(Inflated 3D ConvNet)是本文提出的核心模型,通过将传统的2D卷积网络扩展为3D卷积网络,能够同时捕捉视频的空间和时间特征。膨胀操作的核心是将2D卷积核扩展为3D卷积核,同时初始化3D卷积核的权重为2D卷积核的权重。

nmdbbzcl的博客 470

【数据集】Kinetics-600 dataset介绍

最近在做行为识别,然后介绍一下目前种类多且数据量很大的行为数据集 Kinetics-600 dataset。 参考链接: activityNet:http://activity-net.org/challenges/2018/index.html GitHub:https://github.com/activitynet/ActivityNet kinetics:https://dee...

I am what i am 4万+

kinetics-dataset

动力学数据集 Kinetics是URL链接的大规模,高质量数据集,其中包含多达650,000个视频剪辑,涵盖400/600/700个人类动作类,具体取决于数据集的版本。 这些视频包括诸如乐器之类的人与对象之间的交互,以及诸如握手和拥抱之类的人与人之间的交互。 每个动作类至少具有400/600/700个视频剪辑。 每个剪辑都由一个动作类进行人工注释,并且持续10秒钟左右。 Kinetics项目出版物可以在以下位置找到: : 。 下载视频 CVDF当前在Kinetics-400和Kinetics-700-2020数据集中托管视频。 Kinetics-400 训练/验证/测试拆分细分为许多文件。 可以在这里找到视频文件的链接列表: 通过以下方法很容易获得特定的分割(例如火车): bash download.sh k400_train_path.txt 然后,通过以下方式提取*.ta

kinetics700数据集

一共有600个类别,每个类别至少600个视频以上,每段视频持续10秒左右。类别主要分为三大类:人与物互动,比如演奏乐器;人人互动,比如握手、拥抱;运动等。即person、person-person、person-objec

ST-GCN 自建kinetics数据集

参照的该博主的https://blog.youkuaiyun.com/qq_34551518/article/details/125510050,遇到有些错误,在这里连着流程一起总结一下。

weixin_51691064的博客 1800

避坑指南:Qt无边框窗口拖动+阴影效果这些细节要注意

本文深入探讨了Qt无边框窗口开发中实现流畅拖动与阴影效果的关键细节与常见陷阱。针对高DPI屏幕适配、阴影闪烁、拖动卡顿及多显示器兼容性等核心难题,提供了从QGraphicsDropShadowEffect原理剖析到手动绘制优化、坐标系统精准处理及平台原生事件拦截的实战解决方案,帮助开发者构建稳定、美观的商业级应用界面。

weixin_27943395的博客 479

I3D视频分类论文梗概及代码解读Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset

论文https://arxiv.org/pdf/1705.07750.pdf,from DeepMind ,CVPR2017 代码https://github.com/LossNAN/I3D-Tensorflow 2017年视频分类最好的网络,同时提供了VGG的预训练模型,网络端到端,简单易懂,便于部署及工程化。只是跑一下基本有个Tensorflow,单显卡就能训练和测试,效果还好,一绝。本文...

小小小麦昆的博客 1万+

robomimic实验复现全流程指南:从数据集下载到训练视频生成

本文提供了RoboMimic实验复现的完整实战指南,重点解析了从数据集下载、配置文件定制到模型训练与评估的全流程。以tool_hang任务为例,详细说明了环境准备、数据获取、训练监控及视频生成等关键步骤,并针对常见问题给出了排查方案,帮助研究者高效完成机器人模仿学习实验的闭环验证。

2w3e4r5t6y的博客 1032

UE5实现物体高亮描边效果(含UE相关源码浅析)

UE5实现物体高亮描边效果

专注GIS开发 7334

《Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset》概述

《Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset》概述 引言: 最近阅读了本片论文,这是一篇发表在CVPR’17年的文章,总体上的贡献在于发布了一个新的数据集以及对3D卷积+Two-Stream方法的结合形成一个新的网络架构(I3D),以下是对本篇论文的概述,如有错误,欢迎留言指正。 一、主要贡献: 公布了新的Human Action Video 数据:Kinetics,它有400个人类动作类以及每个类超过400个

一只攻城狮的博客 918

DeepSeek+即梦:AI视频创作从0到1全突破

本文为 DeepSeek 与即梦生成视频全攻略,从前期注册登录、熟悉工具界面及硬件网络准备入手,助读者开启 AI 视频创作。详细阐述利用 DeepSeek 构思脚本、即梦实现画面生成与静态图转动态视频的方法,包括提示词编写、参数调整等技巧。同时介绍后期合成音画、添加字幕特效及多平台适配要点,结合实战案例解析全流程。还分享进阶提示词优化、版权注意等避坑指南,为创作者提供从 0 到 1 的 AI 视频创作完整解决方案。

邓邓子的博客 8108

I3D泛读【Que Vadis,Action Recognition?A New Model and the Kinetics Dataset】

I3D

weixin_47341656的博客 2890

基于Spring Boot 3 + Vue 3 + Vite的现代化社区订餐系统设计与实现

本文将详细阐述系统的整体架构、数据库设计、核心功能模块(用户管理、餐厅管理、菜品浏览、购物车、订单管理)的实现细节,并提供关键代码示例。<el-input v-model="loginForm.password" type="password" placeholder="密码" prefix-icon="Lock" show-password />.requestMatchers("/api/auth/**", "/api/dishes/public/**").permitAll() // 公开接口。

2201_76125393的博客 468

基于Django+Vue3的目标检测系统设计与实现,Web前后端分离,Vue3前台系统+Django后台管理系统开发,YOLOv11 Web目标检测,实现图片、视频和摄像头检测等功能,全网独发

基于Django+Vue3的智能目标检测系统设计与实现,Web前后端分离,YOLOv11 Web目标检测,Vue3前台系统+Django后台管理系统开发,实现图片检测、视频检测、摄像头检测、登录、注册和个人中心功能

在职AI算法工程师,擅长计算机视觉,YOLO目标检测、分割等,擅长web、pyqt界面可视化,好内容持续更新中,来这里跟大家一起学习,共同进步 3667

(I3D)Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset 论文解读

Abstract 本论文提出了一种新的数据集Kinetics、他是ucf101,HMDB-51数据集的的两倍。 论文分别将当前现有的模型在Kinetics数据集上跑一遍,看这些模型在此数据集上表现的如何?,以及在次数据集的预训练下模型在其他数据集上表现的如何? 同时本论文引入了一个新的行为识别模型Two-Stream Inflated 3D ConvNet (I3D) ,I3D是基于2D卷积膨胀的,他将深层图像分类卷积的filters and pooling 的核由2D 膨胀到了3D 使其能够提...

m0_60360632的博客 3922

以太网MII、RMII、GMII、RGMII(三)

RMII接口收发的数据位宽为2bit,因此管脚数目大为减少,在高密端口PHY中应用较多,但是由于其是MAC和PHY共用一个参考时钟,接口之间的距离不能太远;一般的GMII接口都有两个发送参考时钟:TX_CLK和GTX_CLK,两者的方向是不一样的,前者有PHY提供(同MII),后者由MAC或外部参考时钟源提供,绝大多数GMII接口都是兼容MII接口的,在用作MII模式时,使用TX_CLK和8根数据线中的4根。MII接口中的接收时钟和发送时钟是分开的,而且都是由PHY芯片提供给MAC芯片的。

qq_42357877的博客 2332

Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset I3D论文精读

这篇论文的主要贡献有两个。其中一个是提出了inflated膨胀的卷积神经网络,这样就可以把2D里面已经训练好的网络直接扩展到3D,比如VGG,ResNet等,还可以利用一些方式,将预训练模型利用起来,另一个贡献是提出了Kinetics数据集,这是一个大小适中的数据集,它有400类人体行为类别,每个类别有400多个clips。作者提出的I3D模型在Kinetics数据集上预训练之后,在基准数据集HMDB-51和UCF101上分别达到了80.9%和98.0%的准确率,相比之前的模型,效果有了大大的提升。 ...

zhuzyibooooo的博客 1312

标准测试测试数据STDF学习笔记

本文介绍了STDF(Standard Test Data Format)文件的结构与解析方法。首先详细说明了STDF记录的组成,包括记录头类型(REC_TYP和REC_SUB)、数据类型定义、时间日期格式以及无效数据标识。重点分析了25种主要记录类型的功能、数据内容和出现位置,如FAR、MIR、MRR等关键记录。然后介绍了基于pystdf开源工具的解析方法,包括自带脚本的使用和自编程解析流程,通过事件驱动机制处理数据流。特别指出测试数据是按照PIR→PTR/MPR/FTR→PRR的循环模式组织。文章为ATE

歌颂苦难的行为是无耻的; 1513

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

【论文阅读】Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset

【论文阅读】Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset 这是一篇2017CVPR的论文,我感觉这篇论文最大的贡献就是提出了kinetics数据集,这个数据集与之前的行为识别数据集相比有质的飞跃。同时文章也提出一种将2D卷积网络扩张成3D卷积网络的思想,使3D卷积网络可以收益于2D卷积网络的发展。感觉以后行为...

zzmshuai的博客 1万+

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

《Action Recognition》-Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset(I3D)

《Action Recognition》-I3D 目录《Action Recognition》-I3DContributionsExperimentResult Contributions 在新的数据集Kinetics上对当时的SOTA模型进行了实验,并分析了在Kinetics预训练后模型的提升。Kinetics数据集包含了400种动作,每个动作有超过400个片段的视频。 提出了一种新的模型Two Stream Inflated 3D ConvNet(I3D),在HMDB-51和UCF-101数据集上分别

qq_43786852的博客 2791

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

论文阅读【Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset】

论文阅读【Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset】

hei_hei_hei_的博客 924

论文笔记:Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset

论文发表于CVPR2017,先放上论文链接:添加链接描述 在图像领域的大规模ImageNet数据集,对于图像分类、目标检测、语义分割等任务,在其上预训练的模型迁移到相应的数据集时可以获得非常好的效果,从而在ImageNet上进行预训练这一手段被广泛的应用于图像任务。相应的,在视频领域上是否存在这样的大规模视频数据集?在这样的数据集上进行预训练是否可以提高视频行为识别(分类)的精度?该篇文章介绍了大规模视频行为分类数据集Kinetics,并且使用当下常用的行为识别模型,对比了使用预训练前后在UCF101和HM

weixin_45738220的博客 704

逐字稿 | 7 I3D 论文精读【论文精读】Quo Vadis, Action Recognition? A New Model and the Kinetics Datase

接下来我们就一起来精读这篇论文。我选的是最新的 ARCHIVE 版本,是 2018 年 2 月份最后一次更新的,作者上来现在摘要里说,因为这个目前的数据集都太小了,比如说 UCF 101 和 H M D B 51,他们分别有 101 个类别和 51 个类别,而且他们的这个视频数量对于 UCF 来说的话是 13000 个视频, HMDB 是 7000 多个视频,所以说是相当少的。那在这么小的数据集上就往往很难去发挥深度学习的这个威力。

云淡风轻_的博客 951
上一篇: 论文阅读笔记——FLOW MATCHING FOR GENERATIVE MODELING
下一篇: 论文阅读笔记——FLUX.1 Kontext: Flow Matching for In-Context Image Generation and Editing in Latent Space
寻丶幽风
博客等级 码龄5年 656粉丝 72原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
