SD教程·这些常用的Stable Diffusion大模型你知道吗?

部署nsfw_model的过程 nsfw模型环境部署 阅读详情

今天和大家分享一下我们常用的大模型。以便大家在实际应用中针对不同的场景进行AI绘画时使用到的模型有个基本的概念。

01

**基础模型(不推荐使用)

**

基础模型指的是Stable Diffusion自带的大模型,主要包括sd-v1-4、sd-v1-5、sd-v2等大模型,分别对应1.4、1.5和2.0版本。目前1.5版本更好用一些,但是基本没有人会用自带的大模型,因为效果很差。

02

**二次元模型

**

Anything系列

以二次元漫画为主打的模型,出图效果好,但是风格比较单一,对提示词要求也不高。这个模型也是很多SD环境都默认添加的模型之一。

Anything系列的版本比较多,推荐使用V4.0以上的版本。

imgimg

Counterfeit

高质量二次元、人物、风景模型。需要额外加载 VAE 模型,提升色彩表现。

img

img

Cetus-Mix

二次元的混合模型,融合了很多二次元的模型,实际使用效果还不错。对提示词的要求不高。

img

img

**MeinaMix

**

高质量二次元、人物模型。但是模型容易NSFW。因此,要谨慎使用。

imgimg

**Hassaku(NSFW模型)

**

NSFW模型,谨慎使用。

03

**写实模型

**

Chilloutmix

Chilloutmix就是大名鼎鼎的亚洲美女模型。市面上你看到的大量的AI美女,基本上都是这个模型生成的。

imgimg

Deliberate系列

这个模型是一个万能模型,可以出任何你想要的东西。不管是人物动物还是生活用品等都可以还原出来。值得注意的是,这个模型的要求的提示词要尽可能地详细。

imgimg

Realistic Vision系列

该系列能很好地实现极具真实感的人物、动物和环境塑造,还原真实世界风格。它能够生成高度逼真的人脸图像,适用于人机交互、虚拟现实等领域。

img

LOFI

偏人物肖像,镜头感强。

imgimg

04

**2.5D模型

**

国风系列

国人训练的一款专属于中国华丽古风风格模型,非常适用于亚洲东方女性。它能够生成高度逼真的古风游戏角色,适用于游戏、影视等领域。

imgimg

DreamShaper

一个全面而万能的2.5D模型类型,胜任多种风格(写实、原画、2.5D 等),能生成质量很高的人像和风景图。其图像效果具有真实场景的细腻感。

imgimg

PerfectWorld

欧美版的Chilloutmix,主要绘制欧美风格的美女,不过偏2.5D,介于动漫和写实之间。出图基本默认NSFW,需要谨慎使用。

img

到此为止,常见的大模型就介绍完了。

重点说明:本文介绍的是SD的大模型,也就是基础模型,决定生成图片的主要风格的模型,不是Loar模型,也不是VAE模型。

关于AI绘画技术储备

学好 AI绘画 不论是就业还是做副业赚钱都不错,但要学会 AI绘画 还是要有一个学习规划。最后大家分享一份全套的 AI绘画 学习资料,给那些想学习 AI绘画 的小伙伴们一点帮助!

对于0基础小白入门:

如果你是零基础小白,想快速入门AI绘画是可以考虑的。

一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以找到适合自己的学习方案

包括:stable diffusion安装包、stable diffusion0基础入门全套PDF,视频学习教程。带你从零基础系统性的学好AI绘画!

需要的可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

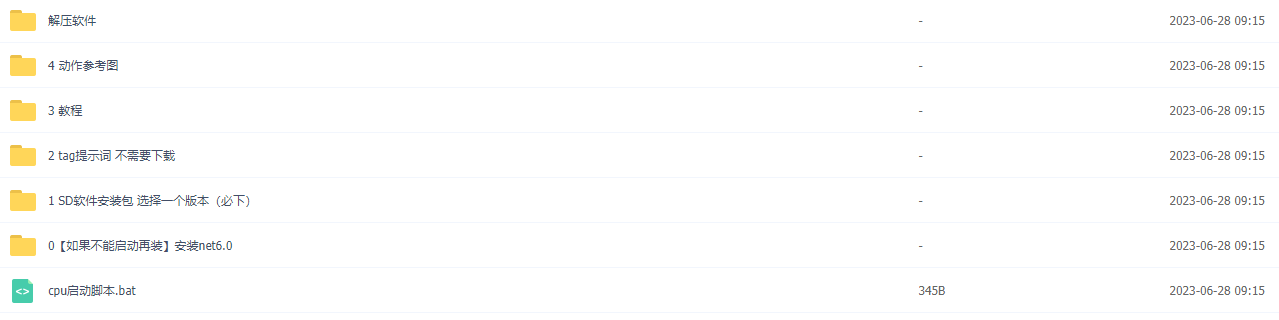
1.stable diffusion安装包 (全套教程文末领取哈)

随着技术的迭代,目前 Stable Diffusion 已经能够生成非常艺术化的图片了,完全有赶超人类的架势,已经有不少工作被这类服务替代,比如制作一个 logo 图片,画一张虚拟老婆照片,画质堪比相机。
请添加图片描述

最新 Stable Diffusion 除了有win多个版本,就算说底端的显卡也能玩了哦!此外还带来了Mac版本,仅支持macOS 12.3或更高版本。
在这里插入图片描述

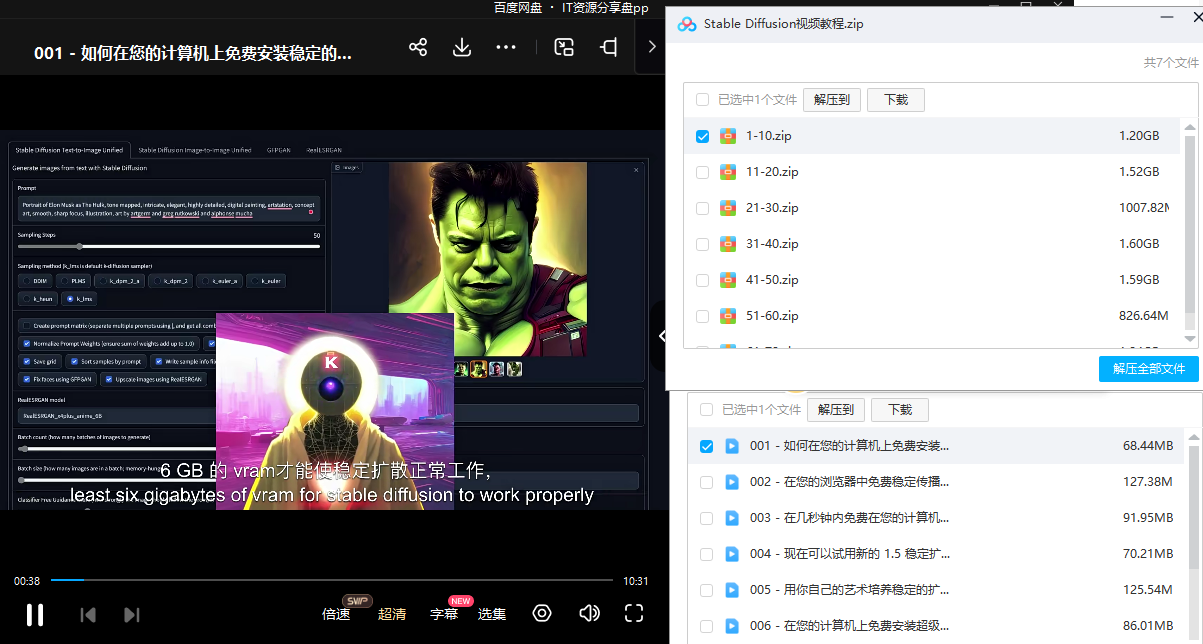
2.stable diffusion视频合集

我们在学习的时候,往往书籍代码难以理解,阅读困难,这时候视频教程教程是就很适合了,生动形象加上案例实战,一步步带你入门stable diffusion,科学有趣才能更方便的学习下去。
在这里插入图片描述

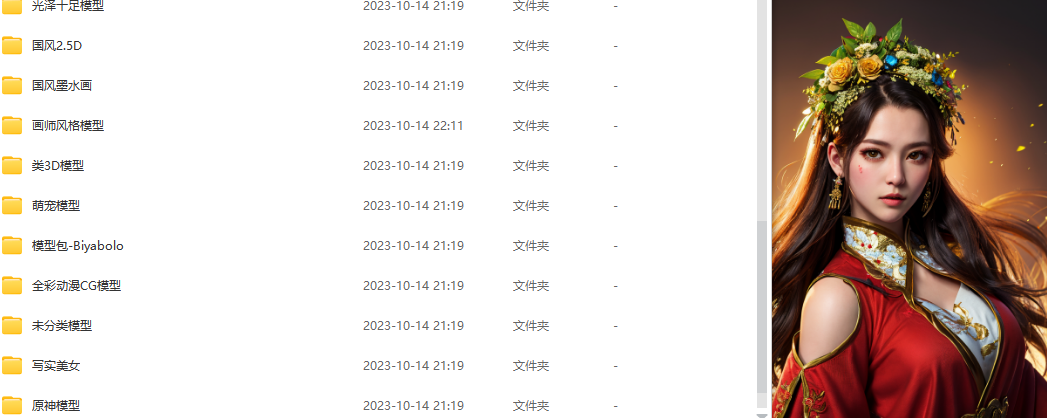
3.stable diffusion模型下载

stable diffusion往往一开始使用时图片等无法达到理想的生成效果,这时则需要通过使用大量训练数据,调整模型的超参数(如学习率、训练轮数、模型大小等),可以使得模型更好地适应数据集,并生成更加真实、准确、高质量的图像。
在这里插入图片描述

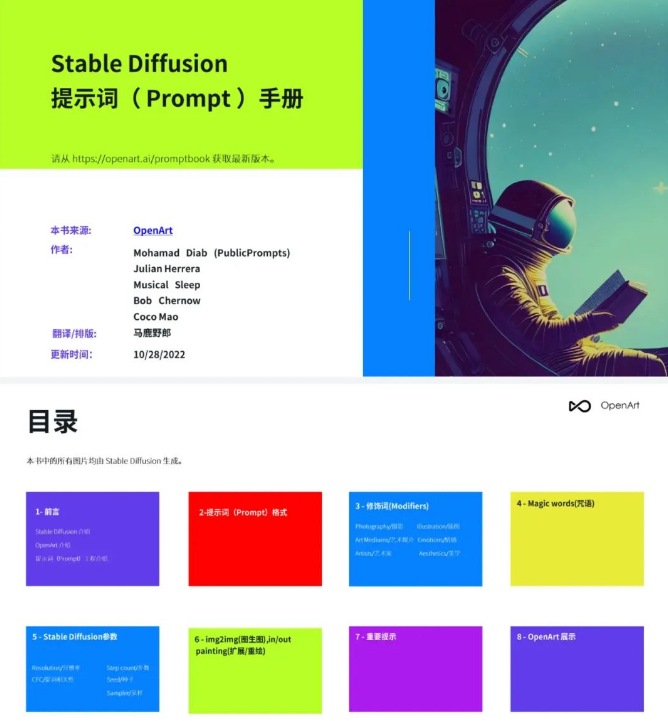
4.stable diffusion提示词

提示词是构建由文本到图像模型解释和理解的单词的过程。可以把它理解为你告诉 AI 模型要画什么而需要说的语言,整个SD学习过程中都离不开这本提示词手册。
在这里插入图片描述

5.AIGC视频教程合集

观看全面零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。
在这里插入图片描述

实战案例

纸上得来终觉浅,要学会跟着视频一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
在这里插入图片描述
这份完整版的学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

请添加图片描述

图片风控NSFW(not suit for work)-1 tensorflow2模型重构 tensorflow2 ResNet50 nsfw 图片风控 not suit for work 阅读详情

相关推荐

图片风控NSFW(not suit for work)-2 基于tf2模型微调

使用tensorflow2 对yahoo开源NSFW模型微调

weixin_42529756的博客 1555

AI绘画Stable Diffusion:常用的大模型,看完就能用

大家好,我是小梁子,今天和大家分享一下我们常用的大模型。大家先了解一下,以便大家在实际应用中针对不同的场景进行AI绘画时使用到的模型有个基本的概念。基础模型(不推荐使用)基础模型指的是Stable Diffusion自带的大模型,主要包括sd-v1-4、sd-v1-5、sd-v2等大模型,分别对应1.4、1.5和2.0版本。目前1.5版本更好用一些,但是基本没有人会用自带的大模型,因为效果很差。二次元模型以二次元漫画为主打的模型,出图效果好,但是风格比较单一,对提示词要求也不高。

阿道夫的博客 1124

Stable Diffusion 常用大模型及其特点

综上所述,SD的常用大模型种类繁多,各有特点。用户可以根据具体需求选择合适的模型进行图像生成或相关任务的处理。

程序猿视角 2676

nsfw模型的搭建(复现实操)

nsfw tf2

Kirito_UGO的博客 5723

Stable Diffusion ComfyUI安装详细教程

ComfyUI安装详细教程(附资源下载链接)

欢迎关注免费星球ComfySpace:https://t.zsxq.com/19H0cfM1O 5967

Stable Diffusion webui安装详细教程

sd-webui详细安装介绍,附webui界面介绍和通用提示词

欢迎关注免费星球ComfySpace:https://t.zsxq.com/19H0cfM1O 4972

这些常用的Stable Diffusion大模型你知道吗?

本文介绍了AI绘画常用的Stable Diffusion大模型分类,包括基础模型、二次元模型、写实模型和2.5D模型。基础模型效果较差不推荐使用;二次元模型推荐Anything V4.0+、Counterfeit、Cetus-Mix等;写实模型推荐Chilloutmix、Deliberate和Realistic Vision系列;2.5D模型包括国风系列和DreamShaper等。文章还附带各类模型的示例图片,并提醒部分模型存在NSFW风险。最后提供了AI绘画学习资料获取方式,包含安装包、视频教程、模型资源

weixin_55154866的博客 3608

tensorflow-open_nsfw:Yahoo的Open NSFW模型的Tensorflow实现

Yahoo的开放NSFW模型的Tensorflow实现 该存储库包含以tensorflow重写的的实现。 原始重量已使用提取 。 您可以在data/open_nsfw-weights.npy找到它们。 先决条件 所有代码均应与Python 3.6和Tensorflow 1.x (经1.12测试)兼容。 该模型的实现可以在model.py找到。 用法 > python classify_nsfw.py -m data/open_nsfw-weights.npy test.jpg Results for 'test.jpg' SFW score: 0.9355766177177429 NSF

SD(Stable Diffusion) 简易教程

国内 - 哩布哩布:https://www.liblib.aiAIGC技术的未来发展前景广阔,随着人工智能技术的不断发展,AIGC技术也将不断提高。未来,AIGC技术将在游戏和计算领域得到更广泛的应用,使游戏和计算系统具有更高效、更智能、更灵活的特性。同时,AIGC技术也将与人工智能技术紧密结合,在更多的领域得到广泛应用,对程序员来说影响至关重要。未来,AIGC技术将继续得到提高,同时也将与人工智能技术紧密结合,在更多的领域得到广泛应用。

qq_41314882的博客 5899

Unity 升级 xLua 版本,编译不同平台链接库

Unity 升级 xLua 详解

LymanCao的专栏 1801

波束形成算法:LCMV实现(MATLAB)

阵列信号处理,波束成形,

weixin_43601588的博客 1万+

【Stable Diffusion教程】SD基础模板及常用节点介绍

有了这个功能,就不再需要记住每个模型的最佳 cfg_scale、实现卡通或现实风格的特定触发词,或者为特定图像类型产生令人印象深刻的结果的设置!这是一位SD资深大神整理的,100款Stable Diffusion超实用插件,涵盖目前几乎所有的,主流插件需求。在我们出图的时候,最头疼的就是出的图哪有满意,就是手部经常崩坏。希望能让大家在使用Stable Diffusion工具时,可以更好、更快的获得自己想要的答案,以上。这个插件提供双语翻译功能,使得界面可以支持两种语言,对于双语用户来说是一个很有用的功能。

m0_71745258的博客 2310

vivado2020.1使用vitis生成QSPI启动文件报错

在使用vivado2020.1使用vitis,生成QSPI启动文件时会报错,data2mem命令无法识别,这是因为data2mem是xilinx7series芯片的命令,当使用ultrascale/ultrascale+芯片时则需要使用updatemem命令,这或许是vitis的一个bug吧,明明选择的是ultrascale的芯片,却一直调用打她mem命令,挺麻烦的,需要手动执行,在XSCT console窗口执行的命令如下: updatemem -force -meminfo \ F:/xc7z35t/x

qq_32134427的博客 2336

【stable diffusion教程】免费好软件分享 SD AI做图,Stable Diffusion 下载+安装+使用教程_stable diffusion免费使用

本教程介绍了一种使用“整合包”在本地部署和安装Stable Diffusion WebUI的方法,无需深入了解计算机知识,对新手非常友好。要注意的是,安装时需要预留100G到200G的磁盘空间,并且对电脑的显卡要求较高。本文介绍的工具是【绘世整合包】,由秋叶大佬开发,是目前市面上最简便的Stable Diffusion整合包之一。这个整合包跳过了大部分需要网络和Python知识的步骤,集成了过去几个月里AI绘画领域最核心的插件,如ControlNet,并且自带最新的深度学习模块。

2401_84760719的博客 1303

[MTK][Android P]如何去掉差分包中的preloader分区

最近碰到一个问题,在进行差分升级的时候,会因为某些原因导致preloader hash值不匹配,升级失败,所以需要在差分升级的时候不升级preloader。 解决的方法,就是在制作AB分区的差分升级包的时候,把目标zip解压出来,把ab_partitions.txt中的分区名去掉,同时把preloader.img去掉 修改如下: Project/build/tools/releasetool...

thonmin的专栏 1434

【图像压缩】超先验模型 《VARIATIONAL IMAGE COMPRESSION WITH A SCALE HYPERPRIOR》

绪论 2015年,第一个端到端图像编码方案被提出。基于深度学习的端到端图像压缩主要分为两类,一类是基于RNN的方法,一类是基于CNN的方法。本文对基于CNN的方法

hahalidaxin的专栏 1万+

SD(Stable Diffusion) 简易教程来啦!

2.启动器下载,可以在启动器模型管理选择对应的模型直接下载。

z19981的博客 2047

在linux上本地大模型部署与推理

您的Python脚本(客户端)可能在您的个人电脑上,而模型服务(服务器)在远程Linux服务器上。如果您的服务器有强大的NVIDIA GPU,并且您对性能有更高的要求(例如需要高吞吐量),vLLM是更好的选择。这种方式无需向公网暴露服务器端口,而是通过加密的SSH通道将服务器的端口“映射”到您的本地电脑上。我们将启动一个API服务器,它会加载您指定的模型,并等待您的代码前来调用。如果您直接在SSH窗口运行上面的命令,一旦您关闭窗口,服务就会停止。这是根据您的原始代码修改的版本,适配本地vLLM服务。

frostmelody 全网同名,大家多多关注呀~ 持续分享优质内容! 2053

免费好软件分享 SD AI做图,Stable Diffusion 下载+安装+使用教程

本文介绍的工具是【绘世整合包】,由秋叶大佬开发,是目前市面上最简便的Stable Diffusion整合包之一。这个整合包跳过了大部分需要网络和Python知识的步骤,集成了过去几个月里AI绘画领域最核心的插件,如ControlNet,并且自带最新的深度学习模块。整合包能够与外部环境完全隔离,即便没有任何编程背景的人,也可以从零开始学习使用Stable Diffusion,并在几乎不需要进行额外设置的情况下,立即体验最新的技术成果。

libaiup的博客 1794

18、近端策略优化(PPO)算法详解

本文详细介绍了近端策略优化(PPO)算法的理论基础、算法流程、实现方法及实际应用。PPO作为当前最受欢迎的策略梯度算法之一,具有易于实现、计算成本低、样本效率高和性能优越等优点。文章对比了基于自适应KL惩罚和基于裁剪目标的两种PPO变体,重点解析了裁剪目标函数的设计原理及其在Actor-Critic框架下的实现方式,并通过Atari Pong游戏展示了完整的训练配置与流程。最后总结了PPO的优势、适用场景及未来发展方向,为强化学习研究者和实践者提供了全面的参考。

mongodb5scout的博客 177

【Qt图书管理系统】5.完整版源码及下载地址

Qt图书管理系统完整源码下载。

小鱼酱的博客 7001

【SD】Stable Diffusion 本地部署教程

最近看Stable Diffusion开源了,据说比Disco Diffusion更快,于是从git上拉取了项目尝试本地部署了,记录分享一下过程~这里是官网介绍:https://stability.ai/blog/stable-diffusion-public-release。

2401_85688943的博客 1660

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Stable Diffusion保姆级教程,小白也可以掌握SD使用

以上就是本期给大家带来的 Stable Diffusion 的详细内容介绍和使用方法介绍,时间有限很多详细信息不能给大家完全介绍到位,有需要资料的可以扫码下方插件,获取资料噢。

2401_85688943的博客 1263

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

上一篇: SD教程·Stable Diffusion教程:LoRA模型
下一篇: 【Comfyui教程】Mv-Adapter 一招搞定人物、物体多视角图像生成
网络安全-XG
博客等级 码龄5年 1万+粉丝 2752原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值