


SegNet: A Deep Convolutional Encoder-Decoder Architecture for Image Segmentation
SegNet新颖之处在于解码器对其较低分辨率的输入特征图进行上采样的方法。具体的说,解码器使用了在相应编码器的最好池化步骤中计算的池化索引来执行非线性上采样。这种房型消除了学习上采样的需要。经上采样后的特征图是稀疏的,因此随后使用可训练的卷积核进行卷积操作,生成密集的特征图。
SegNet也没有全连接层。SegNet和FCN的思路相似,不同之处在于解码器使用从编码器传输的较大池化索引(位置)对其输入进行非线性上采样,从而使得上采样不需要学习,生成稀疏特征映射。然后,使用可训练的卷积核进行卷积操作,生成密集的特征图。最后的解码器输出特征映射被送入soft-max分类器进行像素级分类。
创新点:
- 1.提出encoder-decoder架构
- 2.上采样方式:SegNet用记录的池化过程的位置信息替代直接的反卷积操作。即上采样的方式是采用unpooling来对decoder上的特征层进行上采样。即可以改善物体的边界;又可以减少计算参数量;并且模块化,易于在别的神经网络架构中使用
一些其他的网络架构:
- 1.多阶段的训练
- 2.网络先预训练
- 3.使用额外的RPN来推断
- 4.分类和分割联合
- 5.将RNN将到FCN上或者在大的数据集上微调
- 6.对输入图像的尺寸进行变换或对不同特征层的的特征图 提供一个局部和全局的内容
文章架构
-
1.Introduction
-
2.Releted recent literature
分析目前方法所存在的缺点,FCN的encoder(134M)和decode(0.5M)r的参数,不适合端到端的训练
而该文是将encoder的VGG16的全连接层丢弃掉并且不影响性能,但减轻了内存消耗以及改善了推理时间。受unsupervised feautre learning architecture
- 3.SegNet architecture and analysisi
相比较DeconvNet有着大量的参数,更高的计算量,很难进行端到端的训练。
提出SegNet-Basic结构 权重初始化方式 “Delving deep into rectifiers:Surpassing human-level performance on imagenet classification stochastic gradient descent (SGD) with a fixed learning rate of 0.1 and momentum of 0.9
class balancing median frequency balancing
评测指标:global accuracy (G) which measures the percentage of pixels correctly classified in the dataset;class average accuracy © is the mean of the predictive accuracy over all classes mean intersection over union (mIoU) over all classes as used in the Pascal VOC12 challenge
F1-measure评测轮廓which involves computing the precision and recall values between the predicted and ground truth class boundary given a pixel tolerance distance.
- 4.Evaluate
两个数据集上进行评测 数据集图 效果图 表格图 方法图
- 5.Future work
时间内存以及计算资源; 可嵌入式设备
- 6.Conclude
SegNet网络架构
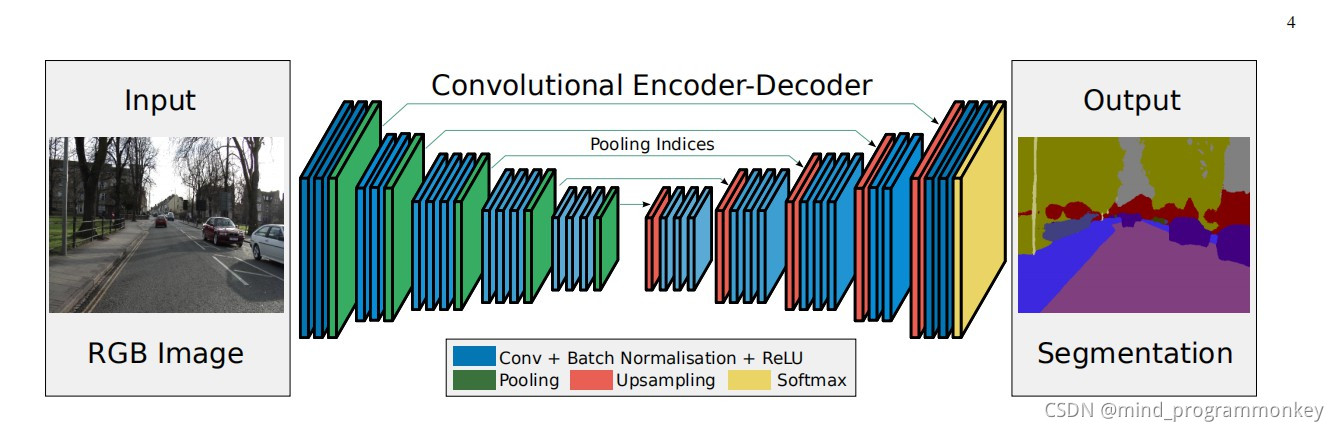
两个易混淆的点:
- 不管是encoder还是decoder,segnet中的卷积都是same填充的,所以都不改变输出特征的大小;大小的改变是通过池化层的上采样,下采样实现的;
- 在decoder中,论文中称之为“反卷积”,实际上,这只是为了使用这个称呼而已,它并不是真正意义上的反卷积,它就是一个普通的卷积操作。
Segnet的encoder过程中,卷积的作用是提取特征,segnet使用的卷积为same卷积,即卷积后不改变图片大小;而在decoder过程中,同样使用same卷积,不过卷积的作用是为upsampling变大的图像丰富信息,使得在pooling过程丢失的信息可以通过学习在decoder中得到。
蓝色部分:普通的conv+bn+relu的标准结构
绿色部分:下采样过程,即pooling过程,这会使得图像变得更小,得到低分辨率的特征图;
红色部分:上采样过程,即upppoling过程,这会恢复到原来图像的大小,得到高分辨率的特征图,直到恢复原来的图像大小;
SegNet网络架构由encoder-decoder组成。
左边encoder部分用VGG-16进行提取特征并保存池化索引;使用的卷积为same卷积,即卷积后保持图像原始尺寸。通过pooling操作增大感受野
右边decoder部分是一个反卷积(这里的反卷积与卷积无区别)与Upsampling的过程,upsampling还原到图像原始尺寸,通过反卷积(同样是same卷积)为upsampling变大的图像丰富信息。
最后通过softmax,输出不同分类的最大值,得到最终分割图。
upsampling操作
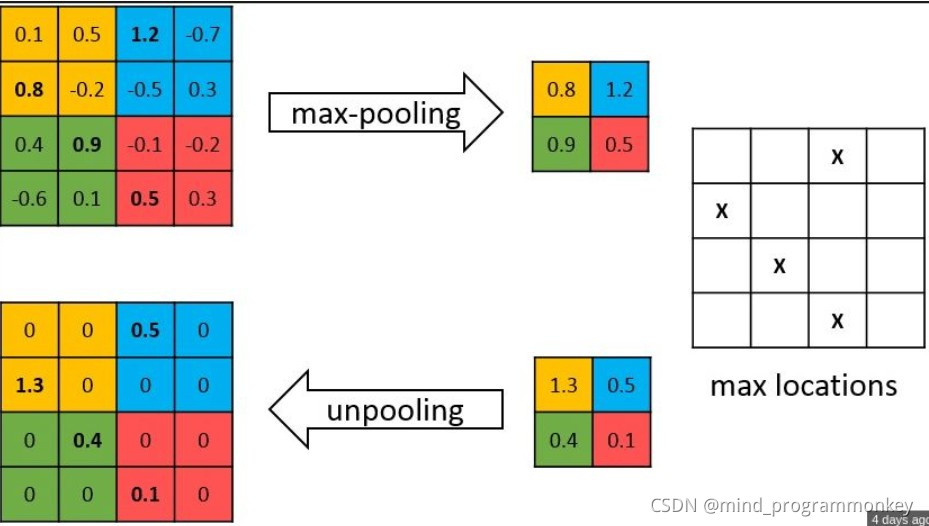
如上图,将编码器中额每一个最大池化层的索引都存储起来,用于之后在解码器中使用那些存储的索引来对相应特征图进行上池化的操作。这有助于保持高频信息的完整性,但当对低分辨率的特征图进行去池化,它也会忽略邻近的信息。
上采样使用池化层索引的优势:
- 提升边缘刻画度;
- 减少训练的采纳数;
- 这种模式可包含到任何的编码-解码网络中
关键代码池化层
class MaxPoolingWithArgmax2D(Layer):

    def __init__(
            self,
            pool_size=(2, 2),
            strides=(2, 2),
            padding='same',
            **kwargs):
        super(MaxPoolingWithArgmax2D, self).__init__(**kwargs)
        self.padding = padding
        self.pool_size = pool_size
        self.strides = strides

    def call(self, inputs, **kwargs):
        padding = self.padding
        pool_size = self.pool_size
        strides = self.strides
        if K.backend() == 'tensorflow':
            ksize = [1, pool_size[0], pool_size[1], 1]
            padding = padding.upper()
            strides = [1, strides[0], strides[1], 1]
            output, argmax = K.tf.nn.max_pool_with_argmax(
                inputs,
                ksize=ksize,
                strides=strides,
                padding=padding)
        else:
            errmsg = '{} backend is not supported for layer {}'.format(
                K.backend(), type(self).__name__)
            raise NotImplementedError(errmsg)
        argmax = K.cast(argmax, K.floatx())
        return [output, argmax]

    def compute_output_shape(self, input_shape):
        ratio = (1, 2, 2, 1)
        output_shape = [
            dim // ratio[idx]
            if dim is not None else None
            for idx, dim in enumerate(input_shape)]
        output_shape = tuple(output_shape)
        return [output_shape, output_shape]

    def compute_mask(self, inputs, mask=None):
        return 2 * [None]


class MaxUnpooling2D(Layer):
    def __init__(self, up_size=(2, 2), **kwargs):
        super(MaxUnpooling2D, self).__init__(**kwargs)
        self.up_size = up_size

    def call(self, inputs, output_shape=None):

        updates, mask = inputs[0], inputs[1]
        with K.tf.variable_scope(self.name):
            mask = K.cast(mask, 'int32')
            input_shape = K.tf.shape(updates, out_type='int32')
            #  calculation new shape
            if output_shape is None:
                output_shape = (
                    input_shape[0],
                    input_shape[1] * self.up_size[0],
                    input_shape[2] * self.up_size[1],
                    input_shape[3])

            # calculation indices for batch, height, width and feature maps
            one_like_mask = K.ones_like(mask, dtype='int32')
            batch_shape = K.concatenate(
                [[input_shape[0]], [1], [1], [1]],
                axis=0)
            batch_range = K.reshape(
                K.tf.range(output_shape[0], dtype='int32'),
                shape=batch_shape)
            b = one_like_mask * batch_range
            y = mask // (output_shape[2] * output_shape[3])
            x = (mask // output_shape[3]) % output_shape[2]
            feature_range = K.tf.range(output_shape[3], dtype='int32')
            f = one_like_mask * feature_range

            # transpose indices & reshape update values to one dimension
            updates_size = K.tf.size(updates)
            indices = K.transpose(K.reshape(
                K.stack([b, y, x, f]),
                [4, updates_size]))
            values = K.reshape(updates, [updates_size])
            ret = K.tf.scatter_nd(indices, values, output_shape)
            return ret

    def compute_output_shape(self, input_shape):
        mask_shape = input_shape[1]
        return (
            mask_shape[0],
            mask_shape[1] * self.up_size[0],
            mask_shape[2] * self.up_size[1],
            mask_shape[3]
        )
在网上搜集资料的过程中,发现有用UpSampling2D()函数来上采样将原始图片扩大,再用Conv2D()函数进行卷积操作
UpSampling只是简单的用复制插值对原张量进行修改,也就是平均池化的逆操作。
而FCN的上卷积的函数是Conv2DTranspose
VGG encoder层
def vgg_encoder(n_classes,input_height,input_width):

    assert  input_height % 32 == 0
    assert  input_width % 32 == 0

    img_input = Input(shape=(input_height, input_width, 3))

    # Block1
    x = layers.Conv2D(64,(3,3),activation="relu",padding="same",name="block1_conv1")(img_input)
    x = layers.Conv2D(64,(3,3),activation="relu",padding="same",name="block1_conv2")(x)
    x, mask1 = MaxPoolingWithArgmax2D(name="block1_pool")(x)
    f1 = x

    # Block2
    x = layers.Conv2D(128,(3,3),activation="relu",padding="same",name="block2_conv1")(x)
    x = layers.Conv2D(128,(3,3),activation="relu",padding="same",name="block2_conv2")(x)
    x, mask2 = MaxPoolingWithArgmax2D(name="block2_pool")(x)
    f2 = x

    # Block3
    x = layers.Conv2D(256,(3,3),activation="relu",padding="same",name="block3_conv1")(x)
    x = layers.Conv2D(256,(3,3),activation="relu",padding="same",name="block3_conv2")(x)
    x = layers.Conv2D(256,(3,3),activation="relu",padding="same",name="block3_conv3")(x)
    x, mask3 = MaxPoolingWithArgmax2D(name="block3_pool")(x)
    f3 = x

    # Block4
    x = layers.Conv2D(512,(3,3),activation="relu",padding="same",name="block4_conv1")(x)
    x = layers.Conv2D(512,(3,3),activation="relu",padding="same",name="block4_conv2")(x)
    x = layers.Conv2D(512,(3,3),activation="relu",padding="same",name="block4_conv3")(x)
    x, mask4 = MaxPoolingWithArgmax2D(name="block4_pool")(x)
    f4 = x

    # Block5
    x = layers.Conv2D(512,(3,3),activation="relu",padding="same",name="block5_conv1")(x)
    x = layers.Conv2D(512,(3,3),activation="relu",padding="same",name="block5_conv2")(x)
    x = layers.Conv2D(512,(3,3),activation="relu",padding="same",name="block5_conv3")(x)
    x,mask5 = MaxPoolingWithArgmax2D(name="block5_pool")(x)
    f5 = x

    return img_input, [f1, f2, f3, f4, f5],[mask1,mask2,mask3,mask4,mask5]
SegNet
def SegNet_decoder(n_classes,levels,masks):

    [f1,f2,f3,f4,f5] = levels
    [mask_1,mask_2,mask_3,mask_4,mask_5] = masks

    #解码层1
    unpool_1 = MaxUnpooling2D()([f5,mask_5])
    y = Conv2D(512,(3,3),padding="same")(unpool_1)
    y = BatchNormalization()(y)
    y = Activation("relu")(y)
    y = Conv2D(512, (3, 3), padding="same")(y)
    y = BatchNormalization()(y)
    y = Activation("relu")(y)
    y = Conv2D(512, (3, 3), padding="same")(y)
    y = BatchNormalization()(y)
    y = Activation("relu")(y)

    unpool_2 = MaxUnpooling2D()([y, mask_4])
    y = Conv2D(512, (3, 3), padding="same")(unpool_2)
    y = BatchNormalization()(y)
    y = Activation("relu")(y)
    y = Conv2D(512, (3, 3), padding="same")(y)
    y = BatchNormalization()(y)
    y = Activation("relu")(y)
    y = Conv2D(256, (3, 3), padding="same")(y)
    y = BatchNormalization()(y)
    y = Activation("relu")(y)

    unpool_3 = MaxUnpooling2D()([y, mask_3])
    y = Conv2D(256, (3, 3), padding="same")(unpool_3)
    y = BatchNormalization()(y)
    y = Activation("relu")(y)
    y = Conv2D(256, (3, 3), padding="same")(y)
    y = BatchNormalization()(y)
    y = Activation("relu")(y)
    y = Conv2D(128, (3, 3), padding="same")(y)
    y = BatchNormalization()(y)
    y = Activation("relu")(y)

    unpool_4 = MaxUnpooling2D()([y, mask_2])
    y = Conv2D(128, (3, 3), padding="same")(unpool_4)
    y = BatchNormalization()(y)
    y = Activation("relu")(y)
    y = Conv2D(64, (3, 3), padding="same")(y)
    y = BatchNormalization()(y)
    y = Activation("relu")(y)

    unpool_5 = MaxUnpooling2D()([y, mask_1])
    y = Conv2D(64, (3, 3), padding="same")(unpool_5)
    y = BatchNormalization()(y)
    y = Activation("relu")(y)

    y = Conv2D(n_classes, (1, 1), padding="same")(y)
    y = BatchNormalization()(y)
    y = Activation("relu")(y)

    y = Reshape((-1, n_classes))(y)
    y = Activation("softmax")(y)

    return y
def SegNet(n_classes,input_height,input_width):

    assert input_height % 32 == 0
    assert input_width % 32 == 0

    img_input,levels,masks =vgg_encoder(n_classes,input_height,input_width)

    output = SegNet_decoder(n_classes,levels,masks)

    Vgg_SegNet = Model(img_input,output)
    return Vgg_SegNet

 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


