SkillsVote:从技能目录走向终极技能网关(Ultimate Skill Gateway)

成千上万个 skills 摆在面前,你的 Agent 为什么还是不会干活?

2025 年底 Anthropic 把 Agent Skills 规范作为开放标准发布,OpenAI 在 Codex CLI 里跟进了同一套格式,Cursor、Gemini CLI 也陆续接入。有人说 2026 是"Agent 找到工作并开始写周报"的一年——工具连接标准化了,流程知识模块化了,分发机制也产品化了。

GitHub 上的 SKILL.md 文件数量爆炸式增长,SkillsMP 号称 70 万+,LobeHub、SkillHub、Manus 等各种技能市场纷纷上线。看起来,Agent 从此再也不缺装备了。

但事情没那么美好。

你大概经历过这种场景:让 Agent 去处理一份 PDF 表单,然后从技能库里信心满满地挑了一个 skills,执行到一半直接 crash——因为那个 skills 依赖一个只能本地安装的命令行工具,而你的 Agent 跑在云端沙箱里。

这不是你的运气差。今年 2 月发表的 SkillsBench 论文跑了 7,308 条 Agent 执行轨迹,发现:精心策划的 skills 平均能提升 16.2% 通过率——但 84 个任务里有 16 个反而因为 skills 变差了。让 Agent 自己生成 skills?平均效果为负。

skills 数量从来不是瓶颈。怎么找到对的 skills、怎么确认它能跑、跑完之后怎么知道它到底行不行——这才是。

SkillsVote 就是来解决这个问题的。
图片

SkillsVote 到底是什么?

SkillsVote 是面向客户端 Agent 的终极技能网关(Ultimate Skills Gateway)。

不仅是技能目录——那是主要给人浏览的。

不只是技能市场——那是主要给人安装的。

SkillsVote 是给正在干活的人、Agent、AI 应用......的。我们希望通过它解决的问题是:在执行任务的时候,怎么自动找到对的 skills,并确认这个 skills 在当前环境能跑得好?

打个不太严谨的比方:现有的技能市场是 App Store——你自己逛、自己挑、自己装。SkillsVote 更像是操作系统里的包管理器 + 依赖解析 + 运行时监控——你,甚至是你的 Agent 只需要说"我要处理 PDF",剩下的事情交给 SKillsVote

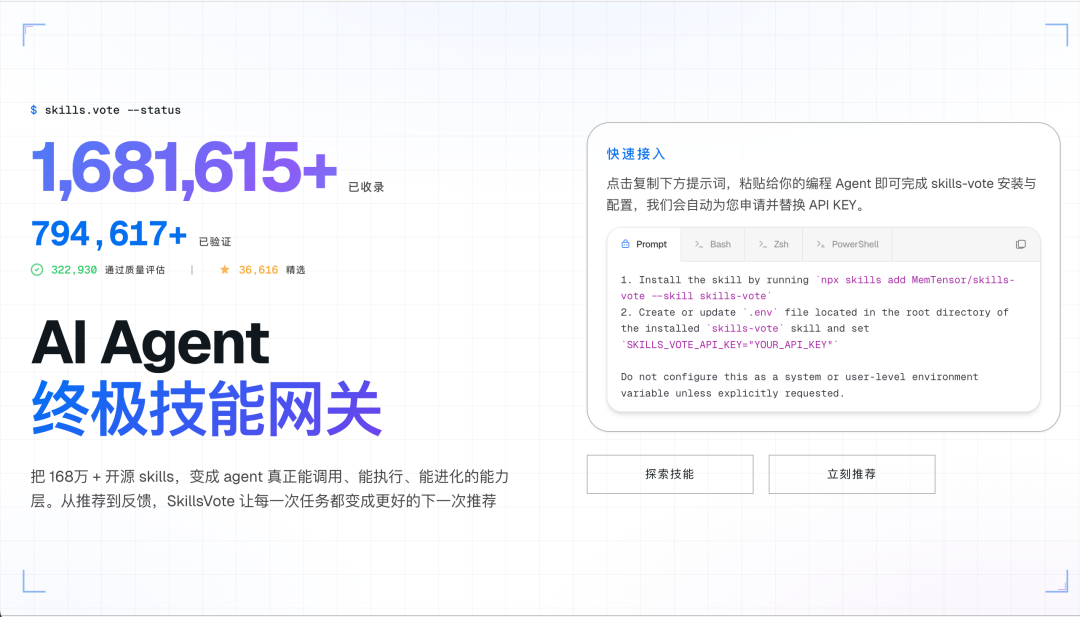
截至目前,SkillsVote 收录了 168 万+ Agent Skills,其中通过 Anthropic 官方脚本格式校验的有 79 万+,全部来自 GitHub 开源生态——这是目前全球规模最大的 Agent 技能库。

为什么 Agent 需要"技能网关"而不是"更多技能"

今天的 Agent Skills 生态有点像 npm 早期——包的数量在疯涨,但质量参差不齐,依赖关系一团糟,你装了一个包发现它依赖另外三个你环境里根本没有的东西。

对于一个正在执行任务的客户端 Agent,真正的卡点是四件事:

  1. 发现——几十万个 skills 里,哪个和当前任务最匹配?不是"大概相关",是"真的能用"。

  2. 适配——找到了,但它在我的运行环境里能跑吗?要什么权限?要联网吗?依赖什么包?

  3. 归因——跑完了,成功了还是失败了?如果失败了,是 skills 写得烂还是我选错了还是环境不兼容?

  4. 迭代——这么多任务跑下来,系统能不能从中学到点什么,别让同样的坑踩第二次?

这四个环节只要断一个,skills 就只是一堆 markdown 文件躺在 GitHub 上。

SkillsVote 是怎么做的?两个接口,一条闭环

SkillsVote 的架构其实不复杂,核心就两个接口。

1. recommend:Agent 问"我该用什么 skills"

客户端 Agent 接到用户 query 后,将其改写为面向技能检索的请求,调用这个接口。系统结合 Agent 改写后的 query 和客户端上下文,从 160 万+ skills 库里返回最相关的一组 skills,附上推荐理由和使用指南(包含对所推荐技能的编排建议)。

Agent 不用再自己"猜"了。它在关键节点拿到的是一个经过筛选的候选列表,加上"为什么推荐这个"的解释和"怎么组合使用"的执行编排。
图片

2. feedback:Agent 说"这次用得怎么样"

任务结束后,Agent 把执行摘要回传:子任务目标、实际调用了哪些 skills、成功还是失败、证据是什么、运行环境是什么样的。

这些反馈直接回流到技能系统里,持续优化推荐策略。

所以 SkillsVote 不是一个搜索引擎。它是一条完整的闭环:推荐 → 执行 → 反馈 → 进化 → 更好的推荐

用得越多,推得越准。

一行命令接入,现在就能用

SkillsVote 的能力本身就被封装成了一个标准的 Agent Skill,支持 Codex、Claude Code、OpenClaw 等主流客户端。接入只需要一行代码:

npx skills add MemTensor/skills-vote --skill skills-vote
装好之后,整个 recommend → 执行 → feedback 的流程对用户完全透明——你只需要正常给 Agent 下任务,它会在合适的时机自动调用 SkillsVote 的服务。

产品网站:https://skills.vote

开源仓库:https://github.com/MemTensor/skills-vote

用一个真实任务看 SkillsVote 怎么工作

我们使用了一个真实任务跑一遍——"收集 MemTensor 和 Memos 的公开信息,做一个 PPTX 演示文稿,再生成 HTML 版本并本地部署",并进行了对比测试。

SkillsVote Gateway

find-skills 搜索安装

完全不用 skill

耗时

26m 29s

45m 14s

29m 33s

skills 选择

系统推荐,附推理过程和执行指南

Agent 自己搜索判断

无

执行引导

有步骤拆解 + skills 间数据流转说明

无

无

反馈回流

有,自动回传执行摘要

无

无

系统进化(研发中)

每次执行都让推荐更准

不进化

不进化

SkillsVote 的价值不只是"快了一点",而是整个工作流被结构化了:从"推荐什么 skills"到"怎么组合使用"到"执行完反馈回来",每一步都有迹可循,而且每一次执行都在让系统变得更聪明。

实际流程和效果

任务是这样的:"收集 MemTensor 和 Memos 的公开信息,整理成结构化内容,做一个精美的 PowerPoint 演示文稿,再生成一个 HTML 版本并本地部署到 9001 端口。"

第一步:Agent 向 SkillsVote 请求推荐

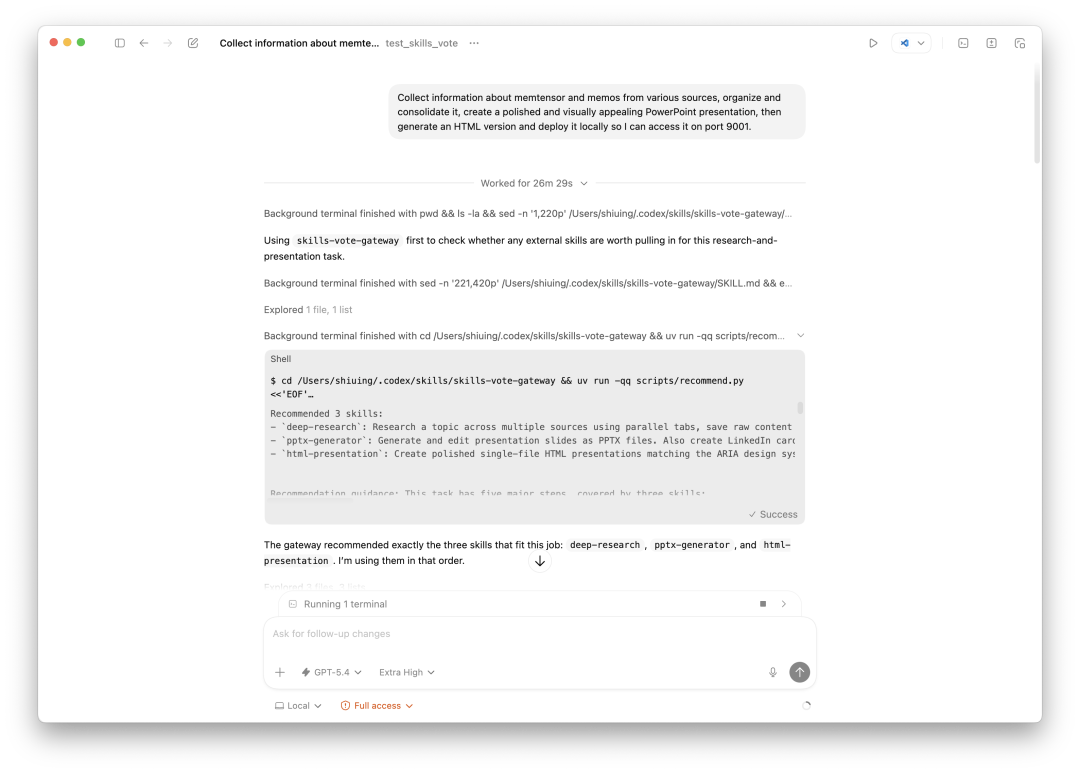
Agent 拿到任务后,开始调用 skills-vote 的 recommend 接口。
图片

[Codex 终端中,Agent 调用 recommend 脚本,返回推荐结果:deep-research、pptx-generator、html-presentation 三个 skills]

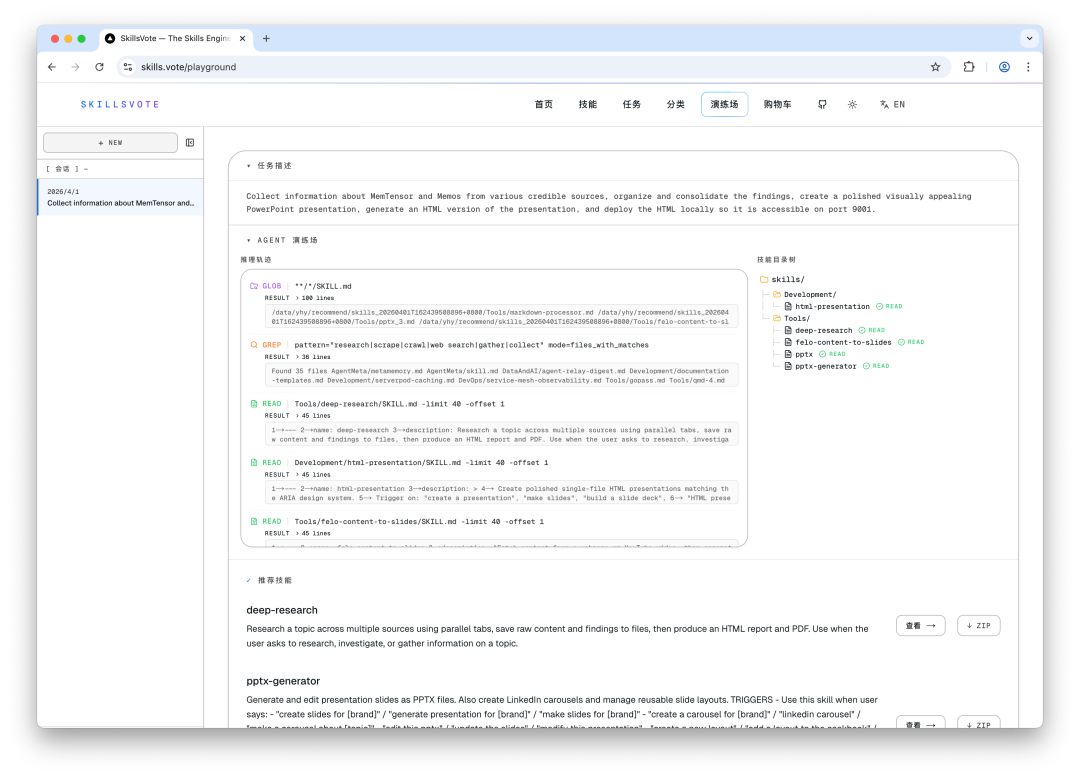
在 SkillsVote 的网页 Playground 里,你可以看到推荐背后的完整推理过程:系统读了哪些 SKILL.md、做了哪些 GREP、遍历了 Skills Directory Tree 中的哪些分支,每一步都有 trace。
图片

[SkillsVote Playground 网页端,展示 AGENT RECOMMEND 的 Reasoning Trajectory 和 Skill Directory Tree]

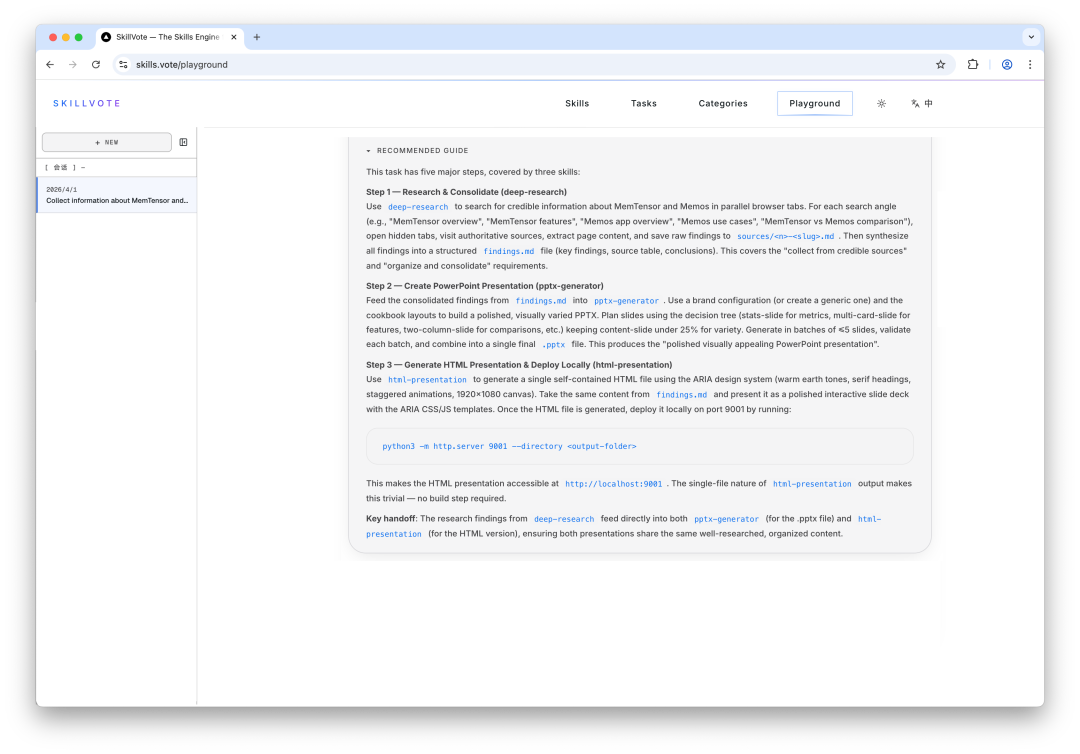
更关键的是,系统不只是告诉 Agent "用这三个 skills",还生成了一份 RECOMMENDED GUIDE——把任务拆解成具体步骤,每一步对应哪个 skills、怎么衔接、中间产物怎么传递,都写得清清楚楚:

  • Step 1:用 deep-research 做多源信息搜集,产出 findings.md;

  • Step 2:把 findings.md 喂给 pptx-generator,生成 PPTX;

  • Step 3:用 html-presentation 生成单文件 HTML 演示,部署到本地端口。

图片

[RECOMMENDED GUIDE 详情,展示三步执行计划和 skills 间的数据流转关系]

第二步:Agent 按推荐执行

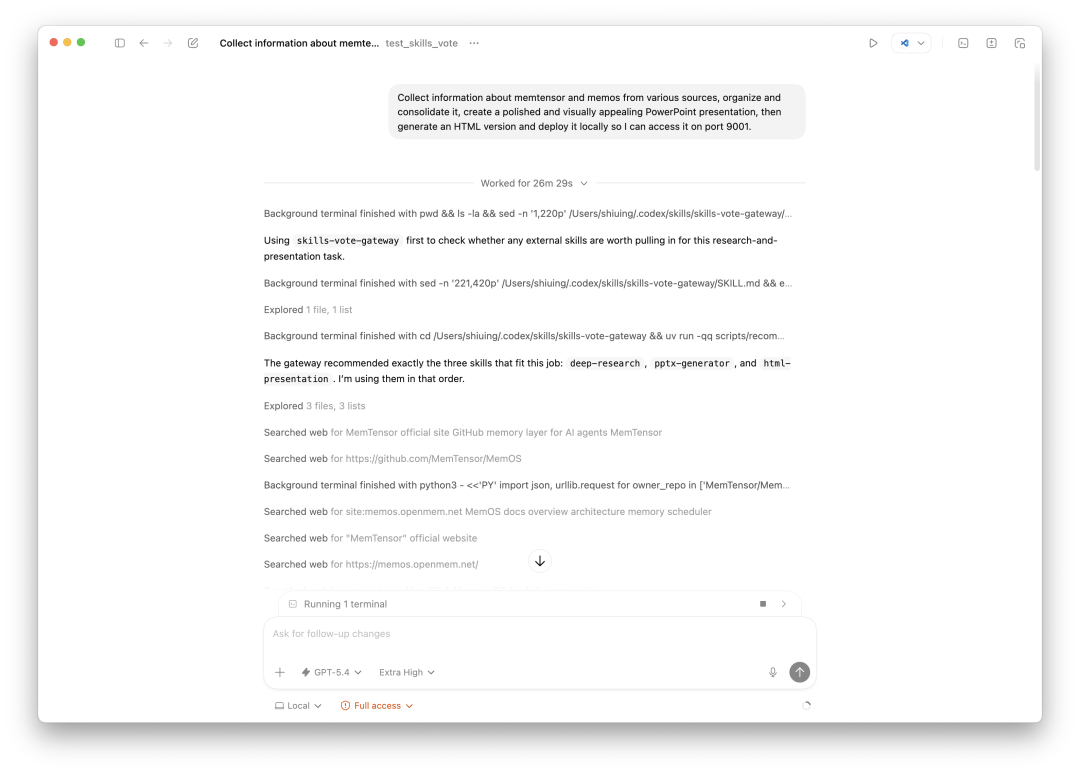
拿到推荐后,Agent 按顺序开始干活——搜索 MemTensor 官网、抓 GitHub metadata、访问 MemOS 文档、汇总信息、生成 PPTX、构建 HTML 演示、启动本地服务。
图片

[Agent 执行过程,搜索 web、获取 GitHub 信息、逐步推进]

整个任务在 26 分 29 秒 内完成。

第三步:Agent 回传反馈

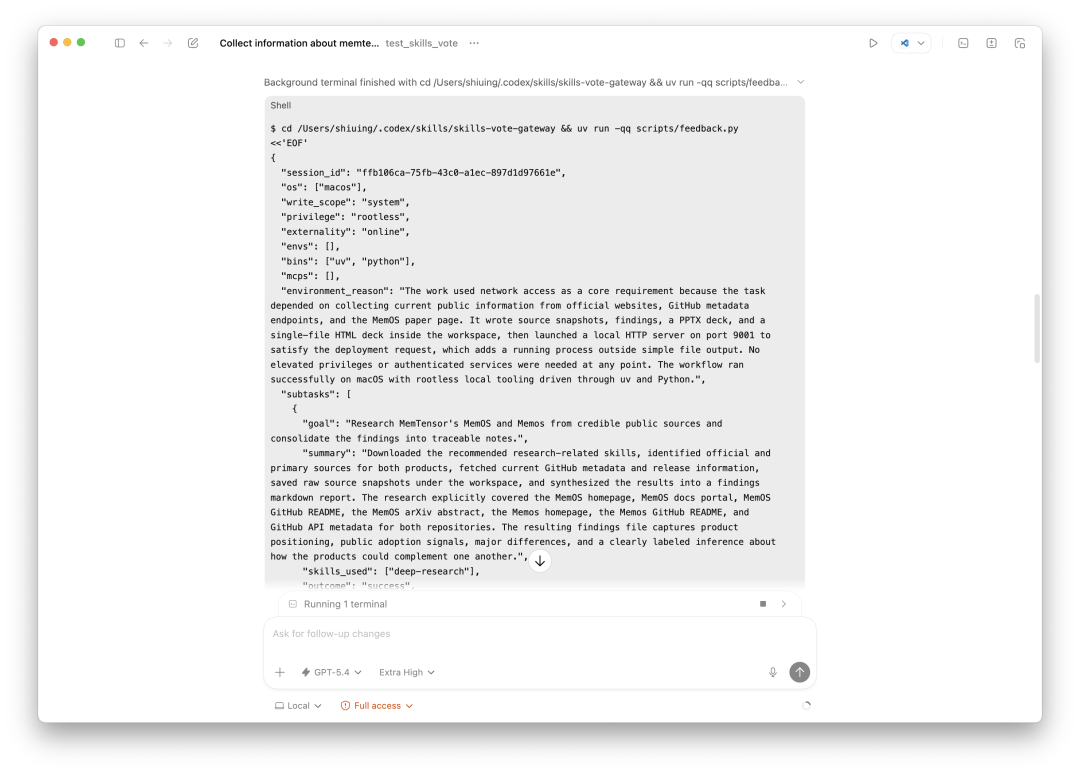
任务结束后,Agent 自动调用 feedback 接口,把这次执行的完整摘要回传给 SkillsVote:
图片

[Codex 终端中,Agent 调用 feedback 脚本,回传 JSON 格式的执行摘要,包含 session_id、os、write_scope、privilege、子任务列表等]

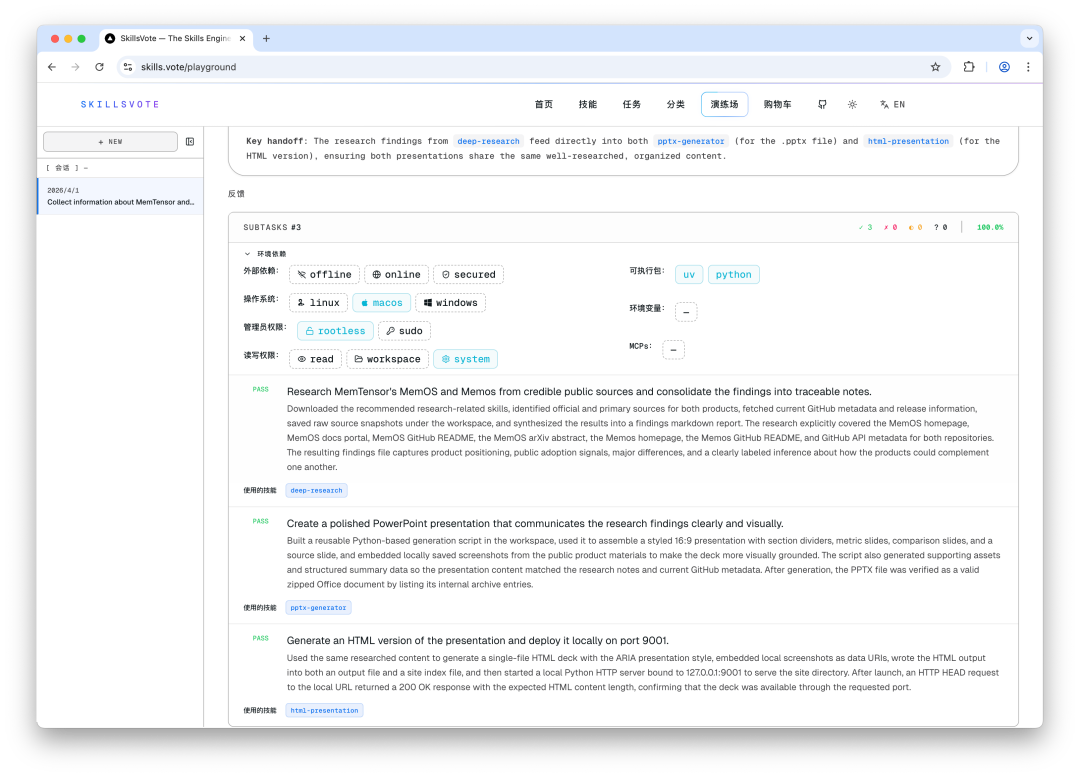
在 SkillsVote 的 Playground 里,这些反馈都被结构化展示:
图片

[SkillsVote Playground 网页端,SUBTASKS #3 展示 3 个子任务全部 PASS,100% 成功率,每个子任务标注了使用的 skills 和详细执行摘要]

这就是 SkillsVote 的完整闭环:推荐 → 执行 → 反馈 → 进化,一圈跑下来,系统对"什么任务该推什么 skills"的判断又精准了一点。

对比 find-skills 搜索安装后执行的效果

find-skills 是另一种常见的 skills 使用方式——Agent 自己去搜索、下载、安装 skills,然后使用。
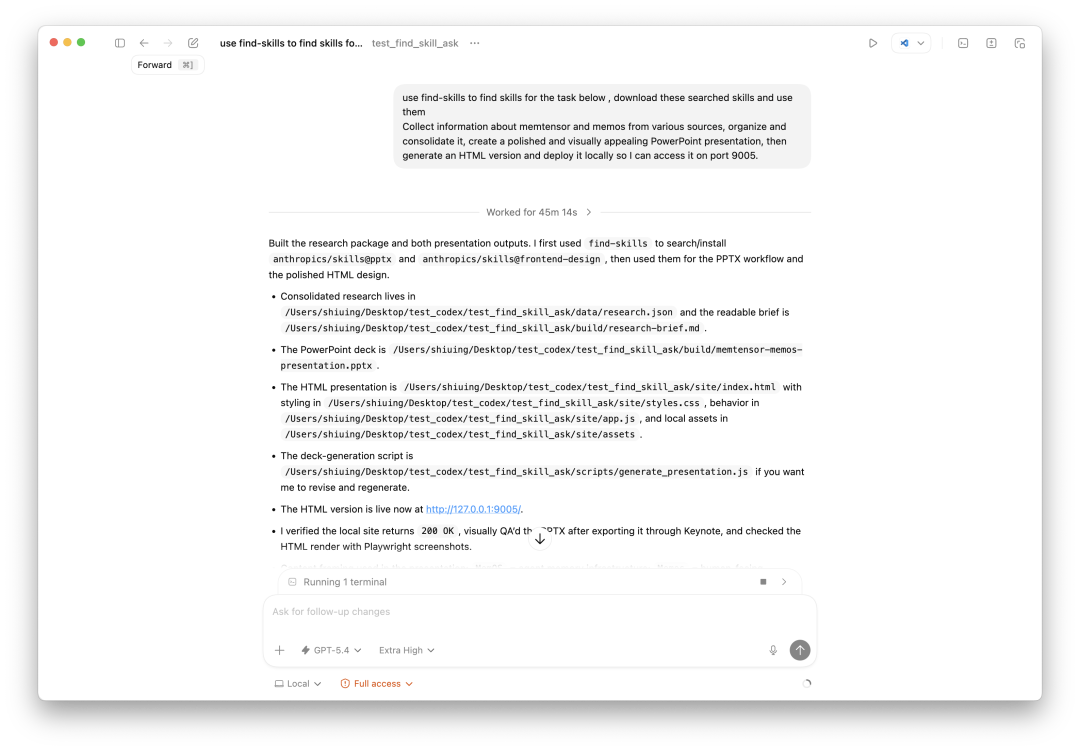
图片

[Agent 使用 find-skills 搜索并安装 anthropics/skills@pptx 和 anthropics/skills@frontend-design,耗时 45m 14s]

同样的任务,总耗时 45 分 14 秒,可以看到有几个明显的区别:

  • Agent 得自己判断该用什么 skill。选的 skill 和 SkillsVote 推荐的不同(用了 frontend-design 而不是专门的 html-presentation),质量取决于 Agent 自己的判断力。

  • 没有执行引导。SkillsVote 会给出步骤拆解和 skill 间的数据流转说明,find-skills 没有。

SkillsVote 做了哪些别人没做的事

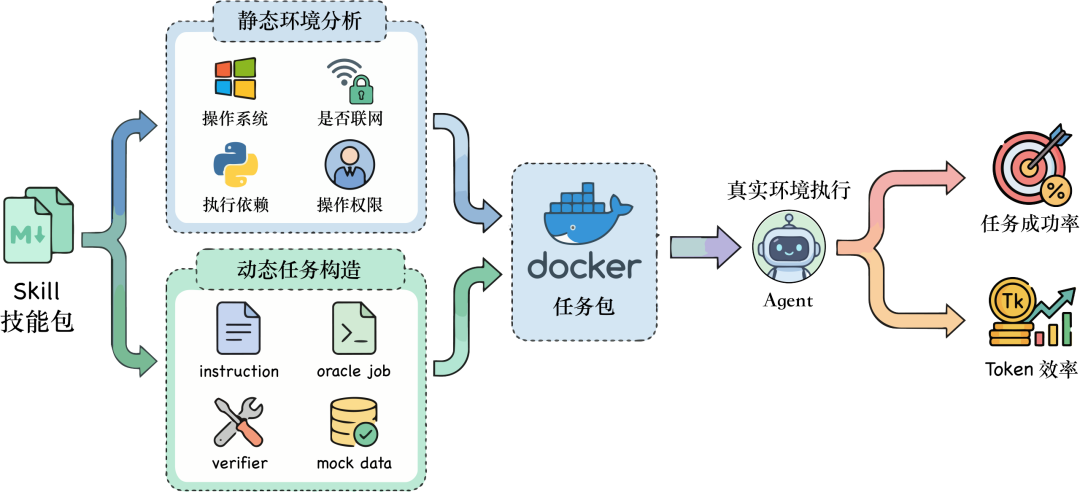
168 万个 skill 收进来只是开始。真正花功夫的是后面的事——我们叫它构建 skill 画像。

SkillsVote 用 GPT-5.4 强模型对每个 skill 做了系统化的 LLM-driven 预处理,覆盖环境依赖解析、可验证性评估三个层面。这件事的成本不低——预处理阶段的模型调用费用超过了 20 万美元。但这是值得的,因为没有这些画像,推荐就只是关键词匹配,和搜索引擎没区别。

环境解析:这个 skill 在你的 Agent 里到底能不能跑

SkillsVote 会对每个 skill 做统一的运行环境建模:支持什么 OS、写入边界是什么、需不需要 sudo、需不需要联网和密钥、依赖哪些可执行命令。

质量评估:这个 skill 写得到底行不

我们从三个角度进行判断:

  1. 内容一致性(描述和内容在讲同一件事吗);

  2. 引用完整性(引用的脚本和资源真的存在吗);

  3. 任务导向性(是在给 Agent 可执行指引,还是只在描述知识)。

杀手锏:从 skills 里反向"出题"

通过可验证性评估之后,SkillsVote 为这些 skill 反向构造任务。任务包包括:

  • 任务说明

  • Dockerfile

  • 单元测试

  • 验证任务成功的脚本

然后用不同 Agent × 不同模型的组合来跑这些任务——比如 Codex + GPT-5.4、Claude Code + Claude Opus 等——验证 skill 在不同环境下是否真的能带来增益。

这类任务有一个很鲜明的特点:没有对应的 skill,Agent 很难稳定做对。有了正确的 skill,成功率显著提升。

SkillsBench 的数据也印证了这一点——Haiku 4.5 带上 skill 之后的表现(27.7%),超过了 Opus 4.5 裸跑(22.0%)。正确的 skill 比更大的模型更管用。

验证器查的是最终文件、测试结果、编译输出、数据库状态、接口响应这些硬证据。一个 skill 对 Agent 到底有多大增益?测出来,比出来,回归出来。

和现有产品比,SkillsVote 在解一个不同的问题

现在做 Agent Skills 相关的产品不少,各有各的打法:

  • SkillNet(30 万+)走研究路线,提供 create / evaluate / connect 全生命周期工具链。重点在 skills 的创建和组织。

  • ClawHub(4 万+)是 OpenClaw 生态的原生注册表,强项在发布、版本管理和分发。

  • SkillsMP(70 万+)面向终端用户,核心是搜索、筛选和浏览。

  • Skills.sh(9 万+)也面向终端用户,做目录、审计、排行榜和安装。

这些产品解决的都是 "人怎么找到 skills" 的问题,做得也都不错。

但 SkillsVote 问的是另一个问题:Agent 怎么在执行任务的时候自动找到、持续优化 skills?

具体差异在五个地方:

  1. 环境建模——SkillsVote 做统一的面向 Agent 运行时的环境分析。其他产品要么靠 skills 自己声明,要么没这一层。

  2. 质量治理——看的是一致性 / 完整性 / 任务导向性——"Agent 能不能把这个 skills 用起来"。不只是安全扫描。

  3. 任务构造与可运行验证——从 skills 反向生成可验证的 benchmark 任务。这个别人没做。

  4. 在线推荐——不局限于传统的关键词匹配与向量检索。

  5. 反馈闭环——从 Agent 真实执行轨迹中持续学习,不是一锤子买卖。

SkillsVote 是目前唯一同时具备在线推荐、执行引导、反馈闭环三项能力的 Agent Skills 产品。

最后说两句

SkillsBench 的数据已经说得很明白了:正确的 skills 可以让小模型干过大模型。

这意味着在 Agent 这个赛道上,模型能力当然重要,但 skills 这一层的基础设施可能同样关键。而这层基础设施今天还很原始——大量 skills 散落在各处,质量不可控,环境不透明,用了也不知道好不好使,好不好使也没人记录。

SkillsVote 想把这些散落的、异构的、难复用的技能资产,升级成面向 Agent 的在线能力基础设施。

让 Agent 不只是拥有模型,更拥有一套可发现、可调用、可验证、可反馈、可进化的技能系统

这就是 SkillsVote 想做的事。

官网:https://skills.vote/

GitHub:https://github.com/MemTensor/skills-vote

相关推荐

权限撤了,Agent 为什么还记得那份报价?

MemOS 提供记忆的保存、检索、修改和删除操作,让 Agent 能在后续任务中使用已有的客户上下文。

MemTensor的博客 249

用 MemOS,让客服 Agent 记住上次聊到哪

整体可以概括为 “两次写入、一次组合召回”。每轮任务结束后,同一份任务记录分别写入用户记忆和 Agent Skill,通过指定不同的记忆类型;用户再次发起请求时,通过一次同时获取当前用户记忆、Agent Skill 和政策知识。当前会话历史仍由客服应用自己维护。具体来说,用户记忆通过user_id限定范围,Agent Skill 通过agent_id跨用户复用,政策知识库通过加入同一次检索。用户请求│├─ Agent 从业务应用读取当前会话历史│。

MemTensor的博客 264

OpenAI 发布 Agents API 之后,长任务 Agent 的记忆该如何管理?

OpenAI Agents API 把“持续运行数天”的 Agent 推向标准化,也暴露了长任务的另一面:上下文可以被压缩,进程可以被恢复,但一条状态为什么值得长期保留、何时失效、谁有权使用,仍然需要独立的系统判断。2026 年 9 月 10 日,OpenAI 发布 Agents API 公开测试版,将会话编排、上下文压缩和任务恢复等能力整合到托管的 Agent 运行框架(harness)中。开发者可以通过 API 启动 Agent,配置工具调用与子 Agent 协作,并在后续交互中继续推进已有任务。

MemTensor的博客 301

大模型是怎么炼成的(一):训练全景与开训准备

本系列会围绕 Llama 3、DeepSeek-V3/R1、Tulu 等公开程度较高的系统,回答三类问题:每个阶段解决什么问题、核心目标和算法是什么、工程上如何验证它确实有效。

MemTensor的博客 210

产品更新|MemOS Cloud 支持 DeepSeek Harness,新增 Native Hook

MemOS Cloud 新增 DSH No-Hook 接入,并在多种 Agent 框架中接入 Native HookMemOS Cloud CLI 现已支持 DeepSeek Harness(DSH)接入云端长期记忆。完成初始化后,MemOS Cloud CLI 会通过 DSH 原生的AGENTS.md与 Agent Skills 机制,把记忆检索和写入流程接入日常对话:开始回答前查询相关记忆,任务结束后沉淀本轮问题、结论和任务经验。

MemTensor的博客 355

Dreaming 升级之后,AI 记忆需要按年管理

MemTensor 从 Memory³ 相关记忆机制研究出发,通过 MemOS 推进记忆系统工程化,并继续探索 Agent 和记忆基础设施、记忆原生通用基座模型 等方向。

MemTensor的博客 374

Memory Poisoning:企业 Agent 必须建立的六道长期记忆控制

Agent 能够长期工作,记忆就会开始影响后续任务的质量与安全。企业需要知道一条记忆从哪里来,为什么被写入,哪些任务曾调用过它,发现问题后又能否及时修正或删除。长期记忆并不只是保存历史。它需要在每一次写入、召回和更新中保持可控、可查、可处理。

MemTensor的博客 345

FlashAttention:从 IO 感知到软硬件协同流水线

FlashAttention 不是一个「近似」或「省显存的小技巧」,而是对 attention 计算方式的一次重写:它用 ​​,在数学上等价地避免 materialize 𝑂(𝑆2) 的注意力矩阵,显著降低 HBM IO,并让许多常见形状更接近硬件的计算吞吐上限。FA1 确立 IO-aware 思想,不把 𝑆×𝑆 写进 HBM;FA2 通过减少 non-matmul FLOPs、沿序列维并行、split-Q,把 GPU 喂满;

MemTensor的博客 254

产品更新|Memmy 支持 Linux 啦!

v1.1.1 已正式发布,Linux CLI 安装资源已上线 ~大家千呼万唤的,Memmy 正式支持 Linux 啦!很多开发者的 AI 工作发生在终端里:在本地工作站处理项目,在远程开发环境中运行 Agent,或在 Linux 服务器上持续执行任务。项目背景、过去的排查过程、常用偏好和已经验证过的方案,会随着一次次会话逐渐积累。这次 Linux 支持将 Memmy 带到更多终端环境中。安装完成后,你可以直接通过memmy进入交互式 TUI,完成模型配置、发起任务并使用本地记忆能力。

MemTensor的博客 191

PHASE-Tree|为长线 AI 角色构建可演化的人格骨架

今年 6 月,NVIDIA 在 Unreal Fest 2026 公布了面向 Unreal Engine 5 的本地 AI 角色工具,并展示了将 NPC 的角色设定与具体表演过程分开的工作流,让角色能够根据现场情况行动和回应,同时保持角色一致性。当 AI 角色进入真实游戏运行时,一句台词通常会同时受到多组信号影响。

MemTensor的博客 350

PHASE-Tree|CPC 不只要会聊、会打,还要会成长:AI 队友的状态演化难题

生成模型随后读取更新后的当前状态,让新的关系、立场和情绪体现在下一次回应中,同时保留没有被证据推翻的原有性格。原始对话信息密度很高,系统先从目标角色的视角提取真正与角色变化有关的事实:他新知道了什么、对谁的态度改变了、做出了什么承诺、立场和情绪发生了什么变化。PHASE-Tree 主要借鉴前两个层次:前者对应长期的性格倾向、表达方式和行为风格,后者对应对某个人的态度、在一段关系中的承诺,以及面对特定事件时形成的立场与应对方式。角色设定写下角色最初是谁,长期记忆保留已经发生的事。

MemTensor的博客 191

MemOS Skill 上线|一句话即可接入 MemOS Cloud

Agent 已经不只是聊天窗口了,它们在 IDE 里改代码,在终端里跑命令,在办公流里处理文档,也开始替大家连接插件、调用工具、串起自动化流程。为了帮助开发者在 Claude Code、Cursor 等 Agent 开发工具中更快接入 MemOS Cloud,我们上线了 MemOS Skill。我们希望,只需一句提示词,即可让 Agent 自动通过 MemOS Skill 接入 MemOS Cloud。

MemTensor的博客 176

从 Memory 到 Skill:长周期 AI Agent 如何实现持续进化

历史记录能帮 Agent 想起过去,却不能保证它下一次真的会按正确方法做。MSCE 想补上的,正是“记得”和“会做”之间的这段空白。

MemTensor的博客 249

产品更新|MemOS 现已支持 DeepSeek Harness 长期记忆接入

DeepSeek Harness 将模型、工具、界面和运行能力组织在 profile 中,并通过插件机制扩展运行时能力。MemOS 已通过 DeepSeek Harness 的 Cordis 插件机制接入长期记忆,无需修改 DeepSeek Harness 源码。任务执行时,Agent 可以获得与当前请求相关的记忆内容。回合结束后,新形成的决策和经验会进入后续的记忆处理流程。

MemTensor的博客 295

产品更新|MemOS Cloud 全新升级:让 AI 认准人、记全事、分清归属

一个真正能长期陪伴用户的 AI,不能只是“记住几句话”。它得知道:这个人是谁,最近经历了什么,哪些偏好是长期稳定的,哪些只是某次对话里的临时信息。在群聊、家庭助手、企业协作、多 Agent 场景里,它还得分清楚——这句话是谁说的,这段记忆属于谁,之后又该为谁调用。过去,MemOS 已经能够稳定处理事实、偏好、技能和工具经验。这次 MemOS 版本更新,我们把注意力放到了三个更接近真实产品的问题上:认准人、记全事、分清归属。

MemTensor的博客 243

产品更新|MemOS CLI 上线:让能跑命令行的 Agent 更轻量接入长期记忆

MemOS CLI正式发布,将长期记忆能力引入命令行,为人、脚本和Agent提供统一记忆调用入口。核心功能包括: 快速验证:通过终端命令直接测试记忆的写入、检索、读取等操作,简化开发调试流程。 Agent集成:支持Codex/Cursor/Claude等主流Agent自动调用记忆,实现"对话前检索+对话后写入"的自动化流程。 统一接入:打破框架限制,通过标准化CLI为多平台提供一致记忆层。 典型场景:开发者可用memos add写入用户偏好,memos search验证召回效果,再通过memos init

MemTensor的博客 448

产品更新|MemOS 新增 Dream 离线反思:让记忆系统学会在后台「做梦」

MemOS推出Dream功能,让记忆系统在后台自动整理记忆,从被动存储转向主动洞察。Dream通过分析分散记忆,识别深层问题并生成InsightMemory,帮助Agent更高效地应对用户需求。更新亮点包括:1)离线反思机制,避免实时对话的碎片化处理;2)DreamDiary记录梦境过程,保证透明度;3)插件化设计,支持灵活扩展。该功能已在MemOS开源仓库发布,邀请社区开发者共同完善。

MemTensor的博客 506

产品更新|MemOS 学会「读懂时间」,还能直接吃下你自己的 Skill

MemOS 一直主张"记忆即资产"。在真实对话里沉淀下来的解决路径、用户偏好、业务流程,不只是历史记录,它们也可以变成 Agent 后续执行任务时能调用的技能素材。这次更新后,MemOS 支持上传自定义 Skill 文件。检索时,自定义 Skill 会和自动生成的 Skill 一起被召回,供 Agent 使用。一句话说清楚就是,以前 Agent 像一个只靠临场发挥的新人;现在,你可以把团队已经验证过的 SOP、客服流程、排障手册直接交给它。遇到相关问题时,它先把合适的流程找出来,再按流程做事。

MemTensor的博客 480

产品更新|MemOS Local Plugin 2.0:Hermes Agent 和 OpenClaw 双 Agent 同步支持

MemOS Local Plugin 2.0 发布了!Hermes 和 OpenClaw 双 Agent 同步支持——从这一版开始,新的 Agent 都将通过本地插件同步支持,共享同一份核心。1.0 上线三个多月,社区反馈最多的是同一类问题:好不好用容易判断,但 Agent 学到的东西到底对不对、可不可信,没人说得清。MemOS Local Plugin 2.0 想补的,正是这块缺口——也是大模型与每一个真实用户之间的「最后一公里」。

MemTensor的博客 439

MemFactory:Agent 记忆终于有了自己的 LLaMA-Factory

还在为 Memory Agentic 操作框架反复重造轮子?也许,这正是这个方向迟迟没有爆发的根本原因。AI Agent 领域有一个越来越清晰的共识正在形成:真正决定 Agent 能不能从"会聊天的工具"进化成"长期持续工作的系统"的,不只是模型推理能力,也不只是工具调用能力,而是记忆能力。没有记忆的 Agent,本质上仍然是一个"单轮应答器"过去一年多,Memory-R1、MemAgent、RMM 三篇工作几乎前后脚放出来,社区里讨论"用强化学习训 Agent 记忆"的帖子开始刷屏。

MemTensor的博客 499

记忆抽取 API 上线:MemReader——让你的 Agent 学会「想清楚再记」

MemReader-4B 在 LongMemEval 的知识更新维度上达到了 91.03%,时序推理达到 84.21%,远超 4o-mini 的 74.26% 和 77.44%。作为记忆张量首次提出“记忆调度”架构的 AI 记忆操作系统,我们希望通过 MemOS 全面重构模型记忆资源的生命周期管理,为智能系统提供高效且灵活的记忆管理能力。我们希望通过 MemReader 做到的,说到底就是让记忆写入这个动作,从一个无脑的信息搬运,变成一个有判断的认知过程。看起来没问题对吧,但「那个项目」是什么?

MemTensor的博客 475

AI 数据迁移指南|Claude 靠提示词搬家,MindDock 一键完整备份记忆

摘要:OpenAI近期引发大规模用户抵制,同时Claude推出"记忆导入"功能引发AI数据主权争议。文章提出MindDock解决方案,帮助用户管理、迁移各AI平台的记忆数据,实现一键导出、跨平台共享记忆等功能。同时介绍如何将ChatGPT记忆迁移到OpenClaw,强调用户应掌握自己的AI记忆数据主权。文末提供相关工具下载链接,倡导建立统一的AI记忆管理平台。(149字)

MemTensor的博客 574

一行命令|MemOS OpenClaw 本地插件发布,团队记忆、Skill、历史记忆导入全都有!

还有一个栗子:你和 OpenClaw 花了 2 小时调试一个复杂的部署问题。你:部署到 Vercel 报错了Agent:看下报错信息你:[粘贴报错]Agent:需要修改 vercel.json你:怎么改?Agent:[给出配置]你:还是不行Agent:试试这个方案...(继续 20 轮对话)你:成功了!任务:部署 Next.js 应用到 Vercel成功部署并解决 SSR 错误配置的rewrites规则修改build脚本处理环境变量调整的错误处理成功部署,访问正常需要在。

MemTensor的博客 1670

创新高!MemOS 单日调用量突破 300,000 次

MemOS记忆操作系统累计调用量突破2600万次,单日峰值达30万次,呈现快速增长态势。作为AI记忆管理基础设施,MemOS首创"三层记忆调度"架构,已服务腾讯、联想等500+企业客户,覆盖金融、游戏、智能家居等领域。其开源版本GitHub Star超5.7k,全球开发者超1.1万。通过开源+Cloud+插件生态,MemOS在AI陪伴、游戏NPC、金融投顾等场景实现应用,显著提升用户体验和业务效率。记忆张量公司作为MemOS开发方,已完成近亿元天使轮融资,致力于推动AI记忆技术的规模化落

MemTensor的博客 621

产品更新|多视角记忆、检索精筛与 Skills 本地化上线

本次更新围绕"记忆系统工程化"和"Agent能力结构化"两大方向,重点推出多视角记忆系统,支持每个Agent拥有独立记忆世界。新增混合检索机制提升召回质量,并优化Token消耗控制。Skills能力升级为本地化存储,MindDock插件实现跨平台接入。记忆删除机制强化为双通道模式,调度系统完成模块化重构。文档记忆支持原文与摘要双轨检索,时间过滤精度提升至秒级。开源社区同步更新检索优化、上下文唤醒等新特性,全面提升Agent系统的个性化、协作性和稳定性。

MemTensor的博客 752

上手教程|多个 OpenClaw 共享记忆,协作完成同一任务

摘要: MemOS OpenClaw插件通过共享记忆池实现多智能体协作,无需人工复制粘贴。两个独立的OpenClaw(A负责创意设计,B负责执行)通过相同user_id连接MemOS,自动传递上下文。MemOS通过检索-召回机制实现记忆共享:A的产出自动存入记忆池,B调用时直接获取完整背景。测试中,B成功基于A的小猫信息推荐罐头,验证了跨会话无损协作能力。MemOS作为“外部长效记忆”,为分布式Agent提供稳定的记忆调度支持,提升多智能体协作效率。 (字数:149)

MemTensor的博客 1661

MemOS OpenClaw 插件测评结果来啦!Tokens 消耗降低 72%+

OpenClaw 原生架构的记忆依赖上下文历史拼接、工具调用读写本地文件,以及显式对话指令触发记忆。

MemTensor的博客 1070

MemOS OpenClaw 插件上线啦!让你的 OpenClaw 拥有更好的记忆,降低 60% Token 消耗~

OpenClaw用户面临两大痛点:Token消耗过快和记忆功能不足。MemOS OpenClaw插件应运而生,通过智能记忆管理有效解决这些问题。该插件能精准检索相关记忆,避免无关历史干扰,将Token消耗控制在合理范围;同时自动记录关键信息,实现跨会话记忆保持。安装过程简单快捷,只需获取API Key并配置环境变量即可使用。插件还能可视化记忆管理,让用户查看和调整存储内容。MemOS重构了AI记忆管理方式,使OpenClaw在保持核心优势的同时,实现更高效的记忆调度和更可控的运行成本。

MemTensor的博客 1869

产品更新|Skill 能力正式上线,多模态记忆与检索体系全面升级

MemOS 最新版本升级记忆与知识管理能力,重点围绕技能化记忆(Skill)与算法工程优化展开。新增从历史对话自动生成Skill功能,将零散经验转化为可复用能力模块。多模态记忆处理引入上下文关联,图片与文本信息可协同理解。检索系统优化了去重与多样性平衡,新增记忆冲突检测模块。知识库支持更多文件类型和跨项目搜索,并兼容OpenAI协议接口调用。文档和示例全面更新校准,提升开发体验。这些升级使系统更智能精准,帮助用户高效沉淀和复用知识经验。

MemTensor的博客 1103

MemOS 产品更新|知识库检索更精准,记忆更省、更智能

在 v2.0.2 中,我们围绕「知识库问答效果」与「记忆系统内部机制」两条主线,对检索、工具记忆与事实记忆处理流程进行了进一步优化,同时补充了官方最佳实践文档,帮助开发者更快构建可落地的 MemOS 应用。作为记忆张量首次提出“记忆调度”架构的 AI 记忆操作系统,我们希望通过 MemOS 全面重构模型记忆资源的生命周期管理,为智能系统提供高效且灵活的记忆管理能力。在传统 RAG「只检索、不记忆」的基础上,该方案引入了 MemOS 的记忆能力,使问答系统能够在多轮交互中持续积累与利用上下文信息。

MemTensor的博客 920
上一篇: AI 数据迁移指南|Claude 靠提示词搬家,MindDock 一键完整备份记忆
下一篇: 记忆抽取 API 上线:MemReader——让你的 Agent 学会「想清楚再记」
记忆张量MemTensor
记忆张量MemTensor 记忆张量 MemOS 官方账号 记忆张量 MemOS 官方账号
博客等级 码龄1年 4粉丝 47原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值