Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation (DeepLab v3+) 论文笔记

Encoder-Decoder-with-Atrous-Separable-Convolution-for-Semantic-Image-Segmentation when ECCV 2018 what 空间金字塔池模块或编码 - 解码器结构用于深度神经网络中解决语义分割任务。 前一种网络能够通过利用多个速率和多个有效视场的过滤器或池化操作探测输入特征来编码多尺度上下文信息,而后一种网络可以通过逐渐恢复空间信息来捕获更清晰的对象边界。 在这项工作中,我们建议结合两种方法的优点。具体来说,我们提出的模型DeepLabv3 +通过添加一个简单而有效的解码... 阅读详情

《Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation》

论文链接:https://arxiv.org/abs/1802.02611

tensorflow 官方实现: https://github.com/tensorflow/models/tree/master/research/deeplab

本文主要参考了优快云 中的一篇文章:https://blog.youkuaiyun.com/u011974639/article/details/79518175 ,感谢博主的分享

Abstract

分割任务中常见的结构有空间金字塔池化模型(Spatial pyramid pooling module)与编码-解码结构,前者通过多个速率(rates)和多个有效视场(field-of-view)的过滤器(filter)或池化操作传入特征来编码多尺度的上下文信息,而后者网络可以通过逐渐恢复空间来捕获更清晰的对象边界信息。该文的改进:(1)DeepLabv3+ 在DeepLabv3的基础上增加了一个decoder 模型来是增强分割结果,尤其是物体边缘的分割。(2)引用了Xception中的深度可分卷积(depthwise separable convolution),应用在ASPP(Atrous Spatial Pyramid Pooling)和decoder 模型上,提高了encoder-decoder 网络的训练速度和健壮性。将模型用于 PASCAL VOC 2012 和 Cityscapes 数据上且不使用任何后处理,分别得到 89.0% 和 82.1% 的IoU。

介绍

语义分割的目的是为图像中的每个像素分配语义标签,这是计算机视觉中的基本主题之一。 在这项工作中,我们考虑使用空间金字塔池模块[18,19,20]或编码器 - 解码器结构[21,22]进行语义分割的两种类型的神经网络,其中前者通过汇集特征在不同的分辨率下来捕获丰富的上下文信息,而后者能够获得尖锐的物体边界。

为了获取不同尺度的上下文信息,DeelLab3 使用了不同速率的 atrous convolution,虽然最终的 feature map 包含了丰富的语义信息,但由于池化操作或卷积中的补偿影响,边缘信息会丢失,这可以通过应用atrous concolution 来提取更密集的特征映射来缓解。然而,考虑到现有神经网络的设计和有限的GPU内存,提取比输入分辨率小8甚至4倍的输出feature map在计算上是行不通的(即如果输出的feature map 过大会导致计算资源的问题,内存不够等)。以ResNet-101为例,当应用atrous卷积提取比输入分辨率小16倍的输出特征时,最后3个残余块(9层)内的特征必须扩大。更糟糕的是,如果需要比输入小8倍的输出特征,则会影响26个残余块(78层!)。因此,如果为这种类型的模型提取更密集的输出特征,则计算量会很大。另一方面,编码器 - 解码器模型使其自身在编码器路径中更快地计算(因为没有特征被扩张)并且逐渐恢复解码器路径中的尖锐对象边界。为了结合两种方法的优点,我们建议通过结合多尺度上下文信息来丰富编码器 - 解码器网络中的编码器模块。

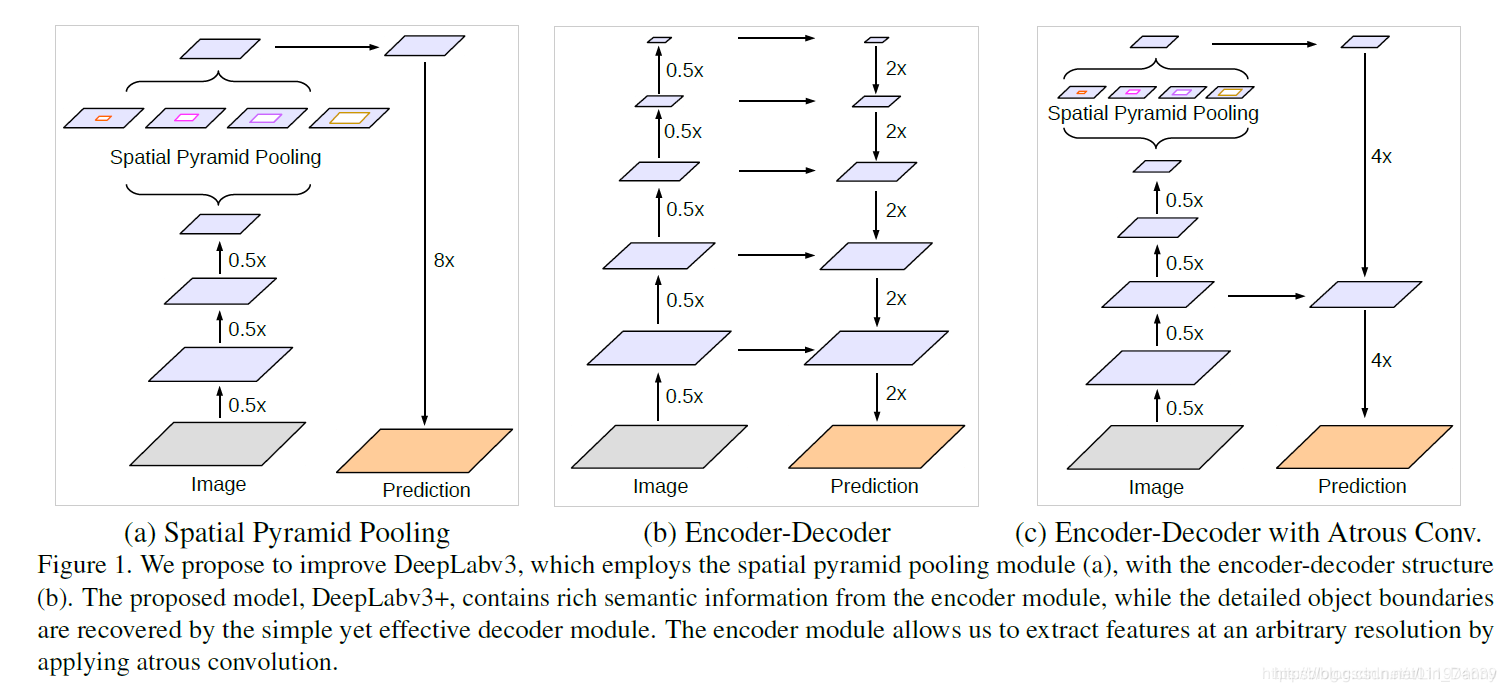
在DeepLabv3+中,使用了两种类型的神经网络,使用空间金字塔模块和encoder-decoder结构做语义分割。DeepLabv3+结合这两者的优点,在DeepLabv3的基础上拓展了一个简单有效的模块用于恢复边界信息。如下图所示:
在这里插入图片描述

(a): DeepLabv3的结构,使用ASPP模块获取多尺度上下文信息,直接上采样得到预测结果
(b): encoder-decoder结构,高层特征提供语义,decoder逐步恢复边界信息
©: DeepLabv3+结构,以DeepLabv3为encoder,decoder结构简单

DeepLabv3的top layer输出的feature中有丰富的语义信息,可通过扩张卷积依据计算资源限制控制计算密度,配合一个decoder模块用于逐渐恢复边界信息。

在上述的encoder-decoder架构上,论文受到Xception等工作启发,将深度分离卷积应用到ASPP和decoder模块,用于快速计算并保持模型的强大学习能力。最终得到的模型在没有添加后端处理的情况下,达到了新的state-of-the-art.

论文的主要贡献在于:

  1. 论文提出了一个全新的encoder-decoder架构,使用DeepLabv3作为encoder模块,并添加了一个简单却有效的decoder模块
  2. 在提出的encoder-decoder架构中,可通过扩张卷积(atrous concolution)直接控制提取encoder特征的分辨率,用于平衡精度和运行时间
  3. 论文将Xception结构应用于分割任务中,在ASPP和decoder模块中加入深度分离卷积,获得到强大又快速的模型
  4. 模型达到了新的state-of-the-art,同时我们给出了模型设计分析细节和模型变体

Related Work

近几年基于全卷积神经网络的模型在语义分割任务上表现很好,有几种变体模型提出利用上下文信息包括多尺度输入在内的做分割,也有采用概率图模型细化分割结果。本文主要讨论使用空间金字塔池化和encoder-decoder结构、并讨论了基于Xception为主体的强大特征提取层,和基于深度分离卷积快速计算。

**空间金字塔池化(spatial pyramid pooling):**如PSPNet,DeepLab 使用多个不同网格尺度(grid scales)进行池化操作,或者使用多个不同rates的平行的 atrous卷积(称为 ASPP),这些模型在多个benchmark 都获得了不错的结果。

Encoder-Decoder: encoder-decoder结构在多个计算机视觉任务上获得成功,例如人类姿态估计、目标检测和语义分割。通常,encoder-decoder网络包含:

  • encoder模块逐步减少feature map分辨率,捕获高级语义信息

  • decoder模块逐渐恢复空间信息

在这领域上基础上,我们使用DeepLabv3作为encoder模块,并增加一个简单又有效的的decoder模块获取空间信息。

深度分离卷积: 深度分离卷积(depthwise seperable convolution)或组卷积(froup convolution)能够在减少计算消耗和参数量的同时取得相似或更好的表现,深度分离卷积已应用在多个神经网络中。我们探索了Xception架构(即使用Xception 作为 backbone),结果表明,我们的模型在语义分割任务上展现了精度和速度上的双重提升。

Methods

本节简明介绍扩张卷积和深度分离卷积,然后回顾用于DeepLabv3+ 架构中的encoder模块——DeepLabv3架构,最后展示改进后的Xception模型。

Encoder-Decoder with Atrous Convolution

Atrous Convolution:Atrous卷积推广了标准卷积运算,它允许我们明确地控制深度卷积神经网络计算的特征的分辨率,并调整滤波器的视场以捕获多尺度信息。

考虑到二维信号上使用空洞卷积,对于位置 i i i,在输入为 x x x 上应用滤波器$ w , 输 出 为 ,输出为 ,输出为y$ :
y [ i ] = ∑ k x [ i + r k ] w [ k ] y[i] = \sum_k x[i + r k] w [k] y[i]=k∑​x[i+rk]w[k]
其中速率r 在采样点之间引入r−1个零,有效的将感受野从k×k扩展到 k e = k + ( k − 1 ) k_e=k+(k-1) ke​=k+(k−1),而不增加参数和计算量。

Depthwise separable convolution:深度分离卷积在MobileNet里面重点讲过,这里简单说一下:

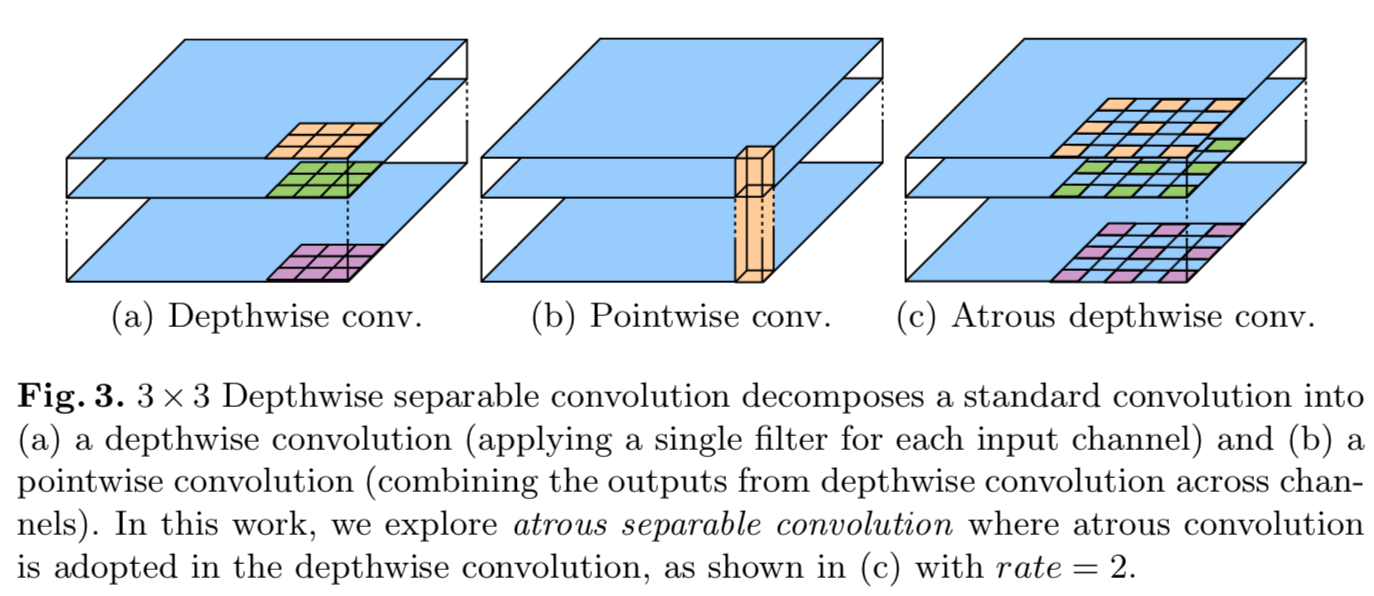
深度可分离卷积的作用是:把标准卷积分解成深度卷积(depthwise convolution)和逐点卷积(pointwise convolution)。深度卷积对每个通道独立使用空间卷积,逐点卷积用于结合深度卷积的输出,如下图所示。深度分离卷积可以大幅度降低参数量和计算量。
在这里插入图片描述

我们将atrous卷积和深度分离卷积结合到一起,即扩张分离卷积,如上图。扩张分离卷积能够显著的减少模型的计算复杂度并维持相似的表现。

DeepLabv3 as encoder:

DeepLabv3中也使用atrous卷积提取特征。我们将输入和输出的分辨率比值记为output_stride,对于图像分类任务,最终的feature map 的大小一般是输入图像的 1/32,即 output_stride=32;对于语义分割任务,将下采样(普通卷积操作)替换为atrous卷积,这样就可以调整 output_stride = 16(或8),从而进行更密集的特征提取(例如,我们应用rate = 2和rate = 4到最后两个blocks,则output_stride = 8)。

DeepLabv3的ASPP模块使用了多个平行的atrous卷积,配合了图像级特征(即全局平均池化)。我们将DeepLabv3的logit前的输出特征作为encoder-decoder模型的encoder输出。此时输出的feature通道为256并包含丰富的语义信息。另外,可已通过使用 atrous 卷积来匹配计算资源的限制。

Proposed decoder:

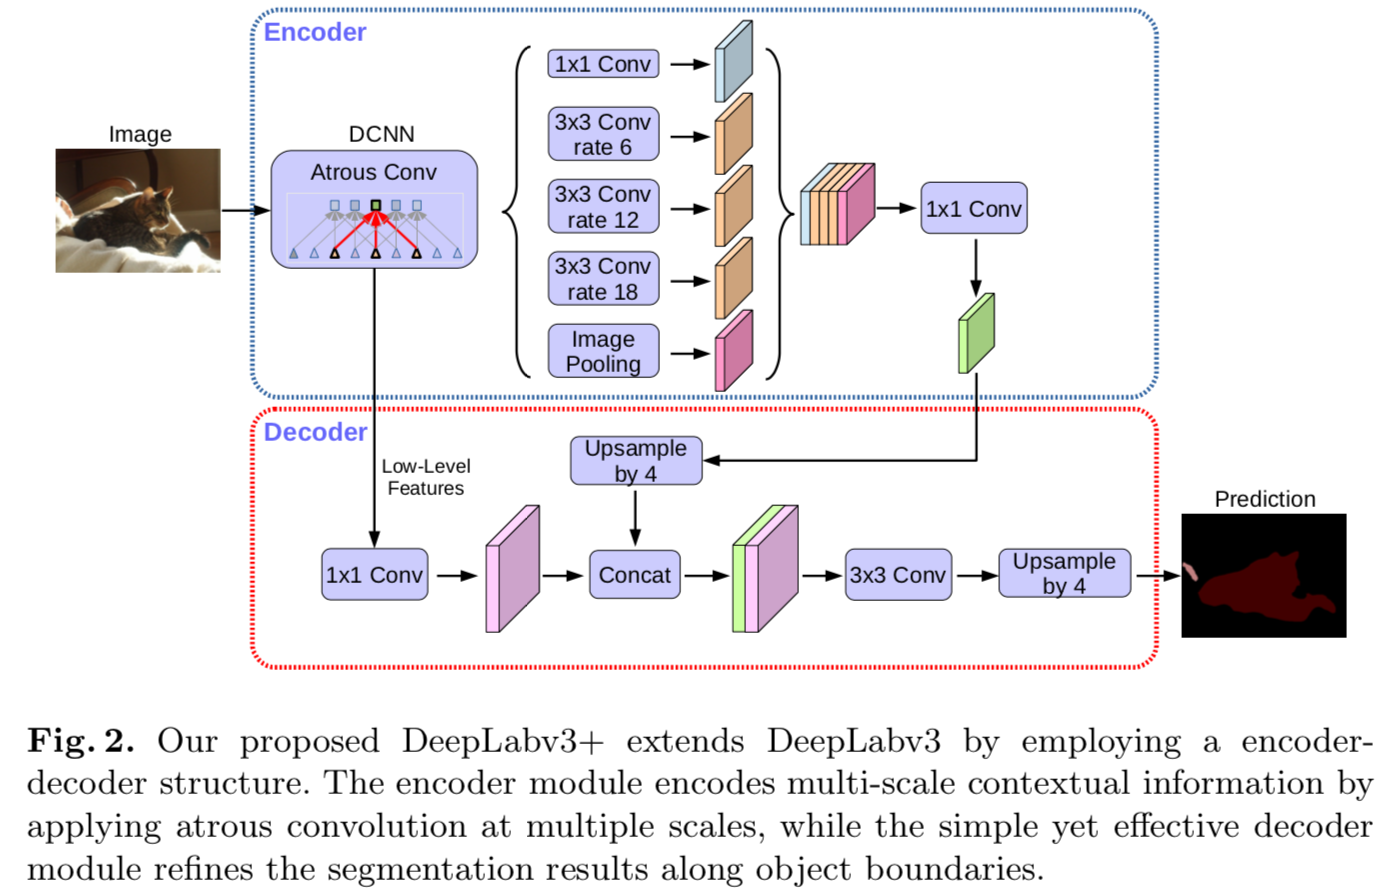
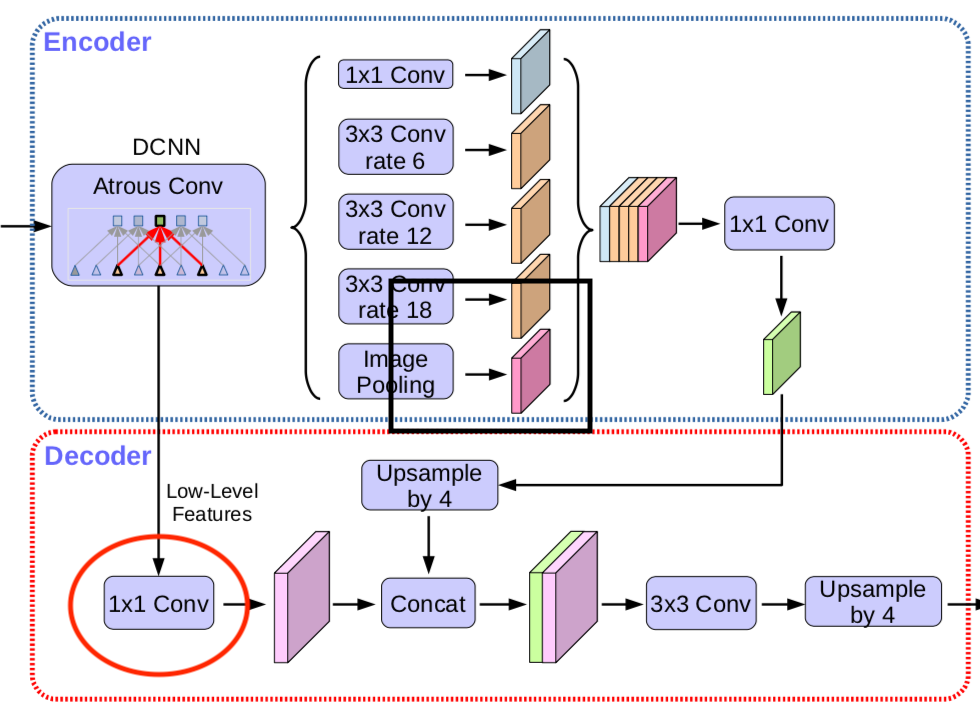
在原先的DeepLabv3中,取预测的feature 直接双线性上采样16倍到期望尺寸,这样的简易的decoder模块不能成功的恢复分割细节。因此加入了一个有效的 decoder 模块,如下图所示:编码器特征先进行 factor=4 的双线性上采样,然后与具有相同空间分辨率的网络主干的相应低级特征(例如,在ResNet-101 [25]中跨越之前的Conv2)连接在一起。

DeepLabv3+的整体的架构如下图所示:
在这里插入图片描述

简单说一下decoder的组成:

  • encoder输出的feature的output_stride=16,经过 factor=4 的双线性上采样得到 low_level features F L ​ F_L​ FL​​, F L F_L FL​ 的 o u t p u t s t r i d e = 4 ​ output_stride=4​ outputs​tride=4​

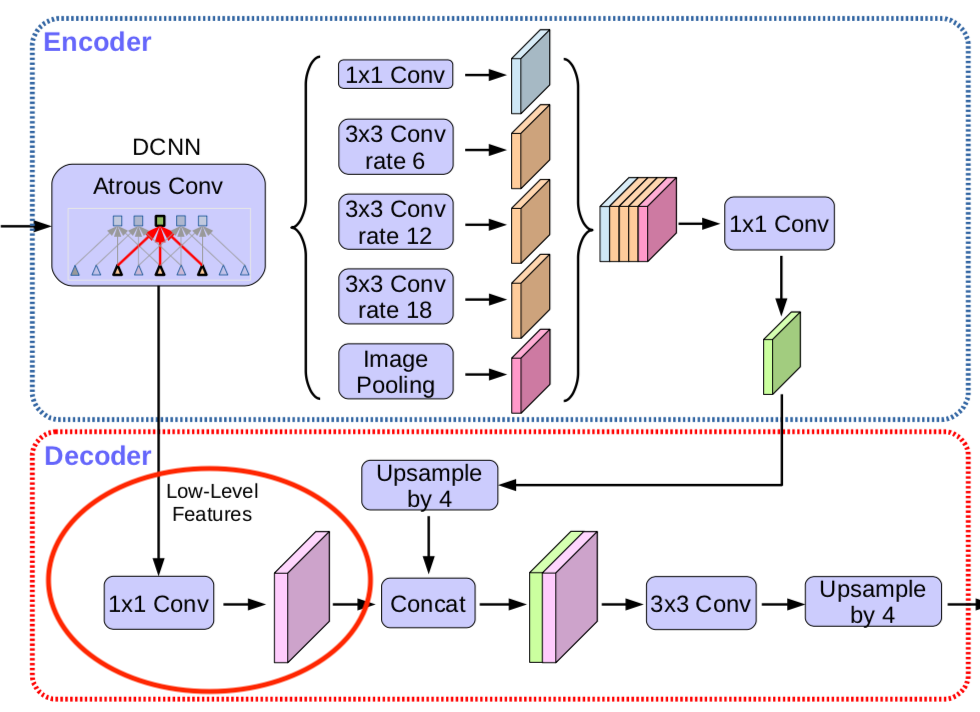
  • 再取encoder中对应着相同分辨率(即output_stride=4 )的特征层,经过1×1卷积降通道,此时输出的features记为 F H ​ F_H​ FH​​ 。这里为什么要经过1×1卷积降通道,是因为此分辨率的特征通道较多(256或512),而 F L ​ F_L​ FL​​ 输出只有256,故降通道以保持与 F L ​ F_L​ FL​​ 所占比重,利于模型学习。

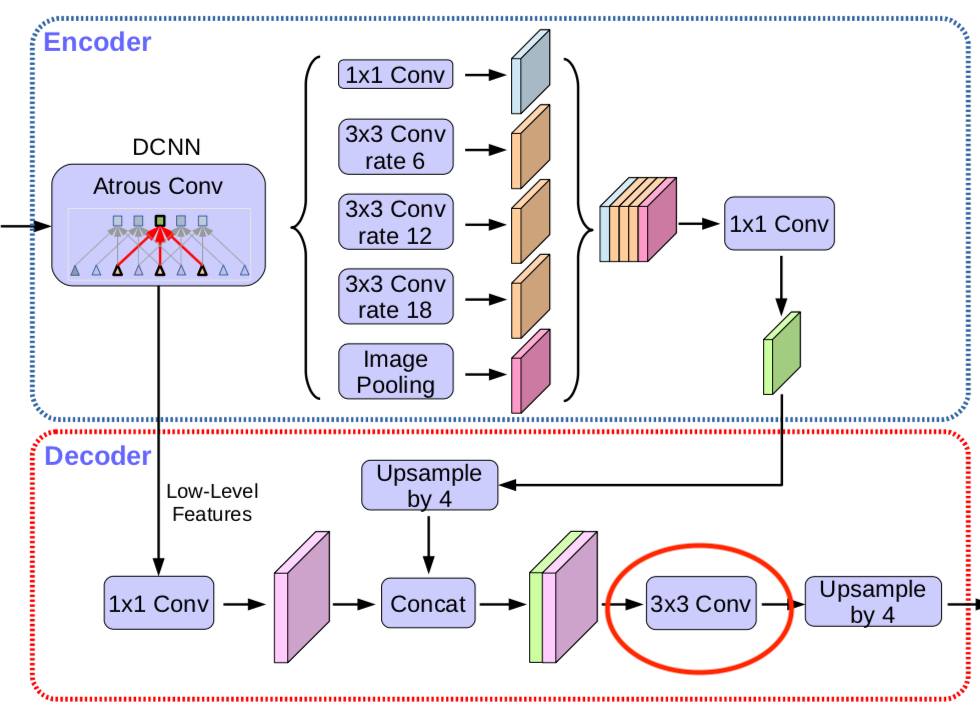
  • 将 F L F_L FL​ 和 F H F_H FH​ 做连接,再经过一个3×3 卷积细化feature,最终再双线性上采样4倍得到预测结果.

在实验部分展示了output_stride=16是在速度和精度上最佳的平衡点,使用output_stride=8 能够进一步提升精度,但同时伴随着是更大的计算消耗。

Modified Aligned Xcetpion

论文受到近期[MSRA组在Xception上改进工作](Aligned Xception,《Deformable convolutional networks – coco detection and segmentation challenge 2017 entry》. ICCV COCO Challenge Workshop (2017))的启发,Deformable-ConvNets对Xception做了改进,能够进一步提升模型学习能力,Aligned Xception的结构如下:
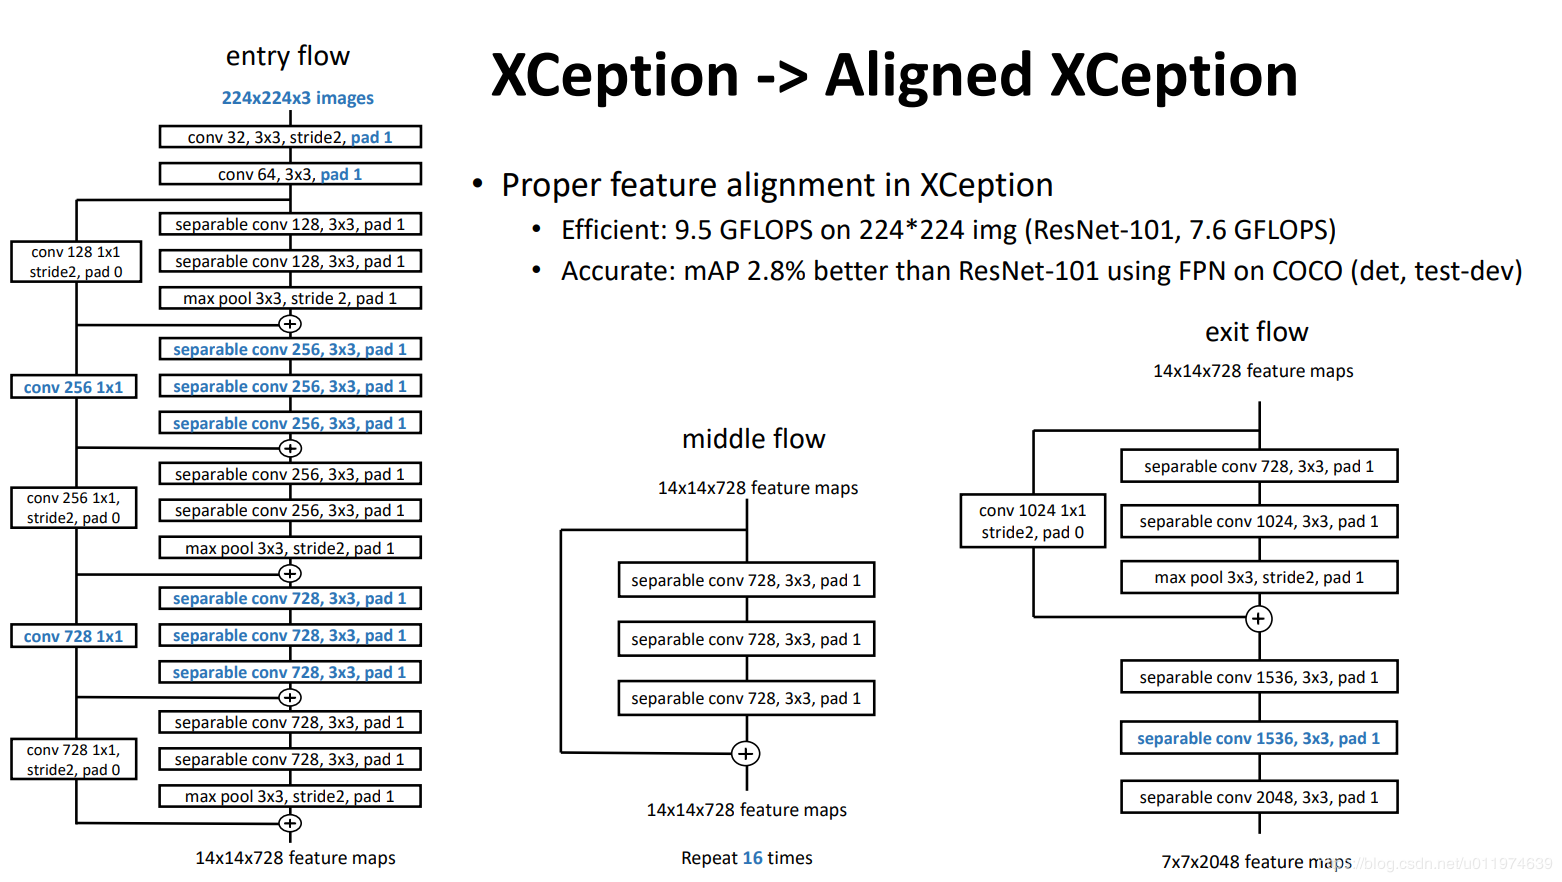
在这里插入图片描述

论文在MSRA的工作的基础上,进一步改进以适应语义分割任务:

  • 采用与Aligned Xception 相同的结构,不同的地方在于不修改entry flow network的结构,以便快速计算和有效的使用内存
  • 所有的最大池化操作替换成带下采样的深度分离卷积,这能够应用扩张分离卷积扩展feature的分辨率
  • 与 [MobileNet](An-dreetto, M., Adam, H.: Mobilenets: Efficient convolutional neural networks for mobile vision applications. arXiv:1704.04861 (2017)) 的设计相似,在每个3×3 深度卷积后增加BN层和ReLU

改进后的Xception整体结构如下:
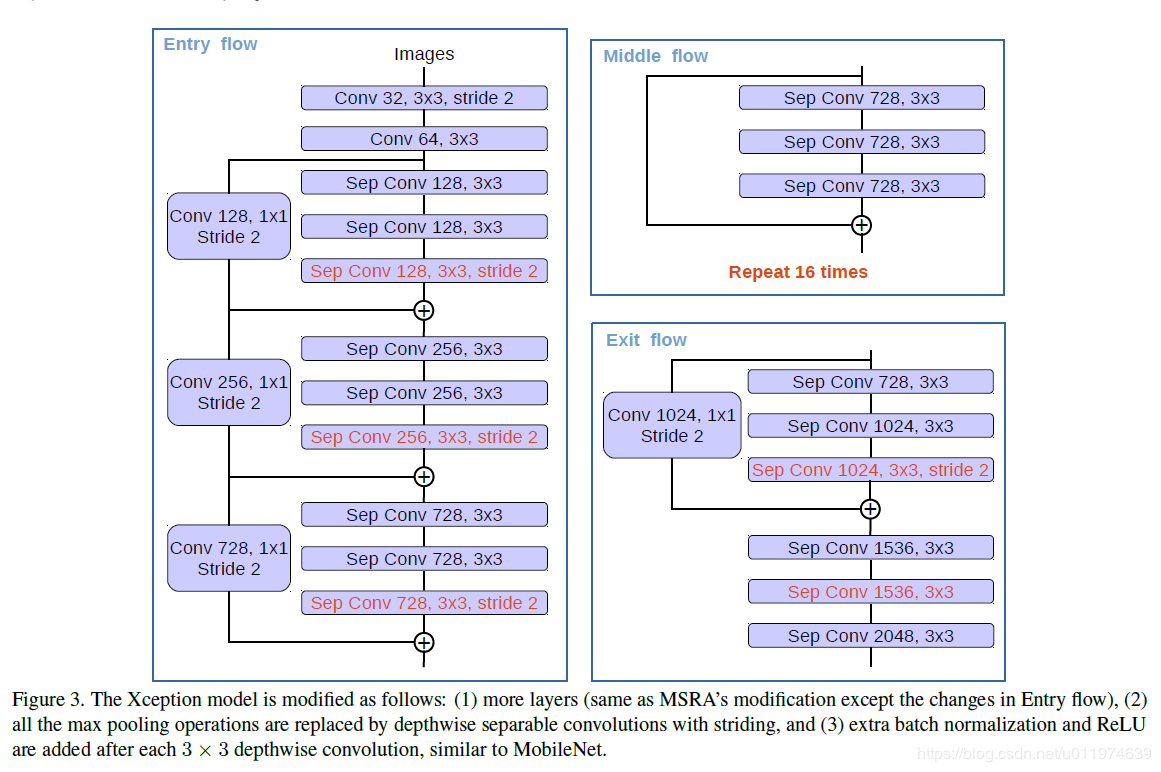
在这里插入图片描述

改进后的Xception为encodet网络主体,替换原本DeepLabv3的ResNet101.

Experiment

我们采用ImageNet-1k预训练的ResNet-101或修改后的Aligned Xception 来通过taros 卷积提取密集的特征图。采用与 DeepLabv3 相同的训练方式,简而言之,当output_stride = 16时,在训练期间使用相同的学习率计划(即[“poly”策略](Liu, W., Rabinovich, A., Berg, A.C.: Parsenet: Looking wider to see better. arXiv:1506.04579 (2015))和相同的初始学习率0.007)、crop大小513×513 、 batch normalization 参数,以及随机比例数据增强(random scale data augmentation) 。 请注意,我们还在解码器模块中包含批量标准化参数。

这里提出的模型是端到端(end-to-end)训练的,没有对每个组件进行分段预训练。。

Decoder Design Choise

用DeepLabv3作为encoder,对于f 个k×k 的卷积操作记为$[k×k,f] $,先前DeepLabv3是在输出结果上继续双线性上采样16倍得到预测结果,这在PASCAL VOC2012 验证集上达到了77.21%。论文在此基础上,提出了改进的decoder模块。关于decoder的设计有多个方案:

使用1×1卷积减少来自低级feature的通道数

下图示意部分为1×1 卷积:
在这里插入图片描述

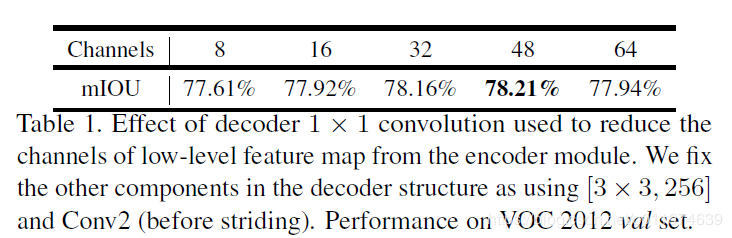
为了评估1×1 卷积的重要性,在encoder中取了 Conv2 尺寸为[3×3,256] 为输出,减少通道数在48到32之间性能最佳。结果如下表:
在这里插入图片描述

最终采用了[1×1,48]来做通道降维。

是否需要3×3卷积逐步获取分割结果

即下图示意部分3×3卷积恢复信息:
在这里插入图片描述

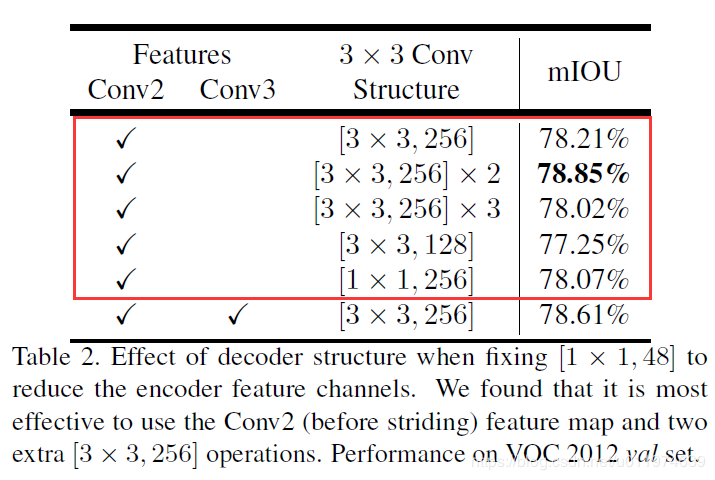
实验部分包括使用1×1,256 的卷积,一组、二组、三组的3×3,256 卷积,使用3×3,128 的卷积,结果如下:
在这里插入图片描述

结果显示使用两组3×3,256 卷积性能最佳。

使用哪部分的低级特征帮助提供细节

即下图示意部分:
在这里插入图片描述

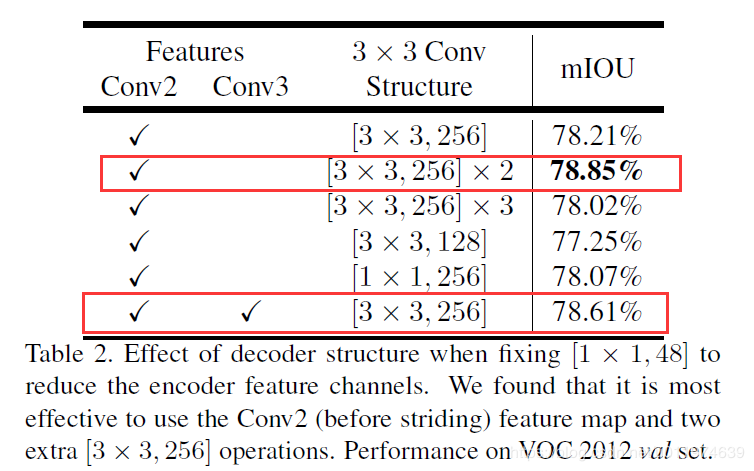
论文实验了如果使用Conv2 和Conv3 同时预测,Conv2 上采样2倍后与Conv3 结合,再上采样2倍,结果如下:
在这里插入图片描述

这并没有显著的提升性能,考虑到计算资源的限制,论文最终采样简单的decoder方案,即取Conv2 Conv2Conv2上采样后再与top feature concatenate。

ResNet-101 as Network Backbone

以ResNet为encoder模型,测试了以下几种变体:

  • Baseline: 在下表的第一组。都没有使用decoder。测试了不同output_stride output_strideoutput_stride,多尺度输入,左右翻转操作。
  • Adding decoder: 下表的第二组。采用的encoder。平均多增加了20B的计算消耗。
  • Coarser feature maps: 测试了使用output_stride=32 ,这样计算速度更快。但是相对于output_stride=16 准确率下降了1-2%左右。
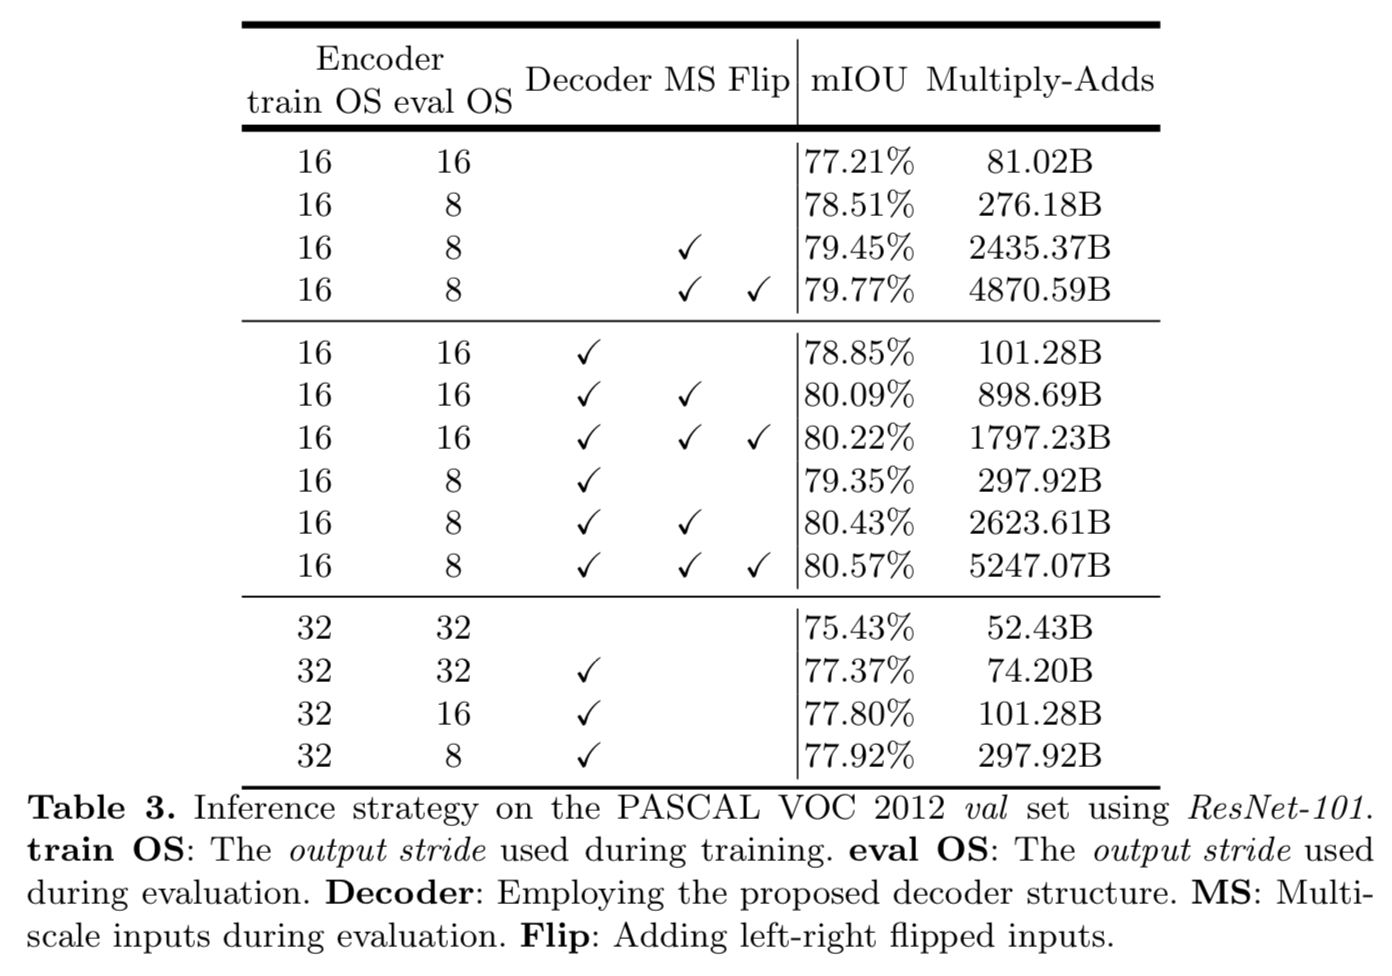
在这里插入图片描述

可以看到使用多尺度MS MSMS计算量计算量增加一个数量级,使用左右翻转Flip FlipFlip计算量翻倍。

Xception as Network Backbone

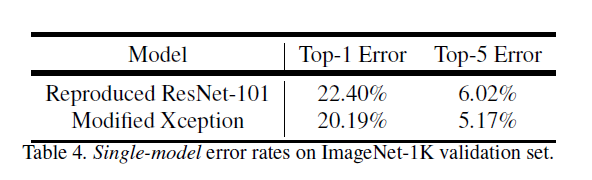
ImageNet pretraining: 改进后的Xception网络在ImageNet-1K上做了预训练。训练设置如下:

选项配置
优化器Nesterov momentum optimizer,momentum = 0.9
学习率初始学习率0.05,2个epochs衰减0.94
weight_decay4e-5
硬件同步使用50 GPUs
batchsize每个GPU取32
image size299x299

在这里插入图片描述

可以看到Modified Xception性能要好点。

整体的使用Modified Xception做为网络骨架,使用如下几种变体:

  • Baseline: 不使用decoder.
  • Adding decoder: 添加了decoder.
  • Using depthwise separable convolution: 在ASPP和decoder中使用深度分离卷积。计算量下降了30-40%.
  • Pretraining on COCO: 在MS-COCO数据集上预训练
  • Pretraining on JFT: 在IamgeNet-1K和JFT-300M上预训练
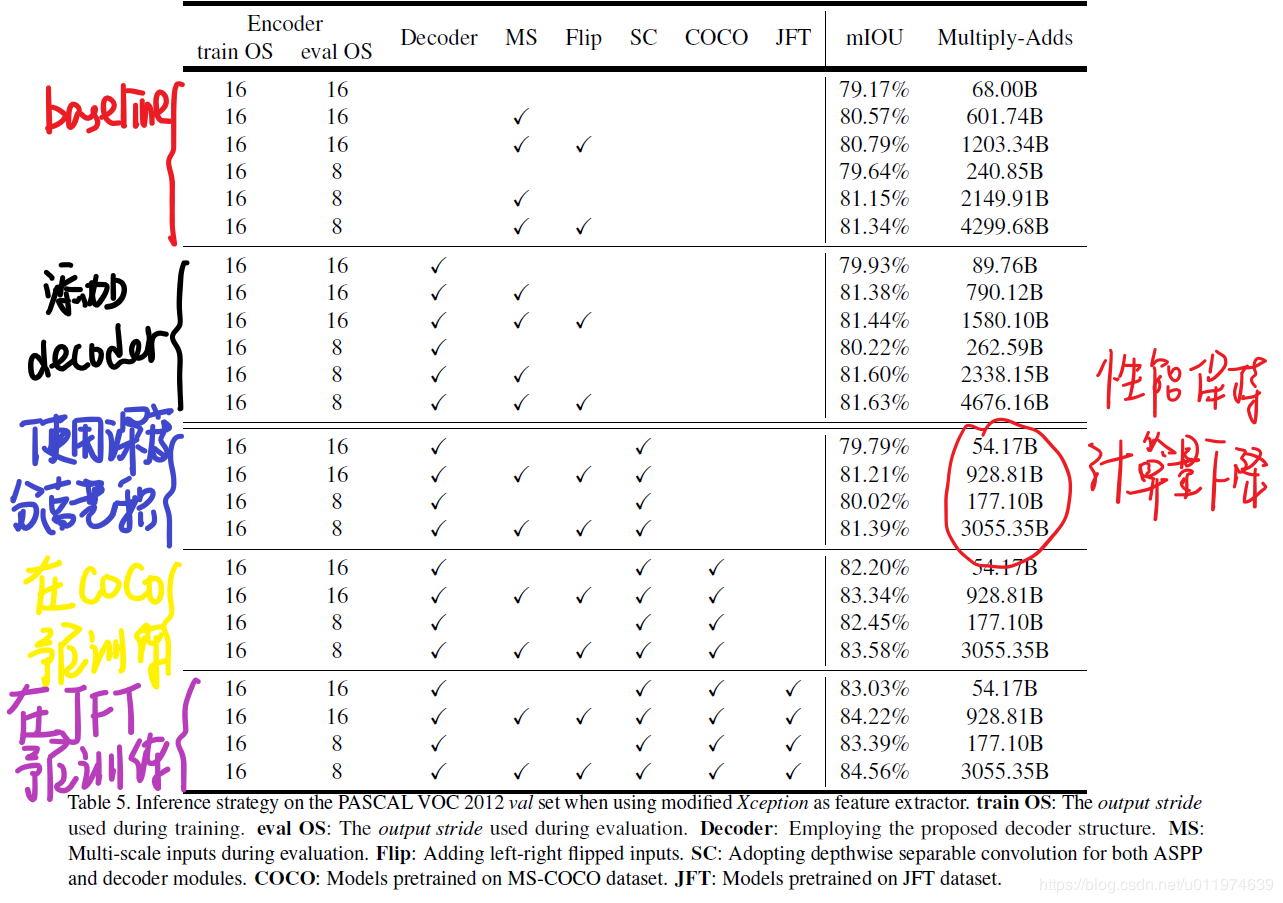
在这里插入图片描述
上图copy 自博客https://blog.youkuaiyun.com/u011974639/article/details/79518175

可以看到使用深度分离卷积可以显著降低计算消耗。

与其他先进模型在VOC12的测试集上对比:
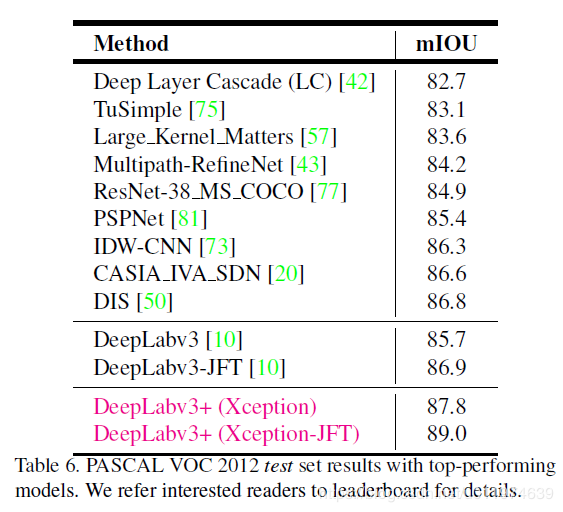
在这里插入图片描述

在目标边界上的提升

使用trimap实验测量模型在分割边界的准确度。计算边界周围扩展频带(称为trimap)内的mIoU。结果如下:

与双线性上采样相比,加decoder的有明显的提升。trimap越小效果越明显。

加了decoder的可视化结果如下:
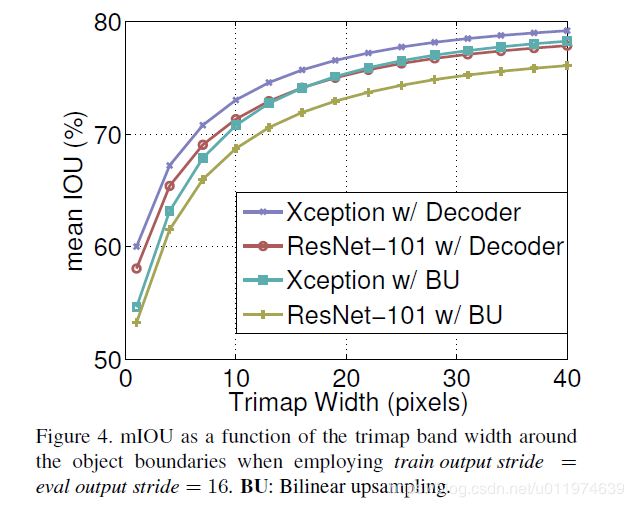
在这里插入图片描述

【语义分割系列:五】DeepLab v3 / v3+ 论文阅读翻译笔记 DeepLab v3 2017 CVPR Rethinking Atrous Convolution for Semantic Image Segmentation ❤ fregu856/deeplabv3 :PyTorch implementation of DeepLabV3, trained on the Cityscapes dataset. 官方开源 |Tensorflow Int... 阅读详情

相关推荐

【DeepLabv3+】Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation

这篇论文呢是参与了DeepLab整个系列的作者Liang-Chieh Chen的又咦新作。在V3的基础上进行的优化更新,故,又叫V3+。这个一作还参与了MaskLab系列和MobileNet系列的工作,其中就会设计到MobileNet的一些方法。 ECCV2018 ...

OneCoder的博客 1137

论文阅读:Enconder-Decoder with Atrous Separabel Convolution for Semantic Image Segmentation(deeplabv3+)

语义分割相关论文翻译(一):Enconder-Decoder with Atrous Separabel Convolution for Semantic Image Segmentation(deeplabv3+) 本人对语义分割的部分论文使用有道进行翻译,其中有错误的地方望大家谅解,只作为个人学习的笔记。 文章目录语义分割相关论文翻译(一):Enconder-Decoder with Atrous Separabel Convolution for Semantic Image Segmentatio

q蓝色Tu耳其 1113

deeplab v3+.pdf

Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation

Encoder-decoder with atrous separable convolution for semantic image segmentation

经典语义分割论文解读-Deeplab系列 - 知乎作为使用深度学习方法解决计算机视觉问题的一个重要分支,语义分割一直是一个重要的研究方向,一大堆研究人员前仆后继的往这个坑里跳,也相继的产出了很多惊艳的研究成果,今天我们一起了解下语义分割中很重要的一…https://zhuanlan.zhihu.com/p/357082897关于全卷积神经网络的思考 - 知乎最近一个月先后想明白了目标检测和图像分类、语意分割和图像分类之间的联系。 通过论文《Single-Stage Multi-Person Pose Mac

liguandong 3937

零基础玩转IndexTTS2:5分钟搭建个人语音克隆工具(支持B站同款情感语音)

本文详细介绍了如何零基础使用IndexTTS2快速搭建个人语音克隆工具,支持B站同款情感语音。IndexTTS2作为自回归零样本TTS系统,突破传统技术限制,实现精准时长控制和丰富情感表达。通过HuggingFace在线演示,用户可轻松克隆音色并调节情感参数,适用于自媒体配音、有声书朗读等场景。

purple的博客 917

华硕ROG枪神双系统实战:Ubuntu安装避坑指南

本文是华硕ROG枪神笔记本安装Ubuntu双系统的详细避坑指南。针对其独特的硬件与BIOS设计,文章核心解决了VMD控制器导致硬盘无法识别、驱动兼容性等关键难题,并提供了从BIOS设置、分区方案到安装后驱动配置与性能调优的一站式解决方案,帮助用户实现稳定的双系统体验。

raspberrypi5的博客 545

图像 分割 - DeepLabv3+: Encoder-Decoder with Atrous Separable Convolution for Semantic ... (ECCV 2018)

空间金字塔池化模块或编码解码器结构用于深度神经网络中的语义分割任务。前一种网络能够通过以多个速率和多个有效视场使用滤波器或池化操作来探测传入特征,从而对多尺度上下文信息进行编码,而后一种网络可以通过逐渐恢复空间信息来捕捉更清晰的目标边界。在这项工作中,我们建议将这两种方法的优点结合起来。具体而言,我们提出的模型DeepLabv3+通过添加一个简单而有效的解码器模块来细化分割结果,特别是沿着目标边界的分割结果,从而扩展了DeepLabv3。

77wpa的博客 2218

【自动驾驶端到端5:VADv2: End-to-End Vectorized Autonomous Driving via Probabilistic Planning】

从大规模人类驾驶演示中学习类人驾驶策略是有希望的。但是,规划的不确定性使得从驾驶演示中提取驾驶知识是有挑战性的。从统计学习的角度来看,动作(包括实际和速度)是高度随机的,受许多无法建模的潜在因素影响。

weixin_40000560的博客 1404

论文解读-Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation

将“DeepLabv3特征图”定义为由DeepLabv3计算得出的最后一个特征图,即包含ASPP特征和图像级特征的特征图。此外,作者还定义了“[k × k;f]”表示卷积操作,其中k × k表示卷积核的大小,f表示滤波器的数量。当使用输出步幅为16时,基于ResNet-101的DeepLabv3 [23]在训练和评估过程中通过双线性上采样将逻辑回归结果上采样16倍。

sanguine__的博客 2619

App爬虫实战篇-以华为真机手机爬取集换社的app为例

在开始学习这篇文章之前,建议你先按照之前2篇文章(和),配置必要的环境,才可以继续完成本章节内容。

youbingchen的博客 780

C#串口通信从入门到精通(1)——硬件接线

RS-232接口一般都是9针的,有公母头(针头和孔头),为了便有理解以下都称为针头和孔头,针头就是露出来的针,孔头就是9个孔,总共使用3条线进行通信,一条用于发送,一条用于接收,另外一根是GND地线,由于线路的功能是永久性的,设置连接时,必须确保一个节点的发送线与另一个节点的接收线相连,反之亦然,RxD(PC的接收线)连接到TxD(传感器电子设备的发送线),TxD(PC的发送线)连接到RxD(传感器电子设备的发送线)。两条线路的电平都是相对于GND的。因此,GND也必须连接,但不能将GND与屏蔽连接。

qq_34059233的博客 1万+

DeepLab V3+——Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation

在DeepLab V3+中通过采用了encoder-decoder结构,在DeepLab V3中加入了一个简单有效的decoder模块来改善物体边缘的分割结果。除此之外还尝试使用Xception作为encoder,在Atrous Spatial Pyramid Pooling和decoder中应用depth-wise separable convolution得到了更快精度更高的网络,在PASCAL VOC 2012数据集上达到state-of-art的效果。 Paper:https://arxiv.o.

qq_38343151的博客 756

SAP 采购订单入库——移动类型

业务场景:采购入库,实物入库至仓库,然后系统同步过账。MIGO:收货、采购订单。 MVT:101 入库,---库存增加。 MVT:移动类型,就是代表业务场景,(比如入库、发货,成本中心发、工单发、报废、盘赢、盘亏等等) 移动类型 1、正向采购入库:101 2、反向冲销(MIGO)102:与101相反,用于错误操作的反向冲销。参考原凭证,全部进行一...

willieyuan的博客 7779

deeplab v3+---Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation

一.摘要: 1.spp是什么? 问题:分割 我们提出了什么: 1.deeplab v3+ 在deeplab v3的基础上加了一个简单的decoder模块来改善分割结果,尤其是对于边界区域 2.我们采用xception当中的深度壳分离卷积,来应用到aspp和decoder模块中去,能够得到一个更好和更快的结果 结果: 我们证明了所提出的模型在PASCAL VOC 2012语义图像分割数...

zxyhhjs2017的博客 1024

Open3D 球旋转算法(BPA)三维建模【2026最新版】

球旋转算法,博客长期更新,本文最新更新时间为:2026年4月11日。

点云侠的博客 37万+

基于Django+Vue3的目标检测系统设计与实现,Web前后端分离,Vue3前台系统+Django后台管理系统开发,YOLOv11 Web目标检测,实现图片、视频和摄像头检测等功能,全网独发

基于Django+Vue3的智能目标检测系统设计与实现,Web前后端分离,YOLOv11 Web目标检测,Vue3前台系统+Django后台管理系统开发,实现图片检测、视频检测、摄像头检测、登录、注册和个人中心功能

在职AI算法工程师,擅长计算机视觉,YOLO目标检测、分割等,擅长web、pyqt界面可视化,好内容持续更新中,来这里跟大家一起学习,共同进步 3667

【语义分割—Deeplab V3+】Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation

deeplabv3+继续在模型的架构上作文章, 为了引入语义分割常用的encoder-decoder融合多尺度信息。在 encoder-decoder架构中,引入可任意控制编码器提取特征的分辨率, 通过空洞卷积平衡精度和耗时。在语义分割任务中采用Xception模型, 在ASPP和解码模块使用depthwise separable convolution, 提高编码器-解码器网络的运行速率和稳定性, 在 PASCAL VOC 2012 dataset取得89.0% mIOU

扬帆·启航 1673

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

论文阅读:DeeepLab V3+《Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation》

ECCV 2018 论文链接:https://arxiv.org/pdf/1802.02611.pdf. 文章目录1 Background and Movtivation2 Related Work3 Advantages/Contributions4 Methods5 Experiments6 Conclusions 1 Background and Movtivation 语义分割给图像上的每个像素都分配一个语义标签,它是计算机视觉上最基础的话题之一。基于FCN的深度CNN在基准任务上实现了很好的性能.

yuansiming0920的博客 870

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

DeepLab-v3+:Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation

Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation 目前的问题: 深度神经网络采用空间金字塔池模块或编码解码器结构进行语义分割。 空间金字塔池模块:可以对多尺度的上下文信息进行编码,通过过滤器或多倍速率和多个感受野的汇聚操作来探测输入的特征。 编码解码器:可以通过逐步恢复空间信息来捕捉更...

makabaka的博客 902

《DeepLab v3+:Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation》论文笔记

1. 概述 导读:空间金字塔池化模块与编解码结构被广泛运用于DCNN网络的分割任务中。空间金字塔模块通过对输入的特征在多种比例与感受野上使用不同的filter或是池化操作,从而编码多尺度上下文信息;编解码结构可以通过逐步恢复的空间信息获取目标的边界。这篇文章提出的结构是DeepLab v3+,是在v3结构上添加一个解码模块,从而优化目标的边界。同时还引入了Xception模块,在ASPP模块与解...

m_buddy的博客 873

深度学习论文翻译 -- Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation

摘要:空间金字塔池化(spatial pyramid pooling)或者编码-解码结构(encode-decode)被广泛应用于语义分割任务。通过不同采样值(rates)和多个有效的感受野,前者可以获取不同尺度的信息,而后者通过逐渐恢复空间信息的方式,可以获取尖锐目标的边界。本文中,我们综合两种方法的优点,设计新的网络结构。特别地,我们提出的模型,DeepLabv3+,与deeplabv3相比,...

DAOCHI 1436

论文学习:Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation

20180313,谷歌开源了语义图像分割模型 DeepLab-v3+。 GitHub 地址:https://github.com/tensorflow/models/tree/master/research/deeplab 论文链接:https://arxiv.org/abs/1802.02611 ===============================================...

bcfd_yundou的博客 885

DeepLab_v3+:Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation

Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation谷歌出品的deeplabv3+,一般谷歌的论文都是实验做得好,比如mobile net系列的,毕竟人家的服务器多。在图像语义分割中,ASPP(Spaital pyramid pooling)和 encoder decoder的结构是十分常...

啦啦头头 2106

PaddleSeg 中的 DeepLabV3+ 语义分割:原理剖析、源码实现与配置实战

DeepLabV3+ 是 DeepLab 系列集大成之作,将空洞卷积(Atrous Convolution)、空洞空间金字塔池化(ASPP)与编码器-解码器(Encoder-Decoder)结构融为一体,在 PASCAL VOC 2012 与 Cityscapes 等数据集上取得了当时最优的分割精度。本文以 [docs/models/deeplabv3.md](https://link.gitco

gitblog_01102的博客 236

论文阅读笔记十二:Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation(DeepLabv3...

论文链接:https://arxiv.org/abs/1802.02611 tensorflow 官方实现:https: //github.com/tensorflow/models/tree/master/research/deeplab 实验代码:https://github.com/fourmi1995/IronSegExperiment-Deeplabv3_PLUS.git...

weixin_34205826的博客 236

TensorFlow DeepLab 语义分割官方模型库(Model Zoo)完整指南:VOC/Cityscapes/ADE20K 预训练权重、评估指标与复现参数

本文是 TensorFlow 官方 DeepLab 语义分割模型库([model_zoo.md](https://link.gitcode.com/i/dd1237c564a36154193ea4d438098b46))的深度解读。该模型库位于仓库 `research/deeplab` 下,官方提供了一系列在 **PASCAL VOC 2012、Cityscapes、ADE20K** 三大主流语义

gitblog_00587的博客 493
上一篇: Python安装 cv2
下一篇: Boosted Tree原理详解
庸木
博客等级 码龄8年 19粉丝 11原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值