如何组织一个并行程序

串行&并行程序在效率上的简单比较 开头:    这是老师在开学时布置的一道作业题目,完整问题为:“多核与单核的CPU在运行串行、并行程序时时,在效率上的差别。” 以前虽然常常听说多核,但是却没有去多了解下并行程序和串行程序,这次作业也算对这些概念有些熟悉。多核兴起:    20世纪40年代第一台电子管计算机的发明标志计算工具进入了一个崭新的时代。20世纪50年代末,晶体管的发现促成了计算机技术的一大飞跃,其性能先之电子 阅读详情

目录

背景:

块+线程建立索引

二维矩阵加法不同模式的对比

如何查询硬件信息


背景:

通过前面的学习,我们知道一个线程是通过一堆的坐标进行定位的,本期就详细的介绍每一个线程是怎么确定唯一的索引,然后建立并行计算,并且不同的线程组织形式是怎样影响性能的

块+线程建立索引

一个核函数绑定一个网格,网格当中我们去设置块,块里面有线程

索引是啥?

本质来说就是偏移量

大家都能访问全局数据,那针对全局数据,我们想要不同的线程访问不同的部分,那就要让每个线程根据偏移量去算属于自己的那部分即可

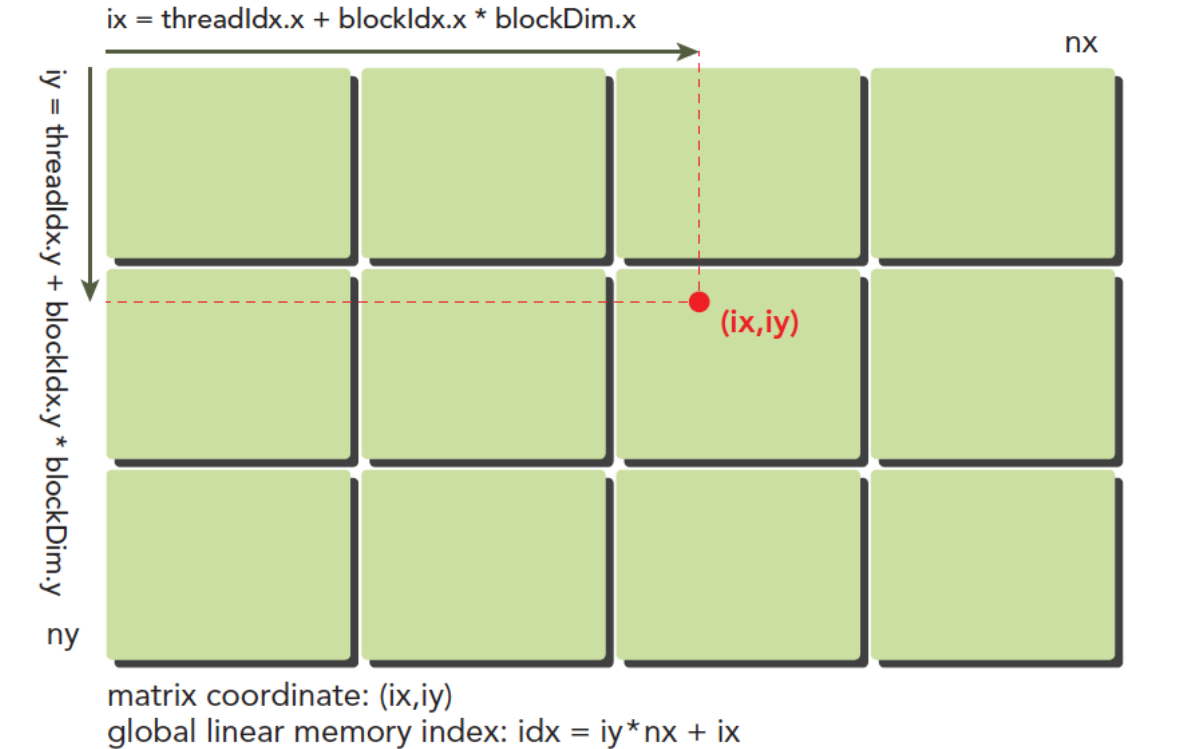
全局地址:(ix, iy),在整个全局网格当中,你属于哪里

局部地址:(threadIdx.x, threadIdx.y),在这个块中,你属于哪里

那计算一个全局地址,肯定要知道某个块有多少个线程,那就是blockDim.x

ix = blockIdx.x * blockDim.x + threadIdx.x;
iy = blockIdx.y * blockDim.y + threadIdx.y;

在学习Linux系统编程的时候就曾经学过数组是如何在内存当中分布的

在Host和Device中的内存都是线性的

我们要做管理的就是:

  • 线程和块索引(来计算线程的全局索引)
  • 矩阵中给定点的坐标(ix,iy)
  • (ix,iy)对应的线性内存的位置

你要学会把二维的地址映射成线性的一维地址,你一开始是计算得到ix,iy,但是你要通过这个地址计算偏移量,然后某个线程通过起始地址+偏移量就能在线性内存当中访问特定的地址

idx=ix+iy∗nx

这个就是偏移量idx的计算,iy*nx就是要把前面的跳过

我们上面已经计算出了线程的全局坐标,用线程的全局坐标对应矩阵的坐标,也就是说,线程的坐标(ix,iy)对应矩阵中(ix,iy)的元素,这样就形成了一一对应,不同的线程处理矩阵中不同的数据,举个具体的例子,ix=10,iy=10的线程去处理矩阵中(10,10)的数据,当然你也可以设计别的对应模式,但是这种方法是最简单出错可能最低的。
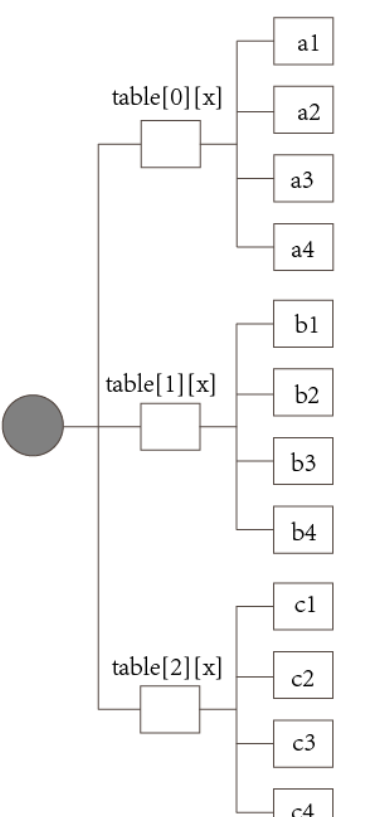
二维矩阵加法不同模式的对比

  • threadIdx.x:水平方向(列方向)的偏移

  • threadIdx.y:垂直方向(行方向)的偏移

int nx = 512;      // 矩阵的列数
int ny = 32768;    // 矩阵的行数

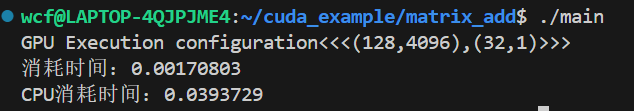
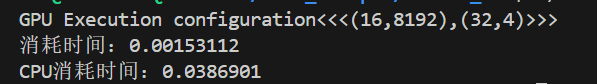
我们设置了二维矩阵加法,一共相加1<<24个数据

数据是一个 32768 行、512 列 的矩阵,总元素数 = 512 × 32768 = 16777216(即 1<<24)。

int dimx = 32;     // 每个线程块在 x 方向(列方向)的线程数
int dimy = 4;      // 每个线程块在 y 方向(行方向)的线程数
dim3 block(dimx, dimy);  // 二维线程块:32列 × 4行 = 128 个线程
dim3 grid((nx + block.x - 1) / block.x, (ny + block.y - 1) / block.y);
  • (nx + block.x - 1) / block.x 是向上取整公式,保证列方向有足够的线程块。

  • 代入数字:(512 + 32 - 1) / 32 = (543) / 32 = 16,列方向需要 16 个块。

  • (ny + block.y - 1) / block.y = (32768 + 4 - 1) / 4 = 8192,行方向需要 8192 个块。

  • 网格总大小:16 × 8192 = 131072 个线程块。

  • 每个块 128 线程,总线程数 = 131072 × 128 = 16777216,恰好等于数据元素总数,完美覆盖。

__global__ void vectorSumDevice(float* a,float*b,float*res,int nx,int ny){
    //先算出下标
    int ix=threadIdx.x+blockIdx.x*blockDim.x;
    int iy=threadIdx.y+blockIdx.y*blockDim.y;
    if (ix < nx && iy < ny) {
        int idx = iy * nx + ix;
        res[idx] = a[idx] + b[idx];
    }
}

if是因为我们向上取整,所以可能开多了线程数,所以可能越界,这里是为了防止越界的

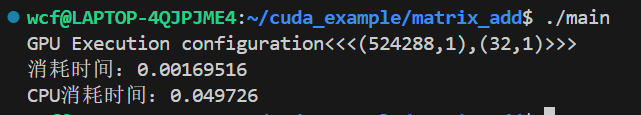
相差25倍啊,这就是并行计算的优势

二维网格一维块

一维网格一维块

  • 改变执行配置(线程组织)能得到不同的性能
  • 传统的核函数可能不能得到最好的效果(默认配置)
  • 一个给定的核函数,通过调整网格和线程块大小可以得到更好的效果

没有万能配置,最佳 Block 大小取决于核函数的寄存器用量、共享内存大小、数据规模,以及你的 GPU 架构(计算能力)。工具就是反复试验,用 ncu 或计时器对比不同配置的耗时。

接下来我们将深度刨析底层硬件结构,了解完之后再来看为什么不同的配置效果竟然不一样
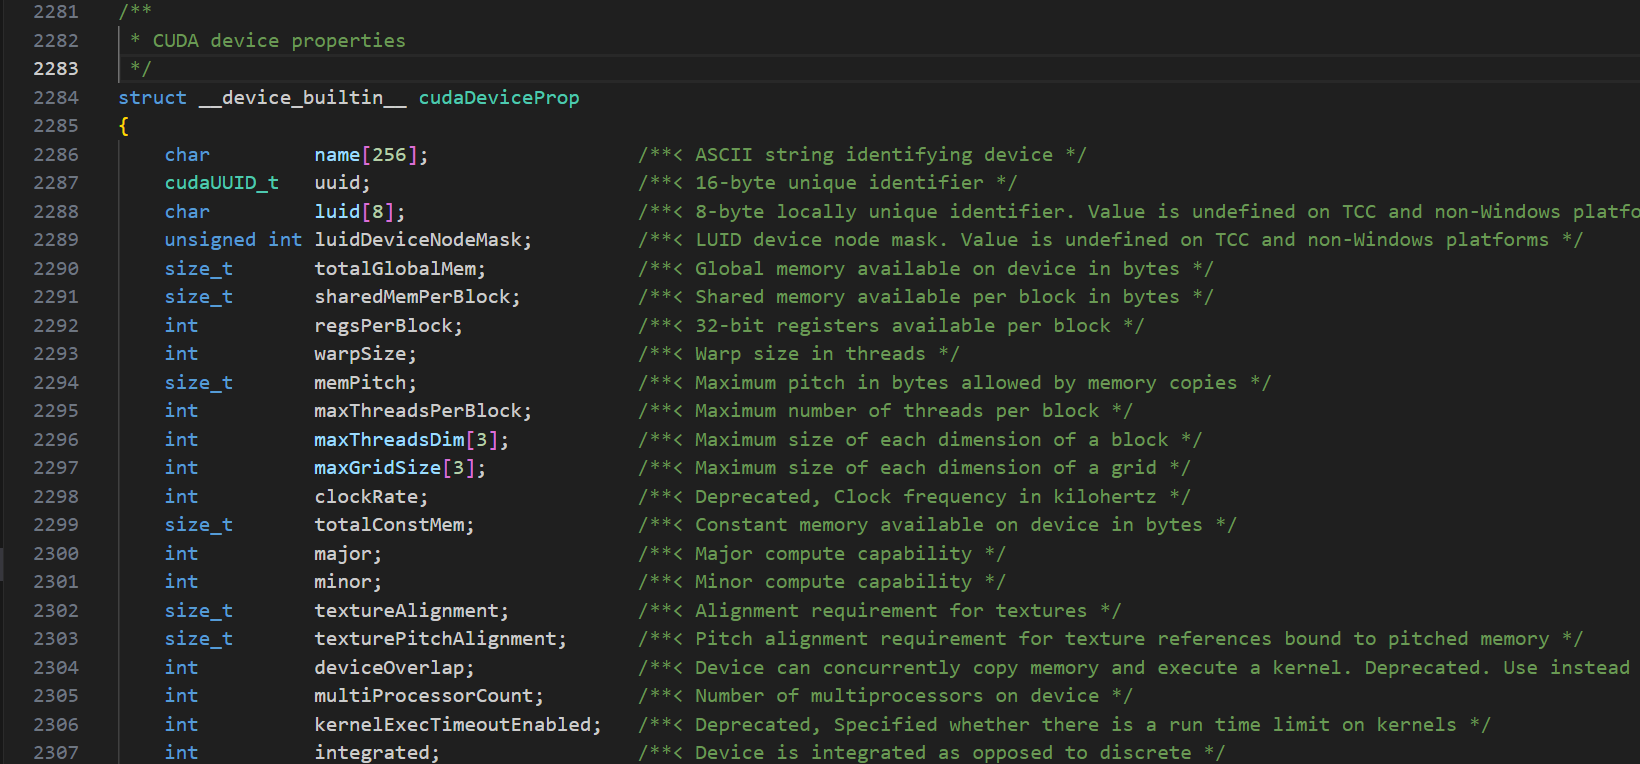
如何查询硬件信息

获取设备数量:

cudaError_t cudaGetDeviceCount(int* deviceCount);
  • deviceCount:输出参数,指向一个 int 变量的指针,函数执行成功后会把可用 CUDA 设备的数量写入这个变量。
  • 返回值:cudaError_t 类型的错误码
    • 成功:返回 cudaSuccess(数值为 0)
    • 失败:返回非 0 错误码,需要通过 cudaGetErrorString() 解析

获取设备信息

cudaError_t cudaGetDeviceProperties(
    cudaDeviceProp* prop,  // 输出参数:CPU 内存中的结构体指针
    int device             // 输入参数:设备索引(从 0 开始)
);

返回值:cudaError_t 错误码

  • 成功:cudaSuccess
  • 失败:常见错误如 cudaErrorInvalidDevice(设备索引越界)、cudaErrorInitializationError(CUDA 运行时初始化失败)

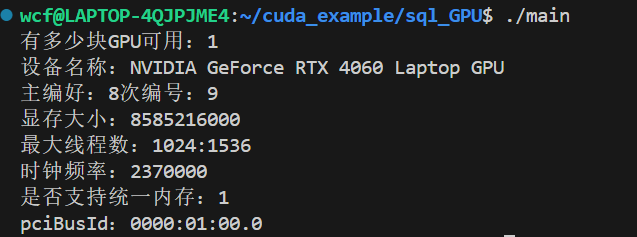
cudaDeviceProp 包含超过 100 个字段,只需要记住一些常见的,或者你用的时候在查一下

  • 名称:prop.name

  • 计算能力:prop.major, prop.minor(主次版本号)

  • 显存大小:prop.totalGlobalMem

  • 多处理器(SM)数量:prop.multiProcessorCount

  • 最大线程数:prop.maxThreadsPerBlock(单个线程块允许的最大线程数)、prop.maxThreadsPerMultiProcessor(单个 SM(流式多处理器)硬件上最多能同时驻留的线程总数。)

  • 时钟频率:prop.clockRate(KHz)

  • 是否支持统一内存:prop.unifiedAddressing

设置/获取当前设备:

// 设置当前活跃设备
cudaError_t cudaSetDevice(int device);

// 获取当前活跃设备
cudaError_t cudaGetDevice(int* device);
  • cudaSetDevice 只影响调用它的那个 CPU 线程
  • 不同的 CPU 线程可以同时使用不同的 GPU 设备
  • 一个 CPU 线程同一时间只能有一个活跃设备

根据条件选择设备:cudaChooseDevice

cudaError_t cudaChooseDevice(
    int* device,                // 输出:选中的设备索引
    const cudaDeviceProp* prop  // 输入:要求的设备属性
);

// 要求:计算能力至少 8.0,显存至少 8GB
cudaDeviceProp requirement;
memset(&requirement, 0, sizeof(requirement));
requirement.major = 8;                  // 主版本号至少 8
requirement.totalGlobalMem = 8 * 1024 * 1024 * 1024ULL; // 显存至少 8GB

int bestDevice;
cudaChooseDevice(&bestDevice, &requirement);

printf("自动选择的最优设备: %d\n", bestDevice);
cudaSetDevice(bestDevice);

查看 PCIe 总线等信息:cudaDeviceGetPCIBusId

cudaError_t cudaDeviceGetPCIBusId(
    char* pciBusId,    // 输出:PCIe ID 字符串,长度至少 16 字节
    int len,           // 缓冲区长度
    int device         // 输入:CUDA 设备索引
);
  • pciBusId:你提供的一个字符数组(缓冲区),用于接收总线 ID 字符串。

  • len:这个缓冲区的长度。官方文档规定最小为 13,但建议给 128 足以万无一失。

  • device:要查询的 GPU 编号(0, 1, 2...)。

  • 返回值:cudaError_t,成功时返回 cudaSuccess。

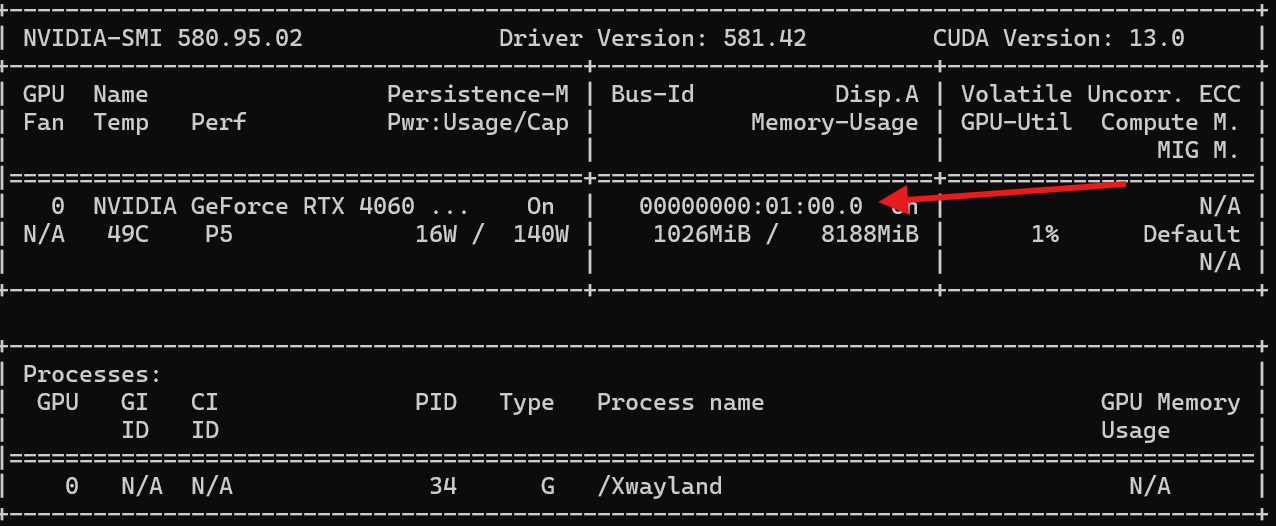
返回的字符串格式是固定的:"domain:bus:device.function",例如 "0000:01:00.0"。这和在 nvidia-smi 里 Bus-Id 一栏看到的完全一致。

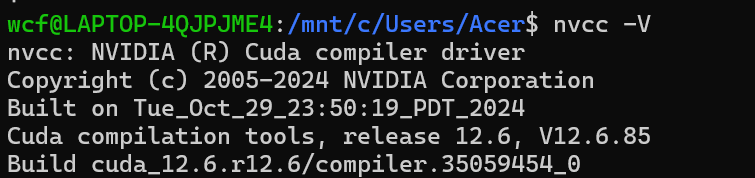
查询CUDA版本

// 获取驱动支持的最高 CUDA 版本
cudaError_t cudaDriverGetVersion(int* driverVersion);

// 获取当前运行时库的版本
cudaError_t cudaRuntimeGetVersion(int* runtimeVersion);

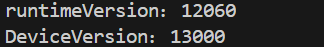
版本号 = 主版本号 × 1000 + 次版本号 × 10
  • 驱动版本告诉你:你的显卡最多能跑多新的 CUDA 程序
  • 运行时版本告诉你:你的程序是用哪个版本的 CUDA 编译的

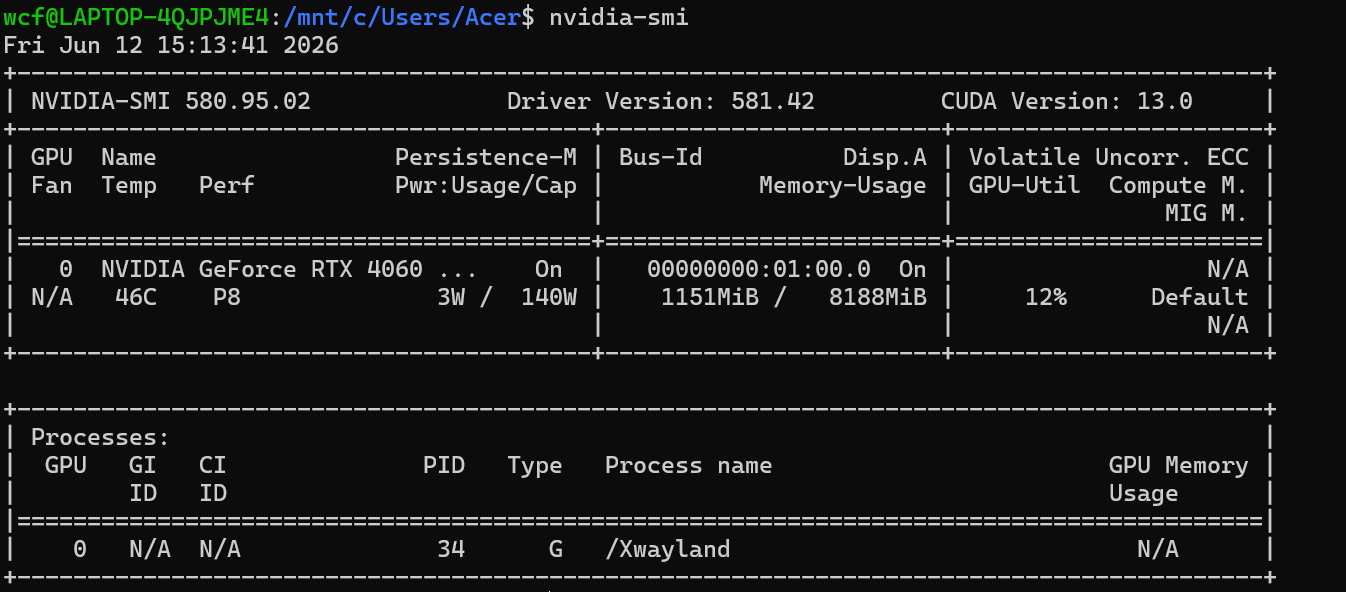
581.42 版本驱动,最多能跑用 CUDA 13.0 及以下版本编译的程序

我安装了12.6的版本,所以可以兼容,向下是可以兼容的,向上就不行

所以有时候安装的cuda过高,但是驱动不行,要么就升级驱动,要么就静态链接而不是采用动态

没问题,通过函数查询也是这个结果

nvidia-smi

nvidia-smi 全称 NVIDIA System Management Interface,是 NVIDIA 驱动自带的命令行 GPU 监控管理工具,不需要额外安装,只要装了 NVIDIA 显卡驱动就有。它是 CUDA 开发者、AI 从业者和运维人员最常用的工具,没有之一。

nvidia-smi --help

可以通过这个命令去参看其参数

分为三个标准部分:

  1. 顶部系统信息栏:驱动版本、CUDA 支持版本(只要小于13.0版本的兼容)
  2. 中间 GPU 设备信息表:核心硬件状态(温度、功耗、显存、利用率)
  3. 底部进程占用表:哪些进程正在使用 GPU 和显存
字段含义说明
GPU 0GPU 设备索引,从 0 开始对应cudaSetDevice(0)的参数,我只有 1 块显卡所以只有 0 号
Name显卡完整型号NVIDIA GeForce RTX 4060(笔记本版)
Fan显卡风扇转速(0-100%)显示N/A是正常的:笔记本显卡的风扇由主板 EC 直接控制,nvidia-smi 读不到转速
TempGPU 核心温度(摄氏度)46℃,非常健康的待机温度(正常范围 30-85℃)
PerfGPU 性能状态从 P0(最高性能)到 P12(最低功耗)。你这里是 P8,说明 GPU 处于低功耗待机状态,运行程序时会自动升到 P0-P2
Persistence-M持久模式On 表示驱动常驻内存,加快 CUDA 程序启动速度。服务器建议开启,笔记本不用管
Pwr:Usage/Cap当前功耗 / 设计功耗上限3W / 140W,待机功耗极低。运行大型程序时会接近 140W 的上限
字段含义说明
Bus-IdPCIe 总线 ID00000000:01:00.0,是物理 GPU 的唯一永久标识,对应cudaDeviceGetPCIBusId的返回值
Disp.A显示输出状态On 表示这个 GPU 正在连接显示器输出画面。我的笔记本屏幕就是由这块 4060 驱动的
Memory-Usage显存使用量 / 总显存1151MiB / 8188MiB,也就是 8GB 显存,当前用了约 1.1GB(主要是桌面系统占用)
Volatile Uncorr. ECCECC 内存错误计数消费级显卡没有 ECC 纠错内存,所以永远显示 N/A
GPU-UtilGPU 核心利用率(0-100%)12%,说明有轻微的图形负载(桌面动画、窗口拖动),没有运行计算程序
Compute M.计算模式Default 是默认模式,允许多个进程同时使用 GPU。还有 Exclusive Process(独占模式,只允许一个进程使用)
MIG M.多实例 GPU 模式消费级显卡不支持 MIG,所以永远显示 N/A
字段含义你的情况说明
GPU进程所在的 GPU 索引0 号 GPU
GI ID / CI IDGPU 实例 ID 和计算实例 ID只有开启 MIG 的服务器卡才会显示,消费级永远 N/A
PID系统进程 ID34,可以用 `ps -efgrep 34` 查看这个进程的详细信息
Type进程类型G= 图形进程(桌面、游戏、视频播放);C= 计算进程(CUDA、AI 训练、推理)
Process name进程名称/Xwayland是 Linux 桌面的显示服务器,负责渲染桌面和窗口
GPU Memory Usage该进程占用的显存显示 N/A 是正常的:Wayland/X11 的显存占用会合并到总显存中,不单独统计

支持非常强大的命令

1. 实时监控 GPU 状态(每秒刷新)
nvidia-smi -l 1

2. 查看更详细的硬件信息
# 显示所有GPU的完整信息
nvidia-smi -q

# 只显示特定GPU的信息
nvidia-smi -q -i 0

3. 自定义输出字段(适合脚本使用)
# 只输出显卡型号、温度、核心利用率、显存利用率
nvidia-smi --query-gpu=name,temperature.gpu,utilization.gpu,utilization.memory --format=csv

4. 实时监控进程 GPU 占用
# 每秒刷新一次,显示所有GPU进程的利用率
nvidia-smi pmon -s u -d 1

5. 释放被占用的 GPU 显存
nvidia-smi --gpu-reset -i 0

接下来我们将重点讲解硬件知识,然后根据硬件来配置最好的参数
用Ray在Python中构建高效并行程序 在当今数据驱动的时代,许多计算任务需要处理大量的数据和复杂的算法,传统的串行编程方式往往无法满足对计算效率的要求。Ray是一个开源的分布式计算框架,它可以让Python开发者轻松地将串行代码转换为并行代码,从而显著提高程序的执行效率。本文的目的是详细介绍如何使用Ray在Python中构建高效的并行程序,涵盖了从基础概念到实际项目应用的各个方面。范围包括Ray的核心原理、算法实现、数学模型、项目实战以及相关的工具和资源推荐。 阅读详情

相关推荐

串行&并行程序在效率上的简单比较

开头:    这是老师在开学时布置的一道作业题目,完整问题为:“多核与单核的CPU在运行串行、并行程序时时,在效率上的差别。” 以前虽然常常听说多核,但是却没有去多了解下并行程序和串行程序,这次作业也算对这些概念有些熟悉。多核兴起:    20世纪40年代第一台电子管计算机的发明标志计算工具进入了一个崭新的时代。20世纪50年代末,晶体管的发现促成了计算机技术的一大飞跃,其性能先之电子管计算机数十倍到数百倍以上。而之后集成电路时代的到来又为计算机的发展开辟了一个新的里程。    20世纪70年代,集成电路技

雲中的专栏 6848

Linux Centos下安装MPICH以及运行第一个并行程序

一:Linux下安装与配置MPICH         为了在Linux下运行我们的并行程序,我们需要安装MPICH,现在的版本是MPICH2,下载地址:#迅雷下载分享# mpich2-1.5.tar.gz [下载速度:200.82 KB/s] [文件大小:21.77 MB] 点击下载:  http://convurl.com/GrM1C          下载完成后,用SSH登录Linux系

天道酬勤 1万+

23、并行程序性能指标解读

本文详细解读了并行程序中的关键性能指标,包括并行运行时间、成本、加速比和效率,并探讨了强弱可扩展性的概念与实际应用。通过理论分析和具体案例(如矩阵乘法和数据排序),帮助开发者更好地评估和优化并行程序的性能。文章还提供了实用的性能优化建议,旨在提升并行计算的效率和可扩展性,适用于各类科学计算和大规模数据处理场景。

tequila的博客 80

简单排序的OpenMP并行程序

同时,为了避免程序的多次间断的运行,导致程序运行时CPU的状态差,导致实验获取的结果误差较大,这里考虑,创建数组提前存储“1、2、4、8、16、32、64”,然后通过for循环将数值传入函数“double achieve(int thread_num)”中,获取运行时间,并计算出对应5次实验的平均值。同时,随着线程数增加,又会导致子数组的归并开销加大,线程调度的开销加大,所以当线程数增加到一定程度时,通过增加线程数的排序加速会逐渐消失,使得最后的运行时间和加数比逐渐趋于平缓。接着,考虑如何实现并行的排序。

weixin_60705585的博客 1183

并行程序测试与逻辑容错的深度解析

本文深入探讨了并行程序的测试与逻辑容错技术,涵盖了信号量类型、异常处理、基本测试类型以及并行程序的测试策略。文章强调了测试与异常处理在确保软件可靠性和容错性方面的重要性,并通过并行程序设计模型的实例,展示了如何运用PADL分析和PBS模型来提升软件质量。

weixin_33239721的博客 453

并行程序测试与逻辑容错策略

本章节深入探讨了并行程序中的异常处理和逻辑容错策略,强调了在软件设计阶段集成异常处理策略的重要性。介绍了通过继承和用户自定义异常类来扩展标准C++异常类的方法,以及如何使用这些异常类来增强软件架构的鲁棒性。特别指出,异常处理策略应作为软件架构的一个基本组成部分,对提高软件的正确性、可靠性和意义具有决定性作用。

weixin_42361478的博客 352

矩阵乘法的MPI并行程序

这主要是与前面代码描述部分中分析的“矩阵乘法过程中,每一个进程都平均需要完成q次的a数组子块数据交换和覆盖、q次的b数组子块数据交换和覆盖,以及q次子块矩阵的乘法”有关系,随着进程数的增加,子块大小在逐渐减少,每个进行子块矩阵的乘法的计算的时间开销在减小,通信的数据量大小是保持不变的,但是通信次数的增加和通信结点是在增加的。同时,程序中的三层for循环,计算进程中子块a和子块b的矩阵乘法中,我针对性的调整了for循环的顺序,来提高for循环过程中的cache的命中率,来提升程序的性能。

weixin_60705585的博客 1447

NMOS管和PMOS管做开关控制电路

NMOS管和PMOS管做开关控制电路

while(1) 3万+

clock函数在计算并行程序用时中存在的问题

clock函数在计算并行程序用时中存在的问题:计算多个核心总共执行的时钟嘀嗒数,会造成时间偏大。

Onwaier的博客 2469

cadence—virtuosoic617的使用技巧收集区

cadence使用

qq_33599939的博客 3万+

别再死记硬背了!用Multisim仿真5分钟搞懂运放电压跟随器到底要不要加反馈电阻

本文通过Multisim仿真实验,深入解析运放电压跟随器中反馈电阻的必要性。实验对比不同阻值对电路性能的影响,揭示反馈电阻在提供偏置电流通路、提升高频稳定性和ESD保护中的关键作用,并给出工程实践中的优化建议,帮助工程师快速掌握运放电路设计要点。

weixin_42641998的博客 371

linux中mpich编程_Linux CentOS下安装MPICH以及运行第一个并行程序

一:Linux下安装与配置MPICH为了在Linux下运行我们的并行程序,我们需要安装MPICH,现在的版本是MPICH2,下载地址:mpich2-1.5.tar.gz [文件大小:21.77 MB] 下载:用户名:www.linuxidc.com密码:www.muu.cc在 2012年LinuxIDC.com\10月\Linux CentOS下安装MPICH以及运行第一个并行程序下载完成后,用...

weixin_42412850的博客 681

在虚拟机中对阿克曼转向车进行导航及避障的仿真测试

一、    在我使用rosdep install teb_local_planner去安装teb_local_planner的时候,报错:Command ‘rosdep’ not found, but can be installed with:sudo apt install python3-rosdep2    我花大半个月好不容易建立起的一系列ROS环境,被python3-rosdep2这条万恶的语句连同ROS一起给我删了。。。悲伤来的那么猝不及防    随着ROS版本的迭代,相关资料很多都不再适用

慕羽★的博客 3807

测试并行程序

测试并行程序   作者:Cesar Martinez(英特尔) 计算机科学领域的一条定律就是世人对更高性能的追求永远不会满足。如今,这些需求不仅仅针对速度,而且还针对体积更小、功能更加强大的移动设备。为了满足不断增长的用户期望,IDC 公司预期原始设备制造商 (OEM) 将会选择速度更快的多核处理器来支持他们的设备[1]。在这种背景下,并行程序将在移动设备中大量使用以充分利用多核技

gukesdo的专栏 1076

CAM350常用快捷键

CAM350快捷键 CAM350常用快捷键

bhxc809751502的博客 3061

高云FPGA系列教程(7):ARM GPIO外部中断

高云GN1NSR-4C共有16个GPIO,每个GPIO可配置成输入或输出模式,支持中断输入,触发方式可选择:上升沿、下降沿、高电平、低电平触发。中断优先级可通过NVIC进行设置,支持 0-7 级可编程中断优先级。

whik1194的博客 1376

MPI并行程序的调试技巧

http://galoisplusplus.gitcafe.com/blog/2013/06/08/mpi-debug-tips/" style="width:100%; height:100%"> backup content

yszheda的专栏 1万+

知识图谱实战应用8-从文本关系抽取到知识图谱关系构建流程贯通

大家好,我是微学AI,今天给大家介绍一下知识图谱实战应用8-从文本关系抽取到知识图谱关系构建流程贯通。我们从文本数据中采集到关键信息,并抽取出其中的关系信息,然后在存入图数据库中,整个过程实现自动化,我这里将举一个文本例子进行抽取。 对于知识图谱的构建是将实体、概念和它们之间的关系都以图表形式呈现出来的一种数据结构。要构建一个知识图谱,需要从不同的数据源中采集到相关信息,并将这些信息整合在一起,最终形成一个全面而且精确的知识图谱。

微学AI的博客 2545

串行程序,并发程序,并行程序,进程状态

摘自:go并发编程实战 第二版 串行程序: 只能被顺序执行的指令列表。 并发程序: 可以被同时发起执行的程序。允许其中的串行程序运行在一个或多个可共享的cpu上,同时也允许每个串行程序都运行在专为他服务的cpu上。 并行程序: 可以在并行的硬件上执行的并发程序。 并发程序代表了所有可以实现并发行为的程序,包含了并行程序。   进程状态: 1.可运行状态(task_running...

Yu的博客 2655

Modis数据处理工具:MRT百度网盘下载和手把手图文安装教程

如下图所示为MODIS Reprojection Tool(MRT)的软界面,看似简单,却是Modis遥感影像必不可少的处理工具,如投影变换等。本文以图文并茂的形式,详细讲解MRT软件在Windows10平台上的安装过程,并附MRT软件百度网盘下载地址。 Modis Tool主界面: 一、安装过程 1、安装Java运行环境 双击Java.exe,安装运行环境。默认的安装路径为C:\Program Files (x86)\Java\jre6\bin,后面需要用到这个路径。 等待...

智慧空间实验室 2623

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

深圳大学并行计算实验三简单排序的OpenMP并行程序

3. 实验结果和分析:测试并行程序在不同线程数下的执行时间和加速比(串行执行时间/并行执行时间),并分析实验结果。固定为100000000,线程数分别取1、2、4、8、16、32、64时,为减少误差,每项实验进行5次,取平均值作为实验结果。中的每个数都初始化为一个0到1之间的随机double型值(用rand()/double(RAND_MAX)实现)。l 添加计算排序时间的代码,注意不包含数组的初始化时间。表1 并行程序在不同线程数下的执行时间(秒)和加速比。判断并行的结果数组是否有序。

jannleo的博客 1146

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

基于任务复制的异构集群并行程序的执行

概述:在本文中,我们在一个异构的计算机集群中使用一种基于重复任务调度方法。基于重复调度方法是为了减少有相关联的任务之间的通信操作,在这里关键任务被多次分配到多台机器上,而随后的任务的开始时间也会减少。这种任务重复的过程也会不均匀地被各个系统

Gikieng的奋斗路 2008

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

windows C++系列- 独立应用程序和并行程序集

独立应用程序和并行程序集是一种 Microsoft Windows 解决方案,可减少 Windows 客户端应用程序中的版本控制冲突。 借助 Windows,应用程序开发人员可以生成完全自我描述且不受注册表更改、其他应用程序或系统上运行的其他程序集版本影响的独立应用程序。 部署后,应用程序作者和管理员可以使用清单来管理并行程序集的共享,无论是全局还是每个应用程序。 客户受益于独立应用程序,这些应用程序更稳定、更新更可靠。

王马的博客 1224

组织要为每一个员工赋能

的关键词。只有关注人的成长,成为价值型组织,才能在变化中生存下去。 Ⅰ 从三个链条到三个角色 管控无法适应变化的环境   传统的管理中,最重要的链条有三个: 1.命令链。 2.信息链。 3.人际关系链。 大部分情况下,在组织系统中,都靠这三个链条来打通。我们通过命令链,让上下的指令一致,通过信息链,使整个组织管理在一个统一的信息系统中,更重要的是我们让人与人的关系,在这个组织系统中保持一个很好的、有效的、有序的连接。 在传统的组织管理中,我们关注的这三个最重要的链条折射出传统的领导者有三

hebeind100的博客 1156
上一篇: CUDA程序效率如何计算以及工具如何使用
下一篇: CUDA执行模型深入刨析
Fcw0551
博客等级 码龄2年 330粉丝 115原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值