并行计算的本质:为何需要它???

R语言:并行计算 一直以来,总觉得并行计算是种很高深的技术,需要系统性的学习才能掌握。直到最近工作中进行大量循环计算,动辄十几个小时,实在是被整崩溃了,于是百度了一下,惊喜的发现R有很傻瓜的并行计算用法,完全满足基本的计算需求,这里简单记录一下。 R语言的并行可以用parallel包,这个包是自带的,不用下载,直接library即可。它本质上相当于打开多个R控制台,然后将任务拆分后让这些控制台计算,等各部分计算完成后再合在一起呈现出来。 完成一次并行计算需要的函数主要有:makeCluster、clusterExport 阅读详情

目录

1.前言

2.背景:并行计算为什么必然出现

3.软件视角理解并行性

3.1指令并行

3.2数据并行

4.数据划分的两种核心策略

4.1块划分 (Block Partitioning)

4.2周期划分 (Cyclic Partitioning)

5.硬件视角理解并行性

6.优化方向

7.内存架构划分:看硬件“怎么组织团队”

总结


1.前言

在c++编程和Linux编程的学习下,我们学习了三高

  • 高并发:系统能同时处理海量请求(像双十一秒杀)。

  • 高可用:系统全年无休,很少宕机(通过冗余、自动故障转移实现)。

  • 高可扩展/高性能/高吞吐:业务量激增时,加机器就能轻松扛住,性能能线性提升。

并发和并行有啥区别?
对比维度并发并行
本质逻辑上同时发生,是一种任务组织方式。物理上同时发生,是一种执行状态。
形象比喻一个人(单核)同时玩三个球,快速轮流抛接,看起来三个球都在空中。三个人(多核)各玩一个球,三个球真正在同一时刻被抛起。
与 CPU 的关系不一定依赖多核,单核 CPU 通过时间片轮转即可实现,这是“切换的错觉”。必须依赖多核或多处理器,需要真正的独立计算通道。
CUDA 中的体现CPU 管理多个异步流,GPU 快速切换线程束(Warp)隐藏访存延迟。

GPU 里成百上千个核心真正同时计算矩阵。

2.背景:并行计算为什么必然出现

我们的计算机从最早的埃尼阿克到现在的各种超算,都是为了应用而产生的,软件和硬件相互刺激而相互进步,并行计算也是这样产生的,我们最早的计算机肯定不是并行的,但是可以做成多线程的(并发,不是真正的并行),因为当时一个CPU只有一个核,所以不可能一个核同时执行两个计算,后来我们的应用逐步要求计算量越来越高,所以单核的计算速度也在逐步上升,后来大规模并行应用产生了,我们迫切的需要能够同时处理很多数据的机器,比如图像处理(GPU主攻),以及处理大规模的同时访问的服务器后台(CPU主攻)。

  • 硬件不行了 → 软件跑得太慢,程序员叫苦 → 刺激硬件厂商研发更快的芯片

  • 新硬件出来了 → 计算能力暴涨 → 刺激软件开发者写出更复杂、更强大的程序(比如从文字处理到 4K 视频渲染)

  • 然后新软件又对硬件提出更高要求,如此循环往复。

也就是软件处理的数据越来越多,对计算要求越来越高,对硬件的要求越来越高,单核已经不足以满足,把单核的cpu逼到了物理计算,那此时必然出现了多核、众核

并行计算应该分为两条技术:

硬件:计算机架构

软件:并行程序设计

3.软件视角理解并行性

并行主要分为

指令并行

数据并行

3.1指令并行

  • 指令并行 (Task Parallelism):不同的指令或任务同时执行。就像厨房里,一个人切菜,另一个人炒菜,他们干的是不同的事。这多用于支付系统这类高并发服务,每个请求处理逻辑可能不同。

3.2数据并行

  • 数据并行 (Data Parallelism):相同的指令,作用在不同的数据上。这是学 CUDA 要处理的核心。就像你要把1000根胡萝卜切丁,你雇了很多人,每个人都只做“切丁”这一个动作,但每人分一根胡萝卜。

CUDA 就是为“数据并行”而生的。你的任务,就是找出计算中那些可以用“同一套操作”处理“大批量数据”的部分。

4.数据划分的两种核心策略

如何把一堆数据,分发给不同的线程去处理

4.1块划分 (Block Partitioning)
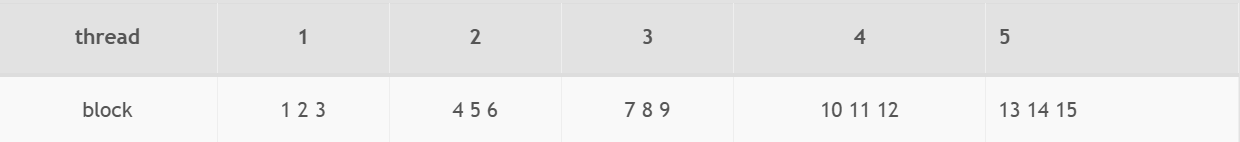
做法:把数据连续地切成大块,每个线程领走一块。

  • 线程1:处理块 1, 2, 3

  • 线程2:处理块 4, 5, 6

  • 线程3:处理块 7, 8, 9

  • ...

  • 优点:像切豆腐,简单直观。每个线程处理的数据在内存里是连续的,访问起来很高效。

  • 缺点:如果每个块的计算量不一样(比如有的块数据复杂,有的简单),就容易“忙的忙死,闲的闲死”,即负载不均衡。

4.2周期划分 (Cyclic Partitioning)
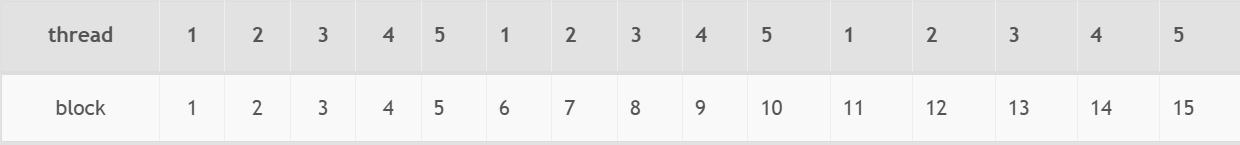
做法:把数据交错地分给各个线程,像发扑克牌一样。

  • 线程1:处理块 1, 6, 11
  • 线程2:处理块 2, 7, 12
  • 线程3:处理块 3, 8, 13
  • ...
  • 你不需要专门找出“1,6,11”是哪个。在周期划分里,这个大块可能是线程1处理,也可能是线程2处理。但因为所有线程分到的大小块比例在统计上是均匀的,所以大家手里的活总量会差不多。

  • 那个倒霉的、分到“1,6,11”这个超大计算块的线程,它也必然同时分到了其他很多“小”块。而那个没分到“1,6,11”的线程,它的篮子里可能装满了各种中等大小和更小的块。

  • 最终的结果就是,大家手里篮子里的总计算量被平衡了,完成时间自然就差不多。它用这种“大杂烩”的方式,完美解决了无法预知单点计算量的问题。

  • 优点:用“概率均匀”对抗“不确定性”,负载非常均衡。不管哪个块计算量大,都被平均分到了各个线程上,大家完成时间差不多。

  • 缺点:每个线程访问的数据在内存里是跳跃的、不连续的,可能导致访存效率降低。

没有完美的策略,你的选择直接影响程序最终的运行速度。

要根据你的数据特征和GPU的内存架构来权衡:

  • 从数据特征看:所有数据块的计算量都差不多吗?还是有的块计算量特别大?

  • 从硬件架构看:GPU 喜欢连续访问内存(块划分更优),但也需要保证所有计算单元都一直在忙(周期划分负载更均衡)。

所以,设计并行程序时,你始终在进行这种权衡,并在理论指导下通过实验去找到那个“最佳划分”。

5.硬件视角理解并行性

软件即兵法谱,我们应该采用哪种策略去划分数据

硬件即兵器谱,我们的计算机架构为了提高并行性是有什么策略
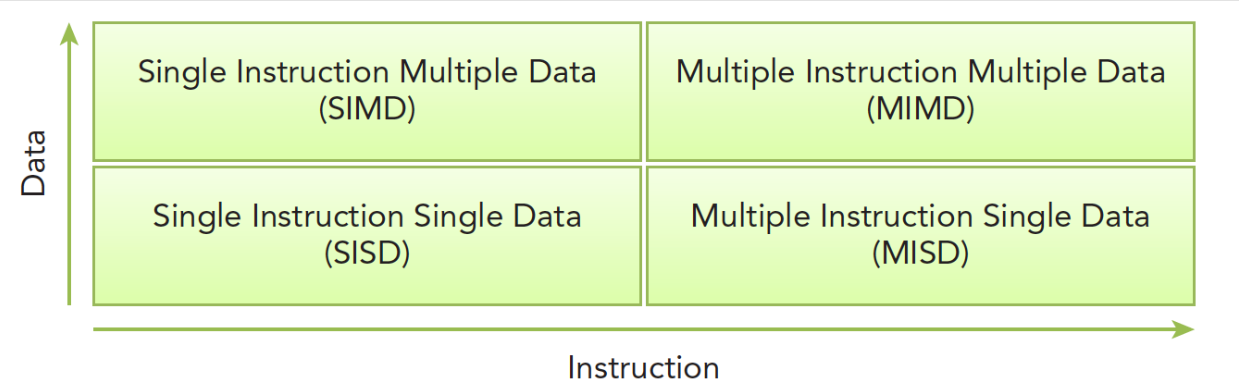
理解所有并行硬件(包括你的 CPU 和 GPU)的基础理论模型。

根据计算机如何处理指令和数据两条流,将其分成四类。

分类全称核心特点与比喻现实对应
SISD单指令单数据传统串行。一个厨子按一张菜谱,一次处理一个食材。老式单核 CPU(如 386)
SIMD单指令多数据数据并行。一个教练喊一声“卧倒!”,一排士兵同时卧倒。GPU 的核心就是 SIMD 架构。GPU、现代 CPU 的向量指令(如 AVX)
MISD多指令单数据罕见。多位专家从不同角度分析同一份数据,确保结果绝对可靠。航天飞机飞控系统等极特殊的容错场景
MIMD多指令多数据任务并行。一个大厨房里,有的厨子在炒菜,有的在切菜,各干各的。现代多核 CPU 就是典型的 MIMD。现代多核 CPU、分布式计算集群
CPU 是一个 MIMD 架构(多核),而它内部的每个核心又都具备 SIMD 指令集(可以同时处理多个数据)

6.优化方向

  • 延迟:是指操作从开始到结束所需要的时间,一般用微秒计算,延迟越低越好。

  • 带宽:是单位时间内处理的数据量,一般用MB/s或者GB/s表示。

  • 吞吐量:是单位时间内成功处理的运算数量,一般用gflops来表示(十亿次浮点计算)

降低延迟、提高带宽、提高吞吐量是所有并行架构的共同目标。

7.内存架构划分:看硬件“怎么组织团队”
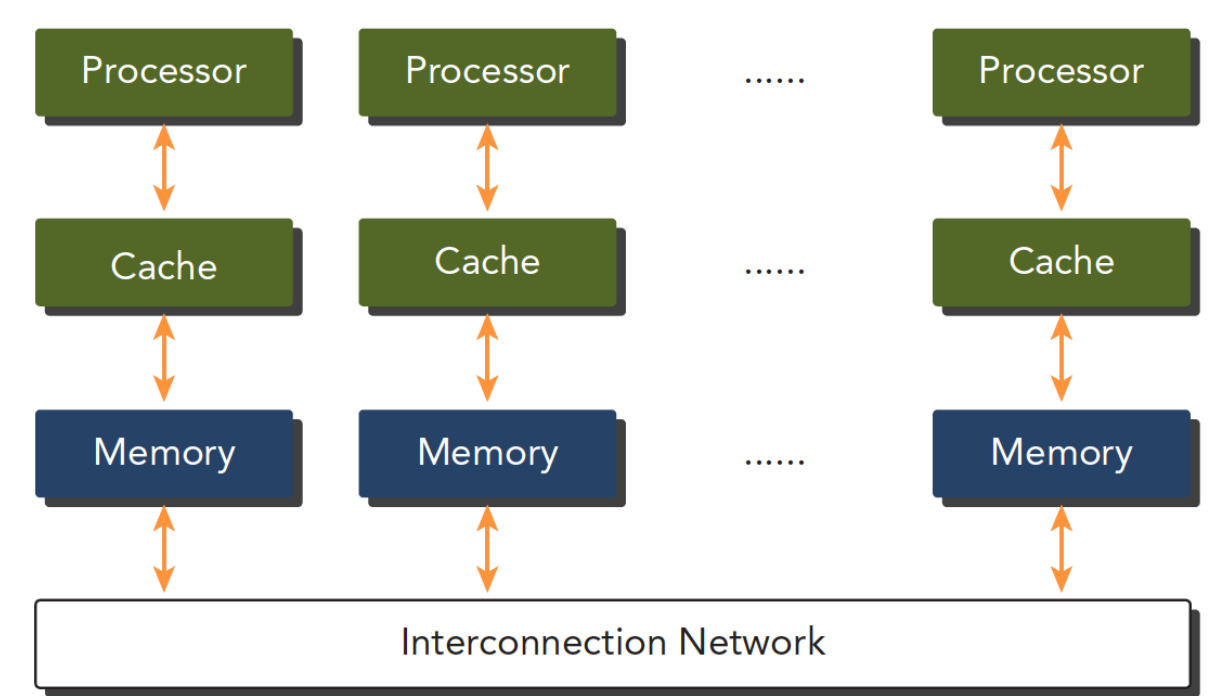
  • 分布式内存系统:

    • 结构:像很多独立的电脑(节点)通过网络连起来,每个节点有自己私有的内存。

    • 特点:规模可以很大(集群),但节点间通信慢,需要程序员显式处理消息传递(如用 MPI)。

    • 地址空间:物理上是分散的。

  • 共享内存系统:

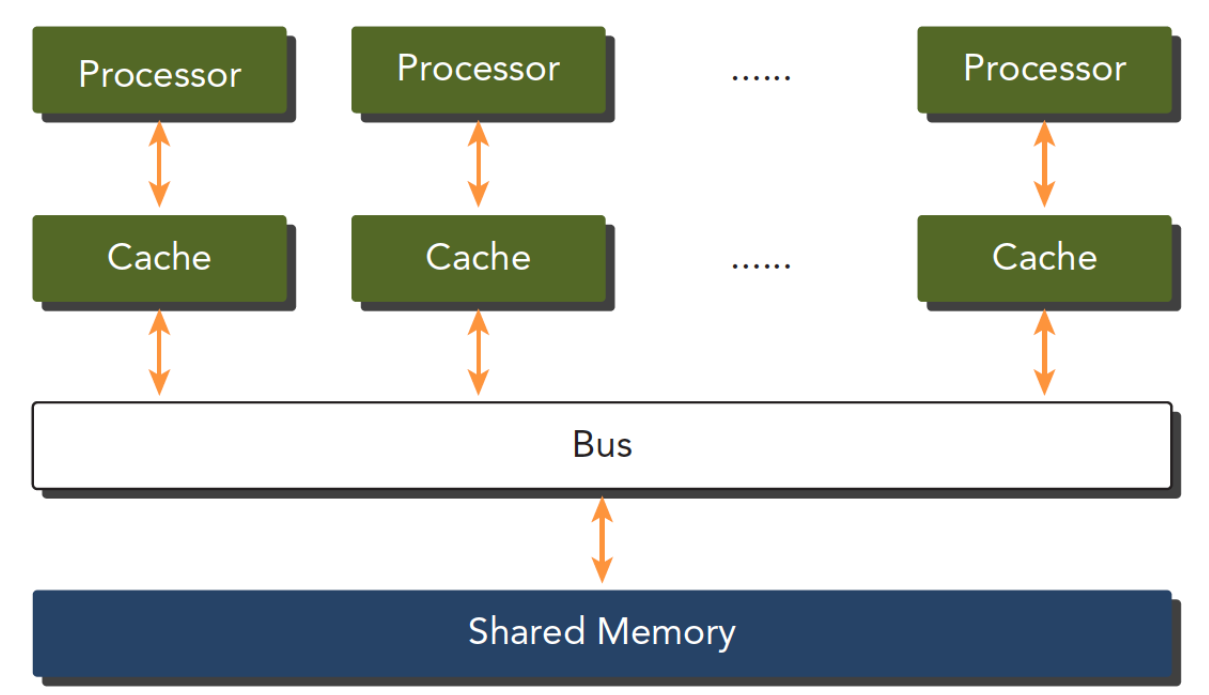
    • 结构:一块主板上的多个处理器(或核心),共享同一块物理内存(我们常说的插在主板上的一条条内存)。

    • 特点:核心间通信非常快,通过共享内存交换数据。

    • GPU 就是典型的共享内存众核系统:一个 GPU 芯片内部有成百上千个核,它们共享显存。这与多核 CPU 本质上是同一类架构,但核心设计哲学不同。

总结

  • 软件:并行计算部分:是软件视角,教你如何把一个计算问题,从逻辑上拆解成可以并行的部分。

  • 硬件:计算机架构部分:是硬件视角,告诉你承载并行计算的物理平台有哪些类别,它们的基本构造和衡量标准是什么。

FPGA本质解析:可编程硬件与并行计算原理 FPGA(现场可编程门阵列)是一种基于查找表(LUT)和触发器的全硬件可重构数字电路平台,其核心原理是将逻辑功能映射为静态配置数据,实现硅基硬件的虚拟化。区别于冯·诺依曼架构的微控制器,FPGA天然支持大规模并行计算与确定性低延迟,技术价值体现在硬件敏捷性、吞吐量密度与IO灵活性三方面。典型应用场景覆盖5G基带处理、高速视频接口、AI边缘推理、IC原型验证及工业硬实时控制。本文围绕FPGA本质、架构差异与六大落地领域,深入剖析其作为‘软硬协同枢纽’在现代电子系统中的不可替代性,尤其聚焦LUT函数发生器机制与 阅读详情

相关推荐

GPU并行计算本质:从硬件结构到CUDA编程范式

并行计算是现代高性能计算的核心范式,其本质并非简单比较GPU与CPU的算力数值,而是理解不同硬件架构如何适配任务特征——CPU擅长低延迟、强分支预测的串行控制流,GPU则依托海量ALU单元与SIMT执行模型实现数据级并行。CUDA并非加速魔法,而是面向NVIDIA GPU物理特性的调度协议,它将线程束(Warp)、共享内存银行、PTX指令层级等硬件约束显式暴露给开发者。掌握这些原理,才能突破ComfyUI卡顿、PyTorch显存碎片、HIP迁移失准等真实工程瓶颈,真正实现从‘能跑’到‘高效’的跨越。

areen7003的博客 410

并行计算:MPI总结

一、MPI简介 1.什么是MPI Massage Passing Interface:是消息传递函数库的标准规范,由MPI论坛开发。 一种新的库描述,不是一种语言。共有上百个函数调用接口,提供与C和Fortran语言的绑定 MPI是一种标准或规范的代表,而不是特指某一个对它的具体实现 MPI是一种消息传递编程模型,并成为这种编程模型的代表和事实上的标准 2.MPI的特点 MPI有以下的特点: 消息传递式并行程序设计 指用户必须通过显式地发送和接收消息来实现处理机间的数据交换。 在这种并行编程中,每个

JacksonKim的博客 5万+

matlab中如何调用gpu进行并行计算_一文读懂多GPU并行计算及Tensorflow实现

平时在使用小规模数据集训练模型的时候,一般一个GPU训练一段时间就够了,但在实际项目中,当数据量不断增大,同时需要在规定的时间内训练出模型,让多GPU并行计算提高训练速度就显得尤为重要,今天我们看看并行计算的原理以及具体实现。1MPI和并行计算并行计算或分布式计算,本质上是把一个计算任务分布到多个节点上计算,然后把每个节点上的计算结果汇总起来,其中的关键是如何分发任务、同步各节点信息、...

weixin_39881802的博客 3663

论述:FPGA中并行计算的常规方法

论述:FPGA中并行计算的常规方法 用过FPGA的人应该都知道,在FPGA中,逻辑是并行地运行的,各个状态机同时都在工作,状态机之间可能会有信号交互,也可能毫无关系、各管各的工作。 这就给了我们一个灵感:如果我们有一个复杂的计算要做,那么,我们是否可以将计算过程拆成几个子计算过程,并利用FPGA的并行特性,让各个子计算过程同时进行以提高计算速度呢? 基于这个灵感,就让我们看看,FPGA中并行计算的...

永恒的止水的博客 1万+

AI算力网络与通信:并行计算的高效实现方法

2023年,OpenAI训练GPT-4时动用了超过2.5万个GPU,这些GPU分布在不同的数据中心,通过高速网络连接成一个巨大的"算力集群"。为什么需要这么多GPU?因为GPT-4的参数规模超过1万亿,单张GPU的显存(即使是40GB的A100)连模型都装不下,更别说训练了。AI算力网络就是为解决这类问题而生:它将分散的计算资源(GPU、CPU、TPU等)通过网络连接,形成一个"虚拟超级计算机",让大规模AI模型能在上面高效训练和运行。而并行计算。

AI天才研究院 1667

ComfyUI安装包运行前准备:增加虚拟内存

在Windows系统中,虚拟内存是一种重要的系统资源管理机制,它主要通过将硬盘空间用作内存来扩展系统的可用内存容量。以下是虚拟内存的主要作用: 1. 扩展物理内存容量 当物理内存(RAM)不足时,系统会将一部分数据从内存转移到硬盘上的虚拟内存区域(也称为“分页文件”或“交换文件”)。这样可以为正在运行的程序提供额外的“内存空间”,确保系统能够继续运行,而不会因为内存不足而崩溃。 2. 提高系统稳定性 虚拟内存为系统提供了一个缓冲区。如果没有虚拟内存...

聚梦小课堂 1万+

云计算机技术是对并行计算,并行计算与云计算有什么关系?

在概述并行计算和云计算与什么关系之前,我们有必要先阐述一下并行计算、云计算等相关的概念,是大家对本文的内容能够理解更加透彻。1、并行计算并行计算其实早就有了,所有大型编程语言都支持多线程,多线程就是一种简单的并行计算方式,多个线程并行地争抢CPU时间。并行计算(Parallel Cpmputing)是指同时使用多种计算机资源解决计算问题。并行计算的主要目的是快速解决大型且复杂的计算问题。此外还包括...

weixin_33196555的博客 2317

CentOS7无网环境实战:MySQL8.0完整离线安装与避坑指南(附依赖包下载)

本文详细介绍了在CentOS7无网环境下MySQL8.0的完整离线安装流程,包括依赖包获取、系统预处理、MySQL二进制安装、服务配置与优化等关键步骤。特别针对离线安装的特殊需求,提供了从依赖包下载到服务调优的全链路解决方案,帮助用户在企业内网或隔离环境中高效部署MySQL数据库。

bush的博客 175

并行计算

http://ifeve.com/ 科普:并行计算、分布式计算、集群计算和云计算 一、产生的背景 曾经,几乎所有的处理器都是以冯诺依曼计算机架构为基础的。该系统架构简单来说就是处理器从存储器中不断取指,解码,执行。 但如今这种系统架构遇到了瓶颈:内存的读写速度跟不上 CPU 时钟频率。具有此特征的系统被称为内存受限型系统,目前的绝大多数计算机系统都属于此类型。 ...

ation_work的专栏 2303

一个测试工程师走进一家酒吧……

一个测试工程师走进一家酒吧,要了一杯啤酒;一个测试工程师走进一家酒吧,要了一杯咖啡;一个测试工程师走进一家酒吧,要了 0.7 杯啤酒;一个测试工程师走进一家酒吧,要了-1 杯啤酒;一个测试...

字节跳动技术团队官方博客 4885

西门子828D/840DSL数控机床产量数据采集实战:手把手教你绕过授权限制(附Demo源码)

本文详细介绍了西门子828D/840DSL数控机床产量数据采集的实战技术,包括绕过授权限制的替代方案和实现方法。通过分析通信协议、配置参数和数据处理,提供了一套高效且合规的数据采集解决方案,并附有Demo源码,帮助技术人员快速上手。

weixin_28278377的博客 762

Transformer Prefill阶段并行计算:本质、流程与思考

阶段并行性是否需要同步?说明生成Q/K/V完全并行❌ 不需要同步Attention打分(Q×K^T)并行矩阵乘法✅ 需要全部token的Q/KSoftmax归一化局部并行✅ 需等待Attention Scores聚合V向量局部并行✅ 需完成Softmax前馈网络完全并行❌了解Transformer Prefill阶段的并行计算本质,不仅有助于我们理解模型的推理性能,还能帮助我们在未来优化部署、提升吞吐率。

ningyanggege的博客 2636

【声呐技术】基于人工智能的拖曳阵声呐声学数据处理系统 SEA公司AI辅助拖曳阵系统

KraitSense是SEA公司开发的紧凑型被动拖曳阵声呐系统,核心传感器为KraitArray细线拖曳阵列。该系统专为小型舰艇、无人水面艇(USV)和无人潜航器(UUV)设计,通过人工智能与机器学习技术实现水下声学数据的自动化采集、处理与分类。系统与Mind Foundry公司开发的软件平台深度集成,形成端到端的智能反潜战(ASW)解决方案。

u012133341的博客 957

Matlab并行计算parpool使用方法+代码

parfor 是并行循环计算多重循环的嵌套,只能在其中一层循环使用parfor并行计算,因为parfor就是让几个worker同时干活,比如一个循环中,i=1:30,那么一个worker做i=1:5,一个做i=6:10····不同的循环变量之间完全独立,所以当然可以一起干活,在里面在嵌套parfor,相当于把里面的工作还要分给6个人,很容易混乱不清,出现问题,如果再继续嵌套就更没法独立地界限清晰地并行工作了。 在命令行中输入ver查看是否有“并行计算工具包”, 里面有Parallel Computin

仅仅用于个人记录,侵删 3万+

RK3576 调试ov2735 mipi-csi摄像头

摘要:本文记录了基于RK3576平台调试OV2735 MIPI摄像头的全过程。开发环境采用Linux 6.1内核和Buildroot文件系统。调试步骤包括:1)硬件检查(电源、晶振和引脚连接);2)驱动配置(设备树节点、ISP通道设置);3)驱动验证(通过ID检测和I2C工具测试);4)推流测试(使用v4l2和gstreamer工具)。重点解决了复位引脚配置、时钟命名匹配等关键问题,并通过寄存器检查确保初始化正常。最终实现了摄像头数据流的成功输出,为嵌入式视觉应用开发提供了完整参考方案。

qq_45147279的博客 1060

航天设备研制中的形态分类:电性件、正样件及其他关键形态详解

航天设备的研制是一个高度复杂且严谨的工程过程,涉及多个阶段的不同产品形态。这些形态各具特点,在研制流程中承担着不同的验证任务和工程目标。本文将系统介绍航天设备研制中的主要形态,包括**电性件(EM)**、**正样件(FM)**以及**结构热控件(STM)**、**鉴定件(QM)**和**初样件(PFM)**等,详细解析它们的定义、用途和工程意义,帮助读者全面理解航天产品从设计到飞行的全生命周期管理。

ScilogyHunter的博客 1656

GPU与CPU分工原理:从CUDA报错看并行计算本质

并行计算是现代AI与高性能计算的基石,其核心在于任务如何在CPU与GPU间合理拆分。CPU擅长低延迟、强分支、异构任务调度,GPU则专精于高吞吐、规则化、数据并行的数学运算。这种差异源于二者底层架构:CPU依赖复杂流水线与缓存一致性,GPU采用SIMT模型与Warp级同步。CUDA并非简单加速库,而是涵盖驱动、运行时与编译器的完整协同系统,负责内存管理、Kernel调度与版本对齐。典型问题如'no kernel image available'实为CUDA Toolkit、PyTorch二进制包与GPU计算

weixin_30410119的博客 620

Transformer 面试题及详细答案120道(1-10)-- 基础概念

本文总结了Transformer模型的10个常见面试问题及答案,涵盖了其核心结构、创新点、工作机制等关键知识点。主要内容包括:Transformer的自注意力机制和多头注意力机制创新点,相比RNN/CNN的优势,模型在《Attention Is All You Need》论文中的提出背景,以及Encoder-Decoder协同工作流程等。重点解析了位置编码的作用、长距离依赖处理能力、与传统注意力机制的区别等核心问题。每个问题都给出了简明扼要的专业解答,适合作为Transformer相关面试准备的参考资料。

大剑师兰特的GIS世界 849

C++并行计算:OpenMP与MPI全解析

OpenMP:以简单易用的编译制导语句实现多核并行,适合快速将串行程序并行化,是单节点性能优化的首选。MPI:通过消息传递支持跨节点集群并行,扩展性强,是大规模科学计算与分布式应用的标准方案。混合模型:结合两者优势,在现代集群系统中提供最佳性能与扩展性。未来,随着异构计算(CPU+GPU+FPGA)的普及,并行编程模型将进一步发展,如OpenMP对GPU的支持(target指令)、MPI与CUDA的混合编程等。掌握OpenMP与MPI的核心思想,将为适应未来并行计算架构奠定坚实基础。

qq2745567641的博客 2716

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

1并行计算概述

并行计算通过多处理器协同工作提升性能,主要分为并行计算(共享内存,科学计算)和分布式计算(跨系统,商业应用)。其优势包括缩短计算时间、处理大规模问题和充分利用现代多核硬件。在数据库领域应用于并行查询、HTAP和GPU加速。体系结构分类(SISD/SIMD/MISD/MIMD)和存储系统(共享/分布式内存)决定了并行方式。编程模型包括共享内存(如OpenMP)和消息传递(如MPI),前者通过线程共享数据,后者通过进程间通信。并行计算克服了单核性能限制,是高性能计算的关键技术。

疯帽子的博客,满脑子都是些“为什么乌鸦像写字台”的问题 1543

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

并行计算(MPI+OpenMP)

并行计算(MPI+OpenMP)

2301_76768181的博客 2950

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

何去何从的并行计算

就在大伙儿都认为并行计算必然成为未来的大趋势时,2014年年底,在Avoiding ping pong论坛上,伟大的Linus Torvalds提出了一个截然不同的观点,他说:“忘掉那该死的并行吧!虽然,现在Intel已经研制出了4GHz芯片,但可以看到,在近10年的发展中,CPU主频的提升已经明显遇到了一些暂时不可逾越的瓶颈。换句话说,软件工程师正在为硬件工程师无法完成的工作负责,因此,也就有了唐纳德的“他们将摩尔定律失效的责任推给了软件开发者”的说法。显然,就目前的硅电路而言,很有可能已经走到了头。

博文视点(北京)官方博客 1474

聊聊被称为并行计算革命的基石的CUDA

摘要: CUDA是英伟达推出的通用并行计算架构,通过扩展C语言语法和分层内存模型,将GPU的并行能力转化为开发者友好的编程工具。自2007年发布以来,CUDA历经Tesla到Hopper架构迭代,性能提升显著,并形成包含编译器、函数库和调试工具的完整生态。其核心优势在于高效支持AI训练、科学计算等场景,成为深度学习框架的底层加速标准。尽管面临生态垄断争议和竞品挑战,CUDA仍持续优化大模型训练、能效比及跨架构兼容性,巩固其作为并行计算基础设施的地位,推动产业创新。

分享知识,拥抱变化 1356

Gurobi 并行计算的一些问题

最近尝试用 gurobi 进行并行计算,即同时用多个 cpu 核计算 gurobi 的 model,但是发现了不少问题。目前看到的一些 gurobi 或 cplex 正确运行并行计算的例子,基本都是在目标函数中重新新建模型,或者将原模型的一些参数文件传递到目标函数中,仍然新建模型。真要实现规划模型的并行计算,估计要深入修改求解器模型的源代码。官方没有意愿将模型对象支持 pickle,估计是因为可能会损失模型的其他功能吧。对于求解器的并行计算,目前来看,没有看出相比串行计算有太大优势。

天天向上的专栏 1039

云计算中的并行计算技术分析

摘要 本文阐述了并行计算和云计算的关系,简要回顾并行计算的历史,分析了并行计算的重要技术OpenMP、MPI和Erlang,研究了这些技术在中国电信的应用方法,并介绍了中国电信实施云计算、并行计算的指导思想、原则和策略。 一、引言 计算是一个含义丰富的概念,包括了服务、市场、技术等诸多方面。通常提到的IaaS、PaaS和SaaS,严格地说是基于服务的术语,并不是对技术的描述。从技术上看,云计

咫尺之间 7028

Qt 并行计算框架与应用

本文介绍了Qt框架中的Qt Concurrent模块,该模块为开发者提供了高效便捷的并行计算支持。文章首先辨析了并行与并发的核心区别,指出Qt并行框架专注于数据并行和任务并行。随后详细解析了Qt Concurrent的三类核心API:任务执行API(run())、数据并行API(map()、mapped()、mappedReduced())及其应用场景,包括图像批量处理、数据转换与统计等。通过对比传统多线程开发的复杂性,文章重点展示了Qt并行框架的四大优势:零线程管理成本、多核自适应调度、简洁API设计和与

编程与实战的博客 1325
上一篇: 多线程redis下如何解决aof重写和rdb持久化的数据一致性问题
下一篇: 探秘异构计算:CPU与GPU的完美协作
Fcw0551
博客等级 码龄2年 330粉丝 115原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值