AI能不能自动给配方?当DOE束手无策,当正向ML陷入瓶颈:你的下一阶段研发必须引入贝叶斯优化

量子AI工程实践:NISQ时代混合计算落地指南 量子AI并非遥不可及的未来概念,而是基于量子-经典混合架构的现实工程技术。其核心原理在于利用参数化量子电路(PQC)在含噪声中等规模量子(NISQ)设备上执行特定子任务,再由经典优化器协同完成端到端求解。该技术路径规避了容错量子计算的硬件瓶颈,已在信用评分、分子构象搜索、物流调度等场景实现可度量的性能增益。关键技术价值体现在问题复杂度降维(如NP-hard问题从指数级降至多项式级)与噪声鲁棒性设计(如贝叶斯读出误差缓解、动态测量基切换)。本文聚焦真实硬件约束下的工程落地,涵盖VQE框架构建、角度编码实操、电 阅读详情

面向对象:材料化工 · 精细化工 · 实验设计与数据团队

"如果我告诉 AI 目标性能,它能不能直接给我一个配方?"这是一个典型的逆向问题。但在多数研发现场,更常见、也更容易起步的是正向问题:给定配方、原料与工艺,能不能预测性能?

核心判断 真正可落地的"AI 给配方"不是让模型从目标一步跳到答案,而是用正向模型评估候选,用EDBO等逆向优化方法选择下一轮最值得做的实验,再用实验结果更新模型。

一、先分清两条逻辑:正向预测与逆向优化

材料配方研发可以抽象为"组成—工艺—结构—性能"的映射。AI 参与其中,至少有两条方向不同、但相互依赖的路径。

正向预测:配方与工艺 → 性能。把同一产品族的历史实验数据整理为可训练数据集,模型学习组分、原料批次、工艺参数、测试条件与性能结果之间的关系。它可以在实验前预测关键指标、排序候选方案、识别主控变量,并给出不确定度。

  • 逆向优化:目标与约束 → 候选方案。研发人员定义变量范围、性能目标、成本或法规约束,优化算法在搜索空间内提出下一批候选。多目标问题通常不会得到唯一"最优配方",而是得到一组可供权衡的 Pareto 方案。
  • 为什么逆向不能直接"反推"

这不是模型不够聪明,而是逆向问题本身的性质:满足同一组性能的配方往往有很多,而其中大部分在现实中不可行——原料买不到、工艺跑不了、成本超预算、法规不允许。缺少这些边界信息时,任何直接反推的结果都只能是假设。所以现实中我们不"解"逆向问题,而是"搜"逆向问题:让正向模型充当评价函数,让优化算法在受约束的空间里搜索。

这个转换带来一个关键好处:搜索并不要求模型"知道正确答案",只要求它"能比较优劣"。后者的数据门槛低得多——这也是为什么在数据量并不大的配方体系里,这条路依然走得通。

研发逻辑

输入 → 输出

适合解决的问题

正向预测

配方、工艺 → 性能

实验前预测、候选排序、关键变量识别、给出不确定度

逆向优化

目标、约束 → 候选方案

在有限实验预算下推荐下一批实验,输出可权衡的 Pareto 方案

闭环迭代

新结果 → 模型更新 → 再推荐

持续缩小搜索空间、处理多目标权衡、逐轮提升判断可靠性

表 1|两条逻辑与闭环迭代

两者不能简单替代:正向模型只回答"这个候选可能表现怎样",不直接告诉团队应该去哪里搜索;逆向优化若没有可靠数据、明确边界和可验证的正向模型,也容易变成缺乏依据的推荐。模型的结论原则上只在训练数据覆盖的产品族与变量范围内成立;换原料体系、设备或测试方法,都需要重新验证。

二、正反向结合,才是"AI 给配方"的真实路径

一条可执行的闭环通常只有四步:

  1. 定义搜索空间

    明确可调整的组分与工艺变量(连续值如温度/pH、离散值如非连续的浓度、分类值如溶剂/配体)、变量范围、性能目标、约束条件和测试方法;

  2. 准备初始数据并初始化代理模型

    若已有历史数据,可直接导入以拟合初始代理模型(通常为高斯过程 Gaussian Process, GP);若没有历史数据,则由系统按空间填充设计(如拉丁超立方采样)生成首批实验,完成后自动建模;

  3. 进行逆向推荐

    EDBO 通过采集函数在"探索未知区域"和"利用当前优选区域"之间权衡,推荐下一批实验;

  4. 回流实验结果

    完成、审核并回传新结果,更新模型后进入下一轮。

第三步在做什么:贝叶斯优化的两个半边

贝叶斯优化之所以适合配方研发,是因为它同时用到了正反两个方向。它先用已有的少量实验拟合一个带不确定度的代理模型(通常为高斯过程 GP)——这是正向的一半,既给出预测值,也给出"这里我有多没底";再用采集函数在"预期性能高"和"信息量大"之间权衡——单目标场景常用期望改进(EI),多目标 Pareto 优化则常用预期超体积改进(EHVI, Expected Hypervolume Improvement),直接给出下一批最值得做的实验——这是逆向的一半。它不追求一次算准,而是让每一次实验尽可能减少模型的不确定性。

做法

回答什么问题

适合的数据规模

典型输出

传统 DOE

在预设的因子与水平里,哪些因素显著、如何配置

按设计表一次投若干组

效应显著性、响应面、优化区域

正向 ML 预测

任意给定配方与工艺,性能大约是多少

同一产品族数十至数百条以上

性能预测、不确定度、变量重要性

贝叶斯优化 / EDBO

下一批实验该做哪几个,才能最快逼近目标

可在较小样本量下起步并逐轮积累

下一轮实验组合、收敛过程、Pareto 方案集

表 2|DOE、正向预测与贝叶斯优化,回答的不是同一个问题

三者不是替代关系:DOE 帮助把变量与范围定清楚,正向模型把已有数据变成可复用的判断力,贝叶斯优化决定下一步往哪走。实践中常常串联使用。

  • 方法学佐证 在钯催化直接芳基化反应的公开基准研究中,贝叶斯优化在优化效率(所需实验次数)与结果稳定性两方面均优于人类专家的决策[2]。
  • 公开案例 在一项发表于 Nature Communications 的电池电解液研究中,研究团队将自动化配液与测试平台 Clio 和机器学习优化结合,在约 1000 种候选组合中完成 42 次实验、用 2 个工作日找到 6 种表现优异的快充电解液。这个案例说明的不是 AI 可以普遍"42 次给出配方",而是模型可以根据上一轮结果选择更有信息量的下一个实验点,从而减少低信息量尝试[1]。
  • 一条专业提醒 如果测试方法的重复性差于模型要分辨的性能差异,闭环会追随测量噪声,而不是收敛到更优方案。进入优化前,应先固定样品制备、仪器方法、环境条件和数据审核规则。

三、创腾科技如何把这条闭环落到产品中

闭环不是一个孤立的算法模块。它需要实验现场、数据底座和建模优化平台协同工作:

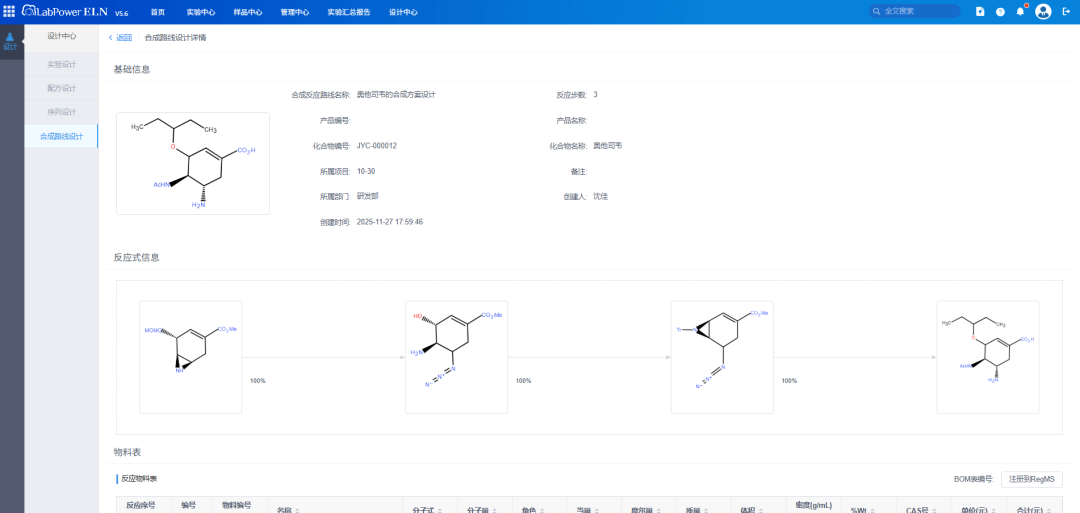
  • iLabPower:记录实验"实际发生了什么"。

    通过 ELN、DOE 等能力管理变量与水平、实验计划、样品、测试结果和审核状态;实验设计可与实验记录双向关联,保留完整追溯链。[4]
图片

图:iLabPower ELN电子实验记录本

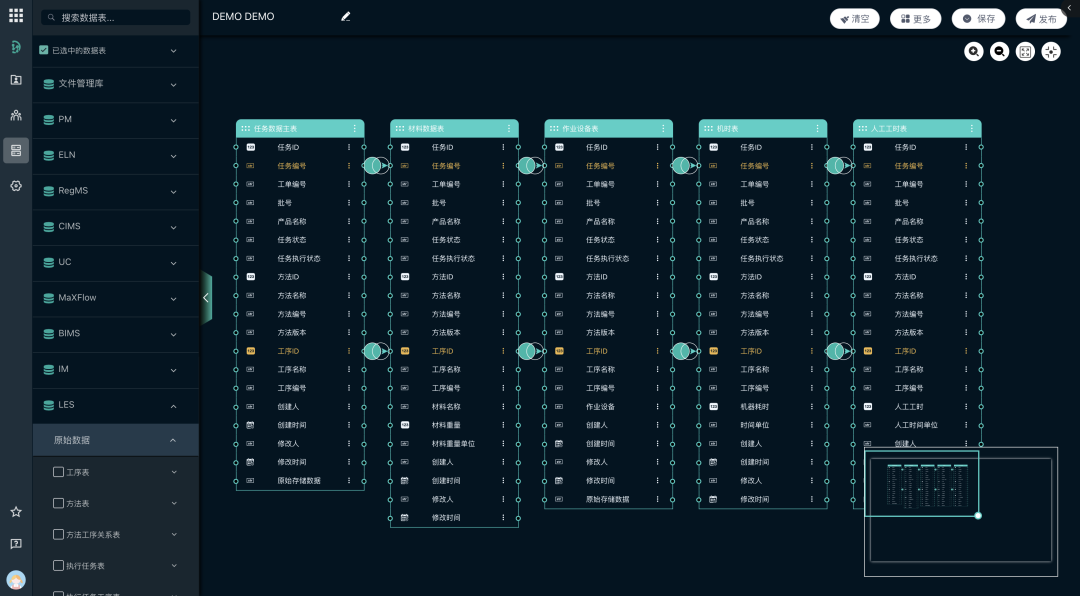
  • SDH:把分散记录变成可训练数据。

    对来自 ELN、LIMS、仪器及历史文件的数据进行抽取、清洗、对齐和融合,统一物料、指标、单位与实验上下文,形成面向具体产品族的数据集。[5]
图片

图:SDH科学数据基因组平台

  • MaXFlow:完成正向建模与逆向优化。

    基于结构化数据训练性能预测模型;EDBO(Experimental Design based on Bayesian Optimization)可利用已有数据构建模型,在多目标 Pareto 优化中推荐下一轮实验,并随新结果迭代更新。[6]
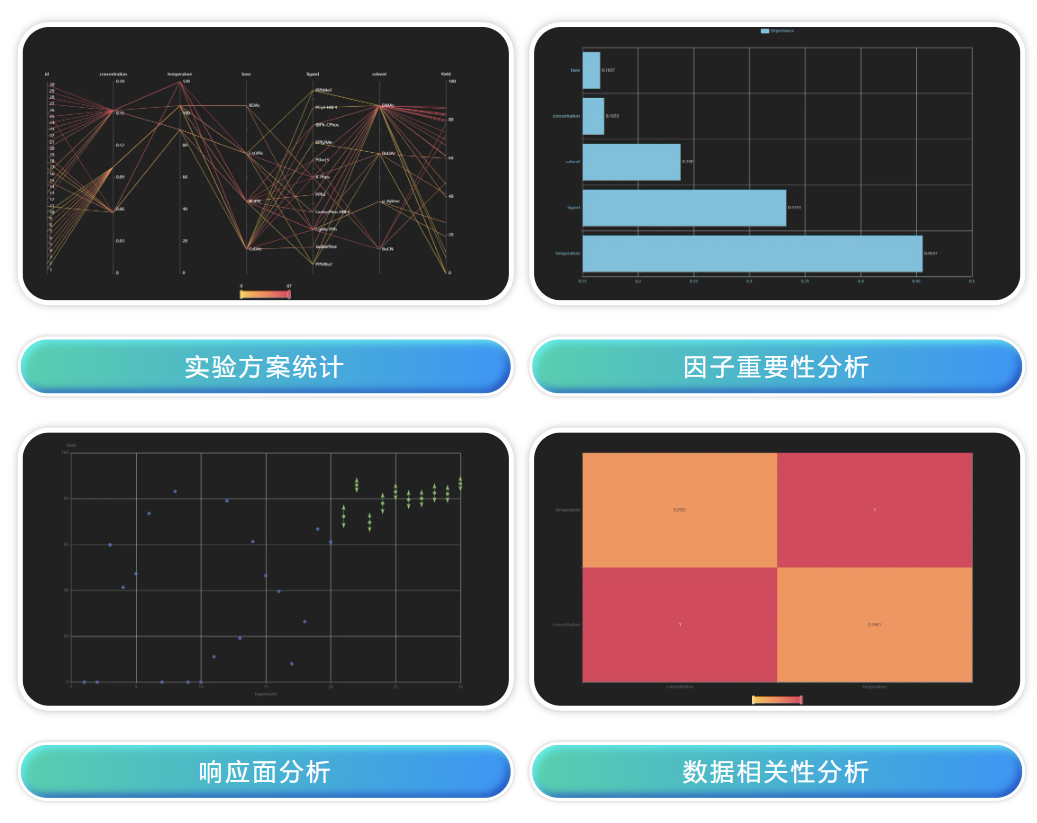
图:MaXFlow平台EDBO数据分析工具

一条链路 iLabPower 采集与执行 → SDH 治理与融合 → MaXFlow 建模预测与 EDBO 推荐 → 实验结果回流。

这条链路把"模型建议"放回日常研发流程:研发人员仍负责定义边界、确认实验和判断是否采纳;系统负责保留依据、减少重复录入,并让每一轮结果成为下一轮决策的输入。

四、企业应该从哪一步开始

不必等到拥有所谓"大数据",但要从一个边界清楚的产品族开始。

  • 数据分散、记录条件不完整:

    先用 iLabPower 规范实验记录,再由 SDH 统一数据口径。此时不要急于要求模型给配方。

  • 已有一批同口径、可比的历史数据:

    先在 MaXFlow 做正向性能预测试点。验收重点不是训练集拟合度,而是对留出批次的误差、不确定度和适用域。

  • 变量与约束可参数化、实验周期可接受、结果能稳定回流:

    再引入 EDBO 做多轮推荐,以相同实验预算下的收敛效率和获得的有效方案数评价价值。

"小数据"可以做窄范围建模,但"小数据"不等于可以忽略数据质量。失败实验、原料批次、设备条件和测试重复性,往往比单纯增加样本数量更重要。值得强调的是,未达标与失败的实验同样要入库[3]:企业库里若只留成功配方,模型就只见过"成功长什么样",学不到边界在哪。早在 2016 年就有研究表明,把实验室笔记本里的失败反应系统整理后用于训练,模型判断成败的准确率可以超过人的经验直觉[3]。

结语:AI 减少的不是实验,而是低信息量的实验

回到最初的问题:AI 能不能自动给配方?

更准确的回答是:AI 可以用正向模型预测候选表现,用 EDBO 等逆向方法推荐下一轮实验,并在结果回流后持续优化;但它不能跳过实验验证,也不能脱离数据覆盖范围直接给出可生产的最终配方。

可靠的交付物不应只有一个配方数字,而应包括候选方案、推荐依据、不确定度、适用边界与验证计划。AI 的价值,是让有限的实验预算优先花在更有信息量的候选上。

欢迎交流:想判断您的配方研发更适合先做正向性能预测,还是进入EDBO多轮优化?欢迎联系创腾科技,我们可以结合一个具体产品、现有数据量和实验周期,协助梳理 iLabPower、SDH 与MaXFlow的试点路径。

参考资料

[1] Dave 等,Autonomous optimization of non-aqueous Li-ion battery electrolytes via robotic experimentation and machine learning coupling,Nature Communications,2022。

[2] Shields 等,Bayesian reaction optimization as a tool for chemical synthesis,Nature,2021(贝叶斯实验优化方法与 EDBO 工具的原始文献)。

[3] Raccuglia 等,Machine-learning-assisted materials discovery using failed experiments,Nature,2016。

[4] 创腾科技,iLabPower DOE 实验设计。

[5] 创腾科技,SDH 科研数据中台。

[6] 创腾科技,MaXFlow 3.10 EDBO 功能说明。

来源:创腾科技

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品) 阅读详情

相关推荐

船载 OpenHarmony AIS 航海工作台:告警与防碰撞预警系统

船载OpenHarmony AIS航海工作台的告警与防碰撞系统,集成十余类告警(超速、偏航、会遇、SOS等),通过网格空间索引实现高效邻近判定,保障实时性。告警管理器统一调度规则、去重、通知与日志,支持悬浮球、语音、跑马灯、弹窗多渠道触达,确保航行安全。SOS紧急通道独立运行,避免干扰。系统设计强调性能优化与多场景适配,为航海安全提供核心支撑。

专注于计算机研发知识和资讯分享 199

贝叶斯优化在材料科学中的革命性应用:如何用3个智能策略减少90%实验成本

贝叶斯优化是一种基于高斯过程的全局优化算法,特别适合处理高成本、耗时长且参数空间复杂的实验优化问题。在材料科学领域,每次实验都可能耗费数天甚至数周时间,而传统试错法不仅效率低下,还容易错过最优配方。通过贝叶斯优化技术,研究人员可以在最少的实验次数内找到最优的材料配方组合,将实验成本降低90%以上,同时大幅缩短新材料开发周期。 ## 🤔 为什么材料配方优化如此困难? 在材料科学研究中,配方优化

gitblog_00027的博客 964

手把手教你用Logisim搭建5级流水MIPS CPU(附华中科技计组实验避坑指南)

本文详细介绍了如何使用Logisim从零构建5级流水MIPS CPU,特别针对华中科技大学计算机组成原理实验提供实用指南。内容涵盖单周期CPU过渡、流水线寄存器设计、数据冒险处理等核心环节,并附有实验避坑建议和性能优化技巧,帮助学生高效完成这一挑战性项目。

weixin_42532938的博客 373

如何高效应用智能优化算法:5个实战策略加速材料配方开发

你是否正在为材料配方优化而苦恼?每次实验都需要大量时间和资源,却难以找到最优组合?贝叶斯优化(Bayesian Optimization)正是解决这类高成本优化问题的智能算法。这个Python实现的全局优化工具通过高斯过程(Gaussian Process)构建目标函数的后验分布,在探索未知区域和利用已知信息之间找到最佳平衡,帮助你在最少的实验次数内找到最优的材料配方参数。 ## 🎯 材料研发

gitblog_01173的博客 407

arcgis根据矢量范围统计栅格数据众数、最大值、均值、中位数、最小值、少数等

像元统计数据 根据多个栅格数据计算每个像元的统计数据。 可用的统计数据有:众数、最大值、均值、中位数、最小值、少数、范围、标准差、总和及变异度。 https://desktop.arcgis.com/zh-cn/arcmap/10.3/tools/spatial-analyst-toolbox/an-overview-of-the-local-tools.htm ...

GIS哼哈哈的博客 6万+

8.DJI-PSDK:一站式项目功能开发总结(空中气象站项目/激光甲烷检测项目)

本文将以一篇文章的幅度快速完成: 项目一:空中气象站项目; 项目二:激光甲烷项目; 项目所使用的PSDK来源于第0章节末尾的百度网盘;解压:Payload-SDK-3.8.zip代码所在目录:双击打开: 修改打印串口和相关波特率,我们修改如下: 进行相关编译选项配置如下: :

哒宰的博客 294

AI设计自动吸甲醛的墙面涂料,传统吸附为主,颠覆催化分解分子,输出能把甲醛变二氧化碳的涂料。

1. 数据层:整合Materials Project(催化材料结构)、ICSD(晶体结构)、NIST(反应动力学)、实验数据集(甲醛转化率、CO₂选择性、量子效率)dos_features['cb_dos_character'] = 0.3 # 导带态特征(s/p/d轨道贡献)return max(5, min(grain_size, 100)) # 限制在5-100nm范围。band_gap = max(0.5, min(band_gap, 5.0)) # 限制在合理范围。

2301_82202864的博客 184

30天入门 SAP BTP 开发系列之四:SAP BTP 控制台里 Global Account 的常规操作介绍

笔者前一篇文章,介绍了 SAP BTP 中 Global Account 的概念。本文咱们一起来看看 SAP BTP 控制台里,给 Global Account 开放了哪些操作功能。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 872

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 306

vue3:html2canvas+jspdf将页面以A4导出为PDF文件,解决内容截断+在分页处截断问题详细排查和解决教程(jsPDF + html2canvas A4分页截断、内容分页时存在截断)

html2canvas + jsPDF 解决内容截断问题,vue3 jspdf-html2canvas生成多页pdf防截断处理(包含代码),vue3解决html2canvas + jsPDF导出pdf分页内容截断问题,jsPDF + html2canvas A4分页截断 完美解决方案(含代码 + 案例),html页面导出pdf截断问题,html2canvas 与 jspdf 相结合生成 pdf 内容被截断的终极解决方案,提供html2canvas+jsPDF将HTML页面以A4纸方式导出为PDF后,内容分页

✅ 精选推荐文章 2245

get_ccopt系列命令介绍

get_ccopt_property:用来获取cts阶段,clock tree上所有的参数信息,可以通过get_ccopt_property –help *获取所有参数。get_ccopt_skew_group_delay:用来获取skew group的相关信息,可以通过筛选出特定条件下skew_group的参数,如skew_group下latency最长是多少;get_ccopt_clock_tree_source_groups:获取clock tree的source group名字;

芯冰乐 282

ChatGPT、Perplexity、Gemini 与 AI Overviews 引用对比:谁的引用更可信

AI 引擎的引用机制差异很大:ChatGPT 以行内引用加 Sources 列表呈现来源,Perplexity 几乎逐句可溯源,Gemini 在回答中内嵌相关来源链接,AI Overviews 则把多源聚合答案与来源列表一起放在搜索结果顶部。本文从引用透明度、来源偏好、可干预性 3 个维度对比这 4 个引擎,并给出 GEO 的 3 点启示,帮企业在多引擎环境下提升被引用的概率。

淡然一笑 的专栏 153

Mastercam软件二次开发:使用C#进行Mastercam二次开发

C#(发音为“C Sharp”)是一种现代、面向对象的编程语言,由微软开发,首次发布于2000年。它结合了C和C++的强大功能,同时引入了Java的垃圾回收机制,使得C#在开发效率和运行性能之间找到了一个良好的平衡点。C#的设计目标是提高开发者的生产力,它支持多种编程范式,包括面向对象、泛型、委托和事件等,这使得它成为开发Windows应用程序、Web应用程序、游戏(尤其是使用Unity引擎)和企业级应用的理想选择。

kkchenjj的博客 2218

AI Agent之核心框架

A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试,反思作为 记忆,影响后续尝试的策略。工作流程:Action → Evaluation → Reflection → Retry。A: 普通 CoT 只在。

剑雨巍巍的博客 239

21、汽车喷漆目标区域识别:机器学习与深度学习的应用

本文探讨了机器学习与深度学习在汽车喷漆目标区域识别中的应用,重点利用卷积神经网络(CNN)提高喷漆效率并减少油漆浪费。通过构建和预处理包含多种汽车类型的数据集,采用ResNet-18、ResNet-50和MobileNet-v2等模型进行训练与评估,结果表明ResNet-50在准确率和鲁棒性方面表现最佳。研究还分析了数据裁剪、标签处理、网络架构差异以及光照和遮挡对识别效果的影响,并提出了系统实现流程。最后,文章展望了多传感器融合、模型优化和场景适应性等未来研究方向,为智能化喷漆工艺提供了技术参考。

5b6n7m8的博客 102

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

【从零理解 Spring AI · 12】MCP 的两种角色:做客户端还是做服务端

上一篇讲了 MCP 的概念:标准协议、三大角色、M+N 替代 M×N。

nice_lcj520的博客 541

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

AI 应用开发工程师技术实践:大模型接入、通用组件封装与性能优化

本文提出AI应用从PoC到生产的核心挑战:模型调用的持续可用、可控与可优化。通过构建统一LLM网关实现多供应商路由与故障转移,封装对话、工具调用与RAG组件以解耦业务逻辑,结合前缀缓存、批处理与流式背压治理等性能优化手段,形成“接通→接稳→接快”的工程路径,最终以工程化能力决定AI应用的生产可用性。

2301_79189962的博客 596

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

终端 AI 审计与 “龙虾” 类智能体风险治理:从可见性到闭环溯源

生成式 AI 办公普及之后,数据泄露风险逐步下沉到终端。员工将合同、源代码、客户资料粘贴至公有大模型,以及龙虾(OpenClaw)这类本地开源 AI 智能体的滥用,成为企业安全新挑战。传统网络边界防护存在审计盲区,本文从风险链路拆解、核心能力模型、分级治理策略、落地踩坑点以及技术局限性多角度,分享终端侧 AI 安全治理的实践思路。

2401_86491085的博客 671

抽象主义人工智能和生命体AI的内在联系

彭军辉提出“抽象主义人工智能”作为第四大AI范式,批判符号主义、连接主义、行为主义剥离生命本体的误区,确立“智能是现象,生命是本体”的核心公理。主张原生智能必须依附具备存续诉求的生命本体,提出“生命体AI理论”,构建七层演化阶梯与自闭环工程框架,强调智能不可跳过底层存续机制直接模拟语言。该体系为生成式AI提供科学边界,推动从“仿真表象”向“原生智能”的范式跃迁,开辟硅基人工生命新赛道。

抽象主义人工智能和生命体AI 139

OpenClaw 深度调查:把 AI 助手做成你自己的控制平面

对 openclaw/openclaw 的完整技术尽调:Gateway 架构、Agent 运行时、工具与沙箱、30 个消息通道、181 个插件、安全信任边界、工程代价与采用建议。17 章 / 10 张图,全部数字标注口径,数据截至 2026-10-31。

厚积薄发 263

企业微信iPad协议详解:接口接入、实时消息同步与语音转码实践

深入解析企业微信iPad协议的技术架构与开发思路,涵盖API接口接入、长连接通信、实时消息同步、Silk语音转码、异常重连及高并发优化,帮助开发者了解企业微信自动化系统的设计与实现。

欢迎来到祖安! 373

AI作图软件技术选型:从4个技术维度出发的实测对比

AI作图软件技术选型:从4个技术维度出发的实测对比

Vbaoke的博客 236

【AI Agent面试系列】AI Agent可观测、评测、安全相关的知识点

之前的文章介绍了和,本文主要介绍AI Agent的测评、可观测等知识。

302

Docling 原理解读:是什么、为什么、怎么样

从论文视角拆解 Docling 的整体架构、DoclingDocument 数据模型、PDF 预处理、版面分析、OCR、TableFormer 双解码器、阅读顺序与装配流程,并解释版面框与 OCR 框的区别。

PLANTTHESON的博客 354

WorkBuddy 实战:一句话需求 → 七屏可交互原型,户外徒步 App 的 AI 设计全流程

WorkBuddy 实战:一句话需求 → 七屏可交互原型,户外徒步 App 的 AI 设计全流程,跟着博主一起来还原整个过程。

夜郎King的博客 4954

从认识人工智能到理解机器学习:我的 AI 入门第一课

正式开始学习人工智能之前,我对 AI 的认识其实比较模糊:知道 ChatGPT、知道大模型,也知道现在很多岗位都在谈 AI,但如果有人问我“人工智能到底是什么”“机器是怎么学会识别一只猫的”,我未必能从头到尾讲清楚。上午的课程更偏向行业全景:人工智能的发展、研究方向、NLP、岗位分工、学习路线和 AI Coding 工具。下午的课程更偏向技术基础:机器学习的原理、有监督学习、深度学习、模型训练和评估方法。

chh563的博客 482
上一篇: 样品送检提速指南:iLabPower SIP V2.6.0 三大新功能来袭
下一篇: 让 AI 真正“懂分子“,分子模拟为何是精准AI模型的底层引擎
Lab_AI4S
博客等级 码龄1年 8粉丝 148原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值