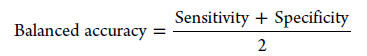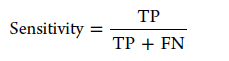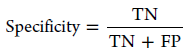机器学习预测铝合金高效缓蚀剂

损失函数与优化器:从「梯度是怎么被造出来的」到「梯度是怎么被用掉的」 本文揭示损失函数与优化器本质一体:优化器仅依赖损失产生的梯度,而损失决定梯度的方向、尺度与噪声特性。错误的损失选择(如分类用MSE)会导致梯度失衡,使优化器失效;不同损失(如Huber、Focal)通过调控梯度分布影响优化过程。实测表明,归约方式、标签结构与损失配对直接决定梯度行为,进而影响收敛性与泛化。核心观点:选对损失,才是让优化器“看得懂”的前提。 阅读详情

解决方案摘要:

有机缓蚀剂在替代传统防护技术方面发挥着至关重要的作用,因为传统防护技术存在严重的毒性问题,比如用重金属无机盐作为腐蚀抑制剂。然而,为什么一些有机化合物能抑制腐蚀,而另一些则不能,其中的机理至今仍不清楚。

本案例测试了不同的机器学习(ML)方法,以区分常用的铝合金高效缓蚀剂。研究成果可以大大有助于在未来自动搜索新的更高效的防腐解决方案:

(i) 确定了一种ML算法,该算法能够正确地分类有效抑制剂(即,效率超过50%)和非抑制剂(即,效率低于或等于50%),即使在同一数据集中包含了不同pH下不同合金的信息,这可以显著增加可用来训练模型的信息;

(ii) 对与分子自关联相关的新描述符进行了评估,但对模型的预测能力的改进有限;

(iii) 确定了抑制剂和非抑制剂的描述符的平均差异,有可能作为选择潜在抑制分子体系的指南。

该案例表明ML可以作为一种工具来执行分子的初始虚拟筛选,从而显著加快该领域的研究。

引言

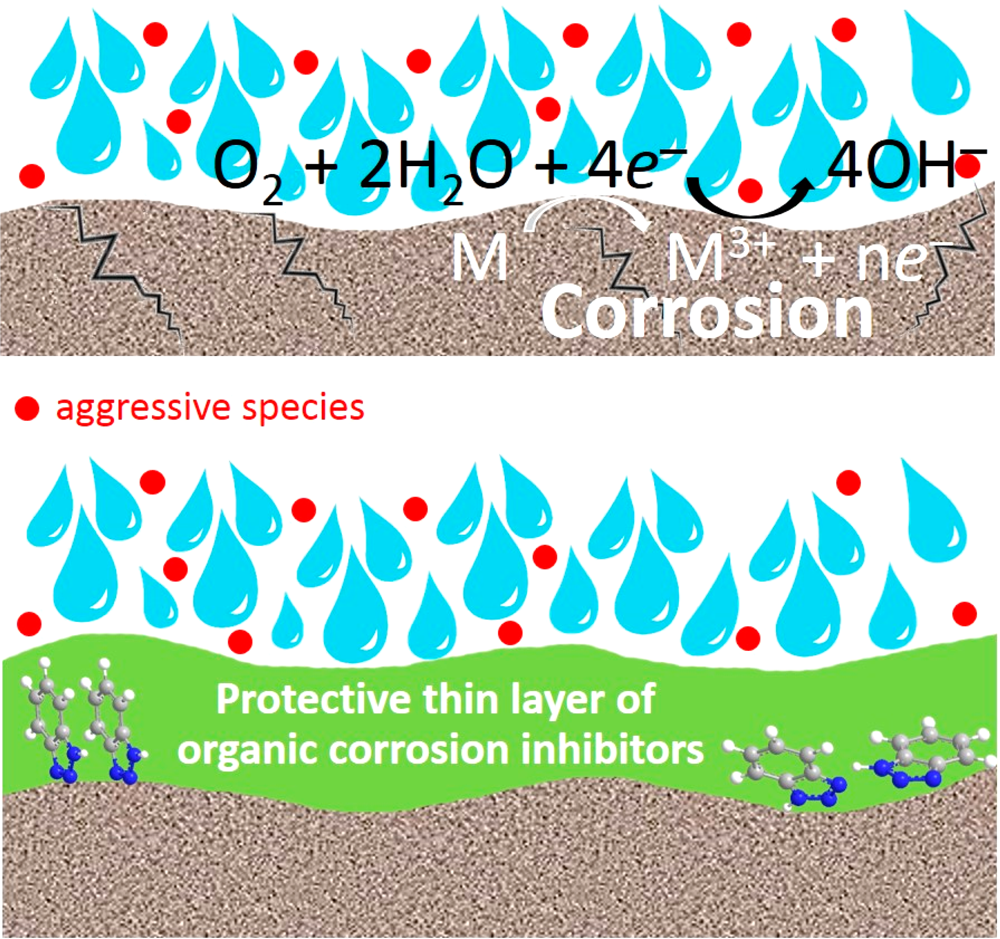
金属露在腐蚀介质中(水环境和氧气),金属腐蚀通常是氧化还原电化学反应的结果,即氧气的还原和金属的氧化。当金属表面有缓蚀剂保护膜时,缓蚀剂吸附在金属表面形成一层致密的保护膜,有效阻碍了腐蚀介质与金属的直接接触,从而起到抑制腐蚀电化学的反应。
P1.png

图1 铝表面的腐蚀电化学过程,包括阴极和阳极反应(上图),以及典型缓蚀剂(如1,2,3-苯并三唑)的吸附,以取代水分子并保护表面免受腐蚀性物种的侵害。

为了快速地筛选出高效的铝合金缓蚀剂分子,本案例采用机器学习方法对缓蚀剂的结构-性能关系进行研究,并对不同的ML算法进行比较分析,以区分铝合金的缓蚀剂和非缓蚀剂化合物的分类。这项工作有助于更好地理解每种算法的优缺点,从而预测有机化合物的缓蚀潜力。案例还提供与缓蚀剂最简单形式的自缔合有关的新描述符,即二聚化焓和二聚化吉布斯能。这些描述符是分子之间相互作用的强度的一个粗略的近似值,以在金属表面上形成粘性薄膜。这种薄膜还可以演变成多层,防止或至少减少侵略性物种与金属表面的相互作用。虽然二聚化能的计算通常比获得电子量子特性的计算要求更高,但它提供了与机械过程(保护膜形成过程中分子的自相互作用)更紧密的并行性,而仅通过将抑制效率与电子特性联系起来是无法实现的。

建立AI预测模型

1、 数据和描述符

本文共研究了102个有机化合物,其中主要包括芳香族基团和/或氨基、羧基、羟基和硫醇基团,涉及到两种铝合金AA2024和AA7075,以及弱酸性(pH4)和碱性(pH10)条件,总共有408个数据条目。

描述符种类:分子量、分子折射率、辛醇/水分配系数、极性表面积、分子体积、分子面积、极性体积、给体原子数、环数(芳香族或非芳香族)、疏水基团数、受体原子数和旋转键数、AA2024_pH4抑制效率、AA2024_pH10抑制效率、AA7075_pH4抑制效率、AA7075_pH10抑制效率、二聚化焓和二聚化吉布斯能。

2、 方法

机器学习方法:K近邻、决策树、带Boosting的决策树、定义错误代价的决策树、Bagging、随机森林、分类规则、人工神经网络和支持向量机。

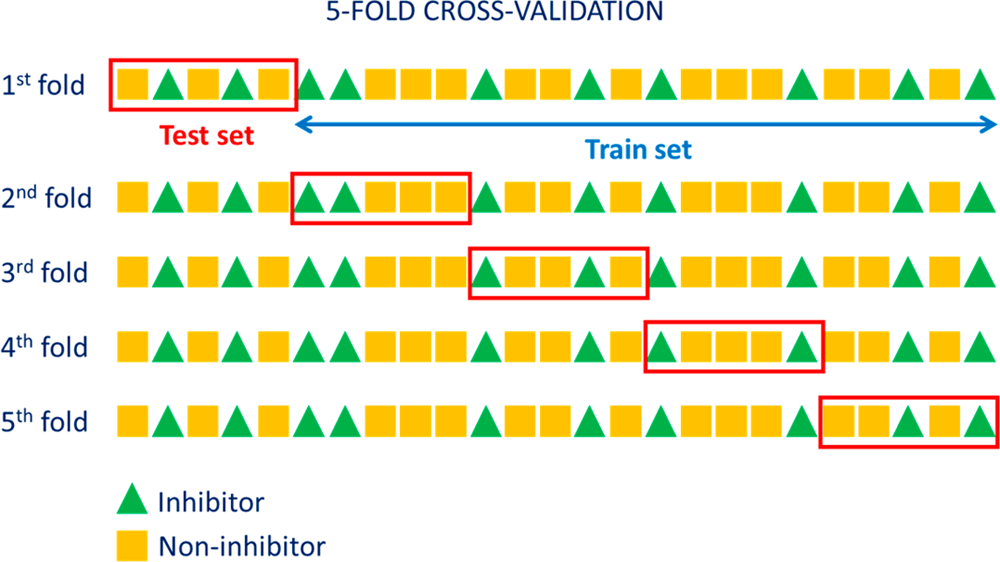
为了评估预测模型,案例采用了5倍交叉验证方法(图2)。
P2.png

图2 举例说明本工作中采用的5倍交叉验证统计方法。

结果与讨论

1、探索性数据分析
P3.png

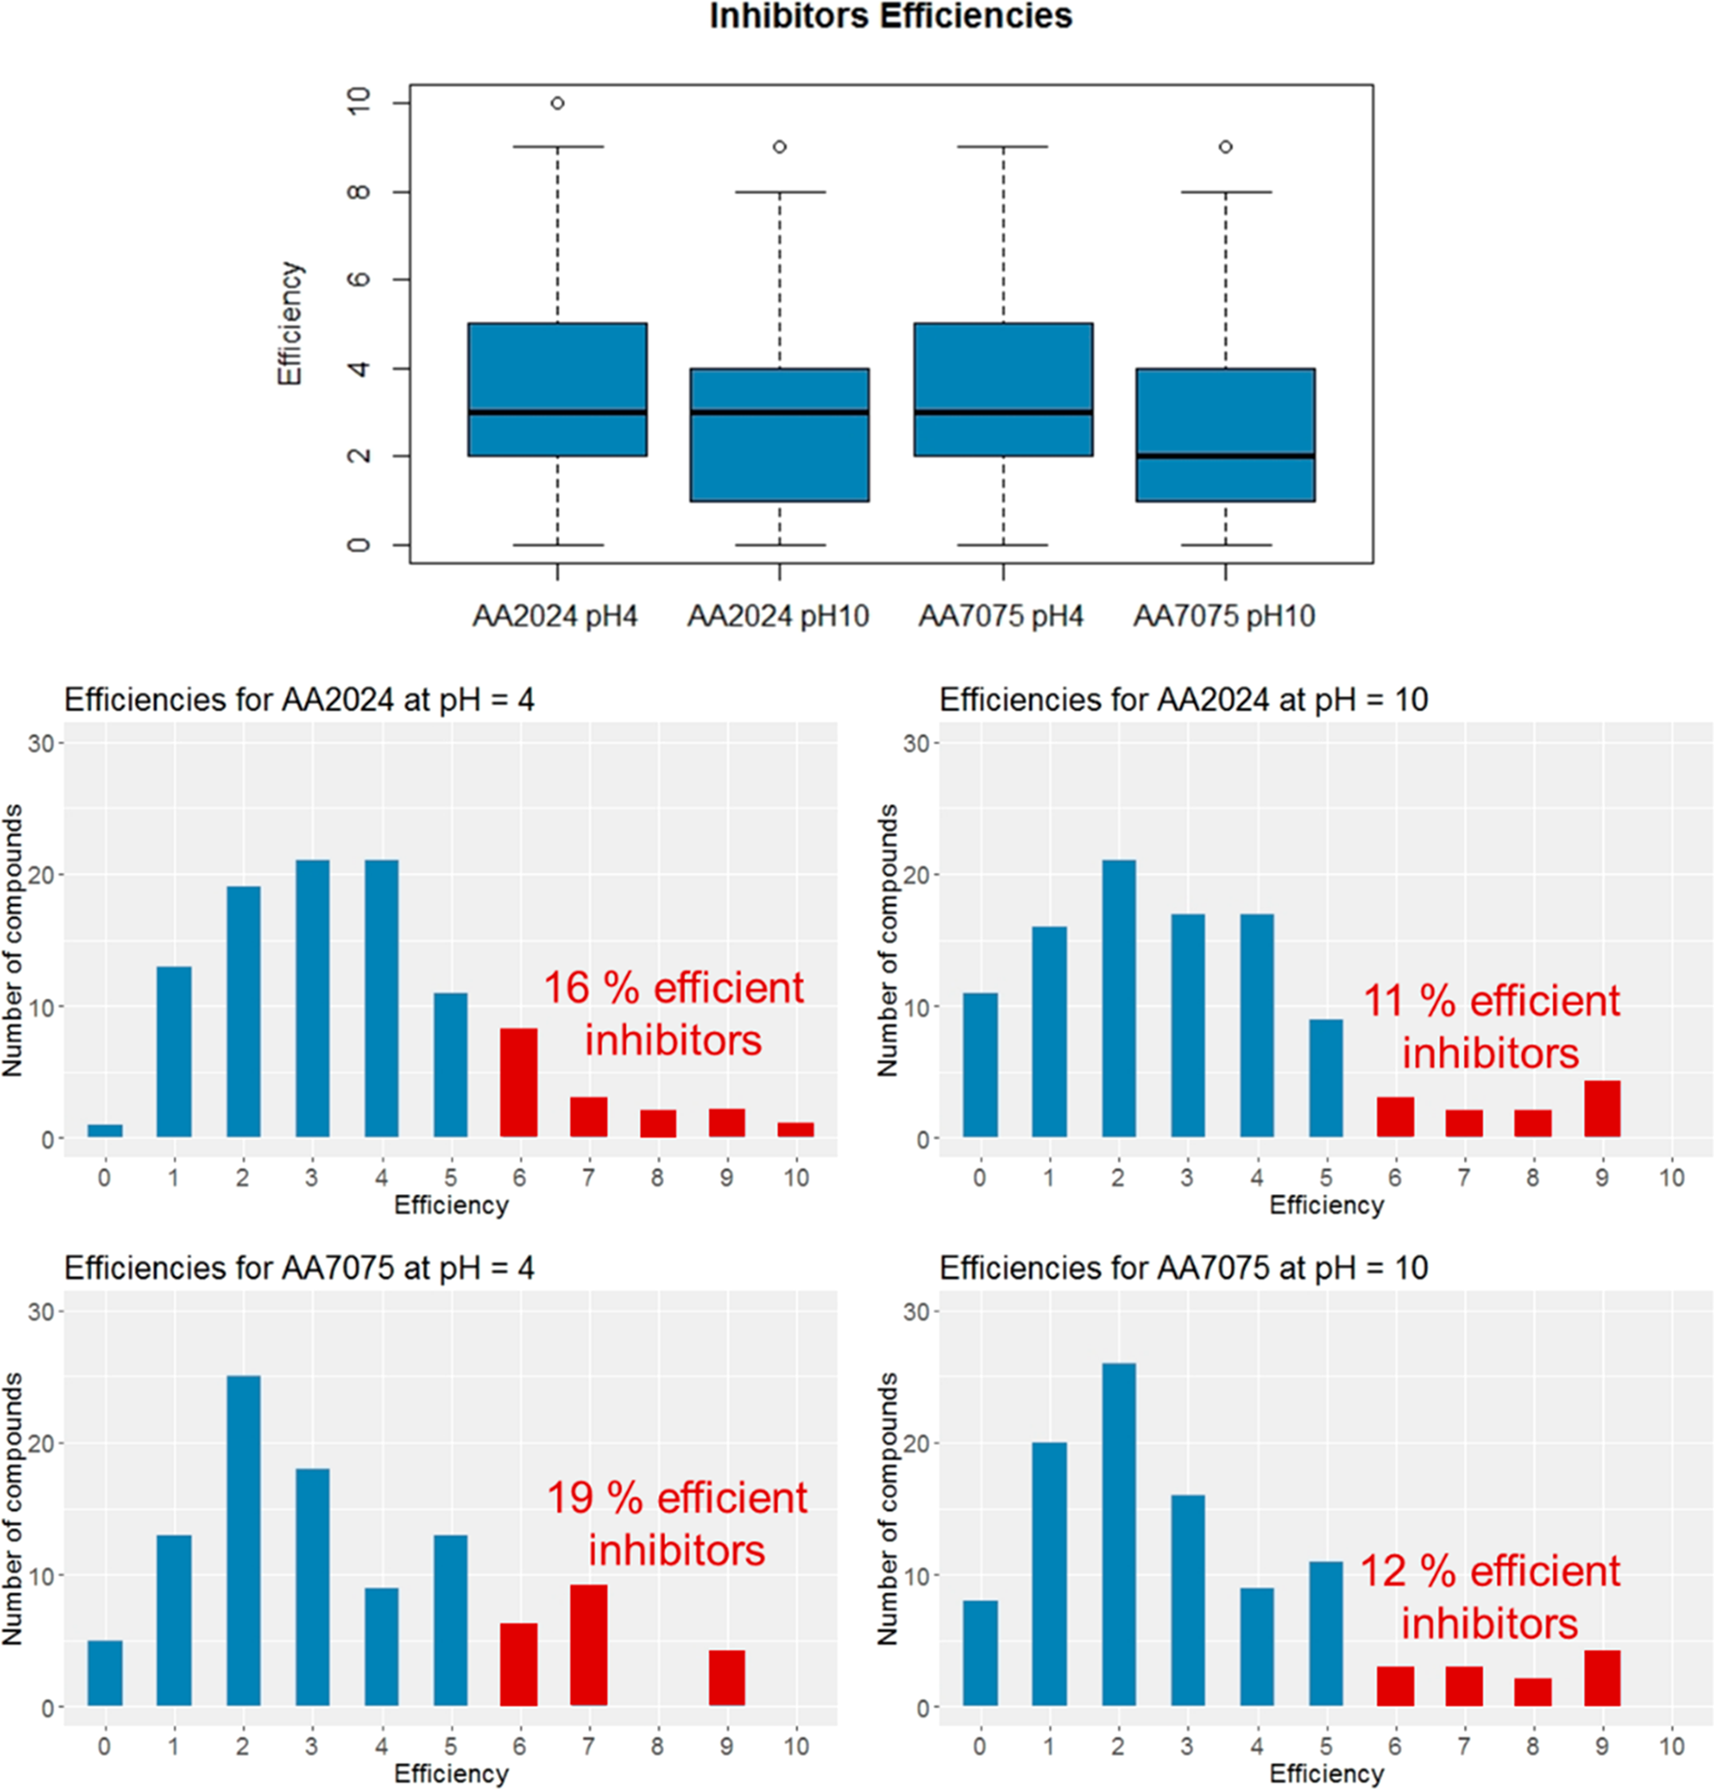
图3 显示了本案例中评估的不同条件下实验抑制效率(方框图和条形图,纵坐标0表示没有缓释作用)

根据箱形图可看出碱性条件下抑制剂的效率低于酸性条件下的效率。从柱状图可以看出,有效缓蚀剂的数量比弱缓蚀剂和非缓蚀剂的数量要少得多,这使得ML算法更难了解数据并正确识别化合物为缓蚀剂。
P4.png

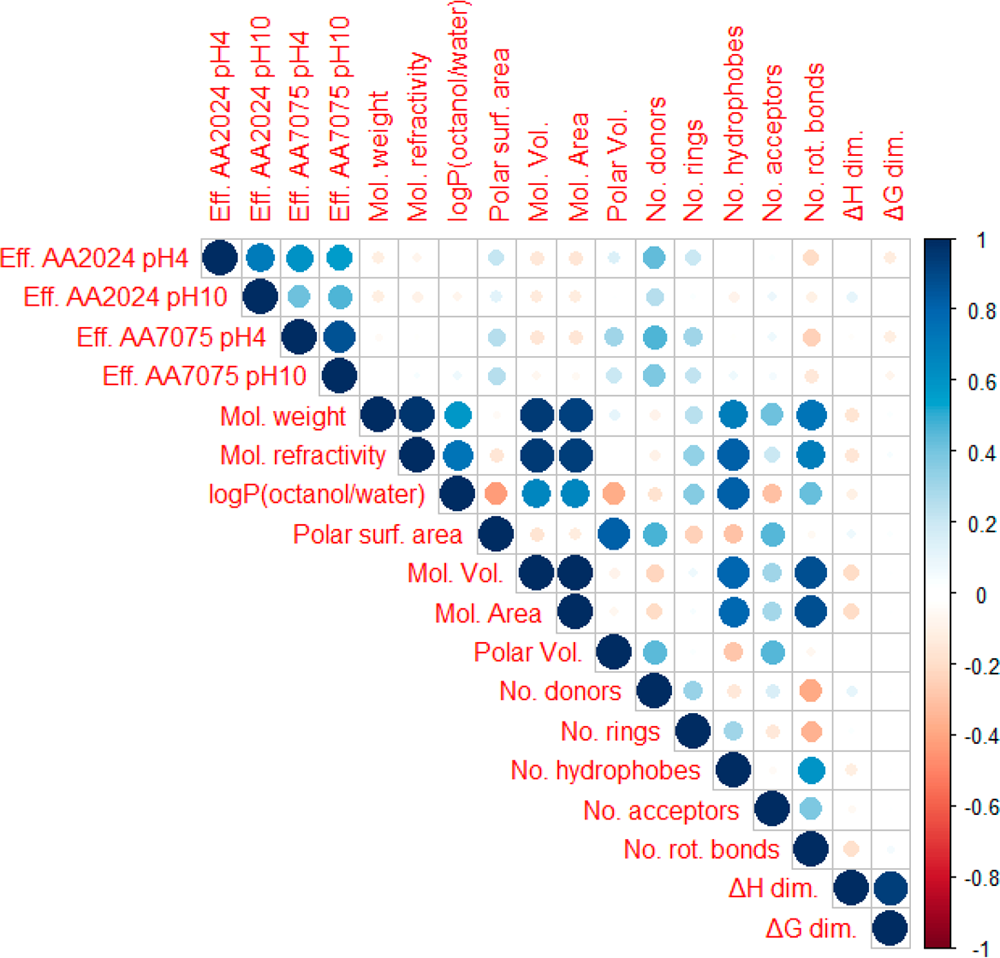
图4 抑制效率和描述符回归分析得到的线性相关图(蓝色表示正线性相关,而红色表示负线性相关。圆越大表示绝对线性相关值越高,而圆越小或没有则表示绝对相关值越低或线性相关为零)。

图4 研究结果表明只有氢键供体原子数与抑制效率有较好的相关性,其次是极性表面积、极性体积和环数。这表明,能够作为缓蚀剂的分子结构的识别是一个高度非线性的问题,线性回归是没有用的。

2、 不同机器学习方法的对比
P5.png

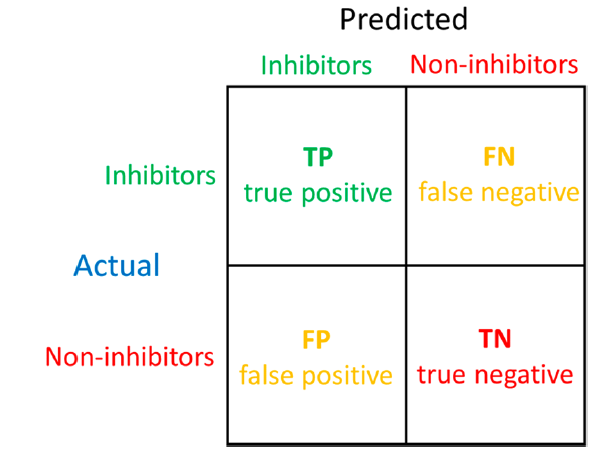
图5 抑制剂和非抑制剂分类的四种可能结果。

GS1.png

GS2.png

GS3.png

对于分类任务,性能指标考虑测试集的类别。感兴趣的类别(此处为缓蚀剂)称为正类别,而另一类非缓蚀剂称为负类别。两类缓蚀剂之间的关系如图5所示,包括四种可能的结果:(i)真阳性(TP),正确分类的缓蚀剂;(ii)真阴性(TN),正确分类的非腐蚀抑制剂;(iii)误报(FP),被归类为缓蚀剂的化合物,实际上是非缓蚀剂;(iv)假阴性(FN),被归类为非缓蚀剂但实际上是缓蚀剂的化合物。公式1、2和3定义的平衡准确性、灵敏度和特异性被用作分类的性能指标。
P6.png

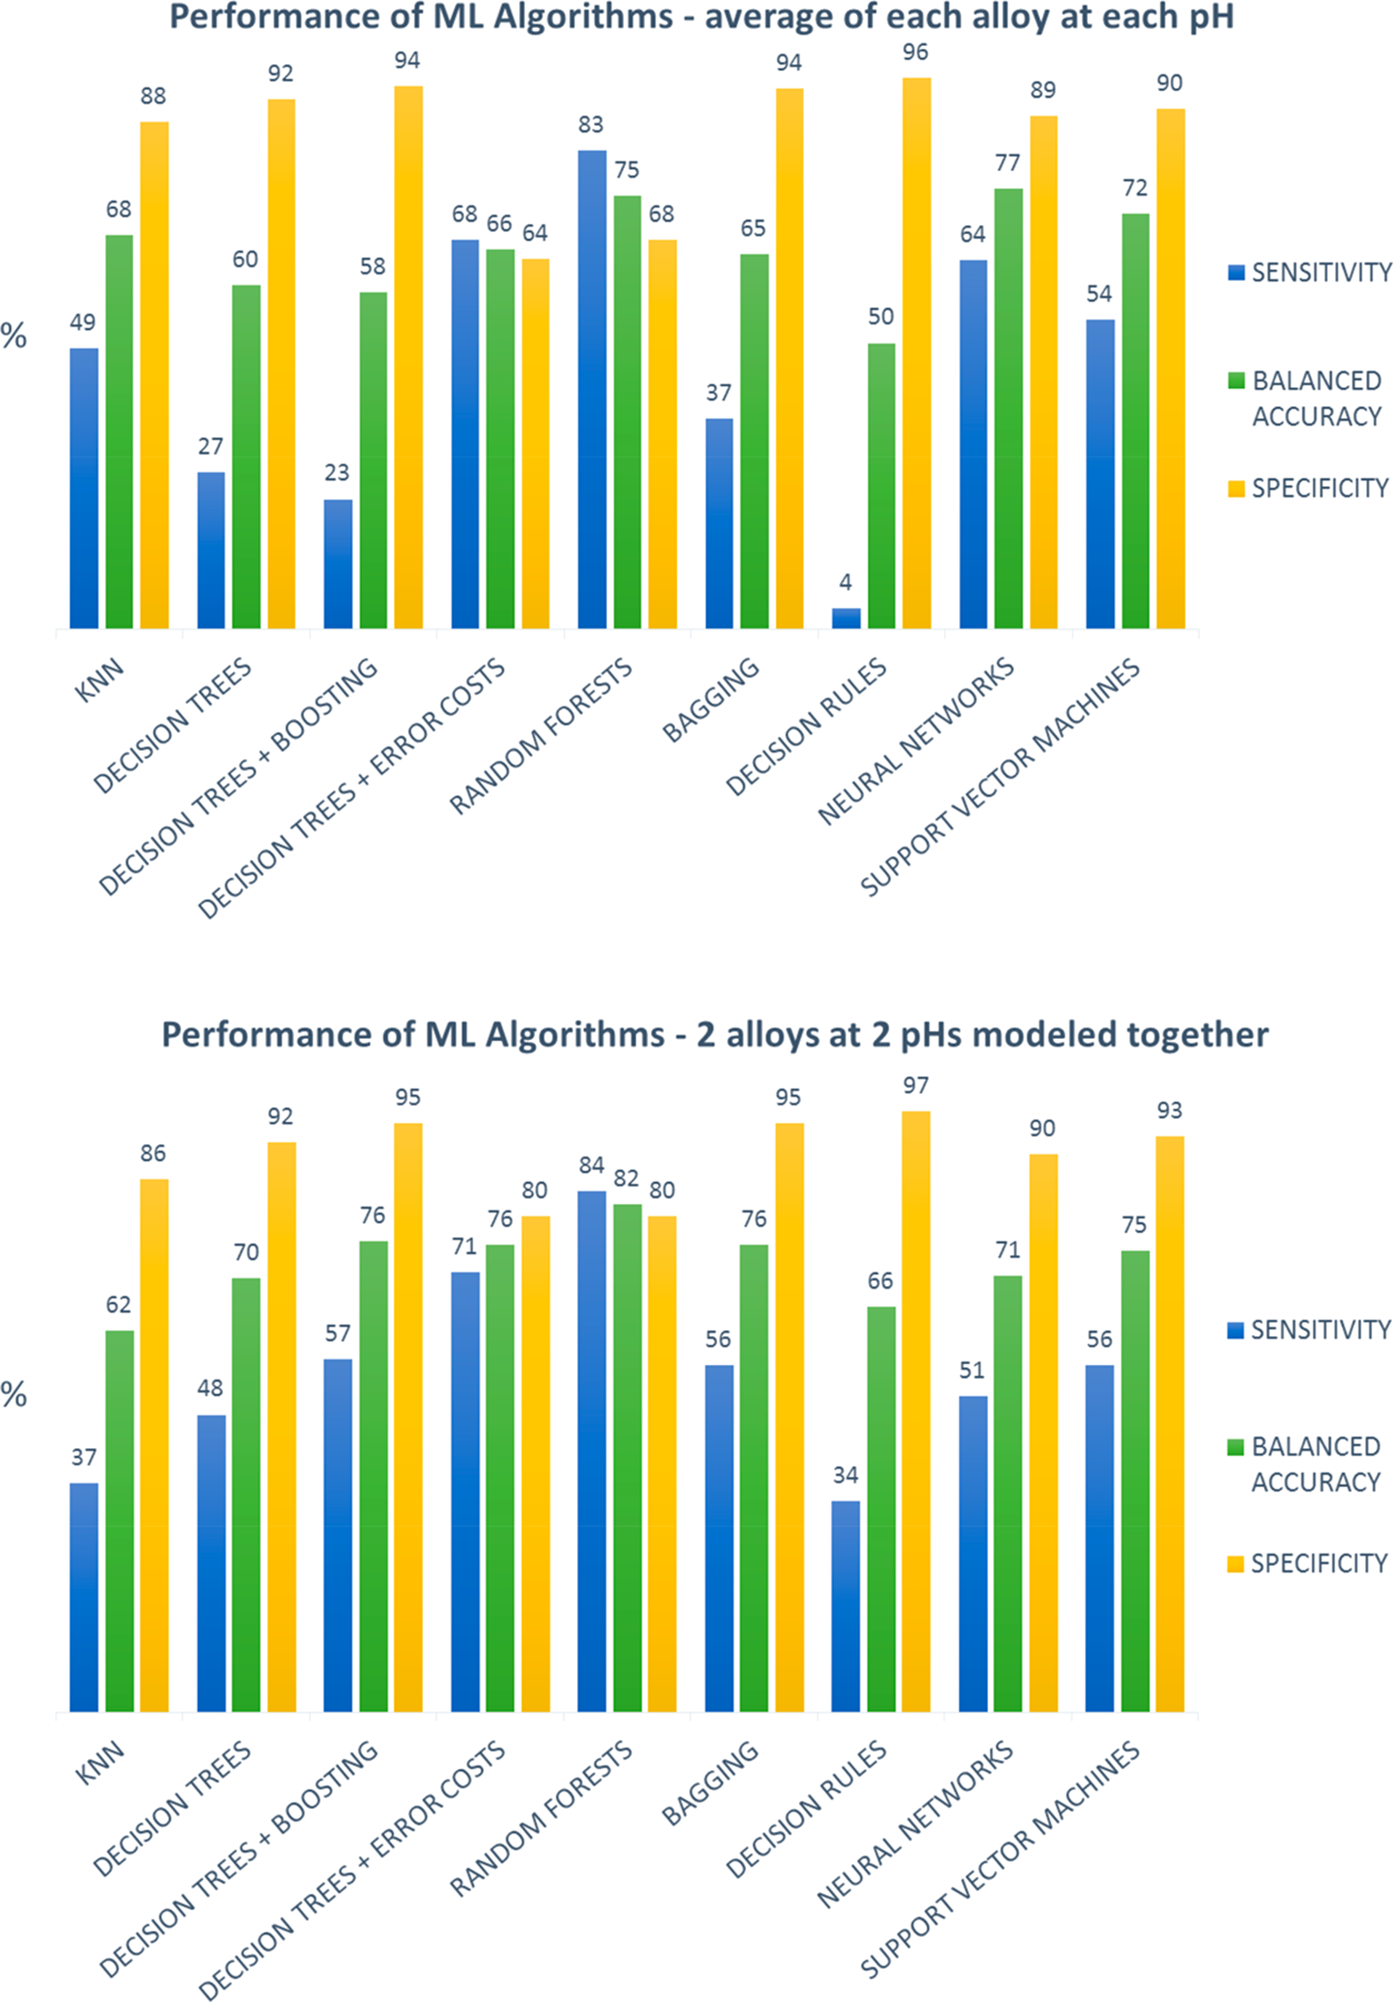
图6 (上图)ML算法分别研究两种合金在不同pH条件下的数据集的性能,(下图)ML算法研究同时包含两种合金在不同pH条件下的数据集的性能。

图6研究结果表明大多数方法的特异性接近90%,甚至更高。然而,高特异性(正确识别非抑制剂的概率)可能是由于数据集中非抑制剂的数量较多。因此,在统计上,他们的正确识别更可能是偶然的。另一方面,灵敏度是指正确分类真正抑制剂的概率,这些抑制剂的数量较少,并且也是具有本研究所关注条件(缓蚀)的化合物。在本研究中使用的数据集中,只有10−20%的化合物的缓蚀效率高于50%(标记为缓蚀剂);因此,80−90%的化合物的缓蚀效率等于或低于50%(标记为非缓蚀剂)。因此,例如,如果某个特定算法预测每种化合物都是非缓蚀剂,则其特异性将达到100%,但其性能仍然不令人满意,因为它无法正确识别任何缓蚀剂。因此,最重要的参数是平衡精度,由于数据集中缓蚀剂和非缓蚀剂的数量不平衡,本研究中使用的精度与其他文献类似,50和灵敏度是正确识别的真实缓蚀剂的比率。当考虑到在两种pH条件下对应于两种合金的四个独立数据集的平均平衡精度时,算法的性能顺序如下:分类规则<带boosting的决策树<决策树<bagging<定义错误代价的决策树<k近邻<支持向量机<随机森林<人工神经网络。关于灵敏度(正确识别真正的缓蚀剂),以下三种方法对单个数据集具有最佳性能:具有误差成本的决策树<人工神经网络<随机森林。神经网络是本研究中针对单个数据集测试的最平衡的方法,在灵敏度和平衡精度之间具有最佳折衷,而随机森林具有最高的灵敏度。

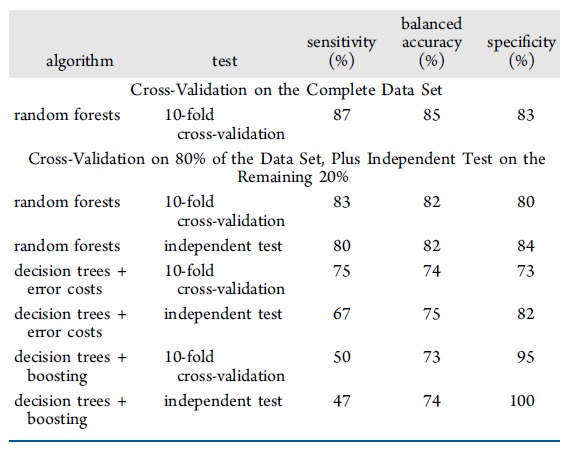
为了为算法的训练阶段收集更多数据,将对应于两种合金的四个子数据集(各102个示例)混合在一个数据集中,每个数据集分别测试两个pH值,共包含408个数据点。执行此测试的目的是,如果成功,它将打开构建更大数据集的大门,其中包含对应于不同合金、条件以及(期望的)不同金属的实验测试。表1研究结果表明,特别是随机森林,具有平衡的准确性和82%的特异性,以及84%的灵敏度,从更复杂的数据集(包括其他因素和条件,例如不同类型的金属、抑制剂浓度和腐蚀环境类型)中识别缓蚀剂看起来非常令人鼓舞。

表1 在两种合金和pHs一起建模的情况下,对复合数据集进行性能测试的灵敏度、准确性和特异性,这三种方法具有最高的灵敏度。
T1.png

3、缓蚀剂的主要特征

P7.png

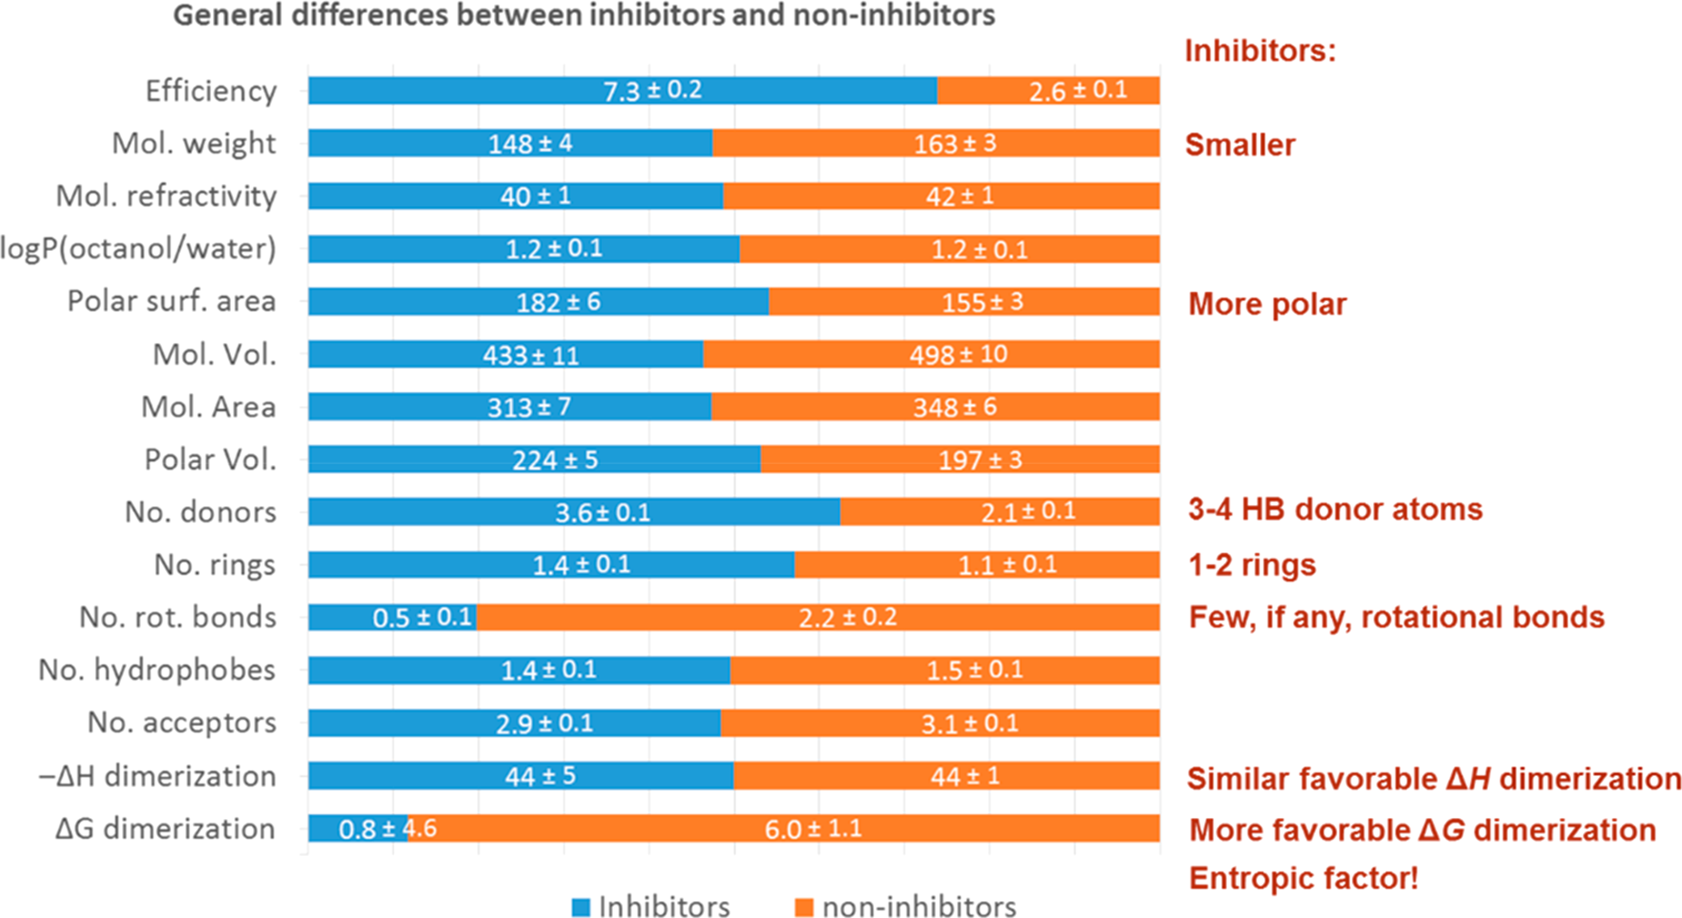
图7 缓蚀剂的主要特征

为了进一步了解区分抑制剂和非抑制剂的特性,获得了整个可用数据的平均值。结果表明,缓蚀剂具有一个或两个芳香环,旋转键很少或没有(大量旋转键不利于缓蚀)。它们的极性也更强,有3到4个氢键供体原子,并且具有更有利的二聚化吉布斯能;

尽管二聚化焓也是有利的,但抑制剂和非抑制剂的二聚化焓是相同的。更有利的吉布斯能和相似的二聚焓也表明了熵项对二聚体形成的重要性,这也与更高的抑制效率有关。

结论

1、通过该研究提供了一种不需要用实验方法评价缓蚀剂的效果,并且该研究发现,随机森林是最成功的方法。

2、对于四个独立的数据集(AA2024和AA7075,在pH 4和pH 10下),随机森林的平均准确率为68%,同时能够正确识别83%的抑制剂。这表明在未来,分析数据不仅包括不同类型的合金和pH,还可能包括其他电解质条件,如腐蚀性阴离子浓度、抑制剂浓度,甚至金属类型。

3、引入二聚焓和吉布斯能作为保护膜形成过程中分子间相互作用的间接衡量指标。

4、对抑制剂和非抑制剂性能的平均值进行了统计分析,表明抑制剂具有一个或两个旋转键很少或没有旋转键的芳香环。此外,大量的旋转键似乎阻碍了缓蚀。抑制剂的极性更强,结构中有3到4个氢键给体原子,并且具有更有利的二聚化吉布斯能,尽管二聚化焓也很有利,但抑制剂和非抑制剂的二聚化焓相同,这表明二聚化熵是保护机制的重要因素。

参考文献:

J. Phys. Chem. C 2020, 124, 5624−5635. https://dx.doi.org/10.1021/acs.jpcc.9b09538

【信息科学与工程学】【物理/化学科学和工程技术】知识体系04 热学 系列二01 尺度与速率:都涉及微纳尺度的热传递,并追求对热过程的快速、精确控制(RTP:秒级;芯片:毫秒级;NIL:秒级)。温度均匀性:是所有领域的核心目标。芯片要求空间温度均匀以保证性能与可靠性;RTP要求片内温度均匀以保证工艺一致性;热NIL要求大面积温度均匀以保证图案保真度。测量与控制的闭环:都严重依赖高精度、实时的温度测量(红外、热偶、噪声)和先进控制算法(PID、MPC、前馈)。材料的热响应:都涉及材料(硅、聚合物、界面材料)热物性(k, c_p, α, η)的精确表征及其对温度/过程的依赖性。多物理场耦合。 阅读详情

相关推荐

【信息科学与工程学】【解决方案体系】第一篇 黑灯工厂解决方案03

方程类别方程名称数学表达式参数说明物理意义应用场景晶体结构与对称性​布拉维格子平移矢量T=ua1​+va2​+wa3​a1​,a2​,a3​: 基矢; u,v,w: 整数晶体周期性平移对称性晶格定义, 倒格子计算晶面间距(立方晶系)dhkl​=h2+k2+l2​a​a: 晶格常数; (hkl): 晶面指数相邻平行晶面间的距离X射线衍射, 晶向计算晶面间距(六方晶系)dhkil​=34​(h2+hk+k2)+(ca​)2l2​a​a,c: 六方晶格常数; (hkil): 四指数晶面六方晶体(如4H-SiC)晶

weixin_49199313的博客 761

AI4S: 利用机器学习探究铝合金缓蚀剂的结构-性能关系

摘要:本研究采用机器学习方法筛选铝合金高效有机缓蚀剂,建立了包含102种化合物、408个数据条目的数据集。通过比较9种算法发现,随机森林模型表现最优,在混合数据集测试中达到84%的灵敏度,能有效区分缓蚀效率>50%的化合物。研究揭示高效缓蚀剂具有1-2个芳香环、3-4个氢键供体、较少旋转键等结构特征,并首次引入二聚化吉布斯能作为分子自缔合描述符。该工作为虚拟筛选缓蚀剂提供了有效工具,可加速新型防腐材料的开发。

Lab_AI的博客 538

【信息科学与工程学】【制造工程】计算机科学与自动化——服务器制造中的学科知识01

由可数可加性:μ(A)=∑k=1∞​μ(Bk​)=limn→∞​∑k=1n​μ(Bk​)=limn→∞​μ(⋃k=1n​Bk​)=limn→∞​μ(An​)。:若limsupAn​=liminfAn​=A,则A中的元素恰是那些“最终总是属于An​”的元素,也是那些“属于无穷多个An​但不属于无穷多个Anc​”的元素。:通过构造一个不相交的序列{Bn​},其中B1​=A1​, Bn​=An​∖(⋃k=1n−1​Ak​)。则⋃n​Bn​=⋃n​An​,且Bn​⊂An​。我们称A为一个“集类”或“集合族”。

weixin_49199313的博客 571

从认识人工智能到理解机器学习:我的 AI 入门第一课

正式开始学习人工智能之前,我对 AI 的认识其实比较模糊:知道 ChatGPT、知道大模型,也知道现在很多岗位都在谈 AI,但如果有人问我“人工智能到底是什么”“机器是怎么学会识别一只猫的”,我未必能从头到尾讲清楚。上午的课程更偏向行业全景:人工智能的发展、研究方向、NLP、岗位分工、学习路线和 AI Coding 工具。下午的课程更偏向技术基础:机器学习的原理、有监督学习、深度学习、模型训练和评估方法。

chh563的博客 492

【信息科学与工程学】计算机科学与自动化-第十一篇 机械工程04 机械结构

上述表格总结了常见机械几何结构的参数特性及其应用场景,涵盖宏观几何参数、微观物理特性等多个层面。这些参数在设计、制造、分析和优化机械结构时都需要综合考虑,以确保结构满足功能、性能、可靠性和寿命要求。注意:微观层面特性通常涉及材料科学、纳米技术和表面工程等领域,对结构的疲劳、磨损、腐蚀、摩擦和润滑等性能有重要影响。宏观层面特性则决定结构的运动学、动力学、强度、刚度和稳定性等整体性能。实际应用中,需根据具体工况(载荷、速度、温度、环境等)选择合适的参数组合,并进行多学科优化设计。上表整理了常见机械几何结构的参数

weixin_49199313的博客 1157

开源LocalAI本地人工智能安装教程

LocalAI是一款能在本地运行的人工智能应用,它兼容了OpenAI API规范,它可以在普通的电脑运行,不需要GPU,也不需要联网,音频转录

2301_78652552的博客 3615

低温ECR-MOCVD生长(002)GaN:椭偏仪测厚与电学性能

本研究用ECR-MOCVD在Si(111)和蓝宝石衬底上低温生长GaN薄膜,蓝宝石1.0SCCM、2h样品呈完全(002)择优取向,椭偏仪测厚32.81nm,迁移率10.42cm²/(V·s)。文章梳理了生长温度、TMGa流量与生长时间对结晶取向、膜厚、粗糙度、光学带隙和电学性能的影响。

Flexfilm_的博客 383

uniapp运行钉钉小程序

因项目原因,公司需要在钉钉里面开发小程序。之前用uniapp开发过app,H5,小程序。还真没尝试过钉钉小程序,今天就简单的记录下uniapp运行钉钉小程序中的过程。

YL 2919

机器学习基础|监督学习、标签、回归

网约车预估等待时长依赖监督学习中的回归任务。平台利用历史订单数据,以司机实际到达耗时为标签,通过上车点、时间、运力、路况等特征训练模型。模型不断优化预测值与真实耗时的误差,最终对新订单输出连续的预估等待时间,实现精准预测。

weixin_43971465的博客 264

手把手教你玩转AT32F403A位带操作:像51单片机一样控制GPIO

本文详细介绍了如何在雅特力AT32F403A国产MCU上实现位带操作,像51单片机一样高效控制GPIO。通过实战演示和性能对比,展示了位带操作在实时控制中的优势,包括更快的执行速度和更低的延迟,特别适合工业控制和电机驱动等场景。

weixin_29234509的博客 285

Linux系统安装AutoDockTools、AutoGrid和AutoDock并实现分子对接(详细讲解)

linux系统为centos7.0 按照下面操作安装AutoDockTools(MGLTools) 1. 下载安装包,链接(https://ccsb.scripps.edu/mgltools/downloads/),我的linux系统是64位,下载红色标记源代码,拷贝入linux目标文件夹下。 2. shell终端进行安装: 1. 终端进入安装包所在文件夹,并获取root权限;赋予代码安装权限; cd /home/... #目标文件夹,根据目标程序文件位置进行更改 su #获

carlos_zhao的博客 1万+

Hugging Face:成为机器学习界的“Github”

以下文章来源于OneFlow,作者OneFlow社区五年前,AI领域的知名研究者Andrej Karpathy发文称,传统人工编程属于“软件1.0”,“软件2

2601_96798011的博客 144

V-REP(Cooprliesim EDU)自学笔记 实现UR5机械臂末端按轨迹移动

V-REP(Cooprliesim EDU)自学笔记 实现UR5机械臂末端按轨迹移动

xu_white的博客 7583

机器学习——混淆矩阵(待更新)

二元: true表示真实==预测,positive表示预测值=1.

m0_61175448的博客 170

华为od统一考试B卷【单词搜索】C++ 实现

找到它是一个小游戏,你需要在一个矩阵中找到给定的单词。假设给定单词 HELLOWORD,在矩阵中只要能找到 H->E->L->L->O->W->O->R->L->D连成的单词,就算通过。意区分英文字母大小写,并且您只能上下左右行走,不能走回头路。

MISAYAONE的博客 713

手把手教你RK3568 MIPI屏驱动适配,纯干货!

RK3568 作为一款高性能的多媒体处理器,在嵌入式领域中备受瞩目。它采用了先进的 22nm 制程工艺,搭载四核 Cortex-A55 处理器,这种架构为芯片提供了高效的功耗比,使其在运行各种复杂任务时,既能保证性能,又能有效控制功耗。在实际应用中,无论是多任务处理还是运行大型应用程序,RK3568 都能凭借其四核 Cortex-A55 处理器,实现流畅的操作体验,满足智能设备对高性能和低功耗的需求。

远程部署调试 运行安装 项目调试 二次开发 项目技术新 持续迭代 部分源码免费分享 4071

LoRA的低秩数学与QLoRA实现

本文系统解析了LoRA及其进阶版QLoRA在十亿参数模型微调中的高效机制。通过低秩假设,将权重更新量ΔW近似为低秩矩阵积,显著压缩可训练参数与显存占用;QLoRA进一步将基座模型量化至4比特(NF4),结合双重量化与分页优化器,实现65B模型单卡微调。文章详解了B初始化为零、缩放系数α/r设计、挂载位置选择等关键实操细节,并给出可运行代码。实践表明:4比特基座+高精度LoRA在多数任务上媲美全参微调,且训练效率极高。超参方面,r不宜过大,学习率需上调,数据质量重于数量。最后强调:LoRA适用于风格适配与领域

2601_96733043的博客 296

Android 中 app freezer 原理详解(二):S 版本

在之前的两篇博文《Android 中app内存回收优化(一)》和《Android 中app内存回收优化(二)》中详细剖析了 Android 中 app 内存优化的流程。这个机制的管理通过 CachedAppOptimizer 类管理,为什么叫这个名字,而不叫 AppCompact 等?freezer,一个针对应用进程长期处于 Cached 状态的优化。在之前博文《app freezer 原理 R 版本》

私房菜 3611

Spark06_MLlib机器学习

本文是《PySpark 从入门到实战》系列收官篇,带你用 Spark MLlib 走通机器学习全流程:从三要素与 7 步标准流程讲起,剖析 KNN、朴素贝叶斯、决策树三大算法原理,再以 KNN 手写、垃圾短信分类、决策树分类、逻辑回归鸢尾花(准确率 96.67%)、K-Means 聚类(轮廓系数 0.7345)五个案例落地,最后详解 TF-IDF 文本特征与余弦相似度。全文代码可直接运行,适合有 RDD 与 Spark SQL 基础的开发者快速上手。

2301_80420058的博客 469

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

机器学习01,KNN使用与简单数学原理

个人笔记

qq_59247073的博客 273

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

AI小白入门|无监督学习到底是什么?

很多新手看完无监督学习的定义只会死记硬背。本文避开复杂公式,从真实业务场景切入,对比监督学习,讲清楚无监督学习的核心价值、适用场景、底层逻辑和容易踩坑的认知误区,帮你理解它在机器学习链路里的定位。

weixin_43971465的博客 194

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

SVM支持向量机通俗解析:找到机器学习的“最优分界线”

一、爆款钩子:同样是画分界线,为何SVM能成为机器学习的“王者选手”?做机器学习的人,几乎都绕不开一个问题:如何给混乱的数据“分家”?有人用逻辑回归,有人用KNN,但有一个算法

2601_96798737的博客 147

机器学习03,端到端02

个人笔记

qq_59247073的博客 274

GaN 动态导通电阻测试专题:电流崩塌从哪来,测量窗口怎么选

但器件装到实际电路上跑一段时间,或者用双脉冲台架模拟开关工况再测导通压降,数值往往明显高于手册静态值,而且关断应力越强(母线电压越高、应力保持越久),抬升越明显;:使用钳位电压探头,把示波器通道的工作区间限制在低电压区(常见做法是钳位在 1.5V 附近的导通压降区),应力高压段由钳位电路吸收,导通段以高分辨率采样。台架搭建相对简单,是器件表征最常用的方案。双脉冲台的难点不在发脉冲,而在采样:漏源电压要从几百伏的应力电平瞬间跌落到毫伏至伏级的导通压降,示波器单一量程难以兼顾"扛住高压"和"分辨毫伏"。

Namisooft的博客 256

《机器学习sklearn实战教程》02|Python机器学习开发环境搭建

2.1 为什么要先搭环境很多人学机器学习,卡住的第一步不是算法,而是环境。代码明明照着教程敲了,却一运行就报错。不是缺包,就是版本冲突。最常见的情况是,昨天还能跑,今天装了个新库

2601_96798011的博客 148

CAGR 21.8%:GaN功率器件封装材料市场从3.23亿美元迈向12.77亿美元

随着氮化镓(GaN)功率半导体在消费快充、AI服务器电源及车载电源领域的加速渗透,GaN功率器件封装材料作为实现芯片贴装、电气互连、热量传导和长期可靠性保障的核心功能性材料,正迎来爆发式增长期。根据LP Information(路亿市场策略)初步调研,2025年全球GaN功率器件封装材料市场规模约为3.23亿美元,2026年预计约3.91亿美元,2032年将达到12.77亿美元,2026—2032年复合增长率(CAGR)高达21.8%。

LPIHelen的博客 193
上一篇: 电子实验记录本 ELN引领无纸化实验室新纪元来源
下一篇: AI驱动药物发现:数据基因组重塑构效关系研究
Lab_AI4S
博客等级 码龄1年 8粉丝 148原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值