机器学习快速预测含氮分子的爆炸特性以发现新的含能材料

化学机器学习实战:分子表征与构效关系建模核心指南 分子表征是化学机器学习的基石概念,指将化学结构转化为模型可计算的数值特征;其本质在于在信息保真度与计算效率间取得平衡,直接影响构效关系建模的可靠性。ECFP4等指纹方法因具备明确化学语义和官能团感知能力,成为工业界事实标准;而构效关系建模则需融合物理先验(如DFT描述符、Hammett常数)与统计学习,避免纯数据驱动导致的伪相关。该技术的核心价值在于将经验性化学直觉量化为可验证、可迁移的预测规则,广泛应用于药物活性预测、材料性能筛选及反应条件优化等场景。本文聚焦真实研发中的分子表征选型逻辑与构效建模落地要点 阅读详情

摘要:含能材料广泛应用于军事、土木工程和空间探索等领域。新含能材料的发现是开发新一代武器、采矿、建筑、火箭推进技术的基础。本研究开发了一种机器学习辅助方法,通过高效预测和快速筛选来加速新含能材料的发现。建立了合适的神经网络,根据不同含氮分子的结构准确地预测各种含氮分子的爆轰特性,包括密度(ρ)、爆速(D)和爆轰压力(p)。此外,也确定了高精度扩展预测的最小数据库容量。利用机器学习发现新的含能化合物的概念验证研究,发现了31种具有出色爆轰性能的新含氮分子。预计在机器学习的辅助下,下一代含能材料的发展将大大加快。

1.引言

新型推进剂、烟火、炸药的发展,对含能材料的要求不断提高。应高效设计和开发更安全、更强大、更经济的含能材料。实验上由于数量巨大且安全性差的原因,合成所有可能的化合物并测试它们的性质是不现实的。因此,发展了一些计算和预测方法,以快速筛选候选分子。

近年来,随着人工智能和机器学习技术的发展,神经网络已被用于根据相应结构有效预测分子性质。无机固体的原子化能、能带、键能、聚合物的介电击穿强度、分子液体的临界点性质和光合复合物的激子动力学等,被各种神经网络预测,误差很小。最近,一些研究人员将机器学习作为一种工具来预测含能材料的性质和筛选含能分子。Elton等人应用机器学习技术从分子结构预测CNOHF含能分子的性质。基于一个包含104个数据点的大数据集,通过机器学习预测了爆轰速度。结合机器学习(ML)、材料信息学(MI)和热化学数据,根据高ΔHe值筛选分子候选物。基于机器学习的性质预测和分子筛选策略在发现新的高能密度材料方面具有很大的潜力。

为了有效地发现新的含能材料,对已开发的神经网络的扩展预测是一项需要评估的额外要求。我们最近发起了一项研究,以基于机器学习高通量筛选发现新的碳氢化合物燃料。在小数据库上训练的最优神经网络也可以应用到更大的数据库中,准确预测新设计的含N分子的爆炸特性。有趣的含能材料的发现将大大加快。

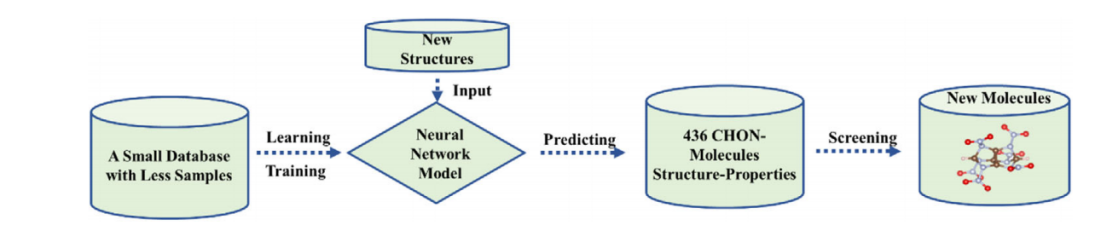
这项工作试图通过机器学习快速预测新型含能材料的爆轰性质,实现对新型含能材料的快速筛选。建立了各种不同体积的典型含能分子的结构-性质数据库,并在此基础上训练了许多神经网络,以准确地扩展预测爆轰性质。研究了数据库样本数量对机器学习扩展预测精度的影响。使用在较少样本上训练的已开发神经网络,实现了对这些新分子的有效性质预测和快速筛选。最后,确定了31个具有高密度、高爆速和高爆压的分子,其精度与理论计算相当。机器学习有望大大加快用于各种应用的新含能材料的设计和发现。这项工作的方案如图1所示。
P1.png

图1 机器学习的属性预测和分子筛选示意图。

2、数据库与方法

2.1 数据库

2.1.1数据集

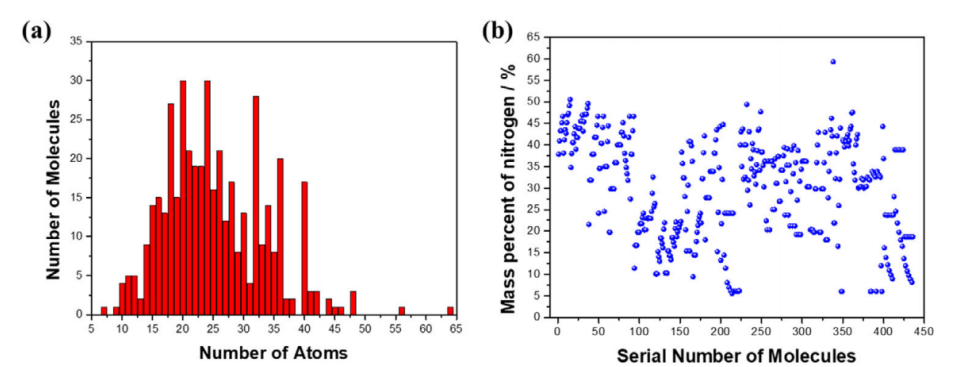
我们使用了许多典型炸药(TNT、CL-20、HMX、RDX等)作为初始数据集和分子骨架设计了436个包含碳(C)、氢(H)、氧(O)和氮(N)元素的分子,因为这些炸药分子在实验中具有出色的爆轰特性,并通过理论动力学分析进行了验证。在这些“分子骨架”的基础上,我们使用键长不等的取代基─NO2、─N─NO2、─O─NO2,短键长的N─NO2、NH2、─NH─NO2构建了新的分子。 如图2所示,分子中包含的原子数为7至64,分子中氮的质量百分比为5.53%至59.32%。统计数据证实了该数据库中设计的分子结构的多样性。
P2.png

图2 a)原子数和b)分子中氮的质量百分比的统计数据。

2.1.2. 计算爆轰特性的方法

密度(ρ)、起爆速度(D)和起爆压力(P)是评价炸药性能的关键指标。下面介绍这三个性质的理论计算方法。

理论密度ρ(g cm-3)采用由Politzer等人推导的式(1)计算
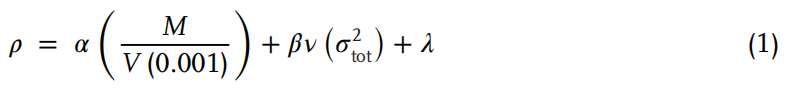
S1.png

M为分子质量(g mol−1),V(0.001)为分子电子密度的0.001电子玻尔轮廓线的体积(每分子cm3),ν表示在等值面上正负电势的平衡程度,

微信图片_20221017134118.png

是静电电势变异性的度量,系数 α、β和λ分别为0.9183,0.0028和0.0443。根据经验Kamlet-Jacobs方程(式(2)和(3))分别估算了爆炸物的爆速D (km s−1)和爆压P (GPa)。
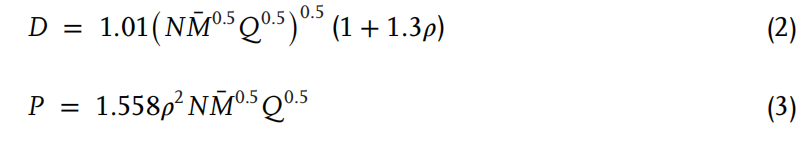
S23.png

N是每克炸药产生的气体的摩尔数,

微信图片_20221017134246.png

为气态爆轰产物的平均分子量,Q是爆轰热(cal  g-1),ρ是炸药的密度(g cm-3)。

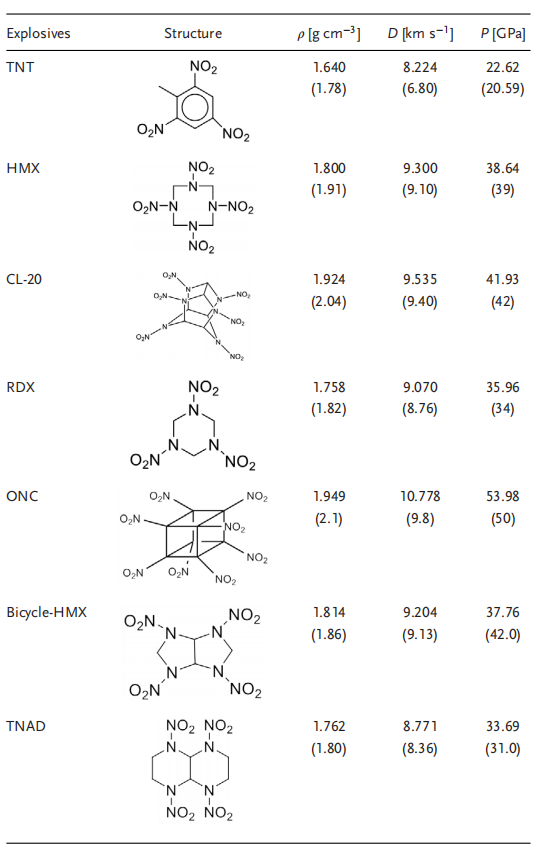
基于上述理论计算方法,我们对7种典型的爆炸分子进行了计算,并比较了理论计算值与实验值的差异。7种典型炸药的ρ、D和P的理论计算值与实验值之间的MAEs分别为0.0905 g cm-3、0.5046 km s -1和2.190 GPa。结果(如表1)表明,本文所采用的计算方法对于预测爆轰性质和筛选目标分子具有足够的准确性。然后用上述方法计算了数据库中其他429个分子的爆炸性质。至此,436个分子的分子结构及其爆轰特性数据库全部建立。

表1 七种典型炸药的理论计算和实验(括号内)性能比较。
T1.png

2.2 数据表达

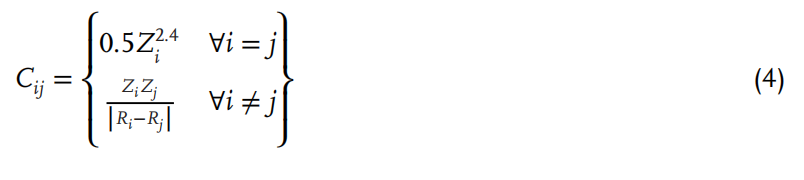
根据之前的工作,库仑矩阵及其本征值已被初步证实是预测分子性质的有效表示。本文选择包含分子结构和核电荷的库仑矩阵作为机器学习的输入。根据式(4)计算库仑矩阵如下:
S4.png

其中,R为笛卡尔坐标,Z为核电荷,非对角元素表示原子i和j之间的库仑斥力,对角元素表示原子能与核电荷的多项式(0.5

微信图片_20221016222726.png

)拟合。这个数据库中分子的原子数从7到64. 因此,我们在低维矩阵中填入0,得到64 x 64的均匀数据。然后由式(5)计算库仑矩阵的本征值。Cij为分子的库仑矩阵。计算得到的本征值也可以代表分子结构

S5.png

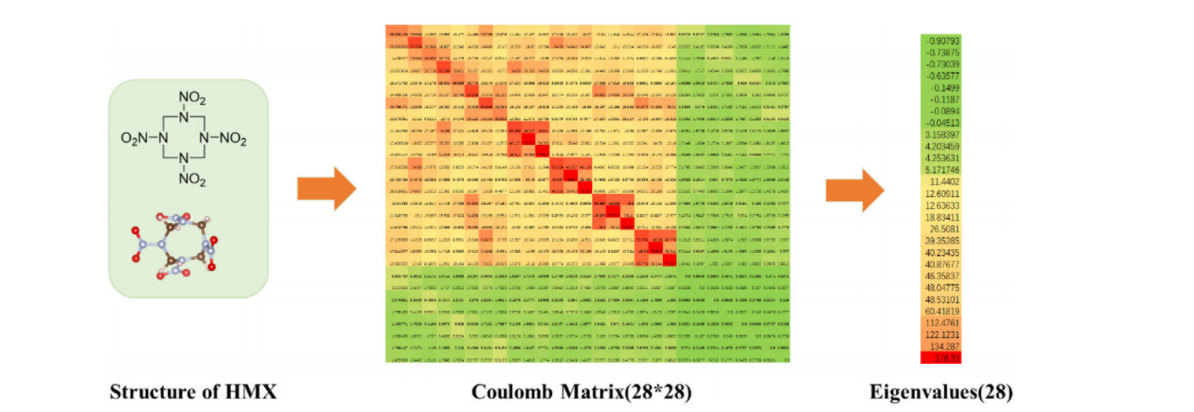
图3为HMX的库仑矩阵和对应的特征值,深绿色表示值越小,深红色表示值越大。每个参与分子的信息都以同样的方式转化。将设计的所有分子转换为包含分子库仑矩阵(436×64×64)、库仑矩阵分子本征值(436×64)和计算得到的三个爆轰性质张量(436×3)的新数据集,以库仑矩阵分子本征值(436×64)作为输入,以2.1节中计算得到的爆轰性质张量(436×3)作为机器学习的输出。
P3.png

图3 HMX的分子结构、库仑矩阵和本征值。(深绿色表示值较小,深红色表示值较大。)

2.3 神经网络

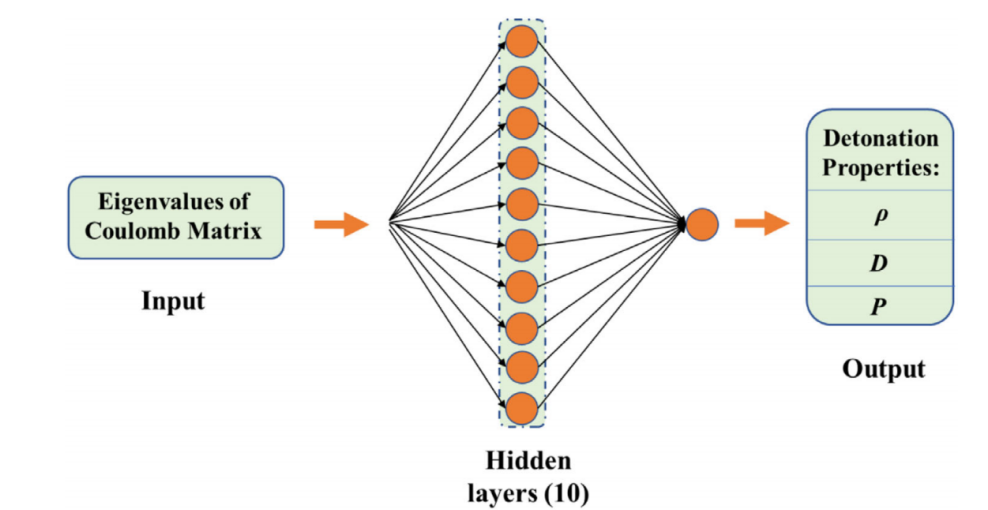
在这项工作中,采用神经网络来完成预测和筛选任务。构建了10个隐藏神经元和1个输出层的神经网络模型(图4)。数据库分为3部分,分别为训练组、验证组和测试组,比例分别为0.8:0.1:0.1。通过比较不同方法训练过程的准确率和速度,我们选择Levenberg-Marquardt (LM)算法,这需要更多的内存,但需要更少的时间。采用均方误差(MAE)作为损失函数和收敛准则。采用LM算法的程序会自动迭代,直到达到收敛准则。训练结束后,我们得到回归函数,绘制出每个属性的表现。未发现明显的欠拟合或过拟合。最后,利用回归函数计算了三种爆轰特性预测的线性相关系数(R)和平均绝对误差(MAE)。
P4.png

图4 神经网络模型的示意图

3、结果与讨论

3.1利用机器学习预测爆炸性质

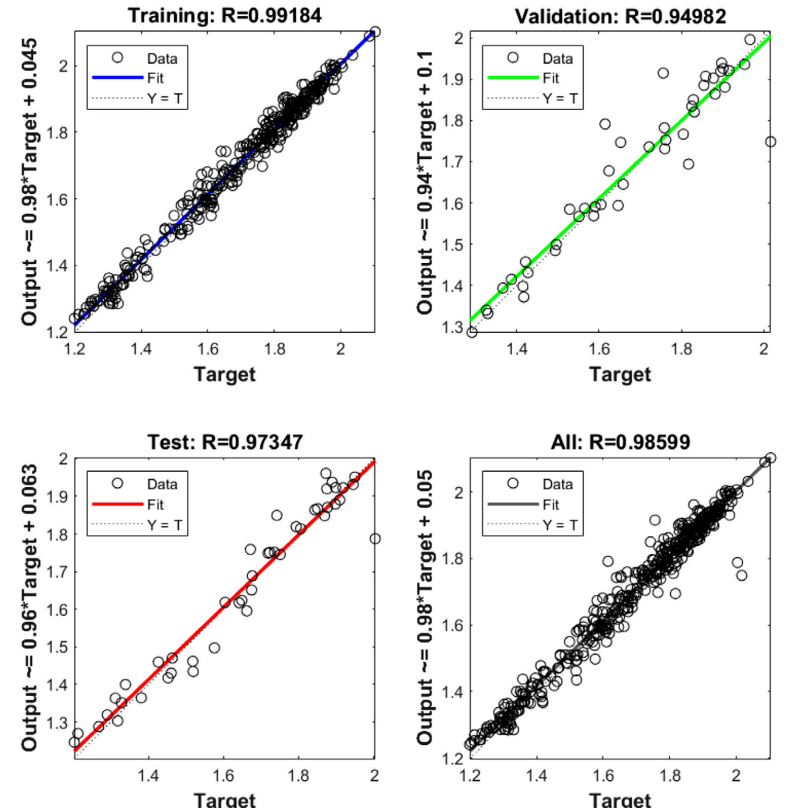
该神经网络由10个隐藏神经元和1个输出层组成,在自建的包含436个含N结构及其爆轰特性的数据库上进行训练。图5显示了密度(ρ)的拟合程度。当R趋于1时,数据点分布在对角线(y = x)附近,预测效果较好。拟合结果表明,所设计的神经网络对训练数据集、验证数据集和测试数据集的学习效果良好。
P5.png

图5 由神经网络通过训练、验证和测试预测的密度(ρ)(“目标”是目标值,“输出”是预测值。)

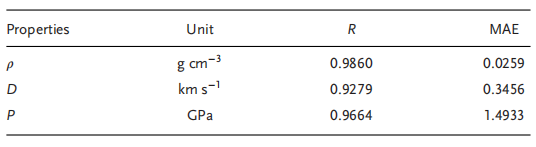
R和MAE预测ρ、D和P的值汇总在表2中。MAE对应ρ、D、P理想性能值的百分比(ρ≈1.9 g cm-3, d≈9.0 km s-1, P≈40.0GPa)分别为1.36%、3.84%、3.73%。预测误差得到了有效抑制。因此,所开发的神经网络足够准确和高效,可以直接根据给定的分子结构生成目标爆轰特性。

表2 使用神经网络预测爆轰特性的MAE值。
T2.png

3.2机器学习的扩展预测

对给定的新分子结构的大数据库进行扩展预测,可以实现对新能量分子的快速高通量筛选。在此之前,应在具有有限样本和属性数据的小型数据库上训练合适的神经网络。在此,通过在不同样本数的不同小型数据库上进行训练,开发了各种神经网络。然后,对所获得的神经网络进行评估,以扩展预测新含氮分子的爆轰特性。进一步研究了数据库样本数量对机器学习扩展预测精度的影响。

建立4个包含不同样本数(100、150、200、300)的小型数据库对神经网络进行训练。数据库中含N分子的类型选择相近。然后,将揭示数据库样本的数量对训练结果的影响。应变神经网络随后用于预测新分子的爆轰特性,形成一个大数据库(436个样本)。

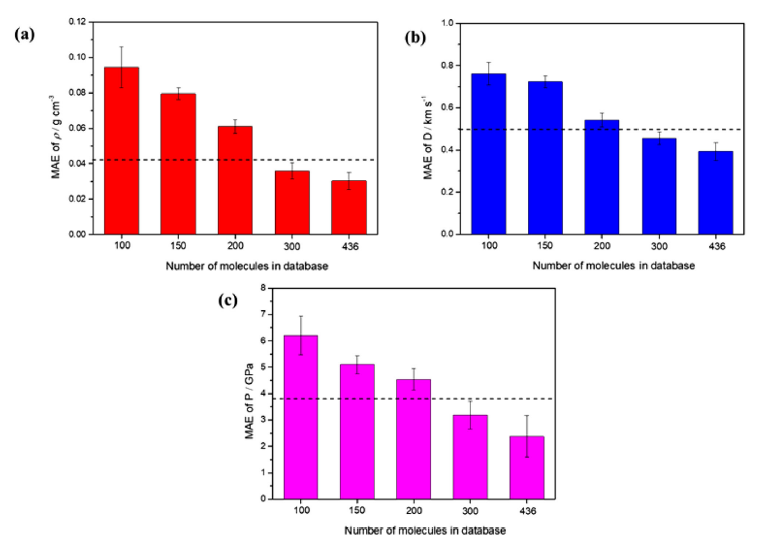
如图6所示,三种爆轰特性的MAEs均随着训练样本从100增加到436而减小,且呈现先快后慢的趋势。在300个样本上训练的神经网络预测ρ、D和P的MAEs分别为0.0359 g cm-3、0.4548 km s-1和3.1873 GPa,对应的标准差分别为0.0046 g cm -3、0.0296 km s -1和0.5271 GPa。用436个样本训练的神经网络预测ρ、D和P的MAEs分别为0.0303 ±0.0047 g cm-3、0.3929±0.0423 km s-1和2.3786±0.7888 GPa。通过比较MAEs及其标准差,300样本训练的神经网络的预测精度已经接近436样本训练的神经网络的预测精度。在选取的300个样本上训练的神经网络已经可以实现高精度的扩展预测。因此,我们在300个样本的小数据库上训练神经网络,在后续研究中通过扩展预测来快速筛选高能量化合物。
P6.png

图6 在不同的大小的数据库上训练的各种神经网络预测含N分子a) ρ、 b) D和 c) P的MAE值。

然后将所有含N分子的结构输入到在300个样本的小数据库上训练的开发好的神经网络中。利用循环代码计算了所有分子的三种爆炸特性。这个过程在个人计算机上只花费0.038秒(CPU i5-7, 8gb RAM)。机器学习可以在很短的时间内完成大量分子的性质预测任务。与2.1.2节所述的基于分子建模和理论计算的传统方法相比,机器学习方法的效率要高得多。

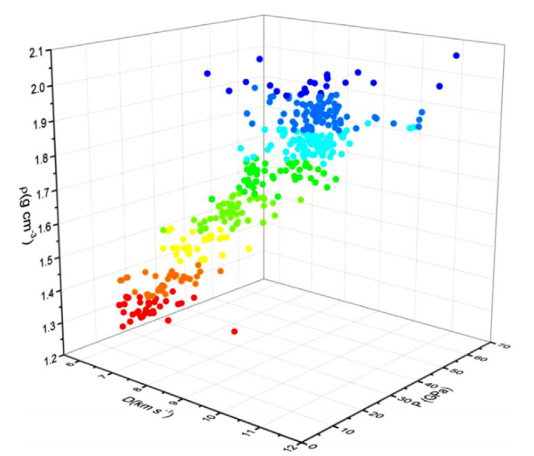
所开发的神经网络预测的所有数据都被可视化地显示在一个3D图中,如图7所示。深蓝色表示较大的密度值,深红色表示图中较小的密度值。在坐标系中远离原点的x、y、z三个坐标的数据点代表突出的爆轰特性。基于高效机器学习扩展预测建立的结构-性质数据库,可以轻松筛选具有突出爆轰性质的有趣分子。因此,发展起来的基于小型数据库的神经网络可以通过扩展预测建立许多大型数据库,并实现更多高能分子的高通量筛选。
P7.png

图7 300个样本的数据库上训练的神经网络预测的所有分子的D(x轴)、P(y轴)和ρ(z轴)。(深蓝色表示密度值较大,深红色表示密度值较小。)

3.3新的含能材料

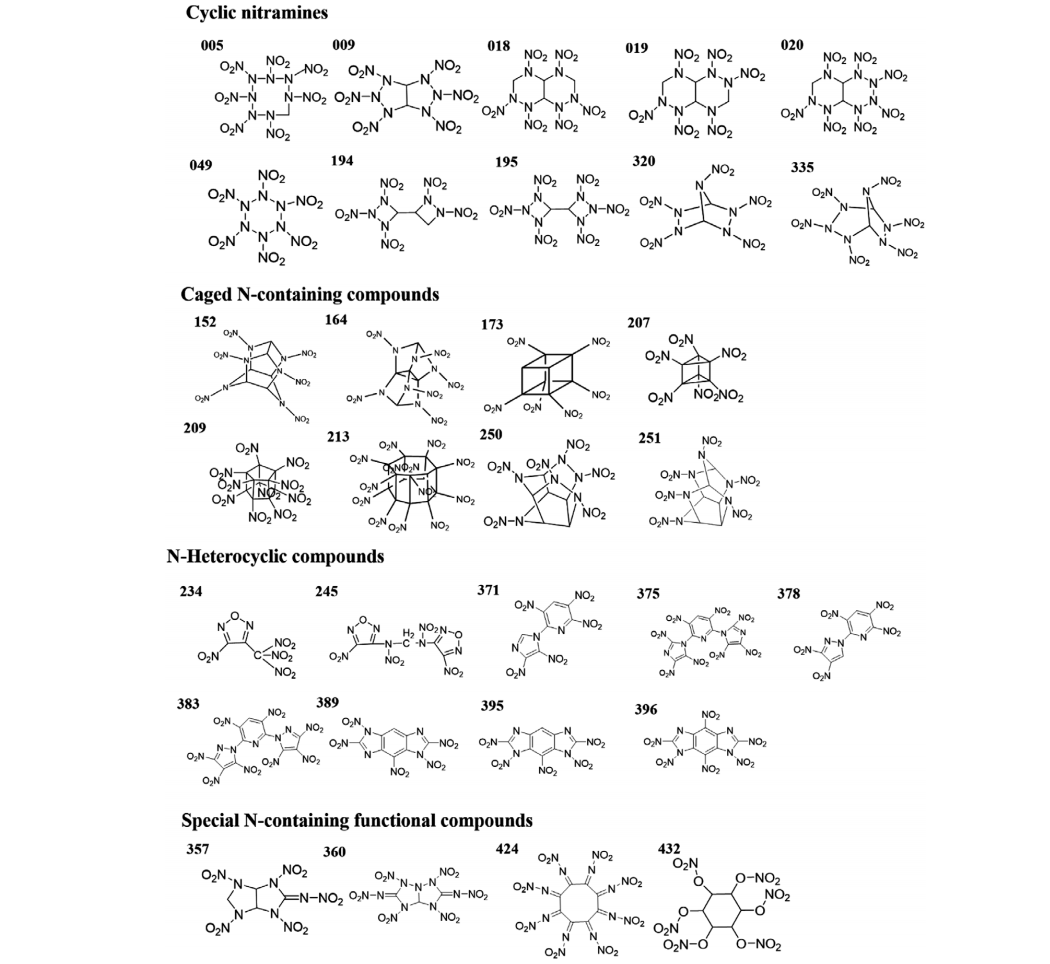
我们对数据库中的三个关键属性进行排名,筛选每个属性(ρ,D和P)的前10个分子。密度最高的前10个分子(ρ)是213、336、25、27、432、37、26、20、209和36。拥有最高爆速(D)的前10个分子分别是209、211、213、4 24、434、148、436、149、20和3。P分子排名前10位的是213、149、434、148、209、424、4、430、3和105。根据性质值的不同,分子数的排列顺序依次递减。具有最高密度、最高爆速或最高爆压的最佳分子各不相同。只有213号分子的三种性质都排在前十。为了发现更多潜在的高能分子,对数据库进行了另一种方式的进一步筛选。典型的高能量材料通常具有ρ≈1.9 g cm−3、D≈9.0km s−1和P≈40.0 GPa的爆轰特性。因此,筛查标准设置为ρ≥1.9g cm−3,D≥9.0km s−1,以及P ≥ 40.0 GPa.经过筛选,得到了31个符合标准的分子。其分子结构如图8所示。
P8.png

图8 筛选的31个含N分子的分子结构。

根据分子结构,这31个分子可分为四种类型。有10个分子具有环状硝基胺的结构,如图8的第一行和第二行所示。这些具有能量环的硝胺可以具有单环(005和049)、熔融环(009、018、019和020)、双环结构(194和195)或桥接环(320和335)。8种高能含N的化合物具有如图8的第三行和第四行所示的笼状结构。据推测,这些有趣的结构为设计和开发新型高能材料或提高现有炸药的性能提供了指导。

上述四种含氮分子的平均含氮质量百分比分别为43.03%、31.22%、32.57%和35.40%。所有31个分子的平均含氮质量比例为38.96%。我们假设一定的含氮质量比例是保证这些化合物具有良好爆轰性能的标准之一。

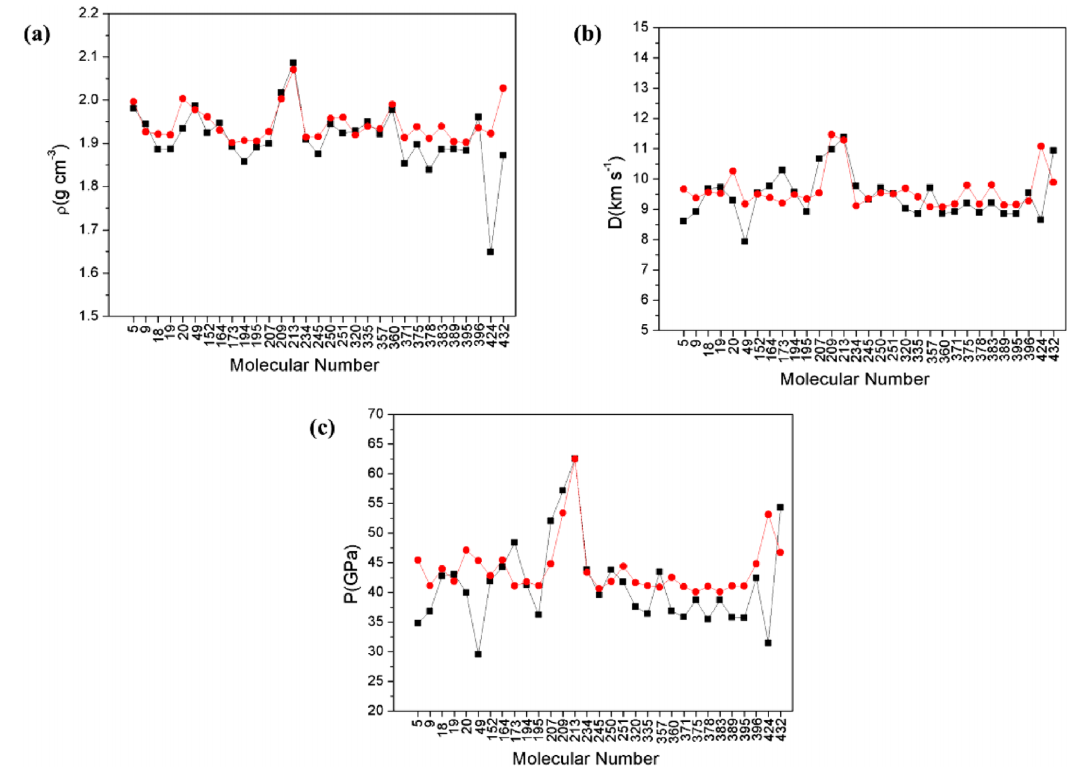
为了验证机器学习的预测并确认我们的筛选结果,我们比较了机器学习预测(红点)和理论方法计算的31个分子的ρ、D和P的值,如图9所示。用两种方法计算出的密度、爆轰速度和爆轰压力三种特性的变化趋势高度一致。计算了通过机器学习预测爆轰特性的MAEs,31个分子中的ρ、D和P分别为0.0394g cm−3、0.5386km s−1和4.666 GPa。
P9.png

图9 通过机器学习(红点)预测和通过理论方法计算(黑方块)的性质a)XX、 b) D和c)P。

相比之下,之前通过训练开发的其他不同容量的数据库(100、150、200和436)的神经网络也通过扩展预测建立了结构-性能的大数据库。在这些数据库中,同样的标准(ρ≥1.9g cm−3,D≥9.0km s−1,P ≥ 40.0 GPa)被用于筛选具有突出爆轰特性的新高能分子。得到不同的靶分子。
P10.png

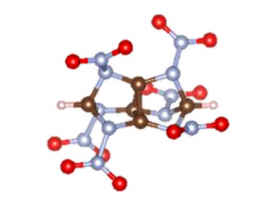
图10 优化后的No.164的分子结构

值得一提的是,在重组的31个分子中的No. 164分子是新的,这在以前的工作中没有报道过。优化后的No. 164分子结构如图10所示。它具有像CL-20这样的笼状结构,通过理论方法计算出的三种爆轰性能(ρ、D、P)均优于CL-20。No. 164的分子可能是新的含能材料的一个非常有竞争力的候选材料。我们目前正在探索这种有趣的含氮结构的合成,为验证我们的预测,并为下一代含能材料的发展开辟新的途径。除了爆轰速度和爆轰压力的特性外,还有一些重要的因素,还需要考虑动力学稳定性、化学安全性等因素。在未来,当这些相关属性的数据库建立起来时,这些属性可以基于机器学习快速预测。从这个角度来看,迫切需要更多的工作来通过机器学习发现新的潜在的能量材料。

4 结论

总之,机器学习已经被引入来准确预测新的含N能量分子的爆轰特性。通过建立合适的神经网络,有效地抑制了预测误差,ρ、D和P的MAEs分别为0.0259 g cm−3、0.3456 km s−1和1.4933 GPa。300个的训练数据库量足以在合理选择样本结构的基础上实现高精度的扩展预测。利用已开发的神经网络建立了一个大型结构性质数据库,筛选了31个高密度(ρ≥1.9 g cm−3)、高爆震速度(D≥9.0 km s−1)和高爆轰压力(P≥40.0 GPa)的分子。这一概念验证研究为发现有趣的含氮分子开辟了新的途径,有望加速下一代高能材料的发展。

参考文献:Advanced Theory and Simulations: Volume4, Issue6 June 2021 2100057.

自条件去噪(SCD)技术在原子尺度机器学习中的应用 自监督学习(SSL)是机器学习领域的重要范式,通过利用无标签数据学习通用表示,显著降低对标注数据的依赖。在原子尺度科学中,传统方法依赖昂贵的密度泛函理论(DFT)计算,而自条件去噪(SCD)技术通过创新的自嵌入机制,解决了现有节点去噪方法的局部性限制和向量嵌入压力不足等问题。SCD采用双重前向传递架构和自适应层归一化(AdaNorm),在分子性质预测、材料带隙计算和生物分子交互等场景展现出卓越性能。该技术特别适合计算资源有限但需要处理多尺度原子系统的场景,如材料基因组计划和药物发现,其轻量级架构(10M参数 阅读详情

相关推荐

前沿数据解析 | 麻省理工-斯坦福-丰田研究中心电池数据集:AI驱动下的固态电解质与寿命预测

本文解析了麻省理工-斯坦福-丰田研究中心发布的电池数据集,展示了AI在固态电解质设计和电池寿命预测中的革命性应用。该数据集通过生成式AI设计的分子结构和实测数据闭环,揭示了电解质性能与寿命的关键关联,为材料科学和电池技术提供了突破性工具。

weixin_30430169的博客 574

量子机器学习的优势

量子机器学习的核心优势在于利用量子态叠加与纠缠,解决经典计算中的维度灾难和组合爆炸问题。其在量子系统模拟、高维优化、隐藏模式发现等领域具有不可替代性,但实际应用仍需等待硬件突破和算法优化。随着量子纠错技术与混合量子-经典框架的发展,未来十年有望在药物研发、材料科学和金融建模等领域实现实用化突破。

神棍之路 775

量子机器学习原理与代码实战案例讲解

量子机器学习原理与代码实战案例讲解 作者:禅与计算机程序设计艺术 / Zen and the Art of Computer Programming 关键词:量子机器学习, QML, 量子计算, 量子算法, 机器学习, Python编程, TensorFlow Quantum库

AI天才研究院 1584

机器学习加速分子动力学模拟:物理约束代理模型在纳米颗粒合成中的应用

在计算材料科学领域,分子动力学模拟是研究原子尺度反应机理的核心技术,但其巨大的计算成本限制了参数空间的全面探索。代理模型作为一种高效的替代方案,通过学习有限模拟数据来预测未知条件的结果,从而显著加速研究进程。其技术价值在于将物理原理(如对称性)编码到机器学习流程中,通过定制特征工程、模型架构和损失函数,构建出既高效又可靠的预测工具。这种方法在材料设计、化学反应预测等场景中具有广泛应用前景。本文聚焦于利用置换不变性和二项负对数似然损失,构建预测硅纳米颗粒在非热等离子体中粘附系数的代理模型,有效降低了模拟数据需

weixin_30613433的博客 247

【信息科学与工程学】信息科学领域---第二篇 材料工程15 材料参数09

E_a,cryst 越大,非晶态越稳定,数据保持力越好,但写入所需的能量也可能更高。分析材料电子结构的基本工具,可从中解读电学、光学、磁性等性质,并识别特定原子/轨道对费米能级附近态的贡献。用于判断模型是欠拟合(随样本增加,性能持续提升)还是过拟合(性能很快饱和),并评估收集更多数据的必要性。可判断晶格动力学稳定性(无虚频),计算声子态密度、热力学性质(如自由能、热容),并预测可能的结构相变。可以探测电子的集体激发(如等离激元)的色散关系 ω(q),是研究材料电子激发和等离激元物理的有力工具。

weixin_49199313的博客 495

COSMO-RS理论:流体相热力学预测的核心模型与技术突破

摘要:COSMO-RS模型通过量子化学计算分子表面电荷分布,实现了从微观量子尺度到宏观化工过程的热力学预测。该模型基于介电连续介质理论,将分子表面片段化处理,通过σ-剖面描述电荷分布,并计算片段间的静电失配能和氢键能。其核心算法通过自洽化学势方程求解活度系数,克服了传统模型依赖实验参数的局限。随着技术进步,模型引入了高阶描述符和色散力修正,提升了预测精度。在药物研发、化工分离等领域广泛应用,但仍存在对长程有序结构预测不足等局限性。该模型为复杂体系的热力学性质预测提供了重要理论工具。

ASKCOS博客 975

数据科学驱动的量子计算落地实践:半导体、高分子与药物发现

量子计算并非替代经典超算,而是针对薛定谔方程求解、高维构象采样、自由能差计算等天然具备量子特性的科学问题提供指数级加速潜力。其真正价值在NISQ时代体现为‘关键瓶颈专用加速’,但受限于比特数、噪声与退相干,必须依赖数据科学完成降维预筛、误差代理建模与电路编译优化。这种‘量子+数据’融合范式,已在半导体新材料筛选、高分子结构-性能关联建模、药物靶点结合路径规划三大领域实现可复现的工程化突破——例如GNN预筛压缩97%量子任务量,VQE+贝叶斯优化将自由能计算帧数降低94%。本文聚焦可部署、可验证、可复现的混合

weixin_34354945的博客 299

DeepChem化学信息学Python工具包实战下载与应用

PyPI(Python Package Index)是Python官方的第三方库仓库,集中存储了超过40万个可安装的软件包,支持通过pip工具进行依赖管理和自动化安装。在科学计算与机器学习领域,PyPI成为开发者分发和获取工具的核心枢纽,尤其对于DeepChem这类跨学科库而言,PyPI提供了稳定版本(如)与开发预览版()的并行发布机制,便于研究者快速集成最新功能。# 安装稳定版DeepChem# 安装开发版本(需启用pre-release)

weixin_35903223的博客 863

突破性AI电解液设计:Bamboo-mixer如何将材料研发周期缩短80%

Bamboo-mixer是字节跳动Seed团队发布的开源AI电解液设计平台,通过预测与生成双引擎架构,为电池材料研发决策者提供革命性解决方案。该项目将传统电解液配方筛选从18个月压缩至45天,实验验证成功率提升3倍,为固态电池产业化提供关键技术支撑。 ## 问题:材料研发的效率瓶颈与成本挑战 当前新能源电池行业面临的核心困境是材料研发的"试错困局"。传统电解液开发依赖人工经验与实验迭代,存在三

gitblog_00478的博客 372

C语言 100道经典编程题适用于专升本,专接本【详细分析版】_c语言专升本题目

/法2//left指向起始 right指向数组末尾= 0){left++;//如果*left是奇数就循环接着向后指,直到指向偶数就退出//(left

2401_84978503的博客 695

001-基础入门-Web演示源码&资源&工具箱等

小迪安全2023笔记

wushangyu32335的博客 4265

突破性AI材料设计系统Bamboo-mixer:架构深度解析与工业应用验证

Bamboo-mixer是字节跳动Seed团队研发的突破性AI材料设计系统,通过统一预测与生成架构将电解液研发周期缩短80%,为固态电池产业化提供关键技术支撑。该系统创新性地融合了物理信息与深度学习,实现了从分子筛选到配方优化的智能设计闭环。 ## 技术背景:材料研发的效率瓶颈与AI破局 当前新能源材料研发面临三重核心挑战: 1. **组合爆炸问题**:传统试错法需测试上万种配方组合,仅三元

gitblog_01175的博客 324

父子Agent架构:解决AI系统上下文污染的技术方案

在AI系统设计中,上下文管理是核心挑战之一。传统单Agent架构在处理复杂任务时,常面临上下文无限膨胀导致的信息淹没和性能下降问题。父子Agent架构通过职责分离和上下文隔离机制,采用分而治之的思想,将大任务拆解为多个子任务由专门子Agent处理。该架构中父Agent负责任务规划和结果汇总,子Agent执行具体任务后立即销毁中间状态,通过精炼摘要进行通信。这种设计不仅能有效控制上下文长度,还能提升系统稳定性和执行效率,特别适用于编程辅助、自动化测试等需要多步骤处理的场景。父子Agent架构体现了计算机科学中

weixin_42531710的博客 353

三维团簇能量预测:从特征工程到机器学习建模实战

在计算材料学和数据科学领域,回归预测是连接微观结构与宏观性质的核心技术。其基本原理是通过数学模型学习已知数据中的特征与目标变量之间的映射关系,从而对未知样本进行推断。这项技术的核心价值在于能够绕过昂贵的第一性原理计算,实现快速、低成本的材料性质预测,极大地加速了新材料的研发进程。在材料设计、催化剂筛选和纳米技术等应用场景中,基于结构描述符的机器学习模型已成为重要工具。本文以三维团簇结合能预测为例,深入剖析特征工程与模型选择的关键环节,特别探讨了如何通过距离矩阵、统计量等几何特征构建有效的描述符,并对比了从多

weixin_34239592的博客 332

CANoe实战:手把手教你用J1939.dbc发送超8字节长帧报文(附完整CAPL代码)

本文详细解析了使用CANoe和J1939.dbc实现超8字节长帧报文的分包发送技术,提供完整的CAPL代码实现与优化策略。内容涵盖J1939.dbc配置、分包发送模块设计、接收端处理逻辑,并与ISO 15765-2协议进行深度对比,帮助开发者构建高效可靠的商用车通信解决方案。

weixin_29169899的博客 394

解决VNC Viewer连接Ubuntu桌面异常:从灰屏到完整菜单栏的实战指南

本文详细解析了使用VNC Viewer连接Ubuntu桌面时出现灰屏或菜单栏缺失的常见原因及解决方案。从桌面环境冲突到配置文件错误,提供了彻底清理系统残留配置、重新安装纯净桌面环境、优化xstartup文件配置等实战步骤,帮助用户快速恢复完整的远程桌面体验。

weixin_30892037的博客 83

基于SchNet的轻量化MBD力机器学习代理模型开发与应用

分子动力学模拟是研究材料与生物大分子性质的核心计算工具,其精度高度依赖于对原子间相互作用力的准确描述。范德华力作为一种关键的非键合相互作用,传统上采用成对势模型近似,但忽略了其本质上的量子多体效应。多体色散方法虽能更精确地描述这一物理图像,但其O(N^3)的计算复杂度使其难以应用于大规模体系。机器学习力场为解决这一“精度-效率”矛盾提供了新范式,通过训练神经网络代理模型来快速预测原子间作用力。本文聚焦于开发一个专门针对聚合物熔体体系中MBD相互作用力的高效代理模型。我们以SchNet架构为起点,通过连接剪枝

weixin_30383279的博客 723

注册电气工程师详细教材

注册电气工程师详细教材

qq_40844444的博客 4258

机器学习势函数加速电化学界面有限场模拟:原理与实践

在计算材料科学领域,密度泛函理论(DFT)是研究材料电子结构和性质的基础方法,但其高昂的计算成本限制了其在复杂体系和大尺度模拟中的应用。机器学习势函数(MLP)通过数据驱动的方式,学习DFT计算产生的构型-能量-受力映射关系,构建出高精度、高效率的替代模型,从而架起了第一性原理精度与分子动力学效率之间的桥梁。这一技术革新为电化学、催化等领域的原子尺度模拟带来了巨大价值,使得在保持量子力学精度的前提下,对电极-电解质界面等带电体系进行长时间、大尺度的有限场分子动力学模拟成为可能。本文聚焦于如何将机器学习势函数

weixin_34327761的博客 398

【R-terra包|第一节】- 栅格相关性、散点图 、波段的计算与异常值处理

提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档 文章目录前言一、pandas是什么?二、使用步骤1.引入库2.读入数据总结 —```mermaid flowchat st=>start: 开始 e=>end: 结束 op=>operation: 我的操作 cond=>condition: 确认? st->op->cond cond(yes)->e cond(no)->op 前言 提示:这里可以添加本文要记录的大概内容: 例如:随着人工智能.

地理空间科学的博客 5615

【C2000系列DSP的双向DC-DC电源】基于TMS320F28034的DC-DC项目开发流程

理解DC-DC 双向电源(基于 TMS320F28034)的开发流程,需要从功能拆解、开发步骤、验证 / 测试项

昔时扬尘处 324

ATOM框架:基于树搜索与智能体协同的分子多目标优化

多目标优化是解决药物发现、材料设计等领域中多个性能指标相互冲突问题的核心技术。其原理在于通过算法同时优化多个目标函数,寻找帕累托最优解集,而非单一最优解。这一技术价值在于能够系统性地探索复杂设计空间,平衡如活性、可合成性、毒性等关键属性,避免传统单目标优化导致的性能失衡。在工程实践中,智能体与树形搜索的结合为多目标优化提供了可解释、可干预的实现路径。智能体作为特定目标的引导器,在共享的树结构上进行协同探索,通过路径协同机制整合不同优化方向。这种架构特别适合化学空间这类离散、组合爆炸的搜索场景,能够将抽象的优

weixin_34248023的博客 439

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

第七篇 量子模拟民用场景:金融、新材料、生物医药全域低成本落地应用

前文已完成量子本源理论、稀疏量子算法、民用量子机器学习、轻量化量子纠错、量子与经典算力融合架构的系统性搭建,形成完备的民用量子算力理论体系。在理论架构、算法模型、容错机制、算力协同全部实现自洽闭环后,本章将完成理论体系向民用应用层的落地延伸。当前国内外量子模拟技术普遍依托低温量子硬件、超算集群、大型实验室环境开展研发,技术门槛高、部署成本昂贵、民用渗透难度极大。行业普遍存在认知固化,认为高端模拟场景仅可依靠国家级算力平台实现,民间硬件不具备复杂系统仿真能力。

A1651548128的博客 248

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Bamboo-mixer:AI驱动的电解液配方设计范式转换,重构固态电池研发路径

在固态电池产业化冲刺的关键窗口期,电解液材料研发正面临前所未有的效率瓶颈。传统试错法需在超过10¹²种可能的配方组合中进行海量筛选,单次实验成本高达2000元,而行业领先企业的研发周期仍长达18-24个月。字节跳动Seed团队推出的Bamboo-mixer大模型,通过"预测+生成"双引擎架构,将这一过程压缩至45天内完成,实验验证成功率提升300%,为固态电池商业化提供了关键技术支撑。这一突破不仅

gitblog_01101的博客 499

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

机器学习势函数:从SNAP到Allegro,如何以DFT精度驱动原子模拟

在计算材料科学领域,原子间势函数是连接微观相互作用与宏观材料性能的核心。传统经验势基于预设物理公式,计算高效但精度有限,尤其在描述键断裂、相变等非平衡过程时面临挑战。其原理在于对原子间作用力进行参数化近似,虽能快速预测平衡态性质,却难以准确捕捉复杂缺陷与极端变形下的能量路径。机器学习势函数的技术价值在于,通过数据驱动方式,直接从高精度第一性原理计算数据中学习原子间相互作用的复杂映射关系,实现了接近密度泛函理论(DFT)的精度与接近经典势函数的计算效率。这种融合了物理对称性约束与神经网络表示学习的方法,在材料

weixin_33701564的博客 636
上一篇: 医药研发工时管理难题破解:科学数据基因组在医药研发项目工时管理中的应用
下一篇: 分子生成模型新发展:根据蛋白配体间相互作用构建分子生成模型
Lab_AI4S
博客等级 码龄1年 8粉丝 148原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值