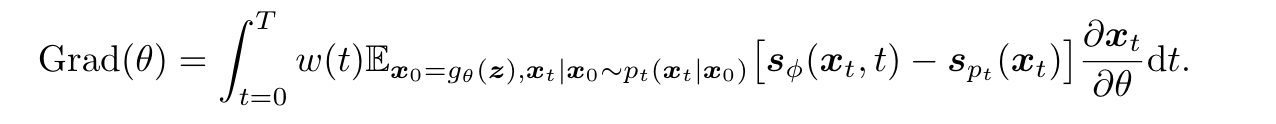SDXS:Real-Time One-Step Latent Diffusion Models with Image Conditions

Diff-Instruct:指导任意生成模型训练的通用框架,无需额外训练数据即可提升生成质量 Diff-Instruct 是一种从预训练扩散模型中迁移知识的通用框架,通过最小化积分Kullback-Leibler散度,指导其他生成模型的训练,提升生成性能。 阅读详情

SDXS: Real-Time One-Step Latent Diffusion Models with Image Conditions

sign: 2024-4-28 💡
在看这个文章之前,首先要对 consistency model ,score-based model要有一定了解,以及相应的知识蒸馏,怎样去做单步生成的等等

扩散模型由于其迭代采样过程而导致显著的延迟。为了减轻这些限制,作者引入了一种双重方法,包括 模型小型化 和 减少采样步骤 ,旨在显著降低模型延迟。还是利用知识蒸馏来简化U-Net和图像解码器架构,并引入了一种利用特征匹配和分数蒸馏的创新的单步DM训练技术。

作者提出了两种模型,SDXS-512和SDXS-1024,分别在单个GPU上实现了大约100 FPS(比SD v1.5快30倍)和30 FPS(比SDXL快60倍)的推理速度。此外,我们的训练方法在图像条件控制中提供了有前途的应用,促进了有效的图像到图像的翻译。
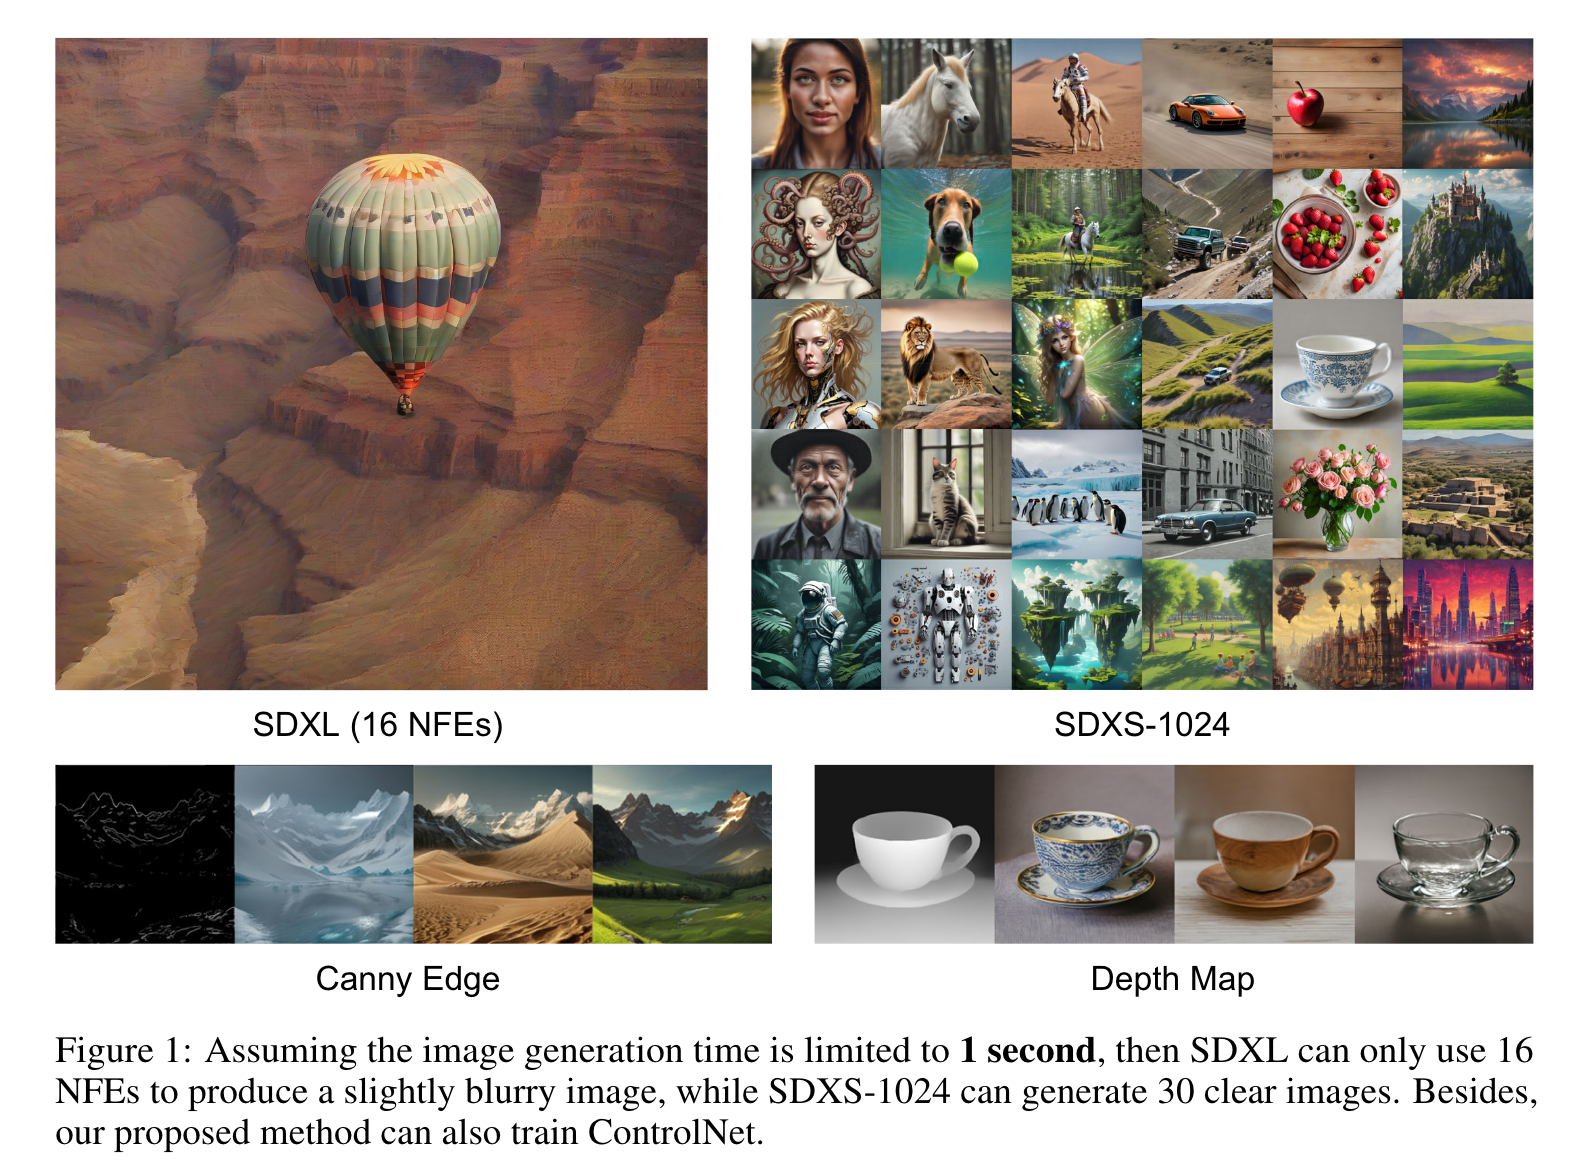
alt text

1. Introduction

这是一篇小米的工作,实时进行图像到图像的生成。因为是要更多考虑手机的部署,所以要潜在解决的就是模型的大规模和多步骤采样的问题。

首先介绍一下什么是 NFE,即 Number of Function Evaluations,模型评估次数。

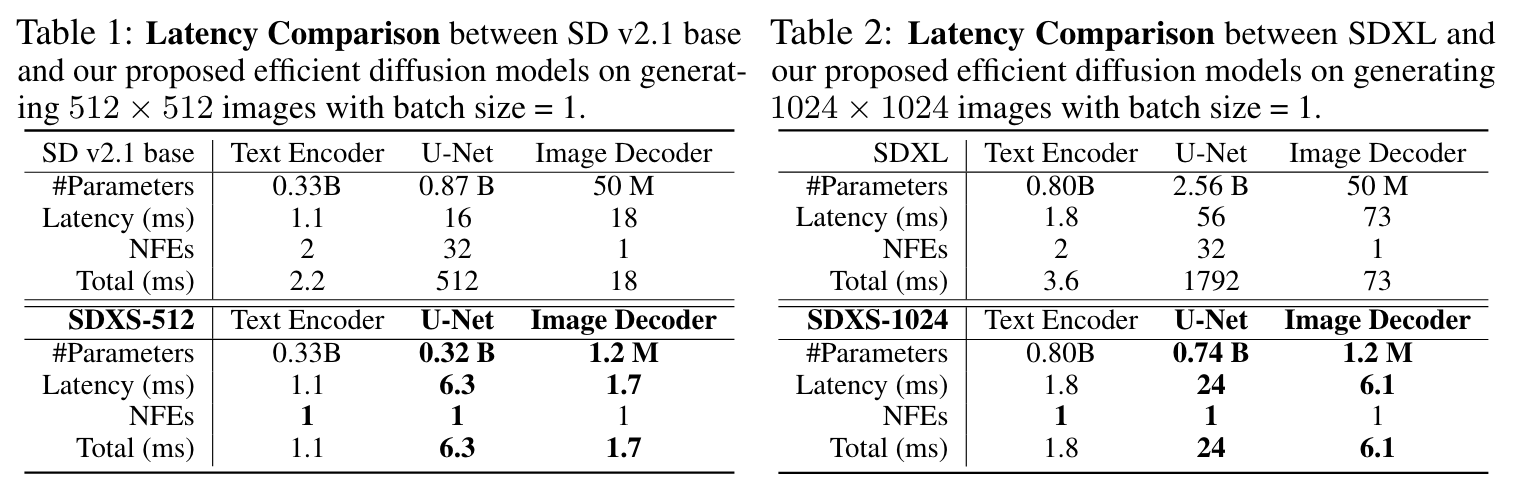
对于常见的文生图模型,成本可以近似地计算为总延迟,其中包括文本编码器、图像解码器和去噪模型的延迟,乘以函数评估次数(NFEs)。

这里是直观的一个对比:
alt text

本文主要考虑减小 VAE解码器 和 UNet 的规模,两者都是资源密集型组件。作者还是通过蒸馏的 Loss 和 GAN Loss 来轻量化。

🤔这应该是和 stability 的那个 Turbo,UFO-Gen 的原理差不多

另外,为了减少 NFEs, 作者提出了一个快速和稳定的训练方法:

  • 首先,我们建议通过将蒸馏损失函数替换为所提出的特征匹配损失函数,调整采样轨迹并将多步模型快速微调为一步模型。
  • 然后,拓展了 Diff-Instruct 训练策略,利用特征匹配损失的梯度取代分数蒸馏在时间步长的后半部分提供的梯度。

💡 从预训练的扩散模型进行知识蒸馏(分数蒸馏) 都是 来自于 DreamFusion 这篇工作,感兴趣可以看看。
Diff-instruct: A universal approach for transferring knowledge from pre-trained diffusion models.

2. Preliiminaries

Score-based Model

所使用的损失函数的核心是分数匹配(SM)损失,其目的是使模型估计的分数与数据的真实分数之间的差异最小化:
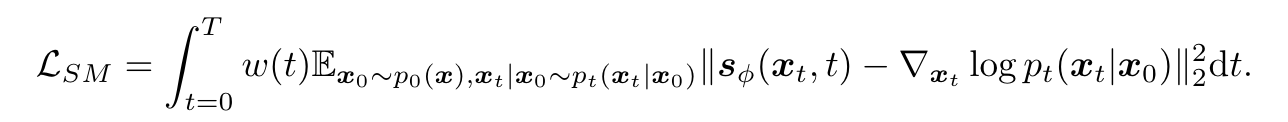
alt text

Diff-Instruct

Diff-Instruct 通过 Integral Kullback-Leibler (IKL)散度,将分数蒸馏引入到图像的生成过程,扩散模型其实实在拟合 p , q p, q p,q两个分布之间的差异。这里我们可以定义优化目标为:
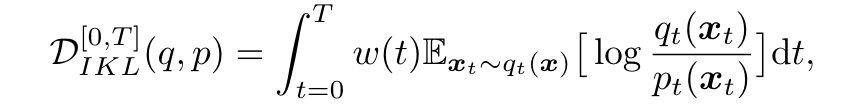
alt text

其中 q t q_t qt​ 和 p t p_t pt​ 代表 t t t 时刻扩散过程的边缘概率密度, q 0 q_0 q0​ 和 p 0 p_0 p0​ 之间的 IKL 梯度可以表示为:

alt text

其中 x 0 = g θ ( z ) \boldsymbol{x}_0=g_\theta(\boldsymbol{z}) x0​=gθ​(z) 表示随机采样的高斯噪声 z z z 通过单步生成的 x 0 x_0 x0​. s ϕ \boldsymbol{s}_\phi sϕ​ 和 s p t s_{p_t} spt​​ 分别表示在线训练 Diffusion Model 和预训练 Diffusion Model的分数函数。

Diff-Instruct 直接使用这个梯度来更新模型,当两个分数函数的输出一致时,单步步生成器输出的边缘分布与预训练DM的边缘分布一致。

3. Method

alt text

Architecture Optimization

VAE Decoder Distillation

原始的 VAE是通过平衡三种损失来优化的:重建、Kullback-Leibler (KL)散度和GAN损失。然而,在训练过程中平等地对待所有样本会引入冗余。利用预训练的扩散模型 F F F 对隐编码 z z z 进行采样,并利用预训练的VAE解码器对图像 x ~ \tilde{\boldsymbol{x}} x~ 进行重构,我们引入了VAE蒸馏(VD)损失来训练一个微小的图像解码器G:

alt text

D D D 是 GAN 的判别器, λ G A N \lambda_{GAN} λGAN​ 用来平衡两个损失项, ∥ G ( z ) ↓ 8 × − x ~ ↓ 8 × ∥ 1 \|G(\boldsymbol{z})_{\downarrow8\times}-\tilde{\boldsymbol{x}}_{\downarrow8\times}\|_1 ∥G(z)↓8×​−x~↓8×​∥1​ 通过 8x 下采样的图像计算的 L1 损失来保持图像的细节。

UNet Distillation

受启发于 BK-sdm 的知识蒸馏策略,即有选择性地从U-Net中去除残余和Transformer块,旨在训练一个更紧凑的模型,该模型仍然可以有效地再现原始模型的中间特征映射和输出。图2 (b)说明了提取微小U-Net的训练策略。知识蒸馏通过输出知识蒸馏(OKD)和特征知识蒸馏(FKD)损失实现:

alt text

总体损失是两个损失函数的结合:

alt text

ControlNet

这里提一下 ControlNet。 ControlNet通过在现有的文本到图像框架中嵌入空间引导来增强扩散模型,从而实现图像到图像的任务,如素描到图像的翻译、绘画和超分辨率。它复制了U-Net的编码器架构和参数,增加了额外的卷积层来整合空间控制。尽管继承了U-Net的参数并使用零卷积来增强训练稳定性,ControlNet的训练过程仍然昂贵,并且受到数据集质量的显著影响。

为了解决这些挑战,我们提出了一种蒸馏方法,将原始U-Net的控制网提炼成相应的微型U-Net的控制网。如图2 (b)所示,我们不是直接提取ControlNet的零卷积输出,而是将ControlNet与U-Net结合起来,然后提取U-Net的中间特征映射和输出,这使得蒸馏后的ControlNet和微小的U-Net能够更好地协同工作。考虑到ControlNet不影响U-Net编码器的特征映射,特征蒸馏只应用于U-Net的解码器

One-Step Training

虽然dm在图像生成方面表现出色,但即使使用先进的采样器,它们对多个采样步骤的依赖也会带来显著的推理延迟为了解决这个问题,之前的研究引入了知识蒸馏技术,如渐进式蒸馏和一致性蒸馏,旨在减少采样步骤并加速推理。然而,这些方法通常只能通过4 ~ 8个采样步骤产生清晰的图像,这与GAN中的一步生成过程形成鲜明对比。

探索将GAN整合到DM训练体系中已经显示出增强图像质量的希望。然而,GAN也有自己的挑战,包括对超参数的敏感性和训练不稳定性。对于一步生成模型,有必要寻求一种更稳定的训练策略。

Feature Matching Warmup

通常做法是是训练一个单步模型,即:初始采样一个噪声 ϵ \epsilon ϵ,然后使用常微分方程求解器 ψ \psi ψ 来进行采样最终得到生成图像 x ^ 0 \boldsymbol{\hat{x}}_{0} x^0​。

然而,这种方法经常导致产生低质量的图像。潜在的问题是使用来自预训练DM的ODE采样器生成的噪声图像对的采样轨迹中的交叉,导致不适定问题。整流通过调整采样轨迹解决了这一挑战。它取代了训练目标,并提出了一个“回流”策略来完善配对从而最小化轨迹交叉。相反,我们注意到采样轨迹的交叉会导致一个噪声输入对应于多个真地图像,导致训练模型生成的图像是多个可行输出的加权和,权重为 w ( y ) w(y) w(y):

alt text

对于最常用的均方误差(mean square error, MSE)损失,该模型在包含多个可行目标的情况下,倾向于输出多个可行解的平均值,以使整体误差最小化,从而导致生成的图像模糊。 为了解决这个问题,我们探索了替代损失函数,改变加权方案,优先考虑更清晰的图像。在大多数情况下,我们可以使用L1损失、感知损失和LPIPS损失来改变权重的形式。我们建立在特征匹配方法的基础上,该方法涉及计算编码器模型生成的中间特征映射上的损失。具体来说,我们从dist损失中获得灵感,在这些特征映射上应用结构相似指数(SSIM),以获得更精细的特征匹配损失:

alt text

其中 w l w_l wl​ 是 SSIM 损失的权重,通过编码器 f θ \boldsymbol{f_\theta} fθ​ 编码的第 l-th 中间特征上计算得到的 SSIM 损失, x θ ( ϵ ) \boldsymbol{x_\theta(\epsilon)} xθ​(ϵ) 是由微型的 U-Net x θ \boldsymbol{x_\theta} xθ​ 生成的图像, ψ ( x ϕ ( ϵ ) ) \boldsymbol{\psi(x_\phi(\epsilon))} ψ(xϕ​(ϵ)) 是由原始的 U-Net x ϕ \boldsymbol{x_\phi} xϕ​ 用ODE采样器 ψ \boldsymbol{\psi} ψ 生成的图像。在实践中,我们发现使用预训练的CNN骨干网、ViT骨干网和DM U-Net编码器都能获得良好的效果,与MSE损失的对比如图6所示。此外,我们还利用现有的微调方法(如LCM)拉直模型的轨迹以缩小可行输出的范围,或者直接使用公开可用的少步模型。我们将单独使用 L F M L_{FM} LFM​来训练一步模型作为热身,只依赖少量的训练步骤。

Segmented Score Distillation.

虽然特征匹配损失可以产生几乎清晰的图像,但不能达到真正的分布匹配,所以训练好的模型只能作为正式训练的初始化。为了解决这一差距,我们详细阐述了diffi - directive中使用的训练策略,该策略旨在通过匹配时间步长的边际分数函数,使模型的输出分布与预训练模型的输出分布更接近。然而,由于需要在 t → T t \to T t→T处加入高水平的噪声才能计算目标分数,因此此时估计的分数函数是不准确的。我们注意到扩散模型的采样轨迹从粗到细,这意味着 t → t t \to t t→t,分数函数提供低频信息的梯度,而 t → 0 t \to 0 t→0,它提供高频信息的梯度。因此,将时间步长分为 [ 0 , α T ] [0, \alpha T] [0,αT] 和 ( α T , T ] (\alpha T, T] (αT,T]两段,后者用 L F M L_{FM} LFM​ 代替,因为它能提供足够的低频梯度。这一策略可以正式表示为:

alt text

λ F M \lambda_{FM} λFM​ 用于平衡两段的梯度, α ∈ [ 0 , 1 ] \alpha \in [0, 1] α∈[0,1]。我们有意将 α \alpha α 设置为接近1, λ F M \lambda_{FM} λFM​ 设置为较高值,以确保模型的输出分布平滑地与预训练分数函数预测的分布对齐。在概率密度达到显著重叠后,我们逐渐降低 α \alpha α 和 λ F M \lambda_{FM} λFM​。图3直观地描述了我们的训练策略,其中离线DM表示预训练DM的U-Net,在线DM从离线DM初始化,并通过Eq.(1)对生成的图像进行微调。在实践中,在线DM和学生DM交替训练,如算法1所示。

alt text

LoRA

alt text

一旦训练了一步DM,就可以像其他DM一样对其进行微调,以调整生成图像的样式。我们将LoRA与提出的分段分数蒸馏(Segmented Score Distillation)结合起来,对一步DM进行微调,如图4所示。

具体来说,我们将预训练的LoRA插入到离线DM中,如果它也与教师DM兼容,它也被插入到离线DM中。值得注意的是,我们没有将LoRA插入到在线DM中,因为它对应于一步DM的输出分布。然后,我们使用与一步训练相同的训练过程,但跳过特征匹配预热,因为LoRA微调比完全微调稳定得多。此外,当Teacher DM不能包含预训练的LoRA时,我们使用简化的λF M。通过这种方式,可以将预训练的LoRA提取到SDXS的LoRA中。

ControlNet

我们的方法也可以用于训练ControlNet,使微小的一步模型能够将图像条件合并到其图像生成过程中,如图5所示。与文本到图像生成的基本模型相比,这里训练的模型是蒸馏的ControlNet,伴随着前面提到的微小的U-Net, U-Net的参数在训练过程中是固定的。重要的是,我们需要从教师模型采样的图像中提取控制图像,而不是从数据集图像中提取,以确保噪声、目标图像和控制图像形成配对三元组。此外,原始的多步U-Net附带的预训练控制网与在线U-Net和离线U-Net集成,但不参与培训。与文本编码器类似,该函数仅限于作为预训练的特征提取器。这样,为了进一步降低L,训练后的ControlNet就是学习利用从目标图像中提取的控制图像。同时,分数蒸馏鼓励模型匹配边缘分布,增强生成图像的上下文相关性。值得注意的是,我们发现用新初始化的噪声替换U-Net的一部分噪声输入可以增强控制能力。

alt text

4. Experiments

实现细节。我们的代码是基于diffusers库开发的。由于我们无法访问SD v2.1 base和SDXL的训练数据集,因此整个训练过程几乎是无数据的,仅依赖于可公开访问的数据集中的提示(Laion-5B)。必要时,我们使用开源预训练模型与这些提示相结合来生成相应的图像。为了训练我们的模型,我们将训练小批大小配置为1024到2048。为了在可用硬件上容纳这个批处理大小,我们在必要时战略性地实现梯度累积。值得注意的是,我们发现所提出的训练策略导致模型生成的图像纹理较少。因此,在训练之后,**我们利用GAN损失和极低秩的LoRA进行短时间的微调。**当需要GAN损失时,我们使用StyleGAN-T中的投影GAN损失,基本设置与ADD一致。对于SDXS-1024的训练,我们使用SDXL的精简版Vega作为在线DM和离线DM的初始化,以减少训练开销。

alt text

alt text

alt text

alt text

5. Conclusion

本文探讨了基于大规模扩散的文本到图像生成模型的升华,使其能够在gpu上进行实时推理。首先,我们使用知识蒸馏来压缩U-Net架构和图像解码器。随后,我们引入了一种新的训练策略,利用特征匹配和分数蒸馏将采样过程减少到一步。这种方法允许在单个GPU上实时生成1024×1024图像,保持与原始模型相当的质量。此外,我们提出的训练方法也可以适应涉及图像条件生成的任务,避免了预训练的ControlNet的直接适应。我们相信,在边缘设备上部署高效的图像条件生成代表了未来研究的一个有希望的途径,并计划探索其他应用,如喷漆和超分辨率。


【PowerHarmony】电鸿蒙学习记录-准备工作 将获取的“PowerHarmony_PHM_SDK_V1.0.1.0.tar.gz”进行解压。将获取的“code_1.91.1-1720564633_amd64.deb”进行解压。打开后可见所有文件夹,即可进行编辑开发,VSCode也可打开终端进行编译等调试。选择主控类型,我是用的是gd32f470,我选gd32f4xx。Open Folder路径选中SDK解压后根目录即可。选择对应系统类型,我的是小型的,我选mini。选好后即完成工程创建。 阅读详情

相关推荐

[终于解决]Ubuntu14.04 32位安装移动网卡(0bda:b711)驱动8188gu tplink-WN726n

大致梳理一下问题解决的流程 首先,在台式机做了双系统,台式机只有一个网线接口,由于项目要求,需要占用网口传输数据,所以用之前买的tplink-WN726n免驱版2.0的移动网卡 【note】免驱版只能在Windows下安装使用,在Ubuntu系统中无法使用,所以,需要另辟蹊径。 找了很多资料,尝试很多方法,有的复杂有的简单,终于解决。 【思路】首先在Ubuntu系统中输入lsusb,查看是否检测到USB网卡设备。然后从Github中复制代码,构建,安装,然后modprobe一下,到前面那步还不行,就再来一步

瑞o 1万+

论文介绍 One-step Diffusion 只需单步扩散生成!

通过最小化近似的KL散度和简单的回归损失,DMD能够在保持图像质量的同时实现极速的生成效率,即在现代硬件上以20 FPS的速度生成图像。尽管DMD在一步生成模型的效率和质量方面取得了显著进步,但作者也指出了其局限性,包括与更细致的扩散采样路径相比,仍有质量差距,以及性能受限于教师模型的能力。(b) 真实得分+假得分: 当考虑了真实和假分布的得分,但没有回归损失时,生成的假数据覆盖了更多的真实分布,但仍然完全错过了第二个模式,即没有捕捉到分布的全部特征。作者的推导使用扩散的均值预测形式来简化,但与。

Willen_的博客 4488

Arduino程序设计(十)8×8 共阴极LED点阵显示(MAX7219)

本文主要介绍8×8 LED点阵显示实验,分别是:1、介绍MAX7219点阵模块;2、点阵显示部分图形;3、点阵显示数字 0~9 及 26 个英文字母。1、通过上述两个点阵实验,了解了8*8点阵显示的基本原理;2、通过SPI通信控制点阵显示,学会了Arduino用SPI通信方式控制外设。

Alice的博客 1万+

InstructDiffusion-多种视觉任务统一框架

InstructDiffusion,MSRA出品,InstructDiffusion可处理各种视觉任务,包括理解任务(分割、关键点检测)、生成类任务(编辑和增强)

持续关注并分享目标检测、数据生成、视频驱动、跨模态、分割、关键点等领域前沿技术 2180

Qt 6.5实战:用QMediaPlayer搞定RTSP监控流播放(附LAV Filters解码器避坑指南)

本文详细介绍了如何在Qt 6.5中使用QMediaPlayer实现低延迟RTSP监控流播放,并提供了LAV Filters解码器的配置避坑指南。通过优化缓冲策略和硬件加速设置,显著提升视频流的播放性能和稳定性,适用于工业视觉检测和安防监控等实时场景。

weixin_33712987的博客 399

别再死记硬背HJB方程了!用Python数值求解一个简单最优控制问题(附完整代码)

本文通过Python数值求解Hamilton-Jacobi-Bellman(HJB)方程,帮助读者从工程实践角度理解最优控制问题。教程涵盖从建立简单车辆控制模型到离散化HJB方程、实现值迭代算法及可视化结果的完整流程,适合具备Python基础的开发者学习。

weixin_42520796的博客 371

SDSX-小米这篇论文牛吹大了,比SD1.5快30倍,比SDXL快60倍

1,蒸馏法,其实最早实现的模型应用的是我们中国人,也就是LCM,出图速度确实快,通常20步出的图,它只需要4步,LCM推出后几天后,老外也搞了一个Turbo, 能在1-2步出图。3, 小米模型用的是固态模型,只有512及1024二种,而别人用的是动态模型,支持多种分辨率,固态模型出图是比动态模型快,没毛病。然后我仔细研究了一下他们的论文,嗯.......没毛病,有雷不死的风格,就象不锈钢,玻璃一样,确实有这么个东西,但玩了点花活。而且是一步生图,图片质量还相当的好。

German2000的博客 1216

Android Settings 设置Preference置灰显示

使Preference置灰显示,不能点击。先调用Preference的setEnabled(false),再调用setShouldDisableView(true); 如果使置灰项恢复正常可点击,可调用setEnabled(true)。

随风而动 1048

SDXS:知识蒸馏在高效图像生成中的应用

人工智能咨询培训老师叶梓 转载标明出处扩散模型虽然在图像生成方面表现出色,但其迭代采样过程导致在低功耗设备上部署面临挑战,同时在云端高性能GPU平台上的能耗也不容忽视。

人工智能讲师分享前沿技术 2083

学习Ultralytics (下载)

Ultralytics由创立,最初是为了简化目标检测模型的开发和应用,专注于构建高效、易用、性能卓越的深度学习框架。其主要产品之一是 YOLO 系列模型,尤其是最新的YOLOv5和YOLOv8,因其在精度、速度和可扩展性方面的出色表现而广受欢迎。

2301_76846375的博客 2864

一篇把 Transport 做到可复制的实战指南:从 CTS 底层表到 LSMW、Variant、Layout、TABU、Query、SAPscript 全对象搬运

本文深入解析SAP系统中的Transport机制,将其视为可审计、可追溯的变更流水线。文章从CTS/Transport Organizer通用方法论和具体对象搬运手法两个层面展开,详细介绍了LSMW项目、程序Variant、屏幕/ALV Layout、表数据、ABAP Query、SAPscript和SO10标准文本等对象的传输策略。通过真实案例说明,代码对象往往能被正确传输,但"运行体验"和"业务配置"却常被遗漏,导致QAS测试正常而PRD环境异常。文章提供了一套可

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 171

如何用 SDXS 生成动漫风格美图?LoRA 动漫文生图实战教程

想不想用一句提示词,几秒内就得到一张高清动漫风格美图?开源项目 SDXS(Real-Time One-Step Latent Diffusion Models with Image Conditions)正是为此而生:它把传统扩散模型动辄几十步的采样压缩到 **1 步**,配合内置的 LoRA 动漫模型,让普通用户无需训练、无需调参即可快速生成动漫风格图,速度比 Stable Diffusion

gitblog_00386的博客 782

【2026最新】3分钟Windows极速部署OpenClaw,完整可复制命令+全链路避坑指南

很多新手在Windows环境部署OpenClaw时,总会遇到各种玄学问题:WSL环境配置失败、Docker镜像拉取超时、容器启动后无法访问、权限报错、数据丢失……网上大量教程要么是Linux环境的,要么是早已过时的旧版本配置,照着操作不仅没法3分钟部署,反而要花几小时踩坑填坑。

2601_94871597的博客 493

SDXS 模型资源清单与路线图:官方模型下载、选型与生态展望

想要一张真正"实时"生成的 AI 绘图模型?**SDXS 模型**(SDXS: Real-Time One-Step Latent Diffusion Models with Image Conditions)给出了答案:它能在单张 GPU 上以约 **100 FPS** 生成 512×512 图像(比 SD v1.5 快 30 倍)、以 **30 FPS** 生成 1024×1024 图像(比

gitblog_00925的博客 1047

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

SDXS Gradio 参数全解析:tiny vae、float16、CPU/GPU 如何选择?

SDXS 是一款主打"实时一步生成"的潜在扩散模型(One-Step Latent Diffusion Model),只需 1 次采样即可出图,512×512 分辨率下推理速度最高可达约 100 FPS。本文作为一份完整的 SDXS Gradio 参数全解析指南,将逐项拆解演示界面中的三个关键选项——Device(CPU/GPU)、Image Decoder Type(tiny vae / lar

gitblog_00130的博客 266

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

SDXS 草图转图像终极玩法:10 种风格模板的 Sketch2Image 指南

想不想像画画一样,随手涂几笔线条,再加一句话,就能在 1 秒内得到一张电影级大片?这就是 SDXS 草图转图像(Sketch2Image)带给你的魔法体验。SDXS 是一个基于实时单步潜在扩散模型(Real-Time One-Step Latent Diffusion Models)的开源 AI 绘图项目,它的 Sketch2Image 功能可以把你的潦草涂鸦瞬间变成高清图片,而且内置了 10 种

gitblog_01091的博客 237

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

SDXS vs SD v1.5 vs SDXL:一步生成与 60 倍提速的全面对比评测

生成一张图要等多久?用过 SD v1.5 和 SDXL 的朋友一定深有体会:几十次迭代采样动辄耗去数秒甚至十几秒,交互体验大打折扣。而开源项目 **SDXS**(Real-Time One-Step Latent Diffusion Models with Image Conditions)凭借**一步生成**技术,把推理速度提升了惊人的 **30~60 倍**——SDXS-512 可达约 100

gitblog_00260的博客 324

没有 GPU 也能玩 SDXS:CPU 部署的完整配置清单与避坑指南

SDXS 是一个主打「实时一步生成」的 AI 绘图项目,即便没有 NVIDIA 显卡,普通电脑同样可以完成 SDXS 的 CPU 部署。本篇文章整理一份完整的 SDXS 配置清单与避坑指南,从环境搭建、模型下载到推理优化,手把手带你无 GPU 运行 SDXS,体验文生图、动漫生图与草图生图三种玩法。 ## SDXS 是什么?为什么值得在 CPU 上尝试? SDXS(Real-Time One-

gitblog_00718的博客 597

100 FPS 的 AI 绘图神器:SDXS 如何让实时文生图成为现实?

在 AI 绘图的众多方案中,等待往往是最磨人的体验:输入一句提示词,Stable Diffusion 需要十几步迭代采样,动辄数秒甚至几十秒才能"磨"出一张图。而开源项目 SDXS(Real-Time One-Step Latent Diffusion Models with Image Conditions)彻底改变了这一局面——它是一款主打实时文生图的 AI 绘图加速方案,能在单张 GPU 上

gitblog_00655的博客 455

SDXS ControlNet 原理与实战:草图、Canny 边缘与深度图图像翻译教程

SDXS 是一个主打"一步生成"的实时扩散模型开源项目,而它的 SDXS ControlNet 分支让草图、Canny 边缘和深度图都能在一秒内完成图像翻译。本文会用通俗易懂的语言拆解 SDXS ControlNet 的工作原理,并带来从环境搭建到草图转图像、Canny 边缘翻译、深度图翻译的完整实战教程,帮助新手快速上手实时图像生成,体验"随手一画,大片即出"的乐趣。 ## 什么是 SDXS?

gitblog_01095的博客 510

5 分钟上手 SDXS:实时 AI 文生图环境搭建完整教程

SDXS 是一款开源的实时 AI 文生图模型,只需一步推理即可生成高清图像,在 512×512 分辨率下可实现约 100 FPS 的生成速度,比传统 SD v1.5 快约 30 倍。本文为你提供一份完整的 SDXS 环境搭建教程,从安装依赖、下载模型到运行文生图 Demo,5 分钟即可全部搞定,全程无需编写复杂代码。 ## SDXS 是什么?为什么能做到实时出图 🚀 SDXS 全称 "Rea

gitblog_00314的博客 233

SDXS 快速入门指南:运行你的第一个一步文生图 Demo

SDXS 是一个主打实时生成的一步文生图开源项目,基于一步扩散模型技术,无需多步迭代采样即可快速出图。它提供 SDXS-512 与 SDXS-1024 两个模型,在单张 GPU 上分别可达约 100 FPS 与 30 FPS 的生成速度,比传统模型快数十倍。这份 SDXS 快速入门指南将带你从零搭建运行环境,并跑通你的第一个一步文生图 Demo,全程只需几分钟。 [![SDXS 一步文生图效果展

gitblog_00557的博客 295

一步生成不是梦:SDXS 特征匹配损失与 Diff-Instruct 策略详解

**SDXS(Real-Time One-Step Latent Diffusion Models)** 是一个专注于**实时一步生成**的开源扩散模型加速项目,目标是让"输入提示词、瞬间出图"成为现实。它通过**特征匹配损失(Feature Matching Loss)** 与 **Diff-Instruct 蒸馏策略**两大核心技术,把原本需要几十步采样的扩散模型压缩为单步推理,在单张 GPU

gitblog_00276的博客 441

SDXS 是什么?一文读懂实时一步式扩散模型的 3 大核心突破

用 AI 绘图时,你是否经历过"等一张图要十几秒甚至一分钟"的煎熬?SDXS 正是为解决这一痛点而生的**实时一步式扩散模型**开源项目。它把传统扩散模型动辄 16~32 步的采样压缩到仅 **1 步**,让 512×512 图片达到约 **100 FPS** 的生成速度——比 SD v1.5 快 30 倍,1024×1024 也能跑出 30 FPS,比 SDXL 快 60 倍。更难得的是,提速的

gitblog_00611的博客 218

SDXS 为何能实现 100 FPS?轻量级 VAE 解码器蒸馏技术深度解析

SDXS 是一个主打实时生成的「一步潜在扩散模型」开源项目,能在单张 GPU 上把 512×512 图像生成速度拉到约 **100 FPS**(比 SD v1.5 快约 30 倍),1024×1024 图像也能达到约 **30 FPS**(比 SDXL 快约 60 倍)。这背后最关键的功臣之一,就是「轻量级 VAE 解码器蒸馏」技术。本文将从这项核心技术切入,一步步拆解 SDXS 实现 100 F

gitblog_00350的博客 253

stable-diffusion.cpp 蒸馏模型运行指南:SSD-1B、Segmind Vega 与 tiny U-Net 系列(SD1.x/SD2.x/SDXS)实战

本文基于 [docs/distilled_sd.md](https://link.gitcode.com/i/3c0b7fa6522a966b9a45527f3145a548) 编写,系统讲解如何在 stable-diffusion.cpp 中运行一系列"蒸馏(distilled)"精简模型:SDXL 精简架构的 **SSD-1B** 与 **Segmind Vega**,以及只有 6 个 U-N

gitblog_01177的博客 272
上一篇: CoMat: Aligning Text-to-Image Diffusion Model with Image-to-Text Concept Matching
下一篇: Cross-Attention Makes Inference Cumbersome in Text-to-Image Diffusion Models
Toyag
博客等级 码龄8年 190粉丝 21原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值