CoMat: Aligning Text-to-Image Diffusion Model with Image-to-Text Concept Matching

Text-to-image Diffusion Model文本到图像扩散模型综述 阅读详情

CoMat: Aligning Text-to-Image Diffusion Model with Image-to-Text Concept Matching

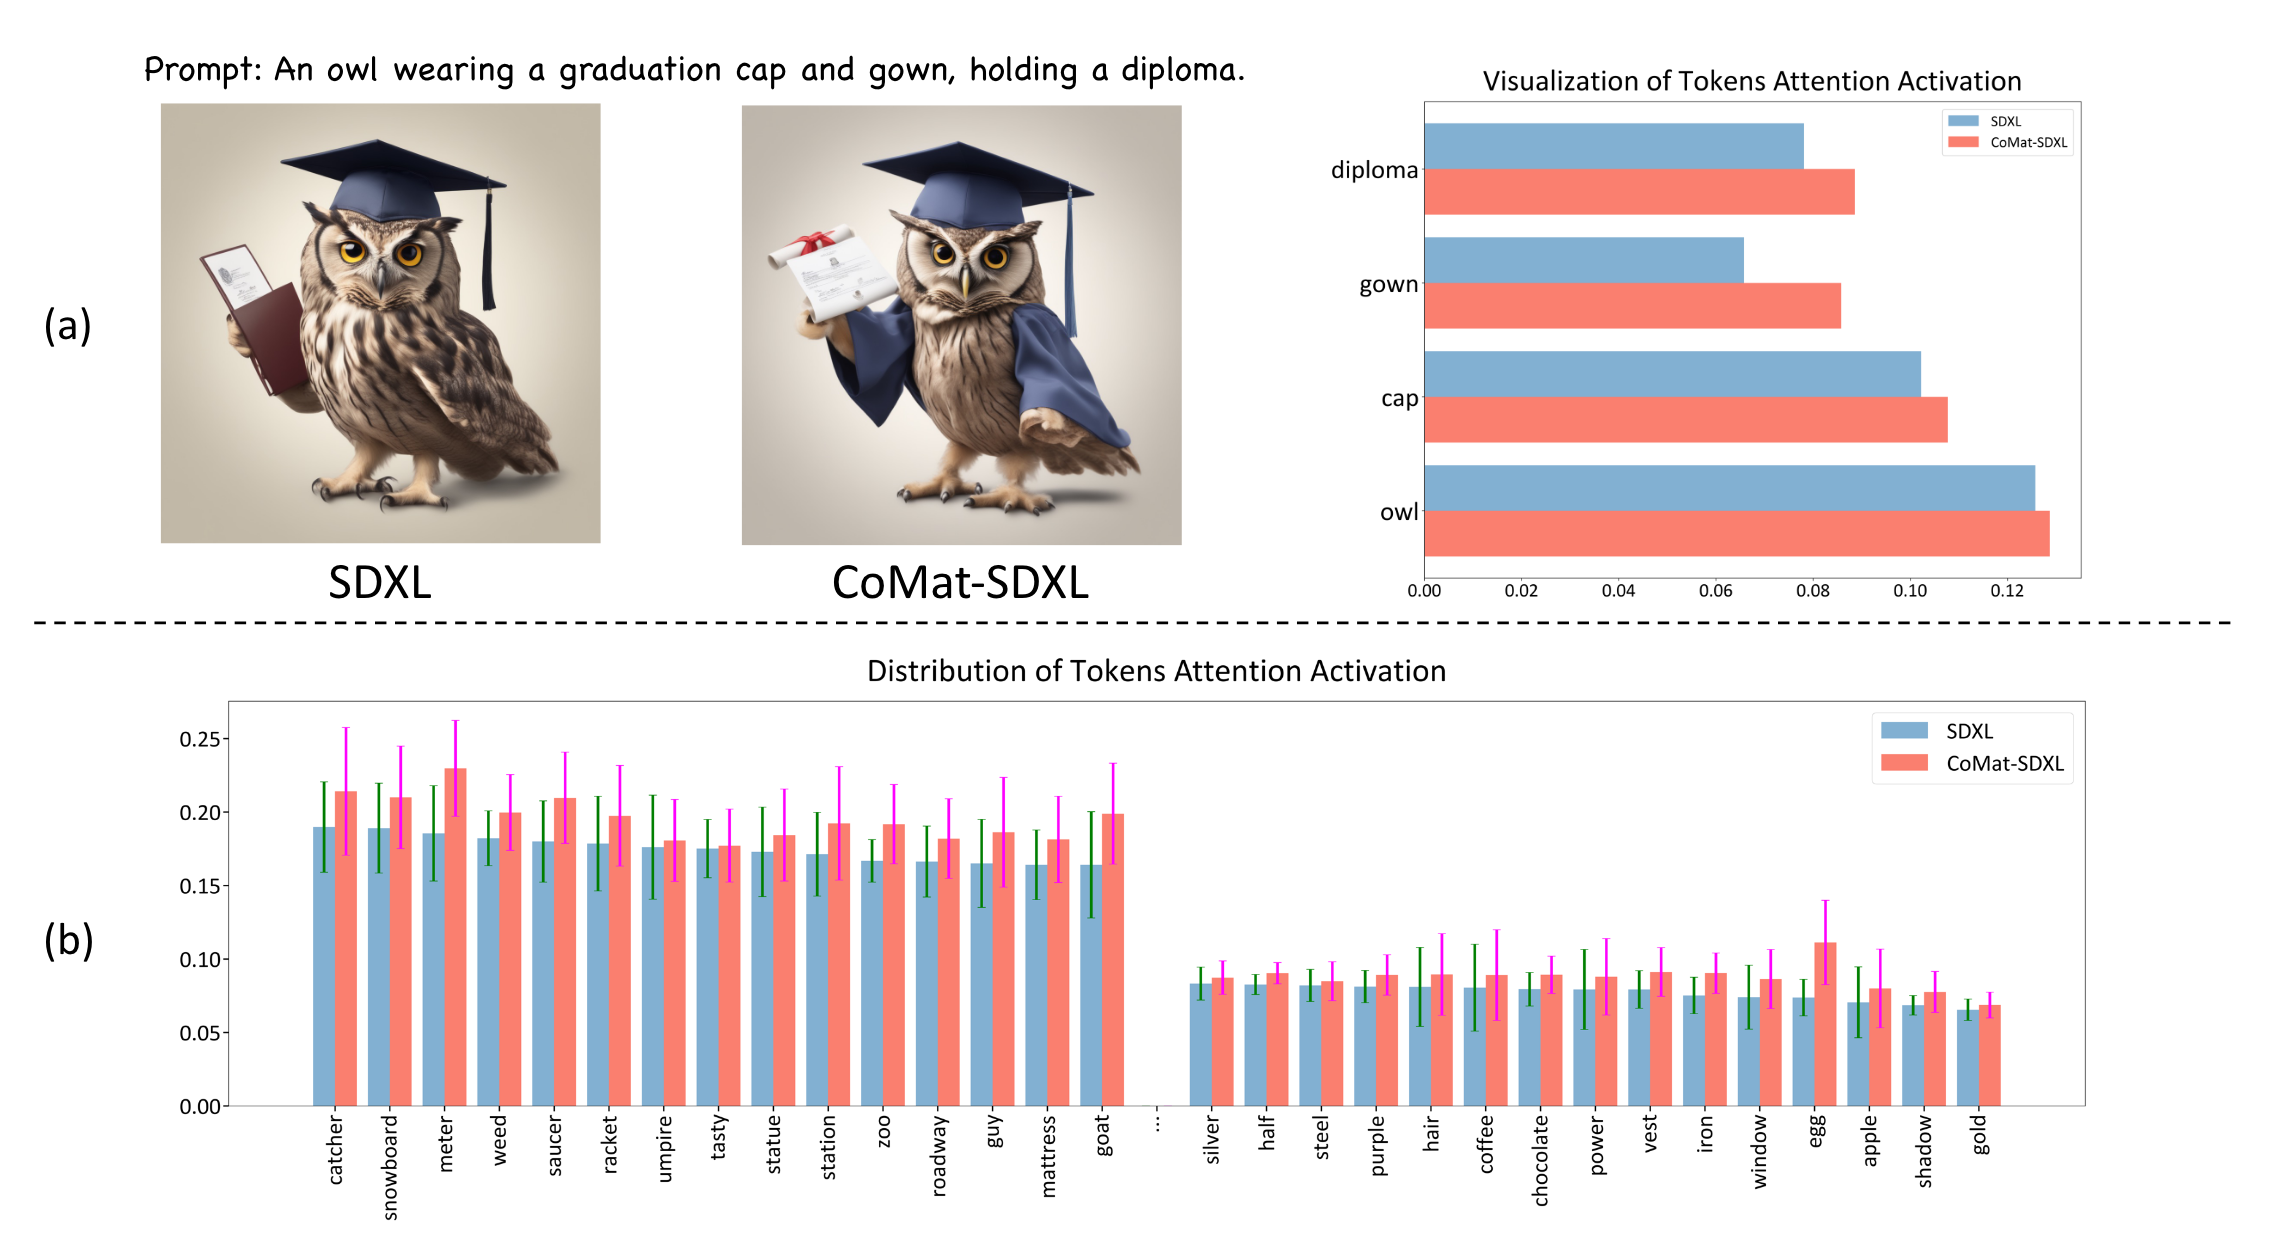
图文一致性的原因还是因为文本的 token 的激活注意值不高,导致文本的 token 无法激活图像的区域,从而导致图文不一致。作者将这种现象归因于扩散模型的训练方式对条件的利用不足,所以提出了 CoMat,是一种 端到端的扩散模型微调策略。
首页

1. Introduction

缺陷

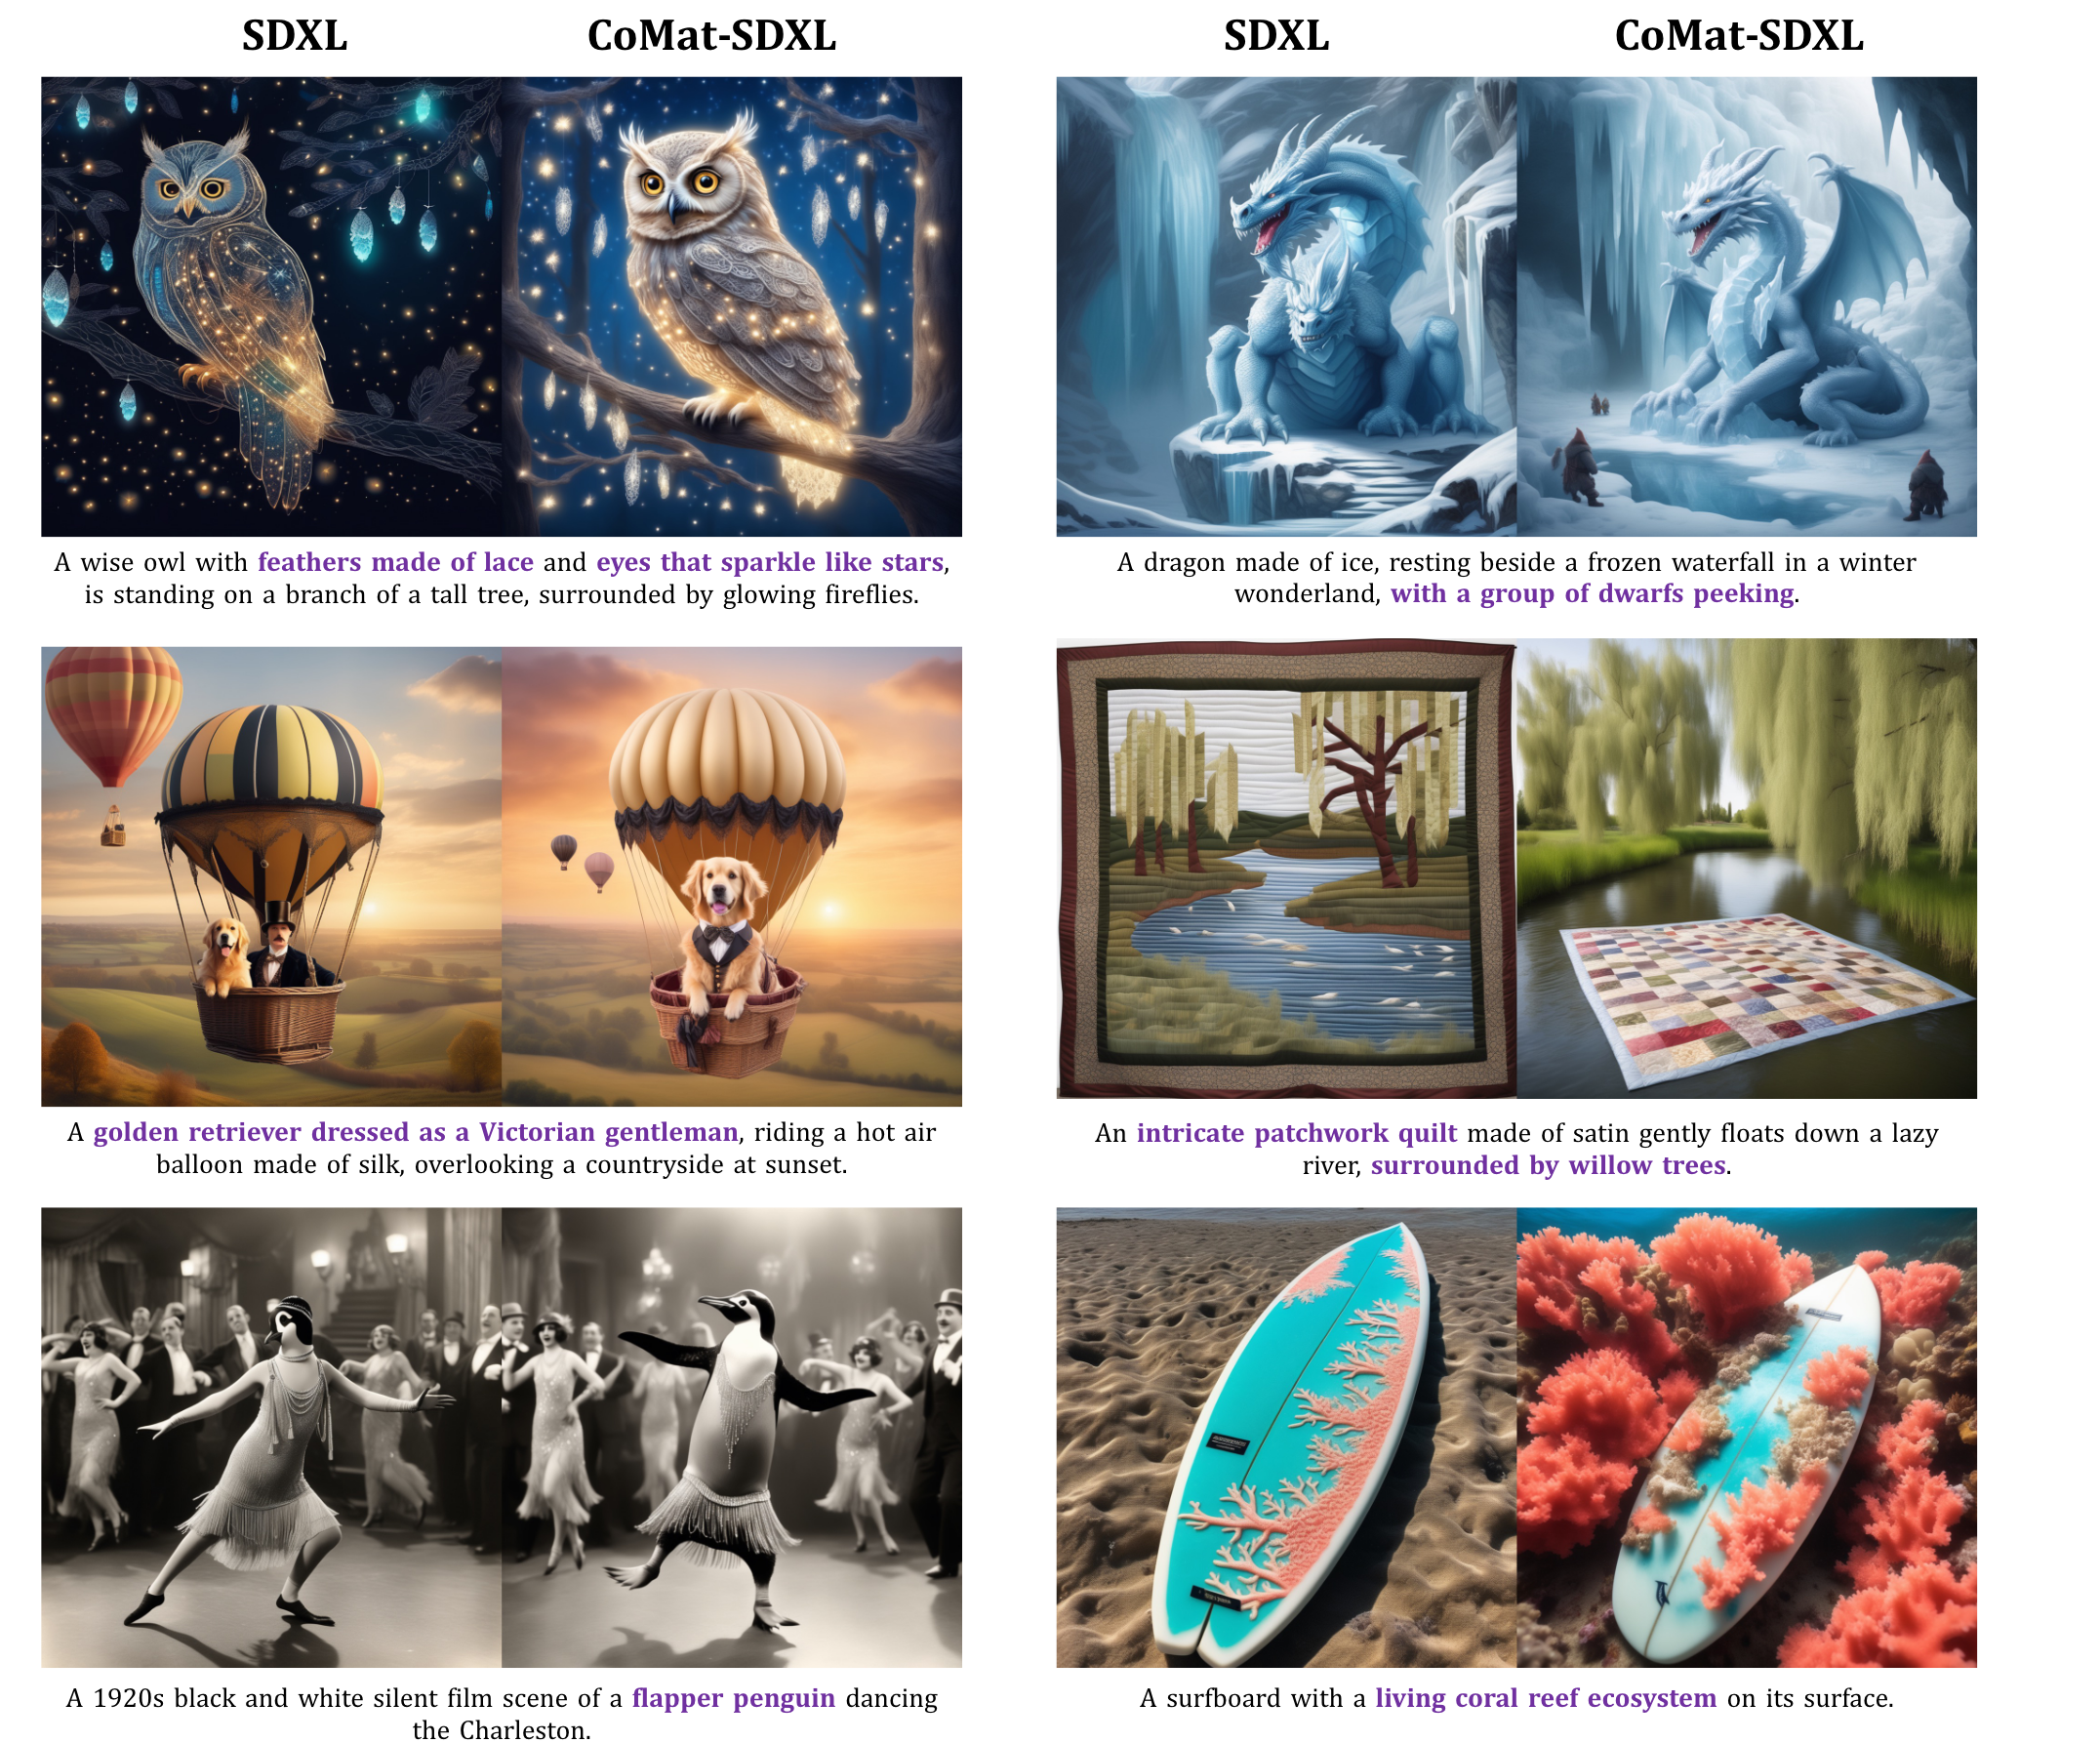
其实上图所展现出来的还是很基础的目标丢失问题

补充一下:
这个问题归因于视觉概念的的激活值不够大而被其他物体的注意力淹没,导致了视觉概念的丢失。之前也有一些相关工作,像:Atten-and-Excite,Structur Diffusion 等

这里也有一个关于问题的分析:

作者将 token 对应的交叉注意图进行了分析,这里采用的做法是:

  • 将预训练UNet对带有文本标题的噪声图像进行降噪。然后记录每个文本token的激活值,并在空间维度上取平均值

可以看到带有 Comat 的,里面的所有激活值都有了提高
alt text

多说一句🤔
看到这里和之前的工作并没有什么不同,像 Atten-and-Excit 是将主题视觉概念的 token 去最大化响应值,这里貌似最后的结果也是一样的

2. Method

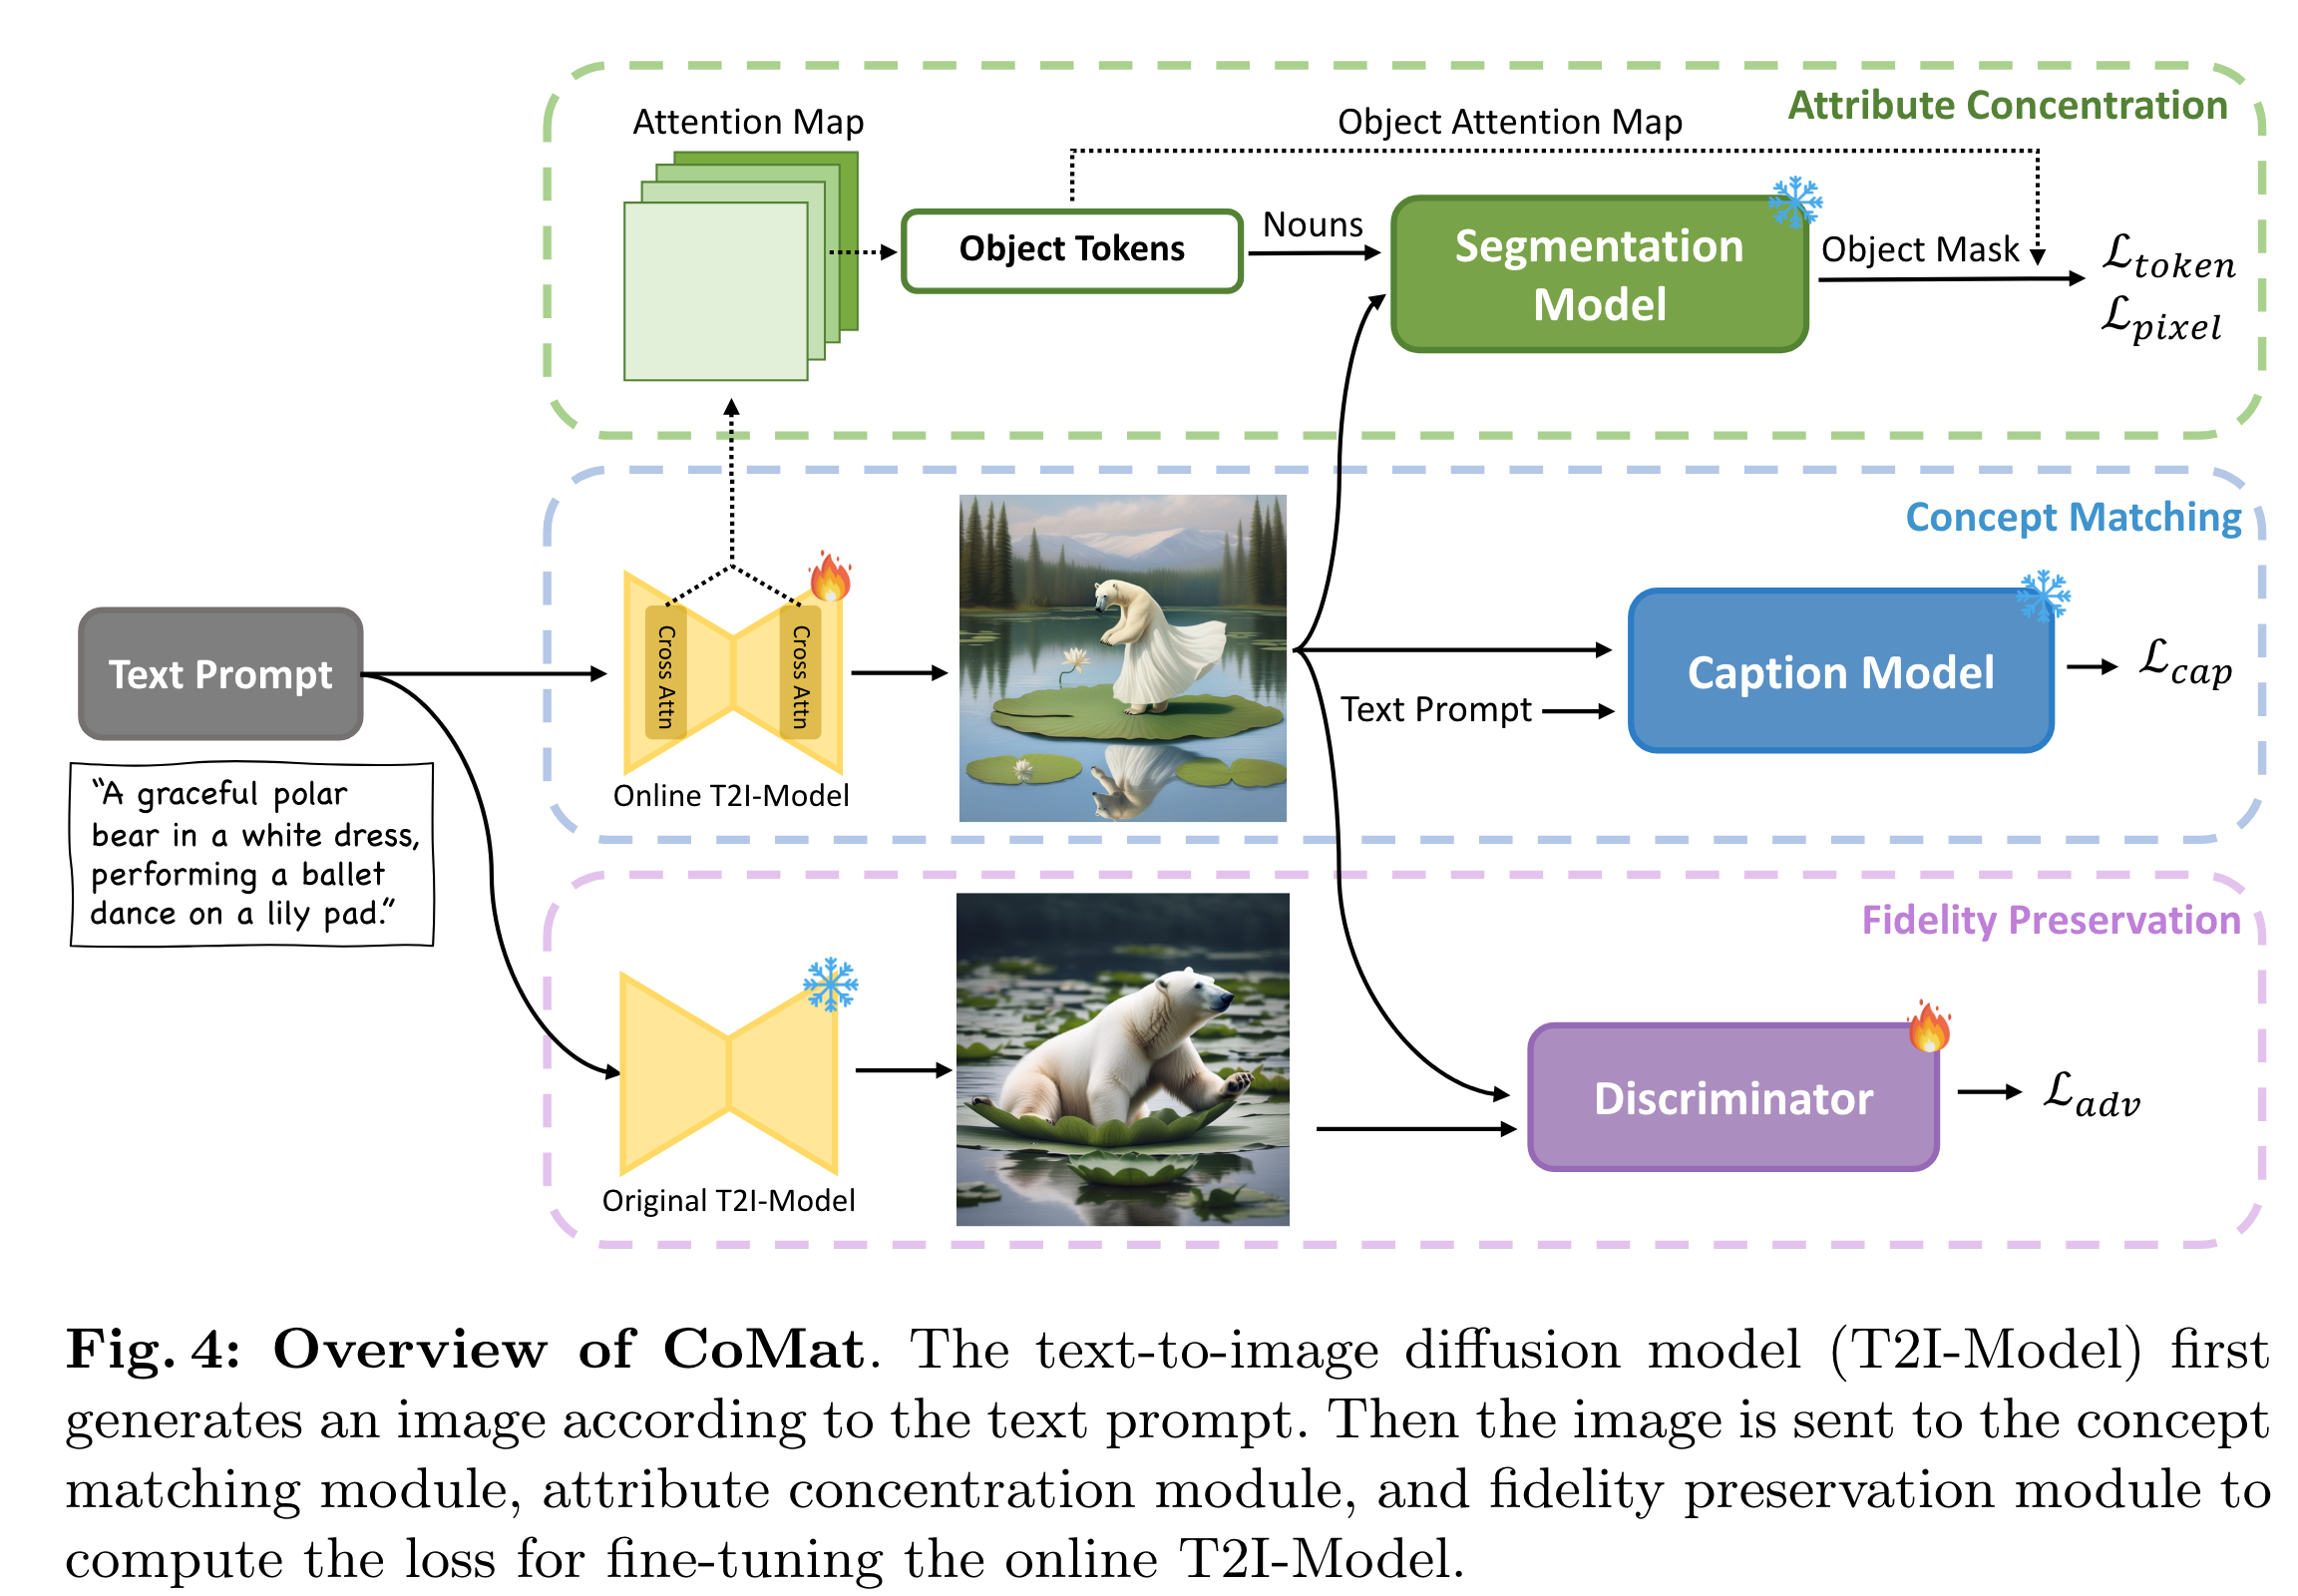
作者一共包括三个模块:

  • Concept Matching
  • Attribute Concentration
  • Fidelity Preservation

alt text

2.1 Concept Matching

这里引入了图像字幕模型,即 Caption Model ,该模型可以根据给定的文本提示准确识别生成图像中不存在的概念。

在 Caption Model 的监督下,扩散模型被迫重新访问文本标记以搜索被忽略的条件信息,并为先前被忽略的文本概念分配重要性,以获得更好的文本-图像对齐。具体来说,做法是:

  • 给定文本提示 P \mathcal{P} P, 以及相应的 词tokens { w 1 , w 2 , … , w L } \{w_1, w_2, \dots, w_{L}\} {w1​,w2​,…,wL​};
  • 对于一张在经过 T \mathbf{T} T 步去噪厚的图像,这个冻结的 Caption Model C C C 会以对数似然的形式对图文一致性进行打分,训练目标就是最小化这个分数,标记为 L cap \mathcal{L}_{\text{cap}} Lcap​:

L cap = − log ⁡ ( p C ( P ∣ I ( P ; ϵ θ ) ) ) = − ∑ i = 1 L log ⁡ ( p C ( w i ∣ I , w 1 : i − 1 ) ) . \begin{aligned}\mathcal{L}_{\text{cap}}&=-\log(p_{\mathcal{C}}(\mathcal{P}|\mathcal{I}(\mathcal{P};\epsilon_{\theta})))=-\sum_{i=1}^{L}\log(p_{\mathcal{C}}(w_{i}|\mathcal{I},w_{1:i-1})).\end{aligned} Lcap​​=−log(pC​(P∣I(P;ϵθ​)))=−i=1∑L​log(pC​(wi​∣I,w1:i−1​)).​

这个优化方式是通过 DPOK 这个方法做的;
作者说这个概念匹配模块可以缓解物体存在、复杂关系等多种错位问题。

2.2 Attribute Concentration

alt text

如上图所示,基于SDXL模型,单词“红”和“蓝”的注意力大多在背景中被激活,其对应对象的对齐很少。 我们的概念匹配模块可以在一定程度上缓解这一问题。然而,由于标题模型对对象属性不敏感,性能提升有限。这里,为了从更细粒度的视图将实体与其属性对齐,我们引入了属性集中,将实体的文本描述的注意力集中在图像中的区域上。

这里看下具体做法:

  • 使用 spacy 解析库,提取文本提示中所有的名词和其修饰语,定义为实体 { e 1 , … , e N } \{e_1, \dots, e_N\} {e1​,…,eN​},而每个实体又可以定义为元组 即 e i = ( n i , a i ) e_i = (n_i,a_i) ei​=(ni​,ai​)
  • 然后手动过滤抽象的名词(例如:场景、氛围、语言),难以识别区域的名词(例如:阳光、噪音等),描述背景的(例如:早餐、浴室、派对等)
  • 然后使用 Grounded-SAM 模型来风格出相应的区域 Mask, { M 1 , … , M N } \{M^1, \dots, M^N\} {M1,…,MN},这里只给名词拿来分割,原因是因为扩散模型会导致错误的属性绑定,那样就会导致不准确
  • 然后就是集中同一区域内每个实体 e i e_i ei​的名词 n i n_i ni​ 和 a i a_i ai​的注意力,用一个 M a s k i Mask^i Maski 来表示,总的来说包括两个优化目标:
    • token-level attention loss
    • pixel-level attention loss

token-level attention loss 就是强制激活 n i ∪ a i n_i \cup a_i ni​∪ai​的区域

L token = 1 N ∑ i = 1 N ∑ k ∈ n i ∪ a i ( 1 − ∑ u , v A u , v k ⊙ M i ∑ u , v A u , v k ) \begin{aligned}\mathcal{L}_{\text{token}}&=\frac{1}{N}\sum_{i=1}^N\sum_{k\in n_i\cup a_i}\left(1-\frac{\sum_{u,v}A_{u,v}^k\odot M^i}{\sum_{u,v}A_{u,v}^k}\right)\end{aligned} Ltoken​​=N1​i=1∑N​k∈ni​∪ai​∑​(1−∑u,v​Au,vk​∑u,v​Au,vk​⊙Mi​)​

pixel-leval attention loss 是通过二元交叉熵损失进一步迫使区域中的每个像素只关注对象令牌:
L pixel = − 1 N ∣ A ∣ ∑ i = 1 N ∑ u , v [ M u , v i log ⁡ ( ∑ k ∈ n i ∪ a i A u , v k ) + ( 1 − M u , v i ) log ⁡ ( 1 − ∑ k ∈ n i ∪ a i A u , v k ) ] , \begin{aligned}\mathcal{L}_\text{pixel}=-\frac{1}{N|A|}\sum_{i=1}^N\sum_{u,v}\left[M_{u,v}^i\log(\sum_{k\in n_i\cup a_i}A_{u,v}^k)+(1-M_{u,v}^i)\log(1-\sum_{k\in n_i\cup a_i}A_{u,v}^k)\right],\end{aligned} Lpixel​=−N∣A∣1​i=1∑N​u,v∑​[Mu,vi​log(k∈ni​∪ai​∑​Au,vk​)+(1−Mu,vi​)log(1−k∈ni​∪ai​∑​Au,vk​)],​

其中|A|是注意力图上的像素数。而提示符中的某些对象可能由于不对齐而无法出现在生成的图像中。在这种情况下,像素级的注意力丧失仍然有效。当掩码完全为零时,它表示没有任何像素应该参与当前图像中缺失的对象标记。此外,考虑到计算成本,在在线模型的图像生成过程中,我们只在随机选择的r个时间步上计算上述两个损失。

2.3 Fidelity Preservation

alt text

由于目前的微调过程纯粹是由图像字幕模型和属性与实体之间关系的先验知识主导的,扩散模型可能会很快过拟合奖励,失去原有的能力,产生劣化的图像,如图6所示。为了解决这个 reward hacking 问题,作者引入了一种新的对抗损失,通过使用鉴别器来区分由预训练和微调扩散模型生成的图像。

这个好像还挺新奇的🤔(可以阅读 UFOGen)

对于判别器 D ϕ D_\phi Dϕ​,用Stable Diffusion模型中预训练的UNet初始化,该模型与在线训练模型共享相似的知识,有望更好地保持其能力。在我们的实践中,这也使得对抗损失可以直接在潜在空间而不是图像空间中计算。此外,重要的是要注意,我们的微调模型不利用真实世界的图像,而是利用原始模型的输出。这种选择的动机是我们的目标是保持原始的生成分布,并确保更稳定的训练过程。

最后,在给定单个文本提示的情况下,我们分别使用原始扩散模型和在线训练模型来生成图像 latent z ^ 0 \hat{z}_0 z^0​ 和 z ^ 0 ′ \hat{z}_0' z^0′​。对抗性损失计算如下:

L a d v = log ⁡ ( D ϕ ( z ^ 0 ) ) + log ⁡ ( 1 − D ϕ ( z ^ 0 ′ ) ) . \begin{aligned}\mathcal{L}_{adv}=\log\left(D_\phi\left(\hat{z}_0\right)\right)+\log\left(1-D_\phi\left(\hat{z}_0'\right)\right).\end{aligned} Ladv​=log(Dϕ​(z^0​))+log(1−Dϕ​(z^0′​)).​

2.4 联合训练

alt text


实验

Caption Model 是用 BLIP 在 COCO 数据集上 finetune 的

训练集包括 T2I-ComBench, HRS-Bench 以及 在 ABC-6K上随机采用的 5000 个 prompt,一共 2W 个图像

训练是在 Unet 里面插入 Lora 模块(包括原始 diffusion 和 判别器),其余全部冻住。 在 8 块 A100 80G 上训练 2000iters,50 步去噪,其中只有 5 步有梯度反馈。

实验效果还是不错的,重点还是看看这篇工作解决方式的方法。解决的问题还是一样的激活值不够,但是作者借用了很多模块包括 BLIP 、 SAM 等,但是 Atten-and-Excite 只用了一个最大化 Loss,估计还是效果和方法的一个 trade-off 。这篇工作感觉还是做的很复杂。


VQA学习(三)BUTD注意力机制 BUTD(Bottom-Up and Top-Down Attention)论文解读 传统的注意力模型,各区域对应等大的网格,没有与图像中的内容相关。文中提出一种方法,结合自下而上与自上而下的注意力机制。 一、自下而上的注意力模型 注意力区域:bounding box,如上面右图所示。 使用Faster RCNN实现自下而上的注意力模型 Faster R-CNN可以简单地看做“区域生成网络RPNs + Fast R-CNN”的系统,用区域生成网络代替Fast R-CNN中的Selective. 阅读详情

相关推荐

EasyNLP 带你玩转 CLIP 图文检索

本文简要介绍CLIP的技术解读,以及如何在EasyNLP框架中玩转CLIP模型。

阿里云云栖号 1985

CV论文--2024.4.7

最新的基于辐射场的方法可以重建完整的三维表示,但在处理遮挡区域时仍存在困难,因为在没有视觉观察的情况下,推断几何形状需要对周围环境的语义知识和空间上下文进行推理。我们引入了一个视觉语言调节模块,通过细粒度的语义信息来丰富点的特征表示。具体而言,我们训练了一个去噪扩散模型,该模型可以根据单个RGB输入图像生成多视角RGB-D图像,并利用深度估计(包含一些噪声)来获得基于投影的条件,以保持多视角的一致性。我们证明了我们的方法可以生成比最先进的技术更准确的合成结果,包括基于蒸馏的3D推断和先前的多视角生成方法。

u012854516的专栏 836

GXHT40温湿度传感器:I2C通信与CRC校验实战解析

本文详细解析GXHT40温湿度传感器的I2C通信协议与CRC校验机制,涵盖硬件连接、时序控制、数据读取及加热功能应用。通过实战案例分享优化技巧与异常处理,帮助开发者提升嵌入式系统中传感器数据的准确性与可靠性。

rgv234567的博客 241

最新140篇!2024年4月 diffusion 生成扩散模型论文汇总

001 (2024-04-26) MV-VTON Multi-View Virtual Try-On with Diffusion Models https://arxiv.org/pdf/2404.17364.pdf002 (2024-04-26) Simultaneous Tri-Modal Medical Image Fusion and Super-Resolution us...

idol24的博客 3044

信号完整性基础04:串扰(1)

我们理解了“单个”传输线(传输线是信号路径+回流路径,切记~),但大多数情况下单独“传输线”的情况并不多见(理想情况下的同轴线缆可以算一个),大多数我们PCB板上有成百上千条走线,它们组成了一个“大社会”,就如当年的TVB神剧《创世纪》一样,到处充满着恩怨情仇;稍处理不慎,单板这个“社会”就会崩溃。那么我们要从哪里入手去理解它呢?最基本的就是从两条PCB走线(传输线)之间的串扰开始。好,年前倒数第二章:《为什么会有串扰》。 ps:我们了解了x射线是啥,那么今天开始讲“放射线”,这两种东西是否就是同一种呢~

WKEZHENG的博客 6032

倍福Beckhoff运动控制功能块实战解析:从MC_ReadActualPosition到MC_GearInVelo

本文深入解析倍福(Beckhoff)TwinCAT运动控制功能块,从基础的MC_ReadActualPosition、MC_Power等轴状态读取与使能操作,到MC_MoveAbsolute、MC_MoveRelative等单轴定位指令,并重点剖析了用于动态速度同步的核心功能块MC_GearInVelo在飞锯等场景的应用。文章结合实战经验,详细介绍了齿轮耦合、电子凸轮(MC_CamIn)等高级同步功能的参数配置、调试技巧及常见问题,旨在帮助工程师快速掌握倍福运动控制工具箱,实现复杂的同步工艺。

transformer2023的博客 981

CV最新论文|4月5日 arXiv更新论文合集

以下内容由马拉AI整理,今天为大家带来4月5日 arXiv 计算机视觉和模式识别相关论文: 1、Know Your Neighbors: Improving Single-View Reconstruction via Spatial Vision-Language Reasoning 了解你的邻居:通过空间视觉-语言推理改进单视图重建 摘要:从单个视图恢复 3D 场景几何体是计算机视觉中一个基本但不恰当的问题。虽然经典的深度估计方法只能推断出局限于图像平面的 2.5D 场景表示,但最近基于辐射场的方

1192

MATLAB新手也能懂:用MATPOWER 8.0b搞定电力系统潮流计算(附case9实战代码)

本文详细介绍了如何使用MATPOWER 8.0b在MATLAB中进行电力系统潮流计算,特别适合新手入门。通过case9实战案例,讲解了从安装配置到运行牛顿-拉夫逊法潮流计算的全过程,包括结果分析和常见问题处理,帮助读者快速掌握这一电力系统分析的核心技能。

weixin_26757925的博客 380

Bottom-Up and Top-Down Attention for Image Captioning and Visual Question Answering 论文精简翻译

摘要 自顶向下的视觉注意机制已广泛应用于image caption 和 VQA 中。我们提出了一个自底向上和自顶向下相结合的注意力机制,使注意力能够在物体和其他突出的图像区域的水平上进行计算。在我们的方法中,自底向上的机制(基于Faster R-CNN)提取图像区域,每个区域有一个对应的特征向量,而自顶向下的机制确定特征权重。用这个模型我们获得了2017年VQA挑战赛的第一名。 1.介绍 视觉注意...

二十三冰芒的博客 902

华为防火墙双ISP出口实战:如何用策略路由实现电信联通流量自动切换(附配置截图)

本文详细解析了华为防火墙在双ISP环境下的智能选路技术,通过策略路由与健康检测的深度应用,实现电信联通流量的自动切换。文章包含实战配置截图,帮助企业解决切换延迟、路径劣化等核心挑战,提升业务连续性。

backprop5master的博客 643

遥感图像处理实战:DOTA数据集旋转框转YOLO格式全流程解析(附代码)

本文详细解析了将DOTA遥感数据集的旋转框标注转换为YOLO格式的全流程。针对遥感图像中物体朝向任意性的特点,文章重点阐述了将旋转框转换为外接水平框的数学原理与代码实现,并提供了批量转换脚本和可视化验证方法,帮助开发者高效处理数据,为基于YOLO的遥感目标检测项目奠定基础。

weixin_29082143的博客 398

提升文本到图像一致性的新方法:自动提示优化

人工智能咨询培训老师叶梓 转载标明出处尽管图像质量得到了显著提升,但这些模型在生成与输入文本提示一致的图像方面仍需要提升。常见的问题包括无法正确捕捉对象的数量、关系和属性。为了解决这些挑战,现有的解决方案通常需要模型微调、只关注附近的提示样本,并且受到图像质量、表示多样性和提示-图像一致性之间不利权衡的影响。

人工智能讲师分享前沿技术 1695

基于YOLOv11的手术器械计数系统:从数据集构建到Web应用部署

m2cai16-tool数据集:包含15种腹腔镜手术器械的标注图像Cholec80数据集:包含80个胆囊切除手术视频,标注了7种器械SurgicalTools数据集:包含超过10,000张手术器械图像,涵盖21类常见器械手术剪(Scissors)止血钳(Hemostat)持针器(Needle Holder)手术刀(Scalpel)镊子(Forceps)拉钩(Retractor)吸引器(Suction)

YOLO 396

图文一致性指标

为了了解文生图模型中的图文一致,借助AI工具搜集了一些资料和论文,对评价图文一致的相关指标内容做了一些简单的了解。在这里记录一下学习成果。

Sdom_L的博客 1639

YOLOv8+SAM强强联合:用分割“喂“检测,复杂背景下作物AP从72%干到77.7%,杂草误检降60%

目标与背景高度相似:如农业(作物vs杂草)、工业(零件vs台面)、医学(病灶vs正常组织);遮挡严重的场景:如密集人群(人被遮挡)、森林(树木被枝叶遮挡);小目标密集场景:如无人机航拍(远处小目标易混背景)。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 793

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

【多模态】36、ShareGPT4V | 借助 GPT4V 的能够来生成更丰富的 caption 用于提升 LMM 模型的能力

本文主要介绍 ShareGPT4V

呆呆的猫的博客 2808

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

CoMat——解决文本与图像之间的差异

在文本到图像生成领域,扩散模型近年来取得了巨大成功。然而,提高生成图像与文本提示之间的一致性仍然是一个挑战。论文指出,扩散模型中文本条件利用不足是对齐的根本原因。论文随后提出了一种新方法 CoMat,通过利用图像捕捉模型来优化生成图像与文本提示之间的对齐。它还引入了一种改进属性和实体之间绑定的方法,以及一个保真模块,以保持生成能力。实验结果表明,与现有的基线模型相比,所提出的 CoMat 方法能生成与文本条件更加对齐的图像。本文提出了改进文本到图像配准的新见解和有效方法,是对该领域的重要贡献。

知来者逆的博客 4814

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

【多模态】26、视觉-文本多模态任务超详细介绍 「CLIP/LSeg/ViLD/GLIP/ALBEF/BLIP/CoCa/BEIT」

本文主要介绍典型的图文多模态任务

呆呆的猫的博客 8033

《Deep Compositional Captioning: Describing Novel Object Categories without Paired Training Data》阅读笔记

《From Captions to Visual Concepts and Back》在论文提到了一种新的image caption方法,visual detector、language model、multimodel similarity model,在近两年的caption论文很多都采用了这种思路。今天阅读的论文在此基础上,提出了Deep Compositional Captioning(D...

SCUT_AUTO143的博客 1031

图文详解分布式一致性算法,这种方式你确定不搞一下?

就是将所有的业务都部署在一个中心主机(节点)上,所有的功能都由这个主机集中处理。特点部署结构简单、不需要考虑多个主机之间的分布式协作问题。分布式系统:指将硬件或者软件组件部署在不同的网络计算机上,彼此之间仅仅通过消息传递进行通信和协调的系统。特点分布性:多台计算机可空间上随意分布,跨机房、跨城市都可以。对等性:分布式系统中没有主/从之分,都是对等的节点或者服务。 副本:指分布式系统对数据或服务冗余,以此提供高可用。数据副本:是指在不同的节点上持久化一份数据,当某一个节点上存储的数据丢失时,可以从副本上读取到

746

一致性hash算法_(图文案例)一致性哈希算法详解 一点课堂(多岸教育)

一致性Hash算法关于一致性Hash算法,在我之前的博文中已经有多次提到了,MemCache超详细解读一文中”一致性Hash算法”部分,对于为什么要使用一致性Hash算法、一致性Hash算法的算法原理做了详细的解读。算法的具体原理这里再次贴上:先构造一个长度为2^32的整数环(这个环被称为一致性Hash环),根据节点名称的Hash值(其分布为[0, 2^32-1])将服务器节点放置在这个Hash环...

weixin_39771987的博客 285

深度解析注意力模型(attention model) --- image_caption的应用

@author : jasperyang@school : BUPT 前言 这里学习的注意力模型是我在研究image caption过程中的出来的经验总结,其实这个注意力模型理解起来并不难,但是国内的博文写的都很不详细或说很不明确,我在看了 attention-mechanism后才完全明白。得以进行后续工作。 这里的注意力模型是论文 S...

weixin_34378922的博客 1031

caption重要性 image_深度解析注意力模型(attention model) --- image_caption的应用

@author : jasperyang@school : BUPT前言这里学习的注意力模型是我在研究image caption过程中的出来的经验总结,其实这个注意力模型理解起来并不难,但是国内的博文写的都很不详细或说很不明确,我在看了 attention-mechanism后才完全明白。得以进行后续工作。这里的注意力模型是论文 Show,Attend and Tell:Neural Image ...

weixin_39767322的博客 422

用Tensorflow建立image caption 模型(三)

第三部分 用tensorflow建立image caption模型 前言:   写这篇博客的目的是一开始想要使用Tensorflow建立一个image caption模型,在一开始觉得不就是一个LSTM模型,因为之前有用Tensorflow实现过CNN结构,所以觉得并不会很难。但实际上,在这个过程中也遇到了不少困难。 按照我自己的学习顺序,这个系列的博客将分为三个部分,最终

CJN_UESTC的博客 2503

【小白学AI】图像标注Image Caption - tensorflow_models/im2txt

Image Caption - im2txt tensorflow工程实践版本,及各种细节 《Show and Tell: Lessons learned from the 2015 MSCOCO Image Captioning Challenge》

JOHNNIE_TURBO的博客 5479
上一篇: Faster Diffusion: Rethinking the Role of UNet Encoder in Diffusion Models
下一篇: SDXS:Real-Time One-Step Latent Diffusion Models with Image Conditions
Toyag
博客等级 码龄8年 190粉丝 21原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值