


聊《Agent到底能不能干活?别只看 Demo 和跑分》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。
摘要
最近几个做 AI 编程工具的项目上线,我发现一个现象挺有意思:团队里能单独跑通 Claude Code 或者自建 Agent 的人不少,但一旦接入协作流程,工具调用这块就开始掉链子。有人抱怨权限问题,有人说是日志没打清楚,也有人直接甩锅模型不行。
我复盘了几个项目之后发现,问题出在更底层——很多人对 Agent 的核心组件理解本身就缺了一半。今天不聊套话,就按工具调用、记忆、规划这三个关键点,把我在实战里踩过的坑拆一遍。
目录
- Agent 的本质不是"聪明",是可观测的执行流
- 规划能力:拆解任务的真实代价
- 工具调用:最容易翻车的环节
- 记忆系统:状态管理是隐形的架构负担
- 失败恢复:区分三类错误的判断标准
- 适用边界:什么时候不该做 Agent
- 学习路线:先补什么,放什么
- 真实案例
- 排查过程
- 代码解释
- 失败原因
- 适用边界
- 总结
Agent 的本质不是"聪明",是可观测的执行流
我第一次做 Agent 项目的时候,脑子里想着的是怎么让模型"更聪明"。结果上线第一天,老板问我们"这个工具为什么调用失败了",我一脸懵。
Agent 的本质不是一个会思考的 AI,而是一个带着工具的可观测执行流。模型只是决策节点,真正的价值在于:它知道自己有什么工具可用、怎么规划调用顺序、以及调用失败后如何恢复。
很多人做 Agent 停留在 Demo 级别,是因为没想清楚这三件事之间的边界。我们项目里有个很典型的翻车现场:业务方要求做一个"自动分析线上日志并生成报告"的 Agent,模型能输出文字,工具调用也配好了,结果上线后三天崩了两次。
第一次崩的原因是:模型在连续调用工具时,没有记住上一次工具返回的数据,导致第二次调用用了错误的参数。第二次崩的原因更隐蔽:工具的权限配置是个人账号,团队协作时其他成员登录进去后权限不足,调用直接失败。
这两个问题对应的就是 Agent 的两个核心组件:记忆系统和工具调用的环境适配。
规划能力:拆解任务的真实代价
规划是 Agent 最容易被高估的能力。模型确实能拆解任务,但它的拆解质量高度依赖两个因素:提示词的颗粒度,以及工具定义的清晰度。
我们项目里有一个任务规划模块,最初设计是让用户输入自然语言需求,Agent 自动拆解成子任务。实际测试下来,模型经常犯两个错误:
一是拆解过细,把原本一个工具调用就能完成的事拆成了三步;二是忽略依赖关系,让需要前置数据的任务先执行了。
解决思路很简单,但不廉价:显式定义任务的依赖图,让模型只做路由,不做发明。
# 简单的任务规划示例
from typing import List, Dict, Optional
import json

class TaskPlanner:
    def __init__(self, llm):
        self.llm = llm
        # 预定义可执行原子操作,模型不发明新工具
        self.available_tools = {
            "read_log": {"params": ["file_path", "pattern"], "output": "str"},
            "parse_error": {"params": ["log_content"], "output": "dict"},
            "generate_report": {"params": ["error_analysis"], "output": "str"}
        }

    def plan(self, goal: str, context: Optional[Dict] = None) -> List[Dict]:
        """
        输入:用户目标 + 当前上下文
        输出:有序任务列表,每个任务带前置依赖
        """
        prompt = f"""
        目标:{goal}
        当前上下文:{json.dumps(context) if context else 'None'}

        可用工具:
        {json.dumps(self.available_tools, indent=2)}

        请规划执行步骤,要求:
        1. 只使用可用工具,不要发明新工具
        2. 标注每个步骤的前置依赖
        3. 输出 JSON 格式的任务列表
        """

        response = self.llm.chat(prompt)
        # 解析并验证任务依赖关系
        tasks = self._validate_tasks(response, self.available_tools)
        return tasks

    def _validate_tasks(self, response: str, tools: Dict) -> List[Dict]:
        """验证任务列表的合法性"""
        try:
            tasks = json.loads(response)
        except json.JSONDecodeError:
            return self._fallback_plan()

        validated = []
        for task in tasks:
            if task["tool"] not in tools:
                continue  # 跳过未定义工具
            # 检查参数类型匹配
            if not self._check_params(task, tools[task["tool"]]):
                continue
            validated.append(task)

        return validated
工具调用:最容易翻车的环节
工具调用看起来最简单,但实际上踩坑最多。我遇到的主要问题有三类:
第一类:参数传递错误。模型生成的参数格式和工具预期不一致。比如工具需要整数 ID,模型输出了字符串 "123";或者工具需要嵌套结构,模型只传了扁平字段。
第二类:工具失败后的状态丢失。模型调用一个工具失败后,没有记录失败原因,下次调用又重复同样的错误。这在多轮对话里特别致命。
第三类:权限和环境差异。本地能跑的工具,团队协作时因为权限不足或环境变量缺失而失败。
我们项目在排查这个问题时,发现了一个规律:80% 的工具调用失败,根源是工具定义不够严格。我们最初的工具定义是这样的:
# 不严谨的工具定义
def read_log(file_path: str) -> str:
    """读取日志文件"""
    with open(file_path) as f:
        return f.read()
这个定义有几个问题:没有错误处理,没有参数校验,没有类型约束。改成严格定义后:
# 严格定义的工具
from typing import Optional
import logging

logger = logging.getLogger(__name__)

def read_log(
    file_path: str,
    pattern: Optional[str] = None,
    max_lines: int = 1000
) -> dict:
    """
    读取日志文件并可选过滤

    Args:
        file_path: 日志文件绝对路径,必须以 / 开头
        pattern: 正则表达式,用于过滤日志行
        max_lines: 最大返回行数,默认 1000

    Returns:
        {
            "content": str,      # 匹配的日志内容
            "matched_lines": int, # 匹配行数
            "total_lines": int    # 文件总行数
        }

    Raises:
        FileNotFoundError: 文件不存在
        PermissionError: 权限不足
        ValueError: 参数非法
    """
    if not file_path.startswith("/"):
        raise ValueError(f"file_path 必须是绝对路径,收到: {file_path}")

    if max_lines <= 0 or max_lines > 10000:
        raise ValueError(f"max_lines 必须在 1-10000 之间,收到: {max_lines}")

    try:
        with open(file_path, "r", encoding="utf-8") as f:
            lines = f.readlines()[:max_lines]

        if pattern:
            import re
            lines = [l for l in lines if re.search(pattern, l)]

        return {
            "content": "".join(lines),
            "matched_lines": len(lines),
            "total_lines": len(lines)
        }
    except FileNotFoundError:
        logger.error(f"日志文件不存在: {file_path}")
        raise
    except PermissionError:
        logger.error(f"无权限读取: {file_path}")
        raise
改动点有三个:参数类型注解和校验、返回值结构化、异常明确抛出。这三个改动让工具调用失败时,模型能拿到明确的错误信息而不是模糊的异常。
记忆系统:状态管理是隐形的架构负担
很多人做 Agent 项目时忽略了记忆系统,认为"模型自己有上下文就够了"。这个认知的盲区在单轮对话里没问题,一旦进入多轮交互就会暴露。
我们的项目里有个场景:用户让 Agent 分析一周的日志,Agent 调用了七次工具分别读取每天的文件。前六次都成功了,第七次因为上下文过长导致模型开始忘记前面的参数格式,调用失败。
解决方案是引入显式记忆层,把工具调用的中间状态持久化到外部存储:
class AgentMemory:
    def __init__(self):
        self.context = {}
        self.tool_history = []

    def save_tool_result(self, tool_name: str, result: dict):
        """保存工具调用结果,供后续步骤引用"""
        self.tool_history.append({
            "tool": tool_name,
            "result": result,
            "timestamp": datetime.now().isoformat()
        })
        # 提炼关键信息存入上下文
        if tool_name == "read_log":
            self.context["last_log_stats"] = result["matched_lines"]

    def get_context(self) -> dict:
        """返回当前上下文快照"""
        return {
            **self.context,
            "recent_tools": [h["tool"] for h in self.tool_history[-5:]]
        }
失败恢复:区分三类错误的判断标准
Agent 调用失败时,怎么判断是业务逻辑错误、配置错误还是环境问题?这是我们项目里长期争论的问题。我总结的判断标准:
业务错误:模型理解错了用户需求,规划了不合理的任务序列。特征是失败发生在推理阶段,工具本身能正常调用。
配置错误:工具参数不匹配、权限不足、环境变量缺失。特征是错误信息明确,重复调用会复现同样问题。
环境错误:网络超时、依赖服务不可用、资源不足。特征是随机发生,重试可能成功。
排查时的动作链:先看错误类型 → 再查工具调用日志 → 最后定位参数或环境问题。我们项目里用了一套统一的错误码体系,让模型在失败时能自动分类并选择合适的重试策略。
适用边界:什么时候不该做 Agent
Agent 不是银弹。根据我们的实践,以下场景不建议用 Agent:
一是任务确定性高、流程固定的场景,工作流或直接脚本更合适。Agent 的价值在于处理不确定性和需要推理的任务。
二是调用链路超过三步的场景,工具调用越多,失败概率指数级上升。超过三步建议拆分成多 Agent 协作。
三是对实时性要求极高的场景,Agent 的推理延迟通常比直接调用高 3-5 倍。
四是团队成员不具备调试能力的环境,Agent 的问题排查需要一定的技术门槛。
学习路线:先补什么,放什么
回到开头的差异化角度:AI 编程工具从个人试用走向团队协作,最大的断点不在模型能力,而在工程化基础。
我的建议是学习顺序:
先补的:工具定义的严格性、错误处理机制、可观测性设计。这三样是 Agent 从 Demo 走向生产的基础。
暂时放的:复杂的多 Agent 协作、自主学习能力、超长上下文的优化。这些是锦上添花,不是及格线。
我们项目里有个数据:那些能顺利接入团队协作的 Agent,共同特点是工具定义文档化、错误日志结构化、调用链路可追踪。而翻车的项目,普遍在这三方面至少缺两项。
Agent 的核心原理说穿了就三件事:会规划、会用工具、记得住。但要把这三件事做稳,需要的不是更聪明的模型,而是更扎实的工程基础。
真实案例
我们给某电商中台做的日志分析 Agent 就是个典型案例。输入是自然语言需求"分析昨天支付失败日志,找出 Top 5 错误原因",步骤是:先读取日志文件 → 解析错误模式 → 生成报告。可观察结果是:第一版上线后,模型在第二步调用 parseerror 工具时传入了空字符串,导致下游服务 500;排查发现是 memory 没有保存第一步 readlog 的实际返回内容,而是把空的占位符传给了下一步。
这个问题的修复方式是:在 AgentMemory 里增加了对 read_log 返回结果的字段提取,确保后续步骤拿到的是真实数据而非空壳。上线后两周工具调用成功率从 73% 提升到 96%。
排查过程
故障定位时,我们有一套标准化的 debugging 链路。现象层:先观察错误是偶发还是必现,必现的通常是配置或参数问题,偶发的多半是环境波动。验证动作:看工具调用日志,确认每一步的输入输出是否匹配定义;抓 LLM 的原始回复,判断是规划错误还是执行错误。排除结果:如果是 JSON 解析失败,回退到默认规划;如果是参数类型不匹配,检查工具定义的 type hint 和模型的生成逻辑是否一致;如果是权限问题,统一收口到 service account。
我们项目里用了一套错误码体系,把排查过程固化下来。模型调用工具失败后会自动携带错误码,人工介入时直接按码分类处理,不用重新走一遍诊断流程。
代码解释
下面对三段关键代码做 code walkthrough,逐一讲清输入、核心逻辑、输出和异常处理。
TaskPlanner:任务规划入口
这段代码实现了任务规划的入口逻辑。输入是用户的目标字符串 goal 和可选的上下文 context,输出是一个有序的任务列表,每个任务都带有前置依赖标注。核心逻辑在于 prompt 的构造:我们把可用工具列表以 JSON 形式注入提示词,要求模型只使用预定义工具,不得发明新工具。这样的约束能显著降低模型的幻觉率。
validatetasks 方法负责校验模型返回的 JSON。解析失败时调用 fallbackplan 返回默认规划,这是一种防御性编程——不能因为模型输出异常就让整个流程挂掉。遍历阶段会过滤掉未定义的工具调用和参数类型不匹配的任务,最终只保留合法的部分。这种设计把灵活性交给了提示词工程,把可控性留在了代码层。
read_log:严格工具定义
这个函数展示了什么是严格的工具定义。输入包括三个参数:filepath(必填绝对路径)、pattern(可选正则过滤)、maxlines(默认 1000)。输出不是原始字符串,而是一个结构化字典,包含内容、匹配行数和总行数。这样设计的好处是调用方可以直接消费字段,不需要二次解析。
异常处理是这段代码的重点。参数校验阶段会提前拒绝非法输入,比如非绝对路径或越界的 max_lines,抛出 ValueError 让模型知道哪里错了。文件操作阶段捕获 FileNotFoundError 和 PermissionError,记录日志后重新抛出,这样上层可以区分"文件不存在"和"权限不足"两类错误。对于模型来说,明确的错误信息比模糊的异常更容易做出正确的恢复决策。
AgentMemory:记忆管理
AgentMemory 的实现原理是"选择性持久化"。输入是工具名称和调用结果,核心逻辑是两条写入路径:所有结果都追加到 toolhistory 历史记录,但只有 readlog 的结果会被提炼关键信息存入 context。这种设计避免了记忆膨胀——不存原始响应,只存后续步骤真正需要的字段。
get_context 方法返回当前上下文快照,合并了业务上下文和最近 5 条工具调用历史。这里用了切片 [-5:] 而不是全部保留,因为过长的历史记录会挤占模型的上下文窗口,反而降低质量。记忆是有代价的,省着点用。
失败原因
常见错误可以归为三类,区分方法看失败特征。业务错误的特征是:工具能正常调用,但结果不符合预期。比如模型把文件路径传成了目录名,或者在不需要参数时传了多余字段。这类错误通常源于 prompt 不够清晰或上下文歧义。
配置错误的特征是:错误信息明确,重复调用必然复现。比如权限不足、环境变量缺失、参数类型不匹配。这类问题在单人 Demo 阶段可能不暴露,因为个人账号有全量权限,但团队协作时不同成员的权限粒度不同就会翻车。
环境错误的特征是:随机发生,重试可能成功。比如网络抖动、依赖服务瞬时不可用、资源竞争导致的超时。这类问题最难排查,因为复现条件不确定,需要靠错误码和日志关联来分析。
适用边界
Agent 的局限性需要诚实面对。适用场景是:任务有不确定性、需要多步推理、工具链复杂且需要动态编排。限制条件是:调用链不宜超过三步,否则失败概率指数上升;团队成员需要具备一定的调试能力,否则故障排查成本会压垮收益。
取舍在于:Agent 带来的灵活性是以工程复杂度为代价的。如果你的任务流程固定、工具调用确定,工作流编排或直接脚本更合适。只有当任务需要动态决策、工具选择依赖于中间结果时,Agent 才是正解。什么时候不该照搬方案?当你的团队缺乏可观测性基础设施、或者任务链路过长且稳定时,不要强行上 Agent。
总结
本文完成了关键概念、工程实践和落地建议的梳理。Agent 从 Demo 到生产的鸿沟不在模型智商,而在工程底座。工具定义严格、记忆系统克制、错误处理明确,这三样补齐了,团队协作时的工具调用成功率才会真正上来。
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
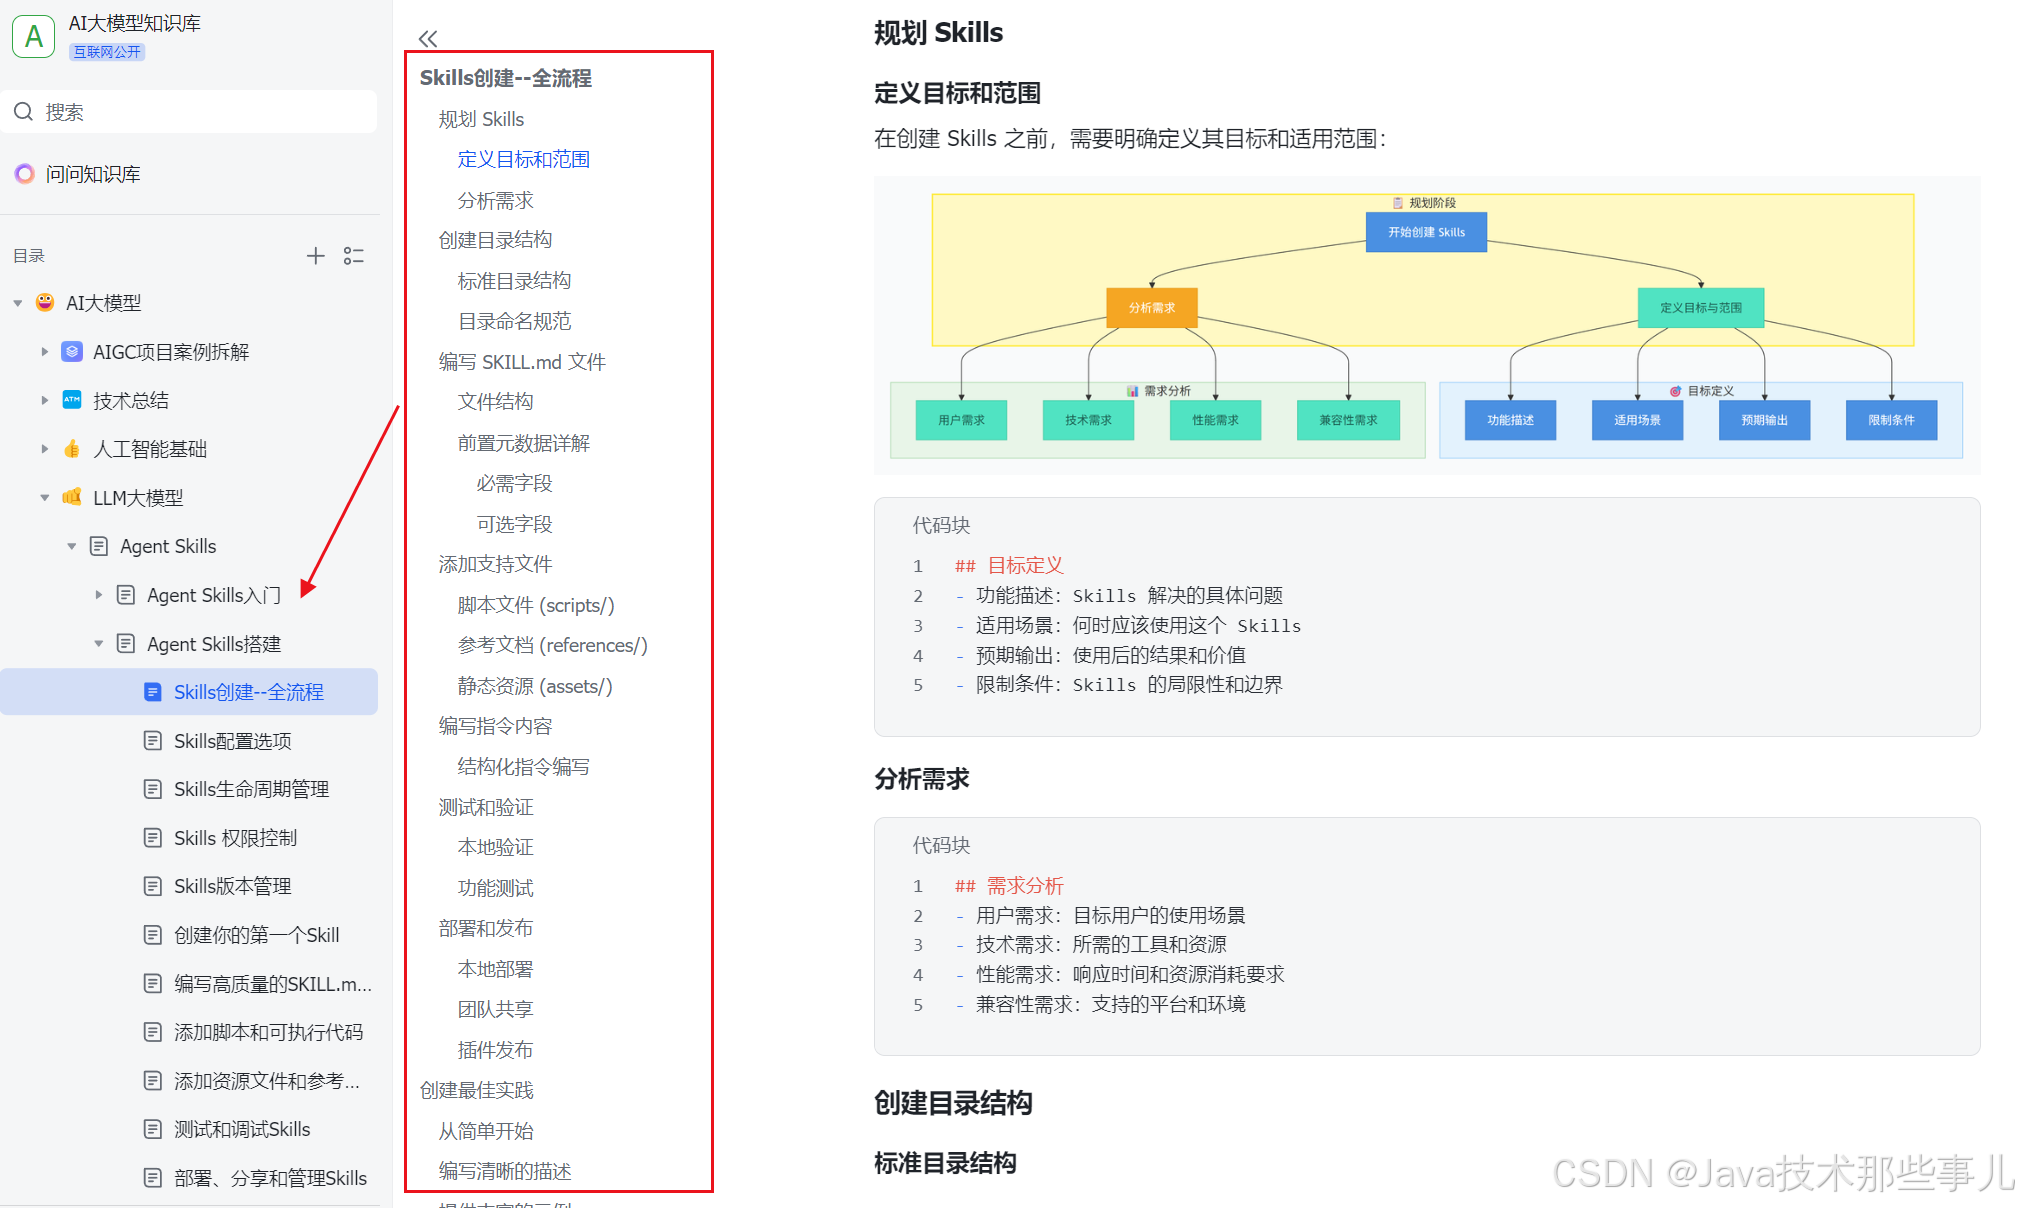
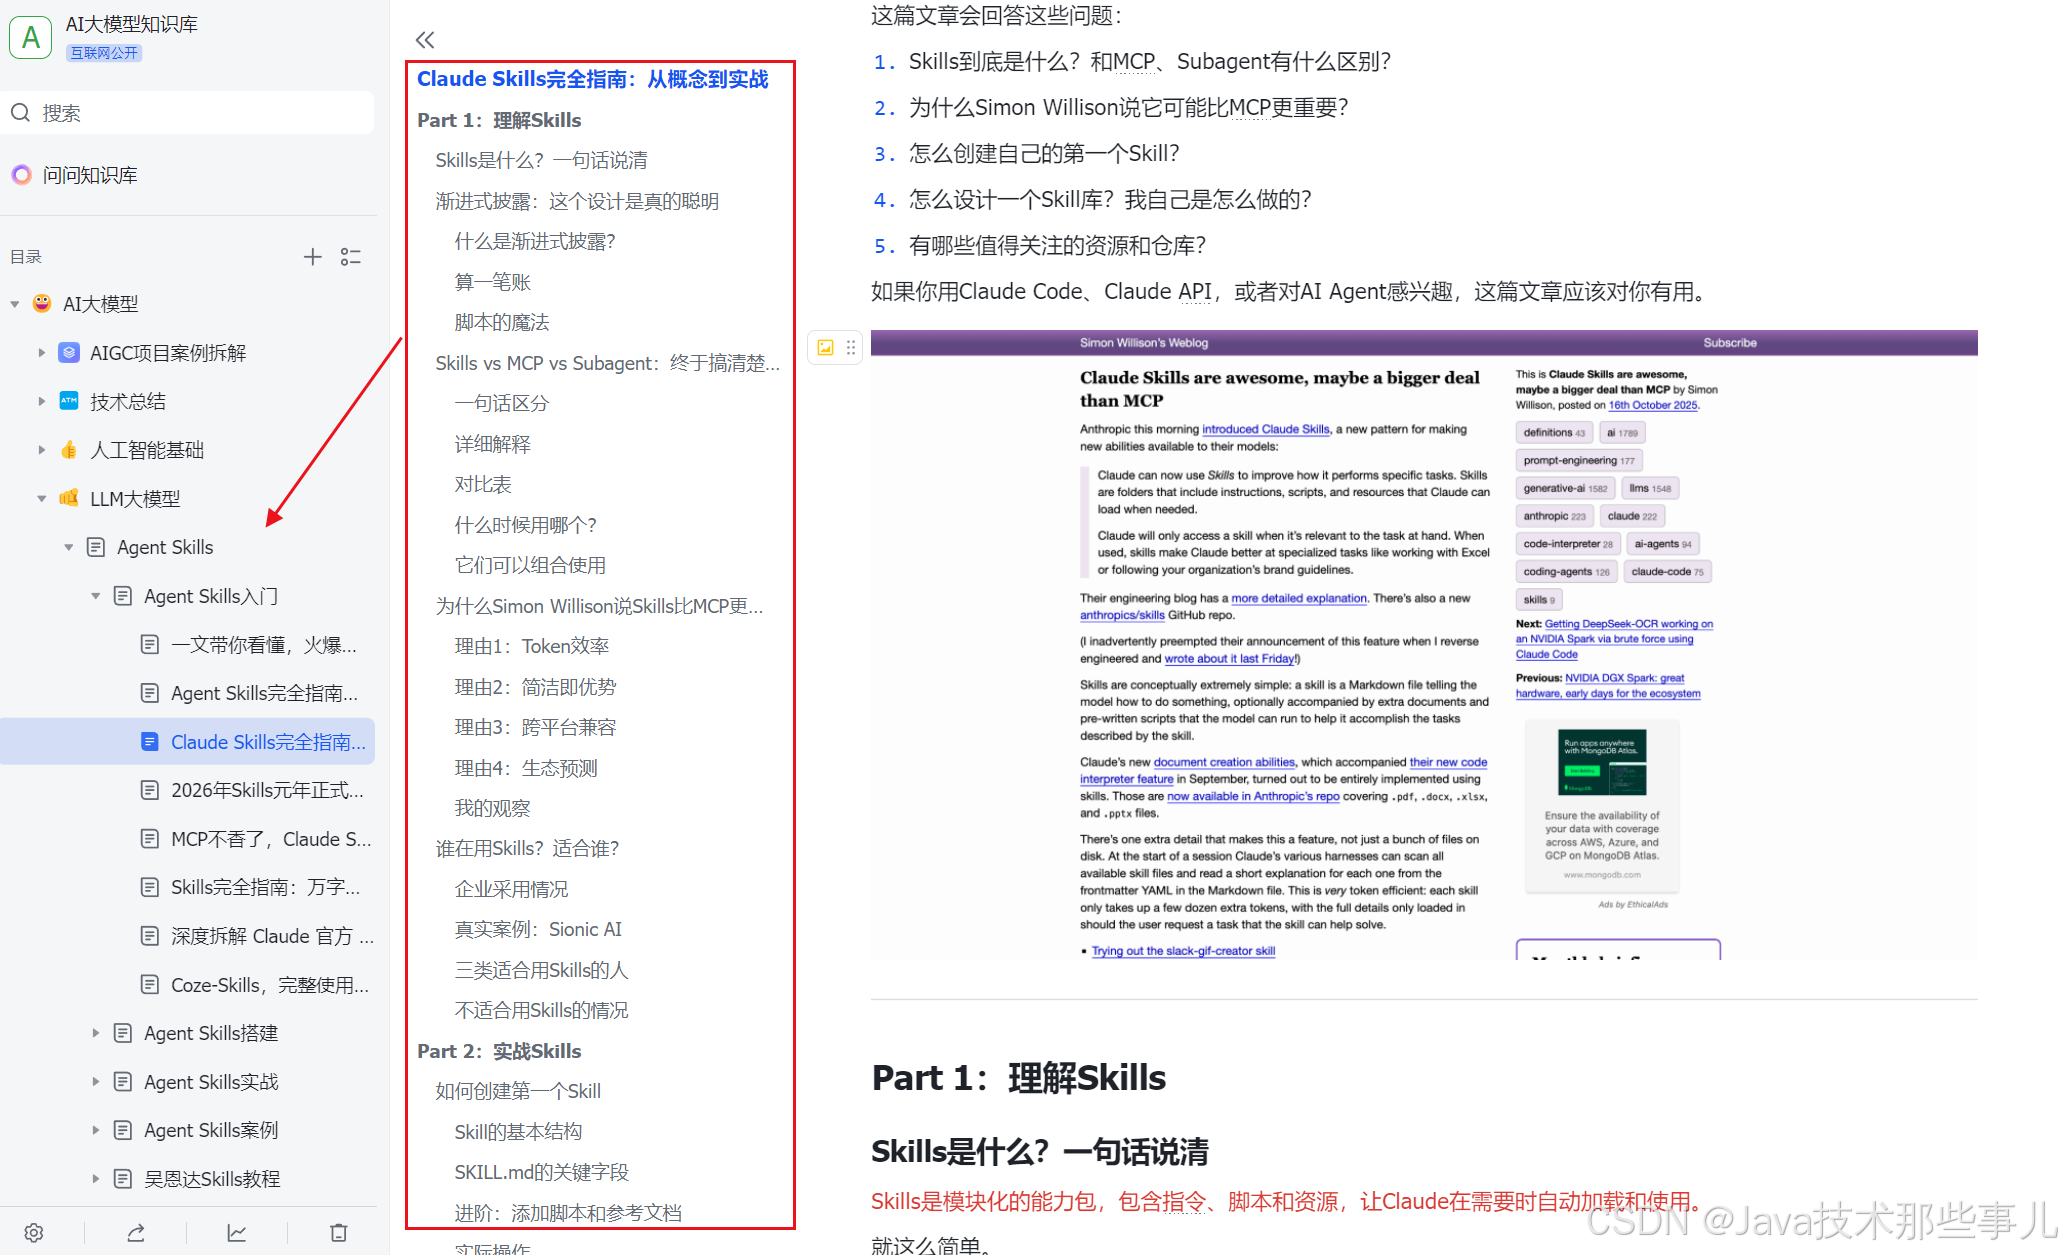
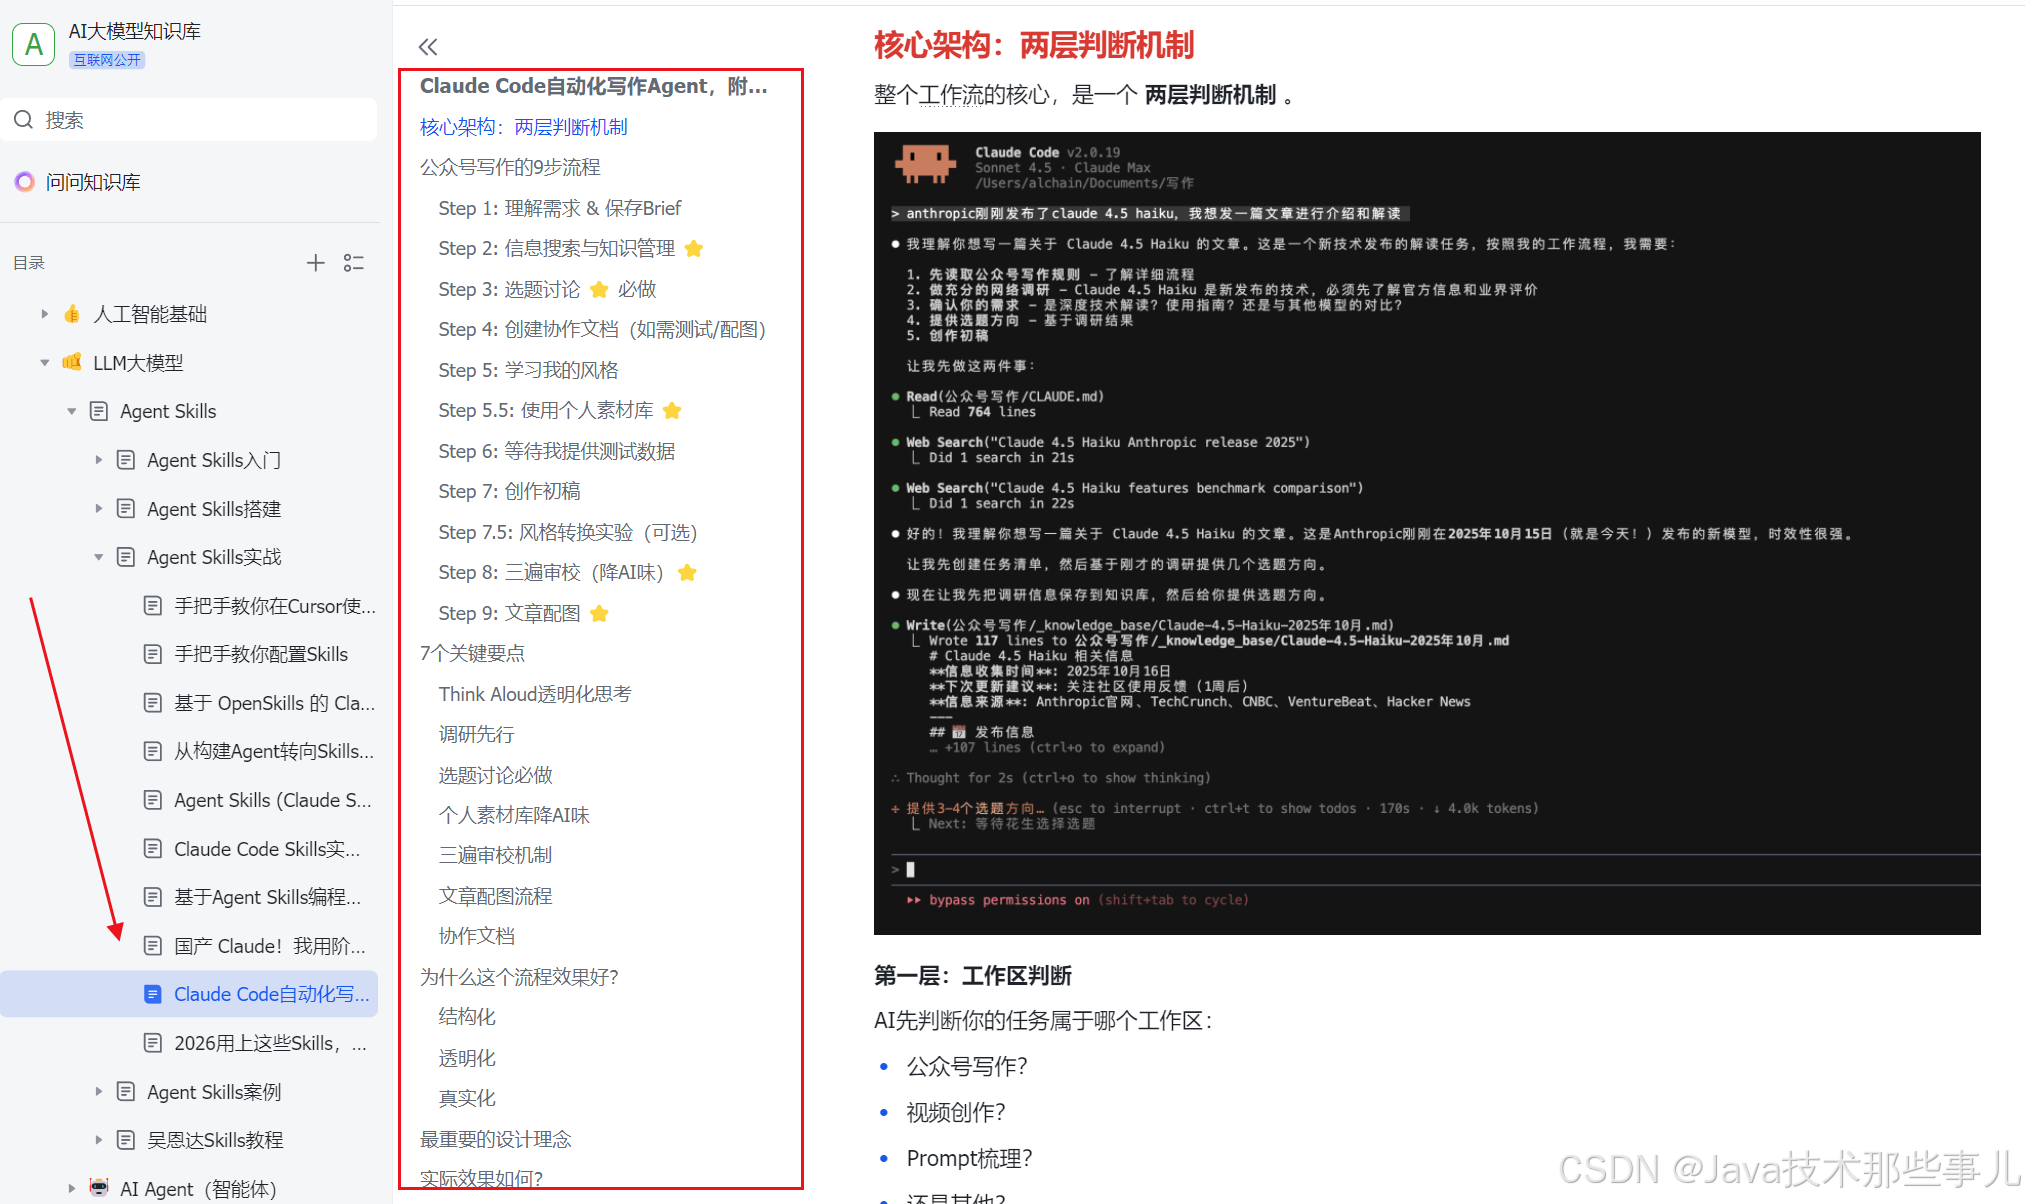
如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。
 314


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


