为什么你的Agent项目能跑通,上线第一天却崩在权限和日志上

Oracle EBS的帐套由“4C”构成,而华为MetaERP将其发展为“6C” 华为MetaERP从OracleEBS的"4C"架构升级为"6C",实现核算理念革新。核心突破在于将会计科目、核算维度和核算单元解耦,形成"科目表+维度库"的灵活架构。新架构优势显著:1)科目回归会计本质,管理维度独立扩展;2)支持无限维度的精细化核算;3)实现数据权限隔离和内部交易自动化;4)采用元数据驱动设计,为AI应用奠定基础。这一平台化架构解决了大型企业在全球化、多元化发展中的核算难题,相比传统架构具有更强的灵活性和扩展性。 阅读详情

聊《程序员职业规划不只看课程,项目证据才是分水岭》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。

摘要

从一个人写Demo到团队交付生产环境,大模型应用的门槛发生了质的变化。很多人以为掌握了RAG、Agent框架就是入行AI的门票,但2026年的真实情况是:面试官和团队真正在意的,是你是否处理过权限校验、日志追踪和可观测性这些"不性感"的工程细节。本文结合一次真实翻车经历,拆解从Demo到上线的关键能力断层,给出从Java后端向大模型转型的可执行路径。

---

目录

  • 岗位趋势:大模型应用正在脱离Demo阶段
  • 一次翻车复盘:Demo能跑通不等于能上线
  • 真实案例:实习生的一天
  • 排查过程:三个问题是怎么浮出水面的
  • 失败原因:业务错误、配置错误、环境错误的区分方法
  • 代码解释:追踪日志模板
  • 适用边界:什么时候这套方法有用,什么时候不该照搬
  • 能力分层:你现在在哪一层?
  • 短期学习计划:先补什么,后补什么
  • 中期项目沉淀:用可复现的证据说话
  • 长期竞争力:权限、日志、可观测才是真正的护城河
  • 总结

---

岗位趋势:大模型应用正在脱离Demo阶段

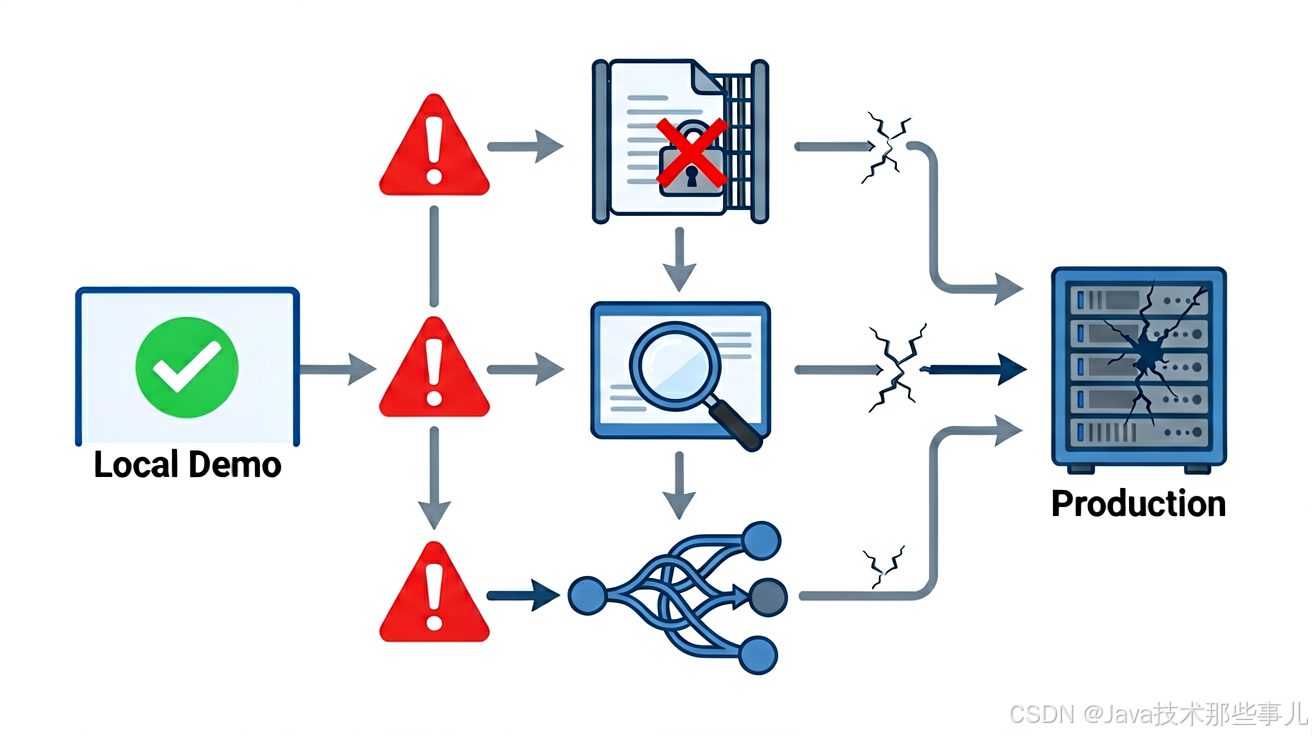
文章插图 1

过去两年,大模型赛道最火爆的话题是"谁能做出最炫的Agent Demo"。谁会用LangChain搭一个聊天机器人,谁会接一个RAG检索增强,谁就会写提示词工程。这些能力在今天确实还有价值,但它们正在快速贬值。

2026年的招聘市场给出了一个明确信号:岗位JD里越来越频繁出现"权限管控""日志追踪""可观测性设计"这类关键词。这不是HR在凑字数,而是业务方真的被Demo阶段的假象骗惨了。

我最近看了一些团队的真实反馈,发现一个共同点:很多候选人简历上写着"独立开发了一款基于LangGraph的智能客服Agent",但面试问到"你的Agent在团队项目中怎么控制权限"时,大部分人的回答停留在"我用了一个if判断"或者"我没想过这个问题"。

这就是现状:Demo阶段的竞争者很多,能跨过生产门槛的人很少。

---

一次翻车复盘:Demo能跑通不等于能上线
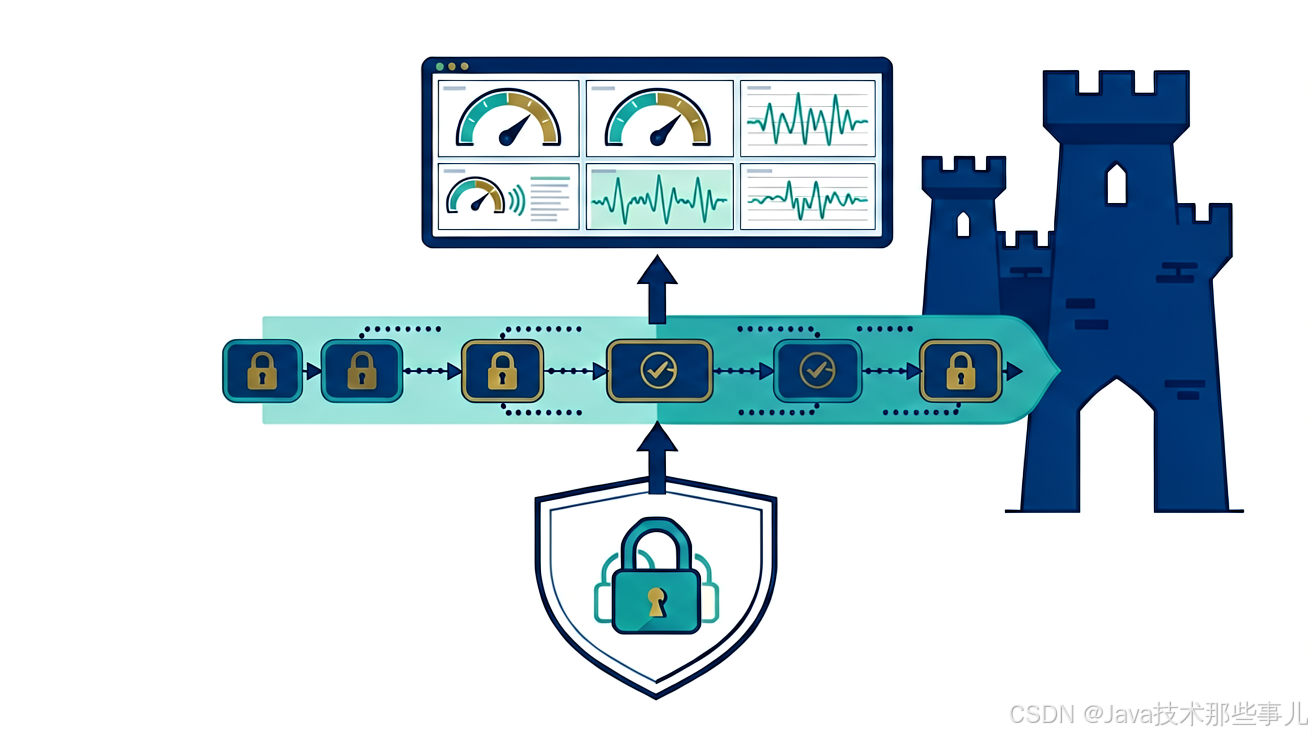
文章插图 2

去年我带一个实习生做一个内部知识问答Agent。他一个人花了两周时间,基于Hermes框架搭了一个完整的RAG系统,本地测试效果很好,检索准确率达到90%以上,他以为自己已经准备好进入团队项目了。

团队接入的第一天,问题就来了。

第一个问题出在权限上。这个Agent接入了公司内部的知识库,但实习生没有做任何访问控制。这意味着任何拿到API Key的人都能通过它访问所有文档,包括薪酬制度和人事档案。安全团队直接把这个服务下线了。

第二个问题出在日志追踪。团队要求这个Agent的每一轮对话都能追溯到具体的输入、输出和模型调用参数,方便后续排查。但实习生的代码里没有任何结构化日志,出问题后完全不知道是哪个环节出了问题。

第三个问题出在Prompt版本管理。实习生修改Prompt的方式是直接改代码里的字符串,没有任何版本控制,团队其他成员也改了自己版本的Prompt,最后整个系统跑出来的结果不一致,谁也说不清哪个是对的。

这三个问题加在一起,直接把一个"看起来完成了"的项目打回了零分。

---

真实案例:实习生的一天

把时间线拉长,看看那天到底发生了什么。

背景:实习生小张,Java后端出身,跟着我做了两周的内部知识库问答Agent。系统基于Hermes框架,接入了公司内部的Confluence和SharePoint两个数据源,使用BGE-M3做Embedding,部署在内网测试环境。

输入:测试用户请求"帮我查一下Q3的研发预算分配",这是一个涉及财务敏感信息的查询。

步骤:
1. 用户通过内部测试页面提交请求
2. Agent接收请求,直接转发给向量数据库检索,没有做用户身份校验
3. 检索返回了包含薪酬数据的文档片段
4. LLM基于检索结果生成了回答
5. 回答被直接返回给用户,没有任何脱敏处理

可观察结果:

  • 检索准确率达到90%以上(本地测试指标)
  • 系统响应时间约1.2秒
  • 但任何持有API Key的人都能发起同样的查询,包括外包人员和离职员工
  • 没有任何日志记录这次请求的trace_id、用户身份或模型调用参数
  • Prompt文件存在代码仓库根目录,没有人知道谁修改过,也没有版本哈希

这个案例的问题不在于技术实现有多复杂,而在于小张完全没有考虑权限隔离和可追溯性。他用一个周末就能跑通的技术栈,去承接了一个需要多人协作、有安全约束的生产级需求。这中间的断层,就是Demo思维和工程思维的差别。

---

排查过程:三个问题是怎么浮出水面的

那次翻车之后,我们做了三轮排查,每轮发现一个新问题。我把排查链路整理出来,方便你在遇到类似情况时参考。

第一轮排查:权限漏洞

现象:安全团队扫描发现内部知识库Agent存在未授权访问风险。

验证动作:

  • 直接用curl命令调用API,不携带任何认证信息,成功返回了知识库文档
  • 检查代码仓库,确认没有任何RBAC或ABAC的实现
  • 对比团队其他服务的权限模型,发现差距巨大

排除结果:不是网络层的问题,不是防火墙配置的问题,纯粹是应用层缺失权限校验逻辑。

第二轮排查:日志缺失

现象:用户反馈回答不准确,但无法定位是哪一步出了问题。

验证动作:

  • 检查日志文件,发现只有应用启动和关闭的记录,没有任何请求级别的日志
  • 尝试通过数据库查询回溯,但向量数据库没有存储查询历史
  • 手动添加临时日志,才发现Prompt版本和模型调用参数根本没有被记录

排除结果:不是日志级别设置的问题,不是日志采集 agent 的问题,是根本没有设计日志方案。

第三轮排查:Prompt版本混乱

现象:同一份代码,不同的人运行结果不一致。

验证动作:

  • 对比三个团队成员本地的Prompt文件,发现至少有4个不同的版本
  • 检查Git历史,Prompt文件没有被纳入版本控制
  • 尝试还原到某个时间点的版本,但无法确定哪个版本是"对的"

排除结果:不是LLM随机性的问题,不是检索结果波动的问题,是版本管理完全缺失。

这个过程花了大约三天。如果一开始就有权限校验框架和结构化日志,这些问题可能在Code Review阶段就能被发现,而不是上线之后才暴露。

---

失败原因:业务错误、配置错误、环境错误的区分方法

那次翻车之后,我总结了一套区分错误类型的方法,后来在带其他人的过程中验证过,确实有效。

业务错误是指逻辑本身的问题。比如RAG检索出来的内容与用户问题无关,或者Agent做了错误的决策路径。这类错误通常表现为结果不符合预期,但不会报错,排查最难。定位方法是:把输入固定下来,逐层打印中间结果,看哪一步的输出偏离了预期。

配置错误是指参数或环境变量不对。比如模型选错了、API Key配错了、Embedding模型和文本模型不匹配。这类错误的特点是报错信息通常很明确,或者结果呈现某种规律性的偏差(比如所有输出都一样,或者全部返回空值)。定位方法是:先检查配置文件和环境变量,再对比官方文档的默认值。

环境错误是指部署层面的问题。比如服务间网络不通、权限不足、依赖版本冲突。这类错误的特点是本地运行正常,一部署到团队环境就崩。定位方法是:把本地环境和生产环境的环境变量、依赖版本、网络策略逐一对比。

用这三个维度去拆解问题,就不会陷入"反正就是跑不通"的无力感。

下面这段代码是我后来在团队里推广的简单日志模板,用于追踪Agent的每轮对话:

import logging
import uuid
from datetime import datetime

logger = logging.getLogger("agent_trace")
logger.setLevel(logging.INFO)
handler = logging.FileHandler("agent_traces.log")
formatter = logging.Formatter("%(asctime)s | %(message)s")
handler.setFormatter(formatter)
logger.addHandler(handler)

def trace_agent_call(user_id: str, question: str, answer: str, model: str, latency_ms: int, error: str = None):
    trace_id = str(uuid.uuid4())[:8]
    timestamp = datetime.now().isoformat()
    log_entry = (
        f"trace_id={trace_id} | "
        f"user={user_id} | "
        f"model={model} | "
        f"latency={latency_ms}ms | "
        f"q={question} | "
        f"a={answer} | "
        f"error={error}"
    )
    logger.info(log_entry)
    return trace_id

这段代码不复杂,但它解决了一个关键问题:当团队里五个人同时改Prompt、调参数的时候,你能通过trace_id回溯到具体是谁在什么时候做了什么改动。

---
优快云资料领取方式

代码解释:追踪日志模板

上面那段代码虽然短,但有几个关键设计值得拆开来看。

第一部分:日志器初始化

logger = logging.getLogger("agent_trace")
logger.setLevel(logging.INFO)
handler = logging.FileHandler("agent_traces.log")
formatter = logging.Formatter("%(asctime)s | %(message)s")
handler.setFormatter(formatter)
logger.addHandler(handler)

这里用getLogger("agent_trace")创建一个命名日志器,而不是用默认的根日志器。这样做的好处是可以在后续代码中按名字精确控制日志行为,比如单独调整某个模块的日志级别,而不影响其他部分的日志输出。

FileHandler把日志写入文件,Formatter定义了输出格式。时间戳和管道符分隔的结构化格式是为了方便后续用命令行工具(比如grep、awk)或者简单的日志解析脚本做分析。如果项目规模更大,这里应该换成JSON格式,方便接入ELK或Loki等日志平台。

第二部分:追踪函数

def trace_agent_call(user_id: str, question: str, answer: str, model: str, latency_ms: int, error: str = None):
    trace_id = str(uuid.uuid4())[:8]
    timestamp = datetime.now().isoformat()
    log_entry = (
        f"trace_id={trace_id} | "
        f"user={user_id} | "
        f"model={model} | "
        f"latency={latency_ms}ms | "
        f"q={question} | "
        f"a={answer} | "
        f"error={error}"
    )
    logger.info(log_entry)
    return trace_id

这个函数的输入是六个参数:用户ID、问题、答案、模型名称、耗时和可选的错误信息。核心逻辑是用UUID的前8位生成一个短traceid,把关键信息拼成一行日志写入文件,最后返回traceid供调用方使用。

异常处理方面,这个版本是最低限度的——它没有捕获异常,意味着如果函数内部出错,调用方会立刻感知到。这在开发阶段是合理的,因为你不希望日志记录本身掩盖了真正的bug。但在生产环境中,你应该在函数外层加try-except,确保即使日志记录失败,也不影响主流程。

一个常见的改进方向是把trace_id注入到请求上下文里(比如用contextvars),这样在异步调用的多层嵌套中也能保持一致的追踪链路,而不需要每层都手动传递。

---

适用边界:什么时候这套方法有用,什么时候不该照搬

这篇文章讨论的思路来自一个内部知识库问答场景,它有明确的适用边界,不能无脑套用到所有Agent项目上。

适用场景:这套方法最适合以下情况——你正在把一个单个开发者能完成的Agent Demo,升级成团队共同维护的生产级服务;系统需要接入公司内部数据或API;需要支持多用户并发访问;或者需要在出现问题时能快速定位是哪个环节出了错。如果你的项目属于这几类,权限校验、结构化日志和可观测性设计就是你必须跨过的门槛。

限制条件:首先,这套方法的成本不低。加上完整的权限控制和日志追踪,开发时间通常会增加30%到50%,尤其是在项目初期没有预留架构设计的情况下。其次,如果团队规模很小(比如三五个人),且内部信任度高,过度工程化的权限体系反而会成为负担。最后,日志量会随调用量线性增长,如果没有限流或采样策略,存储和检索成本会迅速上升。

取舍:在实际项目中,我倾向于先做最小可行方案——用一个简单的用户ID透传加trace_id日志,而不是立刻上完整的RBAC或Jaeger链路追踪。权限体系可以分阶段演进:第一周加用户ID透传,第二周加角色判断,一个月后再评估是否需要细粒度的ABAC。同样的,日志可以先用文件+grep的方式,等调用量上来再迁移到集中式日志平台。不要一开始就追求完整方案,先用最简单的机制跑起来,再根据实际痛点迭代。

什么时候不应照搬:如果你在做的是一个纯探索性的技术验证,用户量不超过10人,数据不涉及敏感信息,那就没有必要花时间去搭建完整的权限和日志体系。这时候过度工程化只会拖慢进度。另外,如果你的Agent是纯前端交互、不接入任何后端数据源,权限问题也不存在,重点应该放在用户体验和响应延迟上,而不是日志追踪。最后,如果你所在的团队已经有成熟的基础设施(比如统一的认证网关、日志平台和链路追踪系统),你的工作应该是适配而不是重建,直接在现有体系上挂上即可,不需要自己重新实现一套。

理解这些边界,能让你在不同阶段做更合理的决策,而不是机械地套用某一种"最佳实践"。

---

能力分层:你现在在哪一层?

我把大模型相关岗位的能力分成四层,你在哪一层决定了你能应聘什么级别的岗位。

第一层:会用框架。知道怎么用LangChain、Hermes、LangGraph搭一个简单的Agent,能跑通官方教程。这个层级的人很多,但竞争力很弱,因为Demo能力正在快速通胀。

第二层:能做定制。知道怎么调整Prompt、怎么选Embedding模型、怎么处理检索召回率低的问题。这个层级的人开始有差异化,但还集中在单机场景。

第三层:能做多Agent协作。理解Agent之间的通信方式、任务拆分策略、结果合并逻辑。这个层级的人已经开始触碰团队协作的真实场景,是2026年大多数中等规模团队在招的人。

第四层:能做生产化设计。理解权限管控、日志追踪、可观测性、灰度发布、回滚策略。这个层级的人很少,但也是团队真正稀缺的。如果你能达到这一层,简历上的任何一个项目都应该围绕这些能力来组织,而不是堆砌框架名称。

---

短期学习计划:先补什么,后补什么

针对Java后端转型的同学,我的建议是不要一上来就啃LangGraph或者GraphRAG的理论。那些东西等你有项目经验之后再学,效率会高得多。

前两周,先把权限和日志这两个短板补上。具体做法是:挑一个你已经跑通的小项目,给它加上结构化的日志追踪和简单的角色权限控制。不需要复杂,一个基于用户ID的权限判断就够了,重点是让你习惯"每个请求都要有trace_id"这个思维。

接下来的两周,学习怎么设计可观测性。不需要上复杂的链路追踪系统,先用日志把关键节点串起来:用户输入、检索结果、模型调用、最终输出。每一层都要记录输入和输出,这样出问题的时候才能快速定位。

再之后,你可以去研究Agent之间的协作模式。LangGraph适合有明确状态机的场景,纯函数式调用适合简单的串联流程,你不用一开始就选最复杂的方案。

---

中期项目沉淀:用可复现的证据说话

简历上写"做过一个Agent项目"是没有说服力的。面试官想看到的是:你在一个接近真实场景的项目里,解决了哪些只有工程化经验才能发现的问题。

我推荐你做这样一个项目:一个内部知识库问答系统,接入两个以上的数据源,支持多轮对话,有权限控制,有完整的日志追踪。这个项目不需要界面漂亮,但一定要有这三样东西:权限校验逻辑、结构化日志输出、以及一个可以演示的回溯工具。

在GitHub上,你可以放两个README:一个是给面试官看的,讲清楚项目的设计思路和解决的关键问题;一个是给同学看的,讲清楚怎么复现、踩了哪些坑。这种写法本身就证明了你具备工程化思维。

---

长期竞争力:权限、日志、可观测才是真正的护城河

回到最初那个问题:为什么大模型时代的程序员职业规划需要重新设计?

因为过去的竞争焦点是"谁会调API、谁会写Prompt",这些能力在模型能力快速提升的背景下正在快速贬值。未来的竞争焦点是"谁能把模型能力安全、可控、可追踪地集成到业务系统里",这是一个更偏向工程化和架构设计的能力。

权限控制、日志追踪、可观测性设计——这三个能力在任何AI项目里都是刚需,不会因为哪家模型更强而消失。它们是2026年及以后程序员职业规划里最值得投入的长期能力。

---

总结

大模型时代的职业规划,核心变化在于:Demo能力的溢价在下降,工程化能力的溢价在上升。

你不需要放弃LangChain或者LangGraph的学习,但你一定要在某个时间点停下来,问自己一个问题:我的项目有没有处理过权限、日志和可观测性?如果没有,你离真正的团队交付还有一段距离。

这次翻车经历让我明白了一件事:面试官问"你的Agent怎么控制权限"不是在难为你,而是在确认你有没有真正做过能上线的东西。回答这个问题之前,先确保你自己项目里已经回答过它。

资料展示

下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
AI大模型资料展示 1

AI大模型资料展示 2

AI大模型资料展示 3

AI大模型资料展示 4

AI大模型资料展示 5

如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。
优快云官方大礼包

架构师之HBase vs MongoDB 技术选型与场景决策实战案例 面对海量数据和高并发查询,该选 HBase 还是 MongoDB?本文为你提供完整的决策框架!从数据模型对比、架构解析、六大真实场景(电信 CDR、金融行情、广告点击流、电商商品、社交档案、内容管理)到性能、一致性、运维全面对比,助你在 PB 级时序数据和灵活查询之间做出精准选择! 阅读详情

相关推荐

raw_count、tpm、fpkm、rpkm如何选择

转录组测序中常见的数据类型有:raw_count、tpm、fpkm、rpkm。本文进行简单辨析: 一、概念 1 raw_count RNA-seq数据中,raw_count一般是指mapped到基因外显子区域的reads数目。比如说htseq,STAR,或者RSEM等NGS分析流程计算产生的counts值。其中RSEM(RNA-Seq by Expectation-Maximization),考虑到一条read 可能会匹配多个exon位置,故而其产生的为expected_count。 2 TPM

weixin_59289660的博客 1万+

LangChain Agent能跑通,为什么上线第一天就崩在权限和日志?

做过LangChain项目的都知道,调个API、写个Chain,两小时就能跑出能演示的结果。但真正接进业务系统、交给你带的人或者上线之后,问题才一个个冒出来。我第一次栽跟头,是因为以为"能跑就行"——实际上,Demo和线上之间隔着权限、日志、错误处理这三道坎。这篇文章把我当时的排查过程、踩过的坑、以及最终的取舍路线拆清楚,希望能帮你少走弯路。LangChain确实降低了构建AI应用的门槛,但它也给项目引入了新的复杂性——尤其是权限、日志、错误处理这些"看不见的部分"。

老男孩的架构路 464

c++ mysql_init 返回无效指针_C++操作MYSQL遇到的一些问题

首先 我使用的是 vcpkg上面是我装的一些库《大大安利vcpkg 安装时一定要使用powershell进行编译装上vcpkg后装ligmariadb这个库,这个对Mysql操作还是挺方便的,然后说一下 在装库时碰到的一些问题1.网络问题1.参考了一下 github上的答案 将下载失败的url拷下来 自己下 然后再重新开始安装《vcpkg在安装时每一个需要下载的 都会提供url-仔细找,2.这个问...

weixin_32176627的博客 681

为什么我的Agent上线就崩?权限日志比调API更重要

很多人以为大模型就业就是会调API、会写Prompt就能搞定,但真实企业环境里,一个Demo跑通的Agent上线时,最先崩的往往不是模型推理,而是权限混乱和日志缺失。本文从一个真实的踩坑经历出发,拆解权限控制、日志追踪和可观测性为什么是大模型工程师真正的硬门槛,并给出具体的技能学习顺序和求职建议。大模型就业确实有机会,但机会不在"会调API"的人手里,而在能把Demo变成生产级系统的工程师手里。权限、日志、可观测性,这些听起来不性感,但却是企业真正在意的能力。

资料免费分享,点击名片 350

MineMap开发教程: 北斗网格位置码实时调度技术详解

本文介绍了MineMap4.0引擎中北斗网格位置码的实时调度技术。北斗网格位置码是我国自主研发的空间位置编码标准,具有层次化结构、三维编码等特点。MineMap4.0通过BeiDouGrid类实现了高效的实时调度机制,重点展示了按预想高度进行网格调度的核心功能。关键技术包括视锥体裁剪、LOD控制、高度筛选算法和交互式查询等。该技术在智慧城市、环境监测等领域具有广泛应用前景,凭借高性能、高精度等优势,为三维地理信息可视化提供了有力支撑。

weixin_42568040的博客 1453

使用Kettle进行数据同步(增量)

文章目录kettle介绍kettle安装kettle使用使用kettle同步关系型数据库数据(MySQL示例)1. 创建一个转换2. 选择表输入3. 格式转换4. 执行脚本5. 创建job使用kettle同步NoSql数据(MongoDB示例)创建转换时的注意事项MongoDBInput怎么创建job的创建如何在Linux上面运行已经创建好的job?1、把创建好的job传输到Linux机器上面2、编辑kjb文件3、执行任务 kettle介绍 Kettle 是一款国外开源的 ETL 工具,纯 Java 编写

JenKin的博客 7351

Agent跑通Demo后,团队接手就崩了:我的权限和日志踩坑复盘

摘要:大模型应用从 Demo 到上线,最大的鸿沟不是模型能力,而是权限、日志和可观测性。本文复盘一个真实 Agent 项目踩坑经历,说明错误假设如何被推翻,以及计算机专业学生该如何重新规划准备方向。目录为什么 Demo 跑通不等于能上手真实案例:Agent 上线第一天的崩塌排查过程:从现象到根因的完整链路代码解释:权限和日志的关键实现失败原因:业务、配置、环境三者的区分基础课价值:被低估的操作系统和网络AI 应用项目:从 Demo 到可观测的取舍。

2601_96285276的博客 312

Windows 2012 SYSVOL复制失败的处理

题外话:晓原理、知架构、查日志是排错的三件法宝今天在DC1上新建并链接了一个组策略对像,在客户端刷新时,却报下面的错误:“处理组策略失败。Windows无法应用组策略对象LDAP….”如下图所示:于是在客户端用\\domain.com访问,发现\\domain.com\SYSVOL\domain.com\policies下面没有上面报错的组策略对象。这是怎么一回事呢,pin...

weixin_33989780的博客 1669

Agent跑通Demo后团队接手就崩:权限和日志才是Java转大模型的真门槛

去年带团队做Agent项目,Demo阶段一切顺利,上线后权限校验漏了、日志查不到、调用链断了,Java后端的工程习惯反而成了"负资产"——因为大家以为写代码和工程化是两回事。这篇文章复盘从需求评审到验收标准的一次完整过程,重点讲权限、日志、可观测这三个"看起来和模型无关"的问题,以及Java开发者怎么把优势迁移过来。Java转大模型,最大的优势是工程化能力,最大的风险是把工程化能力用错地方。Demo能跑通,不代表能上线。权限、日志、可观测性,这三个"看起来和模型无关"的问题,才是真正的门槛。

2601_96285276的博客 335

嵌入式工程师必看:BLDC电机驱动电路设计全流程(附MOS管选型指南)

本文为嵌入式工程师提供了BLDC电机驱动电路设计的全流程实战指南。文章深入解析了三相全桥逆变电路的核心原理,并重点阐述了功率MOSFET的选型关键参数,如Vds、Rds(on)和Qg。同时,详细介绍了栅极驱动设计、PCB布局布线要点及调试安全步骤,旨在帮助开发者构建稳定高效的BLDC驱动系统。

weixin_29194817的博客 591

嵌入式Zephyr RTOS面试题及参考答案

在Zephyr中,为自定义外设编写Devicetree绑定(Bindings)有助于内核理解设备树中自定义外设节点的含义和属性。首先,需要创建一个.yaml格式的绑定文件,通常存放在目录下对应的子目录中,文件名应能反映外设的类型和功能。绑定文件的开头要定义基本信息,包括字段,用于简要描述外设的功能和用途;compatible字段,它是一个字符串列表,用于匹配设备树中自定义外设节点的compatible属性,设备树节点和绑定文件通过这个字段关联起来。接下来,要定义外设节点的属性。使用properties。

大模型大数据攻城狮的专栏 988

Agent联调崩了三次:Demo跑通后,权限和日志才是真门槛

很多程序员最近在焦虑,不是因为没有机会,而是因为机会来了接不住。今年我参与了一个内部AI Agent项目的联调,模型选型、框架搭建、Prompt调试都顺利,Demo演示现场也很成功。结果上线前夜,权限校验和日志追踪出了问题,整个链路直接崩掉。那次复盘之后,我对职业规划的判断变了:大模型时代真正拉开差距的,已经不是谁会调接口,而是谁能守住生产环境。职业规划焦虑的根源,往往不是路线不对,而是能力结构和市场需求不匹配。大模型时代,会调接口的人很多,能守住生产环境的人很少。

m0_62051288的博客 218

ARM功耗管理之功耗状态及功耗模式

思考:功耗状态?功耗模式?Core&Cluster&Device&SoC如何映射?

AI-安全-功耗 785

Agent能跑通Demo,为什么团队接手就崩?权限日志才是真门槛

去年带过一个团队项目,一个数据查询Agent,Demo跑起来的时候确实漂亮。输入"上周销售额Top5的产品",它自己拆解任务、调数据库、生成图表,一气呵成。业务方看了直接拍板要上线。结果上线第一周就翻车了。不是模型不够聪明,是权限失控——Agent能访问的表比预期多了三倍,有些敏感字段直接暴露给前端。也不是工具调用出错,是某个API限流后,Agent卡死在重试循环里,日志里全是重复请求。最要命的是,团队接手后根本不知道这个Agent到底干了什么,因为没有任何可观测性。

2601_96120158的博客 347

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Agent能跑通Demo,为什么上线就崩?普通程序员该补的可能是权限和日志

摘要:大模型应用从 Demo 转向权限、日志和可观测,企业真正需要的不是会调 API 的人,而是能把 Agent 稳定交付到生产环境的人。这篇文章结合一次真实需求评审,拆解普通程序员转型大模型方向的技能缺口和实战路径。---大模型应用正在从 Demo 转向生产,企业真正需要的是能把 Agent 稳定交付到生产环境的人。普通程序员转型,最需要补的不是算法,而是工程化能力:权限管理、日志采集、可观测性、异常处理。简历和项目作品集要突出边界、取舍和验收标准,而不是只写"做了什么"。求职路线要结合实际工作。

2601_96285279的博客 217

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Agent项目能跑通却不敢上线,真正卡住团队的不是代码能力,而是权限和日志

摘要:大模型应用从Demo走向生产,最大的分水岭不是模型选得好不好,而是权限管理、日志追踪和异常兜底。本文从一个真实上线翻车案例出发,梳理Agent工程师的能力分层和实战路径,给出可落地的学习计划和项目建议。---目录岗位趋势:谁在招人,谁在观望能力分层:Demo和生产的距离有多远短期学习计划:先把工程底子补上中期项目沉淀:做一个能扛住线上问题的项目长期竞争力:从"调API的"到"能扛上线的"总结---大模型时代的程序员职业规划,核心问题不是"选什么方向",而是"怎么让自己不可替代"。

资料免费分享,点击名片 247

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

Agent项目上线崩了三次:权限日志配不对,Demo再漂亮也没用

摘要:很多人以为大模型就业的门槛是算法或Prompt,但真正卡住普通程序员的,是Demo跑通之后的工程化细节。本文复盘一个真实项目里踩过的坑——权限配置、日志追踪、可观测性,以及这些能力如何在求职中形成差异化优势。---大模型就业的门槛,从来不是算法,而是工程化能力。Demo能跑,只是第一步。真正值钱的是:你的Agent能不能安全地运行、能不能追踪每一次调用、能不能在出问题时快速定位。这些能力不会出现在任何"大模型速成班"里,但它们才是企业真正需要的。

m0_62051288的博客 210

Agent项目Demo能跑,为什么一上线就崩?权限日志才是就业分水岭

上周需求评审,产品经理抛出一个需求:做一个内部知识库问答Agent,能自动查文档、总结,还能调内部接口改工单状态。团队里两个候选人分别演示了自己的方案。A同学的项目在本地跑得飞起,RAG召回率看着不错,问答流畅,工具调用也配齐了。B同学的项目也跑通了,但代码里有一堆硬编码的判断,权限检查是写死的admin,日志只打印到控制台。我问了三个问题:这个Agent能处理并发吗?权限校验走的是硬编码还是动态策略?出问题时日志能定位到是哪个环节?A同学当场沉默。B同学说"线上再优化吧"。

2601_96120158的博客 234

Agent能跑通Demo的运维很多,能搞定权限和日志的才是真门槛

我见过太多运维工程师转大模型项目,简历上写着"熟练 Python、熟悉 LangChain、做过多个 Agent Demo",投递时石沉大海。原因很简单:能跑 Demo 的人一抓一大把,但能搞定权限控制、日志追踪、可观测性的运维经验,才是项目真正上线的生死线。上周帮一个朋友改简历,他之前在传统运维岗位做了五年,自动化脚本写得飞起,Ansible、SaltStack 闭着眼睛写。转大模型项目后,做了个 Agent 能自动分析日志、归因告警、甚至自动处置。Demo 跑得很顺,但团队不敢接。问题出在哪?

2601_96120158的博客 353

大模型求职:Demo能跑通后,为什么权限和日志成了致命坎

从2024年下半年到现在,我面过几十个候选人,也带过好几批实习生。2026年的求职市场有个很明显的信号:只会写Demo的人,简历关都能过,但一到"这个项目怎么上线"的环节,几乎全军覆没。翻车的地方十有八九不是模型效果,也不是Prompt写得好不好,而是三件事——权限、日志、可观测性。先说个真实场景。上个月有个候选人投了高级后端,简历上写着"独立开发RAG Agent,支持多轮对话和知识检索",项目地址给了GitHub。

老男孩的架构路 382

Agent Demo跑通很香,为什么上线就被权限和日志卡死?

上周参与了一个学生创业团队的需求评审,他们做了一个基于Agent的"智能客服系统",Demo演示得很流畅——用户提问,Agent调用RAG检索,然后生成回答。负责人很自信地说"下周就能上线"。我问了三个问题:用户权限怎么区分?Agent调用的API失败怎么兜底?每次请求的耗时、Token消耗、检索命中率怎么统计?对方愣了三秒,说"Demo里没考虑这些"。这就是大模型应用从Demo走向生产的第一道坎。今天这篇文章,我想把面试时真正看重的东西摊开说清楚。---

2601_96285279的博客 227

Demo能跑不代表能上线:小团队做Agent为什么总栽在权限和日志上

2026年的大模型求职市场,会调API和跑通Demo已经不够用了。企业真正筛掉应届生的,是那些Demo阶段被忽略的工程细节——权限控制、日志追踪、可观测性。这篇文章结合我带项目和面试同学的真实经验,聊聊计算机专业学生在大模型时代该怎么准备,重点讨论小团队资源有限时,如何避免过度设计、把精力放在真正值钱的地方。---大模型时代的计算机专业就业,门槛在提高,不是在降低。会调API的人越来越多,但能把Demo变成能上线的系统的人,依然稀缺。核心建议就三条:1. 别忽视基础课,它们是你能走多远的底座。

资料免费分享,点击名片 186

Demo能跑通却拿不到offer?权限日志才是大模型求职的分水岭

去年我面试过十几个转大模型的候选人,其中一半以上的项目简历写得漂亮:Agent能调用工具、RAG检索准确、流式输出流畅。但问一句"线上故障怎么排查",基本都卡壳。这不是能力问题,是赛道认知问题。现在大模型应用已经从Demo阶段进入工程化阶段,团队招聘的门槛也变了。以前会调API就能写项目,现在真正值钱的是让项目能在生产环境稳定跑起来。大模型就业的真正门槛不是模型本身,而是让模型应用能在生产环境稳定运行。权限、日志、可观测性,这三件事看似基础,却是Demo和上线之间的鸿沟。

2601_96120158的博客 361

Agent上线崩在权限和日志上:我的一次工程化踩坑复盘

我带过的一个内部知识库问答 Agent,最开始只是 Demo 版本,单人用着没问题,后来接入团队,第一天就出问题了。问题的顺序很有意思:先是个别人访问了不该看的资料,然后是调用链路断了,最后输出里带出了敏感信息。这三个问题,现在看就是权限、日志、可观测,但当时一个个排查的时候,真的有点懵。现在回头看,这也是很多准备转大模型方向的程序员的共同坎:Demo 能跑通,一上生产就崩。大模型求职这回事,Demo 能跑通只是及格线。真正拉开差距的是工程化能力——权限怎么设计、日志怎么记录、问题怎么追踪。

老男孩的架构路 274

Agent项目Demo能跑,为什么一上线就崩?权限和日志才是分水岭

上周做需求评审,前端同学展示了基于LangGraph的客服Agent工作流。意图识别→工具调用→回复生成,链路清晰,本地跑通了三个case,效果不错。讨论到一半,后端同学问了三个问题:用户身份怎么校验?敏感操作有没有审计日志?模型返回异常时怎么回滚?现场安静了几秒。这个场景我太熟悉了。过去两年,我带过好几个转大模型方向的程序员,大部分人能跑通Demo,但真正要上线时,崩的不是模型调用,而是权限、日志和可观测性这些" boring 的工程化细节"。

2601_96189167的博客 266

Agent Demo 能跑通,为什么上线第一天就翻车?从权限日志到可观测的排查路径

摘要:跑通一个 Agent Demo 只需要调通 LLM 和工具调用,但把它变成可维护、可上线的系统,问题往往出在权限边界、任务拆解和可观测性上。本文从一个电商客服 Agent 从 Demo 到上线的真实踩坑过程出发,拆解自主执行系统在工程化阶段的常见失败原因,并给出一套可复用的排查和实现思路。很多人对 Agentic AI 的理解还停留在"给模型一个工具列表,让它自己选"。但真正进入工程阶段后会发现,定义 Agentic 的核心不是能力,而是边界。

老男孩的架构路 316
上一篇: LangGraph工作流:能跑通Demo很容易,为什么团队接入第一天就崩?
下一篇: 单测通过不算完,权限日志才是大模型求职的及格线
Java技术那些事儿
博客等级 码龄5年 2306粉丝 2584原创
评论 4
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值