Demo能跑通只是及格线,面试官真正想要的是这些工程细节

2025阿里前端面试核心考点:从JavaScript到工程化实战 前端工程化已成为现代前端开发的核心能力,其本质是将复杂业务拆解为可维护的模块与流程。理解JavaScript作用域与异步机制、浏览器渲染原理及框架设计思想,是构建高质量应用的基础。这些底层知识直接决定了性能优化、微前端改造、大文件上传等实战场景的解决方案质量。2025年阿里前端面试更注重候选人能否从原理层面解释问题,并给出可落地的工程方案。本文整理了面试中的高频考点与答题思路,涵盖JS语言功底、框架对比、构建工具优化、运行时性能调优及AI辅助开发新趋势,为准备高级前端岗位的开发者提供系统参考。 阅读详情

聊《我重新梳理计算机专业就业后,先删掉了这些无效投入》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。

摘要

去年面过一个学弟,简历写得挺漂亮:LangChain + FastGPT,本地部署了一个法律问答的RAG系统,GitHub 200+ star,还配了完整的 README。我以为稳了。

结果聊到第三轮,我问了他一个问题:"你这套东西如果要接入到正式生产环境,权限控制怎么做?操作日志怎么记录?"

他愣了三秒,说:"我们是学校项目,没考虑这些。"

我当时心里就清楚,这个项目只能算个 Demo。

不是说他做得不好,而是现在的招聘市场已经变了。两年前,你能把一个 Chatbot 跑起来,就足以让面试官眼前一亮。但现在,大家都能把 Demo 跑起来,真正拉开差距的,是那些 Demo 跑通之后还要处理的工程细节。

目录

  • 现在的就业现状到底是什么
  • 基础课的价值比你想的大
  • 简历上的项目怎么表达才有说服力
  • 真实案例:从 Demo 到工程化的补全
  • 排查过程:上线之后出了问题怎么办
  • 常见失败原因怎么区分
  • 实习准备和求职路径
  • 总结

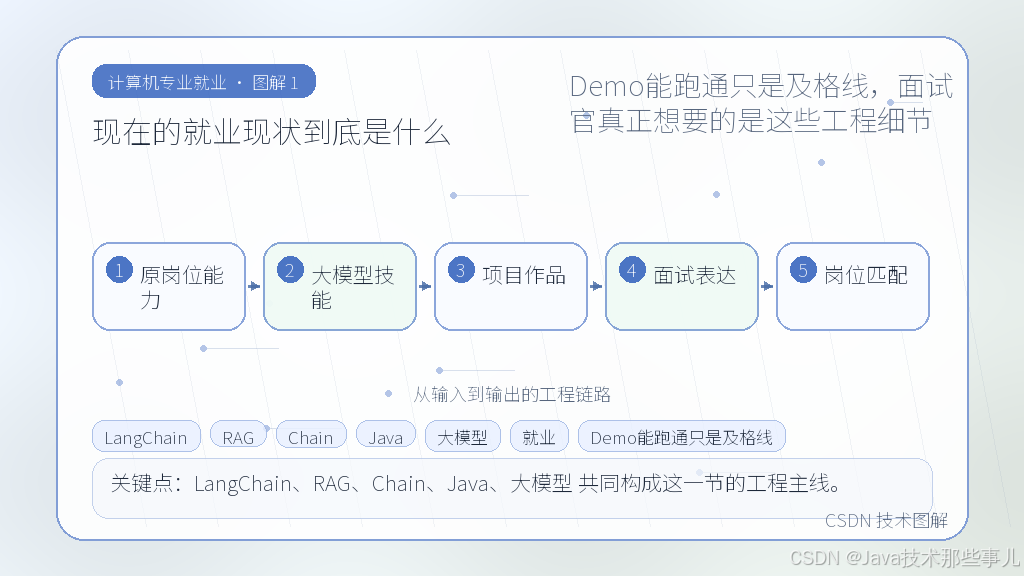
现在的就业现状到底是什么

文章插图 1

先说几个真实观察,不是鸡汤。

今年秋招期间,我看了不少简历,也带了几个实习生。发现一个明显趋势:投大模型岗位的同学,90% 以上的简历项目都是"基于 LangChain/RAG 的某个问答系统"。同质化严重到什么程度?你换掉项目名称,内容几乎一模一样。

所以单纯做一个 RAG Demo 已经不能再证明什么了。

但这不代表大模型方向不好找工作。相反,真正有工程化经验的同学,薪资涨幅普遍比普通 Java 后端高出 15%–20%。差距就在那些 Demo 之外的东西。

面试的时候,我会重点看三点:

第一,你的项目有没有真实的用户场景,而不是"演示一下"就走。

第二,你有没有处理过权限、日志、监控这些"不性感但必要"的部分。

第三,你能不能把项目的决策过程讲清楚,而不是只背技术栈。

基础课的价值比你想的大
文章插图 2

很多同学在准备大模型方向的时候,会跳过一些基础课,觉得"我又不用写编译器,数据结构背几个就行了"。

这个思路有问题。

我带过的实习生里,有个同学算法很强,LeetCode 刷了 500+,但接手第一个生产任务时就卡住了——他要优化一个 RAG 检索链路,涉及向量查询的性能问题。他写了个优化版本,跑起来更快,但内存占用暴涨,线上直接 OOM。

根本原因是他不懂基本的内存模型和数据结构。

所以基础课不是用来"应付考试"的,是用来"理解边界"的。操作系统让你知道资源是怎么被管理的,数据库让你明白查询是怎么执行的,计算机网络让你清楚请求是怎么传递的。这些知识在大模型项目上线的时候,会全部用到。

具体建议:数据结构、操作系统、计算机网络、数据库原理,这四门课的关键概念要真正理解,而不是死记硬背。面试的时候经常会问这些,而且问得比较深。

简历上的项目怎么表达才有说服力

回到开头那个案例。学弟的 RAG 系统其实做得挺认真,文档清晰,代码规范,如果是在一年前,这足够拿一个不错的 offer。但现在,我需要看到他处理工程问题的能力。

如果他的简历上有这样的描述:

  • 实现了基于角色的访问控制(RBAC),区分普通用户、审核员和管理员的操作权限
  • 通过结构化日志记录每次问答的输入、输出、响应时间,支持按用户 ID 和会话 ID 检索
  • 集成 Prometheus + Grafana,对检索延迟、Token 消耗、错误率进行实时监控

那整个项目的分量就不一样了。

这不是为了堆砌技术名词,而是真的在项目中实践了这些能力。我可以给你看一个真实的实现示例,就是之前那个学弟后来补上的部分。
优快云资料领取方式

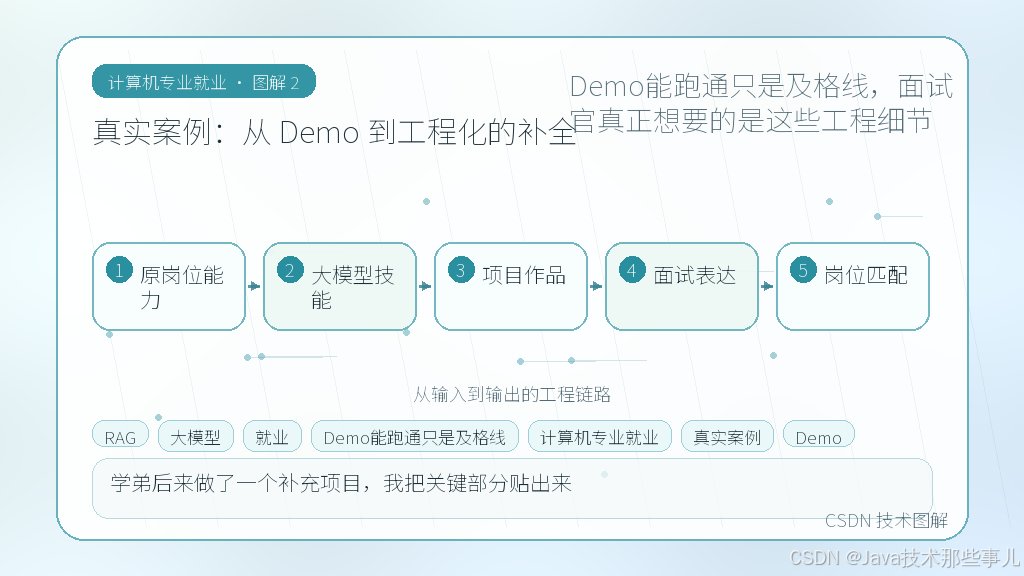
真实案例:从 Demo 到工程化的补全

学弟后来做了一个补充项目,我把关键部分贴出来。

他的场景是:企业内部的 AI 助手,员工可以提问,系统调用大模型生成回答,回答需要授权后才能显示。

第一步,权限控制:

from functools import wraps
from flask import jsonify, request

def require_role(required_role):
    """装饰器:检查用户角色是否满足要求"""
    def decorator(fn):
        @wraps(fn)
        def wrapper(*args, **kwargs):
            user = get_current_user()  # 从请求上下文获取当前用户
            if not user or user.role not in allowed_roles(required_role):
                return jsonify({"code": 403, "message": "权限不足"}), 403
            return fn(*args, **kwargs)
        return wrapper
    return decorator

@app.route("/api/answer", methods=["POST"])
@require_role("employee")
def generate_answer():
    query = request.json.get("query")
    session_id = request.headers.get("X-Session-ID")

    # 记录操作日志:谁、在什么时间、问了什么
    log_operation(user_id=current_user.id,
                  action="query",
                  session_id=session_id,
                  query=query)

    answer = rag_pipeline.run(query)
    return jsonify({"answer": answer, "session_id": session_id})

代码解释:

这段代码的核心逻辑是用装饰器实现角色权限检查。require_role 接收一个目标角色,返回一个装饰器。被装饰的函数在执行前,会先通过 get_current_user() 获取当前登录用户,然后检查其角色是否在允许范围内。如果不满足,直接返回 403,不会执行后面的业务逻辑。

这里还有一个细节值得注意:在调用 RAG 管道之前,我先记录了操作日志。这个顺序很重要——日志应该包裹在权限检查之后,这样可以避免未授权请求产生无效日志,同时保证合法请求的操作可追溯。

第二步,结构化日志:

import logging
import json
from datetime import datetime

class StructuredLogger:
    def __init__(self, name: str):
        self.logger = logging.getLogger(name)
        self.logger.setLevel(logging.INFO)

    def info(self, event: str, **kwargs):
        payload = {
            "timestamp": datetime.now().isoformat(),
            "event": event,
            **kwargs
        }
        self.logger.info(json.dumps(payload, ensure_ascii=False))

    def error(self, event: str, **kwargs):
        payload = {
            "timestamp": datetime.now().isoformat(),
            "event": event,
            "level": "ERROR",
            **kwargs
        }
        self.logger.error(json.dumps(payload, ensure_ascii=False))

# 使用示例
logger = StructuredLogger("rag_service")

try:
    answer = rag_pipeline.run(query)
    logger.info("answer_generated",
                user_id=user_id,
                session_id=session_id,
                token_count=len(answer))
except Exception as e:
    logger.error("answer_failed",
                 user_id=user_id,
                 session_id=session_id,
                 error=str(e))

代码解释:

StructuredLogger 是一个轻量级的结构化日志工具。它的核心设计是把所有日志信息序列化成一行 JSON,这样方便接入 ELK、Loki 之类的日志分析平台。info 和 error 方法都接受动态参数 kwargs,你传什么字段,日志里就有什么字段,非常灵活。异常处理用 try-except 包裹,确保任何错误都能被记录,不会静默丢失。

第三步,监控指标:

这部分他没有写代码,因为主要依赖现有工具。但他做了三件事:

1. 用 Prometheus 的 Counter 类型记录 API 调用次数和错误次数
2. 用 Histogram 类型记录问答的响应时间分布
3. 配置 Grafana 面板,设置响应时间超过 5 秒告警

这三件事做起来不难,但能证明你有生产意识。面试的时候能主动提到这些,比分几个 star 有用得多。

排查过程:上线之后出了问题怎么办

这个项目上线一个月后,真的出了故障。运维告警说某个用户的问答请求响应时间从 2 秒飙升到 15 秒。

排查过程是这样的:

现象:单个用户的请求延迟异常高,其他用户正常。

第一步验证:看日志,找到该用户的请求记录。日志里有完整的输入、输出和时间戳,直接定位到问题是出在 RAG 检索环节,而不是模型推理环节。

第二步验证:检查向量数据库的查询日志。发现该用户的历史会话异常长,包含了大量无关的上下文,导致每次检索都要处理超长的文档片段。

第三步验证:确认根因。会话管理模块没有对上下文长度做限制,导致历史对话无限积累。

排除结果:排除了模型本身的问题(换模型没改善),排除了网络问题(内网调用),最终确认是会话管理逻辑的缺陷。

修复方案:在 RAG pipeline 入口处增加上下文长度限制,超过 4000 token 的历史对话只保留最近的 5 条。修复后,该用户的响应时间恢复正常。

整个过程花了不到两个小时。有完整的日志和监控,排查效率很高。如果当时没有结构化日志,光是定位问题就要花半天。

常见失败原因怎么区分

回到最开始的问题:为什么很多大模型项目 Demo 能跑通,上线就崩?

我总结了三类常见的失败原因,面试的时候如果能区分清楚,会显得很专业。

业务错误:逻辑设计有问题。比如 RAG 系统的召回率和准确率冲突——召回太多,噪声干扰答案质量;召回太少,关键信息遗漏。这种问题不是技术实现的锅,是方案设计的问题。区分方法是看错误是不是可复现的,以及是否符合预期的业务逻辑。

配置错误:环境变量、API Key、模型参数配置错误。这类问题最常见,也最容易排查。日志里通常会有明确的报错信息,比如"401 Unauthorized"、"Invalid API Key"。区分方法是检查配置文件和运行时的实际配置是否一致。

环境错误:依赖版本冲突、端口被占用、容器资源不足。这类问题在本地跑得好好的,上线就出问题。区分方法是对比开发环境和生产环境的差异,逐一排除。

一个实用的排查原则:先看日志,日志能告诉你 80% 的问题。如果日志不够详细,再逐步加 logging。如果加了日志还是找不到问题,那就是架构设计层面需要重构了。

实习准备和求职路径

说了这么多,回到求职本身。实习和正式工作的准备思路不太一样。

实习阶段,重点不是做出了多么复杂的项目,而是展示你的工程思维和学习能力。一个中等难度的项目,加上你对它的深度理解和反思,比十个半成品有价值得多。

正式求职阶段,则需要更有针对性的准备:

简历筛选:你的项目描述要包含可量化的结果。不要写"实现了问答系统",要写"支持日均 500 次问答,平均响应时间 2.3 秒,准确率 85%"。数字是最直观的证据。

技术面试:基础题还是要刷,但大模型相关的题目越来越多了。重点关注:RAG 的原理和常见优化方案、Prompt Engineering 的最佳实践、向量数据库的基本用法、Agent 的工作流设计。

项目展示:面试的时候可能会被要求现场讲解你的项目。讲清楚三个问题:为什么要做这个项目、遇到了什么问题、怎么解决的。不要只讲技术栈,那只是表层。

实习策略:如果能进大模型相关方向的实习,优先选有真实业务场景的团队,而不是只做内部工具的团队。业务场景复杂,你能遇到的坑更多,成长更快。

总结

大模型时代的就业竞争,已经从前两个年的"谁能跑通 Demo"变成了"谁能做出能上线的东西"。

这个转变对普通学生来说既是压力也是机会。压力在于,单纯的技术栈堆砌不再有效;机会在于,愿意在工程化上下苦功的同学,竞争者少了很多。

我的建议是:基础课不要丢,项目要有深度,简历要有证据,面试要能讲清楚决策过程。

那个学弟后来去了另一家公司做 RAG 方向的开发,入职后发现公司里的工程化规范和他自己补上的那套几乎一样。他说,那段补全的经历,是他整个秋招最大的收获。

资料展示

下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
AI大模型资料展示 1

AI大模型资料展示 2

AI大模型资料展示 3

如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。
优快云官方大礼包

嵌入式面试考察趋势:从知识点背诵到工程能力实战 嵌入式开发作为软硬件交叉的工程领域,其核心早已不只是接口调用与寄存器配置,而是围绕系统资源、并发控制与架构设计的综合能力。现代嵌入式系统从MCU裸机到RTOS实时内核,再到嵌入式Linux驱动的复杂层次,都需要开发者具备扎实的Linux内核源码理解、设备树配置能力和调试方法论。而随着边缘AI与设备安全需求的爆发,嵌入式AI量化部署、固件签名验证等新话题也进入技术视野。工程实践中的架构设计、内存管理、任务同步机制,以及AI辅助开发工具的应用,共同构成了评估工程师水平的关键维度。这些能力在面对实际项目时,表现为 阅读详情

相关推荐

C51编程25-应用篇(单片机与电脑端实现wifi通讯)

单片机使用ESP-01S wifi模块与电脑端进行数据通讯。

qq_34343637的博客 1万+

Demo能跑通只是及格线:2026年面试官真正在意的是什么

去年这时候,我的简历上堆了三个大模型项目,自认为足够应付面试。结果第一轮就被刷了,理由是"只有Demo,没有工程化经验"。当时我不服气,觉得能跑就行。今年换了几个公司面,发现这个反馈背后有个明显的趋势:2026年的大模型求职,已经从"能不能做出来"转向了"能不能在线上活下来"。企业不再需要你演示一个ChatGPT式的问答机器人,他们需要的是能在生产环境稳定运行的Agent系统——而这恰恰是很多人的盲区。业务错误、配置错误、环境错误。很多人分不清这三者,排查的时候走弯路。

老男孩的架构路 430

不止于ACC:用CarSim的‘Multiple Objects’和路径跟踪器玩转复杂交通流场景

本文深入探讨了如何利用CarSim的'Multiple Objects'模块和路径跟踪器模拟复杂交通流场景,超越传统ACC测试的局限。通过批量控制、动态交互和参数化设计,实现多车智能响应和复杂轨迹模拟,适用于连续变道、拥堵博弈、匝道汇流等真实交通场景。

weixin_30954265的博客 497

2026年了,为什么大模型Demo能跑通,面试官还是觉得你不够用?

前阵子面了一个同学,简历上写了个"基于LangChain的企业知识库问答系统",听起来挺唬人。让他讲项目,三句话就到位:用了RAG、接了向量数据库、Demo跑通了。我问了一个问题:你们的权限是怎么控制的?日志怎么记录的?线上出问题你怎么排查?他愣了三秒:"Demo里没做这个。我理解他。很多人在准备项目时,思路是"把核心功能跑通就行"。但2024到2026这两年,企业招聘的标准已经悄悄变了。光会调API、能跑出效果,只能算及格线。真正缺的,是能把Agent从Demo变成能上线的东西的人。

老男孩的架构路 538

ROS机器人全覆盖路径规划实战:6种ipa算法对比与选型指南(附避坑经验)

本文深入对比了ROS中ipa_coverage_planning功能包集成的6种全覆盖路径规划算法,包括牛耕分解、栅格旅行商、神经网络、局部能量最小、轮廓线和凸感知放置。文章从覆盖率、重复率、计算效率、动态避障等核心工程指标出发,提供了基于不同场景(如静态/动态环境、规则/复杂布局)的实战选型指南,并分享了神经网络和局部能量最小等关键算法的参数调优与避坑经验,旨在帮助开发者根据实际需求选择并优化最合适的ipa覆盖算法。

perl8的博客 364

CANoe开发入门到精通读书笔记(2)——CAPL编程

CAPL函数的语法跟C语言很类似,但也包含一些C语言所不具备的功能大部分CAPL支持的数据类型都可以直接声明为函数参数, 例如,整型、浮点型、枚举、结构、定时器以及它们的引用。但有一些类型不能被直接声明,而需要加上*号(注意该符号并不是C语言中 指针的意思)。例 如 : signal * s 、 envvarInt * ev 、 sysvarFloat * sv 、 diagRequest * dr、diagResponse * dr、int matrix[][],以及。

weixin_66275497的博客 6462

能跑通 Demo 的人满地都是,2026 年能把 Agent 接入生产的人才有 O…

去年这时候,投简历的焦虑是"没人回";今年变成"回了也没用"。不是技术不行,是面试问你"你的 Agent 项目上线了吗",你说"本地跑通了",对方眼神就变了。2026 年的招聘市场确实变了,但变化不是"没机会",而是"门槛重新画了一条线"。能跑通 Demo 是及格线,权限、日志、可观测这三件事做到位,才是你和其他候选人的差距。2026 年的程序员就业市场,确实比三年前难了。但这个"难"不是因为你不够努力,而是因为门槛提高了——从"能跑通 Demo"提高到了"能把项目搬到生产环境"。

老男孩的架构路 241

睿尔曼超轻量仿人机械臂-ROS第一篇 启动机械臂的Moveit

本文主要讲述了睿尔曼六轴机械臂在ROS中的功能包配置,及如何根据文件启动Moveit做仿真。

realman_Rop的博客 7490

单测通过不算完,权限日志才是大模型求职的及格线

摘要:大模型应用正在从"能跑通"迈向"能上线",企业招聘也在同步变化。本文以一个真实的权限+日志卡点为例,拆解 Demo 和项目之间的差距,梳理计算机专业学生在基础课、AI 项目、实习准备上的取舍路径。---大模型时代的计算机就业,门槛在提高,机会也在增加。提高的门槛不是模型能力本身,而是工程化能力。对在校生来说,最有效的准备方式是:做一个有权限控制、有结构化日志、有异常兜底的真实项目,而不是十个能跑通但经不起追问的 Demo。

老男孩的架构路 384

STM32-CubeMx-HAL库-串口空闲中断+DMA——利用HAL_UARTEx_ReceiveToIdle_DMA实现不定长数据接收

STM32-CubeMx-HAL库-串口空闲中断+DMA——利用HAL_UARTEx_ReceiveToIdle_DMA实现不定长数据接收

weixin_43864631的博客 1万+

RuoYi(分离版) 使用代码生成器添加子模块(idea版)

文章目录准备一、使用代码生成器1.数据库2.导入表并生成代码二、导入代码文件1.新建一个模块2.导入zip代码文件3.模块环境配置添加菜单和访问地址总结 准备 前提要把系统启动起来,部分教程可以参考这边文章若依框架RuoYi前后端分离项目导入IDEA及运行启动 但是完全参考这篇文章还是不能把项目启动起来,因为这篇文章没有说明数据库。 我是用的是本地数据库,采用xampp+Navicat的组合来部署和访问数据库。打开Navicat,连接并创建数据库ry-vue并导入数据脚本ry_20191008.sql,q

dream_coke的博客 1万+

作为面试官,我根本不在乎你的大模型项目

文章摘要:大模型应用开发面试中,候选人常犯三个关键错误:1. 仅停留在功能层(跑通Demo),缺乏设计层(技术选型思考)和工程层(落地优化)的深度认知;2. 用工具流水账代替决策过程描述;3. 无法阐明技术取舍逻辑。通过拆解6个真实面试案例,揭示了面试官真正关注的三层能力模型:功能实现(基础)、架构设计(核心)和工程落地(加分)。同时提供了系统学习路径,包含198节免费课程和配套资源,覆盖提示词工程、RAG、Agent开发到模型部署的全栈知识体系,帮助开发者从理论到实战全面进阶。(149字)

嘴巴吃糖了 243

华为OD机考双机位C卷 - 员工派遣 (Java & Python& JS & C/C++ & GO )

华为OD机考双机位C卷 - 员工派遣 (OD上机考试双机位C卷)。提供在线OJ刷题。Java、C++、Python、GO语言、C语言、JavaScript题解,并提供完整思路讲解。

算法大师! 1035

CS求职Take-home跑通秒挂?2026大厂代码工业级评分红线

从大厂工程主管的底层评判逻辑来看,功能跑通(Happy Path)只能拿到 60 分的及格线。在自动化代码审查普及的今天,面试官真正要考察的是你的代码是否具备接入生产环境 CI/CD Pipeline(持续集成与部署流水线)的工业级素养。你是因为代码的极度脆弱和工程规范的缺失,被系统直接判定为“高维护成本候选人”。

StemCareerGroup的博客 305

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

技术面试最重要的是什么?

如果是一、二面,可以稍微详细点,三面以及以后,介绍一下框架就可以了。我在面试中期在这方面也犯了错误。以前我是直接讲核心方法的,但后面有一天突然脑子抽风,想调整一下项目介绍策略,分三个阶段讲,第一阶段是失败的尝试,第二阶段吸取了第一阶段的教训,第三阶段是更上一层楼,以为这样更有结构性。但是那几场面试我明显感觉面试官的反馈并不好,有一家一面直接挂了我怀疑跟这个也有关系。我给老婆讲了一遍,她说我的前奏铺垫太长了,听了半天都没听到我的核心方法是什么,其实半分钟后她就听不进去了。

https://github.com/heatMa 1137

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

程序员职业规划:工程实践里的常见坑

本文概述文章目标、核心观点和实践价值。最近面试了几十个带着“大模型应用开发”标签的候选人,发现一个很明显的现象:大多数人的简历和项目经历,要么是把 LangChain 官网教程复现了一遍,要么是简单调了个 API 接了几个 Prompt。这种“玩具级”的项目,在面试官眼里不仅没有加分,反而暴露了工程思维的缺失。大模型时代,职场的门槛确实变了,但底层的工程逻辑没变。甚至因为 LLM 的不确定性,对稳定性、可观测性和成本控制的要求更高了。

2601_96120158的博客 292

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

2026年Agent开发求职复盘:你在网上搜不到的一些真相

这篇文章讲的都是大实话,但说实话,光看文章远远不够。Agent求职最难的不是"知道该学什么",而是知道学了之后怎么落地、怎么包装成面试能讲的项目、怎么在面经里那些"隐形考点"上不翻车。我把过去半年整理的所有实操干货打包成了一个文件包,包括:📄大厂Agent面试真题库(含工程治理高频题+参考思路,不是网上能搜到的那些)📋企业级Agent项目模板(从架构设计到上线闭环,每一步都有设计决策记录,可直接改造成自己的项目)🗺️不同背景上岸路线图(后端转行/应届生/产品岗,三条线各有专属时间表和里程碑)

qkh1234567的博客 216

后端做 Agent 项目,做到什么程度才能拿 offer?

文章摘要: 本文为后端开发者转型AI大模型领域提供了系统化指南。首先提出Agent项目的四个能力层级标准:基础闭环(入门)、工程优化(优秀)、架构设计(高阶)及业务深度(资深),并指出面试官常考察的技术原理、工程优化和业务场景三类问题。 随后,作者分享了一套2026年适配的AI大模型免费学习资源包,包含: 分阶段学习路线(零基础到项目部署); 实战视频教程与源码(RAG、微调、Agent开发等); 技术文档与行业报告; 大厂面试真题。 资源由清华博士团队编撰,强调企业级落地能力,适合零基础转行或在岗程序员提

Android_XG的博客 221

Java面试为何总问高并发?面试官想考察的3件事与备战路线

高并发是Java开发者绕不开的核心话题,也是大厂面试的高频考点。从JMM、volatile到synchronized与AQS,从线程池参数到ConcurrentHashMap的锁优化,这些底层机制共同构成了并发编程的知识底座。理解可见性、原子性与有序性,掌握锁升级与CAS原理,是解决缓存穿透、分布式锁等真实场景问题的前提。在实际系统中,高并发能力往往体现在极端流量下的工程决策:如何用Redis扛住读压力、用MQ削峰填谷、用Sentinel做限流降级。面试官考察高并发,并非要求人人都有千万QPS经验,而是通过

weixin_33965305的博客 336

别卷 Agent 编排:大厂面试更看重你的权限与日志兜底能力

先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。做后端开发这几年,我见过太多技术同学陷入一种误区:觉得大模型时代,只要会调 API、会写 LangChain 或 LangGraph 的工作流,就是高级工程师。我也曾以为掌握了复杂的 Agent 编排逻辑就能在简历上大放异彩。直到去年参与了一个内部 BI 分析平台的重构项目,我才真切地意识到:从 Demo 到生产,中间隔着巨大的“工程化鸿沟”,而填平这个鸿沟的不是模型的智商,而是权限控制和可观测性。

2601_96189255的博客 221

后端转到Agent开发已上岸字节,给大家普及一下大厂Agent开发需要达到的强度

后来真正开始面试才发现——他们更关心的是:项目是不是你做的?为什么这么设计?线上出了问题怎么处理?能不能真正把Agent落地。如今入职字节一段时间,我想说:Agent开发的要求没有网上传得那么玄乎,但也。今天把这套真实强度标准拆给你看。· · ·

jennycisp的博客 505

断点续传全解析:从HTTP Range到并发控制的工程落地

在大文件传输场景中,网络中断是常态,而断点续传正是解决这一问题的核心机制。它并非单一技术,而是以HTTP协议中的Range头与206状态码为协议骨架,结合文件切片、状态持久化与并发控制共同构成的工程方案。理解其原理,不仅有助于应对面试中关于“分片上传、续传断点”的追问,更能为实际系统设计提供可靠思路。从浏览器端File.slice拆片,到服务端分片接收与流式合并,再到基于Redis记录已传分片、通过MD5或ETag校验文件完整性,每一个环节都决定了系统能否从Demo走向生产环境。本文以最小可运行代码为起点,

weixin_29722783的博客 141

Flutter开发避坑指南:从环境搭建到工程化实践

跨平台开发是当前移动应用领域的重要趋势,Flutter作为Google推出的UI框架,凭借自绘渲染引擎和声明式开发模式,在性能表现与UI一致性上具备显著优势。然而,许多开发者在实际应用中却频繁受困于环境配置、构建链路、生命周期管理以及原生混合开发等基础性问题,极大影响了开发效率与使用体验。针对这些高频痛点,本文从环境基线的建立、常见报错的快速定位、五层排错框架的运用出发,系统梳理了Flutter从入门到工程化落地的关键环节。同时结合Flutter与uni-app的选型对比、面试题背后的真实能力考察等热门话题

weixin_33910759的博客 830

Golang开发笔试复盘:从GMP调度到工程能力考点解析

在现代后端开发中,并发编程是衡量工程师能力的重要标尺,而Golang凭借goroutine与channel提供了独特的并发原语。理解GMP调度模型、内存逃逸分析以及垃圾回收机制,不仅有助于写出高性能服务,更是面试中区分应试者思维层次的关键。从channel的易错场景到同步包的竞态控制,从错误处理设计到缓存限流等业务场景,每一类考点背后都对应实际工程中的典型问题。本文以一份2019年春招Golang开发试卷为样本,拆解语言基础、底层原理、工程能力与系统设计四层考察逻辑,帮助读者建立应对变式题的知识体系,为后端

weixin_34341117的博客 311

Steal This Portfolio Project:高效复用的工程化作品集构建法

在前端开发中,作品集项目本质是技术决策能力的具象化表达。它并非功能堆砌,而是围绕数据流设计、状态管理选型、错误边界处理与无障碍规范等核心工程要素展开的系统性实践。现代前端框架(如React/Vue/Next.js)已将大量最佳实践沉淀为可复用的抽象层,关键在于能否从成熟开源项目中逆向提取其约束条件与权衡逻辑,完成跨技术栈的语义映射。这种‘偷’不是复制代码,而是复现设计意图——比如用Zustand替代Redux背后的状态原子性需求,或通过IndexedDB替代localStorage所隐含的大体积数据与并发写

weixin_34162228的博客 573
上一篇: AI 编程工具很顺手,为什么团队项目还是崩了?
下一篇: 2026年了,为什么大模型Demo能跑通,面试官还是觉得你不够用?
Java技术那些事儿
博客等级 码龄5年 2306粉丝 2584原创
评论 10
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值