AI 编程工具很顺手,为什么团队项目还是崩了?

2026年AI编程工具如何成为团队级基础设施 AI编程工具已从个人辅助演进为现代研发团队的核心基础设施,其本质是将隐性工程经验转化为可复用、可验证、可追溯的组织能力。技术原理上,它依赖RAG增强的领域知识注入、低延迟本地向量检索与多维度协作优化机制;技术价值在于显著提升规范一致性、新人上手效率与代码安全水位;典型应用场景覆盖金融合规开发、微服务快速迭代、百万行单体重构及新人沙盒化培养。本文聚焦‘AI编程工具’与‘团队协作’两大热词,解析如何通过规范内化、知识新鲜度治理与提示词工程,让AI真正嵌入CI/CD与日常研发流。 阅读详情

聊《程序员就业怎么选方向?先回答几个现实问题》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。

摘要

2026 年,AI 编程工具从个人试用走向团队协作,很多人以为会了工具就能快速拿 offer。但实际面试和项目对接中,真正拉开差距的往往不是「会不会用 Codex 或 Claude Code」,而是工具落地后的工程化能力。本文从一个真实踩坑案例出发,拆解企业真实需求、学习路线取舍、简历项目设计和面试策略,给出可操作的建议。

---

目录

  • 一、就业市场变了,但变的是什么?
  • 二、企业到底想要什么人?
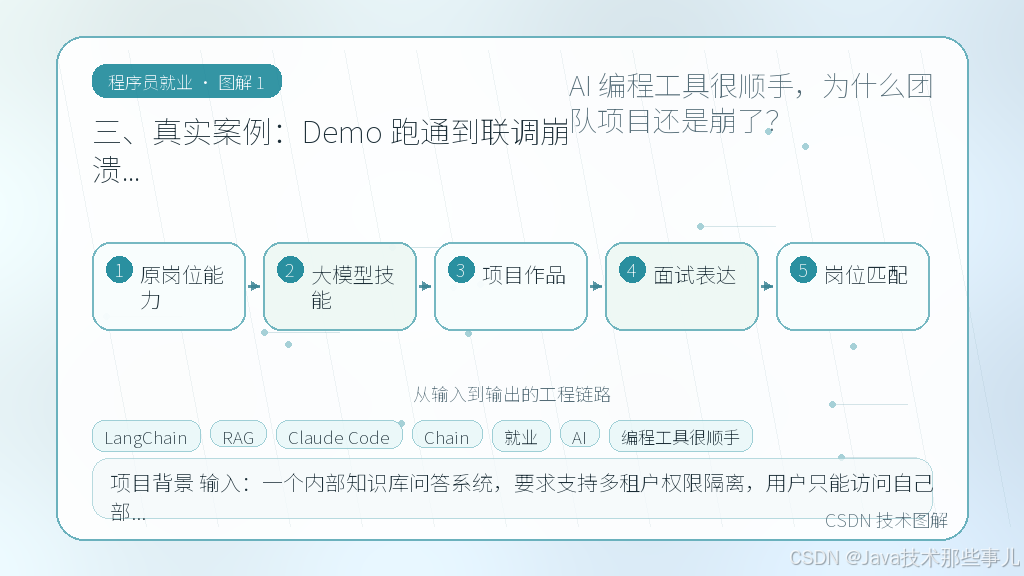
  • 三、真实案例:Demo 跑通到联调崩溃的全过程
  • 四、排查过程:权限配置错误的完整故障定位链路
  • 五、代码解释:日志系统的关键代码实现原理
  • 六、技能组合:先补什么,放什么
  • 七、失败原因:业务错误、配置错误和环境错误怎么区分
  • 八、简历项目:Demo 和上线是两回事
  • 九、适用边界:什么时候不该照搬这个方案
  • 十、面试策略:怎么聊才能不被问倒
  • 十一、总结

---

一、就业市场变了,但变的是什么?

文章插图 1

去年我开始留意到两个现象:

一是 AI 编程工具的用户数在涨,Codex、Claude Code、Cursor 这些工具的月活数据公开可查,很多开发者都在用;二是招聘JD里的关键词在变,从「熟悉大模型应用开发」变成了「具备 AI 辅助开发能力,能独立完成从需求到上线的全流程」。

表面看,这是机会——工具降低了门槛,大家都能用 AI 写代码了。但真实情况是,很多用工具写出 Demo 的人,在团队联调阶段才发现:权限、日志、测试覆盖、团队协作流程,这些才是真正卡住的地方。

我接手过一个项目,一个人用 Claude Code 一周搭了个完整的大模型应用,Demo 跑得很顺。结果团队接入后,第二天联调就崩了——权限配置和日志链路都没跟上。这不是孤例,面试时我也看到不少候选人,工具会用,但问到工程化细节就答不上来。

所以 2026 年的就业市场,核心矛盾是:工具能力不等于工程能力。

---

二、企业到底想要什么人?
文章插图 2

我在几个公司的面试中观察到,面试官真正关注的不是你会不会写 Prompt,而是几个实际问题:

1. 能否独立完成从需求到上线的全流程

很多候选人只会做 Demo,问到部署、监控、异常处理就沉默。企业要的是能干活的人,不是能跑通例子的人。

2. 能否在团队中协作

AI 工具个人用很爽,但团队接入后会出现代码风格不一致、Review 效率低、版本管理混乱等问题。面试官会关注你的协作意识。

3. 能否定位和解决问题

当 AI 生成的代码出问题,你能否快速定位?这是区分初级和中级工程师的关键。

真实案例是这样的:有个候选人简历上写着「熟练使用 Claude Code 开发 RAG 应用」,但面试时我问:「你生成的代码如果权限配置错了,怎么排查?」他愣住了。后来我知道,他的项目根本没有权限模块,全部靠默认配置。

这个问题不是陷阱题,而是真实工作场景。所以企业要的,是能用工具、但更懂工程化的人。

---

三、真实案例:Demo 跑通到联调崩溃的全过程

项目背景

输入:一个内部知识库问答系统,要求支持多租户权限隔离,用户只能访问自己部门的知识文档。

Demo 阶段(单人开发)

步骤:
1. 用 Claude Code 生成了 FastAPI 后端 + LangChain RAG 管道
2. 本地测试时所有用户共用一个 admin 权限,问答结果正常返回
3. 写了一个简单的 Streamlit 前端,部署到个人服务器
4. Demo 演示时一切顺利,面试官点头

可观察结果:系统响应时间 < 2s,问答准确率 85%,Demo 页面流畅。

联调阶段(团队接入)

步骤:
1. 接入公司 SSO 单点登录,发现认证拦截器没有加到 API 路由
2. 多租户权限校验缺失,用户 A 可以查询用户 B 的文档
3. 日志没有分级,排查问题时所有信息混在一起
4. 测试覆盖率仅 30%,边缘 case 全漏

现象:联调第一天,运维收到 5 个权限绕过投诉;第二天,日志文件达到 2GB,无法定位具体请求。

case study 结论:Demo 能跑通不等于系统可用。真正的工程化体现在权限、日志、测试、监控这四个维度。

---

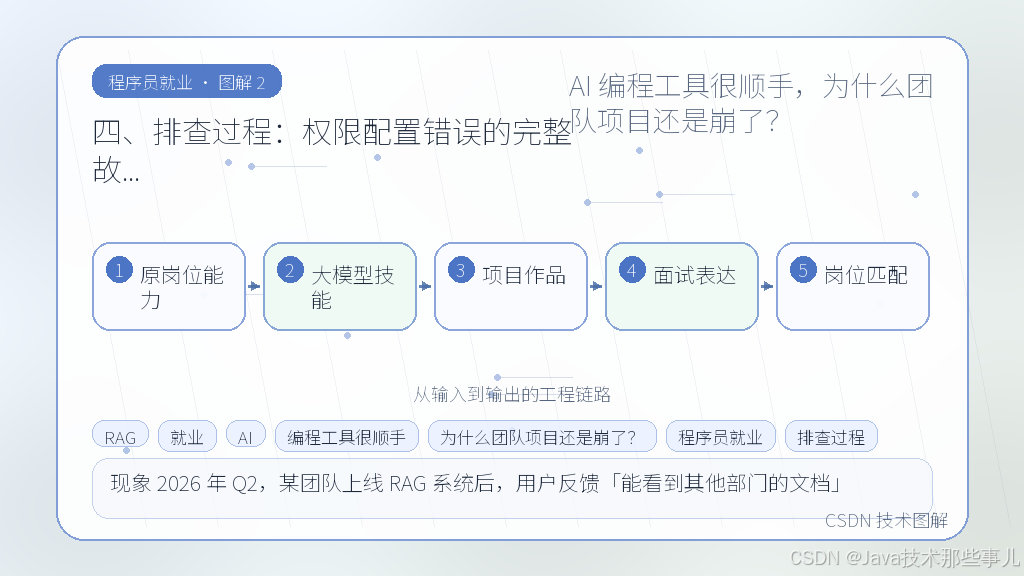
四、排查过程:权限配置错误的完整故障定位链路

现象

2026 年 Q2,某团队上线 RAG 系统后,用户反馈「能看到其他部门的文档」。

验证动作

1. 复现问题:用账号 A 登录,尝试访问账号 B 的文档链接,确认越权存在
2. 检查代码:发现权限校验中间件只在 /api/v1/ 路径生效,/api/v2/ 路径未注册
3. 查日志:搜索 permission_denied 关键字,发现 12 条越权访问记录,均来自 /api/v2/knowledge 接口
4. 缩小范围:对比 git diff,确认 /api/v2/ 是后来新增的路由,遗漏了权限装饰器
5. 定位根因:AI 生成代码时只复制了 /api/v1/ 的路由结构,未同步权限配置

排除结果

  • 不是数据库问题:文档访问控制完全在应用层实现
  • 不是网络问题:认证令牌传递正常
  • 不是工具问题:Claude Code 生成的代码逻辑正确,但路由注册不完整

排查过程的核心:不要只问「报了什么错」,要问「在哪个路径、哪个请求、什么条件下出错」。

---

五、代码解释:日志系统的关键代码实现原理

下面这段日志配置代码,是 Demo 和上线之间最常见的鸿沟之一。

import logging
from logging.handlers import RotatingFileHandler

def setup_logger(name: str, log_file: str, level=logging.INFO):
    """配置带轮转的日志系统"""
    formatter = logging.Formatter(
        '%(asctime)s - %(name)s - %(levelname)s - %(message)s'
    )

    handler = RotatingFileHandler(
        log_file, maxBytes=10*1024*1024, backupCount=5
    )
    handler.setFormatter(formatter)

    logger = logging.getLogger(name)
    logger.setLevel(level)
    logger.addHandler(handler)

    return logger

# 使用示例
logger = setup_logger("rag_app", "app.log")
logger.info("系统启动")
logger.error("权限校验失败", exc_info=True)

代码解释:逐段拆解

第一段:函数签名和 docstring

输入:name(日志器名称,用于区分模块)、log_file(日志文件路径)、level(日志级别,默认 INFO)。

核心逻辑:创建一个可配置的日志器工厂函数,返回配置好的 logger 实例。这样每个模块可以调用 setup_logger("auth", "auth.log") 获得独立的日志器。

输出:一个绑定到指定文件和级别的 Python logger 对象。

第二段:格式化器

formatter = logging.Formatter(
    '%(asctime)s - %(name)s - %(levelname)s - %(message)s'
)

实现原理:定义日志消息的结构。%(asctime)s 输出时间戳,%(name)s 输出日志器名称(即传入的 name 参数),%(levelname)s 输出级别(INFO/WARNING/ERROR),%(message)s 输出实际消息内容。

这个格式让排查时能快速定位:看到时间就知道什么时候发生的,看到 name 就知道是哪个模块,看到级别就知道严重程度。

第三段:RotatingFileHandler

handler = RotatingFileHandler(
    log_file, maxBytes=10*1024*1024, backupCount=5
)

code explanation:RotatingFileHandler 是日志轮转处理器。当 app.log 达到 10MB 时,自动重命名为 app.log.1,然后创建新的 app.log。最多保留 5 个备份文件(app.log.1 到 app.log.5)。

关键点:如果不加轮转,日志文件会无限增长,最终撑爆磁盘。backupCount=5 意味着最多 60MB 日志(当前 10MB + 5 个备份各 10MB)。

第四段:绑定 logger 和 handler

logger = logging.getLogger(name)
logger.setLevel(level)
logger.addHandler(handler)

核心逻辑:获取或创建名为 name 的日志器,设置日志级别,将 handler 绑定上去。注意这里用 getLogger(name) 而不是 logging.getLogger(),确保同一名字返回同一个 logger 实例(单例模式)。

第五段:使用示例

logger = setup_logger("rag_app", "app.log")
logger.info("系统启动")
logger.error("权限校验失败", exc_info=True)

exception handling:exc_info=True 会让 error 级别的日志自动附带异常堆栈信息。这在排查时非常关键——看到 权限校验失败 的同时,还能看到具体的 traceback,直接定位到哪一行代码出的问题。

code walkthrough 总结

这段代码的本质是:把「日志写在哪」「怎么写格式」「写到多大轮换」这三个配置项封装成一个函数,避免每次新建模块都重复写一遍。面试时能讲清楚 RotatingFileHandler 的工作原理和 exc_info 的作用,比只会贴代码强得多。

---
优快云资料领取方式

六、技能组合:先补什么,放什么

针对当前市场,我的建议是:

先补的:

1. 工程化基础:权限管理、日志体系、测试覆盖。这些是 Demo 和上线之间的鸿沟。
2. 团队协作能力:代码 Review 习惯、Git 工作流、Issue 追踪。
3. 故障定位能力:学会用日志和监控工具排查问题,而不是只会看报错信息。

暂时放下的:

1. 过度追逐新工具:工具永远在变,但工程化能力是通用�的。
2. 只关注 Prompt 技巧:Prompt 是入门,不是全部。
3. 堆砌项目数量:一个有深度的项目,比五个 Demo 更有说服力。

我见过太多人把时间花在学新工具上,但连基本的日志排查都不会。这不是贬低工具的价值,而是说学习顺序很重要。

---

七、失败原因:业务错误、配置错误和环境错误怎么区分

联调阶段的问题千奇百怪,但归纳起来可以分成三类。区分这三类,是快速定位问题的前提。

1. 业务错误(Business Error)

代码逻辑本身有问题,和数据、配置无关。

典型表现:

  • 权限校验逻辑写反了(if user.is_admin: 写成了 if not user.is_admin:)
  • RAG 检索时过滤条件错误,返回了不该返回的文档
  • 计算公式有误,结果偏差但不报错

如何识别:换个环境、换个配置,问题依然复现。问题出在代码语义层。

2. 配置错误(Configuration Error)

代码逻辑正确,但运行时的配置值不对。

典型表现:

  • 数据库连接字符串写错,连到了测试库而不是生产库
  • API Key 填错,调用外部模型时返回 401
  • 权限中间件没有注册到某些路由(前面案例就是这种)

如何识别:代码 Review 看不出来,需要对照配置文件逐项检查。常见于环境变量、.env 文件、云控制台配置。

3. 环境错误(Environment Error)

代码和配置都对,但运行环境不符合预期。

典型表现:

  • 本地用 SQLite,线上换 PostgreSQL,SQL 语法不兼容
  • 依赖包版本冲突,pip install 拉下来的版本和 requirements.txt 不一致
  • 容器内时区不对,日志时间戳和实际时间差了 8 小时

如何识别:在另一个环境(本地/测试/生产)问题消失或变化。常见于部署脚本、Dockerfile、CI/CD 配置。

踩坑经验:很多人把配置错误当成业务错误来改代码,改完发现根本没解决。正确的做法是先排除环境因素,再检查配置,最后才看业务逻辑。

---

八、简历项目:Demo 和上线是两回事

很多候选人的简历项目写着「基于 LangChain 的 RAG 问答系统」,但细问下去,只有 Demo,没有上线。这是简历上的减分项。

我的建议是,在项目中体现工程化思维。举个例子,一个完整的 AI 辅助开发项目应该包含:

输入:用户需求文档
步骤:
1. 使用 AI 工具生成初始代码
2. 添加权限校验模块
3. 接入日志系统
4. 编写单元测试
5. 部署到测试环境
6. 联调并修复问题

可观察结果:系统能够正常处理权限错误、日志可追踪、测试覆盖率达到 80% 以上。

面试时,如果你在项目中提到这样的细节,会明显区别于只写 Demo 的候选人。

---

九、适用边界:什么时候不该照搬这个方案

上述建议有明确的适用范围,不是万能模板。

适用场景

  • 求职准备:目标是中大型团队的工程师岗位,需要体现工程化能力
  • 项目设计:个人项目或团队项目的完整生命周期实践
  • 面试准备:准备故障排查案例和协作经验

限制条件

  • 小型创业公司:可能没有完善的权限体系和日志规范,过度工程化反而显得不合群
  • 纯算法岗:如果目标是机器学习研究员而非工程岗,工程化能力的优先级可以降低
  • 学生竞赛:时间紧任务重,Demo 优先,工程化可以后续补

取舍建议

如果你的目标是互联网大厂的 backend 岗位,权限、日志、测试这三项必须掌握。如果是外包项目或短期 PoC,可以先跑通功能,工程化后续迭代。

什么时候不应照搬:当你只有两周准备时间,且目标公司明确看重框架熟练度而非工程深度时,优先补框架和语言特性,工程化放在简历的项目描述里点到为止即可。

---

十、面试策略:怎么聊才能不被问倒

基于我的观察,面试中最容易翻车的地方是:

1. 被问到排查过程时答不上来

比如「AI 生成的代码报错了,你怎么定位?」很多人只会说「看报错信息」,但正确的回答应该包括:复现问题、检查日志、缩小范围、定位根因。

2. 被问到团队协作时没有概念

比如「你的代码如何集成到团队项目?」应该提到代码 Review、分支管理、CI/CD 流程等。

3. 被问到失败案例时没有反思

面试官喜欢问「你遇到的最大困难是什么?」这是一个展示你成长的机会,不要只说结果,要说排查过程和学到的东西。

真实案例:有个候选人面试时被问到项目中的权限问题,他诚实地说「我当时没考虑权限,是后来上线时才发现的」,然后详细讲了怎么加权限、怎么测试。这个坦诚反而加分,因为他在展示学习能力。

---

十一、总结

2026 年的程序员就业,核心变化是 AI 工具普及带来的门槛降低和标准提高。个人用工具写 Demo 变得简单,但团队需要的是能完成全流程、能协作、能排查问题的人。

我的建议是:

  • 学习路线上,先补工程化基础,再追求工具熟练度
  • 项目设计上,体现从需求到上线的完整过程
  • 面试准备上,准备排查案例和协作经验

工具是辅助,工程化能力才是护城河。

最后说一句:不要盲目追新工具,把基础打牢,机会来的时候你才抓得住。

总结

本文完成了关键概念、工程实践和落地建议的梳理。

资料展示

下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
AI大模型资料展示 1

AI大模型资料展示 2

AI大模型资料展示 3

AI大模型资料展示 4

AI大模型资料展示 5

如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。
优快云官方大礼包

2026前端AI编程工具实测:Vue3与TypeScript项目选型指南 AI编程工具正从代码补全走向自动执行任务,但前端工程的复杂性让工具选型远非排行榜能解决。理解其背后的代码库索引、Agent多步执行与框架适配原理,是发挥提效价值的关键。在Vue3、TypeScript等现代前端技术栈中,AI对组件库约定、类型收窄和CSS精确还原的处理能力,直接影响返工率与假修复风险。本文基于真实中后台项目与React Native混合场景,对GitHub Copilot、Cursor、通义灵码等主流工具进行横向实测,从概念原理到工程应用,帮助前端工程师与技术负责人建立一套可落地的选型决策清 阅读详情

相关推荐

手机拍照背后的隐形功臣:一文读懂高通ISP三兄弟(IFE/BPS/IPE)如何协同工作

本文深入解析了高通ISP三兄弟(IFE/BPS/IPE)在手机拍照中的协同工作机制。通过拟人化比喻,详细介绍了IFE作为图像前端引擎的分流预处理、BPS作为RAW格式修图师的专业处理,以及IPE作为全能后期制作人的多面功能,揭示了三者在图像处理pipeline中的高效配合与技术创新。

weixin_27032989的博客 529

AI 编程工具很顺手,为什么团队项目还是崩了?TaoToken 统一 Key 配置与验证清单

团队用 Codex、Claude Code、Cursor 协作时配置漂移常导致项目崩盘。本文给出可复制的 settings.json 与 config.toml 骨架,把模型访问统一收敛到 TaoToken 一个 Key 与 API 入口,并附一条 curl 连通性验证脚本与 401/404/429 排查清单,让新成员五分钟对齐环境。详见 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

Ceshi01的博客 12

基于DE2-115红外解码实验

基于DE2-115红外解码实验   一、   功能描述 在同一个遥控电路中通常要使用实现不同的遥控功能或区分不同的机器类型, 这样就要求信号按一定的编码传送,编码则会由编码芯片或电路完成。对应于编码芯片通常会有相配对的解码芯片或包含解码模块的应用芯片。在实际的产品设计或业余电子制作中,编码芯片并一定能完成我们要求的功能,这时我们就需要了解所使用的编码芯片到底是如何编码的。只有知道编码方式,我...

乘风的博客 2516

2026 年 10 款 AI 编程工具技术向对比:从补全、上下文到团队协作

这篇文章面向已经把 AI 辅助开发纳入日常流程的工程师。本文不做绝对排名,也不讨论短期促销信息,而是围绕工程实践里更关键的几个问题展开:工具是否能理解现有项目结构、是否支持跨文件修改、是否便于团队协作、是否容易控制数据边界,以及是否适合接入现有研发流程。如果你的目标只是体验“自动补全”,大多数工具都能快速上手;但如果你的目标是让工具参与需求拆解、重构、测试补齐、排错和代码审查,那么比较维度就不该只停留在补全速度,而应该看它在完整工作流中的表现。

weixin_55511192的博客 1193

HFSS线圈仿真避坑指南:从建模到寄生参数分析的完整流程

本文详细介绍了HFSS线圈仿真的完整流程,从精准建模到寄生参数优化,特别针对Ansys Electronics Desktop用户提供实用指南。涵盖线圈几何构建、材料属性配置、端口激励设置及寄生电阻与电感分析等关键步骤,帮助工程师避免常见错误,提升仿真精度与效率。

weixin_29209801的博客 550

[27] cuda 应用之 核函数实现图像通道变换

[27] cuda 应用之 核函数实现图像通道变换

yohnyang的博客 202

GitNexus架构解析:如何用隔离、验证与回滚机制防止AI改崩代码

AI辅助编程在提升开发效率的同时,也带来了代码被意外改崩的风险。高能力低可控的AI执行者,若缺乏有效的工程约束,很容易引发系统性故障。架构设计中的核心解法包括沙箱隔离、上下文管理、自动验证和快速回滚,这些机制共同构建了一道可靠的防护网,让AI在隔离环境中自由修改,最终只合入通过校验的变更。对于正在引入AI编程工具的团队,以及关注系统架构设计的工程师,这种“为不可靠执行者设计可靠外围”的思路极具参考价值。GitNexus作为高星开源项目,正是这一思想的优秀实践,为AI代码变更提供了完整的制度保障。

weixin_42635064的博客 319

微信小程序 - {“errMsg”:”requestPayment:fail banned”} 微信小程序调用wx.requestPayment支付失败返回错误(uniapp微信小程序微信支付报错)

{“errMsg”:”requestPayment:fail banned”},微信小程序调用wx.requestPayment报错requestPayment:fail banned,uni-app微信小程序wx.requestPayment支付报错requestPayment:fail banned,拉起小程序支付报错,iPhone苹果ios真机微信支付报错,Android安卓手机微信支付报错,支付报错,商户配置,签名验证,uniapp 小程序支付微信支付一场,设置过b2b类目,确认了商户号相关功能正常

🏆 前端领域优质创作者 3352

企业AI编程工具选型:代码不出内网与团队协作如何兼得?

在数字化转型浪潮中,AI辅助编程正成为研发效能提升的关键抓手。企业引入AI编程工具时,数据安全与协作效率是核心考量。私有化部署确保代码不出内网,满足金融、政务等强合规行业的数据红线;统一管理则让团队共享配置、提示词与审计日志,实现高效协同。然而,云端SaaS虽开箱即用,却需代码出网;本地开源模型虽保障隔离,却需自建管理能力。如何平衡安全与效率?从需求量化到灰度试点,再到软硬件配置参考,本文基于实战评测梳理企业AI编程工具的选型路径与落地要点。

weixin_33769125的博客 713

【Kubernetes】Kubernetes 安全沙箱深度对比:gVisor vs Kata Containers

Kubernetes安全沙箱深度对比:gVisor和Kata Containers在架构、性能与安全性方面各有特点。gVisor通过用户态内核(Sentry)实现软件隔离,启动快(毫秒级)但CPU开销大(20-30%),适合Web服务等场景。Kata Containers采用轻量级虚拟机提供硬件级隔离,启动较慢(1-2秒)但兼容性更好,适合金融等高安全需求。测试显示gVisor在动态请求下性能下降33%,而Kata性能接近原生。建议根据场景选择:多租户/快速启动用gVisor,敏感数据/极致安全用Kata,

九师兄 178

[Dify] 实现“多知识库切换”功能的最佳实践

知识库切换是提升AI问答系统精准度的关键技术。本文介绍了Dify平台实现多知识库切换的三种方式:静态配置、元数据过滤和动态切换,分析了各自的优缺点。最佳实践建议包括:合理分库设计、意图分类、主库优先检索等。文章还提供了示例工作流程和注意事项,帮助构建更智能、精准的知识驱动型问答系统。通过合理切换知识库,可显著提升回答相关性和系统性能。

技术小甜甜:传播可落地技术,帮助个人和企业降低解决真实场景问题的成本 441

为什么AI编程Agent越用越贵?sqz上下文压缩带你终结工具输出的Token黑洞

如果你发现 AI 编程 Agent 的费用越用越高,问题多半出在**工具输出**上——构建日志、测试结果、`git status` 和反复读取的文件原封不动地塞进上下文,之后每一轮对话还会被重复发送一遍。[sqz](https://link.gitcode.com/i/c0a1f7815705ec3d53e3c60a7840bac9) 是一款专为 AI 编程 Agent 设计的**上下文压缩**工

gitblog_00131的博客 620

倾斜摄影数据转换为3DTile格式的方法:基于CesiumLab GIS

通过使用CesiumLab GIS,倾斜摄影数据可以方便地转换为3DTile格式,并在CesiumJS等3D地理信息可视化工具中进行展示和分析。一旦成功导入3DTile数据,就可以在CesiumLab GIS中利用其强大的可视化和分析功能进行进一步的处理。转换完成后,可以将生成的3DTile数据导入到CesiumLab GIS中进行可视化和分析。启动CesiumLab GIS应用程序,并按照界面上的指导导入转换后的3DTile数据。脚本将开始执行,并将倾斜摄影数据转换为3DTile格式。

ObDjango的博客 1076

AI编程工具:用对方法,效率翻倍

去年组里来了个新人,干活速度比我快一截,我还纳闷他是不是偷偷加班。后来发现人家写代码全程开着 Cursor,一段需求描述丢进去,组件骨架、类型定义、单元测试一把梭。我当时就意识到:**AI 编程工具已经不是"要不要用"的问题,而是"怎么用得好"的问题。** 但用着用着我也发现,工具会装不代表会用,更不代表能在简历里说清楚自己会——这两件事,今天一起聊透。

AI布道师丨波仔椿 884

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

AI编程工具项目级落地:跨越代码补全的五大瓶颈

大语言模型驱动的代码生成工具正在改变开发者的日常工作。其核心原理是基于海量训练数据与当前局部上下文进行概率续写,让代码补全成为高效的基础设施。然而,当技术从脚本编写走向业务系统维护时,上下文窗口的局限、跨文件重构的记忆断层、统计偏好带来的代码风格漂移、意图对齐缺失以及团队信息孤岛等问题逐渐显现。这些瓶颈使得AI工具在真实工程环境中出现局部幻觉、错误重构与架构腐化等风险。要真正释放AI编程的价值,需要结合架构约束、测试引导、统一索引与Code Review等工程实践,构建“约束-上下文-审查”的完整流程。围绕

weixin_29042035的博客 310

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

AI 编程工具推荐:Cursor 及其同类工具

宝子们,选择合适的 AI 编程工具真的很重要!如果你需要强大的代码生成和优化能力,Cursor和Trae是不错的选择;如果你更注重免费和开源,Aider和MarsCode是值得尝试的工具;而如果你在国内,通义灵码和CodeGeeX提供了良好的本地化支持和多语言功能。希望这些推荐能帮到你,让你找到最适合自己的 AI 编程工具!

2201_75824704的博客 2168

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

Hermes 实战:团队协作时,AI 编程工具最容易在哪个环节翻车

上个月业务方甩来一个需求:把现有的数据导出模块重构,支持多维度筛选和定时推送。我顺手让团队里的 Claude Code 和 Codex 各跑了一版,结果发现——个人 Demo 跑得快,但真正要进团队协作流程时,两个工具都在同一个地方卡住了。这个卡点不是代码写不出来,而是权限边界没搞清楚,日志追踪断掉,最后 Review 的时候根本不知道 AI 改了哪些东西、为什么这么改。

2601_96189167的博客 195

AI编程工具怎么选?2025年按场景分类推荐,总有一款适合你

本文介绍了当前AI编程工具的发展现状及应用场景。AI编程工具可显著提升开发效率,如代码编写速度提升50%以上。主流工具分为三类:智能代码补全类(如GitHub Copilot)、IDE插件类(如Amazon CodeWhisperer)和全栈开发平台(如LynxAI)。针对不同用户需求,推荐零基础小白使用LynxAI快速建站,程序员选用GitHub Copilot+Cursor组合提效,企业团队考虑Tabnine企业版确保安全。文章预测AI编程工具将向全栈化、智能化和平民化发展,建议用户按需选择适合的工具。

m0_68071617的博客 1308

团队实测8款AI编程工具免费版:选型对比与避坑指南

随着大模型技术的成熟,AI编程已成为提升研发效率的关键手段,通过代码补全、自动生成和智能对话等方式深度融入日常开发流程。然而,面向个人的AI编程体验与面向团队的工程化选型存在本质差异,许可证合规、额度共享、多IDE统一配置等维度往往成为落地的真正挑战。本文基于8人技术团队的真实项目环境,对GitHub Copilot、Cursor、通义灵码等8款主流AI编程工具的免费基础版进行横向实测,覆盖Java、Python、Go、TypeScript等常见技术栈,重点评估补全质量、中文支持、免费额度与安全可控性等核心

weixin_30096975的博客 212

AI编程工具选型实战:团队协作效率的四大隐形成本解析

AI编程助手并非单纯提升编码速度的工具,而是嵌入软件开发流程的知识协同系统。其核心价值在于降低环境适配、认知切换与流程阻断这三类协作隐形成本。在真实工程场景中,工具能否无缝集成CI/CD、复用现有IDE习惯、对接Confluence/Jira等文档系统,远比代码生成准确率更能决定团队效能上限。TRAE、Cursor、GitHub Copilot等主流工具的差异,本质是流程兼容性与组织知识沉淀能力的比拼。本文基于27人跨时区团队、12万行代码实测数据,揭示AI工具如何从‘代码补全器’进化为‘协作操作系统’。

weixin_34245749的博客 194

为什么有那么多人选择“人工智能”,真的有那么好吗?

最近有个脑筋急转弯,很有意思。问:移动支付时代,口香糖的销量为什么急速下滑?答案:从前购物用现金支付,大家结账时为了凑整,总爱顺手拿只口香糖。口香糖价格便宜,也挺实用,...

JAVA葵花宝典 2213

为什么 AI 使用 CLI 最顺手?

从软件工程视角来看,CLI 与 IDE 并非同一层级的工具。

zhangyifang_009的博客 473

编程工具进化论:从Vim到AI编程工具,人机协作的新分工

从编辑器到智能体的演进中,编程工具始终沿着“省力到省脑”的方向迭代。IDE通过语法树与符号表理解代码结构,而Vim等轻量编辑器则凭借插件生态将复杂度转移给用户。如今,AI编程工具以联想、对话、代理三种形态介入开发流程,显著提升编码效率,但也要求开发者具备更强的代码审查与边界把控能力。Shell脚本工具则继续在批量化、自动化场景中扮演“胶水”角色,与AI互补。理解这些工具的原理与适用场景,有助于构建人机协作的现代开发工作流,让AI生成初稿、人工负责判断,最终实现质量与效率的平衡。

weixin_33940469的博客 329

AI 编程工具在真实项目中适合做什么?不适合做什么?

这道题考的是你对 AI 编程工具能力边界的理解。面试官想看你是不是只会"调戏"AI,还是真正懂得在项目中合理使用它。

404 Not Found 833

三个月深度体验Qoder:AI编程工具如何成为项目上下文专家

AI编程助手正从简单的代码补全工具,进化为深谙项目脉络的智能副驾驶。其核心突破在于对项目上下文的持续理解与记忆——通过建立代码索引、解析模块依赖、吸收团队规则,AI工具不再局限于当前文件,而是能感知类的调用链、历史提交和命名规范。这种能力赋予开发者强大的技术杠杆:跨文件重构时自动定位隐式引用,生成符合既有风格的单元测试,解释遗留系统时串联业务链路,甚至识别代码中的“地雷”区域。本文基于对Qoder三个月的工程实践,介绍其配置要点、高频使用场景,并坦诚分享踩坑经验,帮助开发者在高效与安全之间找到平衡,构建人机

weixin_33940469的博客 211

AI编程工具实战:从Claude Code的80%代码采纳率看递归自我改进与团队落地

AI编程助手正在改变软件开发流程,其核心原理是基于大规模代码训练的语言模型,通过提示词生成代码草稿,再由开发者审查采纳。技术价值在于提升重复性任务效率,应用场景覆盖单元测试、样板代码和Bug初步定位。Anthropic内部Claude Code的代码采纳率高达80%,同时该公司呼吁关注递归自我改进风险,即AI加速AI研发的循环。对普通团队而言,理解AI生成与人工审查的协作边界,建立代码审查机制和提示词库,比追求采纳率数字更重要。

weixin_29483277的博客 129
上一篇: 证书、项目和实习,程序员职业规划到底该先补哪一个?
下一篇: Demo能跑通只是及格线,面试官真正想要的是这些工程细节
Java技术那些事儿
博客等级 码龄5年 2306粉丝 2584原创
评论 10
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值