


聊《会用LangGraph只是起点,能解释失败才算真正入门》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。
摘要
最近看到不少团队把LangGraph接入项目后,线上翻车频率不降反升。现象很有意思:Demo阶段一切正常,一上线权限、日志、可观测性问题集中爆发。很多人第一反应是模型不行、Prompt写错了,排查一圈才发现根本问题在工作流设计本身。
我踩过这个坑,也在带团队做类似的迁移。今天不聊概念,直接拿一个真实案例说清楚。
目录
- 为什么需要图工作流
- State与Node
- Edge与条件分支
- 人工审批节点
- 工程化落地
- 代码解释
- 失败原因分析
- 适用边界
- 总结
为什么需要图工作流
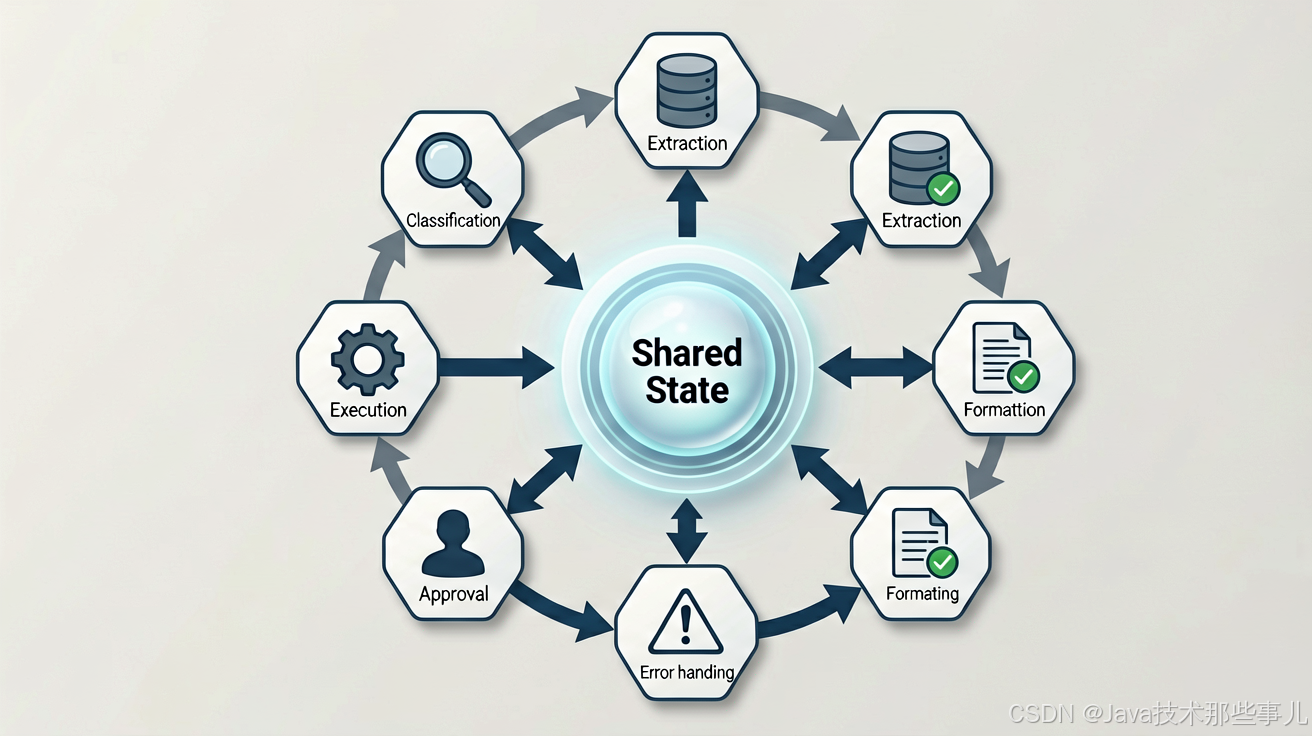
先看一个典型的"脚本式Agent"长什么样。
# 典型的脚本式Agent
def run_agent(user_input):
    response = llm.invoke(user_input)
    if "订单" in response:
        order_id = extract_order_id(response)
        result = query_order(order_id)
        return format_response(result)
    elif "退款" in response:
        return handle_refund(user_input)
    else:
        return "抱歉,我没有理解您的意图"
这段代码能跑,Demo阶段也能应付简单场景。但一旦业务复杂起来,问题就暴露了:
- 条件分支写死在代码里,改一个逻辑要动整段代码
- 没有状态管理,多轮对话无法保持上下文
- 失败时无法定位是哪个环节出问题
- 无法插入人工审批节点
我当时的项目是做一个客服Agent,处理订单查询、退款申请、投诉登记三类请求。最初就是上面这种写法,上线两周后客服反馈:有时候退款请求被当成普通查询处理了。排查后发现是关键词匹配逻辑有漏洞,"退"字出现在订单描述里也会触发退款分支。
问题不在模型,在流程设计。
State与Node
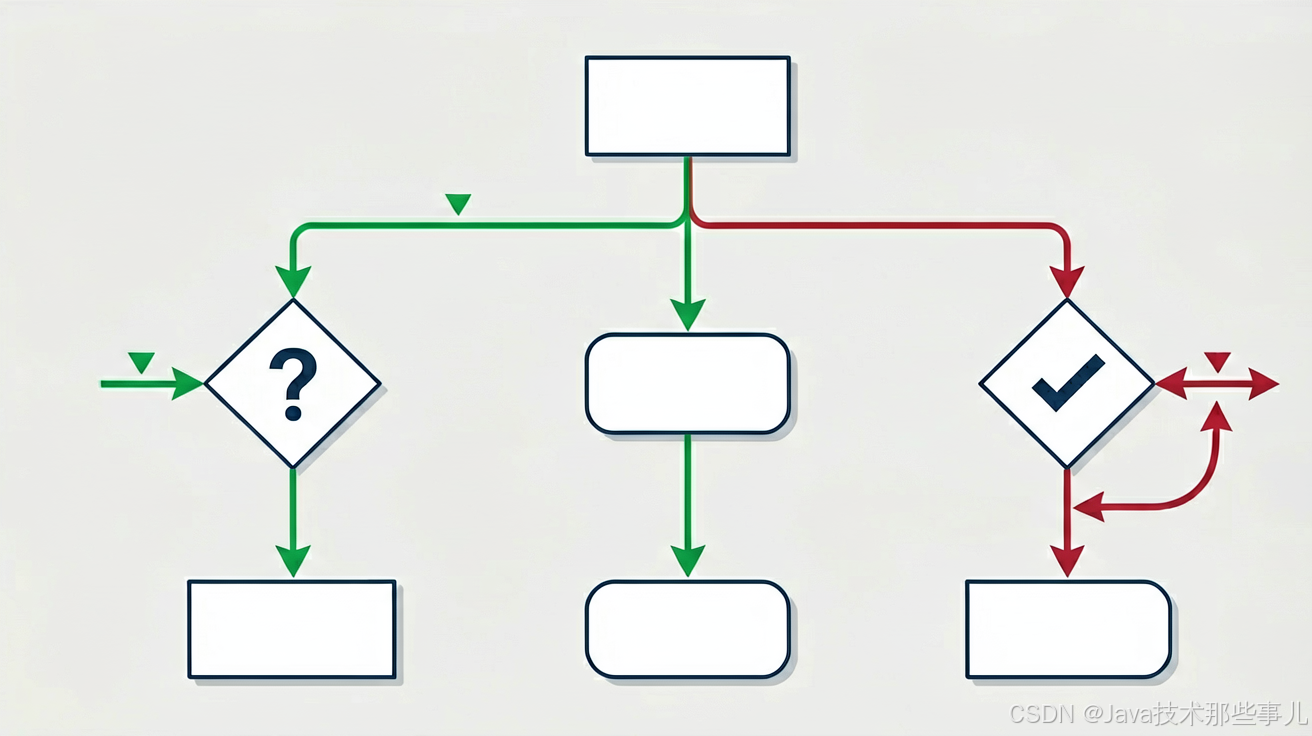
LangGraph的核心思想是把工作流抽象成图。每个节点是一个处理单元,State是贯穿整个流程的共享状态。
from langgraph.graph import StateGraph, START, END
from typing import TypedDict, Annotated
import operator

class AgentState(TypedDict):
    user_input: str
    intent: str
    extracted_info: dict
    result: str
    requires_approval: bool
    approval_status: str
    history: Annotated[list, operator.add]

def classify_intent(state: AgentState) -> AgentState:
    """意图分类节点"""
    prompt = f"分析用户意图:{state['user_input']}"
    response = llm.invoke(prompt)
    state['intent'] = response.choices[0].message.content
    state['history'].append(f"意图分类: {state['intent']}")
    return state

def extract_info(state: AgentState) -> AgentState:
    """信息提取节点"""
    if state['intent'] == "订单查询":
        state['extracted_info']['order_id'] = extract_order_id(state['user_input'])
    elif state['intent'] == "退款申请":
        state['extracted_info']['reason'] = extract_refund_reason(state['user_input'])
        state['requires_approval'] = True
    return state
State设计是关键。我见过很多团队把State设计得过于简单,导致后续节点无法获取必要信息。我的经验是:State应该包含当前节点需要的所有输入、当前节点产生的输出、以及后续节点可能需要的中间结果。
节点设计要遵循单一职责原则。一个节点只做一件事,这样便于测试和调试。
Edge与条件分支
条件边让工作流具备分支能力。这是脚本式Agent最难实现的部分。
def route_by_intent(state: AgentState) -> str:
    if state['intent'] == "订单查询":
        return "query_order"
    elif state['intent'] == "退款申请":
        return "handle_refund"
    elif state['intent'] == "投诉登记":
        return "handle_complaint"
    else:
        return "unknown_intent"

def check_approval_needed(state: AgentState) -> str:
    if state.get('requires_approval', False):
        return "pending_approval"
    return "proceed"

# 构建图
workflow = StateGraph(AgentState)

# 添加节点
workflow.add_node("classify", classify_intent)
workflow.add_node("extract", extract_info)
workflow.add_node("query_order", query_order_handler)
workflow.add_node("handle_refund", handle_refund_handler)
workflow.add_node("handle_complaint", handle_complaint_handler)
workflow.add_node("approve", approval_node)
workflow.add_node("respond", response_node)

# 添加边
workflow.add_edge(START, "classify")
workflow.add_edge("classify", "extract")
workflow.add_conditional_edges(
    "extract",
    check_approval_needed,
    {
        "pending_approval": "approve",
        "proceed": "respond"
    }
)
workflow.add_edge("approve", "respond")
workflow.add_edge("respond", END)
这里有一个我踩过的坑:条件函数的返回值必须与边定义中的key完全匹配。有一次我把"pendingapproval"写成了"needapproval",结果工作流直接走到默认分支,退款请求被错误地自动处理了。
排查过程花了半天:日志显示工作流正常执行,但结果不对。最后对比边定义才发现是字符串不匹配。
人工审批节点
权限和审批是Demo和上线最大的分水岭。我的项目里,退款金额超过500元需要人工审批。
def approval_node(state: AgentState) -> AgentState:
    """人工审批节点"""
    refund_amount = state['extracted_info'].get('amount', 0)

    if refund_amount > 500:
        approval_request = {
            'type': 'refund',
            'amount': refund_amount,
            'reason': state['extracted_info'].get('reason'),
            'user_input': state['user_input']
        }
        send_to_approval_system(approval_request)
        state['approval_status'] = 'pending'
        state['history'].append(f"退款申请已提交审批,金额:{refund_amount}元")
    else:
        state['approval_status'] = 'approved'
        state['history'].append(f"小额退款自动通过,金额:{refund_amount}元")

    return state

def await_approval(state: AgentState) -> AgentState:
    """等待审批结果(阻塞节点)"""
    result = poll_approval_result(state['extracted_info'].get('request_id'))
    state['approval_status'] = result['status']
    return state
审批节点的设计要考虑几个问题:
1. 如何持久化等待状态
2. 超时如何处理
3. 审批结果如何回写State
我当时的方案是用数据库存储等待中的审批请求,定时任务轮询状态。这个设计让工作流具备了"暂停-恢复"能力,是脚本式Agent做不到的。
工程化落地
能跑通Demo和能上线是两回事。我总结了一些必须解决的问题:
日志与可观测性
import logging

logger = logging.getLogger(__name__)

def classify_intent(state: AgentState) -> AgentState:
    logger.info(f"开始意图分类,输入:{state['user_input']}")
    try:
        prompt = f"分析用户意图:{state['user_input']}"
        response = llm.invoke(prompt)
        intent = response.choices[0].message.content
        logger.info(f"意图分类结果:{intent}")
        state['intent'] = intent
        state['history'].append(f"意图分类: {intent}")
    except Exception as e:
        logger.error(f"意图分类失败:{str(e)}")
        state['intent'] = 'unknown'
        state['history'].append(f"意图分类失败: {str(e)}")
    return state
每个节点都要有日志,关键是要记录输入和输出。上线后出问题,日志是唯一能还原现场的证据。
异常处理
def safe_invoke(node_func, state: AgentState) -> tuple[AgentState, bool]:
    """安全执行节点,捕获异常"""
    try:
        result = node_func(state)
        return result, True
    except Exception as e:
        logger.error(f"节点执行失败:{str(e)}")
        state['history'].append(f"节点执行异常: {str(e)}")
        return state, False
节点失败不应该让整个工作流崩溃。我的经验是:每个节点都要有降级逻辑,失败时返回一个合理的安全状态。
配置管理
把硬编码的值抽离到配置:
# config.py
REFUND_APPROVAL_THRESHOLD = 500
DEFAULT_TIMEOUT_SECONDS = 30
MAX_RETRIES = 3

# 使用配置
if refund_amount > config.REFUND_APPROVAL_THRESHOLD:
    # 触发审批
配置和代码分离,改阈值不需要重新部署。
代码解释
下面对关键代码做逐段拆解,这是理解LangGraph实现原理的关键。
State定义段
class AgentState(TypedDict):
    user_input: str
    intent: str
    extracted_info: dict
    result: str
    requires_approval: bool
    approval_status: str
    history: Annotated[list, operator.add]
这段代码定义了工作流的共享状态。输入是用户的原始请求user_input,经过意图分类后写入intent,信息提取后写入extracted_info。requires_approval和approval_status用于控制审批流程。history字段用Annotated[list, operator.add]标注,表示每次追加时会自动合并而不是覆盖,这样整个流程的执行轨迹都能保留下来。
意图分类节点
def classify_intent(state: AgentState) -> AgentState:
    prompt = f"分析用户意图:{state['user_input']}"
    response = llm.invoke(prompt)
    state['intent'] = response.choices[0].message.content
    state['history'].append(f"意图分类: {state['intent']}")
    return state
输入是包含user_input的State对象。核心逻辑是调用LLM进行意图分类,将结果写回State的intent字段,同时记录执行历史。输出是更新后的State。这里没有显式的异常处理,实际项目中应该用try-except包裹,失败时返回默认意图并记录错误日志。
条件路由函数
def check_approval_needed(state: AgentState) -> str:
    if state.get('requires_approval', False):
        return "pending_approval"
    return "proceed"
这个函数的输入是State,输出是字符串路由键。核心逻辑是检查requires_approval标志位。注意这里用state.get()而不是state['requires_approval'],避免键不存在时抛出KeyError。返回值必须与add_conditional_edges中定义的key完全一致,这是之前踩过的坑。
图构建段
workflow = StateGraph(AgentState)
workflow.add_node("classify", classify_intent)
workflow.add_edge(START, "classify")
workflow.add_conditional_edges(
    "extract",
    check_approval_needed,
    {
        "pending_approval": "approve",
        "proceed": "respond"
    }
)
这段代码构建了图的拓扑结构。add_node注册处理函数,add_edge添加确定性边,add_conditional_edges添加条件边。条件边的第二个参数是路由函数,第三个参数是路由函数返回值到节点名的映射。理解这个映射关系是调试工作流的关键。
审批节点
def approval_node(state: AgentState) -> AgentState:
    refund_amount = state['extracted_info'].get('amount', 0)
    if refund_amount > 500:
        send_to_approval_system({...})
        state['approval_status'] = 'pending'
    else:
        state['approval_status'] = 'approved'
    return state
输入是包含退款信息的State。核心逻辑是按金额阈值分流:超过500元触发人工审批流程,写入pending状态;否则直接标记为approved。异常处理方面,send_to_approval_system调用可能失败,需要捕获异常并降级为自动通过或记录错误后重试。
失败原因分析
我复盘了几个典型故障,发现失败原因可以分为三类:
业务错误:意图分类逻辑有漏洞,导致请求被路由到错误的节点。解决方案是增加测试用例,覆盖边界情况。
配置错误:阈值设错了、环境变量没加载。这类问题通常发生在部署环节,解决方案是建立配置检查清单。
环境错误:模型API超时、数据库连接失败。这类问题需要超时重试、熔断降级等机制。
区分这三类失败原因的方法:业务错误通常在特定输入下稳定复现,配置错误在部署后集中爆发,环境错误则随机出现。
适用边界
LangGraph适合的场景:
- 需要多步处理的工作流
- 需要人工介入的审批流程
- 需要完整状态管理的多轮对话
- 需要可观测性和可调试性的生产系统
不适合的场景:
- 简单的单轮问答
- 没有分支逻辑的线性流程
- 对延迟极度敏感的场景(图遍历有额外开销)
我的判断标准:如果工作流需要超过3个决策点,或者需要人工审批,就应该用图工作流。否则,简单脚本可能更合适。这是适用边界的核心取舍。
总结
LangGraph的价值不在于"能跑",而在于"可解释"。每个节点、每条边、每个状态变化都有迹可循。上线后出问题,你能定位到具体是哪个节点、哪条边出了问题,而不是面对一个黑盒无从下手。
能跑通Demo只是起点,能解释失败才算真正入门。这句话不是鸡汤,是血泪教训。
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。
 172


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


